

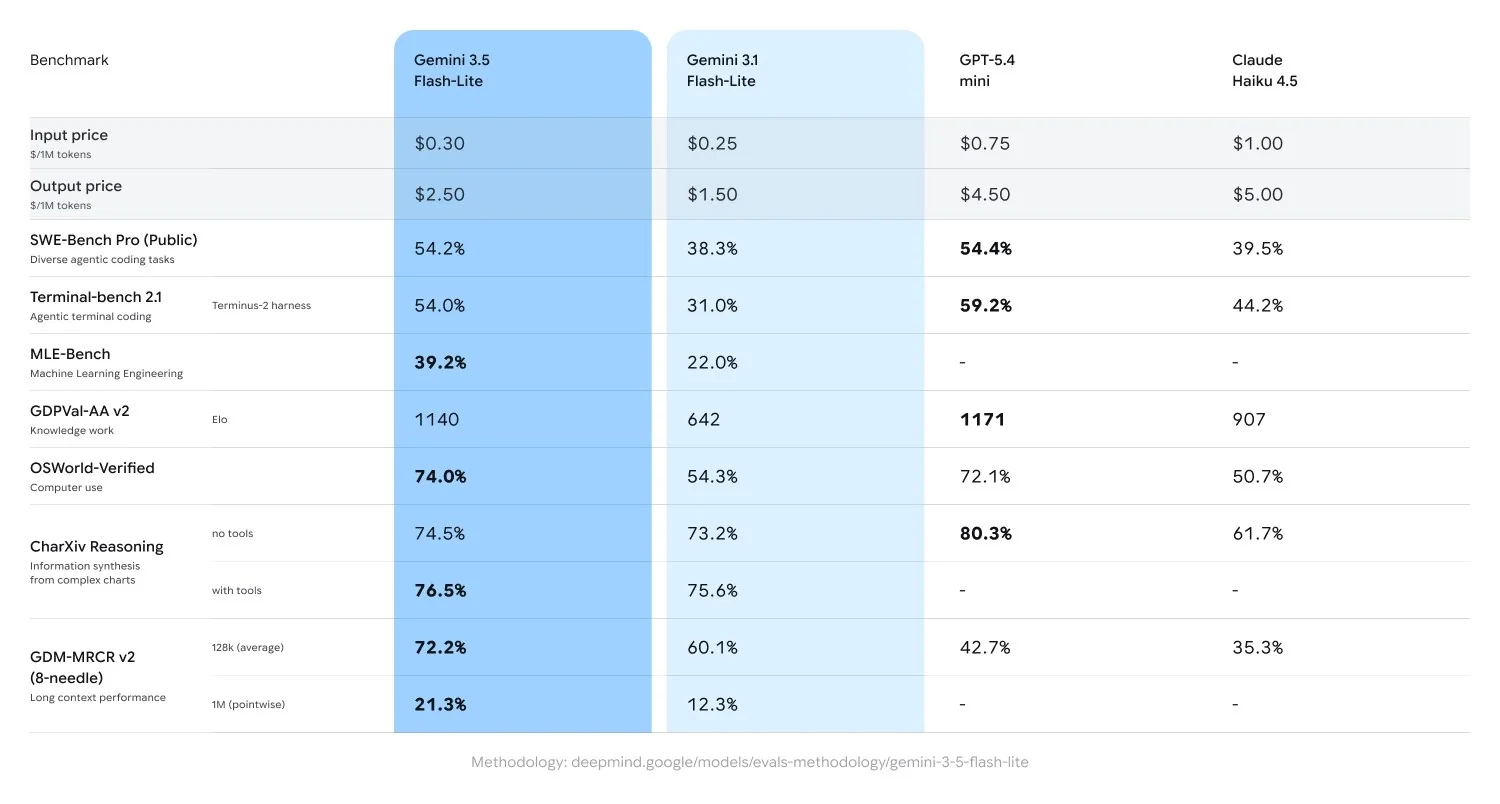
Em 21 de julho de 2026, o Google lançou o Gemini 3.5 Flash-Lite, o modelo mais rápido e barato de sua linha 3.5. Ele chegou no mesmo dia que o mais robusto Gemini 3.6 Flash, e os dois são fáceis de confundir. Resumindo: o Flash-Lite custa $0,30 de entrada / $2,50 de saída por 1M de tokens e roda a cerca de 490 tokens de saída por segundo, o que o torna o modelo a que recorrer quando cada tarefa é simples mas você a executa milhões de vezes.
Não é o modelo mais inteligente que o Google lança, e não tenta ser. No Artificial Analysis Index ele ainda alcança uma pontuação de inteligência respeitável de 36 (#12 de 152), então não é um brinquedo. Se você está lendo isso para construir automação de atendimento ao cliente sobre ele, uma coisa antes de tudo: o modelo é a parte fácil. Eu construo integrações e APIs para viver, e o que quebra um bot de suporte nunca é o modelo bruto, é tudo que está ao redor dele. Mais sobre isso abaixo.
O que o Gemini 3.5 Flash-Lite realmente é
O Google divide sua família Gemini em duas faixas. Os modelos Pro são o nível superior para raciocínio difícil. Os modelos Flash são os cavalos de trabalho: mais baratos, mais rápidos, ajustados para apps que fazem milhares de chamadas por dia. O Flash-Lite é o mais leve desses cavalos de trabalho, posicionado pelo Google para tarefas agênticas de alto volume, tradução e processamento de dados simples.
Pense nele como o modelo que você usa em trabalhos onde a tarefa individual é fácil mas o volume é brutal: classificar um ticket de suporte, extrair campos de um PDF, traduzir uma mensagem de chat, fazer uma busca de primeira passagem. Ele processa entrada de texto, imagem, vídeo, áudio e PDF, suporta function calling, saídas estruturadas, execução de código, cache e grounding com busca, e carrega a mesma janela de contexto de ~1M de tokens que seus irmãos maiores (cerca de 1.500 páginas A4 de entrada).
O que ele deixa de fora deliberadamente diz para quem ele é. O Flash-Lite não suporta computer use, geração de imagens, geração de áudio ou a Live API. Se seu agente precisa controlar um navegador ou gerar mídia, essa é a função do Gemini 3.6 Flash ou de um modelo Pro, não deste. O Flash-Lite se mantém estreito de propósito: ler texto, decidir, escrever texto, fazer isso rápido e barato.
Preços do Gemini 3.5 Flash-Lite
Aqui está o quadro completo. Esse é o motivo pelo qual o modelo existe, então vale a pena ler com atenção antes de colocá-lo em uma planilha.
| Modo de consumo | Entrada (por 1M) | Saída (incl. raciocínio) | Cache de contexto |
|---|---|---|---|
| Padrão | $0,30 | $2,50 | $0,03 |
| Batch (50% de desconto) | $0,15 | $1,25 | $0,02 |
| Flex | $0,15 | $1,25 | $0,02 |
| Priority | $0,54 | $4,50 | $0,05 |
| Nível gratuito | Gratuito | Gratuito | Gratuito |
Algumas coisas que vale a pena destacar:
- O nível gratuito tem uma pegadinha. No nível gratuito, o Google usa seu conteúdo para melhorar seus produtos; em qualquer nível pago, ele não faz isso. Para qualquer coisa que envolva dados de clientes, isso por si só elimina o nível gratuito.
- O modo batch tem um desconto fixo de 50%, que é o nível em que a maioria dos trabalhos de alto volume deveria realmente rodar. O mesmo vale para a inferência flex. Se o trabalho não precisa ser em tempo real, você paga $0,15/$1,25.
- Os acertos de cache são baratos. Um token de entrada em cache custa $0,03 por 1M, um corte de 90%, então o contexto repetido (seu prompt de sistema, um trecho de conhecimento) quase não aparece na conta.
- O grounding com busca é medido separadamente. Você tem 5.000 prompts com grounding gratuitos por mês em toda a família Gemini 3, e depois disso $14 por 1.000 buscas.
Uma observação honesta da Artificial Analysis: a $0,30/$2,50, ele fica em #87 de 152 em preço bruto, então "Lite" não significa "o mais barato do mercado". Significa o mais barato dentro da linha Gemini 3.5, mantendo ao mesmo tempo uma pontuação de inteligência de primeira linha. Para ver como isso se compara aos planos Gemini para consumidores e às outras camadas da API, nosso guia de preços do Gemini tem o detalhamento completo e os preços do Gemini Workspace cobrem os planos empresariais.
A velocidade é o destaque
Se o preço é o motivo para colocar o Flash-Lite na lista, a velocidade é o motivo para ficar com ele. A Artificial Analysis cronometrou cerca de 490 tokens por segundo, colocando-o em #2 de 152 modelos testados; o Google cita 350 tokens por segundo em seu próprio benchmark. De qualquer forma, ele fica perto do topo do campo.
Há uma ressalva que vale a pena conhecer antes de prometer a um product manager respostas em menos de um segundo. O tempo até o primeiro token fica em torno de 6 segundos na mediana, no topo da sua categoria, porque a etapa de raciocínio do modelo roda antes de o primeiro token visível aparecer. Então o streaming é extremamente rápido depois que começa, mas o início pode atrasar em um prompt difícil. Para a maior parte do trabalho de suporte (respostas curtas, classificação simples) esse orçamento de raciocínio é pequeno e o atraso é insignificante; para qualquer coisa que você cronometre no milissegundo, teste primeiro com seus próprios prompts.
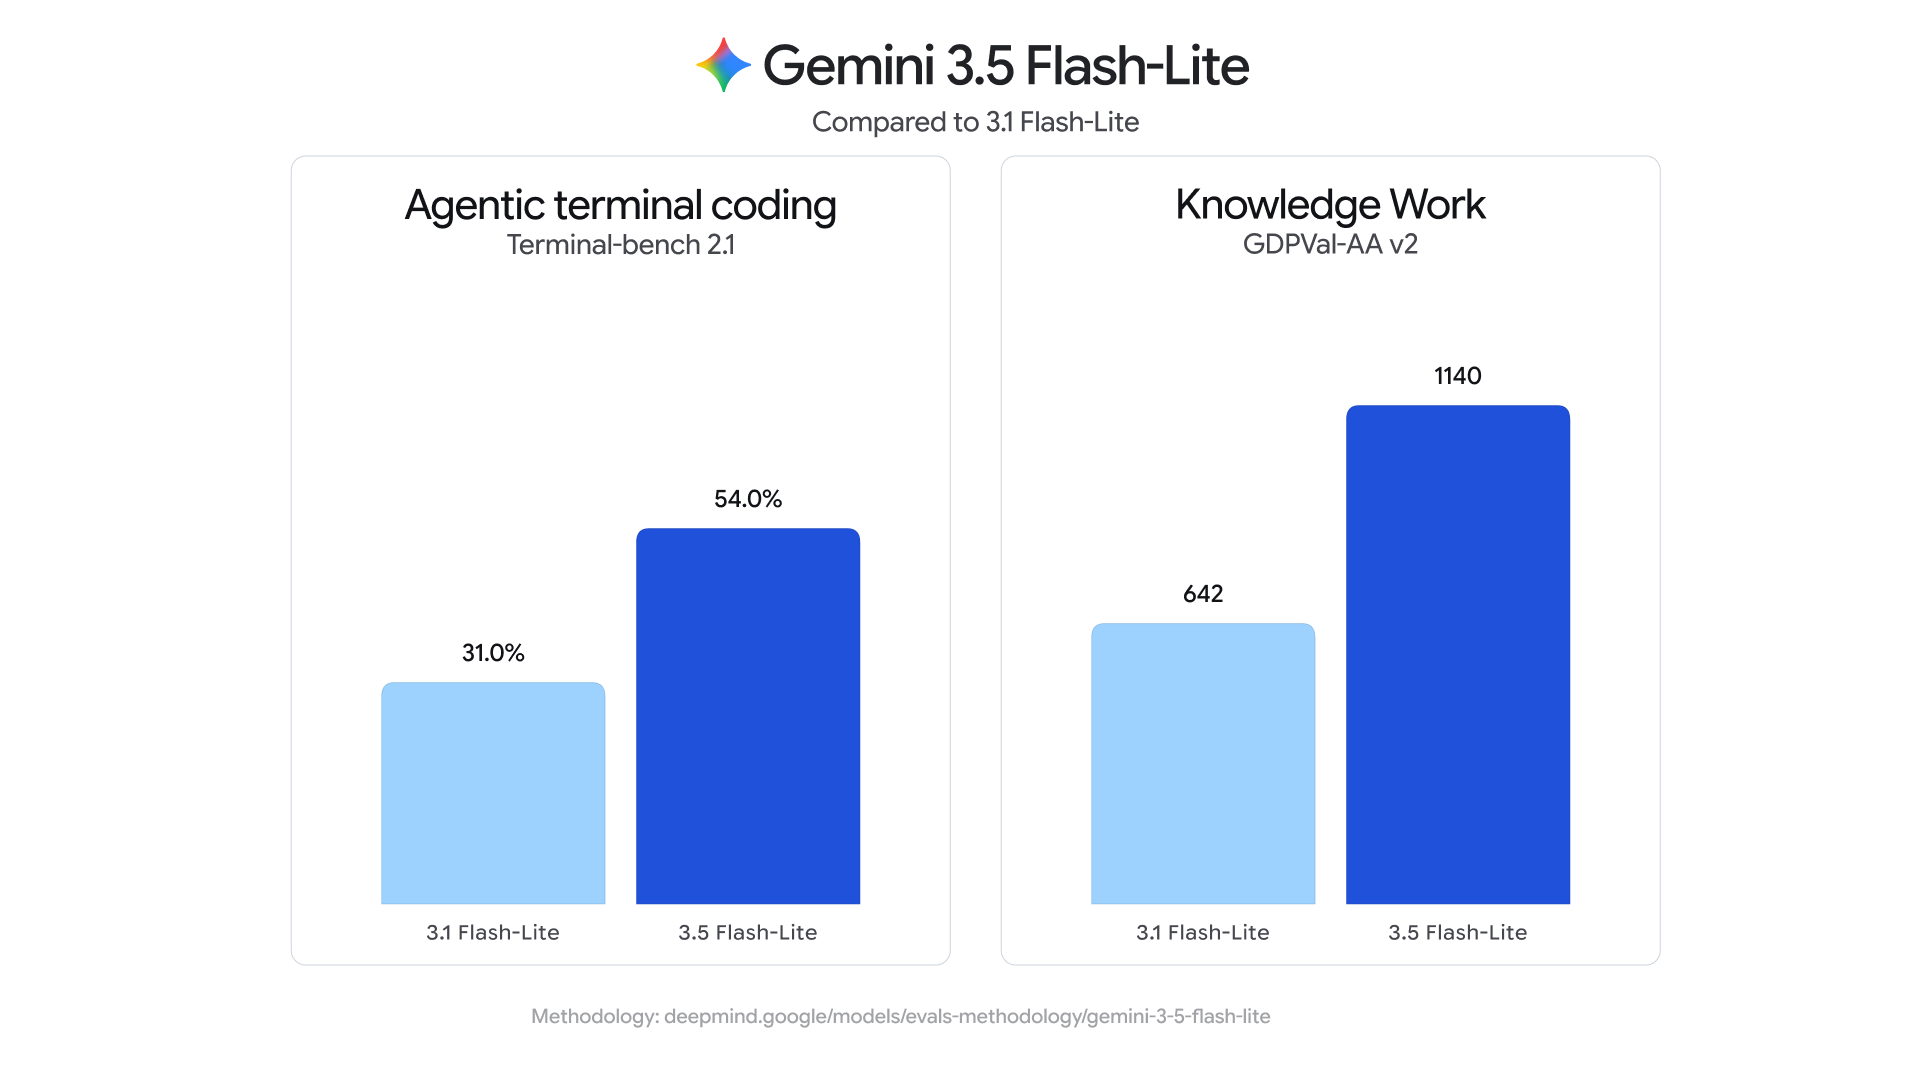
Contra seu próprio antecessor, o salto de geração é claro nos benchmarks de codificação agêntica e trabalho de conhecimento:
Flash-Lite ou 3.6 Flash? Escolha o certo
Essa é a decisão que a maioria das equipes erra, porque os dois foram lançados no mesmo dia e os nomes quase não se diferenciam. Eles foram construídos para extremos opostos do mesmo trabalho. Percorra o seletor abaixo.
A regra geral: recorra ao Flash-Lite quando cada item for simples e o volume for o desafio, como uma primeira triagem de tickets, desvio de nível 1 ou desvio de chat em tempo real de rotina. Recorra ao 3.6 Flash quando o trabalho realmente precisar raciocinar em vários sistemas. Construir um agente de IA de verdade ou um bot com script é uma decisão separada da escolha do modelo.
Os outros modelos que saíram naquele dia
O Flash-Lite não foi lançado sozinho. O Google lançou três modelos em 21 de julho e guardou um, e conhecer esse conjunto evita que você escolha o nível errado.
O Gemini 3.6 Flash é o novo cavalo de trabalho principal, a $1,50 de entrada / $7,50 de saída, com computer use integrado e cerca de 17% menos tokens de saída que o 3.5 Flash. O Gemini 3.5 Flash Cyber é um especialista em segurança ajustado para encontrar e corrigir vulnerabilidades dentro do agente CodeMender do Google, e está disponível apenas para governos e parceiros de confiança em um piloto limitado.
A ausência notável: o carro-chefe Gemini 3.5 Pro. A Bloomberg informou que ele sofreu atrasos internos depois de não atingir suas próprias metas de desempenho, e Logan Kilpatrick, do DeepMind, disse que ele ainda está em testes com parceiros. Então o movimento do Google aqui é revelador: manter o nível barato e de alto volume atualizado enquanto o carro-chefe ainda está sendo preparado. Se você precisa de um modelo de ponta hoje, nosso resumo de alternativas ao Gemini é o ponto de partida honesto, Gemini vs Claude e Gemini vs ChatGPT cobrem os confrontos diretos, e empresas de atendimento ao cliente com IA mapeia os fornecedores que constroem sobre esses modelos.
O que isso significa se você está construindo IA para suporte
Aqui eu preciso ser direto com você, porque essa é a parte que todo artigo de lançamento de modelo pula para as equipes de suporte.
Um modelo mais rápido e mais barato é uma boa notícia. Mas trocar para o Flash-Lite não te dá um agente de suporte funcional, assim como uma CPU mais rápida não te dá um aplicativo. Eu passo meus dias conectando integrações e APIs à eesel, e ao longo de mais de três anos colocando IA em filas de suporte reais, a falha que vimos repetidamente não é o modelo ser burro, é um bot que parece confiante dando uma resposta errada a um cliente real porque ninguém construiu as camadas em torno do modelo. O modelo é a base da pilha, não ela toda.
Essas camadas são o trabalho real. Recuperação de informação, para que o modelo responda a partir da sua base de conhecimento e de tickets anteriores em vez de adivinhar. Guardrails e escopo, para que ele transfira de forma limpa em vez de inventar uma política de reembolso. Integração, para que ele possa agir dentro do seu sistema de tickets. E testes, para que você saiba como ele se comporta antes de tocar em um cliente, não depois. Essa é a diferença entre uma API bruta e um software de atendimento ao cliente com IA de verdade, e é por isso que os problemas de chatbots de IA quase sempre remetem ao encanamento, não ao modelo.
É também por isso que eu contestaria conectar você mesmo a API bruta do Gemini ao seu helpdesk. Você estaria reconstruindo do zero a recuperação de informação, os guardrails contra alucinações, a simulação e cada integração de helpdesk, e depois mantendo tudo isso enquanto o Google lança um novo modelo a cada poucas semanas (três em um dia, dessa vez). Essa rotatividade é todo o argumento para escolher uma IA de helpdesk feita sob medida em vez de uma pilha caseira: o nível do modelo é um item substituível, o sistema em torno dele é o produto.
Experimente a eesel
Essa é exatamente a camada que a eesel foi construída para ser. Você a conecta ao seu helpdesk existente, ela aprende com seus tickets passados e sua base de conhecimento desde o início, e roda sobre modelos de ponta como o Gemini, então você obtém a velocidade e a economia de custos de um modelo como o Flash-Lite sem conectar a API você mesmo.

O diferencial que mais importa aqui é o que o Flash-Lite não pode te dar por conta própria: a eesel permite simular o agente contra seus tickets históricos antes que ele responda a um cliente real, então você vê a taxa de resolução e as respostas exatas que ele teria enviado. E como ela tem preço baseado em resultados, não por token, você evita a conta de tokens em cada ticket. Se você está avaliando modelos para construir automação de suporte, comece pelo resultado que você quer e deixe a plataforma escolher o encanamento. É gratuito para experimentar.