

Kustomerは、Intelligenceアプリがインストールされると、受信したテキストメッセージごとにセンチメントを-1(不満)から+1(満足)でスコア化し、料金ページではSentiment TrackingがEnterpriseとUltimateに含まれています。これにより、キュー内の不満な顧客を見つけるための、追加料金なしで常時動く信号になります。問題は会話レベルの数値です。Kustomer自身のドキュメントは、ある箇所ではすべてのメッセージスコアの平均だと説明し、別の箇所では直近の受信メッセージのスコアだと説明しており、この2つは正反対の方向を示すことがあります。顧客がどんどん怒っていくときにエスカレーションしたいなら、センチメントが悪化したかどうかを判定するConversation Intelligence Scoreを作ってください。1回0.02ドルです。
Zendesk、Freshdesk、Gorgias、Help Scoutでは、eeselのようなAI helpdesk agentがタグ付けやルーティングの前にスレッド全体を読むため、「怒っていて、どんどん怒りが増している」はチューニングすべきスコアではなく指示そのものになります。Kustomerとのインテグレーションはありません。eesel CLIを使えば、AIコーディングエージェントがエスカレーションポリシーをアップロードし、何かが本番に出る前に過去のチケットに対してテスト質問を実行できますが、ヘルプデスクの接続自体には依然として管理者の承認が必要です。
Kustomer AIのセンチメント分析とは何ですか?
これはKustomerが顧客のメッセージに対して行うセンチメント分析で、エージェントやマネージャーが各スレッドを読まずに誰が不満を持っているかを把握できるようにします。私はeeselで機能やAIエージェントを作っているので、自分たちのものを読むのと同じように読みます。何がそれを起動させるか、どのモデルを呼び出すか、数値がどこに保存されるか、その上に何を構築できるか。Kustomerには3つの層があり、混同しやすいです。
- 組み込みのメッセージセンチメント。 Kustomerの言語検出とセンチメント分析のガイドによると、detect-language-at-message-creationというシステムワークフローが新しい受信メッセージごとにスコアを付け、ポジティブ、ニュートラル、ネガティブなどの分類を割り当てます。これはアドオンではなくプラットフォームの一部で、Zendeskのセンチメント分析と似ています。Gorgiasもセンチメント検出で同じことをしています。
- Conversation Intelligence。 自分で定義するAI属性で、Classifier、Score、Extractorが会話を読んで結果をフィールドとして保存します。「この顧客はどんどん怒っているか?」というような独自の信号はここに住んでいます。実行ごとに課金されます。
- AI QA。 会話がどう処理されたかを採点するスコアカードで、1回0.05ドルです。これは顧客の機嫌ではなくあなたのチームを評価するものなので、重なる部分を除いて以下では取り上げません。AI support quality assuranceでその役割を扱っています。
Concierngeや会話の要約の裏にあるEnvoyツールなど、Kustomer AIの残りの部分は、この3つとは別物です。
Kustomerはどのようにセンチメントを計算しますか?
Kustomerは一度に1つのメッセージをスコア化し、受信した顧客のメッセージのみを対象とします。ガイドは2つの条件を挙げています。メッセージがインポートされていないこと、そしてテキストを含むこと。つまり、古いヘルプデスクから移行した会話にはセンチメントが付かず、画像や添付ファイルのみの受信メッセージはスコア化されません。
Kustomerの自然言語処理パイプラインは時間とともに変化してきました。Kustomerの2024年のSentiment scoresの記事では、メッセージが作成されるたびにAmazon Comprehendを呼んでいたとされています。2026年6月のautomatic language detectionの記事では「センチメント分析はAWS Bedrockでホストされる最新の大規模言語モデルを使って行われる」とされ、主要なサービスが利用できないときのフォールバックとしてComprehendが残されています。同じ記事はデフォルトのワークフローを「受信したメールメッセージのセンチメント」を検出するものと説明していますが、ガイドではテキストを含むすべての受信メッセージで実行されるとされているため、チャットが主なチャネルならチャットメッセージもテストしてください。
スコア化された各メッセージは、Kustomerのメッセージ属性リファレンスによると2つの数値を保存します。
| フィールド | 範囲 | 意味 |
|---|---|---|
Sentiment Polarity(sentiment.polarity) | -1から+1 | -1は不満でネガティブ、+1は満足でポジティブ |
Sentiment Confidence(sentiment.confidence) | 0から100 | モデルがその評価にどれだけ確信を持っているか |
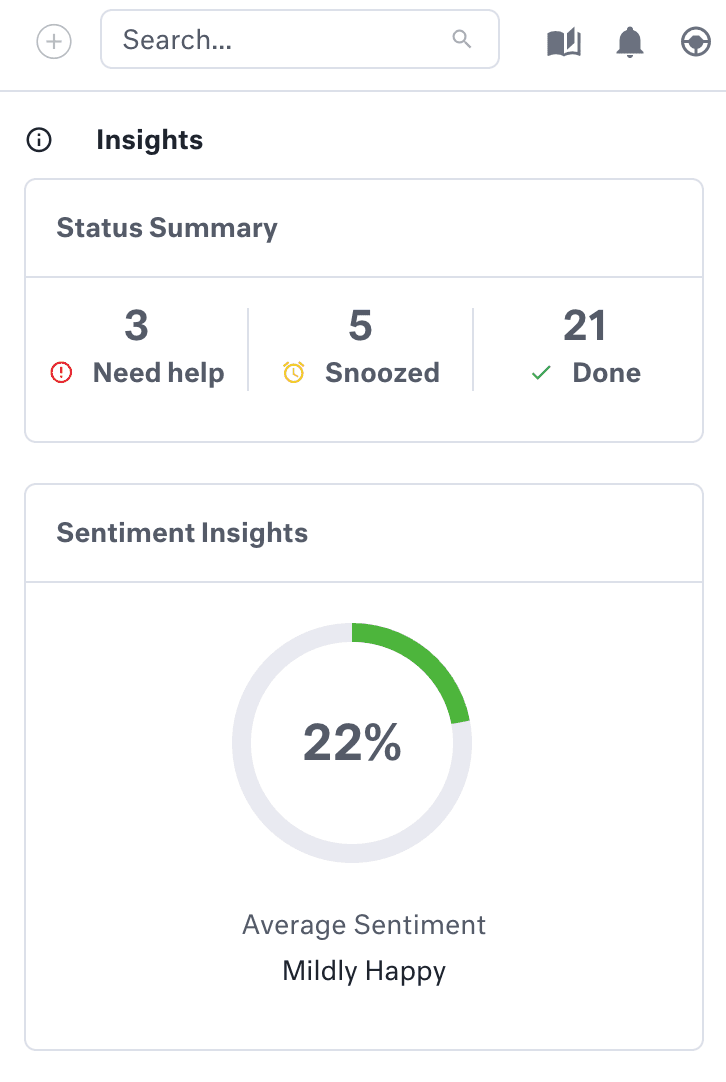
エージェントビューでは、ガイドによるとスコアは「メッセージで検出された口調に対するモデルの確信度を表す」とされ、パーセンテージで表示されます。顧客を検索したマネージャーには、平均値を示すSentiment Insightsカードが表示されます。
Kustomerの会話センチメントは平均値ですか、それとも直近のメッセージですか?
これは何かをその上に構築する前に確認したい部分です。Kustomerのドキュメントが2つの答えを出しているからです。Sentiment scoresの記事は「会話および顧客のセンチメント値は、その会話または顧客に紐づくすべてのメッセージスコアの平均である」としています。会話属性リファレンスでは、会話のSentiment Polarityを「この会話に紐づく顧客の直近の受信メッセージ」のセンチメントと説明し、顧客属性リファレンスでは、顧客のセンチメントは直近の受信メッセージのものであり、直近の会話用には別のフィールドがあるとしています。
どちらの読み方も有用です。ただ答えている問いが異なるだけで、短いスレッドでは完全に矛盾することがあります。
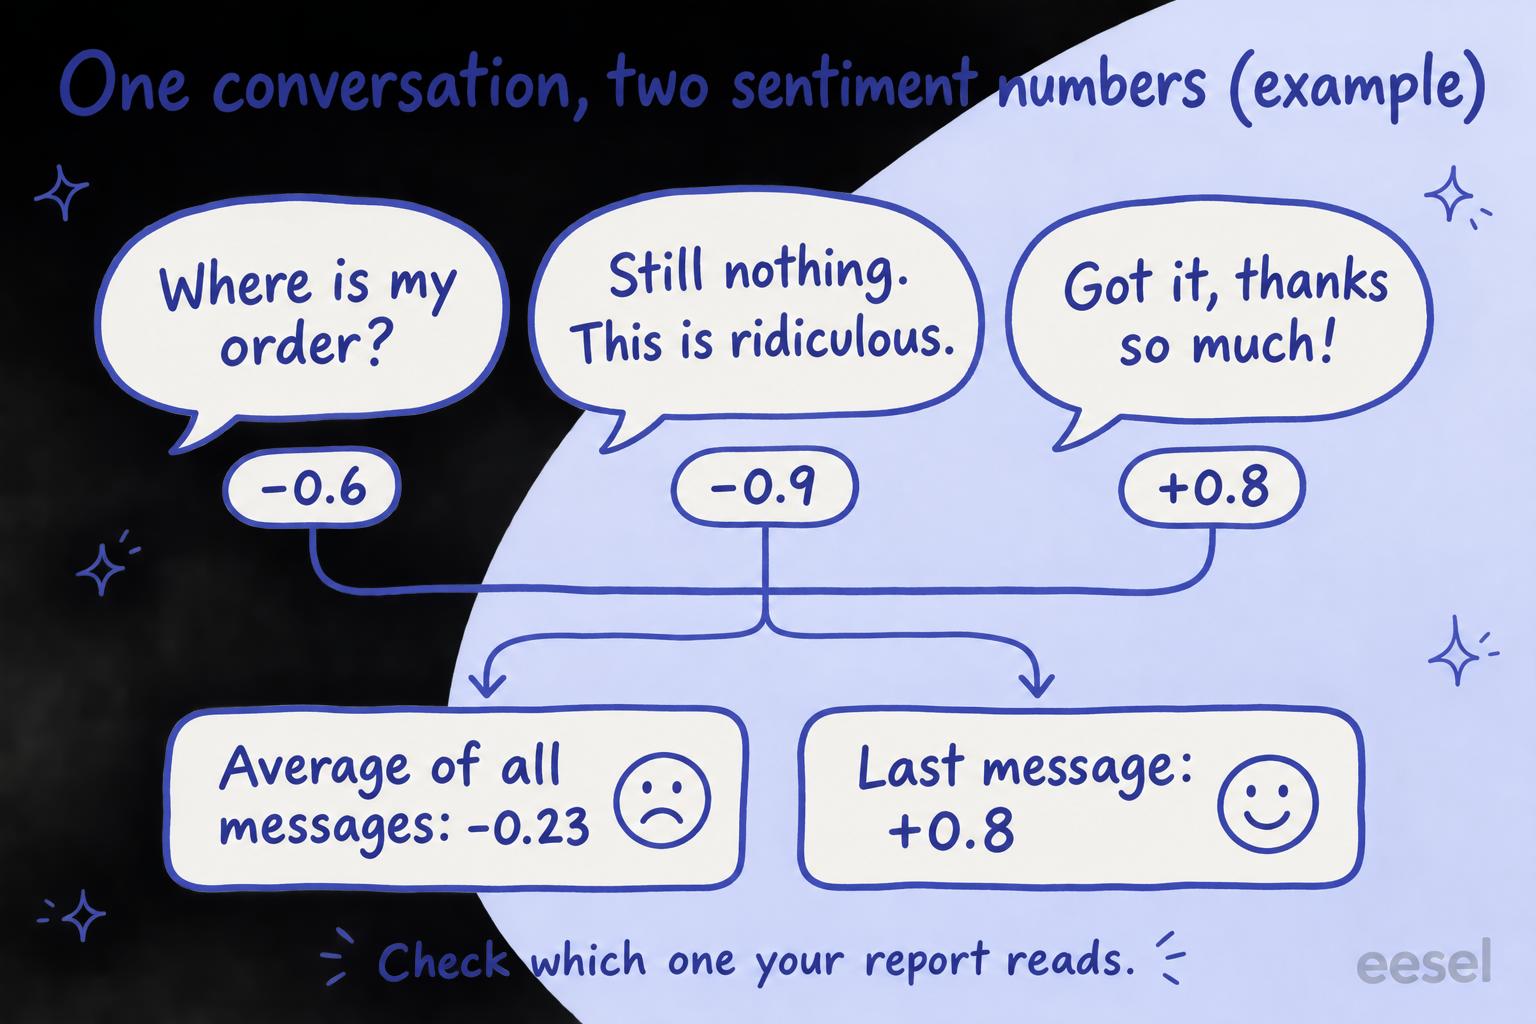
平均は月次トレンドには正しい数字です。「配送について書いた顧客は11月に以前より不満だったか?」直近のメッセージはキューには正しい数字です。「このユーザーは今、まさに怒っているか?」どちらも方向性は示してくれません。エスカレーションに通常必要なのは方向性です。Sentiment analysis on ticketsでは、それぞれの種類がどれだけ信頼できるかを詳しく扱っています。
3つの会話を切り替えて、平均値と直近メッセージのスコアがいつ食い違うかを見てください。
Kustomerでセンチメント分析を有効にする方法
管理者が一度行うだけで、以降の新しいメッセージからスコア化が始まります。
- Intelligenceアプリをインストールする。 左のナビゲーションでAppsをクリックし、Intelligenceを検索して開き、Installをクリックします。
- 検出をオンにする。 左のナビゲーションから任意のAppsページ内でIntelligenceをクリックし、Detect language automaticallyにチェックを入れます。ガイドによると、アプリがインストールされた状態でこの方法で言語検出とセンチメント分析を有効にする必要があり、別のセンチメント用スイッチは用意されていません。
- 実際の会話で確認する。 新しい受信会話を開き、Insightsパネルにあるsentiment insightカードを探します。6月の記事がメールのみという書き方をしているため、メールとチャットの両方を試してください。
- チームが見る場所にセンチメントを置く。 エージェントは会話のInsightsパネルでカードを見られます。マネージャー向けには、KustomerはEnterpriseとUltimateのレポートでSegmentation by Sentimentを挙げており、Sentiment InsightsカードはKustomer検索にも表示されます。
- レポートで使う数値を決める。 口調が揺れ動くメッセージを含む会話を3つ開き、会話のセンチメントと各メッセージのセンチメントを比較してください。ドキュメントが何と言っていようと、そこで見たものがあなたのインスタンスの実際の挙動です。
知っておくべき副作用が1つあります。同じワークフローが受信メッセージごとに会話の言語を再検出するため、どの言語のスニペットや満足度調査が使われるかが変わる可能性があります。Kustomerが提供する1つの選択肢は、システムワークフローを複製し(オリジナルは編集できません)、条件を追加して、オリジナルをオフにすることです。そうする場合は、コピーの中にセンチメントのステップを残しておいてください。Kustomer conversation translationで、このワークフローの言語面を扱っています。
Conversation Intelligenceでセンチメントに基づいてエスカレーションする方法
反応すべき信号には、平均化された数値に頼るより、Conversation Intelligenceの属性を作ることをお勧めします。Score属性についてのKustomer自身の例(Using AI attributes)には、Customer sentimentという基準があります。「対応中に顧客のセンチメントは改善したか、中立のままだったか、悪化したか?」これは組み込みのスコアでは答えられない方向性の問いです。
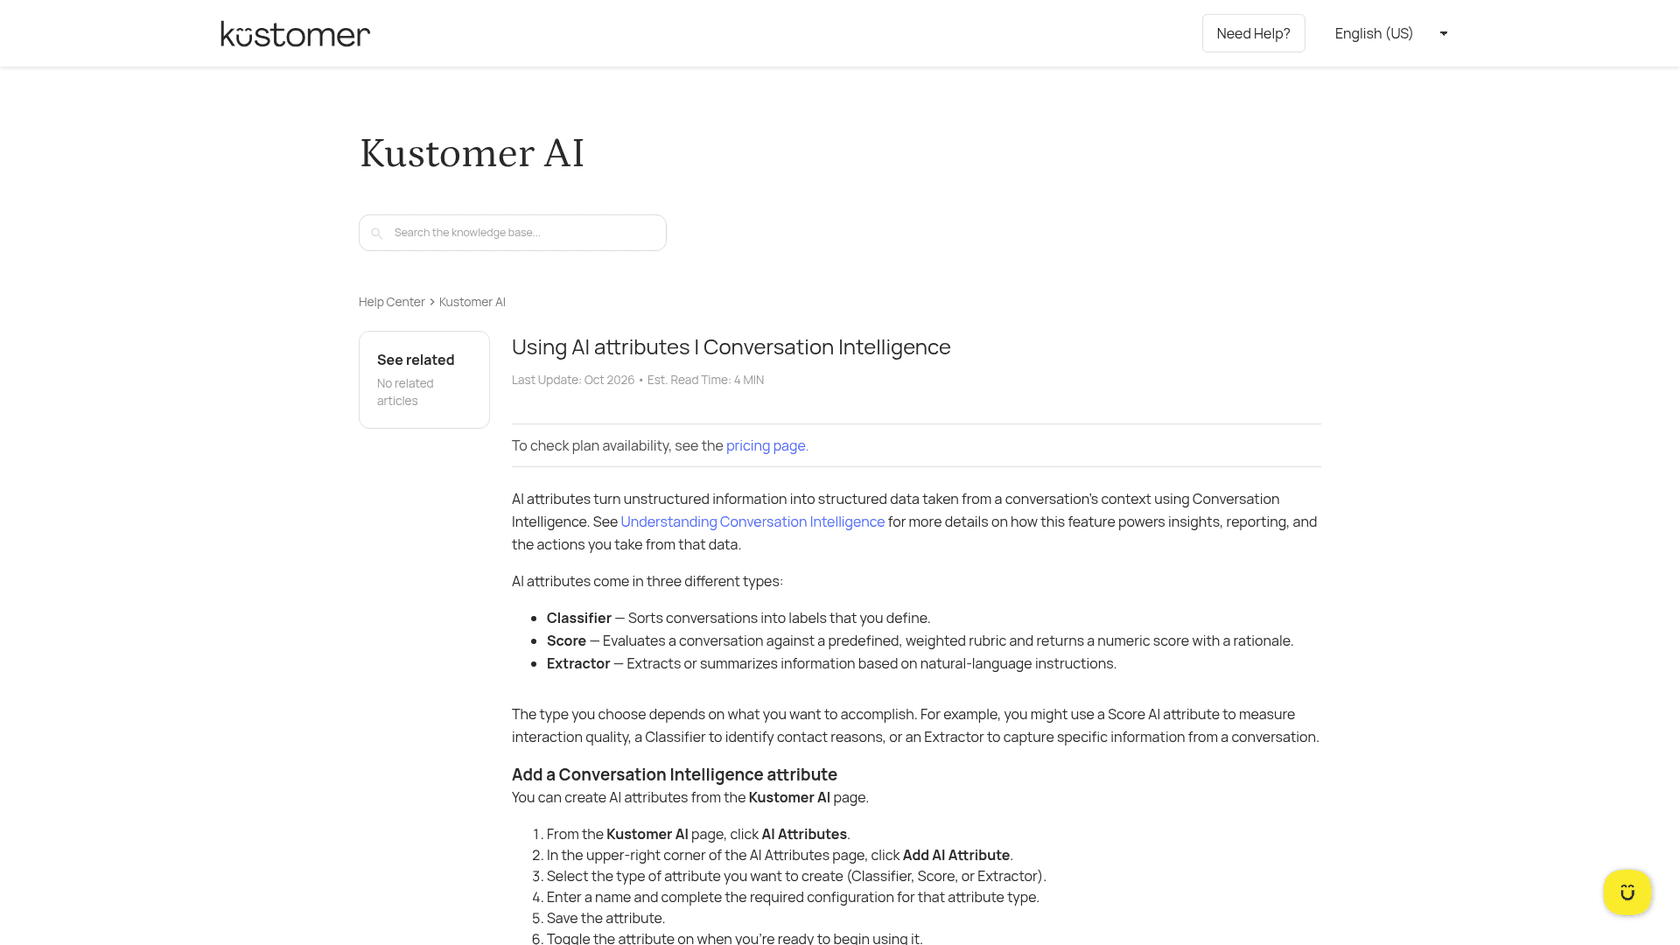
- Kustomer AIページからAI Attributesをクリックし、次にAdd AI Attributeをクリックします。
- タイプを選びます。Scoreは重み付けされた基準から0から100の値を返し、理由付きです。Classifierは会話を自分で定義したラベル、例えば「冷静」「不満」「解約の警告」のいずれかに分類します。
- 指示と基準を書きます。各基準に名前、説明、重み、評価カテゴリーを与えます。エスカレーション用には、センチメントの方向と「マネージャーまたは返金を求めた」を口調よりも重く重み付けします。
- 実行タイミングを選びます。1つの属性は最大3つのトリガーを持てて、各トリガーが1回の実行を生むため、すべてのイベントではなく重要な一瞬を選んでください。
- 保存してオンにし、その結果に基づいて動くワークフロー、たとえばシニアキューへのチケットルーティングを追加します。KustomerのConversation Intelligence overviewは、例として「対応品質スコアが一定の閾値を下回ったらワークフローをトリガーする」ことや、「キャンセル依頼」を retention チームにルーティングすることを挙げています。
計画しておくべきことが2つあります。属性が出力を保存する方法を決めるいくつかのプロパティは作成後に変更できないため、レポートを構築する前にScoreかClassifierかを確定させてください。そしてKustomerは、AIが推定した満足度スコアは「顧客が提出した評価ではなく、顧客満足度のproxyである」と明言しているため、実際のCSAT調査も並行して走らせ続けてください。AI escalationでは、何かが発火した後の良いハンドオフがどのようなものかを扱っています。
Kustomerのセンチメント分析の料金はいくらですか?
組み込みのセンチメントは含まれており、独自の種類は使用量に応じて課金されます。Kustomerのpricing detailsページ(2026年10月12日最終更新)はプラン料金自体を公開していません。それらは「Talk to Sales」ですが、各プランに含まれるものと使用料率は掲載しています。
| 項目 | Enterprise | Ultimate | Legacy Professional / Business |
|---|---|---|---|
| Sentiment Tracking | 含まれる | 含まれる | 含まれる |
| Segmentation by Sentiment | 含まれる | 含まれる | 含まれない |
| Automatic Language Detection | 含まれる | 含まれる | Businessのみ |
| Conversation Intelligence | 1回0.02ドル | 1回0.02ドル | 記載なし |
| AI QA | 1回0.05ドル | 1回0.05ドル | 記載なし |
料金ページはAI Attributesを追加料金で利用可能なものとして挙げており、Kustomer Usage Creditsで実行分を支払うこともできます(Conversation Intelligenceは1クレジットで50回実行)。
月8,000件の会話があり、1会話につき1回だけ発火するセンチメントScoreのトリガーを使うチームなら、8,000 x 0.02ドル = 月160ドルです。それぞれ1回だけ発火するトリガーを3つにすると480ドルになり、顧客からのメッセージごとに発火するトリガーなら、会話あたりのメッセージ数に応じて請求額が増えます。すべての会話にAI QAのスコアカードを追加すると、さらに8,000 x 0.05ドル = 400ドルです。量に応じて増えていくので、トリガーは絞って設定してください。Kustomer pricingでプラットフォーム側の料金を扱っています。
Kustomerのセンチメントが足りない部分はどこですか?
この機能はドキュメントに書かれている通りに動きます。問題はこの数値が運べるものと運べないものの範囲にあります。
- インポートした履歴にはセンチメントがありません。 古いヘルプデスクから持ち込んだメッセージはスコア化されないため、トレンドレポートはIntelligenceアプリを有効にした日から始まります。
- メッセージごとに1つの数値しかありません。 「製品は素晴らしいが、配送業者はひどい」というメッセージには1つの極性しか付きません。顧客が何に不満だったかを知る必要があるなら、それはClassifierかExtractorの仕事であり、Freshdeskのセンチメント分析が抱える同じ分断です。
- 会話レベルの数値は曖昧です。 前述の通り、2つのドキュメントが2通りの説明をしており、平均は後半の悪化を隠してしまいます。
- 送信メッセージはスコア化されません。 顧客を読むものであり、エージェントは対象外です。あなたの返信の口調はAI QAの仕事です。
- 理由は示されません。 組み込みのスコアは極性と確信度だけです。Conversation Intelligence Scoreは理由を付け加え、エージェントがそのフラグを信頼する必要がある場面では0.02ドルの価値があります。
KustomerのMCPサーバーは会話の詳細とともにセンチメントを返すため、外部のAIツールもそれを読むことができます。チームがすでにアシスタントにエスカレーションについて質問しているなら役に立ちますが、それでも同じ数値であることに変わりはありません。
eeselはどこに当てはまりますか?
eeselは、Kustomerからの移行を検討しているチームや、その横で2つ目のヘルプデスクを運用しているチームに合います。eeselはチームが既に使っているツールに加わるAI teammateで、サポートではヘルプデスクのキュー内で動き、過去のチケットから学び、返信する前にそれらに対してテストされます。その後にルールを組むセンチメントスコアの代わりに、スレッド全体を読んで「顧客が同じ注文について3回書いてきたか、マネージャーを求めてきたら、緊急としてタグ付けしエスカレーショングループに割り当てる」といった平易な指示に従います。ZendeskとGorgiasでは、eeselのZendeskドキュメントが、タグ付け、割り当て、優先度のようなフィールドの更新をそのアクションの一部として挙げています。
Gorgiasを使うクライミングアパレルブランドのRúngneは、まずスレッド全体を読み、チームメイトが既にした約束や進行中の返品、不満を抱える顧客を探すドラフトエージェントと、実行対象の新しいチケットごとにタグ付けするトリアージエージェントを運用しており、human_review_requiredタグも含まれます。キャンセル、破損品、人間を求める人はチームに渡ります。
eeselにはKustomerとのインテグレーションがありません。Kustomerはeeselのヘルプデスクドキュメントに含まれていないため、あなたのKustomerワークスペースに接続するようお勧めすることはできません。Kustomerに留まるなら、私の助言は上記のセットアップです。Intelligenceアプリを有効にし、自分の会話スコアが実際には何を示しているかを確認し、方向性に基づいて行動する必要がある場面ではScoreの0.02ドルを払う、というものです。
Kustomerのセットアップと並べてeeselを試す
不満な顧客への対応方法でヘルプデスクを比較しているなら、Zendesk、Freshdesk、Gorgias、Help Scoutでのトライアルでeeselを試してください。エスカレーションルールを平易な言葉で書き、過去1週間のチケットに対して実行し、どれがフラグされ、なぜそうなったかを確認してください。eeselが単独で行うことと、人の承認を待つことはアクションごとにactions and approvalsで設定できるため、何かを再割り当てする前に、まずタグ付けとメモ残しから始めることができます。

まずは自分のエスカレーションルールでeeselを試すか、best AI for Kustomerで他の選択肢を比較してください。