「APIでサポートエージェントを構築する」が実際に意味すること
私はここ数年、AIエージェントをヘルプデスクに接続するコードを書き続けてきましたが、この種の構築を始める人に最初に伝えるのはこれです。モデルへのAPI呼び出しが時間を食うことは決してない、ということです。サポートエージェントは単一のAPIではありません。それは小さなシステムであり、「APIで構築する」とは実際には、それらのAPIをひとまとめにして、単一の信頼できる同僚のように振る舞わせることを意味します。
計画していようがいまいが、行き着くのは次のようなスタックです。
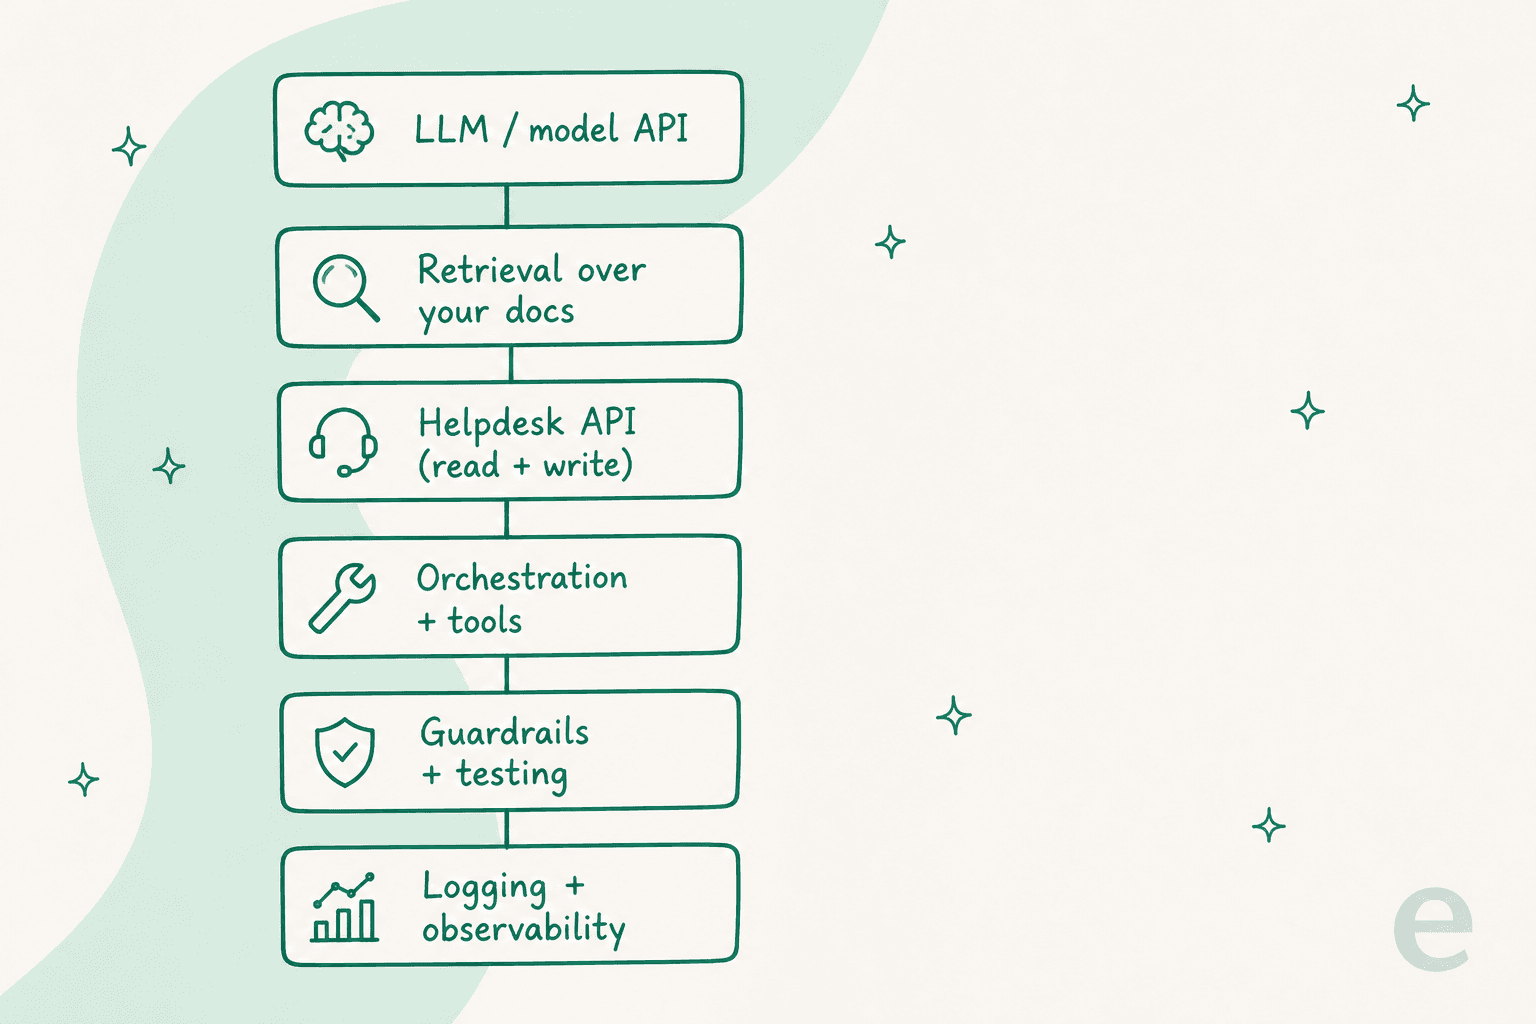
- モデルAPI。 チケットを読み、何を言うべきか決めるLLMです。誰もがここから始める部分ですが、結果に対して最も重要度が低い部分でもあります。今どきどの本格的なモデルも十分に優秀だからです。
- ナレッジ上の検索。 ヘルプセンター、過去のチケット、社内ドキュメントをチャンク化してインデックス化し、モデルがオープンなインターネットではなくあなたの現実に基づいて答えられるようにします。ここを間違えると、自信満々に間違え続けるエージェントができあがります。
- ヘルプデスクのAPI。 Zendesk、Gorgias、Frontなど、チケットが存在する場所への読み書き接続です。エージェントは会話を見て、返信を投稿し、タグ付けし、エスカレーションできる必要があります。
- オーケストレーションとツール。 会話の途中で注文を照会したり、契約状況を確認したり、社内エンドポイントを呼び出したりできるようにする接着剤です。話すことしかできず行動できないサポートエージェントは、簡単な質問しか処理できず、残りは取りこぼします。
- ガードレール、テスト、ログ。 本番環境で全体が暴走するのを防ぎ、実際の顧客に答える前に機能することを証明できるようにする、地味だが欠かせない層です。
この概念的な整理をもっと知りたい方向けに、カテゴリーとしてのカスタマーサポートエージェントAPIについて姉妹記事を書いています。この記事は実践編で、実際にどう組み立てるか、そしてどこで痛い目に遭うかを扱います。
道1:生のAPIから自分で構築する
これが正解となるのは特定のケースに限られます。エージェントそのものが販売する製品である場合、どのベンダーもカバーしないワークフローがある場合、あるいはエンジニアに余裕があり各層を自前で持つ理由がある場合です。それが自分に当てはまるなら、ここに作業の正直な姿があります。
まずモデルAPIとプロンプトから始めます。これは半日で終わり、魔法のように感じられます。次に検索を接続すると、デモは本当に役立つものになります。そしてヘルプデスクを接続すると、プロジェクトの性格は完全に変わります。もうチャットボットを作っているのではなく、連携を作っているからです。
簡単そうに見えて実はそうでない部分
こうした構築を見積もる際に部外者がいつも間違えるのはこの点です。モデルとREST面のサイズで見積もってしまうのです。ヘルプデスクのAPIドキュメントを見て、チケットや返信用のきれいなエンドポイントを目にし、1週間と見積もります。しかし実際の時間は、ドキュメントに載っていない部分に消えていきます。
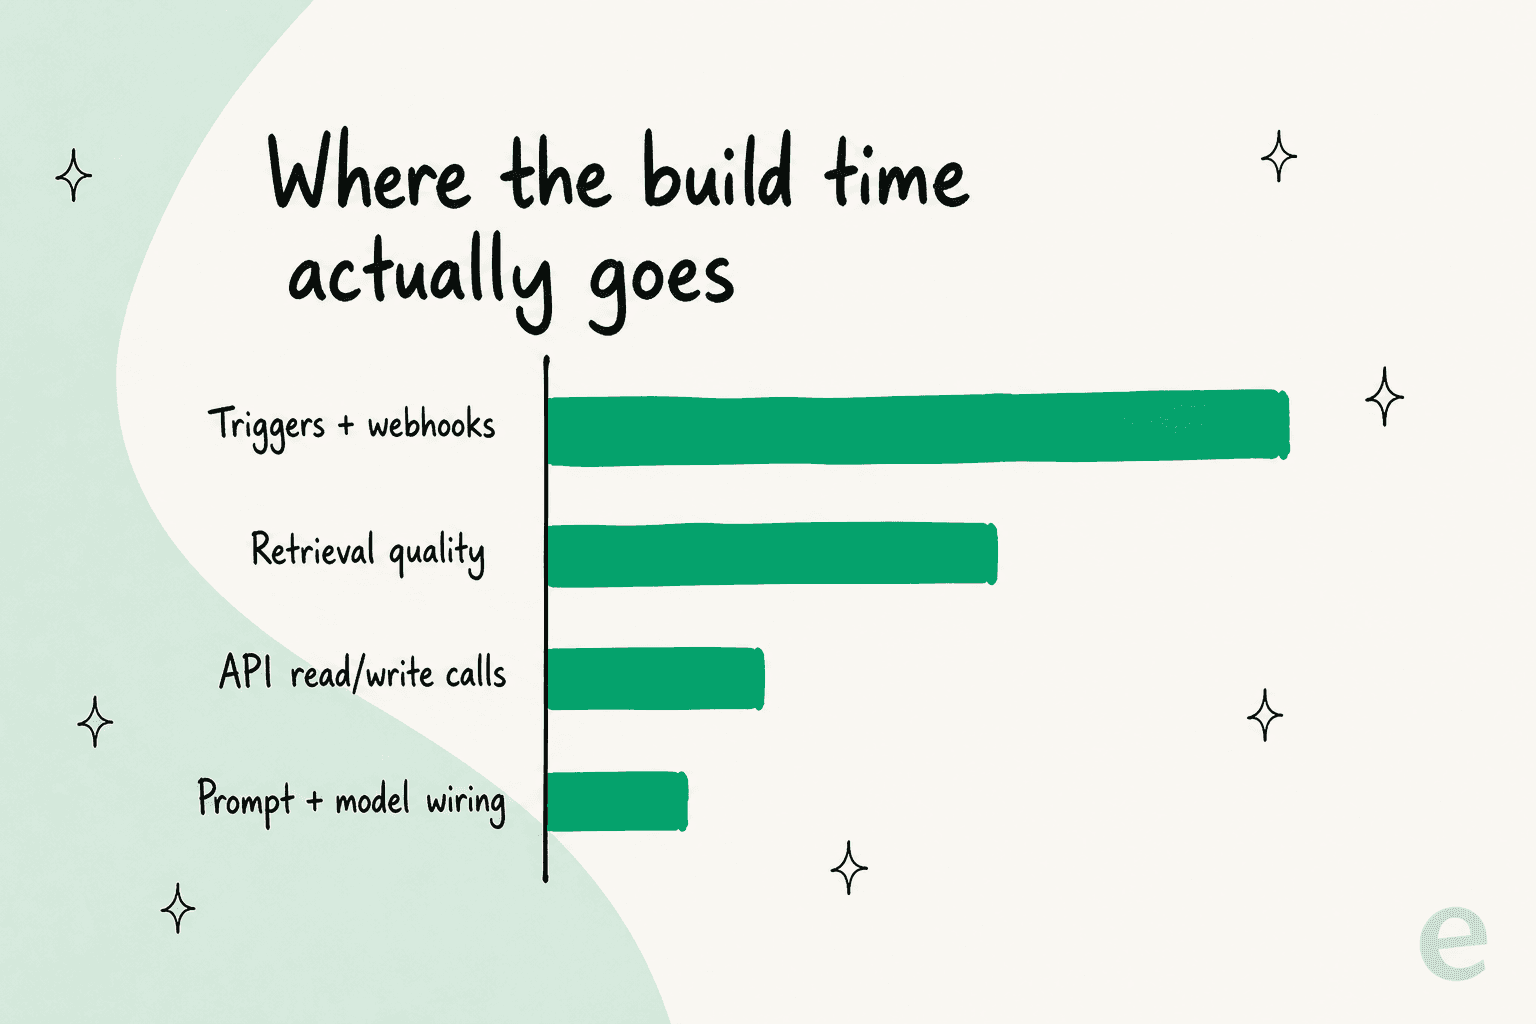
痛みのおよそ半分はトリガーであり、API呼び出しではありません。各プラットフォームはエージェントがいつ起動するかをそれぞれ異なる方法で決めています。本物のWebhookを発火させるものもあれば、ポーリングを強いるものもあり、独自の癖を持つ自動化ルールにすべてを通すものもあります。顧客ごとにWebhookのライフサイクル全体を管理して孤立させないようにし、二重に届くイベントを重複排除し、各プラットフォームの隠れた挙動を苦労しながら学ばなければなりません。私のお気に入りの例は、Freshdeskがエージェント作成のチケットに対して自動化ルールを黙って一切発火しないことで、これが設計通りの動作だと理解するまで何時間も失いました。そのどれもエンドポイントのリファレンスには載っていません。
検索の精度は次の金食い虫です。ドキュメントのインデックス化は簡単ですが、曖昧で誤字混じりの現実の質問に対してエージェントに正しいパッセージを検索させるのは、一度きりのセットアップではなく継続的なチューニング作業です。そして「マルチインスタンス」には驚かされます。Zendeskというプラットフォームへの接続と、この特定の顧客のZendeskへの接続は同じではなく、それを混同すると、あるアカウントで機能を有効にすると別のアカウントの挙動が変わるというバグに悩まされます。
本当に稀な一度限りの連携については、予想とは逆のやり方がうまくいくと分かりました。エージェントにAPIキーとドキュメント、リファレンススクリプトを渡し、エンドポイントを直接呼び出させるのです。これは私たち自身のテストでは、より重厚なベンダー抽象化アプローチを上回りました。マネージドOAuthや事前構築済みのコネクタは、頻繁に使うホットパスでこそ価値を発揮し、ロングテールでは割に合いません。
これらはどれも構築しない理由にはなりません。正直に予算を組む理由になるだけです。この道を進むなら、ヘッドレスカスタマーサポートとサービス間AIエージェントについての記事で、実際に通用するアーキテクチャパターンをより深く掘り下げています。
道2:すでにプログラム可能なチームメイトを雇う
ここからが、ほとんどのチームが本当に望んでいる道であり、エージェントが自社のコア製品でない限り私が選ぶ道です。スタックを構築するのを飛ばして、モデル、検索、1000以上の連携がすでに組み込まれたAIヘルプデスクチームメイトを雇い、それをコードで操作するのです。
エンジニアからのよくある反論はもっともです。購入型のエージェントはダッシュボードで設定するブラックボックスであり、ダッシュボードはプルリクエストに収まりません。まさにそれが、この道が避けようとしている落とし穴です。eeselのドキュメントには文字通り「このサイトのすべてはターミナルから行える」と書かれており、エージェントはブラウザでダッシュボードを操作しないよう指示されています。ダッシュボードはビューであって、正の情報源ではありません。
具体的には、プログラム可能な操作面は次の4つです。
- 本物のCLI。
npx @eesel/cliはアカウントを作成することすらなく使い始められます。連携を接続し、エージェントの恒常的な指示を編集し、eesel activityで過去の実行を一覧・閲覧し、人間による承認を管理する、これらすべてをシェルから行えます。すべてのコマンドはJSONを出力し、--dry-runは書き込みを送信する前に、それが行うであろうサーバー呼び出しを正確に表示します。これがおもちゃとCIに組み込めるものとの違いです。 - ワークスペースごとのMCPサーバー。
npx @eesel/cli mcp tokenはURLとトークン、そしてClaudeや任意のMCPクライアントにeeselを追加するための貼り付け可能なコマンドを提供します。あなた自身のエージェントは、標準的なツールを通じてワークスペースを読み取り、操作できるようになります。 - Webhook。 エージェントを起動する固有のURLで、自分のシステムからのイベントがポーリングループを書かなくても実行をトリガーできるようにします。
- Network Access。 ドメインと認証ヘッダーを許可リストに登録すれば、エージェントは指定した任意のREST APIをGETからDELETEまで呼び出せます。認証情報はモデルが決して目にすることのないヘッダーとして保存されます。
これでほとんどのチームにとって「APIでサポートエージェントを構築する」という意図はカバーされます。自分で構築するのと同じコードファーストでターミナル駆動の制御が、連携とメンテナンスにかかる数か月分の作業なしに手に入るのです。ターミナルでのワークフローこそがここに来た理由のすべてだという方には、ターミナルからAIエージェントを管理するとコマンドラインからサポートを自動化するでさらに深掘りしています。
では、自作か購入か?
この2つの道は、同じものを正反対の方向に取引しています。構築は完全なコントロールを手に入れる代わりに、時間とメンテナンスを永遠に払い続けることになります。プログラム可能なチームメイトはスピードを手に入れる代わりに、最も深いカスタマイズの一部を犠牲にします。ほとんどのサポートのユースケースでは、チームメイトの方が勝ちます。「自社のヘルプデスクでチケットを解決する」はすでに解決済みの問題であり、それを再発明しても割に合わないことがほとんどだからです。
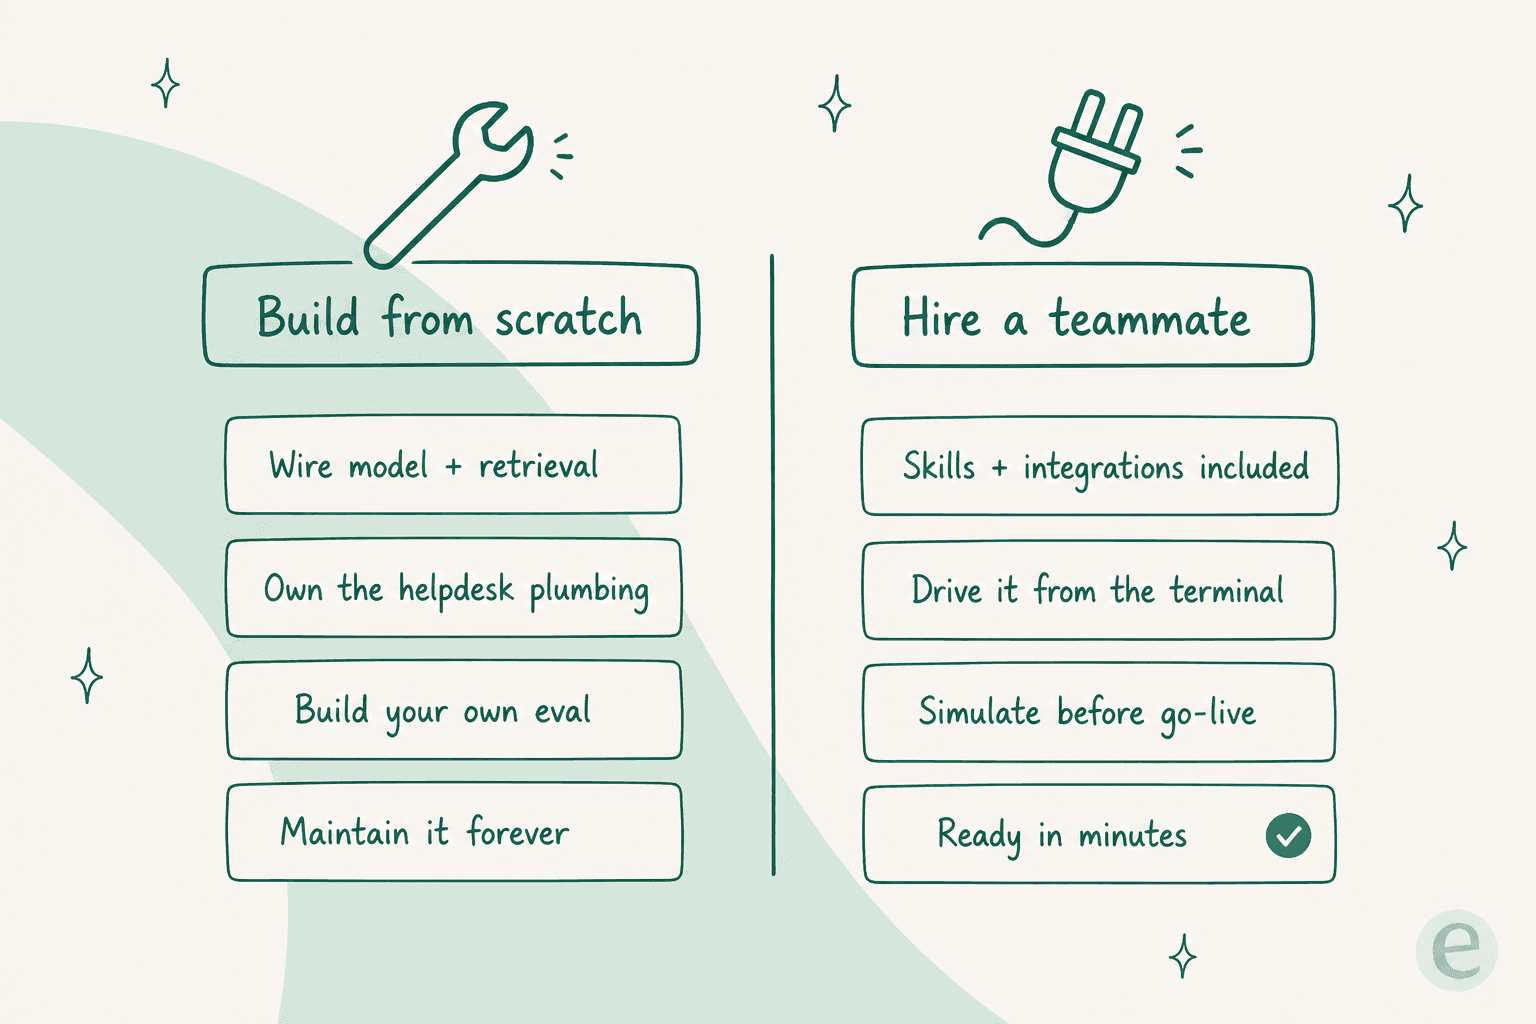
以下の簡単なチェックを使って、あなた自身の状況がどちらに傾くか見てみてください。
みんなが過小評価する部分
どちらの道を選んでも、エージェントが信頼できるものになるか、それとも負債になるかを決めるのは3つの層です。これらはまた、急いだ自作構築が省略してしまいがちな層でもあるので、あえて取り上げる価値があります。
本番投入前のテスト。 サポートエージェントについて最も恐ろしいのは、もっともらしい誤答が正答とまったく同じに見えることです。それを顧客の前で発見したくはありません。ゴールドスタンダードは、本番投入前に、自社の過去のチケットに対してエージェントを実行し、どう返信していたかを確認することです。そのテスト基盤を自分で構築するのは本物の作業ですが、同時にあなたが構築するもののうちで最も重要な一つでもあります。eeselはまさにこれを行うシミュレーションモードを備えており、これはゼロから再実装したくない機能の筆頭です。
人間参加型の承認。 初期段階では、エージェントに下書きさせて人間が承認し、信頼が積み上がるにつれて手綱を緩めていきたいものです。自分で構築するなら、それはキューであり、UIであり、ステートマシンです。購入の道ではeesel approvals listとeesel approvals approve <id> --alwaysで済みます。考え方は同じでも、必要なコード量はまったく違います。
可観測性。 エージェントが予想外のことをしたとき、「なぜ?」には本物の答えが必要です。つまり、すべての実行をその入力、取得されたコンテキスト、実行されたアクションとともにログに残し、後から詳細に読み返せるようにする必要があります。自分で構築するなら、最初のインシデントの後ではなく初日からこれを組み込んでください。eeselではeesel activityで、最新の実行から順に、どれでも詳細に掘り下げられます。
これらはどれも特別なものではありません。単に、デモとキューを任せられるものとの違いであり、まさに「1スプリントで作れる」という見積もりが崩れる場所です。
配管を自分で構築せずにサポートエージェントを構築する
自社が既に使っているヘルプデスクでチケットを解決するサポートエージェントが目標なら、eeselは構築者としてのメンテナンス費用を負わずに構築者としてのワークフローを提供します。過去のチケットとヘルプセンターで学習し、Zendesk、Gorgias、Frontをはじめ数百のツールと連携するAIヘルプデスクチームメイトで、ダッシュボードに触れたくないならCLI、MCP、Webhookから完全に操作できます。
エンジニアに最初に指し示したい差別化要素はシミュレーションです。過去のチケットに対してエージェントを実行し、顧客が一人も関わる前に、それがどう対応していたかを正確に確認できます。クレジットカードなしで無料で始められ、解決件数ごとの利用量課金なので、際限のない構築ではなく実際の数字と比較して検討できます。現在の料金は料金ページをご覧ください。コードファーストな面に惹かれたなら、npx @eesel/cliでターミナルからeeselを試してください。
よくある質問
APIでカスタマーサポートエージェントを構築するにはどうすればいいですか?
AIカスタマーサポートエージェントを構築するにはコーディングが必要ですか?
サポートエージェントを構築するにはどのAPIが必要ですか?
APIでカスタマーサポートエージェントを構築するのにいくらかかりますか?
AIサポートエージェントは自作と購入のどちらが良いですか?


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.