

Ce qu'est vraiment Laya AI
Le slogan de la page d'accueil de Laya est « decisions, not text » (des décisions, pas du texte), et c'est tout le produit en trois mots. La plupart des IA que vous avez utilisées sont autorégressives : elles prédisent le token suivant, puis le suivant, en construisant une phrase. C'est idéal pour rédiger une réponse et désastreux pour une décision par oui ou non, car vous faites tourner un modèle de langage pour obtenir un seul bit d'information, puis vous analysez du texte libre pour le récupérer.
Laya est l'autre type de modèle. C'est un encodeur bidirectionnel qui lit toute l'entrée d'un coup et répond à une question fixe en notant vos options plutôt qu'en les écrivant. Convai l'appelle un modèle System 1 : le jugement instantané, réflexe, par opposition au raisonnement System 2, lent et délibératif, d'un LLM génératif. Le créateur, Nandakishor Mukkunnoth, de Convai Innovations, expose la motivation sans détour :
"Not every AI problem requires an autoregressive chatbot."
Il a raison, et si vous avez déjà branché un modèle de 8B sur un prompt qui se termine par « respond only with JSON », vous avez ressenti la douleur qu'il décrit.
L'idée : System 1, pas System 2
L'argument repose sur une vraie inefficacité. Quand vous appelez un modèle génératif pour acheminer un ticket ou signaler un e-mail de phishing, vous payez trois fois : 500 à 2 000 ms de latence, un vrai coût d'inférence et une analyse de chaînes fragile en sortie. Pire, le chiffre de confiance que vous donne un LLM est du théâtre. Comme le dit Nandakishor :
"When an LLM outputs 'confidence: 0.95', it is just predicting tokens that sound confident. There is zero mathematical calibration behind it."
La réponse de Laya est de faire de la décision réflexe son propre modèle, un modèle qui renvoie une vraie distribution de probabilités plutôt qu'une phrase qui sonne sûre d'elle. Ce contraste est toute la raison d'être du modèle.
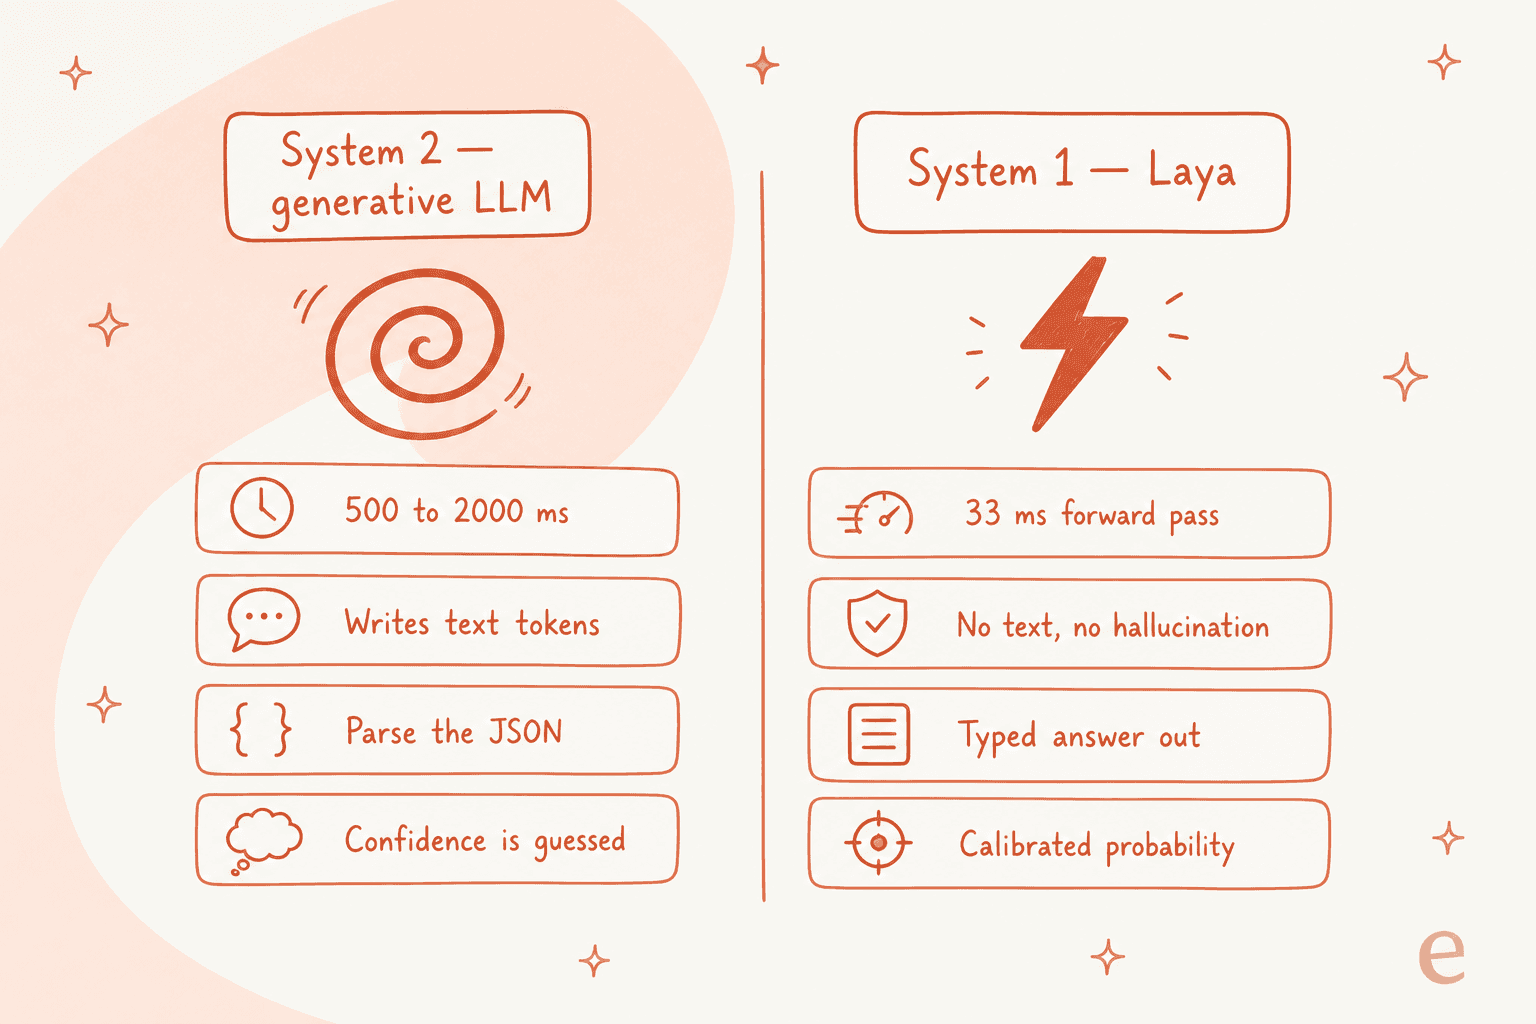
C'est la partie que je trouve la plus intéressante, parce qu'elle rejoint quelque chose que j'ai appris à mes dépens. L'échec dangereux en automatisation du support n'est pas un bot qui dit « je ne sais pas ». C'est un bot sûr de lui et dans l'erreur. Un modèle qui rapporte des probabilités honnêtes vaut plus qu'un modèle qui a un point de précision brute en plus, parce que vous pouvez réellement fixer un seuil sur la confiance et escalader les cas fragiles. Laya est conçu autour de cette idée dès le départ.
Comment Laya fonctionne sous le capot
Mécaniquement, Laya prend un état plus une ou plusieurs questions typées et y répond toutes en une seule passe parallèle. Il existe trois primitives de question, et une fois que vous les voyez, vous réalisez qu'elles couvrent la plupart des « décisions » d'une chaîne de support :
- choice choisit une option dans un ensemble que vous définissez (routage, intention, sujet).
- score place l'état sur une échelle ordinale, par exemple de 0 à 3 (urgence, frustration, gravité).
- noul est un booléen qui renvoie un P(true) calibré de 0.0 à 1.0 (phishing, spam, jailbreak, risque de départ).
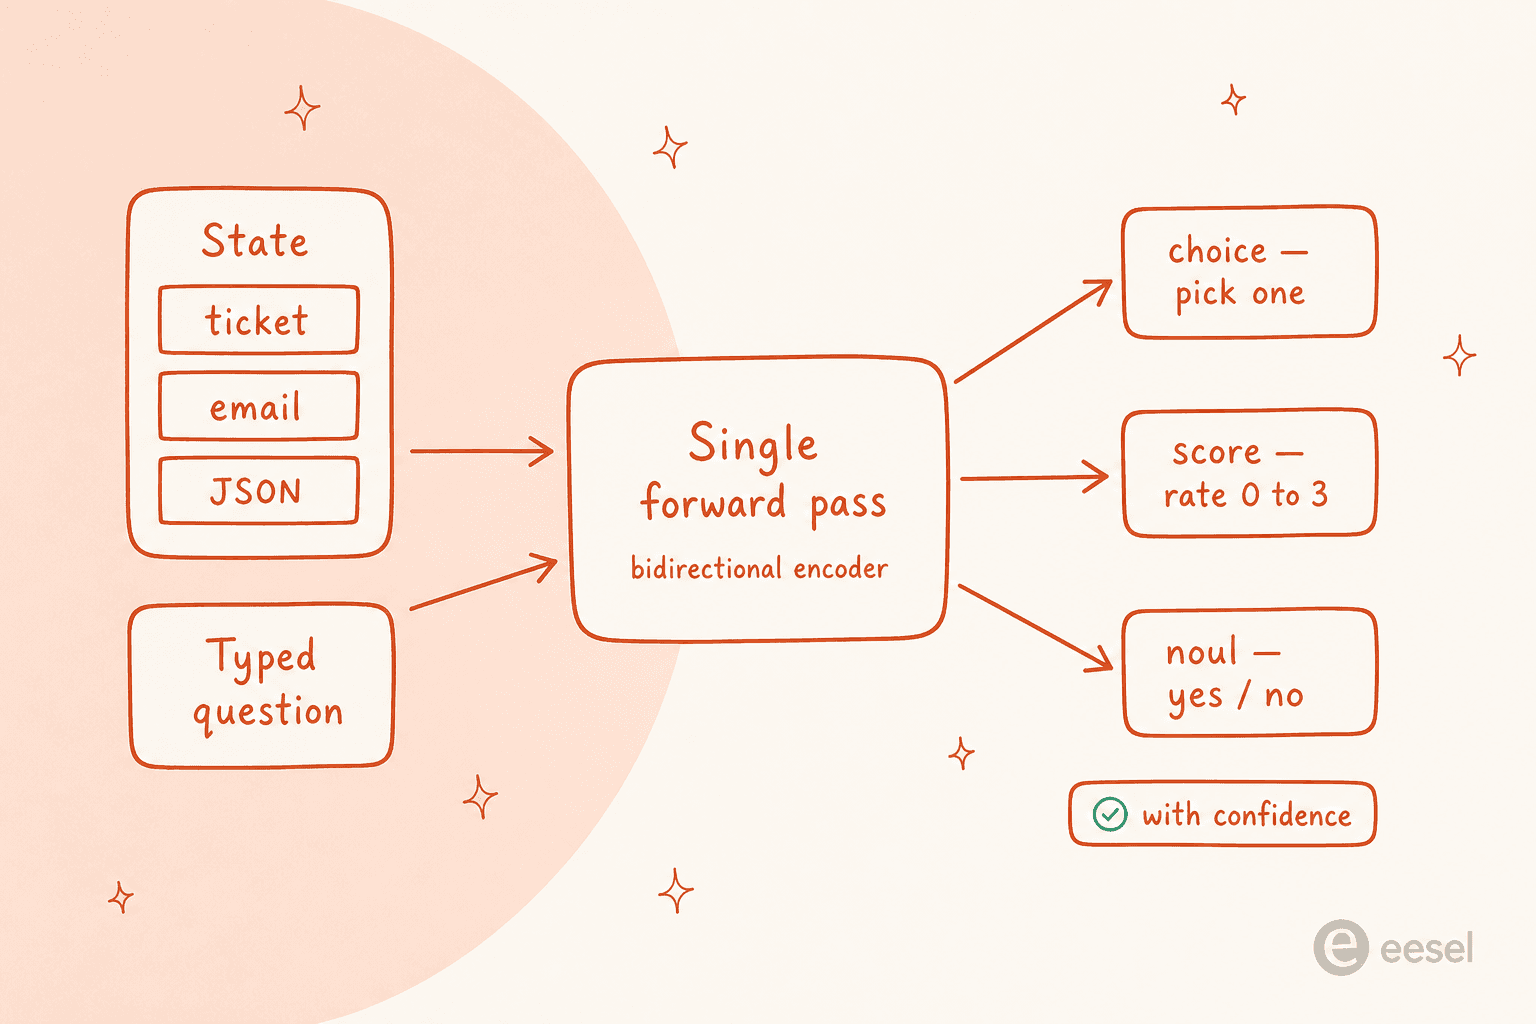
Le point malin est la façon dont il note les options. Chaque option est empaquetée avec son propre token [MASK], et le modèle lit l'état caché à ce marqueur pour produire un logit, puis applique un softmax sur les options de la question. Comme l'espace de réponses est défini au moment de la requête, les nouveaux schémas n'exigent aucun réentraînement, il suffit de passer d'autres options. Le checkpoint anglais est ModernBERT-large à 421M de paramètres, avec une petite tête de décision entraînée par-dessus.
Vient ensuite l'entraînement, d'où provient la calibration. Laya est entraîné avec ce que Convai appelle RLCD, de l'apprentissage par renforcement face à des règles de notation strictement propres. En bref : l'entraînement naïf apprend à un modèle à être trop sûr de lui, parce que pousser la probabilité gagnante vers 1.0 maximise une simple récompense de précision. La phrase de Nandakishor à ce sujet est la plus tranchante de tout le texte :
"Naive RL maximizes accuracy by destroying calibration. It turns your model into a confidently wrong machine."
Le RLCD, lui, ne récompense le modèle que lorsque sa probabilité annoncée correspond à la réalité, de sorte que la confiance honnête est la voie gagnante. C'est un vrai choix de conception, vérifiable, pas un slogan, et c'est ce que je viendrais réellement chercher chez Laya.
Les trois checkpoints
« Laya » est en réalité une famille de trois checkpoints regroupés dans un même dépôt Hugging Face, et choisir le bon compte plus que ne le suggère le marketing.
| Checkpoint | Backbone | Paramètres | Meilleur pour |
|---|---|---|---|
convaiinnovations/laya | ModernBERT-large | 421M | Garde-fous en anglais, triage d'e-mails |
laya-multilingual | mmBERT-base | 322M | Plus de 100 langues, ~2,2 fois plus rapide |
laya-typed-decisions | ModernBERT-large | 421M | Les quatre workflows de décisions typées (0.766 de précision) |
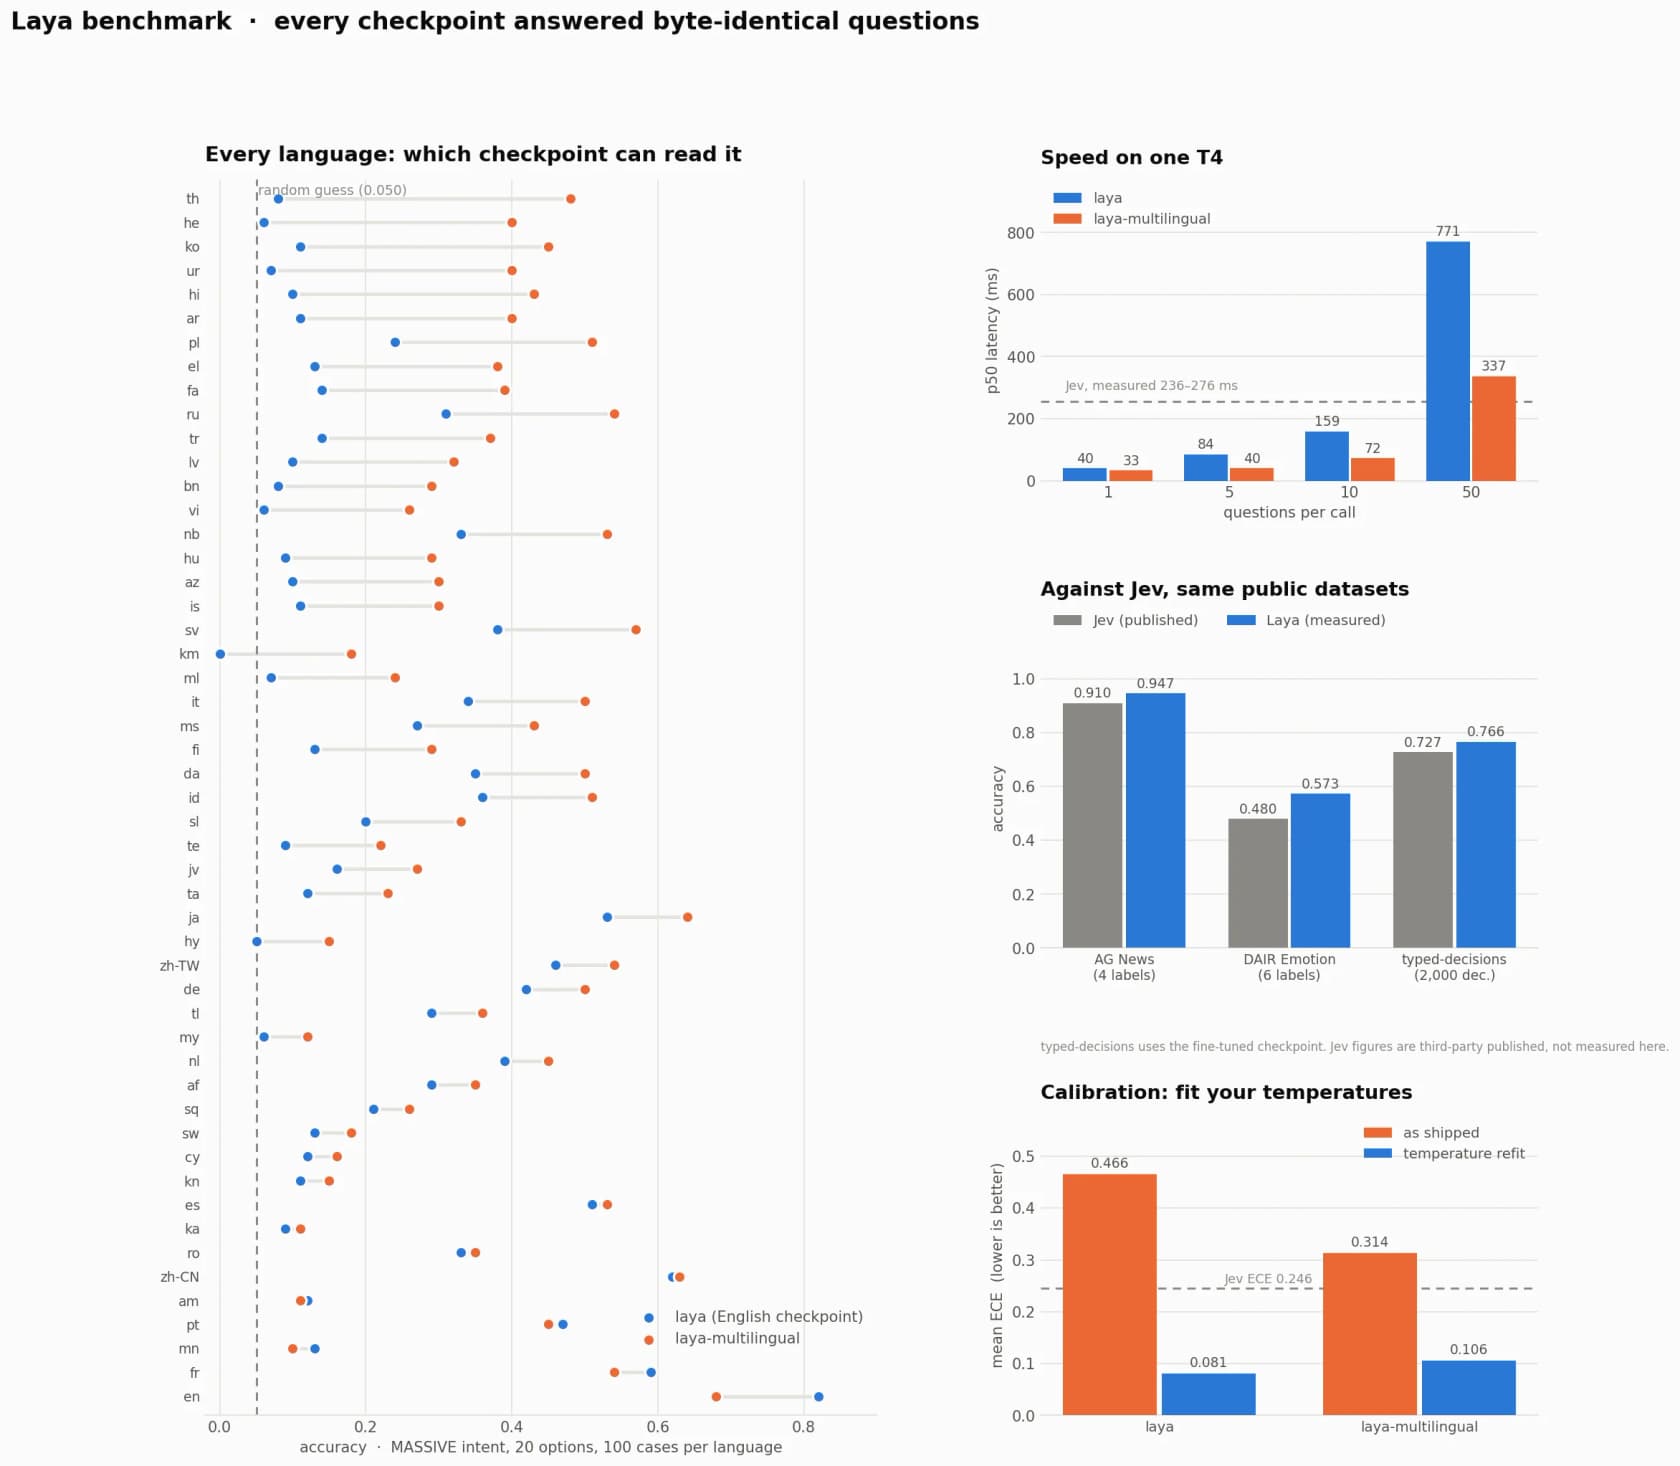
Le modèle racine anglais s'effondre hors des alphabets latins, et pas avec élégance. Sur le balayage de 51 langues, il a obtenu 0.000 de précision en khmer tout en annonçant 0.952 de confiance, exactement le piège du « sûr de lui et dans l'erreur » que le modèle est censé éviter. Le filtrage par confiance ne peut pas vous sauver ici, donc Laya fournit un Router intégré qui détecte l'écriture en moins d'une demi-milliseconde et choisit le checkpoint multilingue avant même que la passe avant ne s'exécute.
Les benchmarks, et la réserve que tout le monde a manquée
Voici la comparaison complète que le projet a publiée face à Jev. C'est beaucoup, mais l'essentiel est que Laya (avec routage) devance légèrement Jev sur les jeux de données publics communs, tout en étant bien plus rapide et mieux calibré.
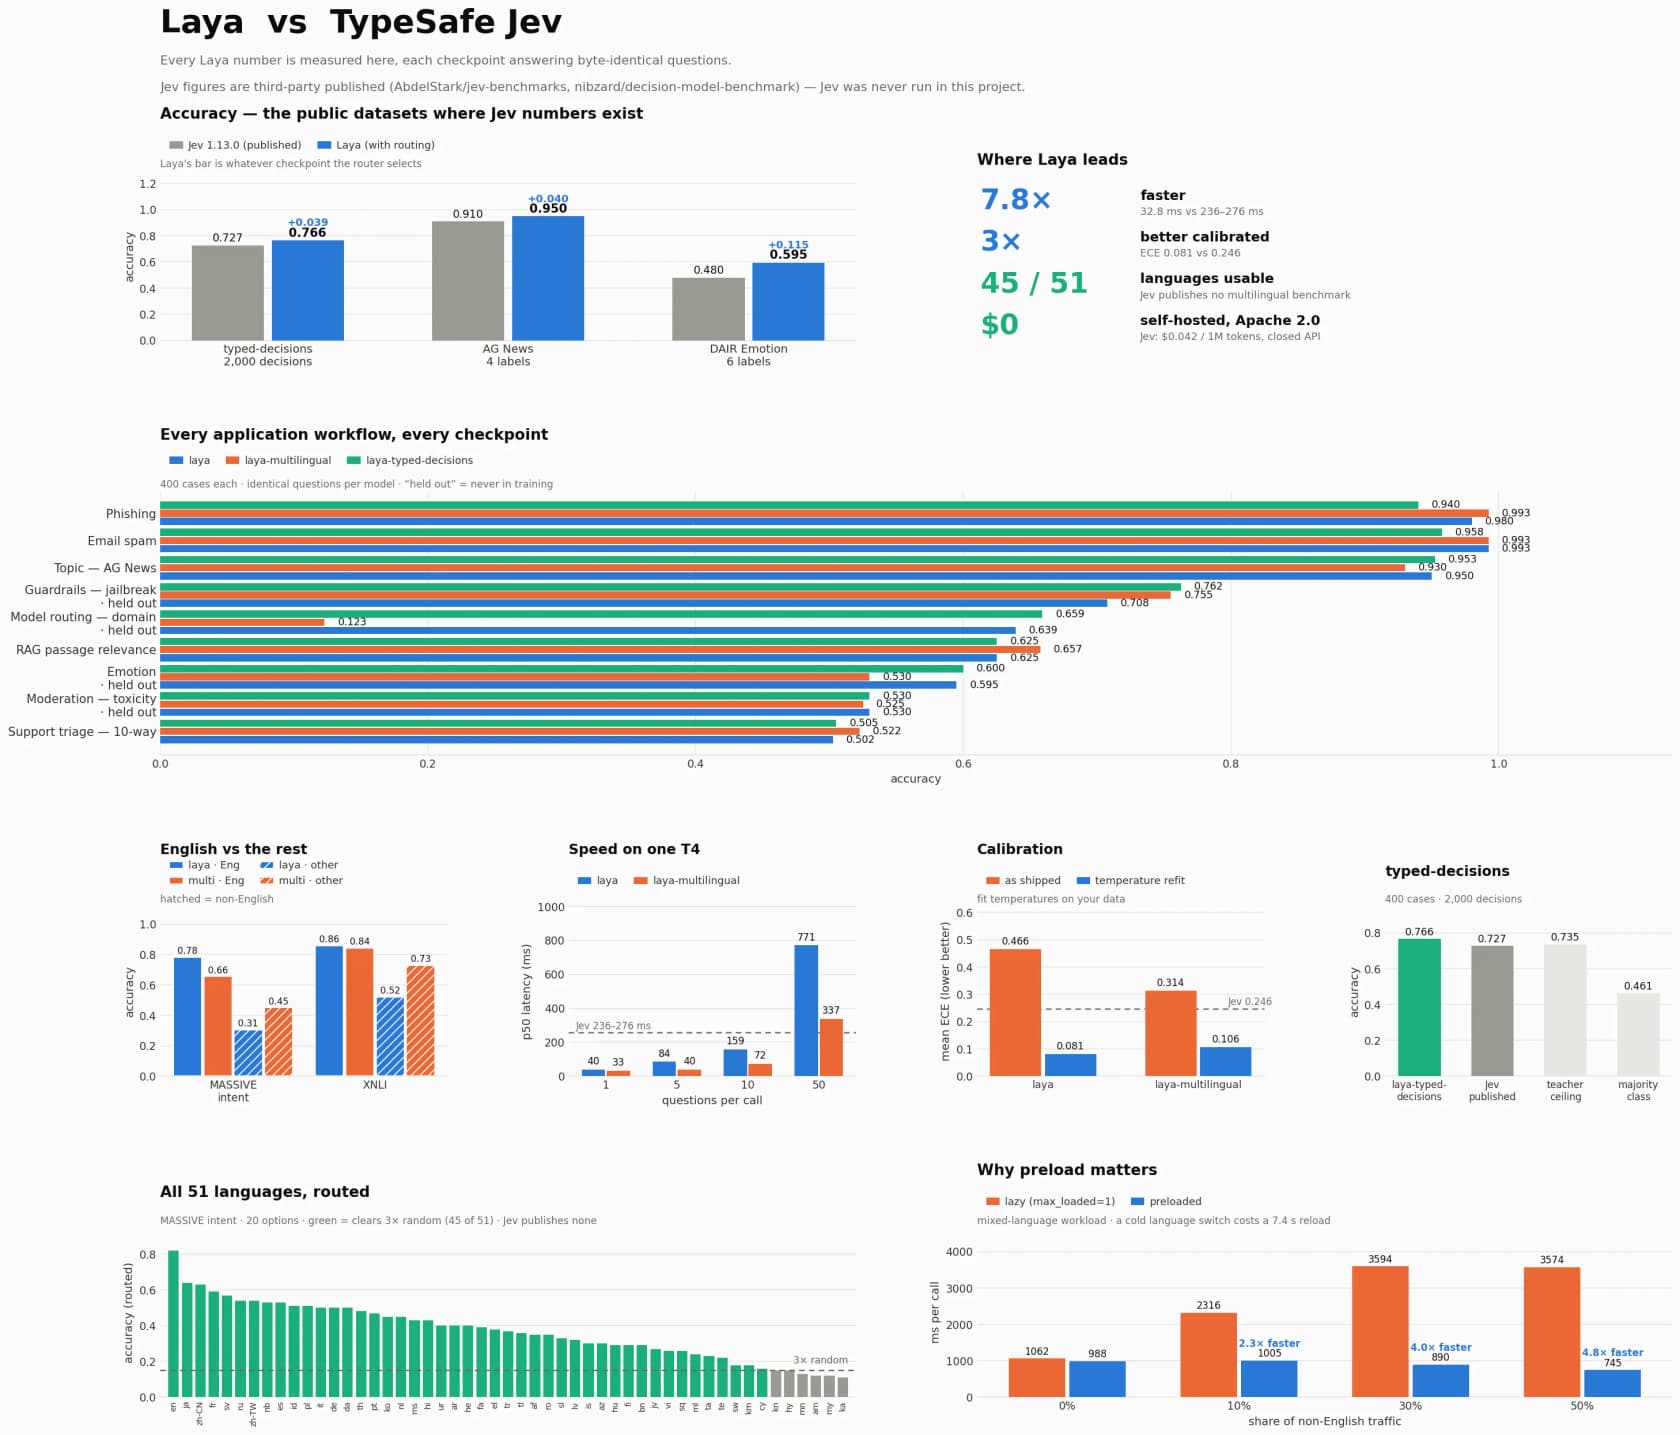
Les chiffres à retenir, tous mesurés sur un seul Tesla T4 (avec des chiffres de Jev publiés par des tiers, Convai n'ayant pas d'accès à l'API) :
- Latence : 32,8 ms p50 pour une question routée, contre 236 à 276 ms pour Jev. C'est le 7,8x.
- Calibration : ECE de 0.081 après réajustement de la température, contre 0.246 pour Jev, soit un score de calibration 3 fois meilleur.
- Précision : 0.766 sur le jeu typé de 2 000 décisions, contre 0.727 pour Jev, et il dépasse le plafond de l'enseignant de 0.735.
Et puis l'astérisque qui a dominé la discussion. Ce 0.766 est celui du checkpoint affiné. Les modèles de base, tels quels, obtiennent environ 0.362 sur le même benchmark, à peine au-dessus de la base aléatoire de 0.318. La section limites du projet le dit elle-même clairement : considérez Laya comme une base rapide à spécialiser, pas comme un oracle zero-shot. Sur Hacker News, où le lancement a dépassé 1 300 points, le principal commentaire critique était exactement celui-ci :
"This should be way up in the article. Fine tuning is a pain, requiring it for good results put Laya in a whole different category vs Jev"

C'est un coup légitime. Jev est vendu comme utilisable en zero-shot ; Laya, lu honnêtement, est une base que l'on spécialise. Les défenseurs avaient aussi une réponse valable : un modèle rapide, pilotable par prompt et calibré, que l'on peut affiner en un après-midi, reste un grand pas en avant par rapport à la gestion d'une flotte de classifieurs sur mesure.
À quoi vous l'utiliseriez vraiment
Sans le drame autour de Jev, Laya est un classifieur rapide avec une confiance honnête, donc il convient partout où vous payez actuellement trop cher un modèle génératif pour prendre une petite décision structurée. Le projet rapporte la précision réelle par workflow, et l'écart montre où il est fort :
- Filtrage du spam e-mail : 0.993
- Détection du phishing : 0.980
- Garde-fous LLM et détection de jailbreak : 0.755 à 0.762 (0.931 à 50 % de couverture sélective)
- Pertinence des passages en RAG : 0.657
- Routage de tickets de support, 10 classes : 0.522
Les décisions de sécurité binaires sont excellentes ; c'est dans la classification large et floue qu'il a besoin du fine-tuning. L'argument des praticiens en faveur d'un tel modèle a été bien formulé sur HN, et il correspond à ce que j'entends d'équipes noyées sous des règles de routage ponctuelles :
"The ability to knock out any arbitrary classification problem in minutes instead of in a week is a big deal... I don't want to spend a week to create a dataset, finetune a model, and set up infrastructure to run the model, every time I have a small routing or classification problem."
Il y a dans ce fil une vraie tension qu'il vaut la peine de nommer, car c'est la vraie décision d'achat. Certains développeurs veulent une solution prête à l'emploi qu'ils n'auront jamais à entraîner :
"I don't want to manage GPUs / CPUs now. I don't want to maintain my corpus and retrain as my product's data distribution shifts... I just want a reasonably good general classifier served to me with a great devex and calibrated confidence scores to help me figure out when to fallback."
C'est la limite honnête de Laya pour beaucoup d'équipes : c'est une excellente brique si vous êtes prêt à l'exécuter et à le spécialiser, et moins adapté si vous vouliez quelque chose qui marche tout de suite.
Vitesse, langues et coût
Là où Laya est sans conteste fort, c'est dans l'opérationnel ennuyeux. Il fonctionne dans 45 des 51 langues au-dessus de 3 fois le hasard avec le routage, contre zéro chiffre multilingue publié par Jev.
Côté coût, il est sous Apache 2.0 et auto-hébergé, soit $0.00 par million de tokens contre $0.042 pour Jev, et il fonctionne en environnement isolé sur votre propre matériel, ce qui compte pour quiconque a des contraintes HIPAA ou RGPD. L'installation tient en une ligne, pip install laya, et Router(preload=True) garde tous les checkpoints résidents pour éviter un rechargement à froid de 7 à 10 secondes lors des changements de langue. Le dépôt GitHub dépasse les 9 000 étoiles, et il existe un Space de démo en ligne si vous voulez l'essayer avant d'écrire du code.
La seule réserve pour les problèmes à forte cardinalité : les questions choice se dégradent au-delà d'environ 20 options avec le budget de tokens par défaut. Sur Banking77 (77 étiquettes), Laya a obtenu 0.425 contre 0.870 pour Jev, car chaque option ne dispose que de 3 à 4 tokens pour se distinguer. La solution est d'augmenter le budget ou de découper en hiérarchie du grossier au fin, mais tel quel, un routeur à 10 classes est confortable et un à 77 ne l'est pas.
La polémique : qui l'a construit en premier
Impossible d'écrire sur Laya sans l'histoire de ses origines, car elle explique à moitié pourquoi le texte est devenu viral. Le récit de Nandakishor est une revendication d'antériorité : il dit avoir publié cette approche de décision non autorégressive, entraînée par RL, dans un article arXiv de mars 2025 et un suivi de septembre 2025, une année entière avant que TypeSafe ne lance Jev en fanfare.
"It is incredibly frustrating when something you poured your heart into for months as an open-source researcher gets overlooked because it was built for a vertical use case, while a funded lab packages the same core idea horizontally and gets all the glory."
La communauté s'est divisée, à juste titre. Certains ont fait remarquer qu'une marque claire et une API utilisable sont elles-mêmes le produit, et que son travail précédent était commercialisé comme un outil de niche de « conversion commerciale » que personne n'a lu. D'autres se sont montrés compréhensifs, et plusieurs étaient contents que la version ouverte existe, tout en levant les yeux au ciel devant le battage du lancement des deux modèles :
"I had used versions of bert to achieve the same functionality years ago. But to me it seems like they were able to trick the VCs with 'can't hallucinate' etc. To the above author, kudos for sharing your work and making it open."
Mon avis : l'argument de l'antériorité détourne l'attention d'une belle sortie. Que Laya ait été le premier ou non, il est ouvert, rapide, honnêtement documenté, et il fonctionne bien pour les tâches sur lesquelles il est honnête. Cela vaut plus que la bataille pour le crédit.
Où se place un modèle de décision face à un coéquipier IA
Voici la partie qui m'importe le plus, car c'est mon métier. Un modèle de décision et un coéquipier IA ne sont pas concurrents. Ils vivent sur des couches différentes.
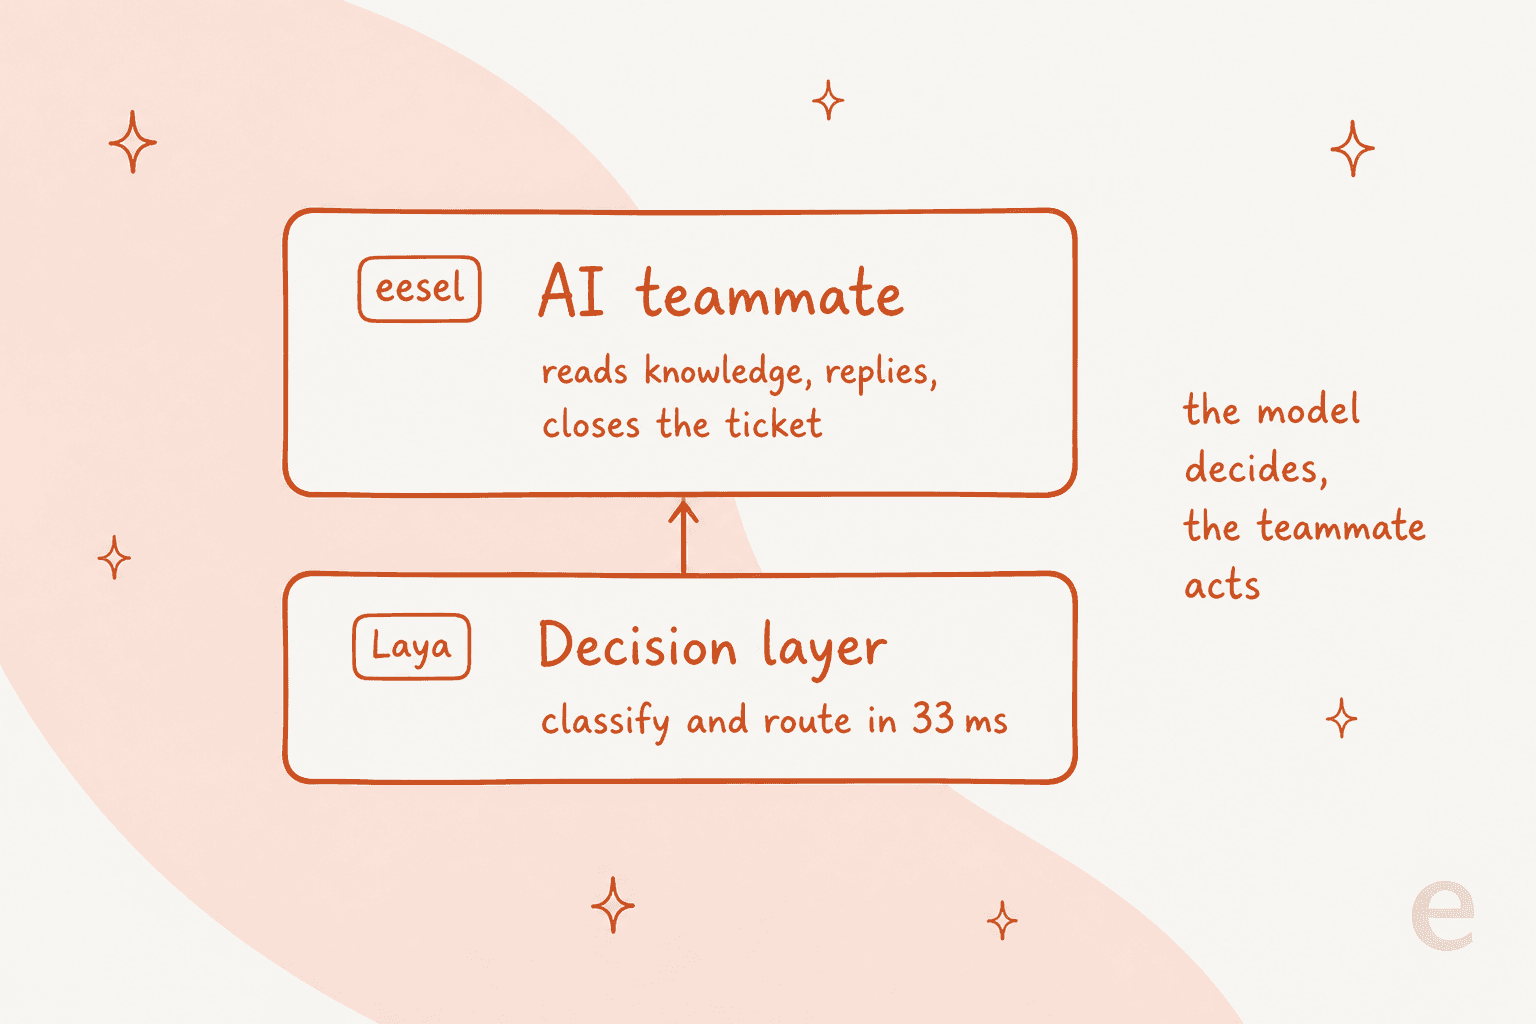
Laya est de l'infrastructure. Il répond à « dans quelle file ce ticket doit-il aller ? » ou « est-ce urgent ? » en 33 ms, et il fait cette seule chose à merveille. Mais il ne lit pas votre centre d'aide, ne rédige pas la réponse, ne vérifie pas le statut de la commande et ne clôt pas la conversation. Ce sont les vrais travaux qu'une équipe de support doit voir accomplis, et ils exigent un modèle qui agit, pas seulement qui classe.
C'est la différence entre un composant et un employé. eesel est une plateforme de coéquipiers IA, et le coéquipier IA pour le helpdesk est celui engagé pour le support : il rejoint votre file existante dans Zendesk, Freshdesk ou là où vous travaillez déjà, lit vos anciens tickets et vos documents, et résout le ticket de bout en bout. Sous le capot, il prend le même genre de décisions rapides et calibrées de routage et de confiance que Laya fait bien, mais il les enveloppe dans la lecture, la rédaction et l'action qui transforment une classification en conversation résolue. Si vous êtes développeur et voulez scripter ou automatiser ce coéquipier directement, la CLI eesel et le serveur MCP permettent à une personne, à un script ou à un agent de code comme Claude Code de piloter le même espace de travail que celui du tableau de bord.
Essayer eesel
Si vous vous intéressez à Laya parce que vous voulez des décisions de support plus intelligentes et plus rapides, il vaut la peine d'être clair sur ce que vous achetez. Un modèle de décision vous donne un composant pour construire. Un coéquipier IA pour le support vous donne le travailleur fini.

Si je crois à l'argument de calibration de Laya, c'est parce que j'ai vécu l'alternative. Nous avons vu des bots à l'air sûr d'eux donner discrètement de mauvaises réponses sur des files réelles, et c'est pourquoi chaque déploiement d'eesel commence par une simulation sur vos propres tickets historiques, pour que vous voyiez le taux de résolution exact et les réponses exactes avant qu'un seul client ne soit touché. La tarification est un prix mensuel fixe, à partir de $299/mois pour 500 crédits (1 crédit par ticket ou chat), sans frais par utilisateur, et il existe un plan gratuit avec 100 crédits. Si vous voulez que la décision soit exécutée et pas seulement étiquetée, c'est la couche à regarder.
Ce que je dirais à un ami
Laya est une vraie contribution, et je suis content qu'il soit ouvert. Si vous êtes développeur avec des problèmes de classification ou de routage et l'envie de faire du fine-tuning, c'est l'un des outils nouveaux les plus intéressants de l'année : rapide, calibré, multilingue et gratuit. Allez lire la fiche du modèle, elle est d'une honnêteté rafraîchissante sur ses propres limites.
Mais lisez cette section sur les limites avant de construire dessus. Les résultats zero-shot sont proches du hasard, la confiance doit être réajustée sur vos données et la classification large demande un fine-tuning. Considérez-le comme l'excellente base qu'il prétend être, et si ce dont vous avez vraiment besoin, c'est que tout le travail de support soit fait plutôt qu'une simple décision renvoyée, tournez-vous vers un coéquipier, pas vers un composant.
Questions fréquentes
Qu'est-ce que Laya AI ?
Laya AI est un modèle de décision open source de 421M de paramètres, créé par Convai Innovations. Au lieu de générer du texte comme un chatbot, il prend un état (un ticket, un e-mail ou du JSON) plus des questions typées, et renvoie des réponses typées avec des probabilités calibrées en une seule passe avant d'environ 33 ms. Il est publié sous Apache 2.0 et présenté comme la réponse ouverte à Jev, le modèle fermé de TypeSafe AI.
Combien coûte Laya AI ?
Laya est gratuit. Les poids sont sous Apache 2.0 sur Hugging Face, donc l'auto-hébergement coûte $0.00 par million de tokens, contre $0.042 par million de tokens facturés par l'API fermée de Jev. Votre seul coût est le GPU ou le CPU sur lequel vous le faites tourner. Si vous préférez ne faire tourner aucun modèle, un coéquipier IA pour le helpdesk s'occupe de la classification et de la réponse à votre place.
Laya AI convient-il au routage de tickets ?
C'est une base solide pour cela. Sur un benchmark de triage de support à 10 classes, le modèle de base obtient 0.522 et le checkpoint affiné dépasse le plafond du modèle enseignant sur le jeu de décisions typées, et chaque réponse est accompagnée d'un score de confiance calibré pour déclencher un repli. Consultez notre comparatif des outils d'IA de triage de tickets pour voir comment cela s'insère dans une vraie stack de support.
Laya AI ne peut-il vraiment pas halluciner ?
Dans son espace de sortie, oui. Laya n'émet jamais de tokens de texte ; il renvoie uniquement des probabilités sur un ensemble fixe d'options que vous définissez, donc une réponse malformée ou une catégorie inventée est impossible par construction. Il peut tout de même se tromper, et c'est pourquoi le score de confiance calibré compte plus que le slogan marketing.
Dois-je affiner Laya AI ?
Pour une précision sérieuse, en général oui. Tels quels, les checkpoints de base obtiennent un score proche du hasard (~0.362) sur le benchmark de décisions typées ; le 0.766 mis en avant vient du fine-tuning sur cette tâche. Considérez Laya comme une base rapide à spécialiser, pas comme un oracle zero-shot, et réajustez sa température sur vos propres données avant de vous fier aux scores de confiance.