Un modèle sorti avant son propre communiqué
La plupart des lancements de modèles, c'est un article de blog, un graphique de benchmarks et une fiche de modèle, tout en même temps. M3.1 Flash a fait l'inverse. Il est apparu dans le sélecteur de modèles de MiniMax Code, à côté de M3 et M2.7, et la communauté l'y a trouvé avant que MiniMax ne dise un mot. Le développeur qui a lancé l'info a tout de suite remarqué le nouveau menu de raisonnement :
"🚨重磅!MiniMax M3.1-Flash 预览版疑似已上线 MiniMax Code!推理等级单独成菜单:low / medium / high / xhigh / max。目前还没有官方公告,属于先露在产品里的灰度上线。" (Traduction : « Grosse nouvelle ! La preview de MiniMax M3.1-Flash semble être en ligne dans MiniMax Code. Les niveaux de raisonnement ont leur propre menu : low / medium / high / xhigh / max. Pas encore d'annonce officielle, c'est un déploiement gris/progressif montré d'abord dans le produit. »)
Le déploiement a aussi été accueilli avec un petit soupir. MiniMax enchaîne les modèles vidéo et musique à vive allure, la série M (texte) s'était tue, et la réponse la plus likée sous le post de lancement se lisait comme de l'impatience affectueuse :
"You finally remembered the M series"
Le buzz a aussi son histoire. Pendant des jours, des développeurs ont martelé un modèle furtif gratuit appelé « Space Bunny » en cherchant à deviner ce que c'était, et la réponse est tombée quelques jours avant le lancement :
"Confirmed, Space Bunny Alpha is Minimax M3.1"
L'enthousiasme est donc réel, mais le « lancement » est une preview progressive, d'abord dans le produit. Si vous décidez de construire dessus, cette distinction compte plus que le buzz : une preview en déploiement gris, sans tarif et sans poids, n'est pas le même engagement qu'un modèle en disponibilité générale.
Ce qu'est réellement MiniMax M3.1 Flash
Une fois le théâtre du lancement mis de côté, la documentation de la plateforme est claire sur le fond. Dans le tableau des modèles pris en charge, M3.1 Flash est décrit comme un « frontier multimodal coding model with 1M context window and tunable thinking depth », conçu pour le raisonnement agentique, l'usage d'outils, le code et l'exécution de tâches structurées. Il accepte texte, images et vidéo en entrée.
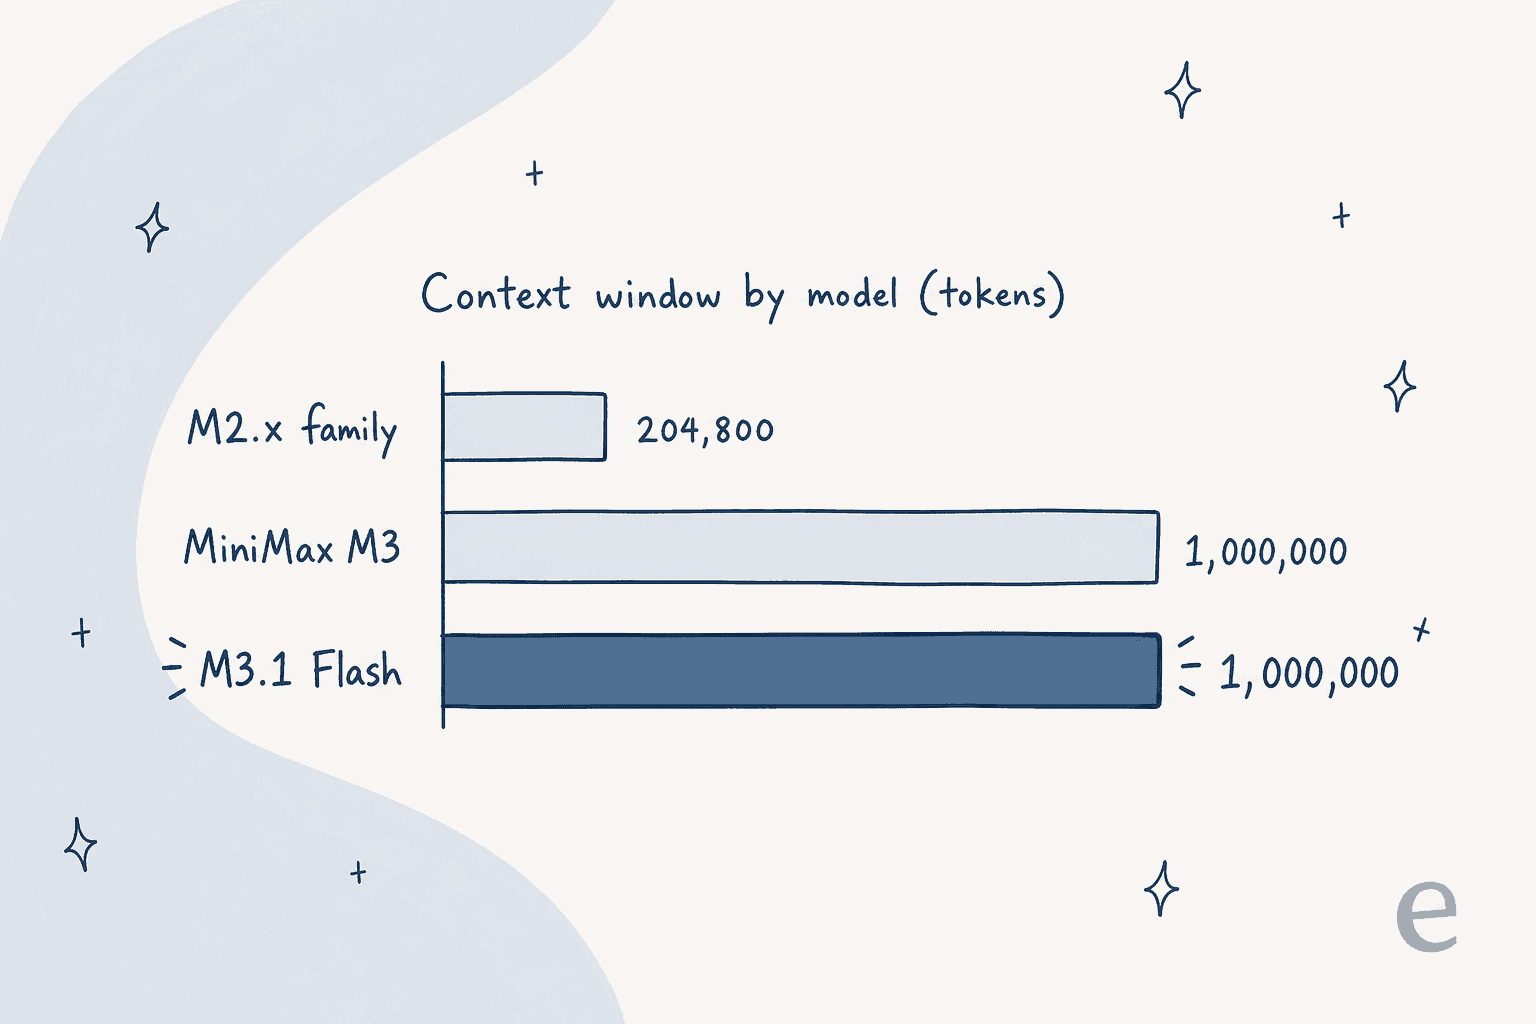
Le contexte de 1M est la spec phare, et c'est un vrai saut au sein de la série M, pas un arrondi marketing. Toute la famille M2 plafonnait à 204 800 tokens ; la génération M3, M3.1 Flash compris, fait un bond net d'un facteur cinq.
Voici ce que la documentation garantit, et ce qu'elle ne garantit pas :
| Attribut | MiniMax M3.1 Flash |
|---|---|
| Id du modèle | MiniMax-M3.1-Flash-Preview |
| Fenêtre de contexte | 1 000 000 de tokens |
| Modalités d'entrée | Texte, image, vidéo |
| Réflexion | Activée par défaut, réglable via effort, impossible à désactiver |
| Disponibilité | Token Plan + MiniMax Code uniquement |
| Poids ouverts | Aucun (pas de fiche Hugging Face) |
| Nombre de paramètres | Non indiqué |
| Débit (tps) | Non indiqué |
| Tarif par token | Non publié |
Ce tableau est volontairement honnête sur les blancs. Il n'y a pas de nombre de paramètres indiqué, pas de chiffre officiel de tokens par seconde, et pas de suite de benchmarks spécifique à M3.1 Flash. Si une page vous dit que le modèle fait « 428B paramètres » ou cite un score de benchmark, elle l'emprunte au M3 parent, elle ne cite pas M3.1 Flash. Je préfère signaler le trou plutôt que de le masquer.
Le curseur qui le définit : effort
La seule fonction que la documentation met en avant pour M3.1 Flash et pas pour M3 est la profondeur de réflexion réglable. Le modèle raisonne toujours avant de répondre, et vous contrôlez l'intensité avec un paramètre effort qui accepte low, medium, high, xhigh et max. Si vous l'omettez, la valeur par défaut est max.
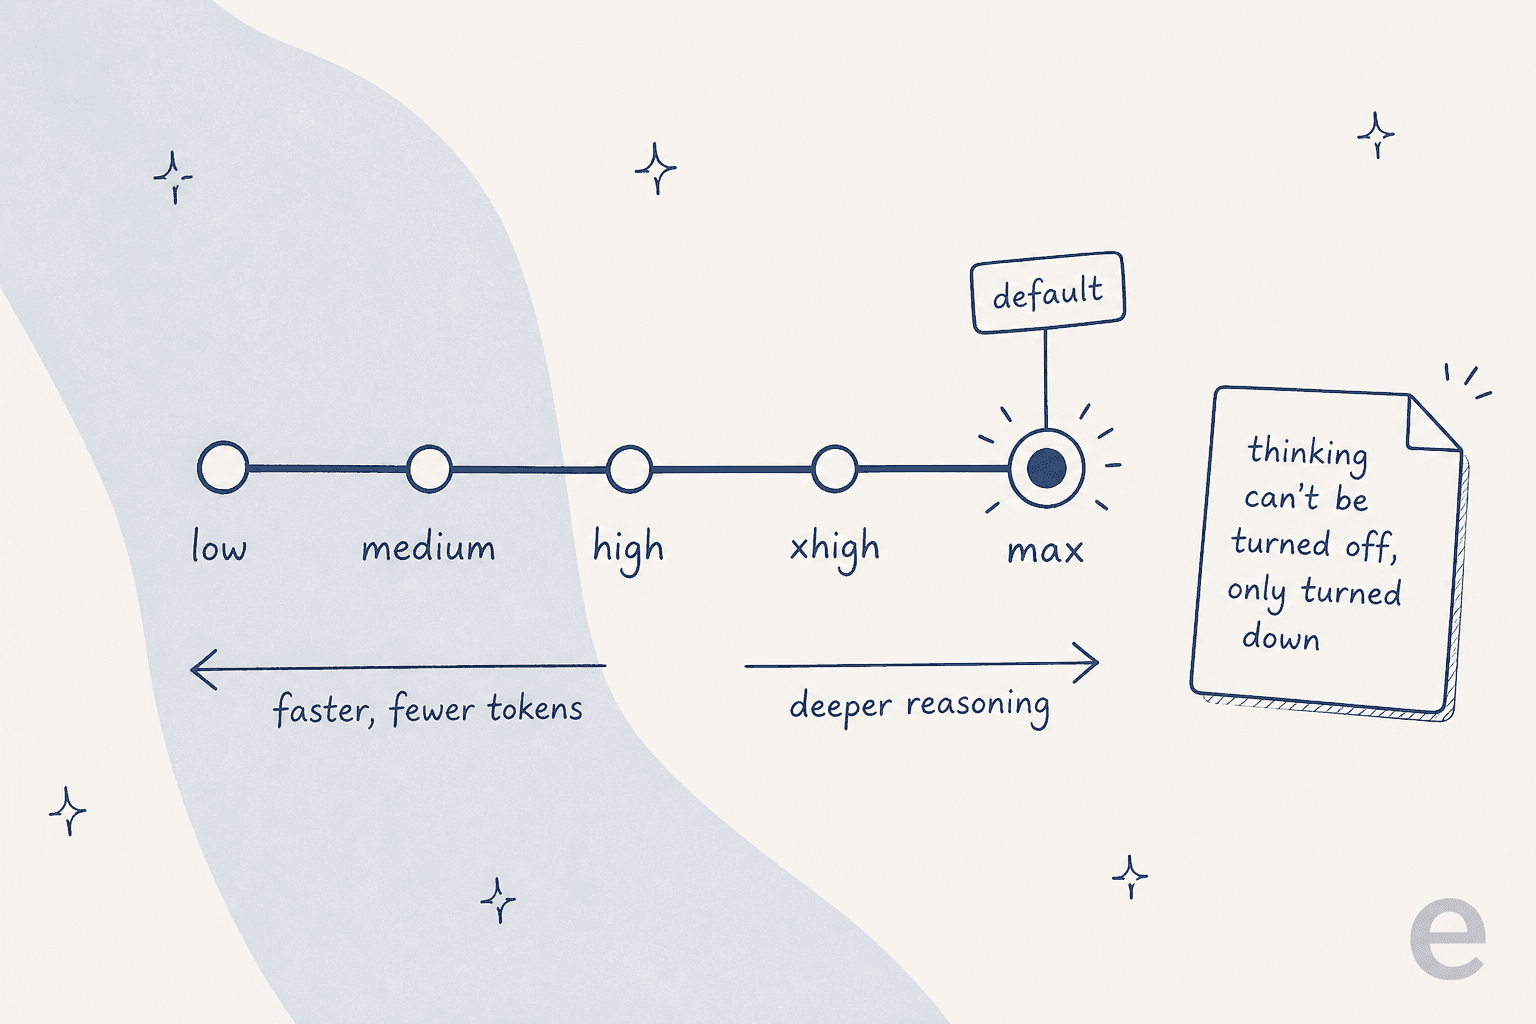
Le détail qui piège : vous ne pouvez pas désactiver la réflexion. Envoyez thinking: {"type": "disabled"} ou effort: "none" et l'API renvoie un 400 avec le message requires adaptive thinking (docs). Pour une latence plus basse ou moins de tokens en sortie, vous descendez effort à low ; il n'y a pas de mode sans réflexion. C'est un vrai parti pris de conception, à connaître avant de le brancher sur un chemin sensible à la latence. Pour un modèle « Flash », défaut à max est un choix un peu surprenant : le comportement rapide et économique qu'on attend du nom, il faut l'activer soi-même.
Est-il vraiment rapide ?
MiniMax n'a pas publié de chiffre de débit : les seules données de vitesse réelles viennent donc de développeurs qui l'ont testé dès le premier jour. La mesure la plus citée place la vitesse de décodage dans une fourchette solide mais pas leader de sa catégorie :
"MiniMax-M3.1-flash-preview is hanging around 90 - 110 t/s range for decode. It's fast, love seeing it, def faster than MiMo-v2.6-flash but not as fast as deepseek-v4.1-flash"
C'est le positionnement honnête : rapide, devant certains concurrents de la catégorie flash, derrière d'autres. Et tout le monde n'est pas convaincu que la vitesse de décodage brute soit ce qu'il faut célébrer :
"Decode speed is not equivalent to fast. The model is slow for the quality in my opinion, numbers dropping soon!"
Je pense que ce sceptique a un point à retenir. Un modèle qui utilise max d'effort par défaut et ne peut pas cesser de réfléchir paraîtra plus lent sur des tâches réelles qu'un chiffre de tokens par seconde ne le suggère, car il génère beaucoup de tokens de raisonnement avant la réponse. La bonne question n'est pas « combien de tokens par seconde », mais « combien de temps avant d'obtenir une réponse correcte que je peux livrer », et ce benchmark, personne ne l'a encore lancé sur M3.1 Flash.
L'architecture en dessous
La documentation ne répète pas les détails internes de M3.1 Flash ; le plus honnête est donc de traiter l'architecture comme héritée de la génération M3 plutôt que comme une spec confirmée de M3.1 Flash. La lignée M3 a introduit MiniMax Sparse Attention (MSA), un design d'attention clairsemée qui rend un contexte d'un million de tokens praticable au lieu de ruineusement lent.
La comparaison de MiniMax avec l'attention standard à requêtes groupées (GQA) illustre le mieux pourquoi l'attention clairsemée compte à cette longueur de contexte :
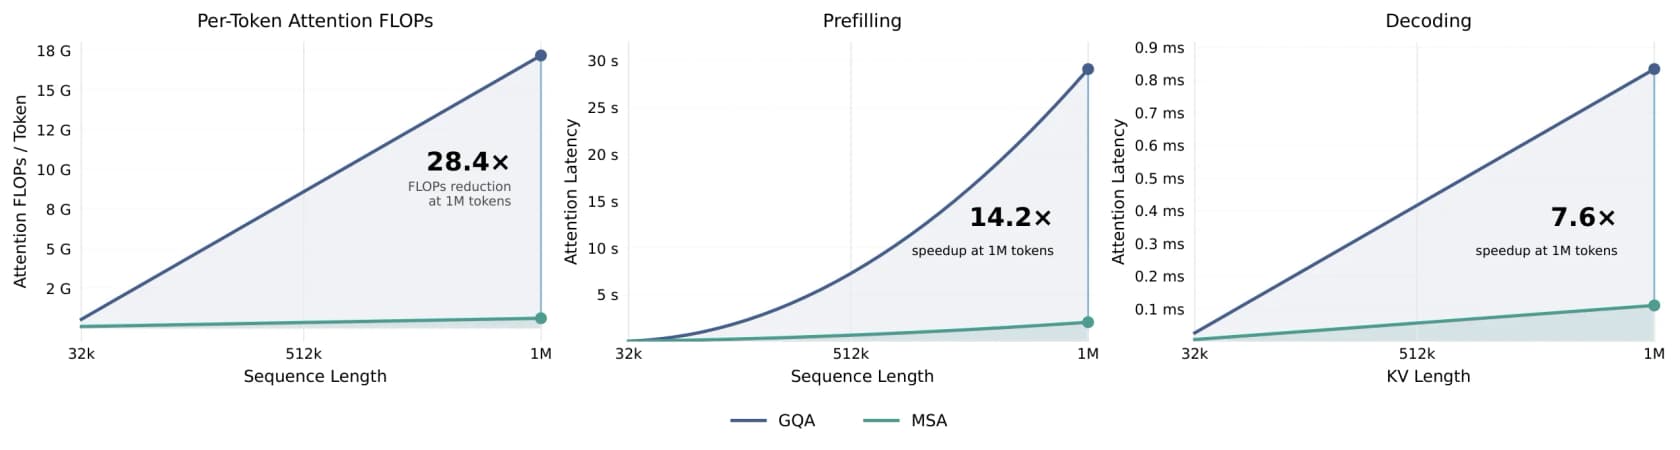
À un million de tokens, le graphique de MiniMax montre que MSA réduit le calcul d'attention par token d'environ 28 fois et accélère le décodage d'~7,6 fois par rapport à l'attention standard. Ce sont des chiffres de la génération M3 ; comme M3.1 Flash a la même fenêtre de 1M, il s'appuie presque certainement sur la même architecture, mais je m'abstiendrais de les citer comme spec mesurée de M3.1 Flash tant que MiniMax n'en publie pas.
Ce que ça coûte
C'est là que M3.1 Flash devient vraiment atypique : il n'y a aucun tarif par token nulle part. Il n'est pas dans la grille de paiement à l'usage, et la documentation de MiniMax indique qu'il est disponible pour l'instant uniquement via le Token Plan et MiniMax Code. Son coût réel, c'est donc votre abonnement divisé par votre usage.
Voici le Token Plan, un quota partagé entre texte, image et voix :
| Plan | Mensuel | Annuel (2 mois offerts) | ~Tokens M3 / mois | Génération vidéo |
|---|---|---|---|---|
| Plus | 20 $ | 220 $ | ~1,7 Md | Aucune |
| Max | 50 $ | 550 $ | ~5,1 Md | 3 clips/jour |
| Ultra | 120 $ | 1 320 $ | ~12,5 Md | 5 clips/jour |
Il existe aussi une option de Credits prépayés (5 $ pour 5 000, 25 $ pour 25 000, 100 $ pour 100 000, valables un an) et aucun palier LLM gratuit. Le quota se réinitialise sur des fenêtres glissantes de 5 heures et hebdomadaires, et le quota mensuel non utilisé ne se reporte pas.
Pour avoir une idée de ce qu'une API publique pourrait facturer un jour, son cousin à 1M de contexte MiniMax M3 est en paiement à l'usage. Ce sont les tarifs de M3, pas de M3.1 Flash, mais la structure préfigure probablement ce qui vient :
| MiniMax M3 (palier standard) | Entrée | Sortie | Lecture du cache |
|---|---|---|---|
| ≤ 512K en entrée | 0,30 $ /M | 1,20 $ /M | 0,06 $ /M |
| > 512K en entrée | 0,60 $ /M | 2,40 $ /M | 0,12 $ /M |
Deux points structurels à noter pour plus tard : un seuil à 512K en entrée qui double le tarif au-delà, et un palier de service Priority à 1,5x le tarif standard. Bon marché pour sa catégorie, donc, mais avec un supplément long contexte intégré.
Comment l'utiliser concrètement
Pour une preview, l'accès est étonnamment favorable aux développeurs. M3.1 Flash parle deux protocoles : un endpoint compatible Anthropic sur https://api.minimax.io/anthropic (la voie recommandée par MiniMax, avec blocs de thinking) et un endpoint compatible OpenAI sur https://api.minimax.io/v1. Le champ effort se trouve simplement à un endroit différent selon celui que vous utilisez : output_config.effort sur l'API Anthropic, reasoning_effort sur celle d'OpenAI.
Comme il est compatible Anthropic et OpenAI, vous pouvez pointer directement vos outils de code agentiques existants dessus. MiniMax cite Claude Code, Cursor, Codex CLI et d'autres comme pris en charge via le Token Plan, sans clé d'API séparée. C'est le vrai cas d'usage visé par la combinaison « Flash + preview » : un modèle par défaut rapide et économique pour le code du quotidien et les boucles d'agents, dans les outils où les développeurs vivent déjà.
Où un tel modèle s'insère
Ce qui me ramène au cadrage du début. M3.1 Flash est un moteur rapide avec une grande fenêtre de contexte et un curseur de réflexion. C'est de l'infrastructure. C'est la capacité brute, exposée en endpoint, et elle est vraiment bonne dans ce qu'elle fait. Mais un endpoint ne connaît pas votre entreprise, ne siège pas dans votre helpdesk et ne prend pas en charge un travail de bout en bout. Tout cela, il reste à le construire autour.
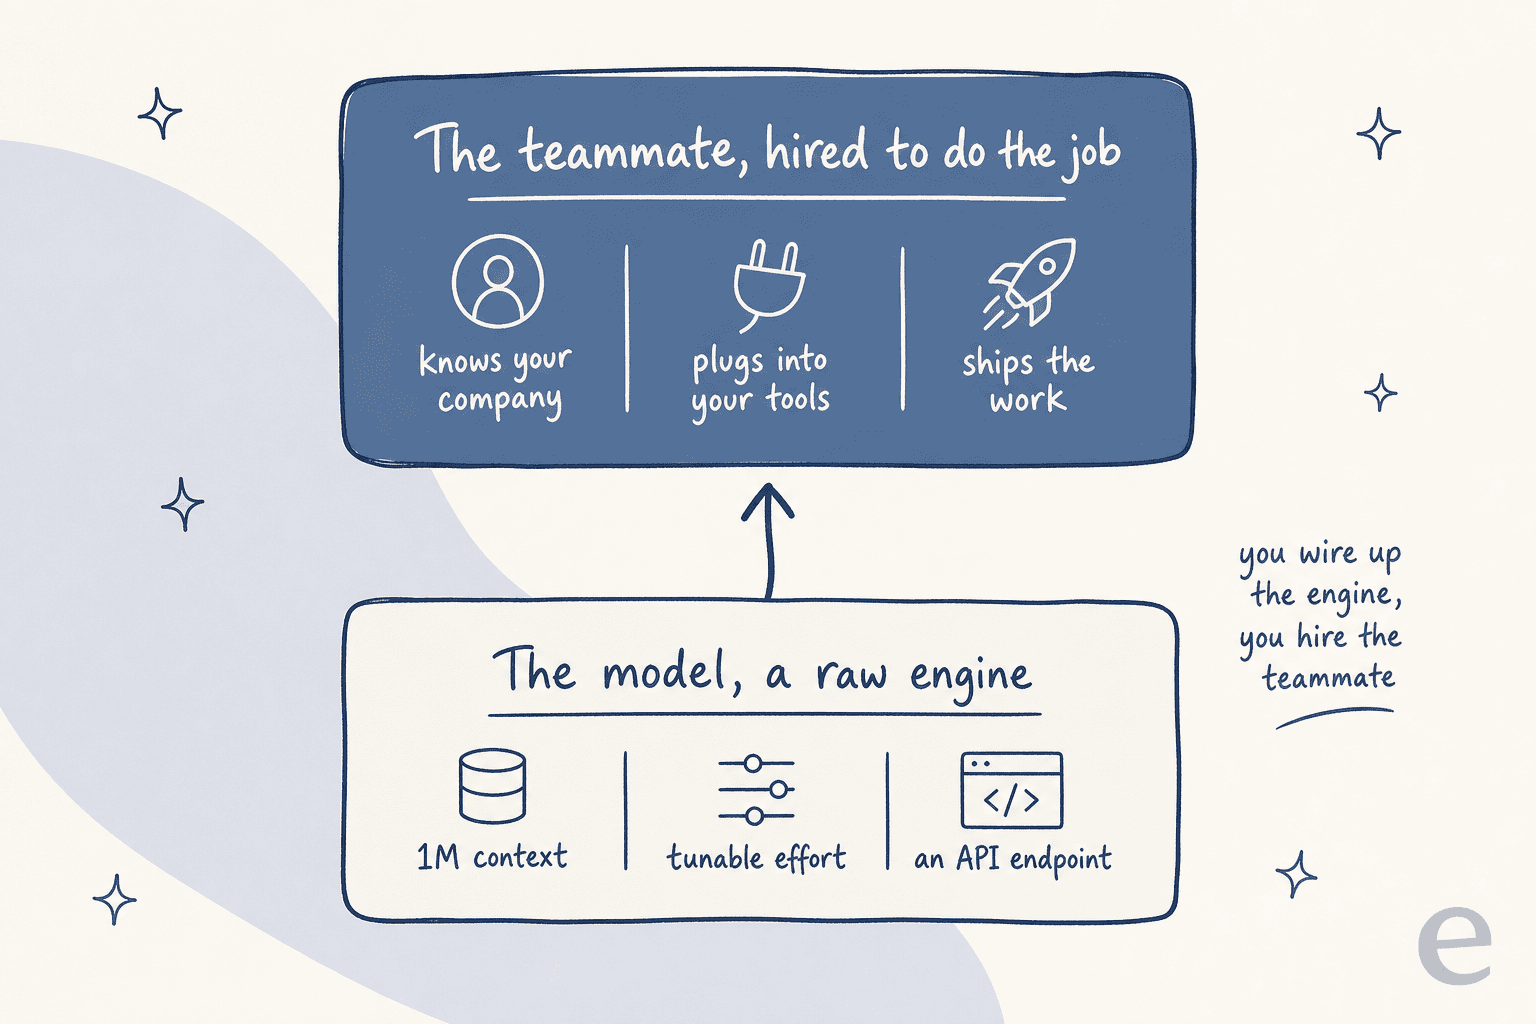
Cet écart entre « un modèle capable » et « du travail réellement accompli » est toute la raison d'être d'eesel. eesel est une plateforme de coéquipiers IA : au lieu de vous donner un modèle et un éditeur vide, vous embauchez un coéquipier prêt à travailler pour une mission précise. L'équipe actuelle comprend un coéquipier IA pour helpdesk qui rejoint votre file de support existante, et un rédacteur de blog IA qui fait la recherche et rédige des articles dans votre voix. Chacun arrive sachant déjà faire son rôle et se branche sur les outils que vous utilisez déjà.
Si vous vivez dans un terminal, la CLI eesel est la partie qui vous sera la plus familière après la lecture d'une page de docs comme celle de MiniMax. C'est le même coéquipier que dans le tableau de bord, piloté en ligne de commande : vous pouvez connecter un helpdesk, importer des connaissances, câbler des automatisations et approuver des actions en attente sans jamais ouvrir l'interface. Chaque commande affiche du JSON, et les erreurs reviennent sous forme d'objets structurés {error, hint, retryable}, de sorte qu'un agent de code comme Claude Code, Cursor ou Codex peut piloter toute la configuration en lisant le champ hint et en décidant quoi lancer ensuite. Chaque workspace fait aussi office de serveur MCP : le même agent qui appelle M3.1 Flash peut appeler eesel. Le modèle mental est simple : le modèle est le moteur que vous branchez ; le coéquipier est celui que vous embauchez.
Essayer eesel
Si M3.1 Flash vous enthousiasme parce que vous voulez une IA qui fait du vrai travail, pas seulement qui répond à des appels d'API, ce dernier kilomètre est ce que gère eesel. Pointez-le sur vos anciens tickets et votre centre d'aide, et le coéquipier IA pour helpdesk commence à rédiger de vraies réponses en quelques minutes ; ou donnez un sujet au rédacteur de blog IA et il fait la recherche, rédige et illustre un article complet dans votre voix, exactement comme celui-ci a été réalisé.
Le meilleur, c'est que vous pouvez le voir travailler avant de vous engager : eesel tourne d'abord sur votre propre historique, vous voyez donc la qualité sur vos vrais tickets, pas sur une démo. C'est gratuit pour démarrer, sans carte bancaire, pour voir par vous-même la différence entre louer un modèle et embaucher un coéquipier.
Questions fréquentes
Qu'est-ce que MiniMax M3.1 Flash ?
MiniMax-M3.1-Flash-Preview) est le dernier modèle de la série M de MiniMax : un modèle de code multimodal avec une fenêtre de contexte de 1 000 000 de tokens et une profondeur de réflexion réglable. Il est sorti en preview dans MiniMax Code et le Token Plan le 27 septembre 2026, et vise le travail rapide du quotidien en code et en agents. Si vous voulez qu'un tel modèle fasse un vrai travail plutôt que de rester derrière une API, un coéquipier IA comme eesel est la couche qui le transforme en travail.Combien coûte MiniMax M3.1 Flash ?
MiniMax M3.1 Flash est-il open source ou sur Hugging Face ?
En quoi M3.1 Flash diffère-t-il de MiniMax M3 ?
Peut-on désactiver la réflexion dans MiniMax M3.1 Flash ?
effort: "none" ou thinking: disabled renvoie une erreur 400. Pour réduire la latence et la consommation de tokens, vous baissez le niveau de effort au lieu de couper la réflexion.

Article by
Rama Adi
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.