

Tencent Hunyuan Hy4 (la "Hy4 preview") es un modelo grande de pesos abiertos creado para hacer trabajo, no para chatear. Es un modelo Mixture-of-Experts de 770B parámetros con 49B activos por token, contexto de 1M de tokens y licencia Apache 2.0, lanzado el 28 de agosto de 2026 para programación, productividad de oficina, desarrollo de videojuegos e investigación científica.
En cifras: la prueba ciega de la propia Tencent lo sitúa un pelo por delante de Kimi K3 y GLM-5.3, pero en benchmarks públicos se reparte las victorias con ellos y normalmente queda por detrás de Claude Opus 5 y GPT-5.6. La lectura honesta es "más o menos a la par de los otros modelos insignia chinos", con dos ventajas reales: es el más barato de los modelos abiertos de gama insignia, a 0,834 $ de entrada / 2,501 $ de salida por millón de tokens, y los pesos son realmente abiertos.
El inconveniente que domina toda conversación: es demasiado grande para ejecutarlo en local. Solo los pesos necesitan unos 924 GB incluso cuantizados, así que es un modelo de centro de datos o de API, no de portátil. Y como es un modelo en bruto, la mayoría de los equipos conocerán Hy4 a través de la API o de un producto construido sobre él, no descargándolo. Si lo que realmente quieres es una IA que haga un trabajo concreto de principio a fin, un compañero listo para trabajar como eesel encaja mejor que cualquier modelo base, Hy4 incluido.
Qué es realmente Tencent Hy4
Tencent lanzó y publicó como código abierto Hy4 preview el 28 de agosto de 2026, y lo describe como un modelo "built for real-world productivity tasks, delivering outstanding performance across coding, office work, and scientific research." Es el modelo más reciente del equipo Hunyuan de Tencent, tras la línea Hy3, y llegó con pesos abiertos desde el primer día.
El enfoque importa. No se presenta como un asistente amigable para competir con un chatbot de IA general. Tencent lo codiseñó con sus propios productos CodeBuddy y WorkBuddy y lo entrenó con datos de trabajo de ingenieros de software, desarrolladores de videojuegos, analistas financieros y expertos en seguridad. Las capacidades principales son cosas como depuración de largo recorrido, convertir contexto desordenado de varios archivos en documentos y hojas de cálculo, generar un prototipo de juego jugable a partir de un solo prompt y razonar sobre problemas de investigación en dinámica molecular o matemáticas puras.
Estas son las especificaciones que importan, según la ficha del modelo en Hugging Face:
| Propiedad | Valor |
|---|---|
| Arquitectura | Mixture-of-Experts (MoE) |
| Parámetros totales | 770B |
| Parámetros activos por token | 49B |
| Capas | 78 (1 densa + 77 MoE) |
| Expertos enrutados / compartidos | 256 enrutados + 1 compartido, top-8 activados |
| Longitud de contexto | 1M de tokens |
| Atención | Gated DeepSeek Sparse Attention (Gated DSA) |
| Licencia | Apache 2.0 |
| Variantes | BF16 instruct + build FP8 oficial |
Una buena señal de honestidad: Tencent etiqueta esto como "preview" y enumera abiertamente sus defectos. La ficha del modelo admite que Hy4 pasa más tiempo del necesario razonando en tareas complejas y tiene "a tendency to over-verify its own work." Ese enfoque de lanzar pronto e iterar es el mismo que hizo mucho más fuerte a Hy3 entre su preview y su versión final.
Cómo funciona el diseño Mixture-of-Experts
Las dos cifras en las que todos se fijan, 770B y 49B, describen el truco central de un modelo Mixture-of-Experts, y vale la pena entenderlo porque explica tanto por qué Hy4 es rápido como por qué es una pesadilla de ejecutar.
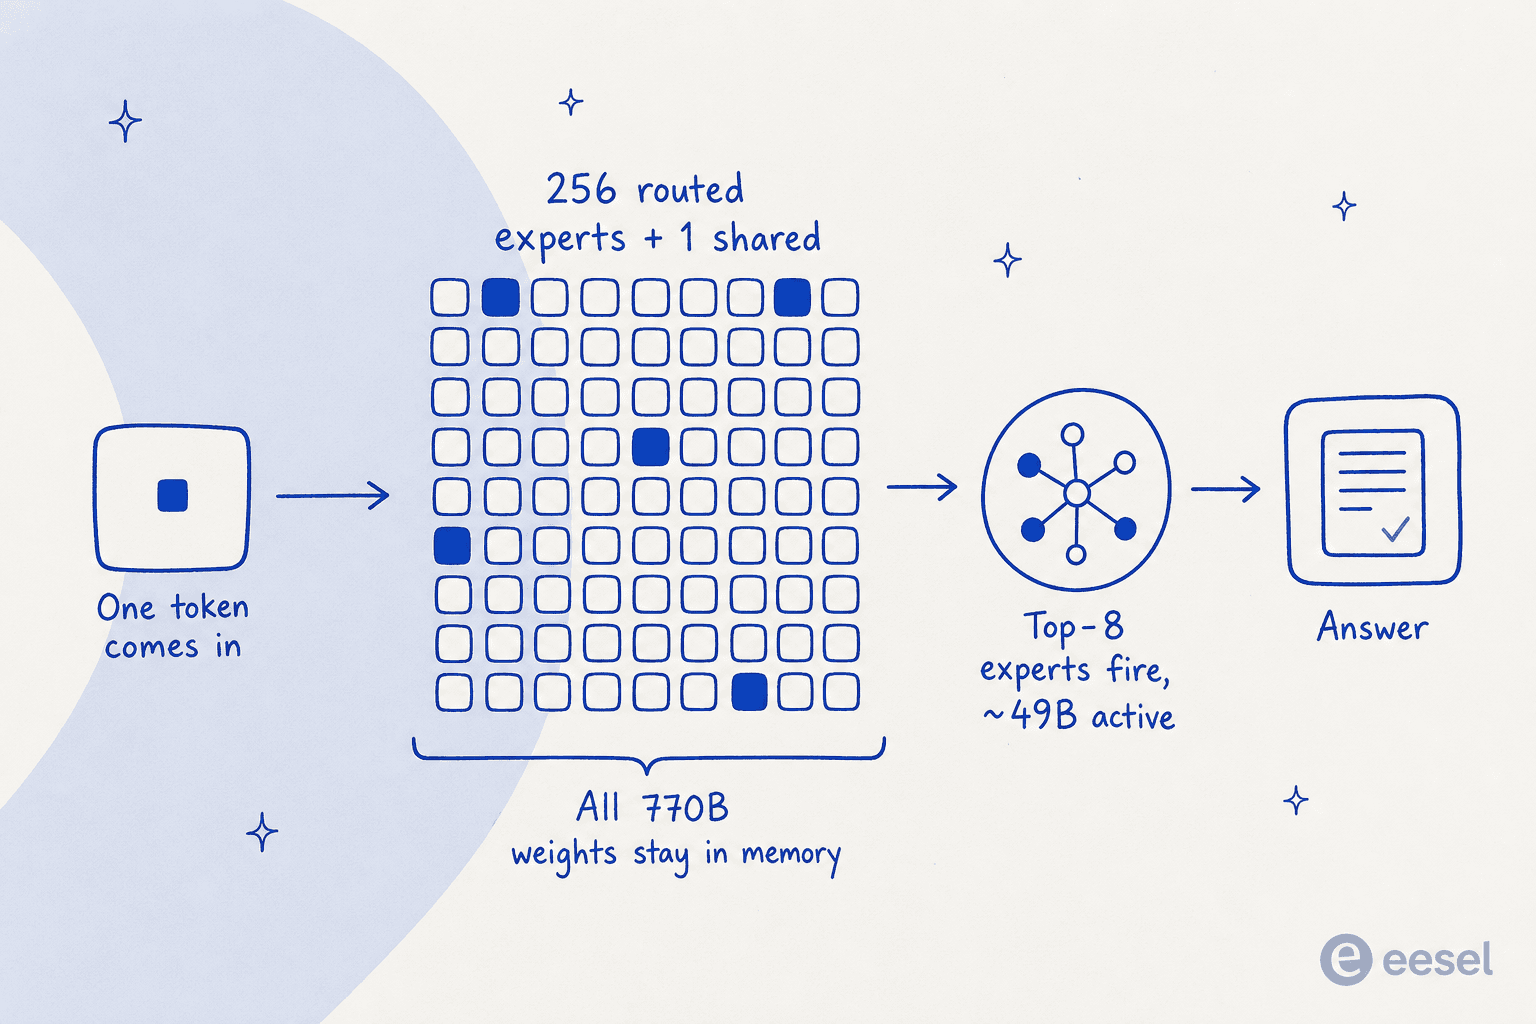
La base son 78 capas. La primera es una capa densa estándar; las otras 77 contienen cada una 256 expertos enrutados más 1 experto compartido. Cuando entra un token, un enrutador elige los 8 expertos más relevantes para él, y solo esos (más el compartido) calculan realmente. Así, aunque el modelo tiene 770B de parámetros, unos 49B se activan por token. Eso mantiene viable el rendimiento de inferencia: no pagas el coste de cómputo de un modelo denso de 770B en cada token.
Por dentro, Tencent se apoyó en ideas de DeepSeek y GLM: la atención usa Gated Sparse Attention con una caché de índices reutilizable, y hay una capa nativa de predicción de múltiples tokens añadida para la decodificación especulativa, que acelera la generación con lotes pequeños. Lo importante es el inconveniente de la siguiente sección: MoE ahorra cómputo, no memoria. Los 770B pesos tienen que estar a la vez en la memoria de la GPU.
Los benchmarks, leídos con honestidad
El material de lanzamiento de Tencent afirma "supera a GLM-5.3 y Kimi K3", y es técnicamente cierto, pero mucho más flojo de lo que suena. La afirmación procede de una evaluación ciega interna: 163 expertos internos valoraron las salidas de los modelos en 203 tareas de ingeniería, puntuando cada una sobre 4,00.
| Modelo | Media de la evaluación ciega (/4,00) | Resultado por pares de Hy4 |
|---|---|---|
| Hy4 preview | 2,99 | - |
| Kimi K3 (Moonshot) | 2,94 | Hy4 gana 51,2 % / empata 7,9 % / pierde 40,9 % |
| GLM-5.3 (Z.AI) | 2,92 | Hy4 gana 46,8 % / empata 12,8 % / pierde 40,4 % |
Una diferencia de 0,05 puntos en la escala de cuatro puntos del propio fabricante es, estadísticamente, un encogimiento de hombros. La propia Tencent lo advierte: "bounded by its tasks, model versions, raters, and procedure... not an independent public benchmark". Frente a GLM-5.3, las victorias de Hy4 solo superan a sus derrotas por 47 a 40. Es un casi empate disfrazado de ventaja.
El gráfico de benchmarks públicos cuenta la historia completa, y es el que conviene mirar con honestidad:
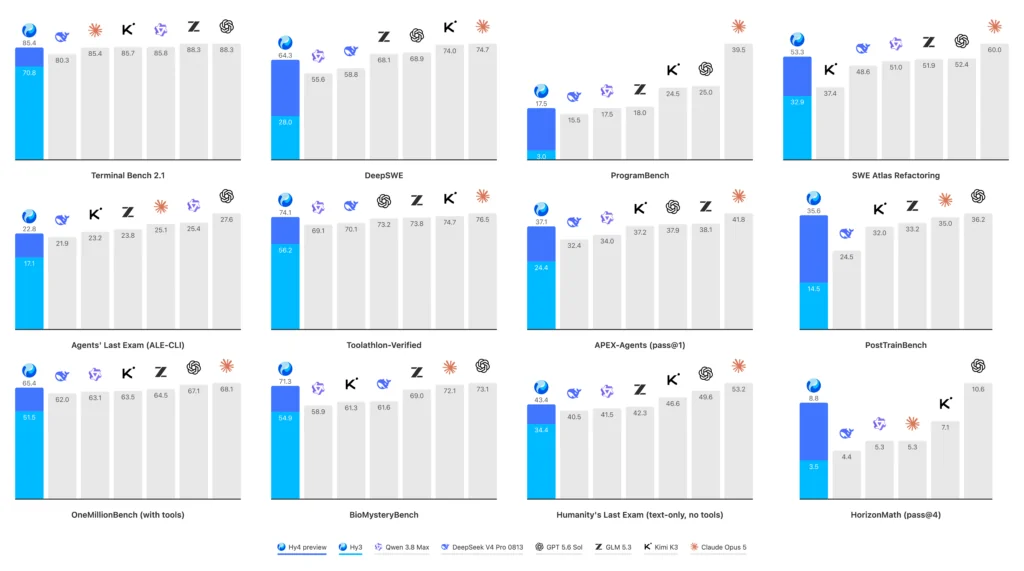
Hy4 sí logra algunas puntuaciones sólidas: 92,3 en GPQA Diamond, 85,4 en Terminal Bench, 82,9 en SWE-bench Multilingual, y lidera el campo abierto en HorizonMath y BioMysteryBench. Pero si recorres los doce paneles, normalmente Claude Opus 5 o GPT-5.6 está arriba, con Hy4 agrupado en mitad de la tabla junto a Kimi K3, GLM-5.3 y Qwen 3.8 Max. La comunidad detectó rápido el enfoque:
Why do they always highlight benchmarks where it scored less than other models the same as the ones where it scored better? It's so misleading. I can't even tell which benchmarks it actually beat other models.

Para una ubicación independiente, Hy4 aún no aparece en el índice de inteligencia de Artificial Analysis, así que no hay una puntuación agregada neutral que citar (como referencia, el líder actual de esa tabla, Claude Opus 5, está en 63). La única señal de terceros hasta ahora viene de la clasificación de programación de LMArena:
Hy4 preview by @TencentHunyuan just landed ~#5 in the Code Arena: WebDev with 1633 pts (AutoEval)... Among open models, Hy4 preview is ~#3, compared to Hy3 at #7.
Es un salto real respecto a Hy3, pero fíjate en el matiz "AutoEval": Arena dice que un modelo de recompensa emitió votos automáticos en lugar de votos humanos en vivo, así que trátalo como provisional. Mi lectura: Hy4 es un modelo abierto realmente fuerte que está más o menos al nivel de los otros modelos insignia chinos, y el lenguaje de "supera" es marketing sobre un casi empate. Si quieres una comparación directa más profunda, la comparativa Qwen 3.8 Max vs Kimi K3 cubre la misma gama.
¿Se puede ejecutar de verdad?
Esta es la pregunta que dominó todos los hilos del lanzamiento, y la respuesta es sobria. MoE ahorra cómputo, pero los 770B pesos tienen que vivir en la memoria de la GPU.
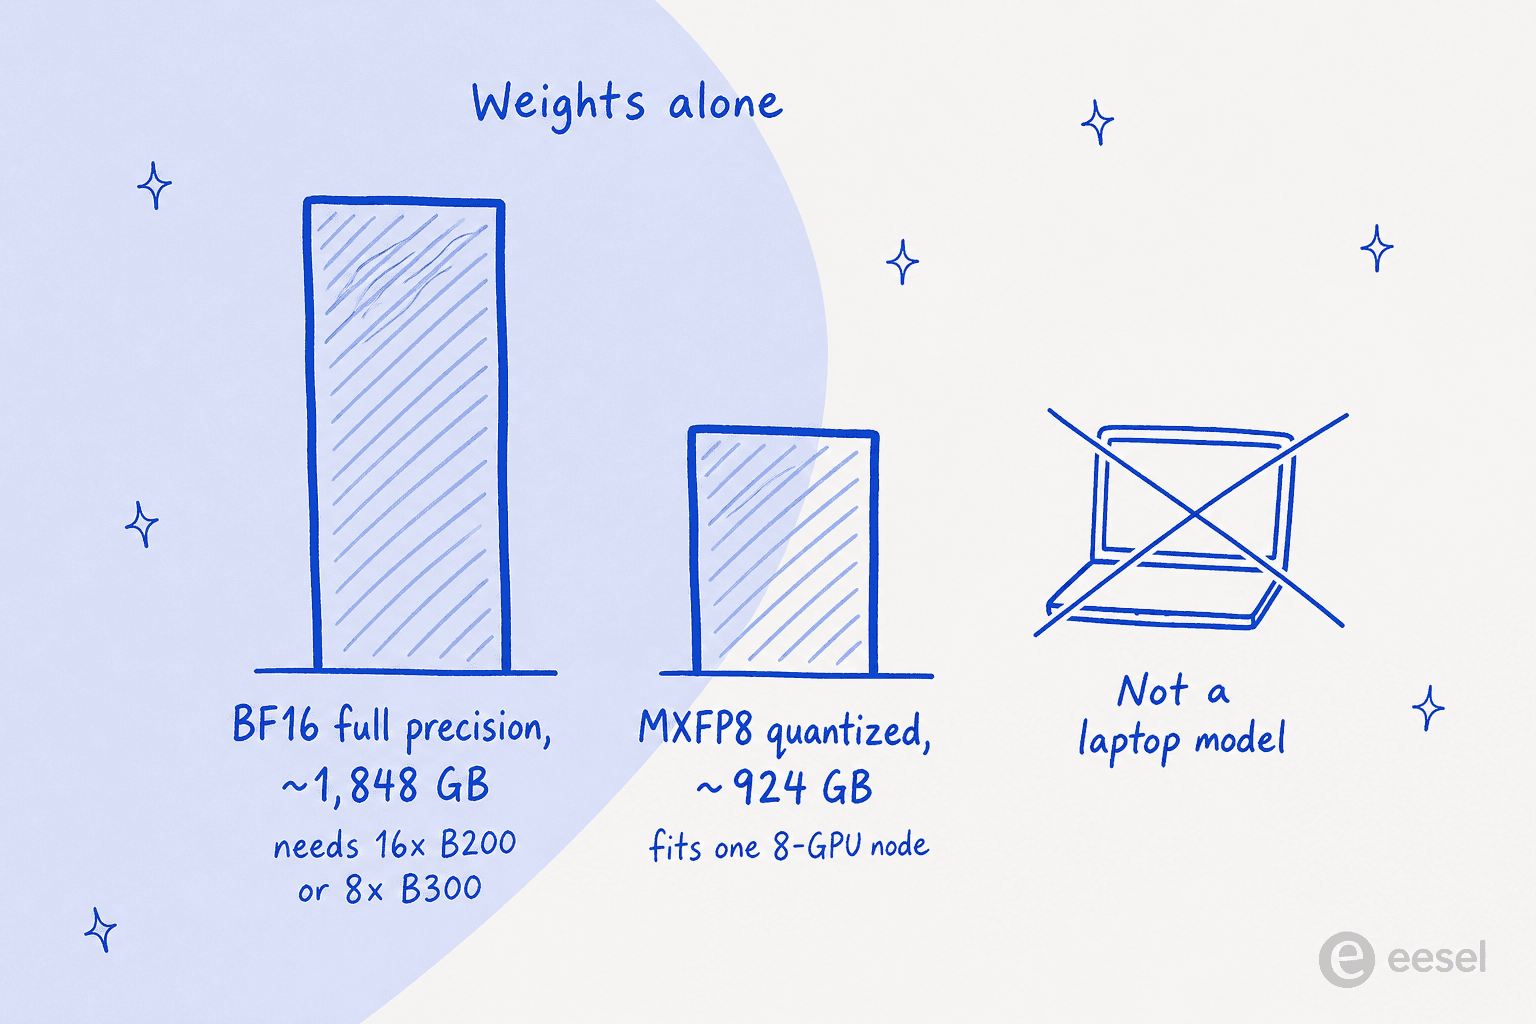
Según la receta oficial de vLLM, los pesos completos en BF16 suman unos 1.848 GB. Su conclusión es directa: necesitas "16x B200 or 8x B300 minimum for weights + KV cache." La versión cuantizada MXFP8 reduce eso aproximadamente a la mitad, unos 924 GB, que cabe en un nodo de 8 GPU de los aceleradores más recientes con mucha VRAM, y por eso el ejemplo de servicio por defecto usa un tamaño de tensor-parallel de 8. Hay un checkpoint FP8 oficial y un kit de cuantización llamado AngelSlim para reducirlo aún más, pero nada de eso lo pone al alcance de un equipo doméstico. La gente de r/LocalLLaMA, que ejecuta modelos grandes por afición, en su mayoría se rindió:
I don't know who around here runs 780b models, but I am happy for them :)
Incluso las cuentas de cuantización de la propia comunidad son sombrías: una versión Q4 ronda los 450-512 GB, y una máquina de 256 GB solo admite cuantizaciones de 1-2 bits. Como dijo un comentarista, si tienes 256 GB, "you'll probably be much better off with GLM-5.3-Flash Q4". Así que para la mayoría, "pesos abiertos" es un dato de licencia, no un dato práctico. Usarás Hy4 a través de una API.
Precios y comparación
La API de Hy4 cuesta 0,834 $ por millón de tokens de entrada, 2,501 $ por millón de salida y 0,042 $ por aciertos de caché. Entre los modelos abiertos de gama insignia, es el más barato del grupo.
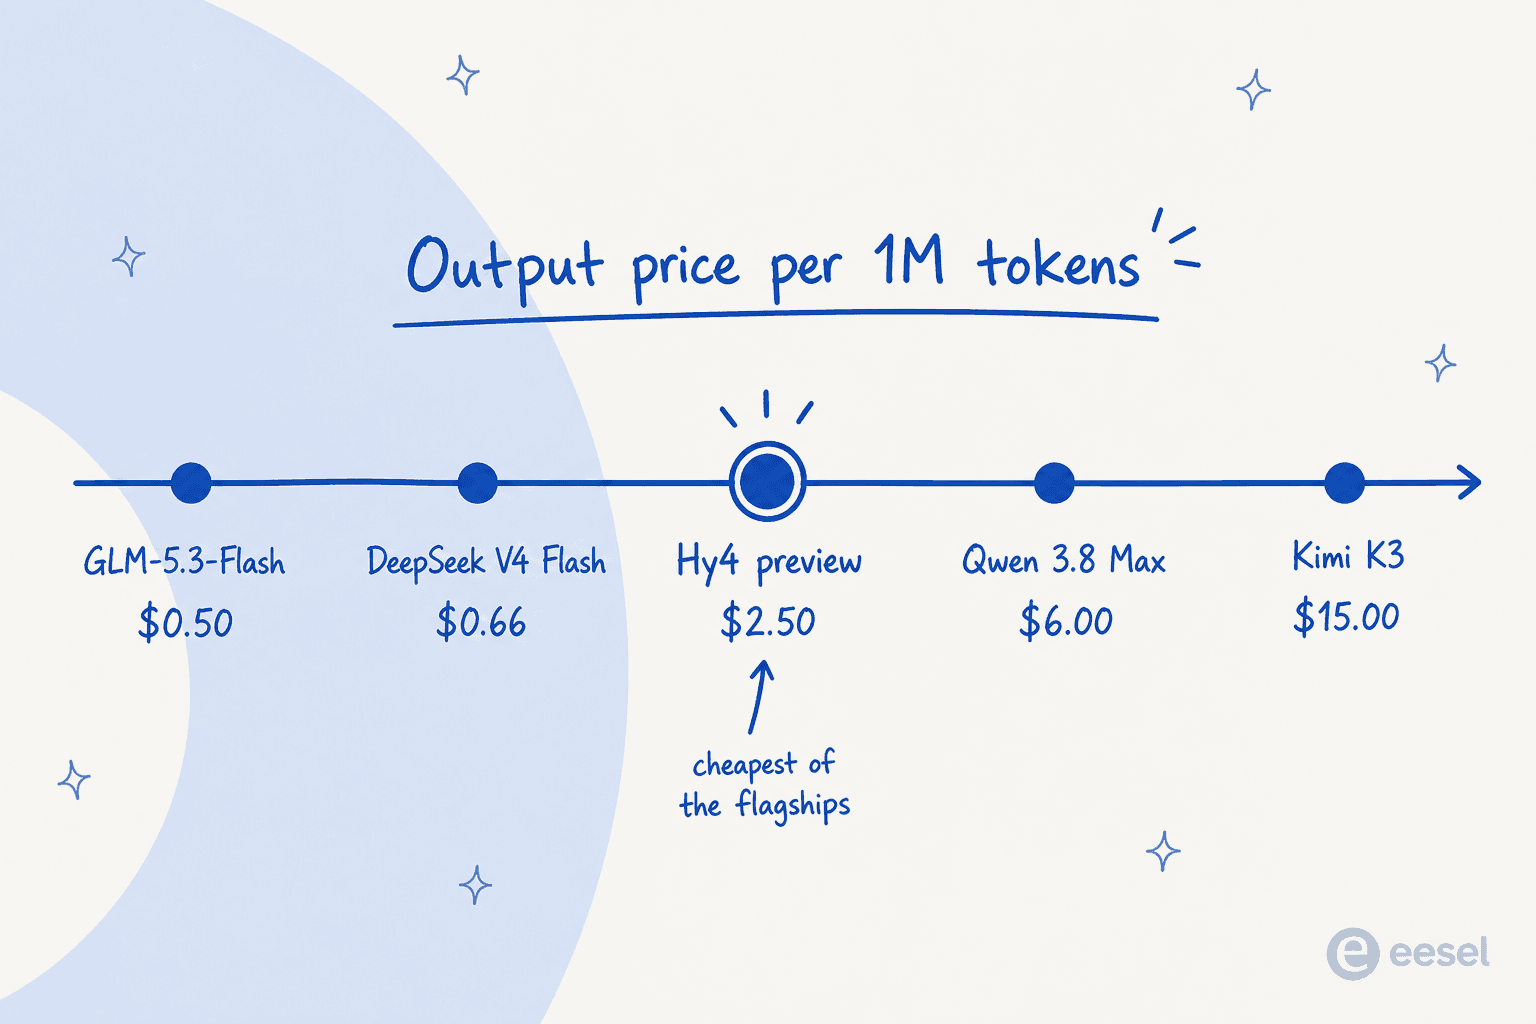
Este es el panorama completo frente al campo actual de pesos abiertos (todo por millón de tokens, comprobado el 30 de agosto de 2026):
| Modelo | Entrada | Salida | Entrada con acierto de caché | Pesos |
|---|---|---|---|---|
| Hy4 preview (Tencent) | 0,834 $ | 2,501 $ | 0,042 $ | Apache 2.0 |
| GLM-5.3-Flash (Z.AI) | 0,15 $ | 0,50 $ | 0,03 $ | Abiertos |
| DeepSeek V4 Flash | 0,22 $ / 0,44 $ | 0,66 $ / 1,32 $ | 0,007 $ | MIT |
| GLM-5.3 (Z.AI) | 1,40 $ | 4,40 $ | 0,26 $ | Abiertos |
| Qwen 3.8 Max | 2,00 $ | 6,00 $ | 0,25 $ | Personalizada |
| Kimi K3 (Moonshot) | 3,00 $ | 15,00 $ | 0,30 $ | Abiertos |
Así que Hy4 mejora con holgura los precios de GLM-5.3, Qwen 3.8 Max y Kimi K3 (cuya tarifa de salida es casi 6 veces la de Hy4). Pero no es el suelo de precios. DeepSeek V4 Flash y GLM-5.3-Flash son ambos mucho más baratos, y la tarifa fuera de hora de DeepSeek lo deja en una fracción del coste de Hy4. Y hay un inconveniente para quien ya usa Hunyuan:
But the new HY4 pricing is roughly 5-6x higher than HY3, so you're looking at about a 400-500% increase in input/output cost.
La única ganga real de la tarifa es el caché de contexto a 0,042 $ por millón, que según un usuario es mucho más bajo que el de GLM-5.3. Si tu carga de trabajo relee un contexto fijo grande (una base de código, un documento largo) en muchas llamadas, esa tarifa de caché es donde Hy4 se vuelve interesante. Para un desglose de costes más completo de los modelos vecinos, la guía de precios de DeepSeek V4 Flash y la guía de precios de Kimi K3 son buenos complementos.
Cómo acceder a Hy4 hoy
Si no vas a montar un nodo de 8 GPU, aquí tienes dónde acceder realmente:
- API: el ID del modelo es
hy4-preview, servido a través de Tencent Cloud TokenHub y OpenRouter. Se admiten APIs en formato OpenAI y Anthropic, y OpenRouter lo ofrece con una política de datos de retención cero, una buena ventaja frente a algunas APIs propias chinas cuyos términos son vagos sobre el uso para entrenamiento. - Gratis durante dos semanas: Hy4 es gratis en WorkBuddy y CodeBuddy desde el lanzamiento, y el acceso gratuito a Hy3 en ambos se amplió hasta el 30 de septiembre. También se puede usar dentro de las apps Yuanbao e ima de Tencent.
- Pesos abiertos: disponibles en Hugging Face, GitHub, ModelScope y GitCode, con una versión BF16 y otra FP8.
Una aclaración, porque circuló en el lanzamiento: las CLI de programación de terceros adoptaron Hy4 rápidamente a través de OpenRouter, pero esos no son canales gratuitos oficiales de Tencent. Las únicas ofertas gratuitas propias son WorkBuddy y CodeBuddy.
El ángulo de la automejora
La afirmación más futurista del lanzamiento es fácil de pasar por alto. Tencent dice que Hy4 contribuyó a su propio desarrollo, participando en la "automated optimization of training methods, data strategies, evaluation frameworks, and low-level operators", lo que llama un "early-stage recursive self-improvement loop." La versión concreta y comprobable: Hy4 analizó cuellos de botella en su propia pila de inferencia y las optimizaciones resultantes aumentaron el rendimiento de extremo a extremo un 31,8 %.
Yo tomaría el marco grandilocuente de "automejora" con pinzas (un modelo que propone fusiones de operadores está muy lejos de un modelo que se rediseña a sí mismo), pero la cifra del 31,8 % de rendimiento es específica y real, y es el tipo de lucimiento de ingeniería que suele envejecer bien. También alimenta la esperanza recurrente de la comunidad de que el lanzamiento final llegue mucho más fuerte que esta preview:
And this is a PREVIEW? The actual release must actually be fable level or higher then?
Entonces, ¿quién debería usar Hy4?
Tras repasarlo todo, este es mi veredicto honesto. Hy4 es un modelo insignia de pesos abiertos serio, con una ventaja real de precio frente a Kimi K3 y Qwen 3.8 Max, fuertes benchmarks de programación y ciencia, y una licencia permisiva Apache 2.0. Si estás construyendo un agente de IA sobre una infraestructura que controlas, quieres una licencia realmente abierta y tienes el presupuesto de API o el hardware, es una opción legítima, sobre todo para trabajo de programación con contexto largo y uso intensivo de caché.
Pero sé realista con dos cosas. No es la opción más barata (ahí ganan DeepSeek y los modelos Flash), y no es un líder aplastante (está al nivel de sus pares chinos y por detrás de la frontera cerrada). Y, sobre todo, Hy4 es infraestructura. Es un modelo en bruto que responde a prompts. No conoce tu negocio, no vive en tus herramientas y no hace un trabajo por sí solo. Esa brecha, entre un modelo potente y algo que realmente hace el trabajo, es el sentido de la siguiente sección.
Prueba eesel
Esta es la distinción que importa: Hy4 es un modelo; eesel es el compañero que contratas. Un modelo base como Hy4 te da inteligencia en bruto que luego tienes que cablear, ajustar con prompts, conectar a tus datos y vigilar. eesel es una plataforma de compañeros de IA donde contratas compañeros listos para trabajar para tareas concretas, cada uno con las habilidades, integraciones y contexto de empresa propios de su rol.
La plantilla actual incluye un compañero de IA para el helpdesk que se une a tu cola de soporte existente, consulta pedidos, etiqueta tickets y redacta o envía respuestas dentro del helpdesk que ya usas, y un redactor de blog con IA que se encarga de investigación, redacción y SEO de una sola vez. Ambos se entrenan con tus tickets anteriores, tu centro de ayuda y tus documentos, y se ponen en marcha en minutos en lugar de necesitar un equipo de ML. Donde un modelo te deja con una caja de prompts, un compañero llega ya conociendo el trabajo.
Lo otro que los modelos en bruto no pueden hacer: antes de que un compañero de eesel entre en producción, puedes simularlo con tus tickets históricos, así sabrás cómo rendirá de verdad en lugar de activar el interruptor y esperar lo mejor. Es gratis de probar, sin tarjeta de crédito y sin llamada de ventas. Si tu objetivo es hacer trabajo real en lugar de gestionar un clúster de inferencia, empieza con eesel.