Las 8 mejores alternativas a Tencent Hy4 en 2026

Rama Adi

Katelin Teen
Última edición August 30, 2026
Resumen
Tencent Hy4 preview es un modelo de pesos abiertos realmente potente: un lanzamiento de mezcla de expertos de 770B que recorta precios frente a los otros buques insignia chinos y queda cerca de lo más alto entre los modelos abiertos en la arena de codificación WebDev. El problema es que probablemente no puedas ejecutarlo. Es un modelo de mezcla de expertos, así que solo se activan 49B parámetros por token, pero los 770B tienen que estar a la vez en la memoria de la GPU, lo que significa un servidor de ocho GPU. Además, es unas cinco o seis veces más caro que Hy3 y sigue siendo una versión preliminar.
Así que la pregunta real no es "¿es bueno Hy4?" (lo es), sino "¿qué modelo me da resultados de nivel Hy4 con el hardware y el presupuesto que realmente tengo?". Mis elecciones:
- GLM-5.3-Flash - la mejor alternativa general: 320B, multimodal nativo y barato.
- DeepSeek V4 Flash - el suelo de precio, con licencia MIT y lo bastante pequeño para alojarlo por cuenta propia.
- GLM-5.3 - lo más parecido a la calidad de Hy4 (es el modelo con el que Tencent se compara).
- Kimi K3 - el más fuerte para ejecuciones largas de codificación con agentes.
- Qwen 3.8 Max, DeepSeek V4 Pro, Claude Opus 5 y GPT-5.6 completan la lista para necesidades multimodales, de contexto largo y de cero infraestructura.
Una cosa más: si quieres un modelo para responder tickets de clientes, no tienes por qué montarlo tú. eesel es un compañero de IA para el helpdesk que ya funciona sobre modelos de frontera, se integra con tus herramientas actuales y te deja probar con tickets pasados antes de salir en producción.
Por qué la gente mira más allá de Hy4
Primero, seamos justos con Hy4, porque lo merece. El equipo Hunyuan de Tencent lanzó un modelo abierto de frontera de verdad: 770B parámetros en total, 49B activos, una ventana de contexto de 1M de tokens, pesos abiertos en Hugging Face y un precio inferior al de GLM-5.3, Qwen 3.8 Max y Kimi K3. En el ranking Code Arena WebDev quedó cerca del puesto #5, aproximadamente el #3 entre los modelos abiertos, un salto de +115 puntos respecto a Hy3. Si tienes el hardware, es una opción sólida.
Aquí es donde se complica, y es lo que me encuentro cada semana construyendo sobre estos modelos. Un modelo de mezcla de expertos te ahorra cómputo por token, no memoria. El enrutador solo activa 49B de los 770B parámetros para cada token, así que es rápido, pero los 770B completos tienen que estar cargados y residentes. En la práctica son unos 924GB de pesos en la versión MXFP8, es decir, un nodo de ocho GPU de clase B300. Una máquina con ocho H100 (640GB) no lo aguanta. La opinión de la comunidad en r/LocalLLaMA llegó al mismo punto: modelo increíble, imposible ejecutarlo en casa.
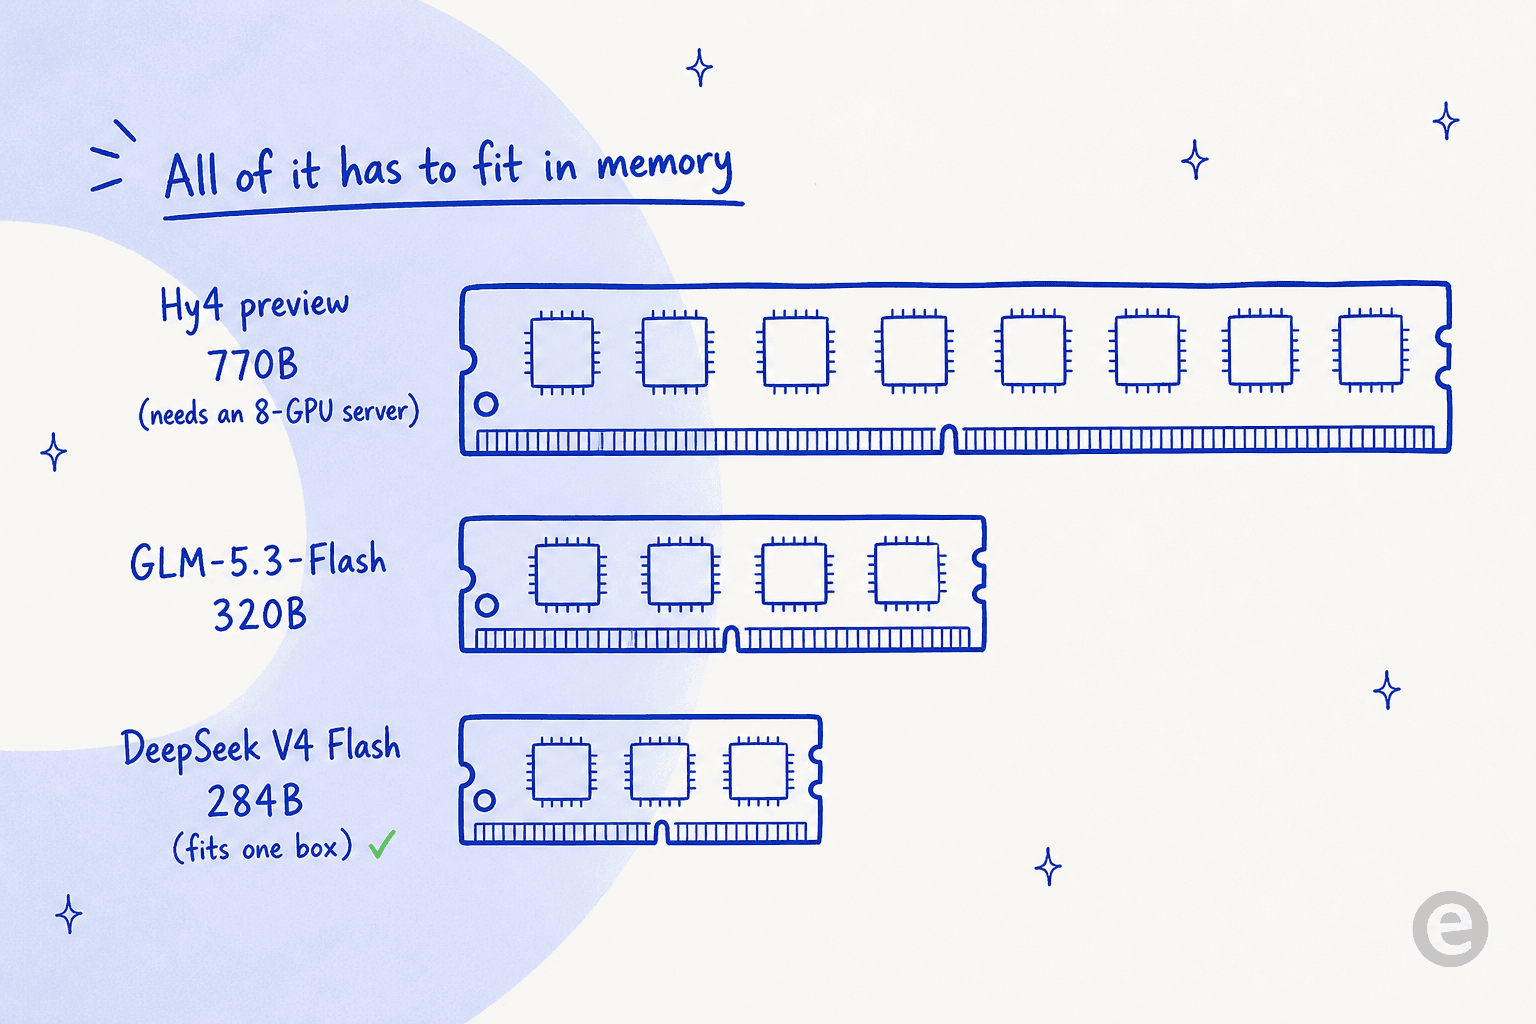
El segundo problema es el coste. Hy4 recorta precios frente a sus rivales insignia, pero es un gran salto respecto al modelo que sustituye, así que los usuarios actuales de Hy3 se enfrentan a una factura bastante mayor aunque parezca barato al lado de Kimi. Y el tercero es la madurez: es una versión preliminar, y la propia Tencent indica que el modelo tiende a razonar y verificar en exceso.
Nada de eso hace de Hy4 un mal modelo. Lo convierte en un modelo con un grupo reducido de personas que pueden desplegarlo de verdad. Para todos los demás, las alternativas de abajo te llevan casi hasta allí con hardware que sí puedes permitirte.
Cómo se compara realmente Hy4 con estas alternativas
Antes de pasar a las recomendaciones, conviene ver el cara a cara. Esta es la tabla de benchmarks de la propia Tencent en el lanzamiento, y lo útil es que los rivales que aparecen son exactamente los modelos de este análisis: Qwen 3.8 Max, DeepSeek V4 Pro, GPT-5.6 Sol, GLM-5.3, Kimi K3 y Claude Opus 5.
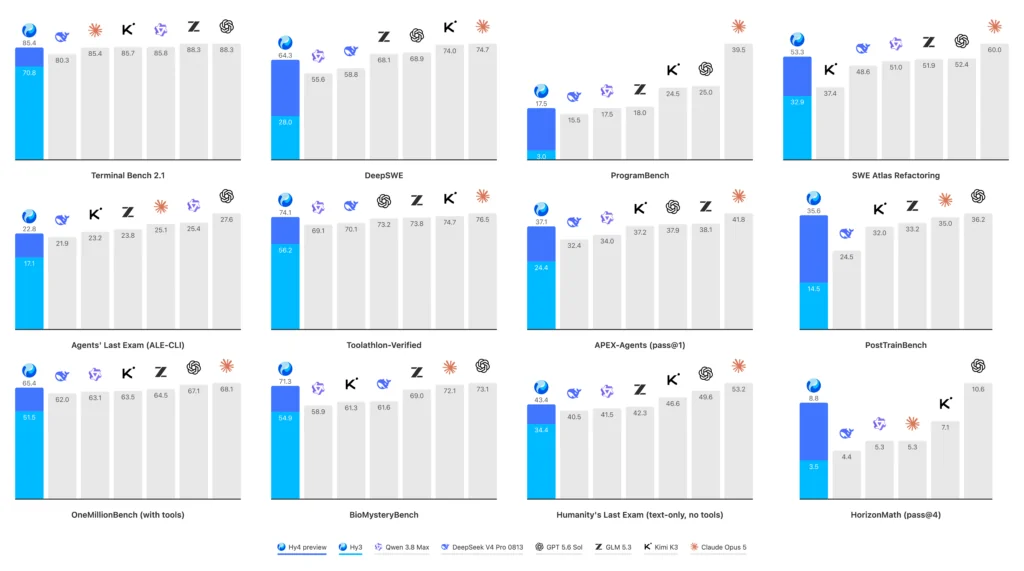
Dos salvedades honestas. Primero, es el gráfico de un proveedor sobre su propio producto, así que tómalo como punto de partida, no como veredicto. Segundo, Hy4 todavía no aparece en el índice independiente de Artificial Analysis, así que no hay una puntuación de inteligencia neutral que citar. La evaluación ciega interna de la propia Tencent situó a Hy4 en 2,99/4,00 frente a Kimi K3 (2,94) y GLM-5.3 (2,92), lo bastante cerca como para que la comunidad de CLI de codificación lo leyera como un triple empate, con el precio como la verdadera ventaja de Hy4.
Cómo elegí estos modelos
En eesel me encargo de las integraciones y de la parte técnica de los modelos, así que decidir cuál ejecutar realmente en producción es buena parte de mi semana. Una cifra de ranking es la parte fácil. Lo que decide en la práctica son estas preguntas: ¿caben los pesos?, ¿cuánto cuesta un mes real de tokens?, ¿la licencia me permite lanzar un producto?, ¿aguanta una ejecución larga con agentes y no solo una respuesta brillante? Por eso lo pondero así:
- Facilidad de despliegue - si un equipo normal puede ejecutarlo o pagarlo de forma realista, no solo un hiperescalador.
- Precio por 1M de tokens - según la tarifa del propio proveedor, señalando promociones y rarezas de horas punta/valle.
- Licencia y pesos abiertos - si puedes alojarlo tú y qué se te permite hacer.
- Capacidad real - fuerza en codificación y en agentes, no solo una cifra de titular.
Todos los precios y especificaciones de abajo proceden de las páginas del propio proveedor, comprobadas el 30 de agosto de 2026. Cuando una cifra es un benchmark interno del proveedor y no uno independiente, lo indico.
Las alternativas de un vistazo
| Modelo | Ideal para | Parámetros totales / activos | Contexto | Entrada $/1M | Salida $/1M | Pesos abiertos | Licencia |
|---|---|---|---|---|---|---|---|
| GLM-5.3-Flash | Mejor opción general | 320B / 18B | 1M | $0.075* | $0.25* | Sí | Abierta (HF) |
| DeepSeek V4 Flash | Precio más bajo | 284B / 13B | 1M | $0.22-0.44 | $0.66-1.32 | Sí | MIT |
| GLM-5.3 | Más cercano a Hy4 | No divulgado | 1M | $1.40 | $4.40 | Sí | Abierta (HF) |
| Kimi K3 | Codificación con agentes | 2.8T / 104B | 1M | $3.00 | $15.00 | Sí | "other" |
| Qwen 3.8 Max | Multimodal + ecosistema | 2.4T / 95B | 1M | $2.00 | $6.00 | Sí (base) | qwen3.8-max |
| DeepSeek V4 Pro | Recuperación en contexto largo | 49B de clase activos | 1M | $0.66-1.32 | $1.98-3.96 | Sí | Abierta |
| Claude Opus 5 | Cero infraestructura | No divulgado | 1M | $5.00 | $25.00 | No | Propietaria |
| GPT-5.6 | Niveles de API gestionada | No divulgado | Niveles de contexto largo | $0.20-5.00 | $1.20-30.00 | No | Propietaria |
*GLM-5.3-Flash tiene una promoción de lanzamiento del 50% ($0.15 / $0.50 de lista) que termina el 9 de septiembre de 2026. DeepSeek muestra de horas valle a horas punta; un horario de EE. UU./UE suele facturarse sobre todo a la tarifa valle, más baja. Todas las tarifas según la página de precios de cada proveedor, comprobadas el 30 de agosto de 2026.
El patrón salta a la vista al verlo todo junto: los dos modelos "Flash" son un orden de magnitud más baratos que el nivel de frontera, y las APIs cerradas (Opus 5, GPT-5.6) están arriba en precio pero no te piden nada a cambio. Aquí está la misma imagen como precio de salida, que suele ser la factura que de verdad duele con un agente charlatán:
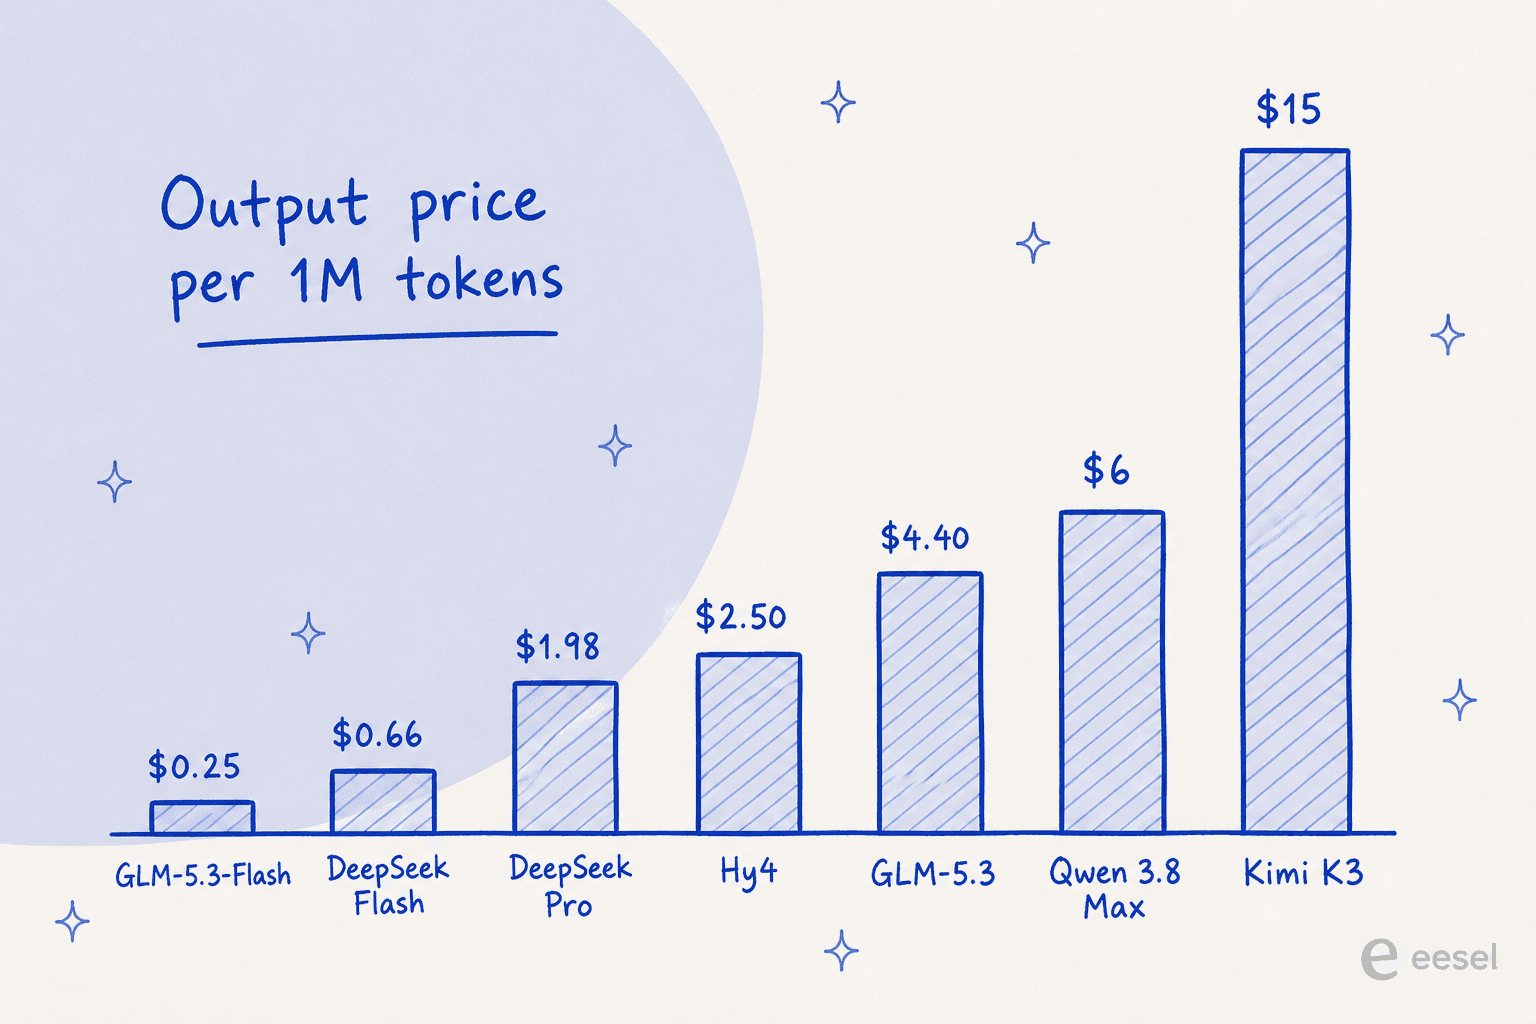
Si no estás seguro de en qué esquina del mapa encajas, esta herramienta rápida te lleva hasta una elección.
1. GLM-5.3-Flash
Ideal para: equipos que quieren calidad de nivel Hy4 con hardware que realmente puedan ejecutar, al menor precio realista.
Este es el primero al que recurriría. GLM-5.3-Flash, de Z.ai (antes Zhipu AI), es un modelo de mezcla de expertos de 320B con solo 18B activos, y es el primer modelo multimodal nativo de la línea GLM-5, que maneja texto, imagen y vídeo. El lema de Z.ai es "inteligencia de frontera, coste flash", y las cifras respaldan la segunda mitad: obtiene 57 en el índice de inteligencia de Artificial Analysis a unos $0.045 por tarea con descuento, un nivel que antes costaba aproximadamente 10 veces más.
La razón por la que supera a Hy4 para la mayoría es simple: con 320B en total es menos de la mitad del tamaño de Hy4, así que es bastante más fácil de servir, y se probó discretamente como "ox-alpha" en OpenRouter, donde fue el modelo más usado de la semana, todo servido sobre chips chinos. En el Code Bench propio de Z.ai llega a 29,0 frente al 29,5 de Claude Opus 4.8, casi un empate.
Ventajas: multimodal nativo (texto, imagen, vídeo), pesos abiertos en Hugging Face y, con diferencia, la mejor relación precio-capacidad de esta lista.
Inconvenientes: las comparaciones de benchmarks son de la propia Z.ai y el precio de titular es una promoción de lanzamiento. Z.ai no ha publicado una hoja completa de parámetros y contexto tan limpia como algunos rivales.
Precio: $0.075 de entrada / $0.25 de salida por 1M durante la promoción de lanzamiento del 50% (lista $0.15 / $0.50), que termina el 9 de septiembre de 2026. La entrada en caché cuesta $0.015. También está incluido en el GLM Coding Plan desde $18/mes.
Veredicto: si solo puedes probar una alternativa a Hy4, que sea esta. Es ese modelo raro que es más barato y más pequeño y multimodal, y el que le daría a un equipo al que le gustó Hy4 pero no podía justificar el servidor de ocho GPU.
2. DeepSeek V4 Flash
Ideal para: el coste por token más bajo absoluto y la licencia más amable con el autoalojamiento del grupo.
DeepSeek V4 Flash es el suelo de precio, y no hay color. Es un modelo de mezcla de expertos de 284B con 13B activos, publicado bajo una verdadera licencia MIT, y con unos 167GB de pesos es el único modelo de clase frontera de esta lista que un equipo bien equipado puede ejecutar en casa por menos de 10.000 $. En horas valle cuesta unos $0.22 de entrada / $0.66 de salida por 1M, aproximadamente una cuarta parte de la tarifa de salida de Hy4.
Hay una rareza que conviene conocer: la tarifa de DeepSeek está dividida por franja horaria, con las horas punta siguiendo el horario laboral chino (01:00-04:00 y 06:00-10:00 UTC). Una cola de soporte de EE. UU. o la UE funciona sobre todo en la ventana valle de DeepSeek, así que por defecto pagas la mitad más barata de la tarifa. El único reproche honesto es la verbosidad: las pruebas independientes muestran que consume bastantes más tokens de salida que sus rivales para llegar a una respuesta, así que el ahorro por token se reduce un poco por tarea.
Ventajas: el más barato por un amplio margen, con licencia MIT y lo bastante pequeño para alojarlo por cuenta propia.
Inconvenientes: es charlatán (más tokens de salida que sus pares), y los términos de la API de pago de DeepSeek callan sobre el uso para entrenamiento en lugar de declararlo explícitamente seguro, con residencia de datos en China. Eso importa si envías datos de clientes por la API oficial.
Precio: entrada sin caché $0.22 en horas valle / $0.44 en horas punta; salida $0.66 / $1.32; entrada con acierto de caché desde $0.007, según la página de precios de DeepSeek.
Veredicto: si lo que decide es la factura, este es tu modelo. Solo presupuesta su locuacidad y mantén los datos personales de clientes fuera del endpoint oficial salvo que hayas leído los términos con cuidado.
3. GLM-5.3
Ideal para: lo más parecido a la calidad real de Hy4, del modelo con el que Tencent eligió compararse.
Cuando Tencent quiso demostrar que Hy4 era de clase frontera, GLM-5.3 fue uno de los dos modelos con los que lo comparó, y Hy4 solo lo superó por 2,99 a 2,92 en la propia evaluación ciega de Tencent. Es decir, si quieres el modelo que más se acerca a la calidad real de Hy4, este es el candidato obvio, y viene de un linaje con un historial serio en codificación de largo recorrido (su predecesor GLM-5.2 fue el primer modelo de pesos abiertos en superar el 80% en Terminal-Bench).
También es más barato que Hy4 en entrada y queda en la misma zona en salida, así que no pagas un sobreprecio por un modelo casi igual. Z.ai no publica el número exacto de parámetros de GLM-5.3 de forma tan clara como algunos rivales, así que dejo esa cifra fuera en lugar de citar a un agregador.
Ventajas: el rival con benchmark más cercano a Hy4, pesos abiertos, sólida trayectoria en codificación de largo recorrido, 1M de contexto y endpoints compatibles con OpenAI y Anthropic, así que encaja en las herramientas existentes.
Inconvenientes: la hoja de especificaciones pública de Z.ai para 5.3 es escasa en parámetros totales/activos y, como Hy4, es un modelo grande para alojar por cuenta propia.
Precio: $1.40 de entrada / $4.40 de salida por 1M, entrada en caché $0.26, según la documentación de precios de Z.ai. También disponible a través del GLM Coding Plan.
Veredicto: si tu objetivo es "dame Hy4 pero que pueda desplegar sin las salvedades de la versión preliminar", GLM-5.3 es el cambio más seguro. Es la alternativa equivalente.
4. Kimi K3
Ideal para: ejecuciones largas de codificación con agentes y muchas herramientas, donde la profundidad importa más que el precio.
Kimi K3, de Moonshot AI, es el modelo más grande de aquí: 2.8T en total, 104B activos, con 1M de tokens de contexto y pesos abiertos que salieron a tiempo. En el índice de inteligencia de Artificial Analysis está en 57, en la zona del puesto #4 en el lanzamiento, y es el modelo al que Hy4 gana con menos claridad en las comparaciones por pares de la propia Tencent (Hy4 gana solo el 51,2% de las veces). Es realmente bueno en sesiones largas con agentes.
Lo que hay que saber es que Kimi K3 es caro y te compromete: el razonamiento no se puede desactivar en ningún nivel, y bajar el esfuerzo no lo abarata (los niveles se facturan a la misma tarifa). Con $3 de entrada / $15 de salida por 1M está en territorio de Claude Sonnet, aproximadamente 23 veces la tarifa de salida de Hy4 sin caché. Lo justifica en trabajo difícil de varios pasos; para llamadas simples es excesivo.
Ventajas: capacidad de agentes y codificación de nivel frontera, visión nativa, enorme contexto de 1M y pesos abiertos en Hugging Face.
Inconvenientes: el modelo más caro de este análisis, sin forma de desactivar el razonamiento y no acepta URL de imágenes públicas (solo base64 o ID de archivo).
Precio: $3.00 de entrada / $0.30 con acierto de caché / $15.00 de salida por 1M, según Moonshot. Los planes de la app de consumo van desde uno gratuito hasta $199/mes.
Veredicto: recurre a Kimi K3 cuando la tarea sea una ejecución de agente larga y realmente difícil y la calidad lo sea todo. Para lo rutinario, uno de los modelos más baratos de arriba hará el mismo trabajo por una décima parte de la factura.
5. Qwen 3.8 Max
Ideal para: trabajo multimodal y el ecosistema más profundo de los laboratorios chinos.
Qwen 3.8 Max, de Alibaba, es un modelo de mezcla de expertos de 2.4T / 95B que llegó a disponibilidad general a principios de agosto, con 1M de contexto y entrada nativa de imagen y vídeo. Está en el ranking de Artificial Analysis en el puesto 6 (índice ~58) y también es fuerte en los rankings de WebDev y visión de LMArena. Donde destaca del resto es el ecosistema: Qwen tiene una de las mayores familias de modelos abiertos que existen, así que hay un hermano más pequeño para casi cualquier presupuesto, y el Max alojado añade visión, modo sin razonamiento y herramientas integradas sobre la base abierta.
Una nota de justicia que siempre incluyo: los pesos base totalmente abiertos (Qwen3.8-2.4T-A95B) se publicaron, pero no son equivalentes en funciones al Max alojado, que añade la entrada de visión y el contexto de 1M por defecto. Y el miembro permisivo con licencia Apache de la familia es el más pequeño Qwen3.8-27B, no el propio Max.
Ventajas: multimodal nativo, una familia de modelos enorme y bien respaldada, un ecosistema real de herramientas y pesos base abiertos.
Inconvenientes: la licencia de Max no es Apache, las versiones alojada y abierta difieren en capacidad y, con $6 de salida, es más caro que las opciones de GLM y DeepSeek.
Precio: $2.00 de entrada / $6.00 de salida por 1M, caché implícita $0.25, según QwenCloud.
Veredicto: elige Qwen 3.8 Max si te importan la entrada multimodal y una familia amplia de modelos, o si quieres estandarizar en un solo laboratorio con muchos tamaños de modelo. En relación precio-capacidad pura, GLM-5.3-Flash sigue superándolo.
6. DeepSeek V4 Pro
Ideal para: la recuperación en contexto largo y la búsqueda de la aguja en el pajar, donde el Flash más pequeño se queda corto.
Si DeepSeek V4 Flash es la opción de presupuesto, DeepSeek V4 Pro es la opción de recuperación. Tiene más parámetros activos (clase 49B) que Flash, y se nota donde cuenta: en la tabla entre modos de la propia DeepSeek, Pro supera a Flash en SimpleQA-Verified (57,9 frente a 34,1) y en encontrar agujas en 1M de contexto. El ranking de preferencia humana de LMArena también sigue poniendo a Pro por encima de Flash. Es el modelo para cuando el trabajo consiste en leer un documento muy largo y sacar un dato preciso.
Hay una trampa que señalo a quien enruta niveles de esfuerzo: la correspondencia publicada por DeepSeek atiende una petición low en Pro como high, así que no hay ejecución barata de Pro, pagas la tarifa completa y no puedes reducir el razonamiento. Si el control de costes importa, es una razón para quedarte en Flash salvo que necesites específicamente la recuperación de Pro.
Ventajas: mejor recuperación y búsqueda en contexto largo que Flash, sigue con pesos abiertos y sigue con la misma tarifa por franja horaria que favorece los horarios no chinos.
Inconvenientes: no puedes hacer una petición Pro barata de bajo esfuerzo y cuesta unas 3 veces la tarifa de Flash sin caché.
Precio: entrada sin caché $0.66 en horas valle / $1.32 en horas punta; salida $1.98 / $3.96, según la página de precios de DeepSeek.
Veredicto: la mayoría de los equipos deberían empezar con Flash y pasar a Pro solo para las cargas concretas (preguntas sobre documentos largos, recuperación precisa) en las que Flash se queda claramente corto. No pagues Pro para todo.
7. Claude Opus 5
Ideal para: equipos que quieren calidad de primer nivel y cero infraestructura que ejecutar.
Este es el replanteamiento honesto: para muchos equipos, la verdadera alternativa a un modelo de pesos abiertos de 770B no es otro modelo de pesos abiertos, sino no ejecutar ninguno. Claude Opus 5 es el buque insignia de Anthropic, está en el puesto #1 del índice de inteligencia (por poco, con 61-63 según la instantánea) y no hay nada que ajustar en memoria. Llamas a una API y obtienes una respuesta de frontera.
La contrapartida es el precio y la apertura. Con $5 de entrada / $25 de salida por 1M es un orden de magnitud más caro que las opciones de pesos abiertos, y no hay pesos que alojar. La comunidad también señala que Opus 5 tiende a gastar más tokens de salida que su predecesor con el mismo esfuerzo, así que el coste por tarea subió incluso con la misma tarifa de lista, aunque el contraargumento es el coste por tarea exitosa. No es la opción barata; es la opción sin complicaciones y en lo más alto del ranking.
Ventajas: calidad líder de frontera, 1M de contexto sin recargo por contexto largo y cero infraestructura que ejecutar.
Inconvenientes: mucho más caro por token que los modelos abiertos, pesos cerrados y puede ser verboso con esfuerzo alto.
Precio: $5 de entrada / $25 de salida por 1M (sin cambios respecto a Opus 4.8), con lotes al 50% de descuento y lecturas de caché a 0,1x, según Anthropic.
Veredicto: si tu cuello de botella es el tiempo de ingeniería y no el presupuesto de tokens, Opus 5 es la respuesta limpia. Cambias dinero por no volver a pensar en GPU.
8. GPT-5.6
Ideal para: una API gestionada con una gama escalonada, para equilibrar coste y capacidad en cada llamada.
La otra respuesta de API gestionada es GPT-5.6, y su fuerte es el rango. En lugar de un único precio, OpenAI ofrece una escalera: gpt-5.6-luna a $0.20 de entrada / $1.20 de salida por 1M para trabajo barato de alto volumen, gpt-5.6-terra a $2 / $12 en el medio y gpt-5.6-sol a $5 / $30 en lo alto. Eso te permite ajustar el modelo al trabajo en lugar de pagar tarifas de buque insignia en cada llamada, una palanca realmente útil si tu tráfico es una mezcla de peticiones fáciles y difíciles.
El único detalle estructural que debes incluir en el cálculo: OpenAI cobra un nivel de contexto largo con forma de 2x una vez que superas el umbral de contexto, el mismo patrón que usa xAI (y uno que Anthropic y Google no usan). Así que si tu carga trabaja mucho con contexto largo, la tarifa efectiva es mayor que la de titular. GPT-5.6 Sol también queda justo detrás de Opus 5 en el índice de inteligencia, así que es una opción de frontera real, no un sustituto barato.
Ventajas: una gama escalonada que te deja ajustar el coste por llamada, un ecosistema maduro de API y herramientas y sin infraestructura que ejecutar.
Inconvenientes: pesos cerrados, y el nivel de contexto largo prácticamente duplica la tarifa en llamadas de contexto grande.
Precio: desde $0.20 / $1.20 (luna) hasta $5 / $30 (sol) por 1M, con multiplicador de contexto largo, según OpenAI.
Veredicto: si te gusta la idea de una API gestionada pero la tarifa plana de Opus 5 te parece pesada para tu tráfico fácil, los niveles de GPT-5.6 son la opción más flexible. Solo modela el recargo de contexto largo antes de comprometerte.
Las dos familias, en una imagen
Si das un paso atrás, cada opción de aquí cae en uno de dos campos: pesos abiertos que puedes ejecutar o alquilar barato, y APIs gestionadas donde no ejecutas nada. Este mapa es como le explicaría la elección a un compañero en diez segundos.
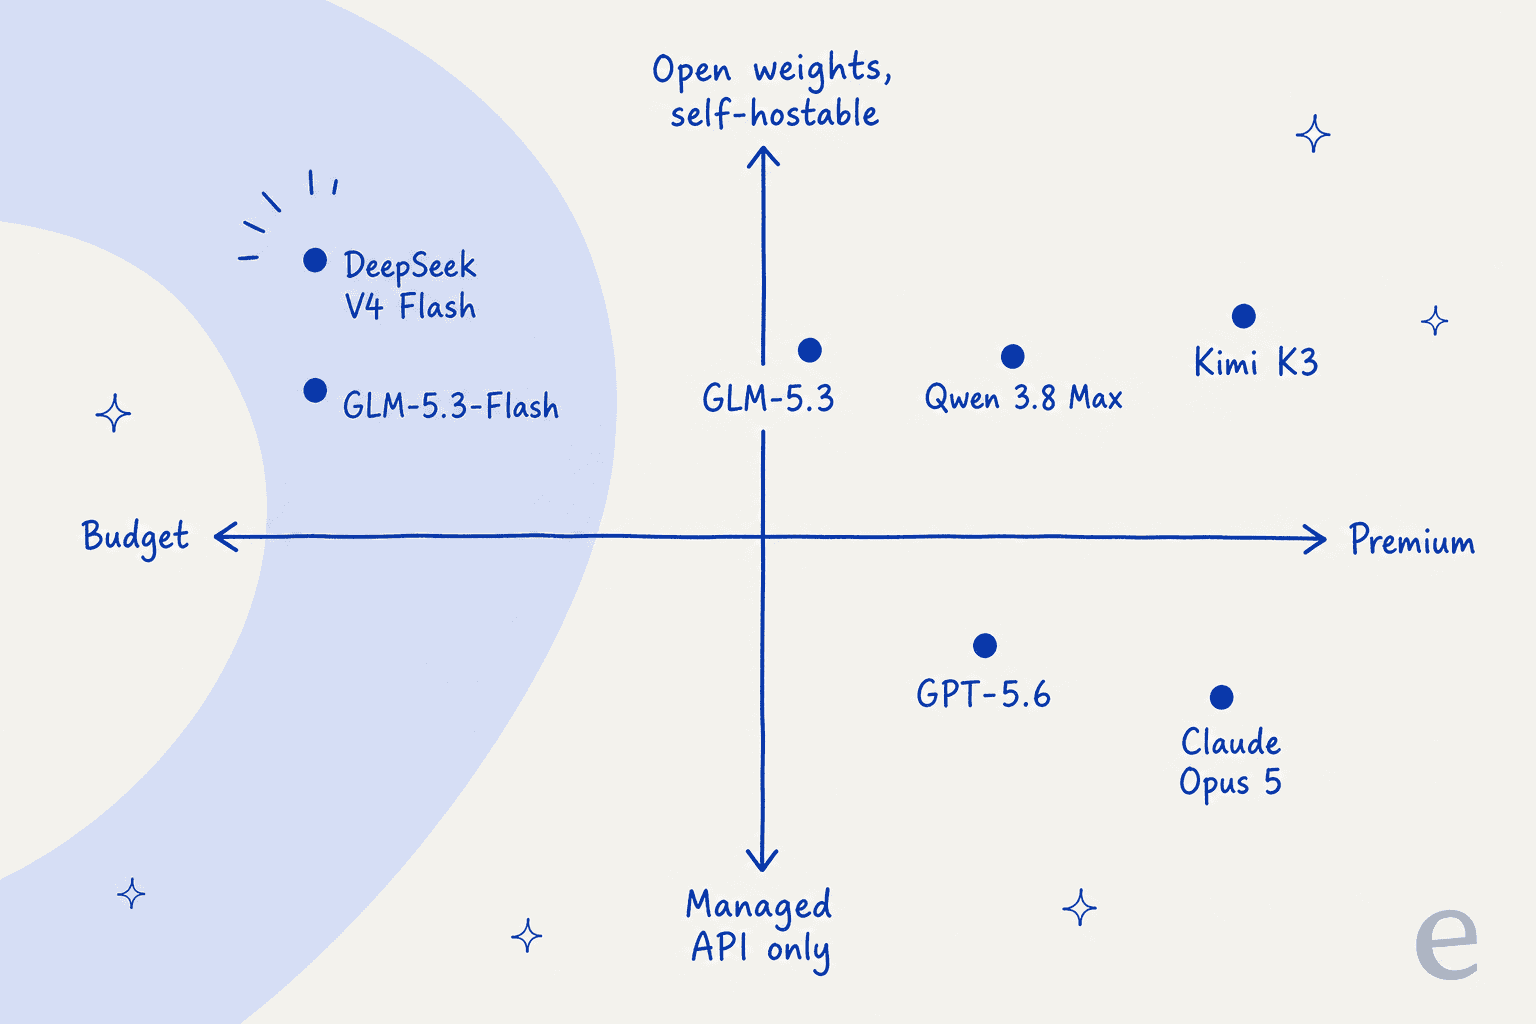
Si el control y el coste fueron lo que te alejó de Hy4, quédate en la fila superior de pesos abiertos y empieza con GLM-5.3-Flash o DeepSeek V4 Flash. Si fue el esfuerzo de ejecutar un modelo de 770B, baja a la fila gestionada y deja que Anthropic u OpenAI carguen con la infraestructura.
Prueba eesel
Hay algo que todos los modelos de esta lista tienen en común: son infraestructura en bruto. Elegir Hy4 o cualquier alternativa es elegir un motor. Todavía tienes que construir el coche alrededor: la conexión con tu centro de ayuda, las barreras de seguridad, las integraciones y alguna forma de probarlo antes de que responda a un cliente real.
Si el motivo por el que comparas modelos es el soporte al cliente, eesel se salta toda esa construcción. Es un compañero de IA para el helpdesk que ya funciona sobre modelos de frontera, así que heredas la calidad del modelo sin tener que elegirlo, alojarlo ni ajustarlo en VRAM. Se conecta a herramientas como Zendesk, Freshdesk y Slack, aprende de tus tickets pasados y de tu centro de ayuda y, lo que más me importa como alguien que ha visto bots seguros de sí mismos dar respuestas seguramente erróneas, te permite simular con miles de tus tickets históricos reales antes de que responda a nadie en directo.

Así que si llegaste hasta aquí comparando modelos para construir un agente de soporte, vale la pena preguntarse si necesitas el modelo o el compañero ya terminado. Puedes probar eesel gratis, y se conecta a tu helpdesk actual en pocos minutos.