

Tencent Hy4 preview tiene dos precios, y el que todo el mundo cita es el más pequeño. En la API cuesta $0.834 por millón de tokens de entrada y $2.501 por millón de salida, con la entrada en caché a $0.042 (anuncio oficial). Entre los modelos insignia de pesos abiertos con los que se compara, es el asiento barato.
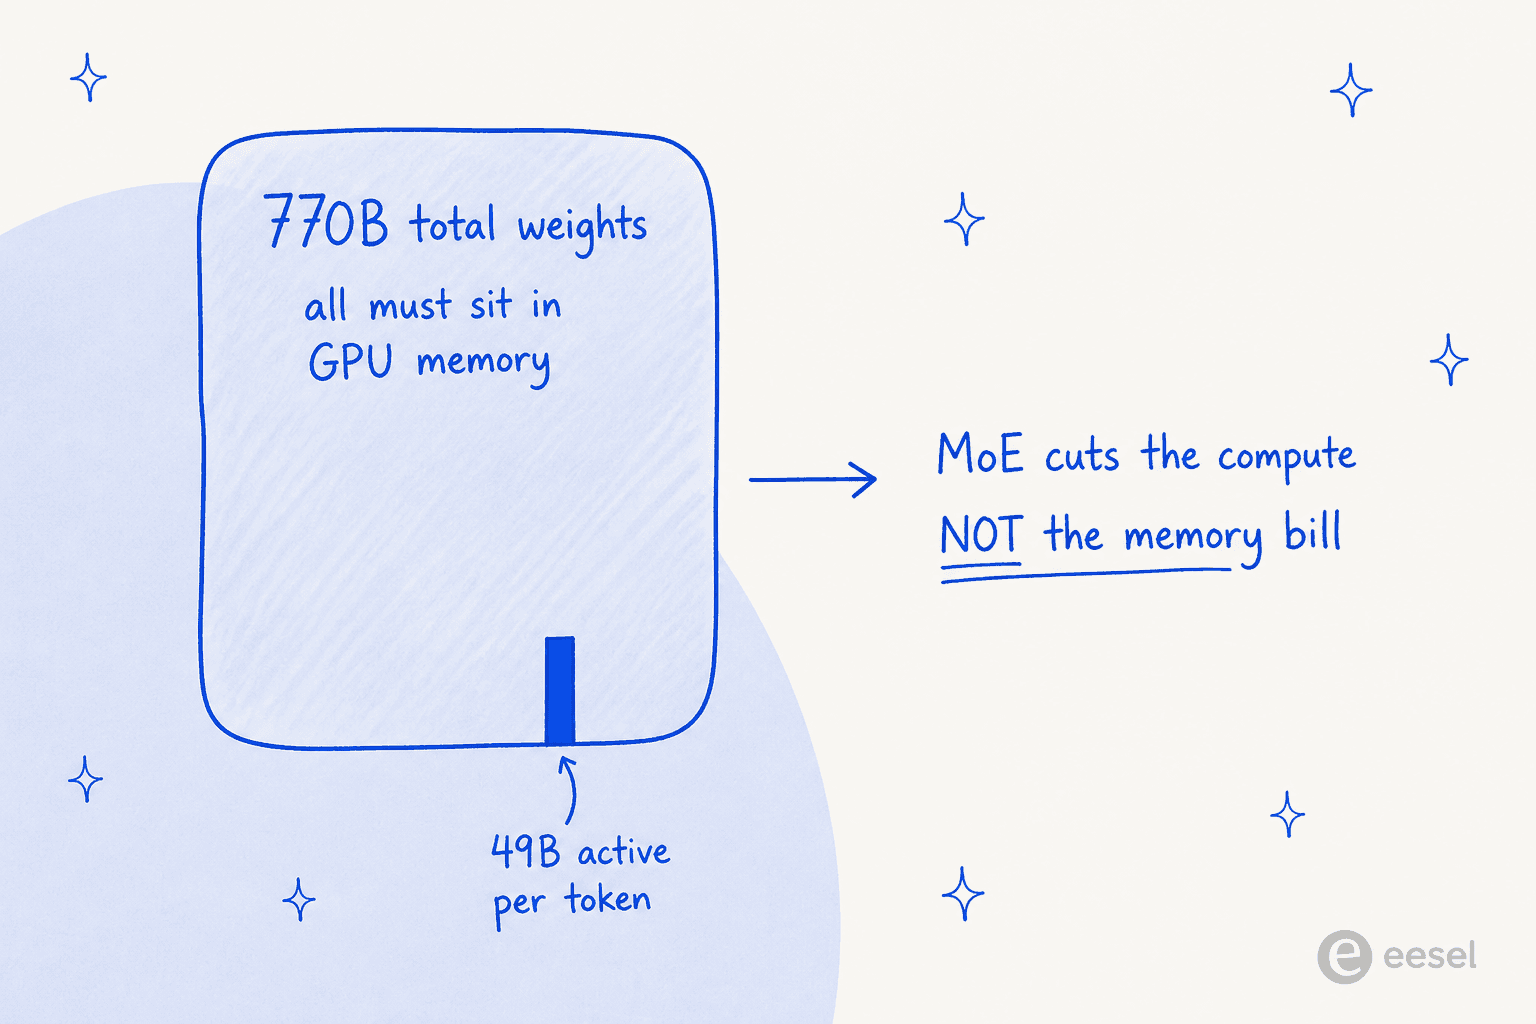
La cifra más grande es el hardware. Hy4 es un modelo Mixture-of-Experts de 770B parámetros, y MoE reduce el cómputo por token, no la factura de memoria, así que los 770B pesos tienen que estar a la vez en la memoria de la GPU. Ejecutarlo tú mismo significa 16x B200 u 8x B300, un nodo de centro de datos, no una estación de trabajo.
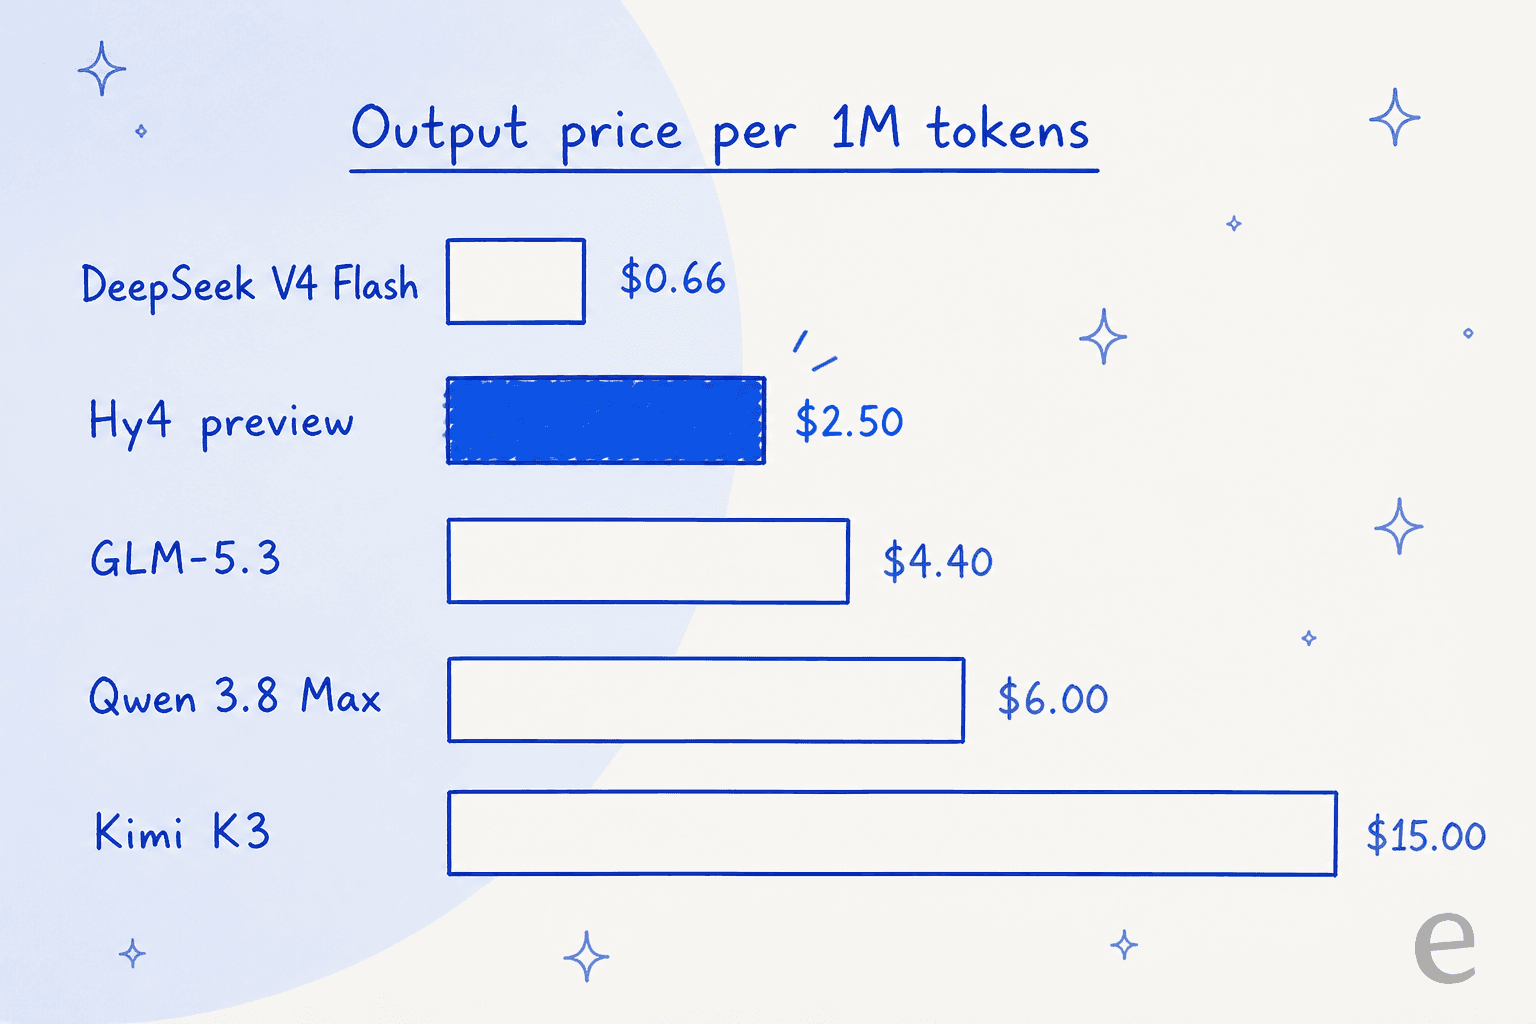
Así que la lectura honesta sobre los precios de Tencent Hy4: alquilado por API tiene un precio competitivo, más barato que Kimi K3 o Qwen 3.8 Max, aunque DeepSeek V4 Flash sigue siendo mucho más barato. Si intentas tenerlo en propiedad, el precio es una partida de capital seria. Y es 5-6x más caro que el Hy3 al que sustituye, así que los usuarios actuales no deberían dar por hecho una mejora gratuita.
Si lo que realmente quieres es un trabajo terminado en lugar de un modelo aprovisionado, un compañero de IA listo para usar es un camino más corto y a menudo más barato que todo esto.
Precios de la API de Tencent Hy4 de un vistazo
Paso la mayor parte de la semana pensando en cómo buscan realmente los compradores herramientas como esta, y "precios de Tencent Hy4" casi siempre son en realidad dos preguntas: cuánto cuesta un token y cuánto cuesta ejecutarlo todo. Empecemos por la pregunta del token, porque es la sencilla.
Estas son las tarifas publicadas de la API, directamente del anuncio de lanzamiento de Tencent, todas por millón de tokens:
| Contador | Precio por 1M de tokens | Qué cubre |
|---|---|---|
| Entrada | $0.834 | Cada token que envías (prompt, contexto, documentos recuperados) |
| Salida | $2.501 | Cada token que el modelo genera de vuelta |
| Entrada en caché | $0.042 | Tokens de entrada servidos desde la caché en un prompt repetido |
Hay tres cosas que merece la pena destacar de esa tabla.
Primero, la proporción entre salida y entrada es de aproximadamente 3:1, lo normal en un modelo con mucho razonamiento. Como Hy4 es un gran razonador (más sobre eso abajo), tus facturas se inclinarán hacia el contador de salida, así que esa cifra de $2.501 es la que hay que usar para planificar, no la de $0.834 de los titulares.
Segundo, la tarifa de caché es muy barata, $0.042. Si tu carga repite un prompt de sistema grande o una base de conocimiento fija en muchas llamadas, y la mayoría de las cargas agénticas lo hacen, los aciertos de caché reducen el precio efectivo de entrada en unas 20 veces. Es una palanca real, y es lo que distingue a un agente de IA bien construido de un chatbot basado en reglas o de un wrapper ingenuo que paga la tarifa completa por cada token.
Tercero, no hay un plan gratuito permanente. La prueba tiene un límite de tiempo (dos semanas en las apps de Tencent) y después cada token se mide y se cobra.
Estima tu factura mensual de Tencent Hy4
Las tarifas por millón de tokens son difíciles de visualizar. Introduce un volumen mensual aproximado y mira cuánto cuesta Hy4 frente a los demás modelos abiertos insignia. La calculadora asume las tarifas estándar sin caché para todos los modelos.
El precio que nadie cita: ejecutarlo tú mismo
Aquí es donde "pesos abiertos" se vuelve caro, y es lo más importante que hay que entender antes de entusiasmarse con que Hy4 sea de código abierto. La licencia Apache 2.0 significa que tienes permitido ejecutarlo en cualquier sitio. El hardware decide si puedes hacerlo y cuánto cuesta.
La receta de vLLM es directa sobre el mínimo. Los pesos completos en BF16 son unos 1.848 GB. Incluso los pesos cuantizados MXFP8 son ~924 GB. El mínimo de la propia receta: "16xB200 or 8xB300 minimum for weights + KV cache." Un único nodo de 8x H100 (640 GB) no puede contenerlo.
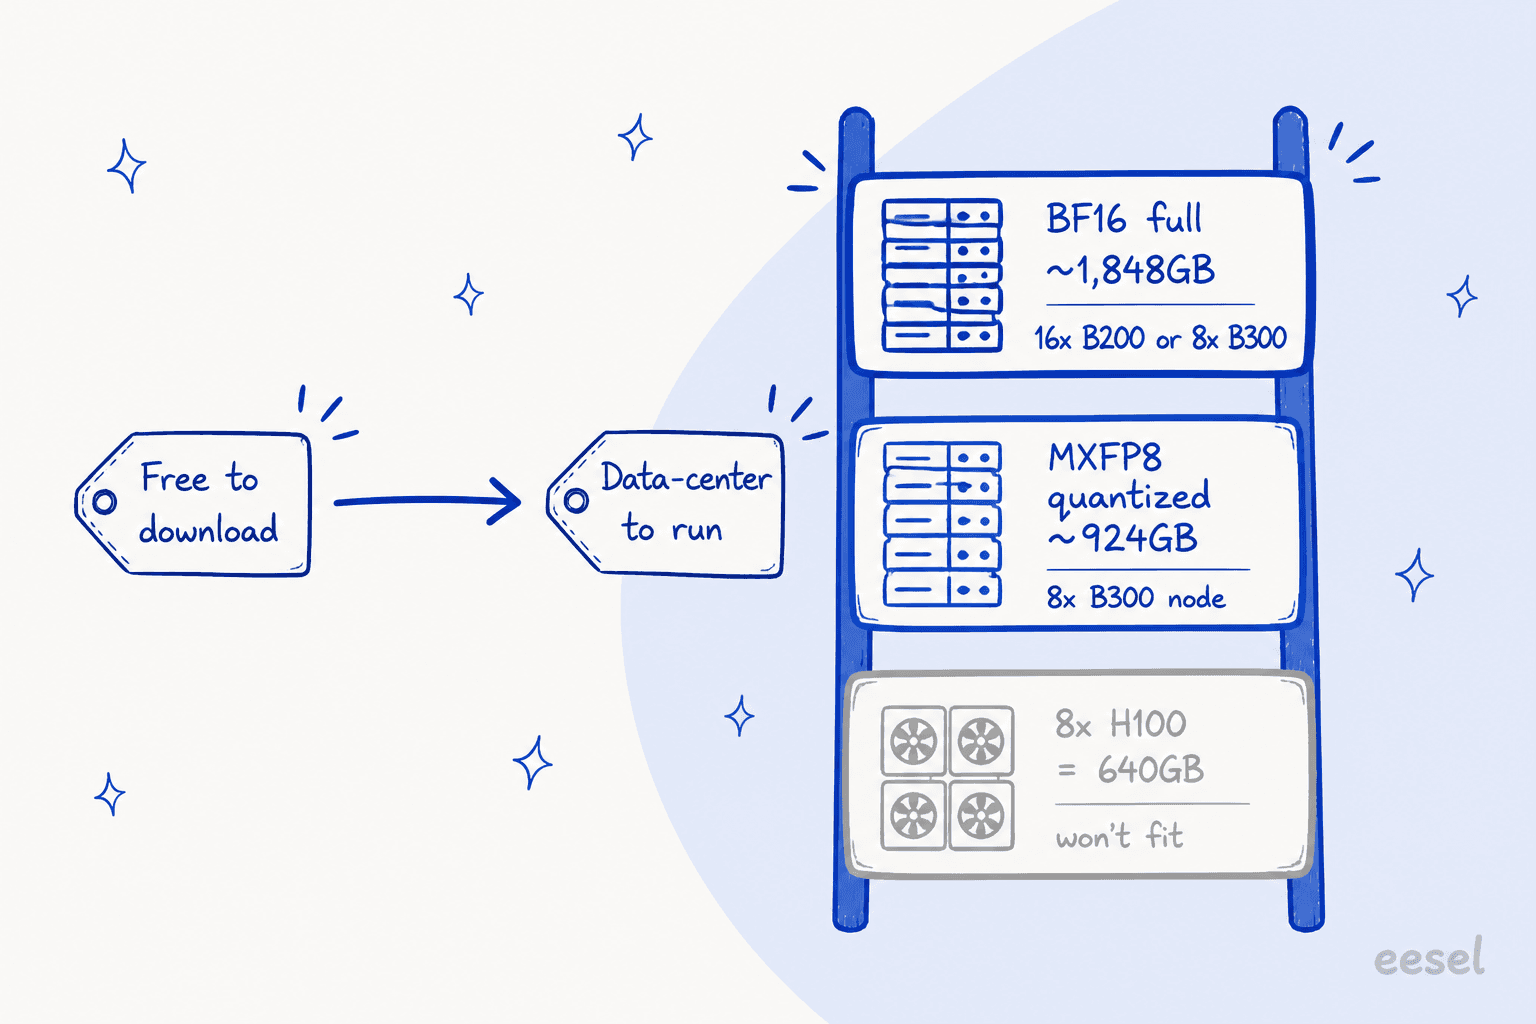
Pongamos cifras aproximadas. Alquilar un nodo de 8x B200 a un proveedor de GPU en la nube ronda las decenas de miles de dólares al mes, y la receta completa en BF16 pide dos. Comprar el silicio directamente es una compra de capital de seis cifras antes de encenderlo. Ese es el precio real de Tencent Hy4 para quien quiera ser dueño de su inferencia, y supera con creces la tarifa por token salvo que uses la máquina con una utilización muy alta.
La gente de r/LocalLLaMA, que ejecuta modelos grandes en casa como hobby, lo recibió con partes iguales de admiración y resignación:
The amount of people who can drop $5-10k to run these locally is vanishingly small.

La cuenta de cuantización que hicieron es útil si te tienta. Un GGUF Q4 ronda los 450 GB, así que 512 GB de memoria es el mínimo realista, y una máquina de 256 GB solo admite las cuantizaciones de 1-2 bits. Un desglose detallado lo dijo claro: si tienes 256 GB, te conviene mucho más GLM-5.3-Flash. Para uso local, un modelo más pequeño y bien postentrenado sigue ganando el argumento del coste.
La conclusión sobre precios: para casi todo el mundo, "usar" Hy4 significa la API. Alojarlo tú mismo es un proyecto de centro de datos, no una partida de presupuesto.
Precios de Tencent Hy4 frente a los demás modelos insignia de pesos abiertos
Así se sitúa Hy4 frente a sus rivales, todo por millón de tokens, comprobado el 30 de agosto de 2026.
| Modelo | Parámetros totales / activos | Contexto | Entrada | Salida | Entrada con acierto de caché |
|---|---|---|---|---|---|
| Hy4 preview (Tencent) | 770B / 49B | 1M | $0.834 | $2.501 | $0.042 |
| DeepSeek V4 Flash | 284B / 13B | 1M | $0.22 / $0.44 | $0.66 / $1.32 | $0.007 |
| DeepSeek V4 Pro | 49B-class active | 1M | $0.66 / $1.32 | $1.98 / $3.96 | $0.022 |
| Qwen 3.8 Max | 2.4T / 95B | 1M | $2.00 | $6.00 | $0.25 |
| Kimi K3 | 2.8T / 104B | 1M | $3.00 | $15.00 | $0.30 |
| GLM-5.3 | no divulgado | n/d | $1.40 | $4.40 | $0.26 |
El gráfico cuenta la misma historia más rápido. En el contador que domina la mayoría de las facturas, la salida, Hy4 es el segundo más barato de este grupo, solo por detrás de DeepSeek V4 Flash.
Dos salvedades honestas acompañan a ese precio.
Primero, Hy4 es aproximadamente 5-6x más caro que Hy3, como se señaló en el hilo de precios de la comunidad. Si ya usas Hy3, es un salto de coste real, no un descuento, y debes decidir si la capacidad extra cambia tus resultados.
Segundo, DeepSeek V4 Flash es drásticamente más barato en ambos contadores, y en mucho trabajo agéntico gana lo de "barato y suficientemente bueno". Un desarrollador lo dijo sin rodeos tras hacer una prueba real:
even mimo 2.5 was same good and on 1/20 of the costs... the model is interesting if the price is lower but not for 2.5 USD per million output.
Ese es el centro de la posición de precio de Hy4: no es el más barato y no intenta serlo. Es la opción de precio medio que te da resultados de código de nivel frontera y un contexto de 1M, y si vale la pena el sobrecoste frente a DeepSeek o un modelo de gama Flash depende por completo de cuánto mejore tus cifras la calidad extra.
Cómo probar Hy4 barato (o gratis)
Si quieres probarlo antes de comprometer un presupuesto, hay varias vías de bajo coste:
- Gratis durante dos semanas en las apps WorkBuddy y CodeBuddy de Tencent desde el lanzamiento. Sin coste de tokens durante la ventana.
- OpenRouter, que lista Hy4 preview con una política de datos de retención cero. Útil si quieres una sola clave de API para muchos modelos y te importa el tratamiento de los datos.
- Tencent Cloud TokenHub, la vía de primera mano si ya estás en la nube de Tencent.
Para la mayoría de los compradores, lo inteligente es hacer un piloto pequeño en la ventana gratuita, medir tu reparto real entre entrada y salida (usa la calculadora de arriba con esas cifras) y solo entonces decidir si la tarifa de Hy4 supera a la de un modelo más barato para tu carga concreta.
Qué compra realmente el precio de Hy4 y dónde se escapa
Un matiz más de precios que no aparece en la tarifa. Tencent reconoce abiertamente que esta preview razona más de lo necesario y verifica en exceso su propio trabajo. En un modelo que cobra por token, un exceso de razonamiento infla tu factura sin que lo notes, porque pagas cada uno de esos tokens de salida extra. Así que el coste efectivo de Hy4 en una tarea conversacional y cargada de verificación puede ser mayor de lo que sugiere la tarifa de lista, que es justo lo que solo se ve una vez en producción.
Esa es la brecha a la que vuelvo una y otra vez. La tarifa en bruto de un modelo te dice lo que cuesta un token. No te dice cuántos tokens necesitará el trabajo, si tus prompts aciertan en la caché, cuánto gastarás en reintentos ni cuánto vale el tiempo de ingeniería para integrarlo todo. Esas son las cifras que deciden la factura real, y son las que un benchmark o una tabla de precios nunca muestran.
Si quieres más contexto de especificaciones y benchmarks detrás de estos precios, la reseña completa de Tencent Hy4 y la visión general de Hy4 explican por qué estás pagando.
Y si lo valoras puramente por coste, estos desgloses son las siguientes lecturas naturales:
- Precios de Qwen 3.8 Max
- Precios de Kimi K3 y la reseña de Kimi K3
- Precios de Gemini
- Precios de Mistral
- DeepSeek V4, el actual suelo de precios
Prueba eesel: contrata al compañero y olvídate de la cuenta de tokens
Así lo planteo tras años viendo a equipos elegir modelos. Un modelo como Hy4 es infraestructura, un motor sin coche alrededor. eesel AI es el empleado. En lugar de elegir un modelo, aprovisionar GPU o medir tokens y construir tú mismo la recuperación, los guardarraíles, las integraciones y las evaluaciones, contratas a un compañero de IA listo para trabajar en una tarea concreta y llega sabiendo ya cómo hacerla.

Ahora mismo el equipo son dos compañeros. El compañero de IA para helpdesk se une a tu cola existente en Zendesk, Freshdesk o una bandeja compartida, se entrena con tus tickets anteriores y tu centro de ayuda, y redacta o envía respuestas. Puedes simularlo con tickets históricos antes de que responda a un solo cliente, para conocer de antemano el coste y el comportamiento en lugar de activar un interruptor y esperar. El redactor de blog con IA se encarga de la investigación, la redacción y el SEO de un artículo largo en una sola ejecución.
Ambos funcionan con modelos de frontera por debajo, así que obtienes la capacidad sin aprovisionar una sola GPU ni leer una tabla de tarifas, y los precios mensuales fijos de eesel (desde $299/mes por 500 créditos) son una cifra predecible en lugar de un contador de tokens en bruto que tengas que prever. Puedes empezar gratis, sin tarjeta de crédito y sin llamada comercial.
¿Quieres las cuentas de principio a fin en lugar de una tarifa por token? Estos artículos lo concretan: