

Tencent Hy4 preview es un modelo open-weight impresionante y, para la mayoría de la gente, uno que alquilarás en lugar de ejecutar. Es un modelo Mixture-of-Experts con 770B de parámetros totales, 49B activos por token y una ventana de contexto de 1M de tokens, publicado como open-weight bajo Apache 2.0 en Hugging Face el 28 de agosto de 2026.
En benchmarks se sitúa en la primera línea de los modelos abiertos: 92,3 en GPQA Diamond, 82,9 % en SWE-bench Multilingual y ligeramente por delante de Kimi K3 y GLM-5.3 en la evaluación ciega de Tencent. Pero su propio gráfico publicado muestra que alterna victorias y derrotas con esos rivales, así que "a la par de los mejores modelos abiertos" es la lectura honesta, no "los supera a todos".
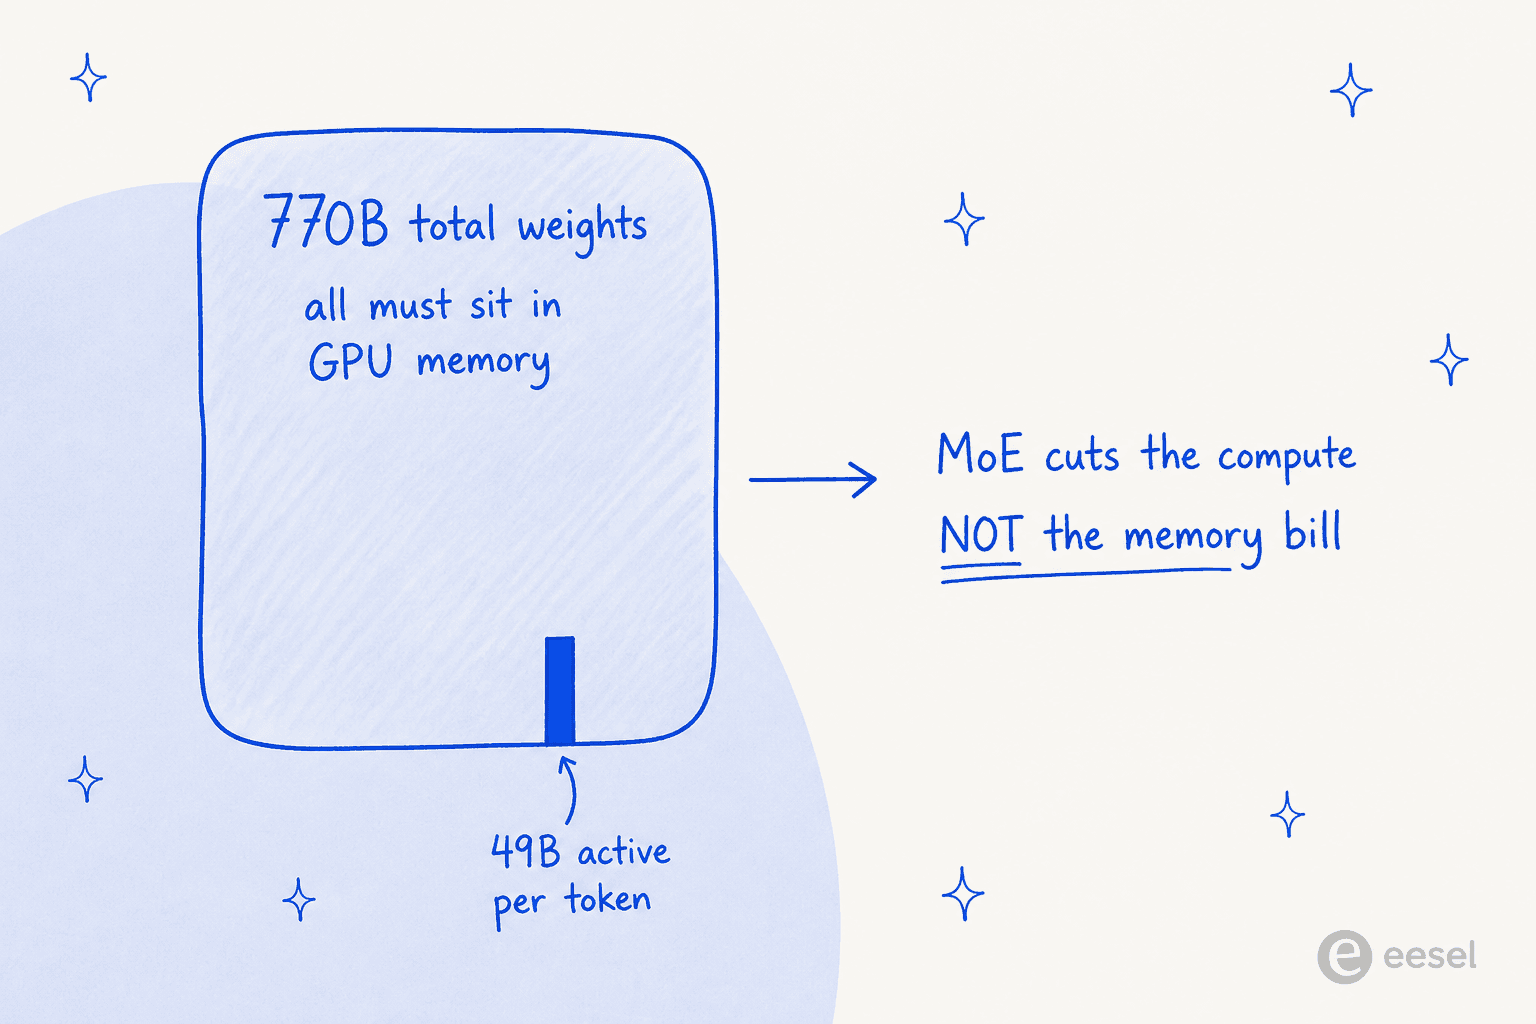
La pega es ejecutarlo. MoE reduce el cómputo por token, no la factura de memoria: los 770B pesos tienen que estar en la memoria de la GPU, así que hablamos de 16x B200 u 8x B300 para el modelo completo. Por API cuesta $0,834 de entrada / $2,501 de salida por millón de tokens, lo que queda por debajo de Qwen 3.8 Max y Kimi K3, pero es 5-6 veces más caro que el Hy3 al que sustituye, y DeepSeek V4 Flash sigue siendo mucho más barato.
¿Para quién es? Para equipos que construyen herramientas agénticas de programación o investigación, que quieren pesos abiertos y una licencia permisiva, y que tienen (o alquilan) el hardware. Si solo quieres el resultado, un ticket de soporte respondido o un blog redactado, un compañero de IA ya listo es un camino más corto que montar tú mismo un modelo de 770B.
Qué ha lanzado realmente Tencent
Me dedico a construir los agentes de IA que se apoyan en modelos como este, así que un nuevo modelo insignia open-weight es la parte de mi semana que de verdad espero con ganas. He pasado los últimos años viendo qué separa a un modelo que luce en una demo de uno que sobrevive a una cola de producción real, y Hy4 es una buena prueba de esa brecha.
Aquí va la versión corta de lo que llegó. El equipo Hunyuan de Tencent lanzó y publicó como código abierto Hy4 preview el 28 de agosto de 2026, posicionándolo como "built for real-world productivity tasks... across coding, office work, and scientific research." Es el sucesor de la línea Hy3 de julio, y Tencent lo lanza con la fórmula "primero preview, versión oficial después", el mismo ritmo de antes.
Las especificaciones principales, directamente de la tarjeta del modelo:
- 770B de parámetros totales, 49B activos por token (un diseño Mixture-of-Experts).
- 78 capas, con 256 expertos enrutados más 1 experto compartido; cada token activa los 8 mejores expertos enrutados.
- Ventana de contexto de 1M de tokens.
- Licencia Apache 2.0, con un modelo BF16 y una versión cuantizada FP8 oficial publicados a la vez.
Un detalle que me pareció interesante: Tencent dice que Hy4 participó en su propio desarrollo, proponiendo y ejecutando experimentos sobre métodos de entrenamiento y operadores de bajo nivel, y que optimizó de forma autónoma su propio stack de inferencia para una mejora del 31,8 % en el rendimiento. Lo llaman "an early-stage recursive self-improvement loop." Es un enfoque de marketing sobre un resultado real, pero es el tipo de afirmación que conviene archivar.
Cómo funciona realmente la cuenta de 770B / 49B
Si Mixture-of-Experts es nuevo para ti, las dos cifras grandes parecen contradictorias: ¿cómo puede un modelo de 770B ser solo "49B" de algo? La respuesta es que MoE divide la red en muchas subredes expertas y, para cada token, un enrutador elige un puñado pequeño para ejecutarlas. Así, el cómputo por token se comporta como el de un modelo de ~49B, que es lo que mantiene a Hy4 lo bastante rápido para servirlo.
La trampa es suponer que un número activo menor significa un hardware menor. No es así. Cada uno de esos 770B pesos tiene que estar residente en la memoria de la GPU, porque el enrutador podría elegir cualquier experto para el siguiente token. MoE te da matemáticas más baratas, no una máquina más barata.
Por dentro hay más ingeniería de la que deja ver la hoja de especificaciones: la atención usa Gated DeepSeek Sparse Attention con un IndexCache para reutilizar índices dispersos entre capas, y hay una capa nativa de predicción de múltiples tokens añadida para la decodificación especulativa. Si has seguido los artículos de arquitectura de DeepSeek y GLM, mucho de esto te sonará, lo cual es en sí mismo una señal de lo rápido que la frontera open-weight converge en los mismos trucos.
Los benchmarks, leídos con honestidad
Hy4 rinde bien en benchmarks. En las puntuaciones verificadas que muestra Hugging Face, alcanza 92,3 en GPQA Diamond, 82,9 % resueltos en SWE-bench Multilingual, 65,7 en SWE-bench Pro y 64,3 en Deep SWE. Para un modelo open-weight, son cifras sólidas de programación y razonamiento, y la comunidad lo notó. Un comentarista del hilo de benchmarks completos resumió el ánimo:
For a 770B parameters model, it's impressive.

La comparación con la que Tencent abre es una evaluación ciega interna: 163 expertos puntuaron resultados en 203 tareas de ingeniería, sobre 4,00. Hy4 obtuvo 2,99, por delante de Kimi K3 (2,94) y GLM-5.3 (2,92). Es un resultado real, pero es la prueba de Tencent, y una diferencia de 0,05 puntos en una escala de 4 es un casi empate, no un nocaut.
Su propio gráfico público cuenta la historia completa, y vale la pena mirarlo en lugar de fiarse del resumen. Frente a Claude Opus 5 y GPT-5.6 Sol, Hy4 (azul oscuro) suele ir por detrás; frente a Kimi K3 y GLM-5.3 intercambia golpes benchmark a benchmark.
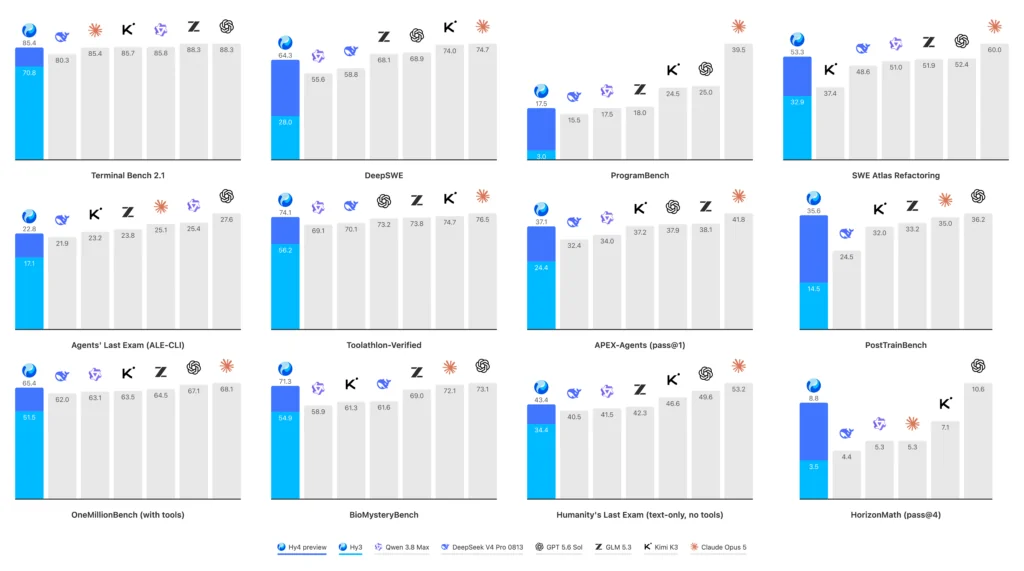
El lector más agudo del hilo de r/LocalLLaMA hizo el recuento que el marketing no hizo:
I don't think their own chart backs the beats glm and kimi line. Against kimi k3 it's behind on 7 of the 12 benchmarks... The beats claim comes from the internal blind test where wins only beat losses 47 to 40 against glm.
De forma independiente, la cuenta oficial de Arena informó de que Hy4 quedaba en torno al puesto 5 en la clasificación WebDev de Code Arena con 1.633 puntos, más o menos el 3.º entre los modelos abiertos, aunque señaló que es una colocación temprana de AutoEval (un modelo de recompensa votando en lugar de votos humanos en vivo), no un puesto definitivo. Y todavía no aparece en el índice de Artificial Analysis, así que no hay una puntuación de inteligencia independiente que citar. Mi lectura: es un modelo abierto de primer nivel y fuerte, no el nuevo n.º 1, y el planteamiento de "supera a todos" es la parte que descontaría.
Otra cosa que Tencent reconoce abiertamente y que respeto: esta preview razona más de lo necesario y verifica en exceso su propio trabajo. Lanzan pronto a propósito, igual que hizo la preview de Hy3 antes de que su versión final, según se dice, mejorara un 50-100 %.
¿Se puede ejecutar de verdad?
Aquí es donde la etiqueta "open-weight" se complica, y es lo más importante que hay que entender antes de entusiasmarse. Los pesos abiertos y una licencia Apache 2.0 significan que se te permite ejecutar Hy4 donde quieras. El hardware decide si puedes.
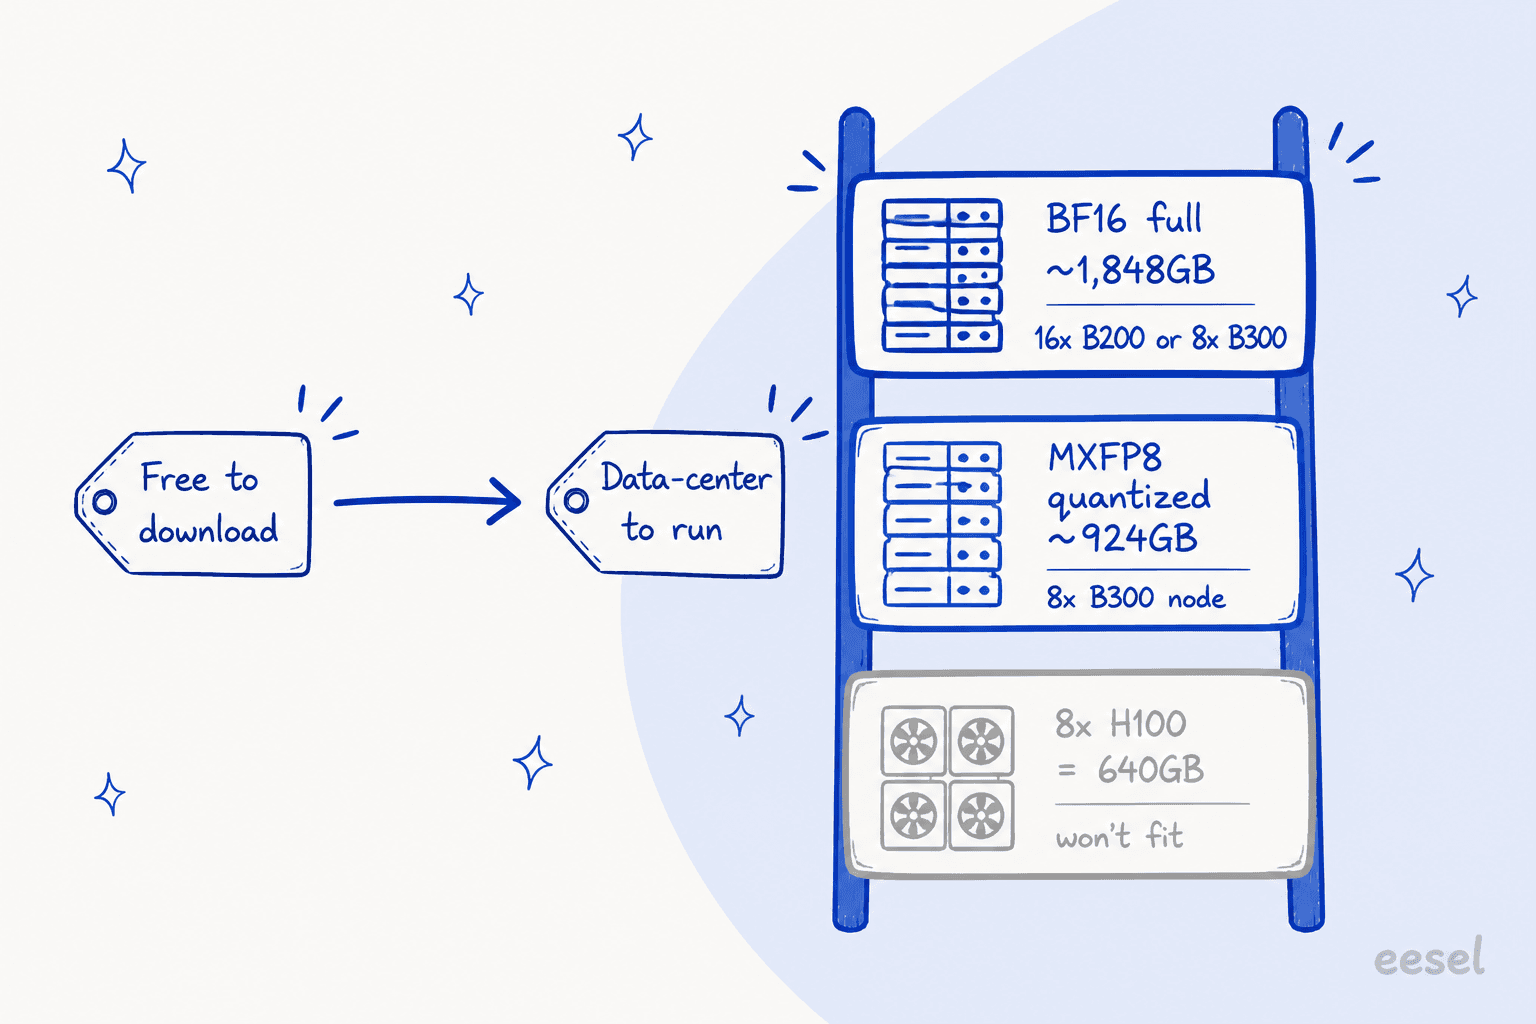
La receta de vLLM es contundente. Los pesos completos en BF16 son unos 1.848 GB. Incluso los pesos cuantizados MXFP8 son ~924 GB. El mínimo de la propia receta: "16xB200 or 8xB300 minimum for weights + KV cache." Un único nodo de 8x H100 (640 GB) no puede alojarlo. Es un modelo de centro de datos, y punto.
La gente de r/LocalLLaMA, que ejecuta modelos grandes en casa como afición, lo recibió con partes iguales de admiración y resignación:
The amount of people who can drop $5-10k to run these locally is vanishingly small.
La cuenta práctica de cuantización que hicieron es útil si te tienta: un GGUF Q4 ronda los 450 GB, así que 512 GB es el mínimo realista, y una máquina de 256 GB solo admite las cuantizaciones de 1-2 bits. Como lo resumió un desglose detallado: "if you have 256GB, you'll probably be much better off with GLM-5.3-Flash Q4." Ese es el veredicto recurrente: para uso local, un modelo más pequeño y bien posentrenado es la elección más inteligente, y los modelos Flash de Z.AI siguen apareciendo como los que conviene elegir.
Así que, de forma realista, "usar" Hy4 significa la API o una de las apps de Tencent, no tu propia máquina.
Cuánto cuesta Tencent Hy4
En la API, Hy4 preview cuesta $0,834 por millón de tokens de entrada y $2,501 por millón de salida, con entrada en caché a $0,042 (anuncio oficial). Entre los modelos abiertos insignia con los que se compara, es la opción barata.
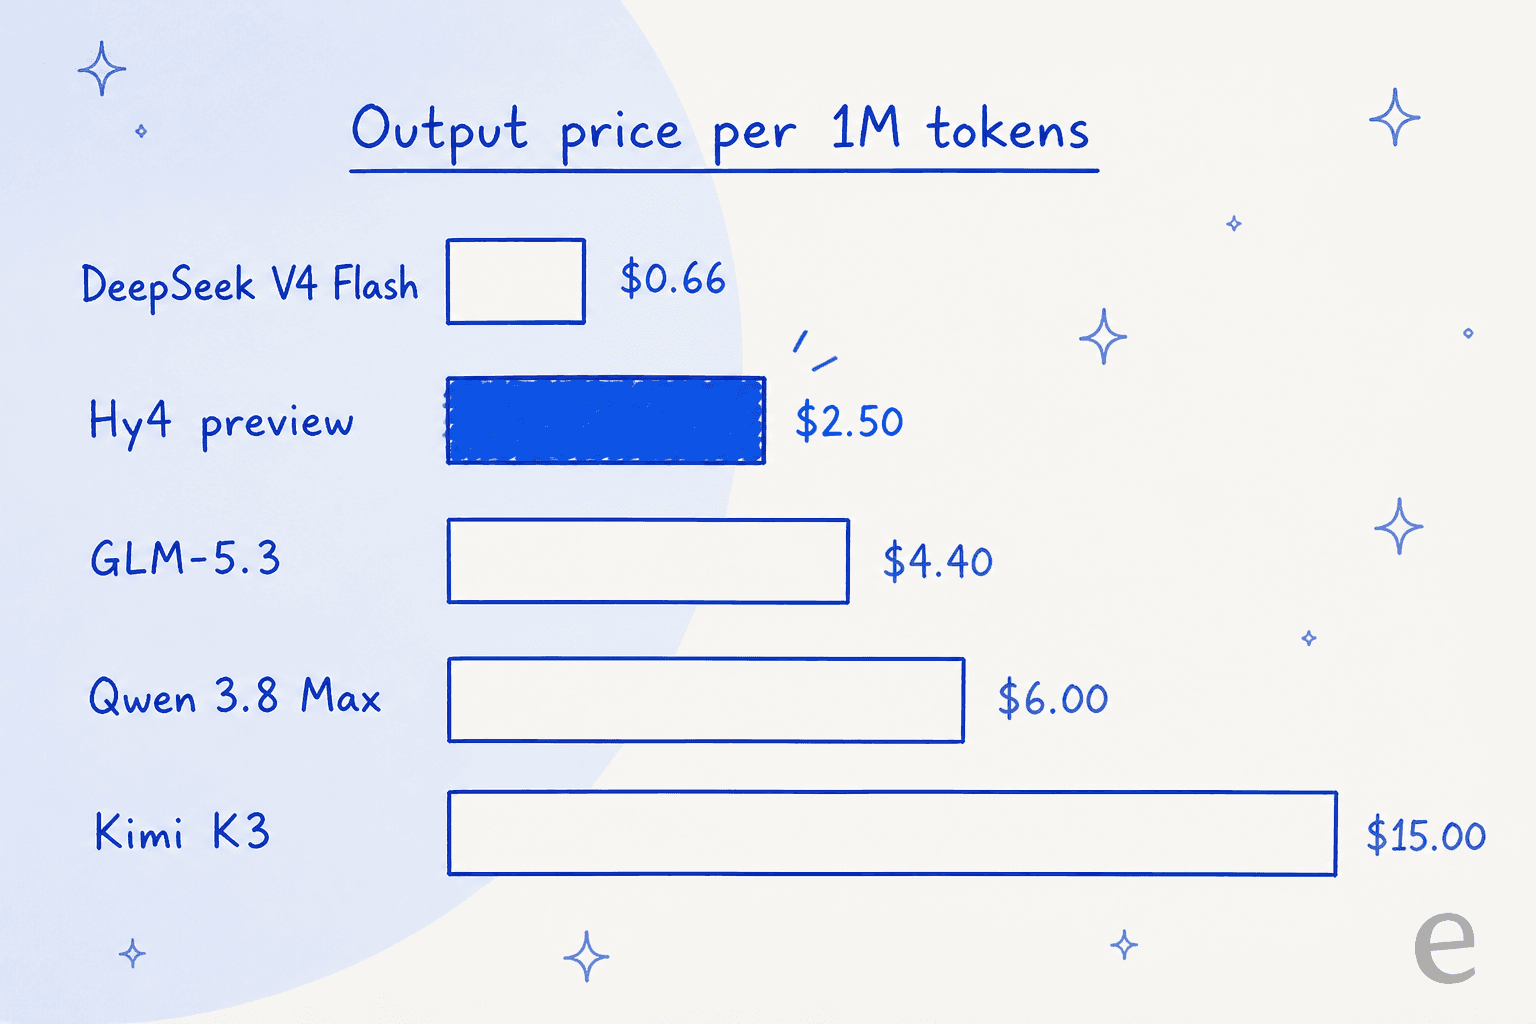
Este es el panorama completo frente a sus rivales, todo por millón de tokens:
| Modelo | Parámetros totales / activos | Contexto | Entrada | Salida | Entrada con acierto de caché |
|---|---|---|---|---|---|
| Hy4 preview (Tencent) | 770B / 49B | 1M | $0.834 | $2.501 | $0.042 |
| DeepSeek V4 Flash | 284B / 13B | 1M | $0.22 / $0.44 | $0.66 / $1.32 | $0.007 |
| DeepSeek V4 Pro | 49B-class active | 1M | $0.66 / $1.32 | $1.98 / $3.96 | $0.022 |
| Qwen 3.8 Max | 2.4T / 95B | 1M | $2.00 | $6.00 | $0.25 |
| Kimi K3 | 2.8T / 104B | 1M | $3.00 | $15.00 | $0.30 |
| GLM-5.3 | no divulgado | n/d | $1.40 | $4.40 | $0.26 |
Encima hay dos matices honestos. Primero, Hy4 es aproximadamente 5-6 veces más caro que Hy3, así que si ya usas Hy3 es un salto de coste real, no un descuento. Segundo, DeepSeek V4 Flash sigue siendo drásticamente más barato en ambos contadores, y para mucho trabajo agéntico gana lo "barato y suficientemente bueno". Un desarrollador hizo una prueba real y lo dijo sin rodeos:
even mimo 2.5 was same good and on 1/20 of the costs... the model is interesting if the price is lower but not for 2.5 USD per million output.
Si quieres probarlo sin pagar, Hy4 es gratis durante dos semanas en WorkBuddy y CodeBuddy, y está listado en OpenRouter (con una política de datos de retención cero, un detalle agradable frente a algunas API propias chinas).
Entonces, ¿para quién es realmente Tencent Hy4?
Tras unos días con él y con las pruebas de la comunidad, aquí es donde aterrizo.
Recurre a Hy4 si estás construyendo herramientas agénticas de programación, automatización de oficina o investigación, quieres específicamente pesos abiertos y una licencia permisiva Apache 2.0, y tienes el hardware (o el presupuesto de API) para ejecutar un modelo de escala de frontera. Las puntuaciones de programación y matemáticas son reales, la ventana de contexto es enorme y el precio queda por debajo de los otros modelos abiertos insignia.
Déjalo pasar si ejecutas modelos en local en una estación de trabajo (un modelo de nivel Flash bien posentrenado te servirá mejor con una fracción de la memoria), si el coste bruto por token es tu palanca principal (DeepSeek V4 Flash es mucho más barato) o si solo quieres un trabajo terminado y no te importa qué modelo lo haga.
Ese último caso es el que veo más a menudo, y conviene ser honestos: la mayoría de quienes preguntan "¿debería usar Hy4?" en realidad no quieren un modelo. Quieren una cola de soporte despejada, un blog redactado o una tarea de investigación terminada. Un modelo de 770B en bruto es un motor brillante sin coche alrededor: todavía tienes que construir la recuperación de información, las barreras de protección, las integraciones, las evaluaciones y la lógica de respaldo antes de que haga algo útil en producción. Esa es la brecha entre un benchmark impresionante y algo que sobrevive al tráfico real, y es la parte en la que paso el día entero.
Prueba eesel: contrata al compañero, sáltate la fontanería del modelo
Así lo veo yo: modelos como Hy4 son infraestructura. eesel AI es el empleado. En lugar de elegir un modelo y cablear todo lo que lo rodea, contratas a un compañero de IA listo para trabajar en una tarea concreta, y llega sabiendo ya cómo hacerla.
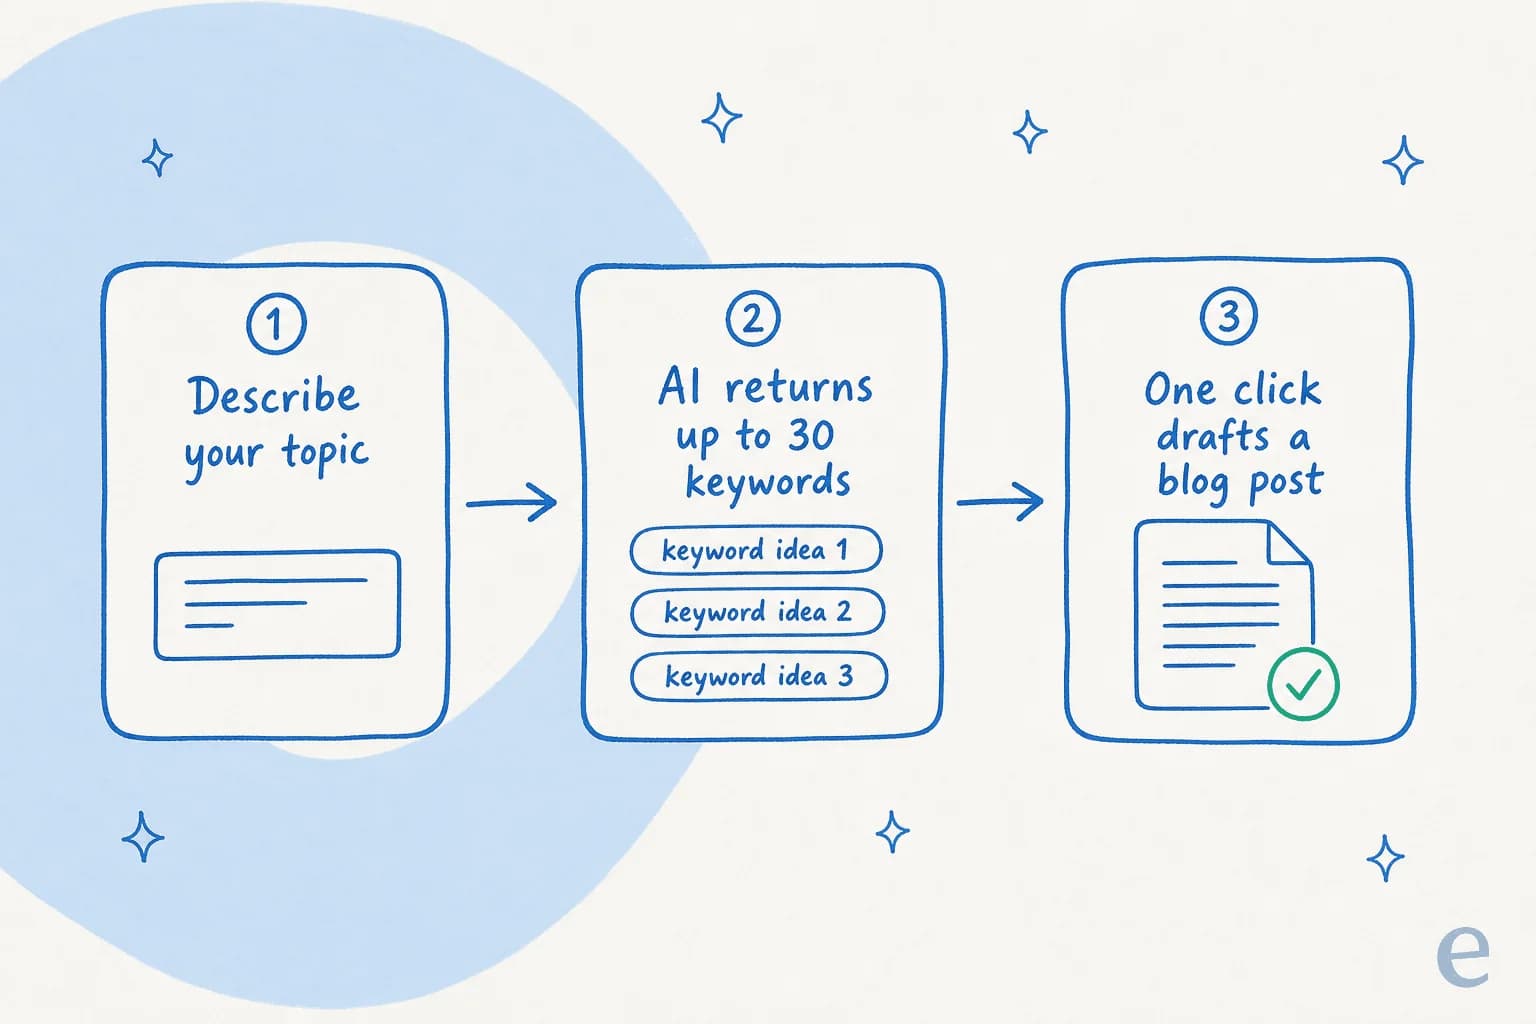
Ahora mismo el equipo son dos compañeros. El compañero de IA para helpdesk se une a tu cola actual en Zendesk, Freshdesk, Gorgias o una bandeja compartida, se entrena con tus tickets anteriores y tu centro de ayuda, y redacta o envía respuestas, y, lo más importante, puedes simularlo con tus tickets históricos antes de que responda a ningún cliente, para saber cómo se comportará en lugar de accionar un interruptor y esperar lo mejor. El redactor de blogs con IA hace la investigación, la redacción y el SEO de una entrada larga en una sola ejecución. Ambos funcionan con modelos de frontera por debajo, así que obtienes la capacidad de algo como Hy4 sin aprovisionar una sola GPU. Puedes empezar gratis, sin tarjeta de crédito y sin llamada comercial.