

MiniCPM5-2B es un nuevo modelo solo de texto de 2.500 millones de parámetros de OpenBMB, pensado para ejecutarse en tu propio hardware. El titular es real: promedia 53,9 en 34 benchmarks, lo que OpenBMB presenta como el estado del arte de código abierto en la clase de 2B, y dentro de su conjunto de comparación supera por poco al mejor modelo de 4B, Qwen3.5-4B con 51,1. Tiene licencia Apache-2.0, contexto nativo de 128K y funciona en teléfonos, portátiles y mini-PC mediante Ollama, llama.cpp, MLX y compañía.
Las salvedades honestas: es solo texto, sin visión, únicamente en inglés y chino, y una parte de la comunidad duda de que sus victorias en benchmarks sobrevivan al contacto con entornos de programación reales. Además, hay una discrepancia pública en su puntuación del Artificial Analysis Index (los rastreadores independientes dicen 15, el propio tuit de OpenBMB dice 23).
A quién le importa: si estás construyendo asistentes locales, herramientas en el dispositivo o un agente ligero y quieres algo pequeño y con licencia permisiva, MiniCPM5-2B es uno de los modelos de menos de 4B más interesantes del momento. Si lo que necesitas es una IA que resuelva tickets de soporte en producción, un modelo en bruto es el nivel equivocado, y explico por qué hacia el final.
Qué es realmente MiniCPM5-2B
MiniCPM5-2B llegó alrededor del 6 y 7 de septiembre de 2026 como el segundo modelo de la línea MiniCPM5 de OpenBMB, después del más pequeño MiniCPM5-1B. OpenBMB (también conocida como ModelBest) lleva un par de años lanzando modelos pequeños y eficientes, y esta línea trata de una sola cosa: llevar capacidad real al hardware de borde en lugar de a una GPU de centro de datos.
Estas son las especificaciones que importan, todas de la ficha del modelo:
| Campo | Valor |
|---|---|
| Parámetros | 2.516.756.480 (unos 2,52B) |
| Arquitectura | LlamaForCausalLM estándar, 42 capas |
| Atención | Grouped-query, 16 cabezas de consulta, 2 cabezas KV |
| Longitud de contexto | 131.072 tokens (128K) |
| Licencia | Apache-2.0 (pesos y repositorio) |
| Modalidad | Solo texto, inglés y chino |
| Formatos | BF16, más GGUF, MLX de 4 bits, GPTQ de 4 bits |
Una decisión de diseño hace mucho trabajo silencioso aquí. MiniCPM5-2B usa la arquitectura simple LlamaForCausalLM, de modo que, en palabras de OpenBMB, los motores habituales pueden cargarlo directamente con "no custom kernels, no model-code fork." Por eso salió con soporte desde el día 0 en vLLM, SGLang, llama.cpp, Ollama, LM Studio y MLX, en lugar de la habitual espera de dos semanas a que el ecosistema se ponga al día. Si alguna vez has intentado ejecutar un modelo abierto nuevo el día que sale, sabes que esa amplitud desde el día 0 no es lo normal.
La otra cifra destacada son esos 128K de contexto, realmente grandes para un modelo tan pequeño, y los benchmarks de contexto largo (más abajo) sugieren que no es solo un número de ficha técnica que se desmorona en la práctica.
Los benchmarks: ¿puede un 2B superar de verdad a un 4B?
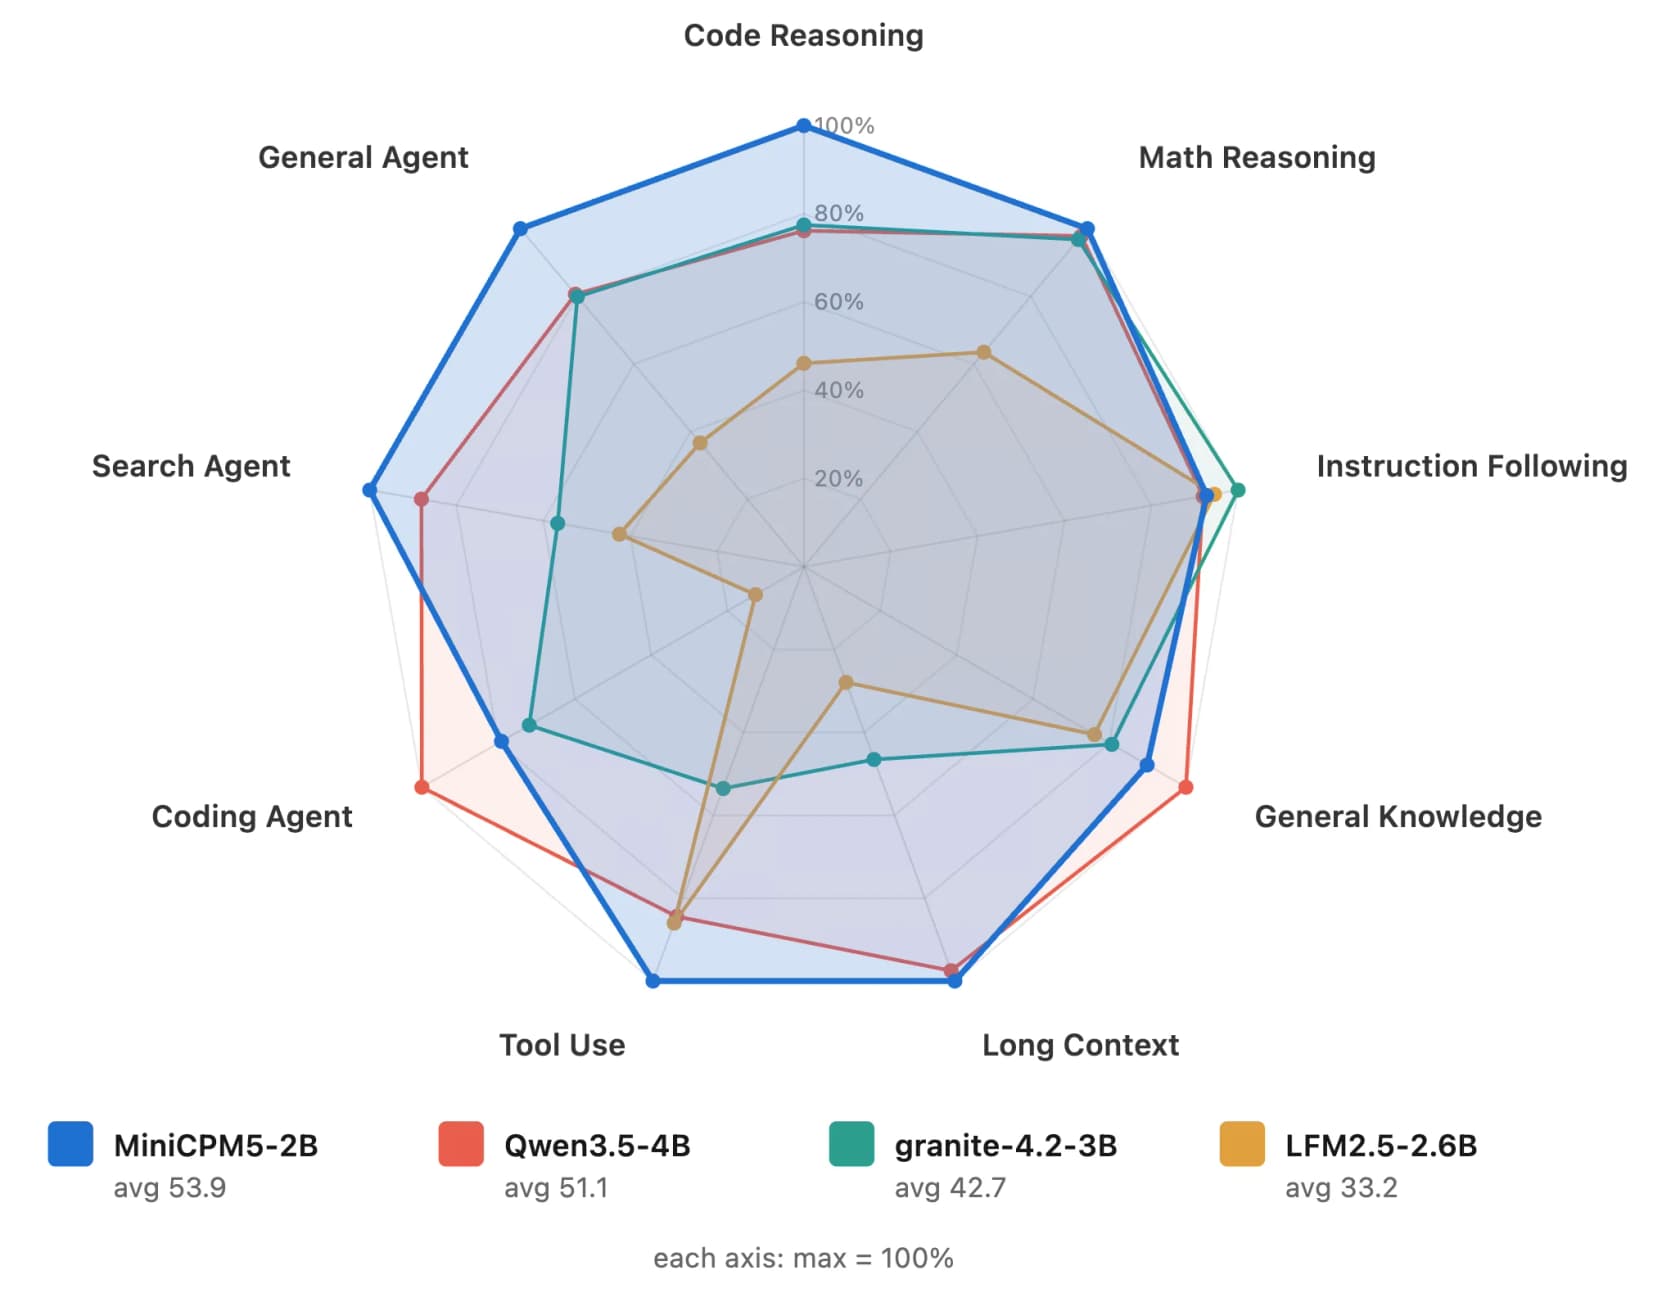
Esta es la afirmación a la que todos se agarraron, así que te pongo delante la tabla real. En la suite de 34 benchmarks de OpenBMB, MiniCPM5-2B promedia 53,9, por delante de Qwen3.5-4B con 51,1 y muy por encima de los otros modelos de la clase de 2B con los que se probó.
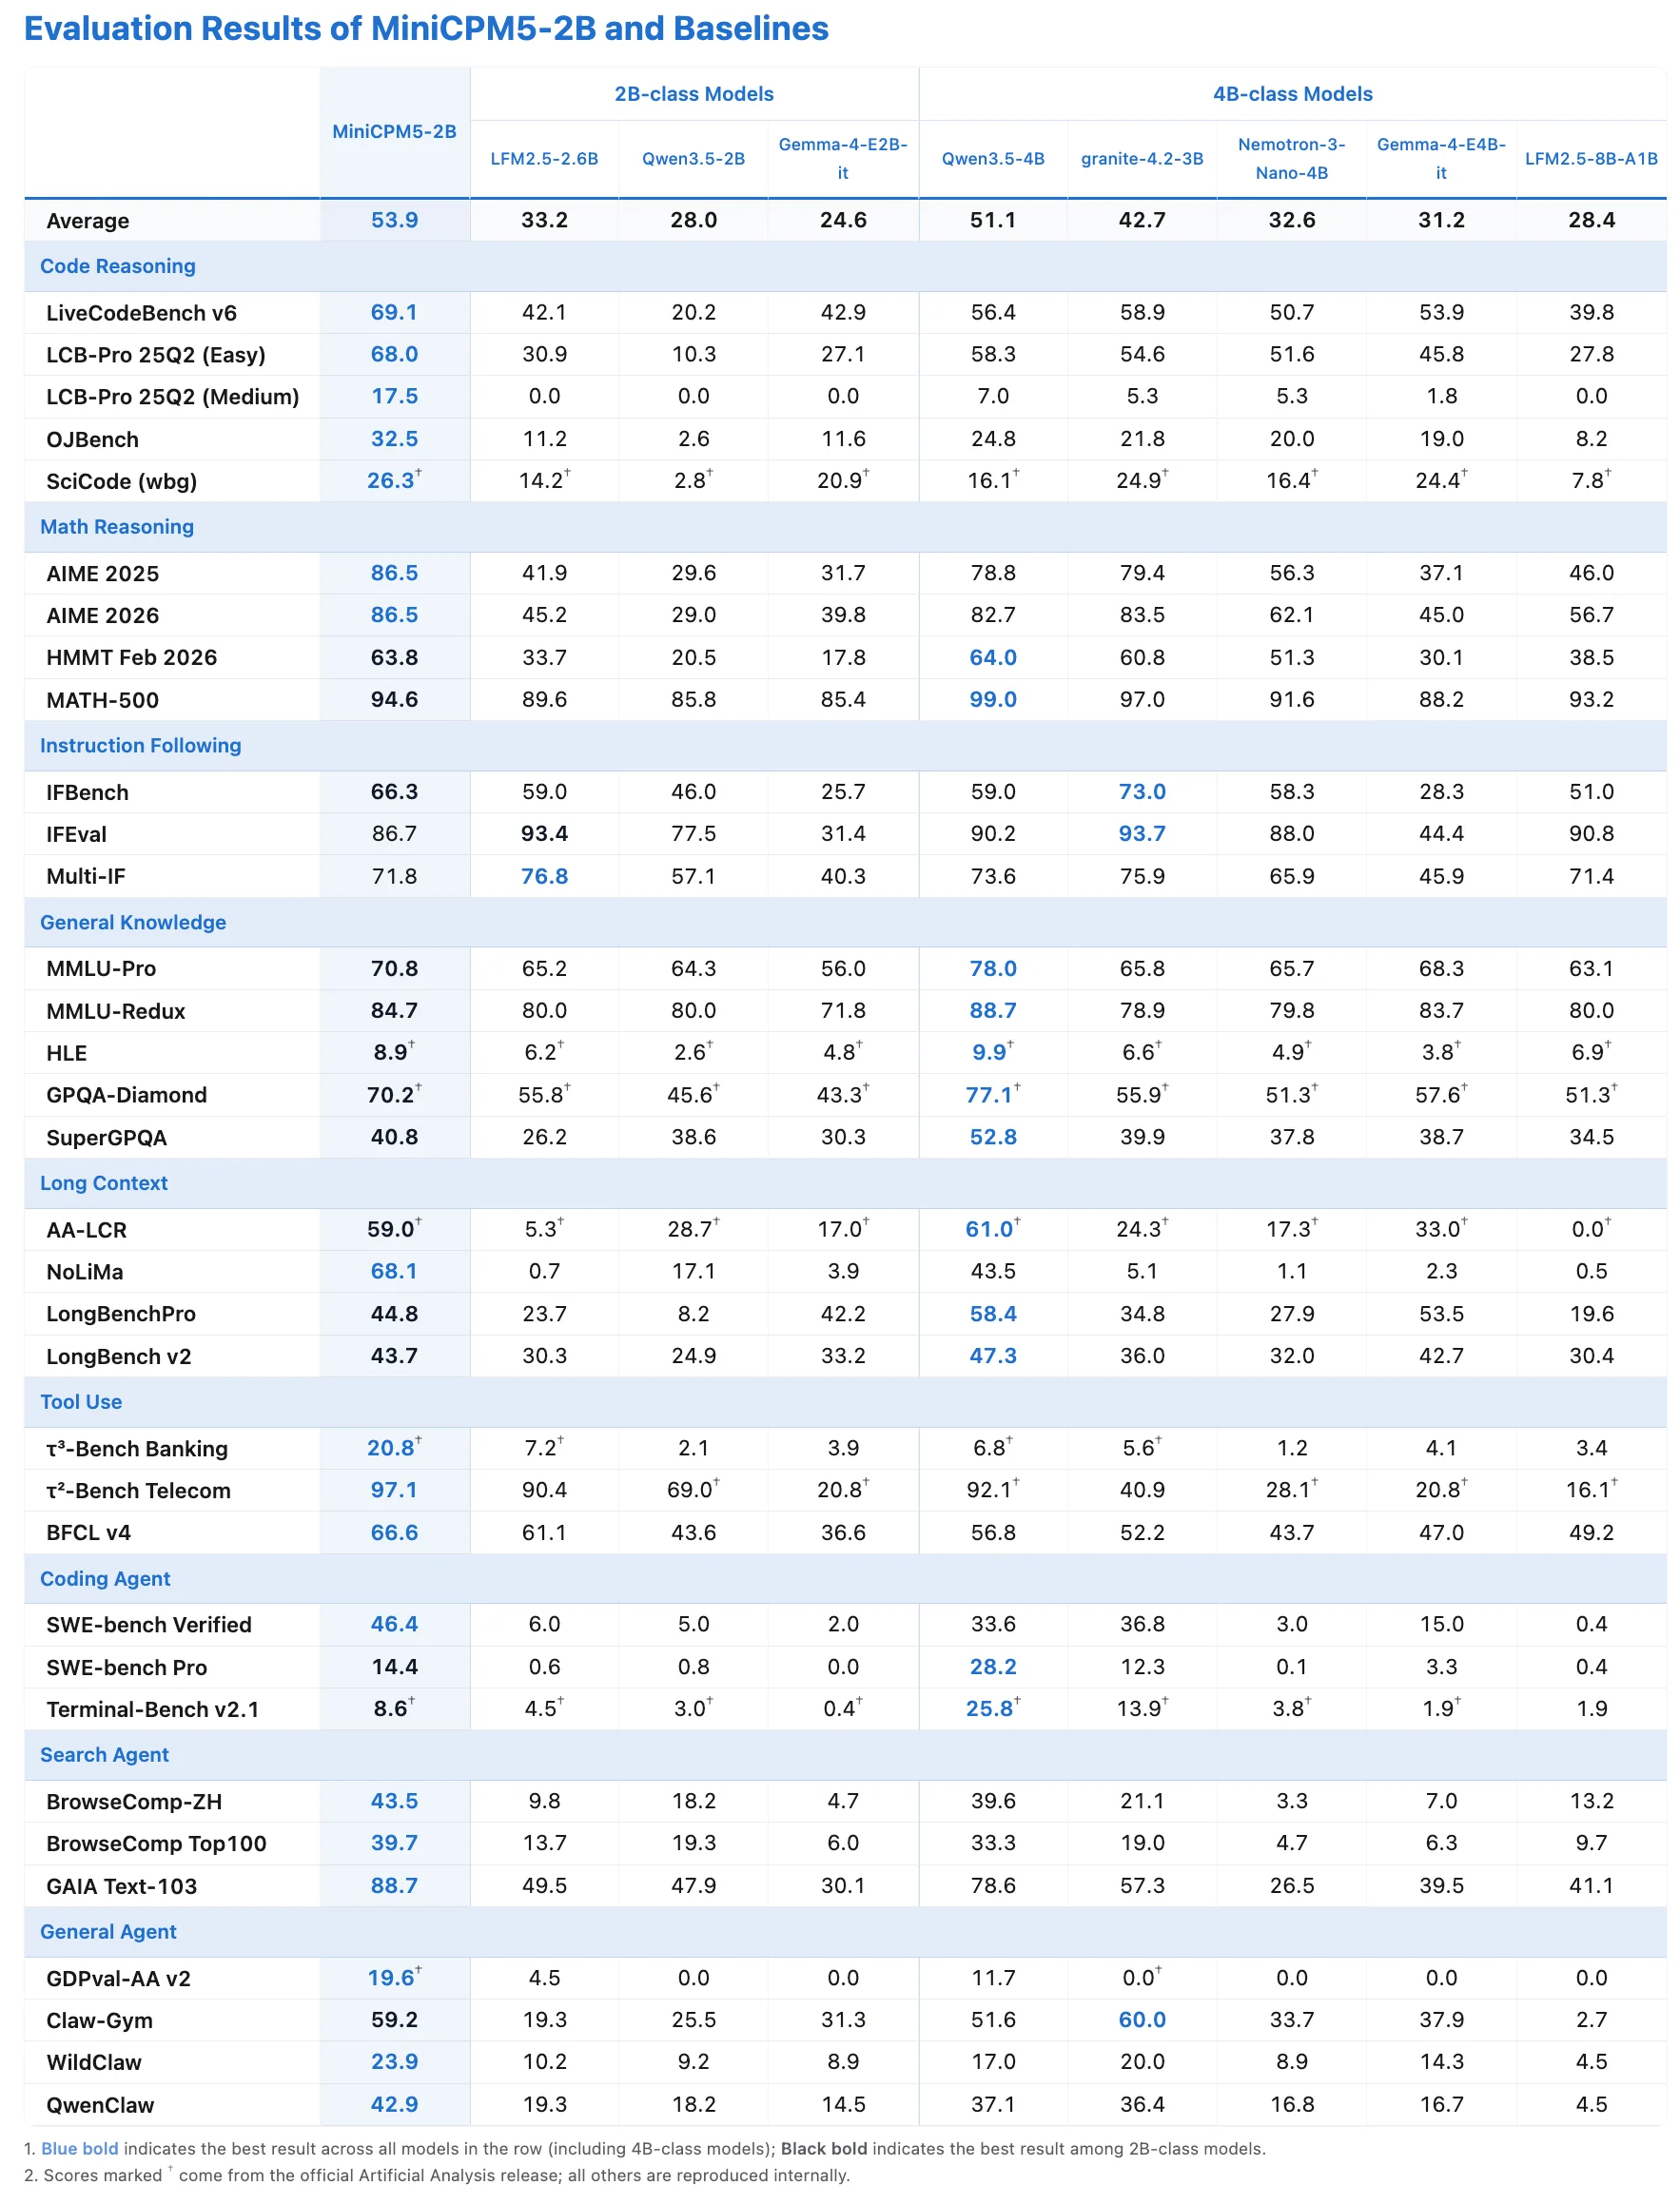
Las filas destacadas son donde la cosa se pone interesante. En matemáticas llega a MATH-500 94,6 y AIME 2026 86,5. En razonamiento de código lidera la tabla con LiveCodeBench v6 69,1 y SWE-bench Verified 46,4, ambos por encima del Qwen de 4B. En uso de herramientas registra τ²-Bench Telecom 97,1 y BFCL v4 66,6, y en agentes de búsqueda GAIA Text-103 llega a 88,7. Para un modelo que puedes ejecutar en un portátil, esas cifras de agentes y uso de herramientas son lo sorprendente.
Dos cosas hay que mantener con honestidad. Primero, este es el conjunto de comparación del propio OpenBMB, así que lo de "supera a 4B" es cierto dentro de los modelos y benchmarks que ellos eligieron, no es una afirmación universal. El Qwen de 4B sigue ganando varias filas de conocimiento y contexto largo (MMLU-Pro 78,0, GPQA-Diamond 77,1). Segundo, hay una discrepancia real en la cifra de terceros. El hilo de lanzamiento en r/LocalLLaMA y la publicación en Hacker News informan ambos de un Artificial Analysis Intelligence Index de 15, "the highest of any open weights model at 4B parameters or below." Sin embargo, el propio tuit de lanzamiento de OpenBMB afirma una puntuación de 23 más un 20 en el Agentic Index. Eso no cuadra en las fuentes que pude comprobar, probablemente por una diferencia de versión o de redondeo, así que confiaría en el 15 independiente como la cifra conservadora y trataría el 23 como el número del proveedor.
Un matiz más que conviene señalar: OpenBMB no publica las puntuaciones clásicas de MMLU, GSM8K o HumanEval que uno busca por instinto. La ficha usa una suite más nueva (MMLU-Pro, LiveCodeBench, SWE-bench, etc.), así que si comparas con la hoja de especificaciones de un modelo más antiguo, no encontrarás una fila limpia para comparar de igual a igual.
Cómo un modelo de 2B llegó a ser tan bueno
Lo que me parece más interesante no es la puntuación, sino la receta de entrenamiento que la produjo, porque explica por qué un modelo de 2B rinde por encima de su tamaño en lugar de sonar a marketing.
La versión final no es una sola ejecución de entrenamiento. Tras el entrenamiento base y medio sobre los conjuntos de datos UltraData de OpenBMB, la etapa de post-entrenamiento aplica ajuste fino supervisado y luego aprendizaje por refuerzo con profesores especializados en matemáticas, código, tareas agénticas y escritura, usando su algoritmo JustRL II. Lo ingenioso es el último paso: la destilación on-policy fusiona 16 modelos expertos distintos (incluidos 5 expertos agénticos) en el único modelo de 2B mediante KL inversa de vocabulario completo entre estudiante y profesor. En términos sencillos, entrenaron un banco de especialistas y luego comprimieron sus habilidades en un único modelo pequeño.
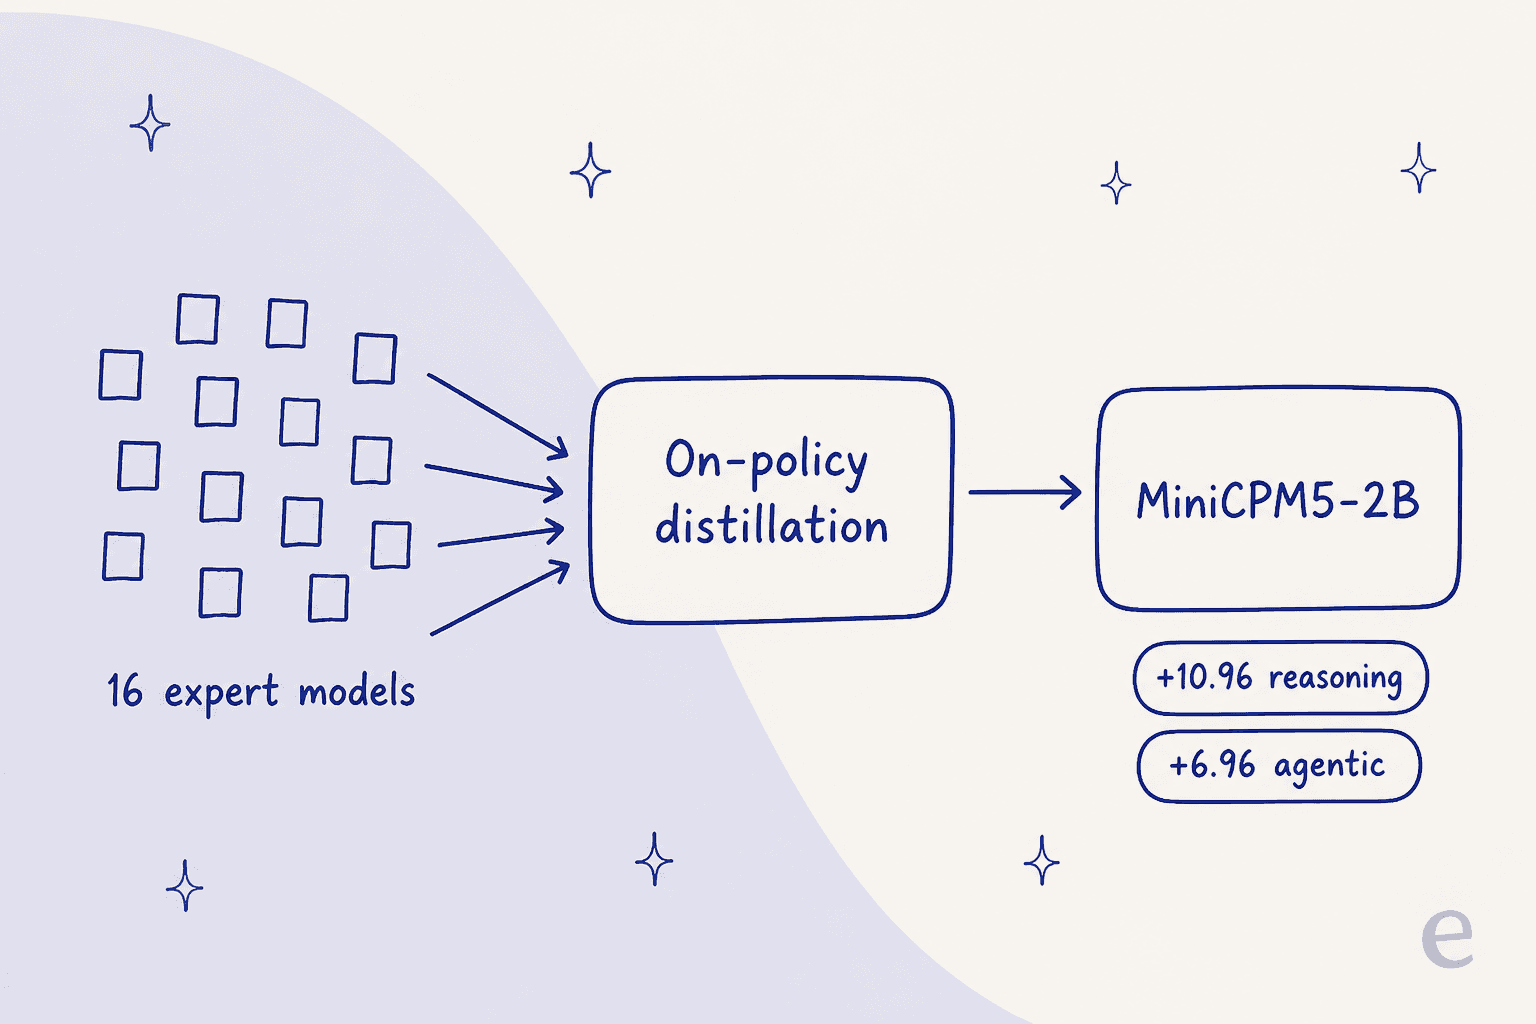
Según la ficha del modelo, esa etapa de RL más destilación elevó los benchmarks de razonamiento y generales en una media de 10,96 puntos y las tareas agénticas en 6,96 puntos respecto al checkpoint solo con SFT. Es un salto enorme para una pasada de post-entrenamiento y es el mecanismo detrás de la historia de "modelo pequeño, puntuación grande". Si quieres entender cómo se construyen hoy los modelos pequeños, esta receta merece una lectura atenta.
Ejecutarlo: dónde encaja MiniCPM5-2B
Como usa una arquitectura estándar, poner en marcha MiniCPM5-2B resulta refrescantemente aburrido, lo cual es un elogio. La ficha del modelo incluye una línea de vLLM:
pip install "vllm>=0.21"
vllm serve openbmb/MiniCPM5-2B --port 8000
Si te importa la llamada a herramientas, SGLang es el backend recomendado: el modelo emite llamadas a herramientas en estilo XML y el parser integrado minicpm5 de SGLang las convierte en tool_calls compatibles con OpenAI. También hay un modelo borrador DSpark para decodificación especulativa si quieres una salida más rápida sin cambiar los resultados. Para portátil y teléfono, las versiones GGUF y MLX de 4 bits funcionan con Ollama, LM Studio, llama.cpp y MLX, y OpenBMB también afirma adaptación desde el día 0 a chips de Intel, Arm y Rockchip, con aproximadamente 1,7x de mejora en prefill y 1,2x en decode en hardware móvil Arm SME2.
Las demos de rendimiento en el dispositivo son donde deja de ser una ficha técnica. Un probador ejecutó 32 subagentes concurrentes en un solo DGX Spark a 931 tokens por segundo de media y 1.364 de pico, todo con el modelo de 2B. OpenBMB compartió otra ejecución funcionando en un MacBook de 16 GB, llamando a la búsqueda web y resumiendo resultados íntegramente en el dispositivo. Son el tipo de cargas de trabajo que permite un modelo compacto y rápido y que un gran modelo en la nube no puede igualar en latencia ni coste.
Qué dice la gente realmente
La recepción en r/LocalLLaMA, el hogar natural para modelos como este, fue en su mayoría entusiasta:
"Hot damn. Very promising."

Pero dos líneas de crítica aparecían una y otra vez, y ambas son justas. La primera es la ausencia de soporte de visión, que claramente molestó a la comunidad local:
"Sad that there is no vision though. Having to switch to Lfm2.5-vl-3b for it is a bummer"
La segunda es un escepticismo saludable sobre si las puntuaciones de los rankings se traducen en trabajo útil. Sobre la demo de rendimiento, una respuesta fue contundente:
"you get some likes here, but useful code? I don't think so"
Y un probador práctico informó de que falla cuando se usa con un entorno de programación real, algo que atribuyó a la versión cuantizada de 2B más el drafter. Esa es la lección recurrente con los modelos pequeños: ganar en un benchmark no es lo mismo que ser un agente fiable, y la brecha aparece justo cuando lo conectas a un bucle real de herramientas.
Las limitaciones honestas
Para reunir las salvedades en un solo lugar, porque una reseña justa las nombra con claridad:
- Sin visión ni audio. Este checkpoint es solo de texto. Lo multimodal vive en la línea separada MiniCPM-V, así que las tareas con imágenes implican ejecutar un segundo modelo.
- Solo inglés y chino. Los probadores de la comunidad confirmaron el alcance de idiomas, así que no es un modelo multilingüe amplio.
- Los benchmarks van por delante de los informes del mundo real. Los fallos con el entorno de programación mencionados arriba son lo que debes probar tú mismo antes de construir sobre él.
- Una discrepancia pública de puntuación. La diferencia de 15 frente a 23 en el Intelligence Index sigue sin resolverse, y las cifras ejecutadas por el proveedor siempre merecen una ceja levantada.
- La adopción de la primera semana sigue siendo pequeña. La ficha del modelo mostraba 2.879 descargas en su primera semana, así que las pruebas de estrés de la comunidad apenas empiezan.
Ninguna de estas lo hunde. Solo lo sitúan: MiniCPM5-2B es un excelente modelo de borde para investigación y aficionados, y una base prometedora para herramientas en el dispositivo, más que un cerebro listo para producción.
Modelo frente a compañero: qué puede y qué no puede hacer un modelo de 2B por el soporte
Este es el replanteamiento que me importa, porque muchos que leen una reseña de modelo se preguntan en silencio si podrían apuntar algo así a su cola de soporte.
Un modelo en bruto es un ingrediente, no una comida. MiniCPM5-2B te da pesos y una sólida ficha de benchmarks. Para convertirlo en algo que un cliente toque, aún tienes que alojarlo, darle instrucciones, conectarlo a tu helpdesk, alimentarlo con tu conocimiento, darle herramientas, añadir barreras de seguridad y probarlo para que no dé con aplomo una respuesta equivocada. Es un proyecto de ingeniería real, más parecido a construir un agente de IA que a elegir un buen modelo. Es la misma brecha que señalaría si estuvieras mirando MiniCPM5-2B, un modelo Qwen o un endpoint de OpenAI: el modelo es infraestructura, y el trabajador real es todo lo que construyes encima.
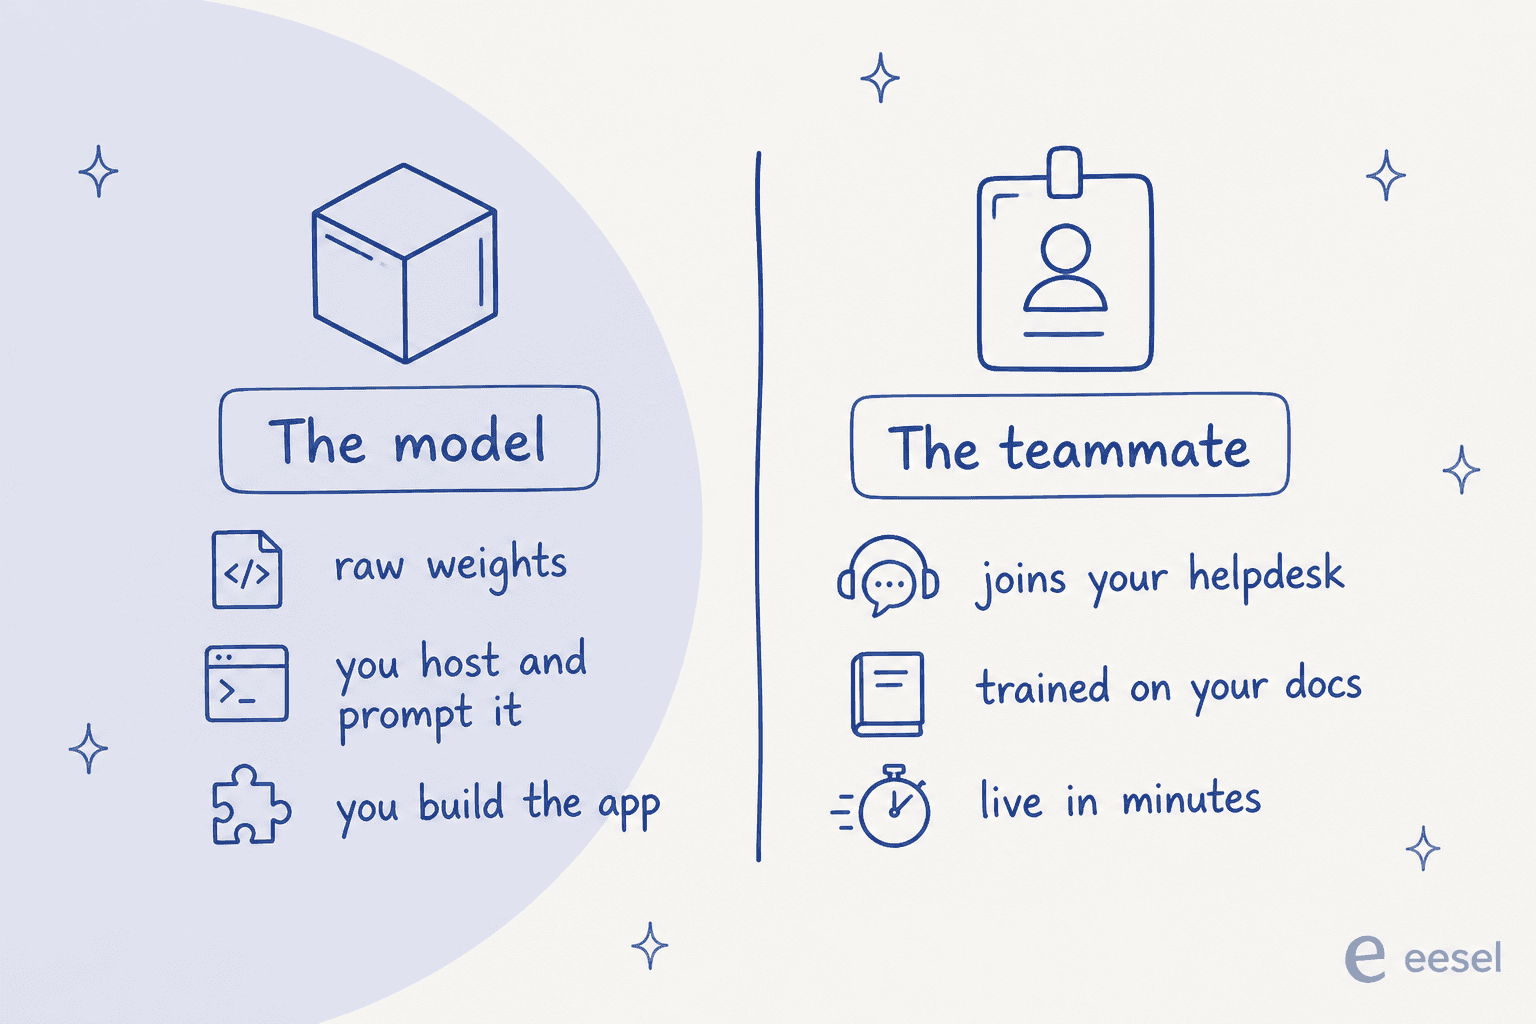
Esa distinción es la razón de ser de eesel. En lugar de darte un modelo para conectar, te da un compañero de IA listo para trabajar en una tarea concreta, y su compañero de IA para helpdesk ya trae integradas las integraciones, el contexto de la empresa y las herramientas para soporte. El compromiso es real y conviene dejarlo claro: no puedes ejecutar tus propios pesos en tu propio portátil como con MiniCPM5-2B. A cambio, obtienes algo que responde tickets reales en minutos en lugar de meses.
Prueba eesel para soporte con IA
Si tu motivo para leer una reseña de un modelo de 2B era "¿podría esto ayudar a mi equipo de soporte?", la respuesta honesta es que un modelo por sí solo no, pero el compañero de IA construido sobre uno sí.
eesel se conecta al helpdesk que ya usas (Zendesk, Freshdesk, Gorgias, Help Scout y más), se entrena con tus tickets y documentos anteriores y puede estar activo en minutos. La parte que no me saltaría: se puede simular con tus tickets históricos antes de tocar jamás una conversación en vivo, de modo que ves exactamente cómo habría respondido a clientes reales. Esa es la disciplina de "probar antes de confiar" que piden los escépticos del modelo citados arriba, integrada en el producto. Y para el público de terminal y scripts al que le gustó el enfoque en el dispositivo de MiniCPM5-2B, eesel también ofrece CLI y soporte MCP, de modo que una persona, un script o un agente de programación como Claude Code o Cursor puede manejar el mismo compañero sin abrir el panel.
Puedes probar eesel gratis, sin tarjeta de crédito ni llamada de ventas, y tener un compañero respondiendo tickets antes de que hubieras terminado de configurar tu propia infraestructura de inferencia.