

¿Qué cuenta como feedback a un agente de soporte?
El feedback a un agente de soporte es cualquier señal que le dice cómo cayó una respuesta y qué hacer distinto la próxima vez. La mayoría de los equipos piensan en la hoja de puntuación de QA, pero es una de cinco fuentes, y normalmente la más lenta.
| Fuente | Quién lo da | Qué tan rápido llega | Para qué sirve |
|---|---|---|---|
| Notas en tickets activos | Agente sénior o líder de equipo | De minutos a horas | Corregir una respuesta antes o justo después de enviarla |
| Revisiones de QA | Analista o líder de QA, con una hoja de puntuación | De días a semanas | Coherencia en el equipo, detectar patrones |
| Comentarios de CSAT del cliente | El cliente | De horas a días | Tono y resultado, con las palabras del cliente |
| Métricas | El informe del helpdesk | Semanal | Tendencias: tiempo de gestión, tasa de reapertura, resolución |
| Autorrevisión y revisión entre pares | El propio agente u otro agente | Cuando se programe | Desarrollar criterio, compartir lo que funciona |
Trabajo la cola de soporte de eesel todos los días, y el feedback que cambió cómo escribo respuestas casi nunca vino de una puntuación. Vino de alguien que dejó una nota en un ticket que acababa de responder, cuando aún recordaba por qué lo había escrito así.
Ese es el marco para el resto de esta guía: cada fuente tiene su trabajo, y los problemas empiezan cuando un equipo espera que la más lenta haga todos.
¿Por qué la mayor parte del feedback a agentes de soporte no cambia nada?
Pregunta a los agentes por el feedback y oirás las mismas cuatro quejas, una y otra vez. Ninguna es "mi jefe fue demasiado directo".
Llega tarde. Una revisión de QA escrita dos o tres semanas después del ticket le pide al agente que recuerde una conversación de la que ya ha tenido cien más. Para entonces el hábito se ha repetido decenas de veces.
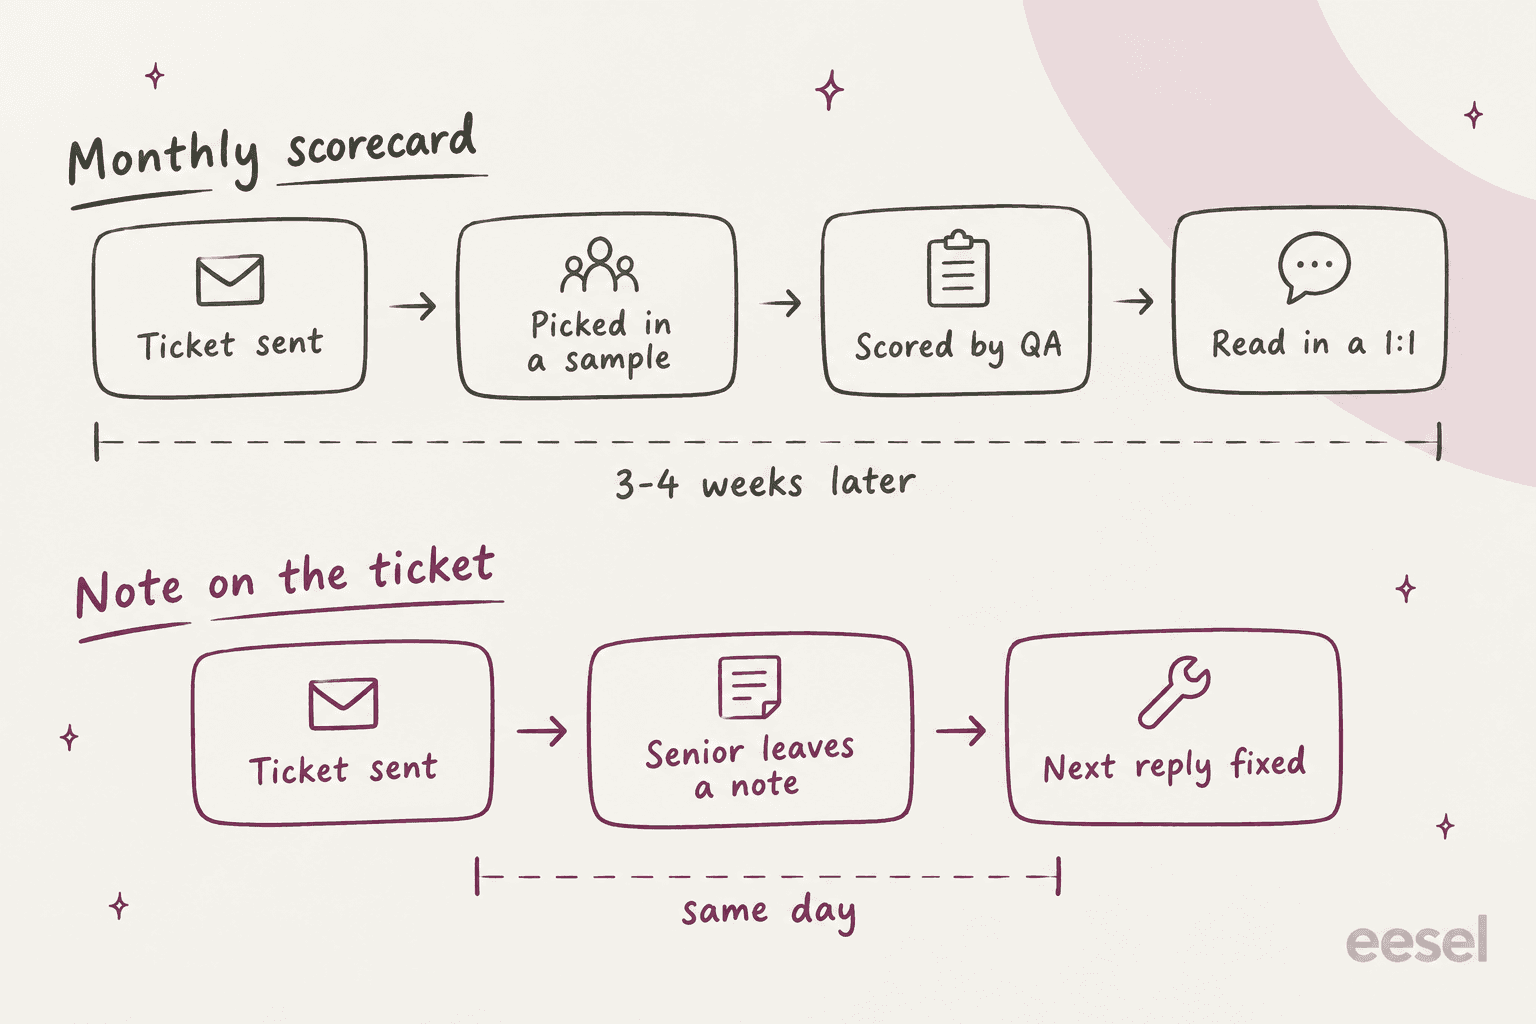
Es una puntuación sin conversación. Este es el grande. Un porcentaje le dice al agente que algo salió mal, nunca qué hacer en el siguiente ticket.
"I've gotten the same QA scores for weeks now. I haven't reviewed a single call with my boss yet and I've been graded on 8 or 9 calls. She's sent out a copy of the QA agent rubric sheet for two or three of them - the rest, no detail at all. But with no info on account and no call review or coaching on it, I really can't process the percentage score."

La muestra es demasiado pequeña para ser justa. Cuando un revisor lee dos tickets al mes por agente, un mal ticket se convierte en toda la historia. Un agente recibió un cero en una llamada por lo demás perfecta porque su perro ladró: "Out of hundreds of calls, they got the one where he barked!" Otro señaló que los revisores se saltan los tickets difíciles y puntúan los cortos que cualquiera resuelve bien, lo que premia justo a los agentes equivocados.
La hoja de puntuación mide lo que no toca. Los agentes aprenden lo que de verdad te importa por la ponderación, no por el póster de valores de la pared.
"I did tech support, only 30% of our score was actually fixing the user's problem. 70% was getting the opening/closing right, bullshit empathy statements, positive responses about being able to fix the problem (even when I couldn't because it was a misroute that I'd have to transfer), offering to send the knowledge article you were using, etc.."
Las métricas usadas como feedback tienen el mismo fallo, solo que más fuerte. En Hacker News, un antiguo agente de call center describió un equipo tan centrado en la duración media de las llamadas que era "common practice" molestar a los clientes a propósito para que pidieran un supervisor y se pudiera transferir la llamada. Otro describió una llamada de traductor que duró casi una hora y el único feedback al día siguiente, según su relato, fue "your handle time is too high." Se fue en una semana.
La buena noticia es que los agentes tienen claro lo que quieren en su lugar. Un habitual de r/callcentres pasa cada feedback por tres preguntas: ¿es objetivo, es justo y es constructivo? Si el revisor "can't give practical advise", se descarta. Es una mejor vara de medir para los responsables que la mayoría de las presentaciones de formación.
El ritmo del feedback: diario, semanal, mensual, trimestral
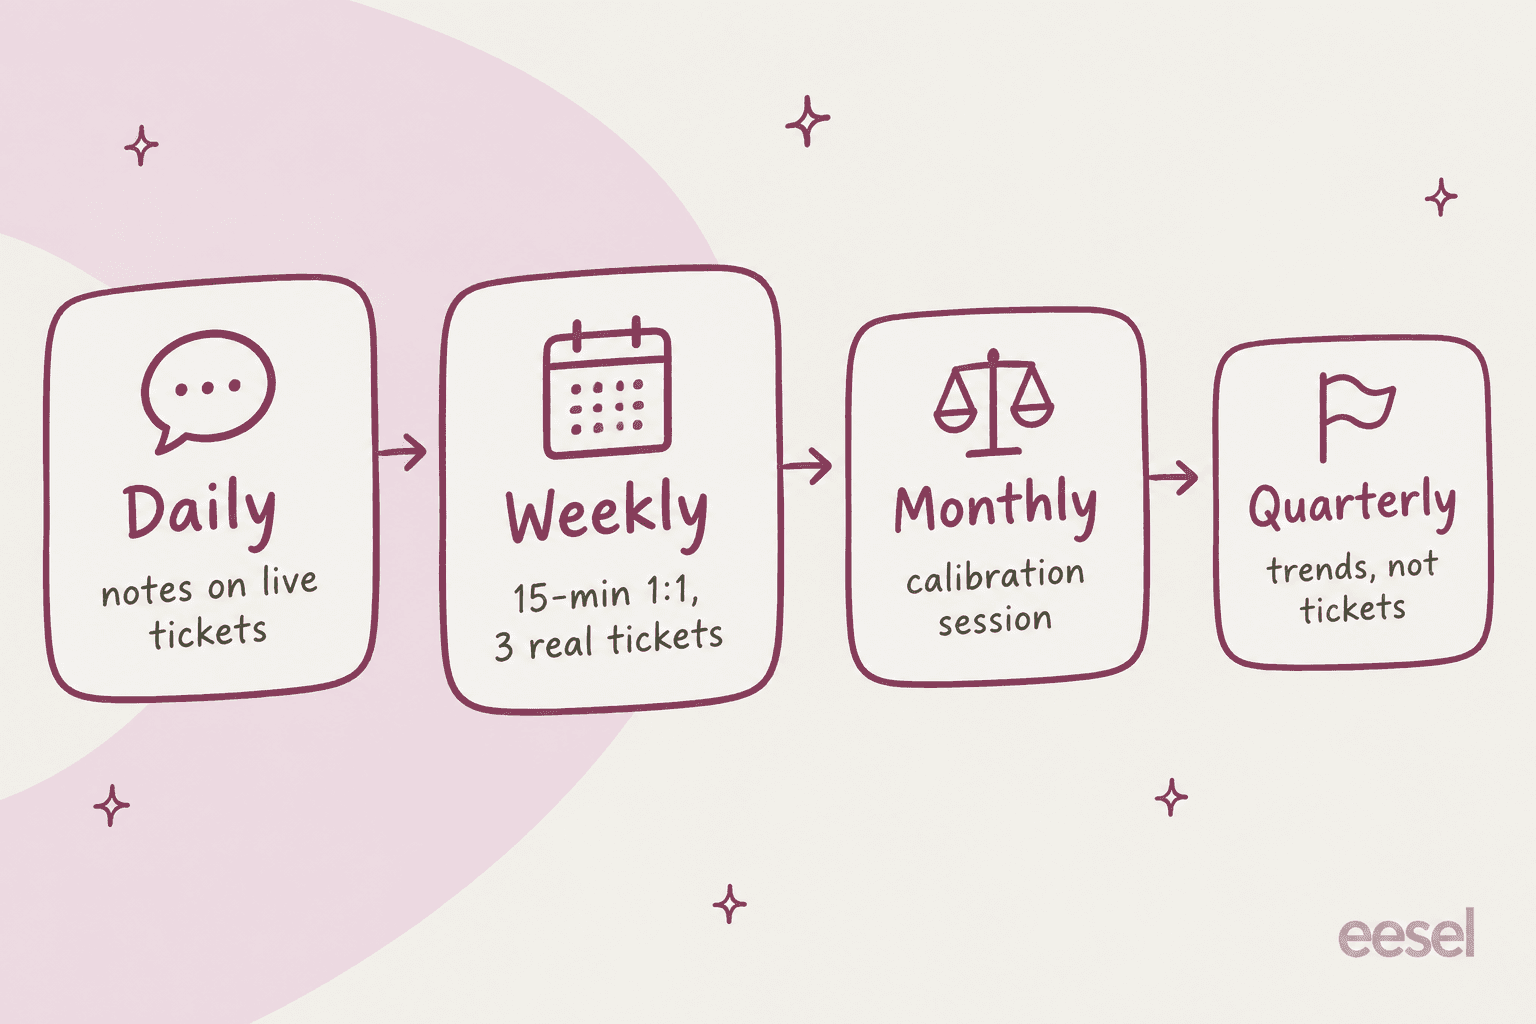
La solución al feedback tardío y escaso no es más QA. Es poner cada tipo de feedback en la cadencia para la que de verdad sirve. Este es el ritmo que montaría para un equipo de cinco a 50 agentes.
Diario: notas en tickets activos
Esta es la capa que enseña la mayor parte, y la que la mayoría de los equipos no formaliza. Un sénior o líder lee unas cuantas respuestas al día y deja una nota interna breve en el ticket: qué funcionó, o la única cosa que cambiar. Para los agentes nuevos, ve un paso antes y revisa las respuestas antes de enviarlas.
Un líder de soporte en Hacker News describió justo eso: los agentes nuevos acompañan a los expertos y, cuando su líder los considera listos, responden tickets "reviewed by a senior before sending," según ese hilo. Es el feedback más barato que darás, porque llega mientras el agente aún tiene el problema del cliente en la cabeza. Mi guía de incorporación explica cómo configurar esos puestos de solo notas en cada helpdesk.
Todos los helpdesks pueden hacerlo con herramientas que ya pagas. Los hilos privados de Freshdesk, las notas de Help Scout, las notas internas de Gorgias y los comentarios de Front avisan a quien @menciones (detalles por herramienta en la tabla más abajo).
Semanal: una 1:1 de 15 minutos sobre tres tickets reales
Elige tres tickets de la semana del agente: uno que gestionó bien, uno que se torció y uno que elija él mismo. Léanlos juntos. Pregunta qué haría distinto antes de decir nada.
Tres tickets es el número correcto. Uno parece un veredicto sobre un mal día; diez lo convierten en un sermón. Lleva también sus comentarios de CSAT, porque las palabras del cliente calan distinto que las de un revisor.
"It sounds like your boss is really letting you down. A big part of their job is to help you perform better. When I worked the floor I'd have a weekly meeting with my boss and we'd go over my surveys then."
Mantén la proporción honesta. Una responsable de QA de despacho del 911 dijo en Reddit que da "a lot of positive and supportive feedback as well as coaching feedback." Si cada 1:1 es una lista de fallos, los agentes dejan de traerte los tickets de los que dudan. Para la redacción, mi artículo de ejemplos de feedback de QA tiene redacciones de antes y después por criterio de la hoja de puntuación.
Mensual: calibra a los revisores, no a los agentes
Cuando tres revisores dan tres puntuaciones distintas al mismo ticket, los agentes lo notan, y toda puntuación posterior resulta sospechosa. Un agente contó que leyó el guion palabra por palabra y aun así recibió "3 different scores" de tres revisores.
La calibración es la solución. Todos puntúan por separado el mismo lote pequeño y luego se reúnen y acuerdan la respuesta correcta. La versión más concreta que encontré vino de un antiguo líder de equipo de calidad:
"Every month we'd pick a random call, all score separately, then get together and decide the correct score for each quality point. Whatever we all decided on, we had to be within 3% of that score (and certain elements had to be 100% on point)."
Zendesk QA tiene sesiones de calibración integradas, con una revisión base para comparar. Dos salvedades que conviene conocer: la calibración no envía notificaciones, así que el líder tiene que avisar a los revisores de que hay una sesión, y los agentes no ven nada de ella. Ambas son decisiones de diseño razonables, pero pon tú la sesión en el calendario.
Trimestral: tendencias, no tickets
La conversación trimestral es donde van las métricas, y solo como tendencias. "Tu tasa de reapertura bajó de 9 % a 5 % desde marzo" es útil. "Tuviste un tiempo de gestión alto el día 14" no lo es. Mis ejemplos de evaluación de desempeño y la guía de KPI explican qué números aguantan.
Si quieres una guía para elegir dónde debe ir un feedback concreto, esta es la versión que tengo fijada:
¿Dónde debe ir este feedback?
Elige la situación. Obtendrás el canal, el momento y una frase que puedes adaptar.
- "Una cosa rápida: este cliente tiene el plan anual, así que el plazo de reembolso es de 30 días, no de 14. ¿Puedes enviar un seguimiento para corregirlo?"
- Si la política tampoco está clara en el centro de ayuda, arregla el artículo en la misma sesión.
- Pregunta primero: "¿Cómo crees que se sintió este cliente al leer tu respuesta?"
- Luego muestra una frase reescrita, no un correo reescrito.
- Actualiza la macro, el artículo de ayuda o las instrucciones de la IA que siguen provocando el fallo.
- "He actualizado la macro de envíos, así que ya no tendrás que acordarte de la excepción."
- "Tu tasa de reapertura subió de 5 % a 9 % en seis semanas. Vamos a sacar tres tickets reabiertos y ver qué tienen en común."
- Nunca plantees un solo mal día como una métrica.
- "Esta respuesta al ticket del doble cargo es ahora la plantilla. Clara, corta, y respondió la siguiente pregunta antes de que la hicieran."
- El elogio en público funciona como formación para todos los demás.
Cómo dar feedback que los agentes puedan usar
El ritmo decide el cuándo. Estos cinco hábitos deciden si el agente sale sabiendo qué hacer distinto.
- Ancla cada punto a un ticket real. "Sé más empático" no significa nada. "En el ticket 4182, el cliente dijo que le habían cobrado dos veces; tu primera línea fue directa a los pasos del reembolso" es algo que un agente puede imaginar y corregir.
- Una sola cosa por sesión. Si hay cinco problemas, elige el que más le cuesta al cliente. Los otros cuatro pueden esperar una semana, y el agente recordará de verdad el uno.
- Pregunta antes de decir. "¿Qué cambiarías aquí?" La mitad de las veces el agente lo detecta solo, y el feedback al que uno llega se queda mejor que el que se recibe.
- Di por qué le importa al cliente. "Confirma el número de pedido" es una regla. "Confirma el número de pedido, porque dos de las reaperturas de la semana pasada fueron reembolsos enviados al pedido equivocado" es una razón.
- Separa el coaching de la evaluación. Una 1:1 que termina con "y por eso estás en el 72 %" hace defensiva cada conversación futura. Guarda la puntuación para la evaluación; deja la 1:1 para el siguiente ticket.
Añadiría una más para quien gestione un equipo mixto de agentes nuevos y veteranos: no juzgues a los nuevos con la misma hoja de puntuación en la segunda semana. Una líder de equipo en Reddit, al reaccionar a una promoción de nuevas contrataciones despedida tras 10 días con un objetivo del 80 %, lo dijo sin rodeos: "10 days is nothing." Mi guía del tiempo de incorporación recoge los plazos que los equipos ven en realidad.
Deja que los agentes respondan: disputas y autorrevisiones
Un sistema de feedback sin forma de discrepar es un sistema de calificación. Los agentes conocen la diferencia, y las historias de disputas en r/callcentres son una lección de lo que sale mal.
Un agente impugnó una puntuación de 95,5 %, su responsable estuvo de acuerdo, y la revisión volvió con 90,25 % y unos ocho "new errors found," escribió el agente. Otro dijo que las disputas sobre encuestas malas eran "almost always ignored for months," y luego denegadas, según su comentario. Y alguien notó que una puntuación había cambiado en silencio tras una apelación exitosa, sin ningún mensaje: "an acknowledgment of it would be nice."
Compáralo con cómo suena un proceso que funciona:
"If there's a problem with one of my scores and I feel I have a reason to dispute we have a process, but I've never even had to use it because the scorer just looks at it and either clarifies in a way that makes sense to me or changes it because they agree with me. They are reasonable, and not retaliatory, even the semi cranky ones. That's how adults behave at work."
Las reglas que marcan la diferencia son sencillas: un motivo por escrito del agente, un plazo de respuesta fijo, una decisión explicada en cualquier caso y una notificación cuando se resuelve. Un revisor del otro lado añadió una que me gusta: cuando QA se equivoca, "we own up to it and award the points back and issue an apology," como lo expresó un revisor de QA.
Zendesk QA integra casi todo eso en el producto. Un agente abre la revisión, elige quién recibe la disputa, puede proponer nuevas puntuaciones por categoría y debe escribir un comentario explicando por qué. El destinatario acepta, acepta parcialmente o rechaza, ambas partes reciben notificación, y no hay límite de disputas por revisión, según la documentación de disputas de Zendesk QA.
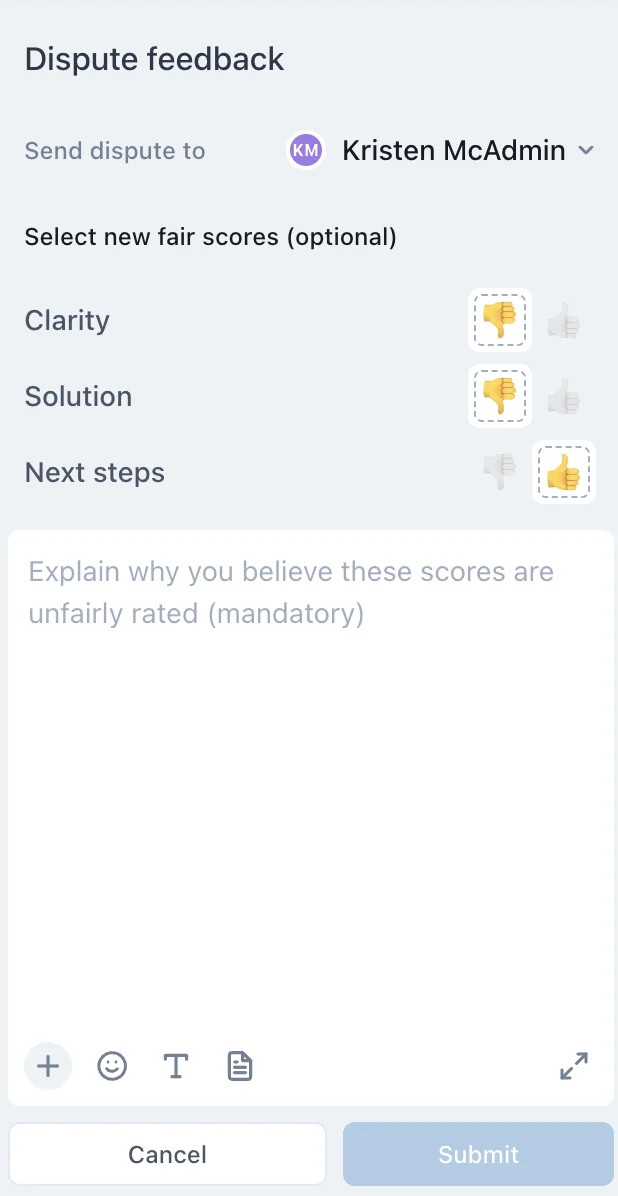
También hay un panel de disputas con el tiempo medio de resolución en días y una tabla de qué revisores son más disputados, una forma discreta de detectar a un revisor que necesita calibración. MaestroQA (ahora Rippit) llama a su versión apelaciones, con la opción de que un líder de equipo revise primero la apelación, y Scorebuddy da a los agentes un proceso de "request a review" desde su panel.
Las autorrevisiones son la mitad infravalorada. Zendesk QA permite activar autorrevisiones por espacio de trabajo, para que los agentes puntúen sus propias conversaciones con la misma hoja de puntuación. Haz una al mes junto a la puntuación del revisor, y la diferencia entre ambos números suele ser mejor tema de 1:1 que cualquiera de los dos por separado.
Dónde vive el feedback en tu helpdesk
Aquí se vuelve práctico, y aquí encontré las mayores sorpresas en la documentación de los proveedores. No todos los helpdesks dejan que los agentes vean sus propias puntuaciones de calidad, y los complementos de puntuación con IA son deliberadamente cautos sobre cómo se usan sus puntuaciones.
| Herramienta | Dónde se escribe el feedback | ¿Se avisa al agente? | Vía de disputa | Autorrevisión / entre pares | Puntuación con IA | Precio |
|---|---|---|---|---|---|---|
| Zendesk QA | Comentarios de revisión (hashtags, @menciones), sesiones de coaching, pins | Sí, por correo o Slack, de inmediato a mensual | Sí: nuevas puntuaciones, comentario obligatorio, aceptar / parcial / rechazar | Ambas, más calibración | AutoQA, 8 categorías del sistema | Complemento de $35/agente/mes, anual |
| Front Smart QA | Hoja de puntuación con IA en la barra lateral, anulación del admin con comentario, comentarios internos | @menciones sí; sin alerta específica de QA documentada | Ninguna documentada | No documentada | 15 criterios por defecto, hasta 10 personalizados | $20/puesto/mes, incluido en Enterprise |
| Gorgias Auto QA | Puntuaciones de IA en el ticket; los líderes editan; notas internas | Notas sí; los agentes no pueden ver las puntuaciones de QA | Ninguna | No documentada | 3 criterios automáticos, 4 manuales | Requiere suscripción a AI Agent |
| Freshdesk | Notas privadas e hilos privados con @menciones | Sí, correo al asignado y participantes | No se encontró módulo de QA | No se encontró | No se encontró | Hilos en todos los planes |
| Help Scout | Notas con @menciones | Sí, Notification Station más correo opcional | No se encontró módulo de QA | No se encontró | No se encontró | Notas en todos los planes |
| MaestroQA / Rippit | Calificaciones por rúbrica, sesiones de coaching con tareas | No confirmado públicamente | Sí, apelaciones con aprobación opcional del líder | Programa de revisión entre pares | AutoQA | Rippit Free, $185, $495/mes |
| Scorebuddy | Hojas de puntuación con feedback del evaluador, sesiones de coaching | Paneles del agente en tiempo real | "Request a review" | Puntuación entre pares y calibración | 500 o 1.000 puntuaciones de IA/mes | Solo con cotización |
Algunos detalles de esa tabla merecen explicarse, porque cambian cómo gestionarías el feedback en cada herramienta.
Zendesk QA registra si los agentes leen su feedback. Su panel de Reviews informa de Unseen reviews, el porcentaje de revisiones manuales que el agente aún no ha abierto, y el panel de Coaching registra si los agentes han revisado el feedback recibido. Si tu tasa de no vistas es alta, tu problema de feedback no es la redacción, es la entrega. La página de Activity del agente reúne revisiones, comentarios, reacciones, feedback de CSAT y disputas en un solo lugar.
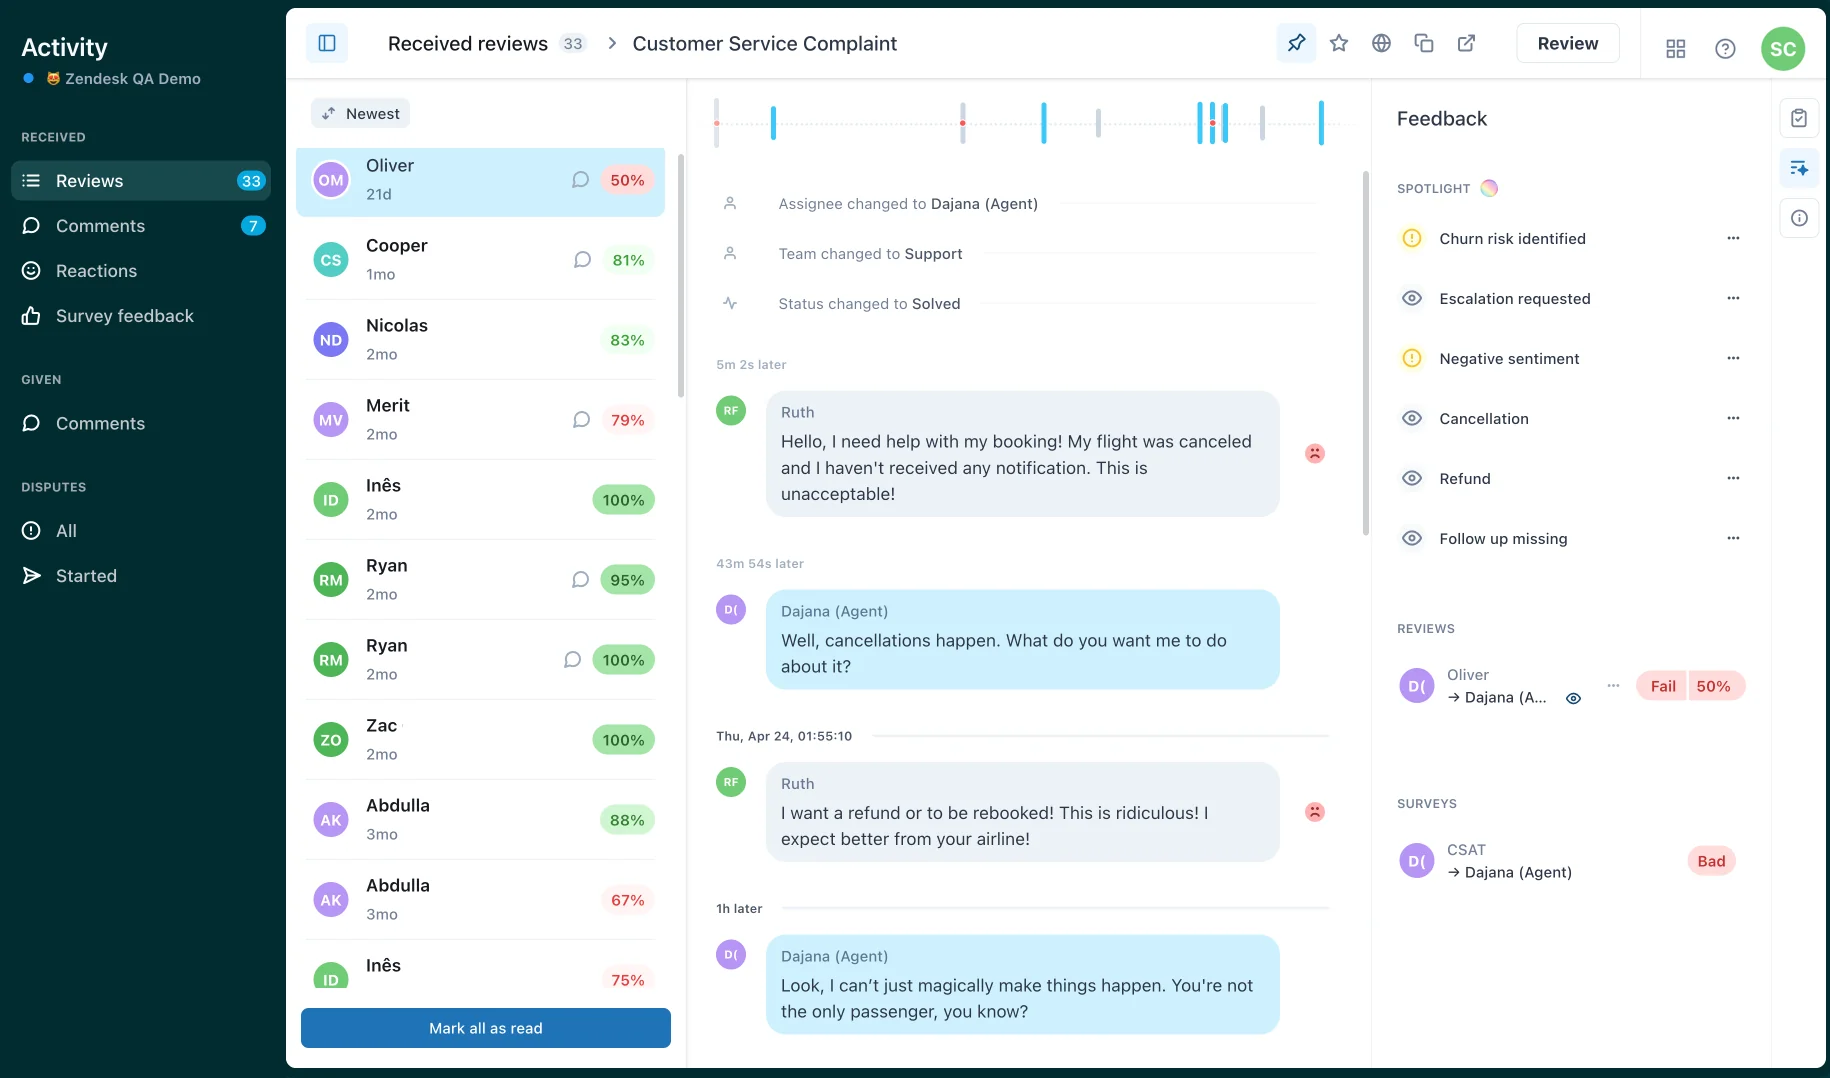
Zendesk mantiene separadas las puntuaciones de IA y las humanas. Los resultados de AutoQA alimentan una puntuación de calidad automática, mientras que la puntuación de calidad interna se basa solo en revisiones manuales, y la propia documentación de ajustes de cuenta de Zendesk dice que las evaluaciones de AutoQA "are for guidance only and shouldn't be used for performance decisions." Es una línea sensata para copiar aunque uses otra herramienta. El complemento de QA cuesta $35 por agente al mes además de cualquier plan Support o Suite, según los precios de Zendesk.
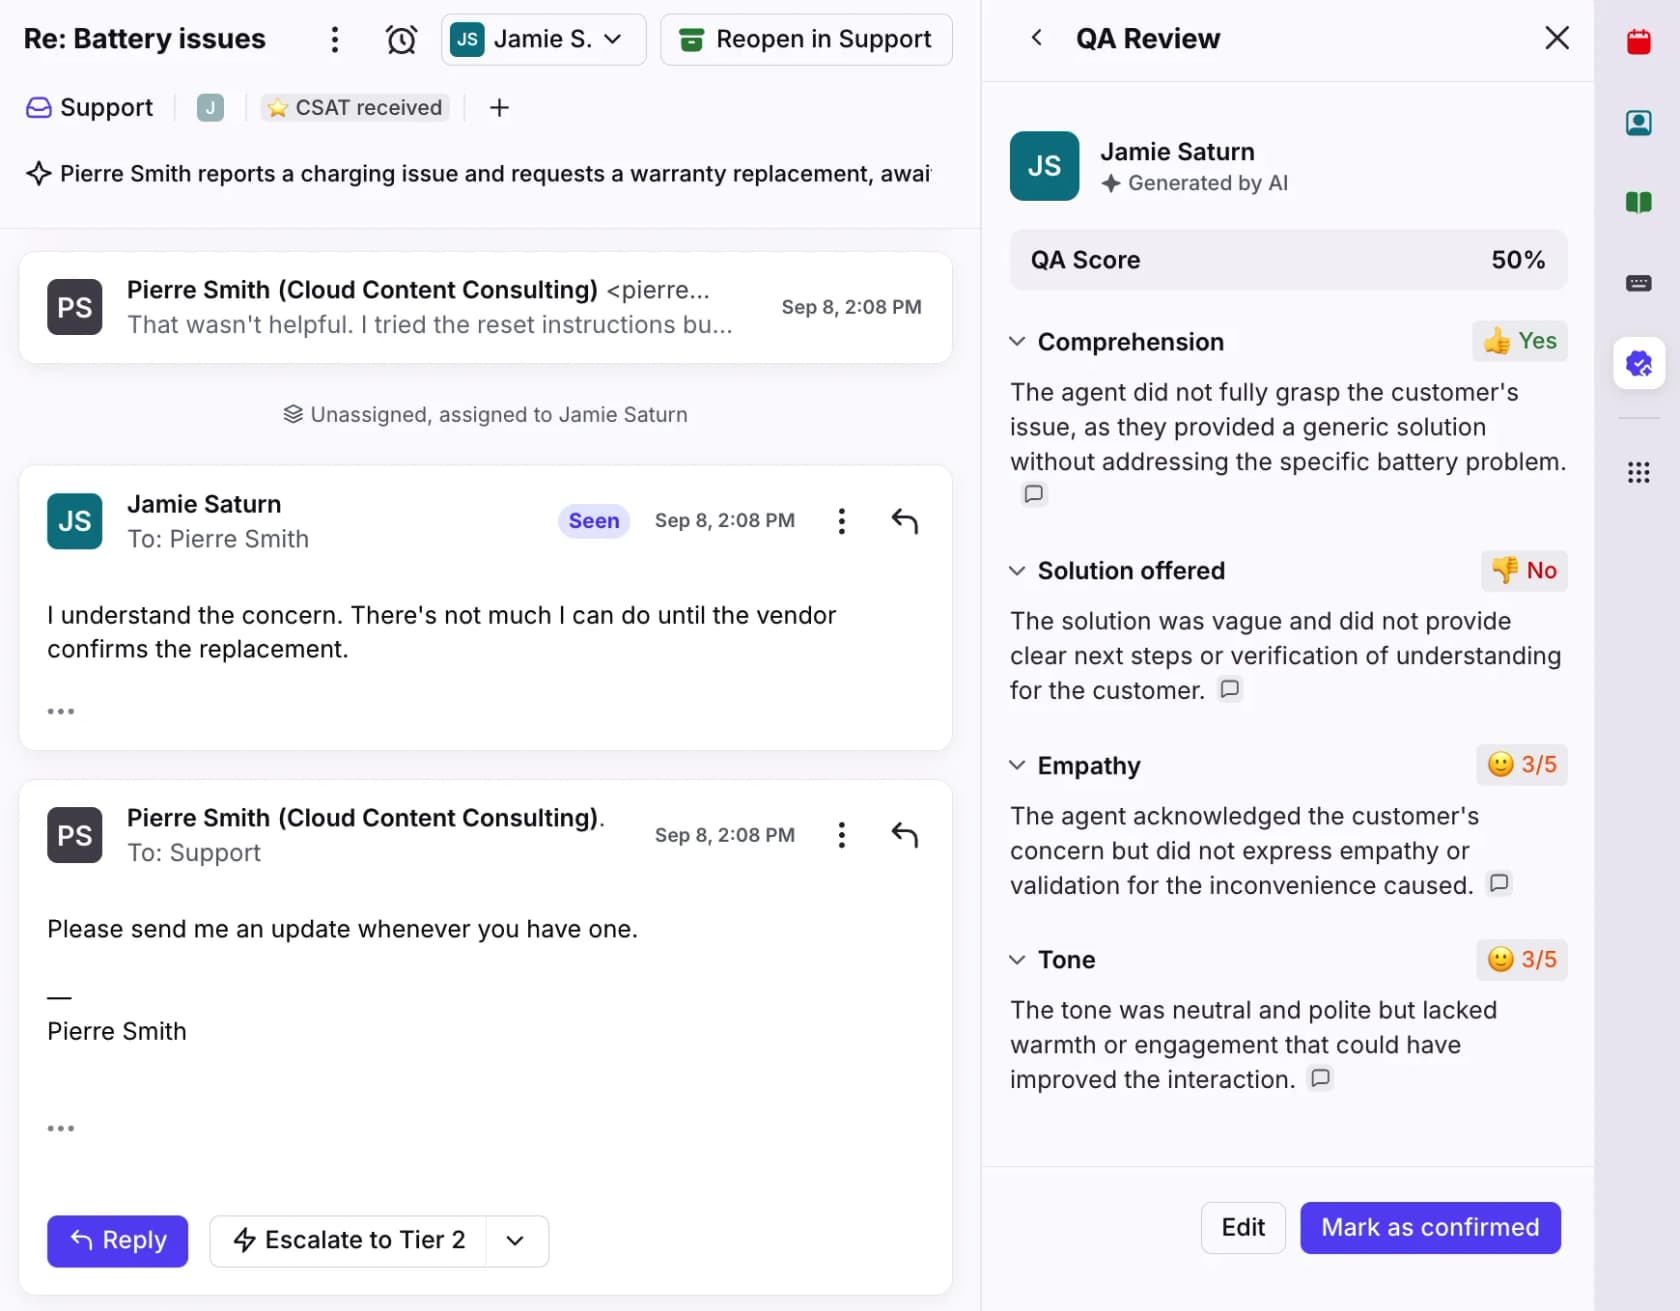
Front muestra a los agentes sus propias puntuaciones de IA, con el razonamiento. Smart QA pone una hoja de puntuación en la barra lateral de la conversación con una explicación escrita por criterio, y los agentes solo ven sus propios resultados. Los admins pueden anular una puntuación, añadir un comentario y marcarla como confirmada, momento en que su nombre sustituye a "Generated by AI." Front también pide avisar a los clientes cuando Smart QA puntúa sus conversaciones, algo que haría con cualquier herramienta. Cuesta $20 por puesto al mes en Starter y Professional, y está incluido en Enterprise a $105, según el artículo de ayuda de Smart QA y los precios de Front.
Gorgias Auto QA es una herramienta para gestores, no feedback para agentes. Puntúa automáticamente la completitud de la resolución, la comunicación y el dominio del idioma, pero "only the account owner, admins, and leads can view and change QA scores," según la documentación de Auto QA. Así que en Gorgias, cualquier feedback que llega a un agente pasa por una nota, una 1:1 o un informe que compartas. Está bien, siempre que alguien tenga de verdad la conversación.
Freshdesk y Help Scout no tienen hoja de puntuación de QA nativa en su documentación ni en sus páginas de precios. El feedback ahí pasa por notas y @menciones, que sí avisan al agente, más CSAT. Los hilos privados de Freshdesk permiten comentar una respuesta concreta e incluir al asignado, lo que funciona bien para la capa diaria. Si quieres hojas de puntuación en cualquiera de los dos, necesitas una herramienta de QA dedicada.
Los comentarios de CSAT son la única fuente que todos los grandes helpdesks muestran a los agentes. En Zendesk la valoración aparece arriba del ticket con los comentarios bajo Events; Freshdesk los muestra en las Activities del ticket; Gorgias deja que cualquier rol abra el informe de Satisfacción con sus comentarios destacados. Úsalos en la 1:1 semanal, no como una clasificación.
Arréglalo una vez: cuando el feedback es en realidad una respuesta que falta
Esta es la parte que cambió mi forma de pensar sobre el feedback. Si te encuentras dando la misma corrección por tercera vez, a distintos agentes, el problema probablemente no son los agentes.
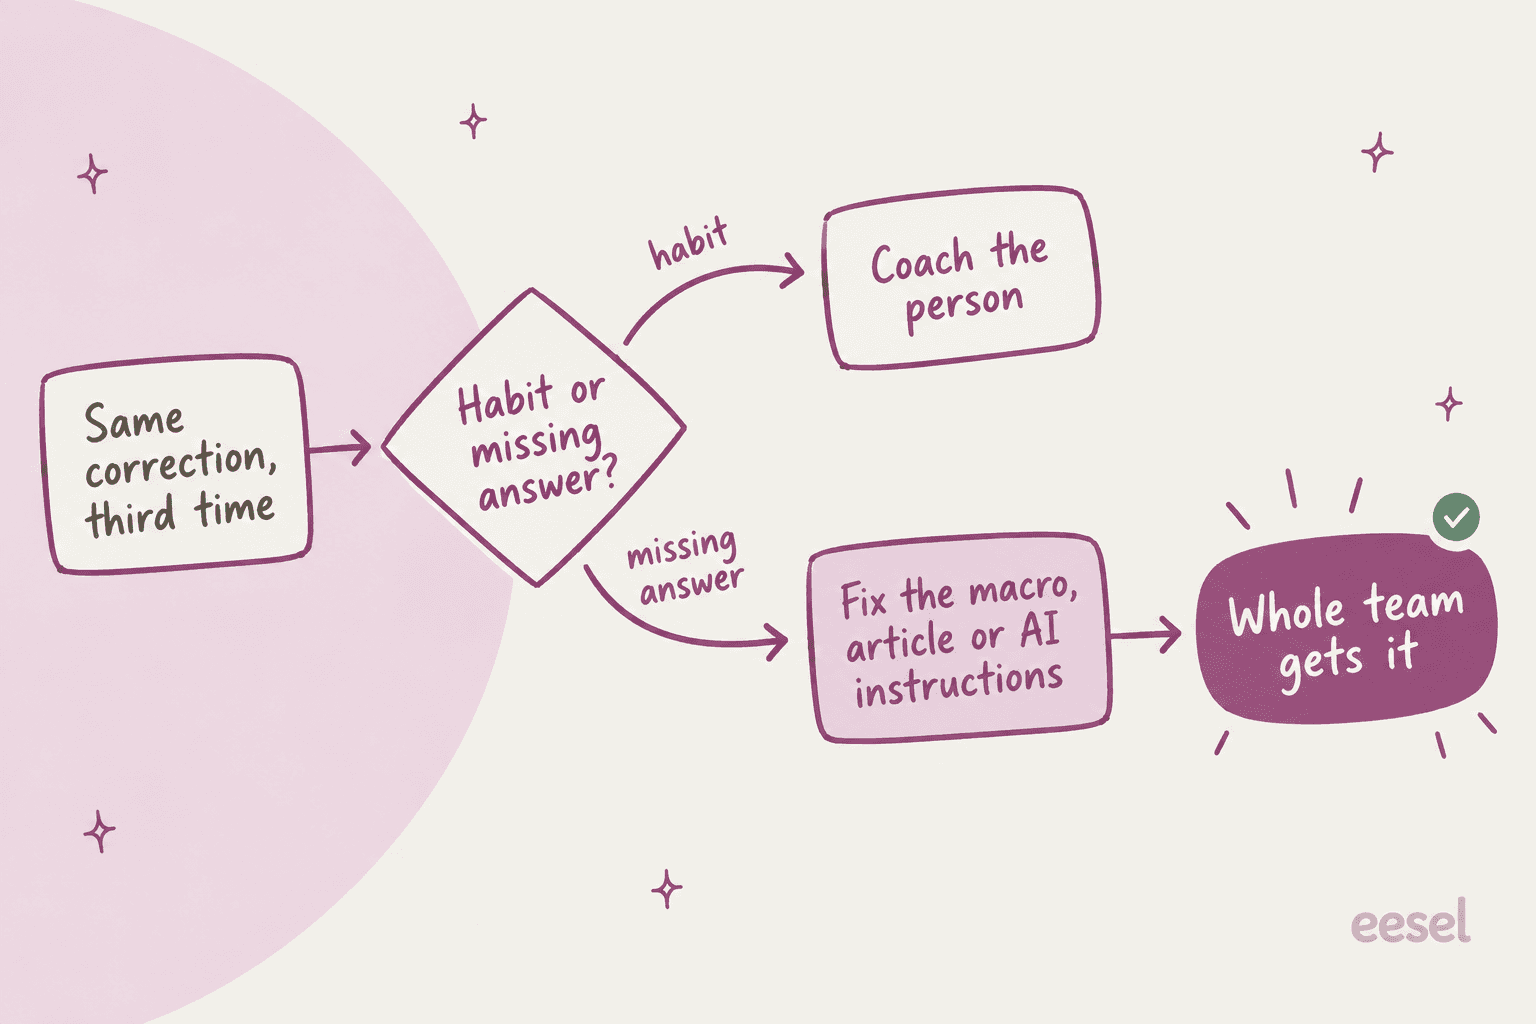
Las correcciones repetidas suelen ser un hueco en la base de conocimiento, una macro desactualizada o una política que vive en la cabeza de un sénior. Hacer coaching a cada agente por separado es lento, y la siguiente contratación cae directamente en el mismo hoyo. Arreglar la fuente una vez lo arregla para todos, y a menudo es una edición de cinco minutos.
Lo vi claramente en una prueba de eesel que revisé. Los agentes enviaban los borradores de la IA sin cambios solo alrededor del 12 % de las veces; el patrón habitual era "glance and rewrite", convirtiendo borradores largos en respuestas de una a tres frases. Desglosado, alrededor del 65 % eran longitud y tono, alrededor del 20 % necesitaban datos a los que la IA no estaba conectada, y solo alrededor del 5 % eran la IA equivocándose en los hechos. Todos los agentes daban el mismo feedback, a mano, en cada ticket. La solución no fue hacer coaching a los agentes ni a la IA ticket por ticket. Fue entrenar con las respuestas enviadas del propio equipo para que los borradores salieran con su voz desde el principio.
La misma lógica vale para tu equipo humano. Lleva una lista continua de correcciones de las notas diarias. Todo lo que aparezca tres veces se arregla en la fuente: el artículo de ayuda, la macro o las instrucciones de la IA. Luego menciónalo en la 1:1 para que el agente sepa que el problema fue el sistema, no él. Ese gesto hace más por la moral que cualquier sándwich de feedback.

Si un copiloto de IA redacta respuestas para tu equipo, también pertenece a este circuito. Necesita el mismo feedback que una contratación nueva, y lo bueno es que una corrección hecha una vez se aplica a todos los borradores futuros. Escribí más sobre eso en mi guía de coaching a un agente de IA.
Errores que hacen que el feedback a agentes de soporte salga mal
- Guardarlo todo para la evaluación mensual. Cuando llega, el agente lleva semanas repitiendo el hábito. Las notas diarias lo atrapan en el segundo ticket, no en el cuadragésimo.
- Puntuar tickets de los que nadie habla. Una revisión que el agente nunca comenta es una nota, no feedback. Revisa tu tasa de no vistas si tu herramienta la reporta.
- Ponderar la hoja de puntuación hacia los guiones. Si el 70 % de la puntuación son saludos y despedidas, los agentes optimizarán saludos y despedidas. Pondera más la resolución en el primer contacto y la precisión que la redacción.
- Usar puntuaciones de IA para decisiones de desempeño. Hasta los proveedores dicen que no. Usa la IA para encontrar los tickets que merecen una revisión humana y luego revísalos.
- Plantear un solo mal día como una métrica. Una llamada de traductor puede arruinar el tiempo de gestión de un día. Mira las tendencias de tres o más semanas.
- No tener vía de disputa, o tenerla lenta. Los agentes que no pueden responder dejan de confiar en todas las puntuaciones, incluidas las justas.
- Hacer coaching a personas por un proceso roto. Si tres agentes cometen el mismo error, arregla primero la macro o el artículo.
eesel para el feedback a agentes de soporte
Si tu equipo sigue recibiendo el mismo feedback sobre los mismos tipos de tickets, la solución más rápida es poner la respuesta correcta delante de los agentes antes de que envíen. El compañero de helpdesk con IA de eesel se conecta con Zendesk, Freshdesk, Gorgias y el resto de tu stack, aprende de tu centro de ayuda, tus macros y tus tickets pasados, y redacta cada respuesta como una nota interna para que un agente la revise y la envíe. Los agentes nuevos ven cómo responde tu equipo a un reembolso o a una caída antes de escribir una palabra, lo que convierte mucho feedback posterior en una edición rápida previa.

Lo que más me gusta para el feedback: cuando un líder corrige una respuesta en el chat, eesel escribe esa corrección en sus propias instrucciones, así que el arreglo aparece en todos los borradores futuros en lugar de repetirse en cinco 1:1 distintas. Un fundador que usa Freshdesk lo expresó así en una reseña de G2:
"When we re-test, it correctly incorporates the coaching... specifically on enabling newer team members to have a 24/7 supervisor that coaches them on how to handle inquiries."
Para ser claros sobre el terreno: eesel no es una hoja de puntuación de QA ni una herramienta de disputas para agentes humanos, así que mantén Zendesk QA, Front Smart QA o una plataforma de QA dedicada para eso. Lo que hace es reducir cuánto feedback correctivo necesitas dar en primer lugar. Puedes probar eesel gratis con 100 créditos y ver los borradores en tus propios tickets.