

GLM-5.3 Flash ist das Modell mit dem besten Verhältnis von Intelligenz zu Preis, das Sie derzeit aufrufen können, und daran lässt sich schwer rütteln. Artificial Analysis bewertet es mit 57 Punkten im Intelligence Index bei etwa 0,045 $ pro Aufgabe, nur drei Punkte hinter dem vollen GLM-5.3 zu einem Bruchteil des Preises. Es ist das erste nativ multimodale Modell der GLM-5-Linie, schlägt GLM-5.2 in jedem von Z.ai veröffentlichten Benchmark, und die offenen Gewichte liegen auf Hugging Face.
Die Nuance, die die meisten Berichte auslassen: Es ist ein günstiges Modell mit zwei echten Sternchen. Auf Z.ais eigener First-Party-API läuft es langsam, mit etwa 49 Tokens pro Sekunde, und der Ruf als „langsamstes Modell, das AA je gesehen hat“ stammt von diesem Endpunkt, nicht von den Gewichten. Bei einem Anbieter wie Databricks erhalten Sie vom selben Modell 273 Tokens pro Sekunde. Das andere Sternchen sind die Daten: Es gibt keinen unterzeichneten Vertrag, keine Zero-Retention-Stufe, und der First-Party-Dienst unterliegt dem Recht der Volksrepublik China.
Mein kurzes Urteil: Wenn Sie viel Coding, Agenten-Läufe oder Vision-Aufgaben erledigen und Kosten wichtiger sind als Latenz, ist GLM-5.3 Flash ein klares Ja, besonders selbst gehostet. Wenn Sie ein Modell in Echtzeit vor Kunden einsetzen, war der Preis nie Ihr schwierigstes Problem, und warum, erkläre ich am Ende.
Zunächst: Welches GLM-5.3 testen wir?
Das verwirrt viele, deshalb kurz zur Klärung. Es gibt zwei Modelle mit „5.3“ im Namen, und sie sind nicht dasselbe.
Das Flaggschiff GLM-5.3 ist ein reines Text-Modell für Coding und Cyber-Aufgaben, das mit 1,40 $ Input und 4,40 $ Output pro Million Tokens gelistet ist. GLM-5.3 Flash ist das günstigere, multimodale Geschwistermodell, das am 26. August 2026 erschien, und um dieses geht es in diesem Test. Es hat 320 Mrd. Parameter insgesamt, davon nur 18 Mrd. aktiv in einer Mixture-of-Experts-Architektur. Vor dem Start betrieb Z.ai es anonym als „ox-alpha“ auf OpenRouter und OpenCode, wo es kurzzeitig das meistgenutzte Modell der Woche wurde, und das alles auf chinesischen KI-Chips.
Wenn also in einer Benchmark-Tabelle „GLM-5.3“ steht, prüfen Sie, welches gemeint ist. Die Werte, die ich unten nenne, sind Flash-Werte, sofern ich nichts anderes sage. Für den Überblick über die ganze Familie zeigt die Übersicht zu GLM-5.3 Flash, wie beide zusammenpassen.
Ich habe es so bewertet wie jedes andere Large Language Model, das ich tatsächlich einsetzen würde: Ich habe beide Ranglisten gelesen, die Benchmark-Tabelle des Herstellers geprüft, sie mit Artificial Analysis und der Modellseite von Cloudflare abgeglichen und die Marketingaussagen mit dem verglichen, was Praktiker nach eigenen Tests berichteten.
Die Benchmarks: Wo es wirklich steht
Z.ais Kernaussage lautet, GLM-5.3 Flash „outperforms GLM-5.2 across benchmarks and real-world workloads at one-tenth the price, while approaching Claude Opus 4.8 on coding and agentic benchmarks.“ Die veröffentlichte Tabelle stützt die erste Hälfte eindeutig.
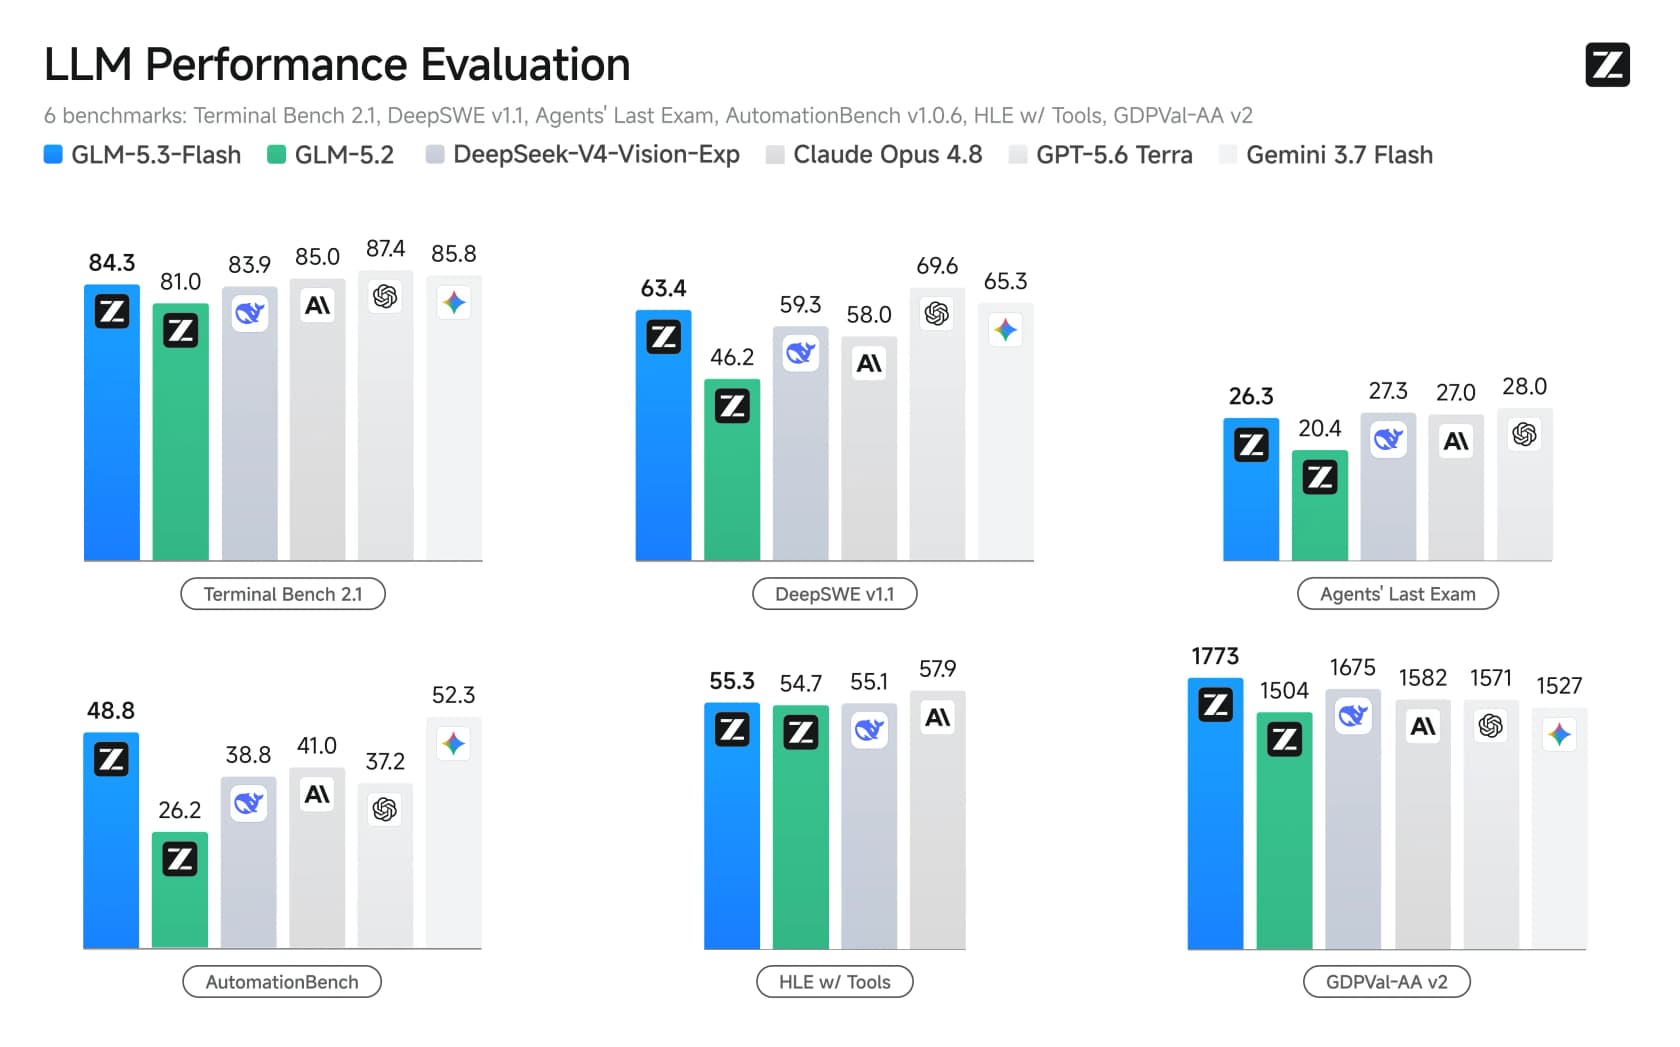
Die Sprünge gegenüber GLM-5.2 sind groß und durchgängig: DeepSWE v1.1 steigt von 46,2 auf 63,4, AutomationBench von 26,2 auf 48,8 und GDPval-AA v2 von 1504 auf 1773. Im Z.ai Code Bench v1.0, ausgeführt in Claude Code mit maximalem Aufwand, erreicht Flash 29,0 gegenüber 29,5 von Claude Opus 4.8. Das ist die Aussage „kommt Opus fast gleich“ in Zahlen.
Die Formulierung „nähert sich Opus“ ist bei Coding und Agenten-Aufgaben fair, und sie ist ehrlich darüber, wo sie endet. Gegenüber den geschlossenen Spitzenmodellen gewinnt GPT-5.6 Terra bei DeepSWE (69,6), und Gemini 3.7 Flash liegt bei AutomationBench knapp vorn (52,3). GLM-5.3 Flash schlägt die besten geschlossenen Modelle nicht eindeutig. Es landet für ein Zehntel des Geldes in derselben Region, und das ist eine andere und interessantere Aussage.
Klar vorne liegt es in der Tabelle an zwei Stellen, wo man es von einem Budget-Modell nicht erwartet: Es führt GDPval-AA v2 mit 1773 an, und bei den Vision-Zeilen erzielt es 89,4 bei CharXiv Reasoning und 80,5 bei MMVU, in beiden vor DeepSeek-V4-Vision-Exp und Opus. Für ein so günstiges Modell ist das die Überraschung.
Ein Vorbehalt, den ich klar nennen will: Auf keiner der beiden Seiten gibt es einen MMLU-, GPQA- oder AIME-Wert. Z.ai veröffentlicht eine Coding-, Agenten- und Vision-Suite, keine klassische Tabelle zu akademischem Wissen. Wenn Ihr Einsatz auf breitem Faktenwissen beruht, sagen die veröffentlichten Belege dazu schlicht nichts. Sehen Sie das als Datenlücke, nicht als Bestehen oder Durchfallen.
Der Preis ist die ganze Geschichte
Das ist die Zahl, die GLM-5.3 Flash überhaupt eine Besprechung wert macht. In der Launch-Aktion kostet es 0,075 $ pro Million Input-Tokens und 0,25 $ Output, bei einem Cached-Input-Satz von 0,015 $. Der Listenpreis nach Ende der Aktion am 9. September 2026 beträgt 0,15 $ und 0,50 $. So oder so ist das etwa ein Zehntel des Flaggschiffs GLM-5.3 und platziert es auf der Effizienzgrenze des gesamten Marktes.
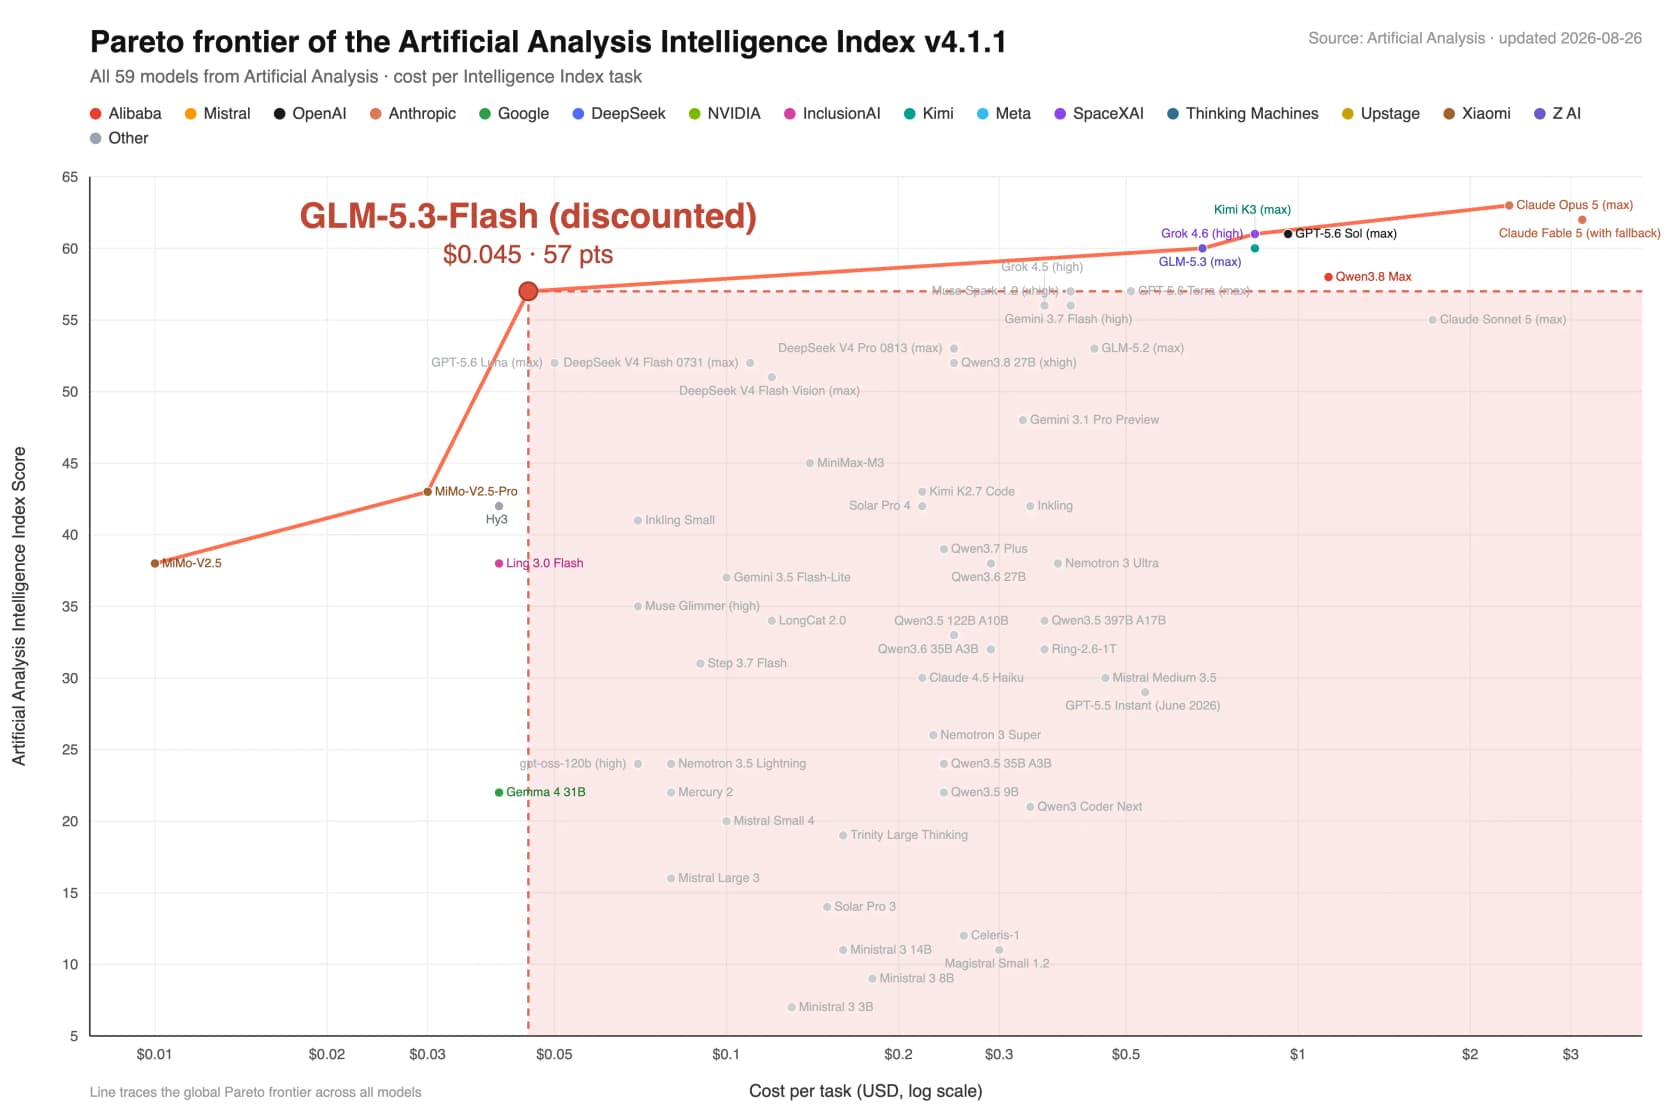
Dieser rote Punkt ist das Verkaufsargument. GLM-5.3 Flash verschiebt die Pareto-Grenze: Für die gebotene Intelligenz ist nichts auf dem Diagramm günstiger, und Z.ais eigene Formulierung lautet, dies sei „a level of intelligence previously only available at roughly 10x the cost.“ Die Reaktion der Community war meist Ungläubigkeit genau darüber.
"Noticeably cheaper even than Gemini Flash 3.7, while being only slightly worse performing. That's actually really impressive."

Der Weg über den Coding Plan verdient Erwähnung, denn dort werden die meisten Menschen dem Modell tatsächlich begegnen. Z.ais GLM Coding Plan kostet 18 $, 80 $ und 168 $ im Monat für Lite, Pro und Max, funktioniert in Claude Code, Cline, OpenCode, Cursor und Roo Code, und Flash bietet das Dreifache des nutzbaren Kontingents von GLM-5.3 im selben Plan. Wenn Sie bereits ein Coding-Abo bezahlen, ist Flash die Einstellung, mit der Ihre Credits dreimal so lange reichen. Wie es sich gegen andere günstige Spitzenmodelle schlägt, zeigen der DeepSeek-V4-Flash-Test und der Kimi-K3-Test, und Qwen 3.8 Max ist der Schritt nach oben beim Preis.
Wählen Sie, was Ihnen am wichtigsten ist, und ich gebe Ihnen die ehrliche Einschätzung.
Warum es so günstig sein kann
Ein so niedriger Preis bedeutet meist ein kleines, dummes Modell. Dieses ist keines von beidem, und der Grund liegt in der Architektur, nicht in einem Rabatt, der bald verschwindet. Z.ai erklärt die Kosten damit, dass drei Ebenen zusammenwirken, nicht ein einzelner Trick.
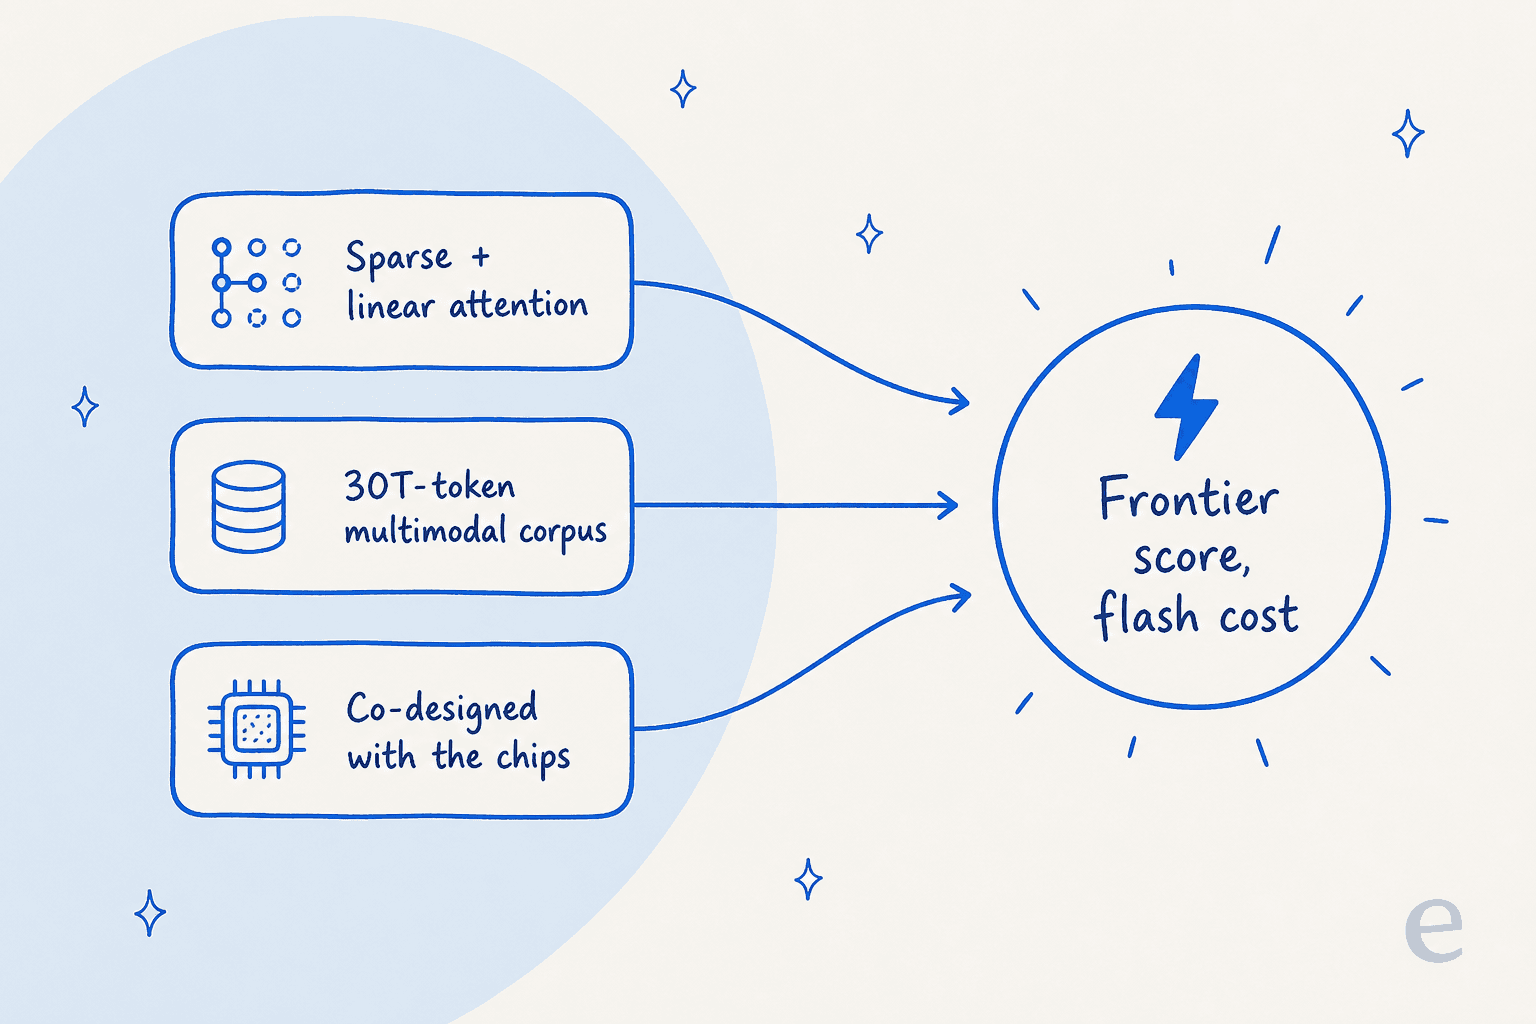
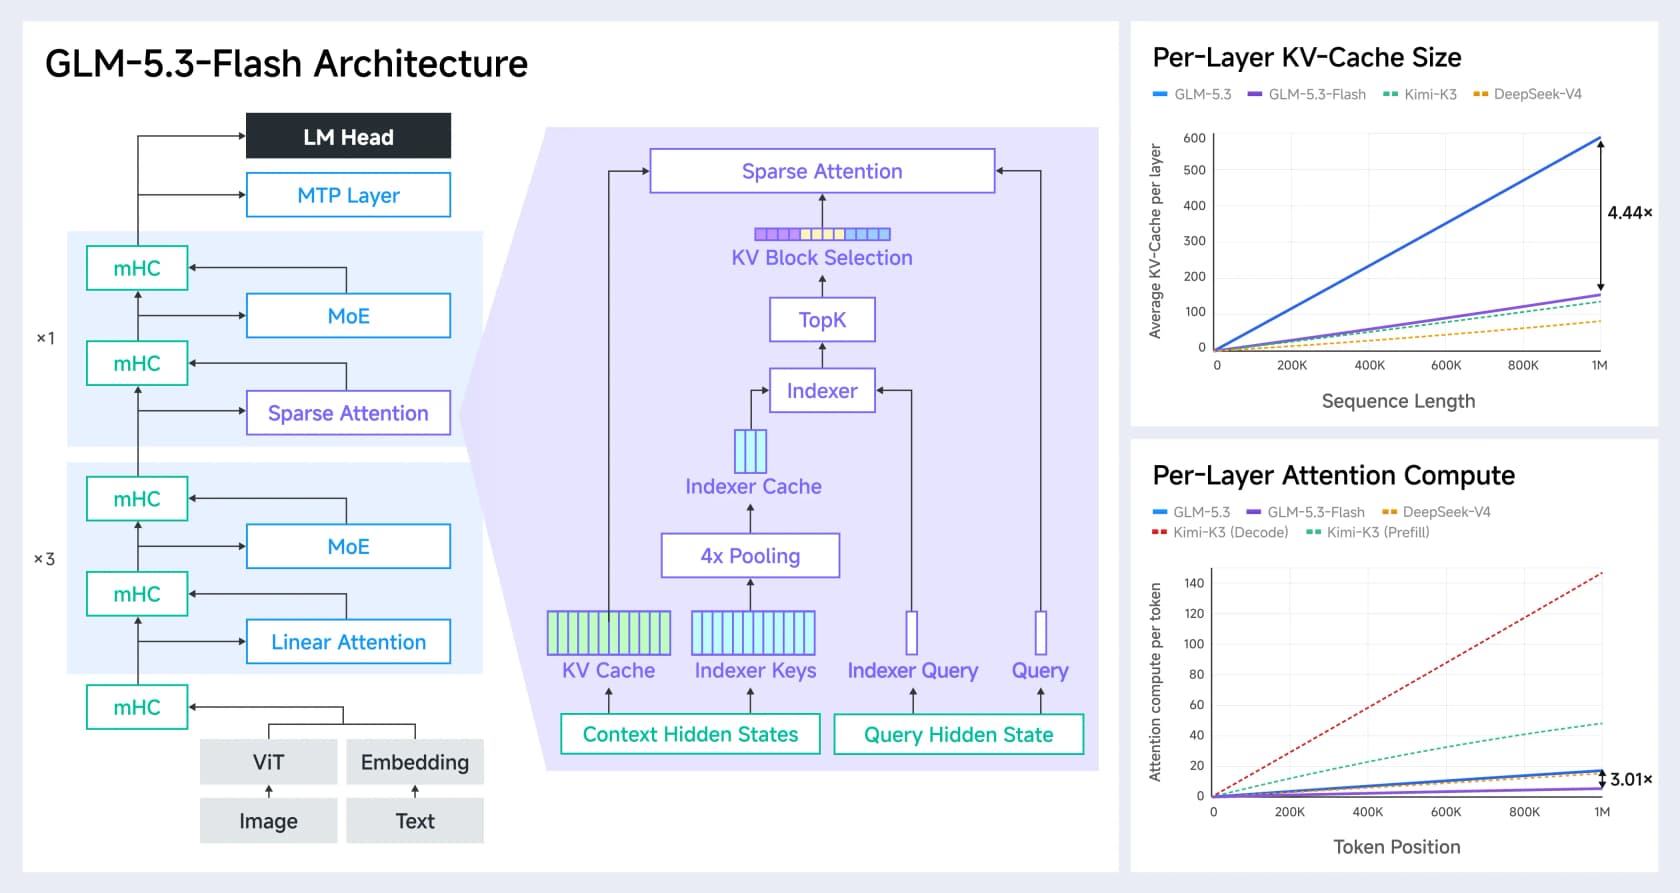
Das tragende Element ist das Attention-Design. GLM-5.3 Flash ist das erste offene Modell, das Sparse- und Linear-Attention kombiniert: Linear-Attention behandelt lokale Abhängigkeiten über Zustandsmodellierung, während ein leichtgewichtiger Indexer globalen Kontext abruft. Das Ergebnis sind laut Z.ai 3-mal weniger Attention-Rechenaufwand und ein 4,4-mal kleinerer KV-Cache als beim Flaggschiff GLM-5.3, und das ist größtenteils der Grund, warum der Betrieb bei 1 Mio. Tokens Kontext bezahlbar bleibt.
Die anderen beiden Ebenen sind im Alltag weniger wichtig, aber wissenswert. Es wurde auf einem multimodalen Korpus mit 30 Billionen Tokens trainiert, und das Ganze wurde gemeinsam mit chinesischer Inferenz-Hardware entworfen, worauf Z.ai immer wieder zurückkommt: „Chinese chips can support frontier-model inference efficiently and economically at scale.“ Verglichen mit dem älteren GLM-4.5 halbiert Flash bei ähnlicher Gesamtgröße fast sowohl die aktiven Parameter (18 Mrd. gegenüber 32 Mrd.) als auch die Schichtzahl (45 gegenüber 92). Das ist eine echte Effizienzgeschichte, kein Lockangebot zum Launch.
Die multimodale Wette: Vision im Coding-Loop
Das Interessanteste, was GLM-5.3 Flash tut, steht nicht in der Benchmark-Tabelle. Es bindet Vision in den Coding-Loop ein, sodass das Modell seine eigene Ausgabe rendern, ansehen und Fehler beheben kann. Z.ais Formulierung ist die treffende: „Code lets the model build and change the world. Vision lets it enter the world people see and use.“
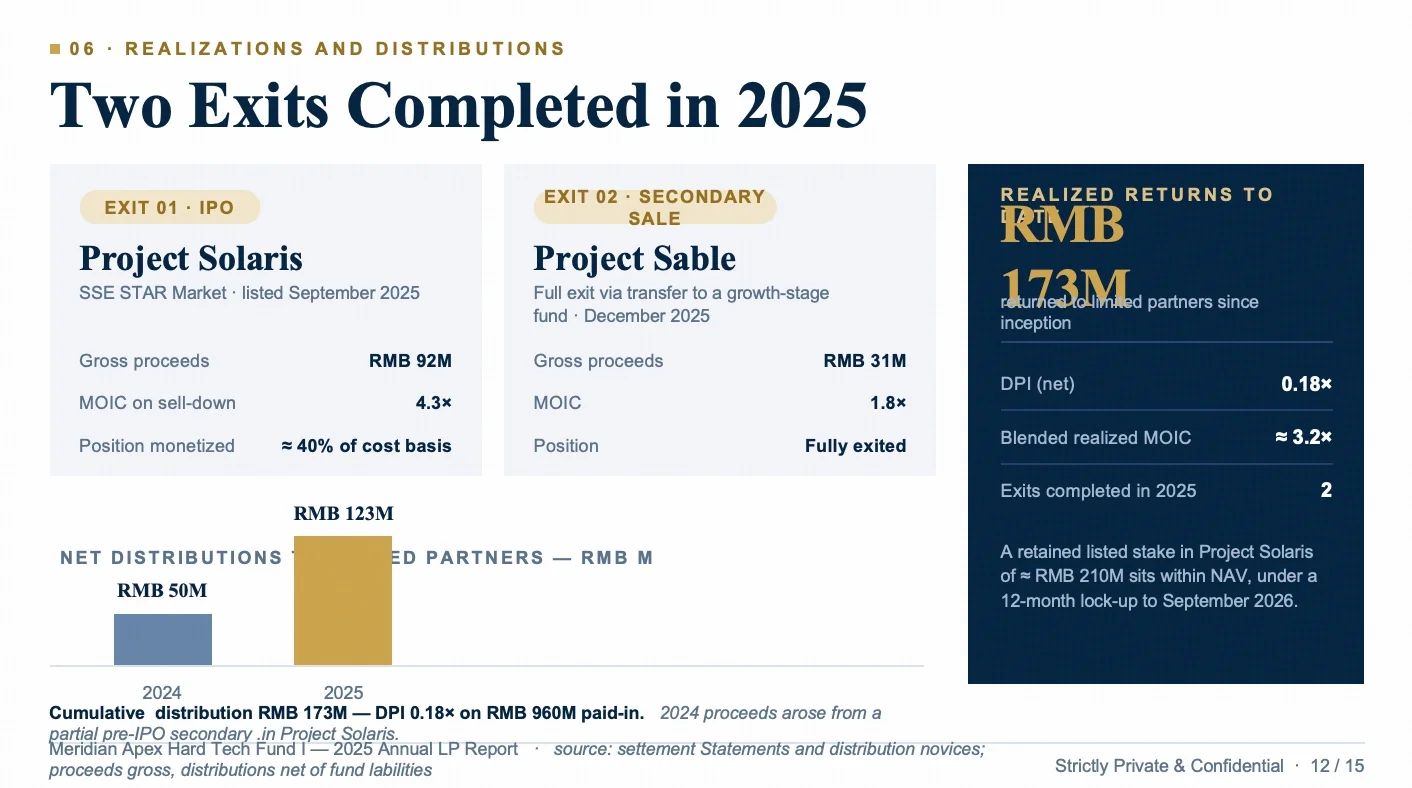
Die klarste Demo ist eine Folie, die es erzeugt und dann selbst repariert hat. Hier der erste Durchlauf mit überlappendem Text und kaputtem Layout:
Und hier dieselbe Folie, nachdem das Modell sein eigenes Rendering angesehen und die Überschneidung korrigiert hat:
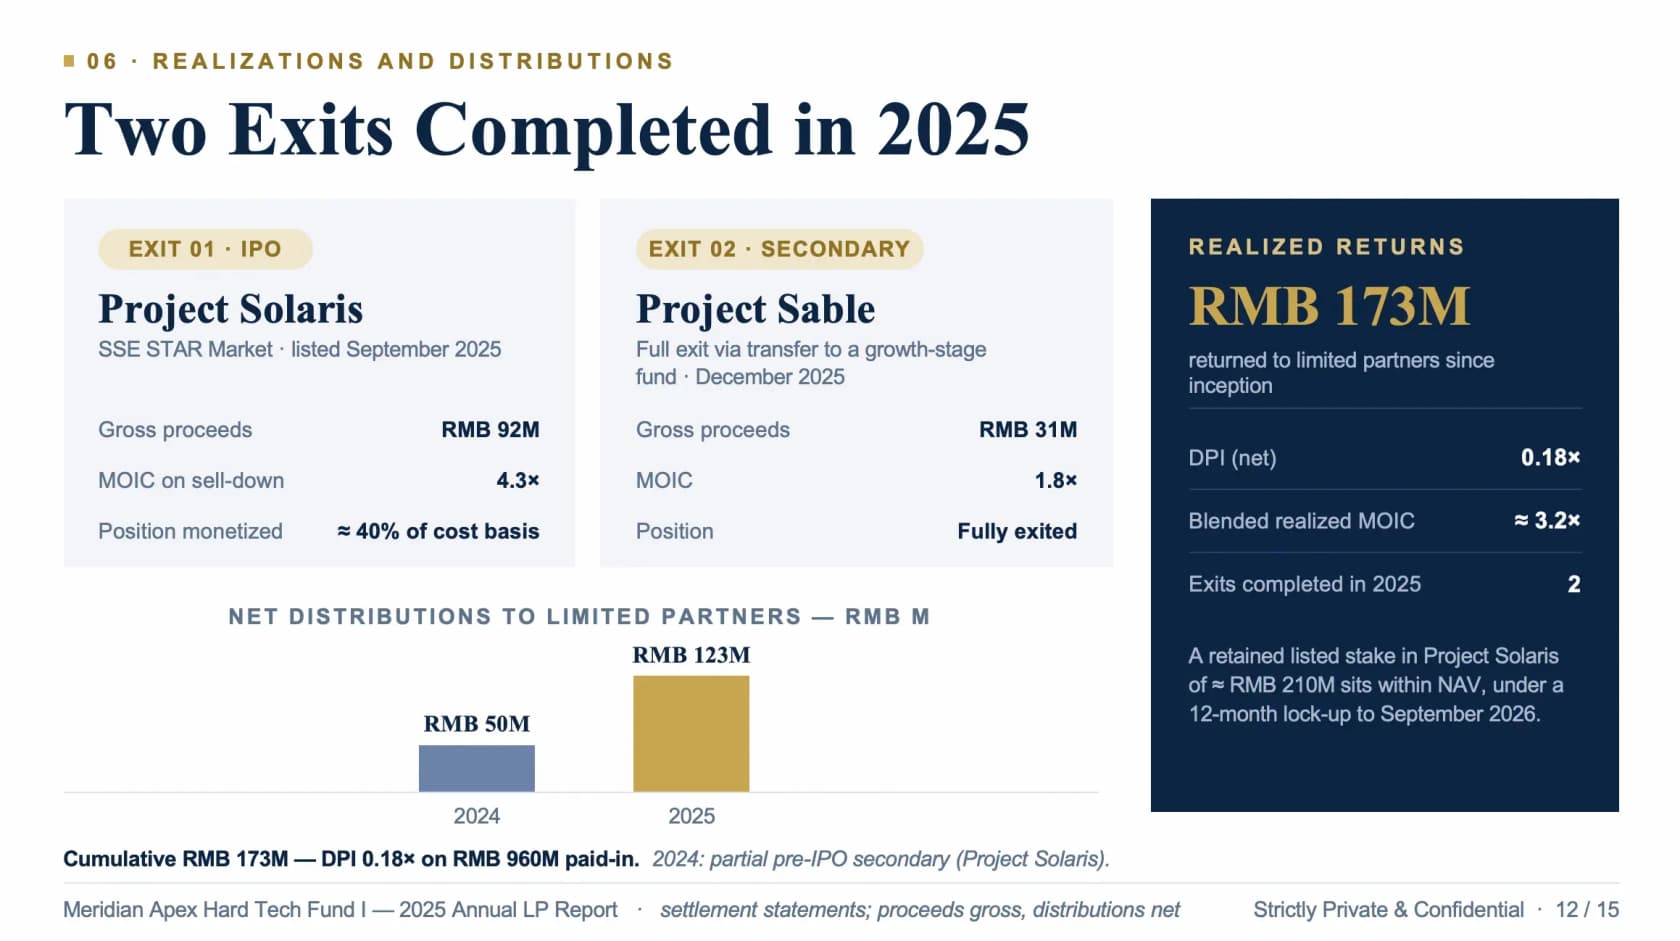
Das ist ein nützlicher Loop für Frontend-, Spiele- und 3D-Arbeit, wo „es kompiliert“ und „es sieht richtig aus“ zwei verschiedene Fragen sind. Er reicht auch über Code hinaus bis zum Lesen von Dashboards, Tabellen und Präsentationen sowie zu Computer-Use- und Browser-Use-Agenten in ZCode. Praktiker, die die Vision-Seite getestet haben, kamen überzeugt zurück:
"GLM-5.3-Flash vision. With 1,500 samples it scored an 81% accuracy rate, which is reasonable. It works very well."
Die Selbstprüfung würde ich dennoch als hilfreichen Reflex statt als Garantie behandeln. Sie fängt offensichtliche visuelle Fehler ab; sie ersetzt nicht den Blick eines Menschen auf alles, was live geht. Aber für eine erste nativ multimodale Version liegt die Vision-Qualität deutlich über dem, was der Preis erwarten lässt.
Wo es versagt
Ein Test, der nur Stärken aufzählt, ist eine Pressemitteilung. GLM-5.3 Flash hat zwei wunde Punkte, die Sie kennen sollten, bevor Sie es irgendwo einbinden.
Die First-Party-API ist langsam, und der Ruf ist verdient. Auf Z.ais eigenem Endpunkt läuft es mit etwa 49 Tokens pro Sekunde, gegenüber rund 86 beim vollen GLM-5.3, und ein Thread formulierte es deutlich.
"GLM 5.3 Flash is one of the slowest models AA [has ever seen]. GLM's visible context grows half as fast as Deepseek Flash and is much more precise and direct."
Die wichtige Nuance, und der Grund, warum ich dieses Zitat nicht das letzte Wort sein lassen würde: Es beschreibt den First-Party-Dienst, nicht die Gewichte. Artificial Analysis listet 11 Anbieter, und die Spannbreite ist enorm.
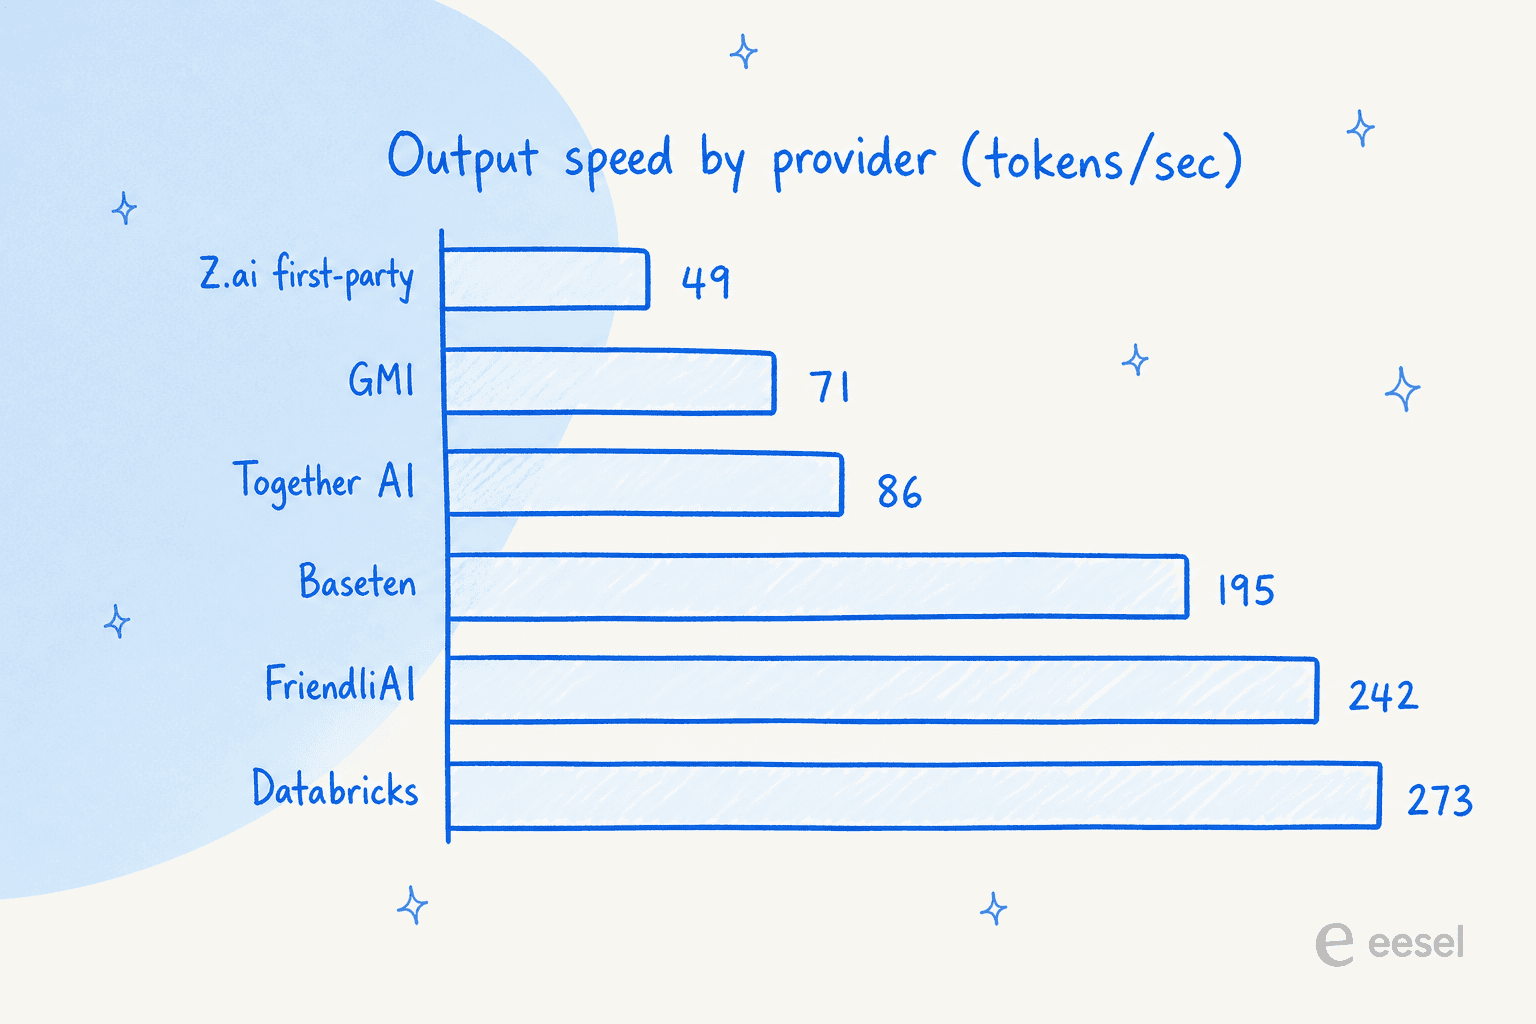
Databricks liefert dasselbe Modell mit 272,9 Tokens pro Sekunde, mehr als das Fünffache der First-Party-Rate, bei 8 Sekunden bis zum ersten Token. „GLM-5.3 Flash ist langsam“ heißt also eigentlich „Z.ais eigene API ist langsam“. Wählen Sie Ihren Host bewusst, und das Problem verschwindet größtenteils. Die Seite mit dem Anbieter-Benchmarking sollten Sie prüfen, bevor Sie sich festlegen, und wenn Sie echten Traffic darüber leiten, erspart Ihnen ein sauberes Setup zur Nutzungsverfolgung eine böse Überraschung bei der Rechnung.
Die Datenlage ist dünn, wenn Sie Kundeninhalte verarbeiten. Die First-Party-API bietet keinen veröffentlichten Auftragsverarbeitungsvertrag und keine Zero-Retention-Option, und der Dienst unterliegt dem Recht der VR China. Das ist eine echte Einschränkung, keine Kritik am Modell, und die ehrliche Lösung sind die offenen Gewichte: Self-Hosting unter SGLang, vLLM oder TokenSpeed ist der Weg zu einem kontrollierten Datenpfad. Wenn irgendetwas davon Kundendaten berührt, lesen Sie zuerst SOC 2 und DSGVO.
Noch etwas, das Sie einplanen sollten: Die GLM-5.3-Reihe denkt zuerst, also kalkulieren Sie Reasoning-Tokens in Ihre Kosten ein. Cloudflare bietet eine reasoning_effort-Steuerung mit den Stufen low, medium und high, sodass Sie bei einfachen Aufgaben herunterregeln können, aber es gibt keinen kostenlosen „gar nicht denken“-Modus, wie ihn manche Modelle bieten. Das ist zugleich ein Hinweis auf Halluzinationen: Mehr Reasoning bedeutet nicht mehr Genauigkeit, und die visuelle Selbstprüfung erstreckt sich nicht auf Tatsachenbehauptungen.
Was Menschen damit tatsächlich bauen
Das aufschlussreichste Signal ist kein Benchmark, sondern dass Anbieter und Entwickler es binnen Tagen aufgegriffen haben. James Grugett hat es zum Launch kostenlos in ein Produkt eingebaut:
"GLM 5.3 Flash is 100% free in our [product]. Leading capabilities at a highly competitive price - Natively multimodal with a 1M-token context window. Previously previewed as Ox Alpha."
Beim Einsatz für Security-Reviews löste das Preis-Leistungs-Verhältnis die lauteste Reaktion aus. Ein Team ließ es gegen einen Schwachstellen-Benchmark laufen und rechnete nach:
"We benchmarked the new GLM-5.3 Flash on VulnPR-100. It found 34/100 vulnerabilities at a total model-review cost of just $4.21. That makes it the strongest sub-$10 model we've tested."
So sieht ein guter GLM-5.3-Flash-Job aus: hohes Volumen, tolerant gegenüber etwas längerer Laufzeit und so günstig, dass Sie es auf Arbeit werfen können, für die Sie nie ein Spitzenmodell bezahlen würden. Die Übersicht beste Open-Source-KI-Agenten zeigt mehr solcher Muster, und wenn es speziell um Support geht, liefert das beste Modell für Support-Tickets eine engere Betrachtung dessen, worauf es dort ankommt.
Mein Urteil, nach Aufgabe
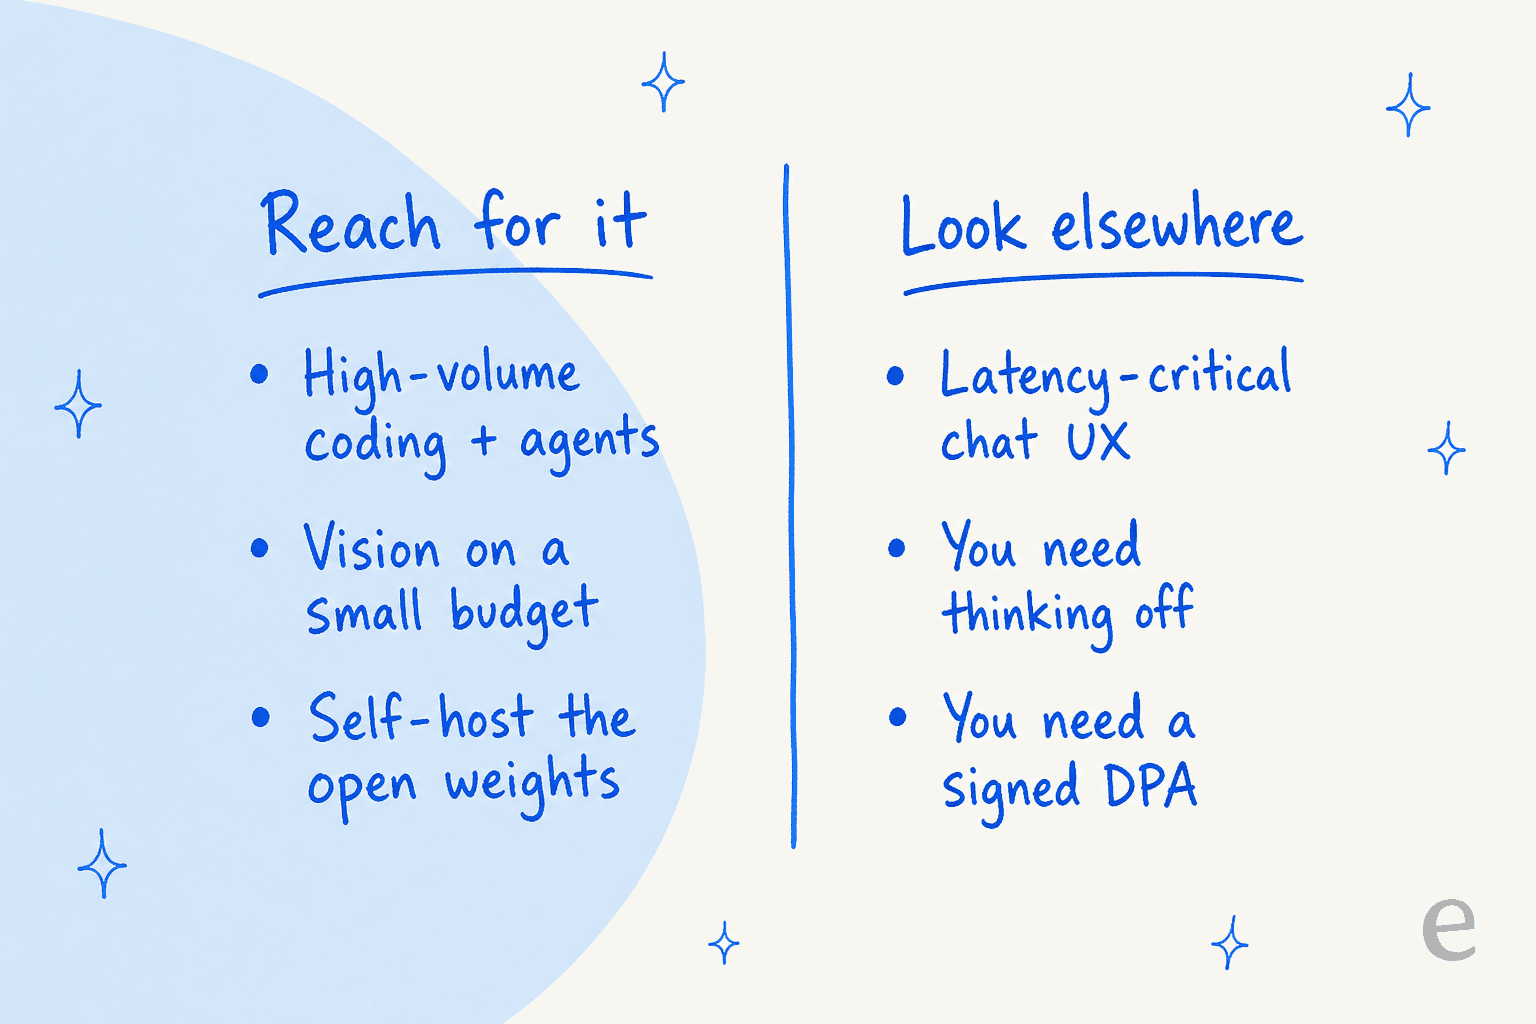
Greifen Sie zu GLM-5.3 Flash, wenn Sie Coding oder Agenten-Arbeit in großem Umfang betreiben, echte Vision-Qualität ohne Spitzenpreis wollen oder offene Gewichte selbst hosten und Ihre Daten im Haus behalten möchten. In allen drei Fällen ist es heute eines der besten Preis-Leistungs-Angebote, und die Übersicht zu GLM-5.3 Flash ist die Stelle, auf die ich Sie für die Einrichtung verweisen würde.
Schauen Sie sich anderswo um, wenn Latenz Ihr Produkt ist und Sie den Anbieter nicht kontrollieren können, wenn Sie einen Modus brauchen, der das Reasoning komplett überspringt, oder wenn Sie einen unterzeichneten Datenvertrag brauchen, den Sie ohne Self-Hosting nicht bekommen. Nichts davon ist fatal, aber in diesen Situationen verdient ein teureres, schnelleres oder stärker reguliertes Modell seinen Aufpreis. Wenn Sie es mit einer geschlossenen Spitzenoption vergleichen, ist Claude Opus 5 Preise der Referenzpunkt am anderen Ende der Skala.
Die Kurzfassung: GLM-5.3 Flash ist das Modell, das ich als Standard für günstige, hochvolumige, langsamkeitstolerante Arbeit wählen würde, und das, das ich sorgfältig testen würde, bevor ich ein latenzempfindliches Produkt darauf setze.
Try eesel
Wenn Sie hier gelandet sind, weil Sie Preise pro Token vergleichen, da eine KI den Support übernehmen soll, sage ich Ihnen, was ich bei einem Kaffee sagen würde: Der Token-Preis war nie der schwierige Teil. Ein Modell wie GLM-5.3 Flash ist der Motor. Es an Ihr Helpdesk anzubinden, es auf Ihren echten Makros und früheren Tickets zu fundieren und zu wissen, was es sagen wird, bevor ein Kunde es sieht, das ist die eigentliche Arbeit, und es ist ein ganz anderes Produkt.
Hier kommt eesel ins Spiel. eesel bietet Ihnen sofort einsatzbereite KI-Teammitglieder für bestimmte Aufgaben, einen KI-Support-Agenten, der sich in Zendesk oder Ihr bestehendes Helpdesk einklinkt, und einen KI-Blog-Autor für Inhalte. Jeder kommt mit den Skills, Integrationen und dem Unternehmenskontext für seine Rolle, sodass Sie ein Teammitglied einstellen, statt rohen Modellzugang zu mieten.
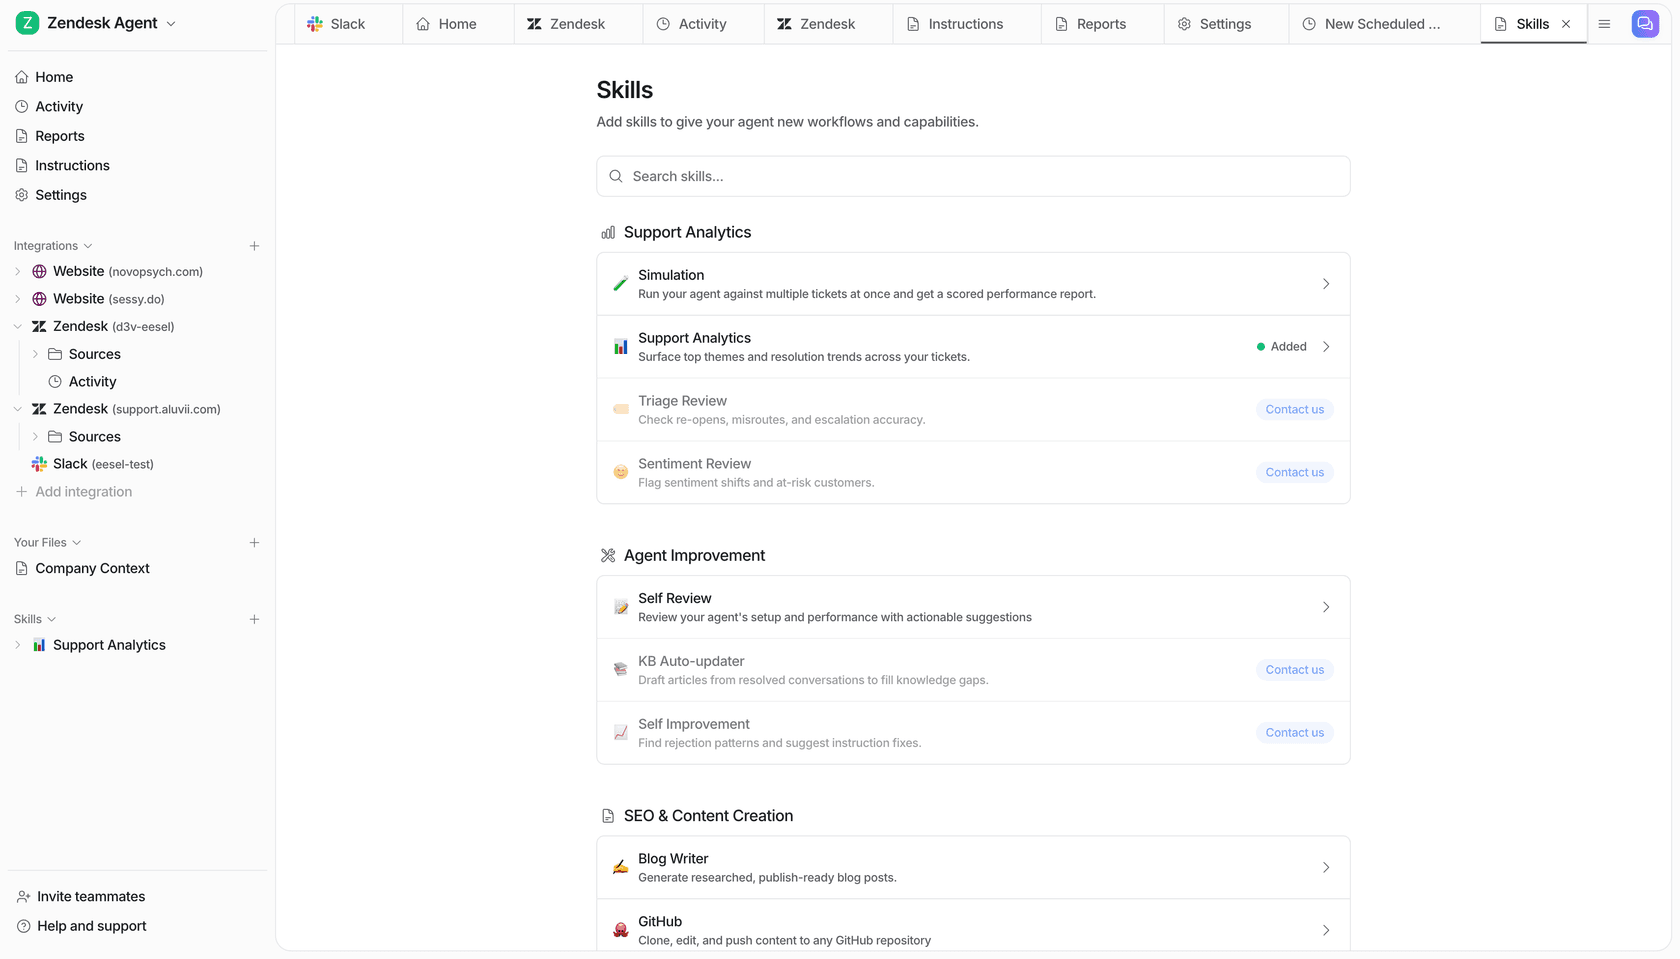
Das Wichtigste für den Support: Wir setzen seit Jahren KI-Agenten in Live-Support-Warteschlangen ein und haben erlebt, wie ein überzeugend klingender Bot Arbeit erzählt, die er nie getan hat. Genau deshalb wird jeder eesel-Rollout anhand vergangener Tickets simuliert, bevor er ein echtes Gespräch berührt. Die Preisgestaltung ist ein fester Monatspreis nach Volumen (1 Credit pro Ticket oder Chat) statt pro Platz, sodass ein schrittweiser Rollout wirklich möglich ist, und es gibt 100 kostenlose Credits zum Start. Dieses Credit-Modell ist auch der Grund, warum die Kosten von KI im Kundenservice anders ausfallen als eine reine Token-Rechnung. Führen Sie eine Simulation mit den Tickets des letzten Monats durch, und Sie wissen innerhalb einer Stunde, ob es Ihre Zeit wert ist, was besser ist, als ein Modell im Blindflug zu testen.