

O GLM-5.3 Flash é o modelo com melhor relação inteligência-preço que você pode chamar agora, e isso é difícil de contestar. A Artificial Analysis dá a ele 57 pontos no Intelligence Index por cerca de US$ 0,045 por tarefa, três pontos atrás do GLM-5.3 completo por uma fração do preço. É o primeiro modelo nativamente multimodal da linha GLM-5, supera o GLM-5.2 em todos os benchmarks que a Z.ai publicou, e os pesos abertos estão no Hugging Face.
A nuance que a maioria dos textos pula: é um modelo barato com dois asteriscos reais. Na API própria da Z.ai ele roda devagar, em torno de 49 tokens por segundo, e a fama de "modelo mais lento que a AA já viu" vem desse endpoint, não dos pesos. Mude para um provedor como a Databricks e o mesmo modelo entrega 273 tokens por segundo. O outro asterisco são os dados: não há acordo assinado, nem nível de retenção zero, e o serviço próprio opera sob a lei da República Popular da China.
Meu veredito curto. Se você faz programação em alto volume, execuções com agentes ou trabalho de visão e se importa mais com custo do que com latência, o GLM-5.3 Flash é um sim fácil, principalmente hospedado por conta própria. Se você vai colocar um modelo na frente de clientes em tempo real, o preço nunca foi o seu problema difícil, e volto a isso no final.
Primeiro, qual GLM-5.3 estamos analisando?
Isso confunde muita gente, então vou esclarecer rápido. Há dois modelos com "5.3" no nome, e eles não são a mesma coisa.
O GLM-5.3 principal é um modelo só de texto para programação e cibersegurança, listado a US$ 1,40 de entrada e US$ 4,40 de saída por milhão de tokens. O GLM-5.3 Flash é o irmão mais barato e multimodal, lançado em 26 de agosto de 2026, e é sobre ele esta análise. Ele tem 320B de parâmetros no total, com apenas 18B ativos em uma arquitetura de mistura de especialistas, e antes do lançamento a Z.ai o rodou de forma anônima como "ox-alpha" no OpenRouter e no OpenCode, onde ele chegou a ser o modelo mais usado da semana, tudo servido em chips de IA chineses.
Então, quando uma tabela de benchmarks disser "GLM-5.3", confira qual é. As pontuações que cito abaixo são do Flash, a menos que eu diga o contrário. Se quiser um panorama mais amplo da família, a visão geral do GLM-5.3 Flash mostra como os dois se encaixam.
Avaliei como avalio qualquer modelo de linguagem grande que eu pudesse colocar para trabalhar: li os dois placares, puxei a tabela de benchmarks do próprio fornecedor, cruzei com a Artificial Analysis e com a página do modelo na Cloudflare, e comparei as promessas de marketing com o que os profissionais disseram depois de testar por conta própria.
Os benchmarks: onde ele realmente fica
O destaque da Z.ai é que o GLM-5.3 Flash "outperforms GLM-5.2 across benchmarks and real-world workloads at one-tenth the price, while approaching Claude Opus 4.8 on coding and agentic benchmarks." A tabela publicada sustenta com clareza a primeira metade.
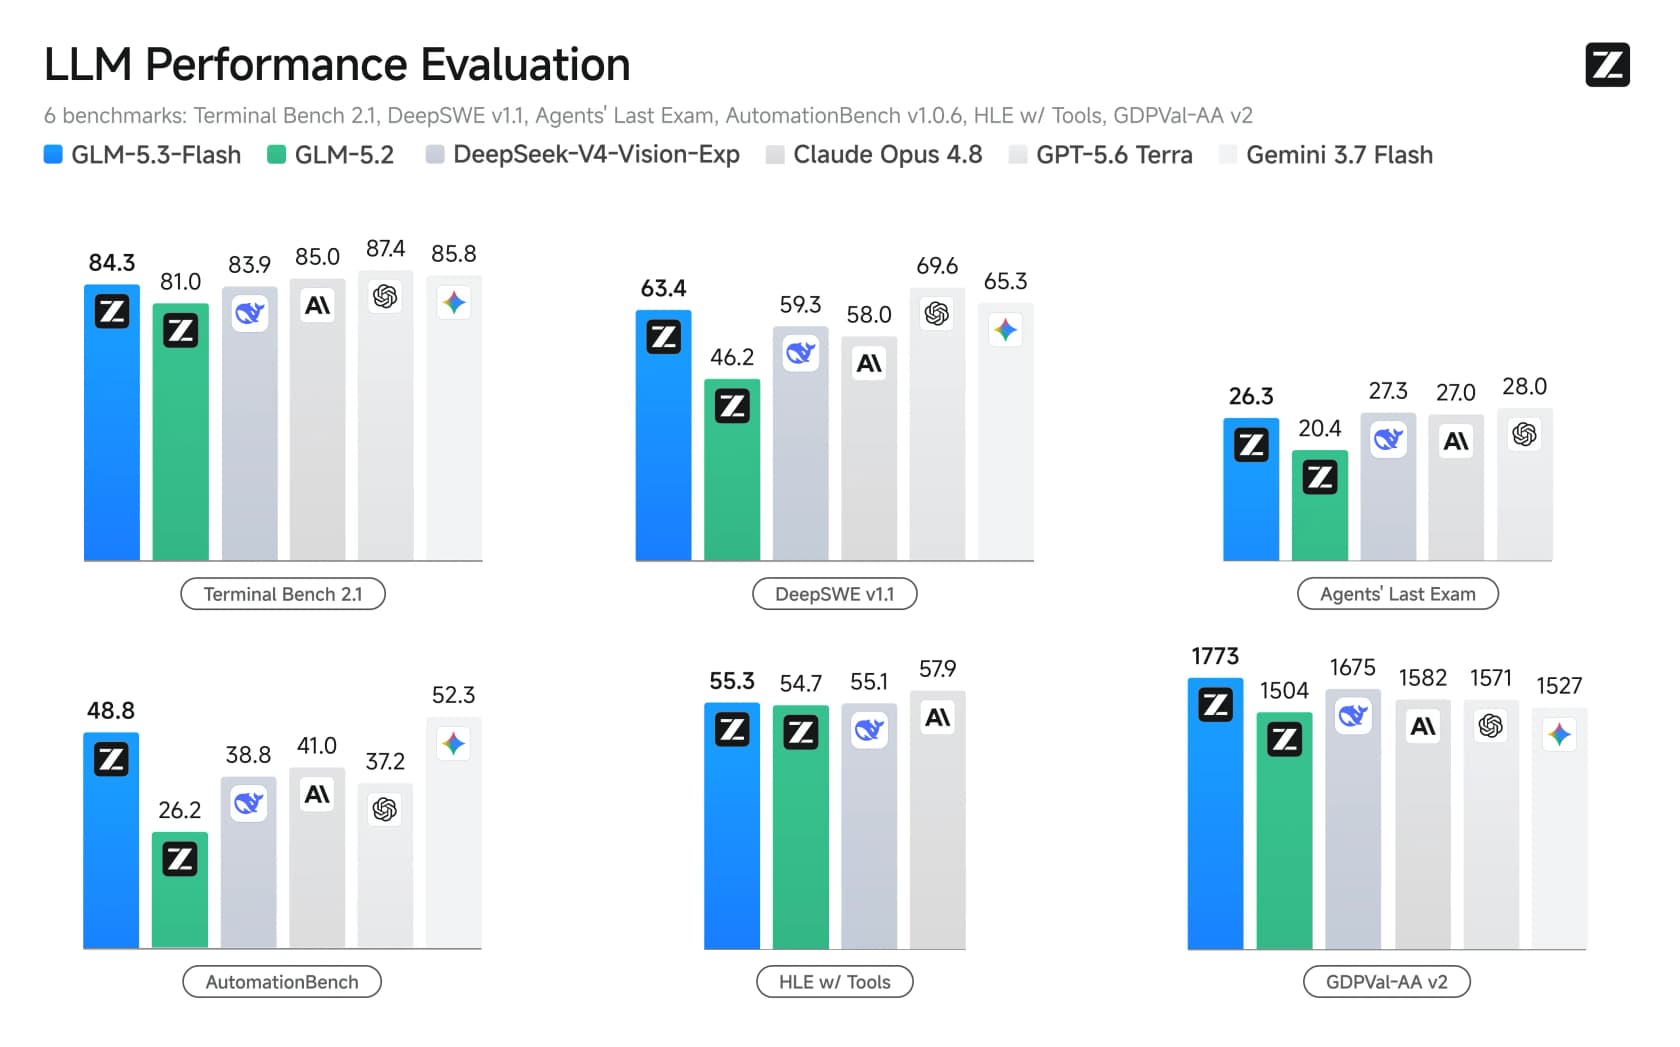
Os saltos sobre o GLM-5.2 são grandes e consistentes: o DeepSWE v1.1 vai de 46,2 para 63,4, o AutomationBench de 26,2 para 48,8 e o GDPval-AA v2 de 1504 para 1773. No Z.ai Code Bench v1.0, executado dentro do Claude Code com esforço máximo, o Flash marca 29,0 contra 29,5 do Claude Opus 4.8, que é a frase "quase iguala o Opus" na prática.
Dizer "se aproxima do Opus" é justo em programação e tarefas com agentes, e é honesto sobre onde isso para. Diante dos modelos fechados de ponta, o GPT-5.6 Terra leva o DeepSWE (69,6) e o Gemini 3.7 Flash passa por pouco no AutomationBench (52,3). O GLM-5.3 Flash não vence de forma clara os melhores modelos fechados. Ele chega à mesma vizinhança por um décimo do dinheiro, que é uma afirmação diferente e mais interessante.
Onde ele lidera claramente a tabela é em dois lugares em que ninguém espera de um modelo econômico: lidera o GDPval-AA v2 com 1773 e, nas linhas de visão, marca 89,4 no CharXiv reasoning e 80,5 no MMVU, à frente do DeepSeek-V4-Vision-Exp e do Opus nos dois. Para um modelo tão barato, essa é a surpresa.
Uma ressalva que vale dizer com clareza: não há pontuação de MMLU, GPQA nem AIME em nenhuma das duas páginas. A Z.ai divulga um conjunto de programação, agentes e visão, não uma tabela tradicional de conhecimento acadêmico, então se o seu caso de uso depende de amplo conhecimento factual, a evidência publicada simplesmente não diz nada. Trate isso como uma lacuna nos dados, não como aprovação ou reprovação.
O preço é a história toda
Este é o número que faz o GLM-5.3 Flash valer uma análise. Na promoção de lançamento, custa US$ 0,075 por milhão de tokens de entrada e US$ 0,25 de saída, com taxa de entrada em cache de US$ 0,015. O preço de tabela depois do fim da promoção, em 9 de setembro de 2026, é de US$ 0,15 e US$ 0,50. De qualquer modo, é cerca de um décimo do GLM-5.3 principal, e o coloca na fronteira de eficiência de todo o mercado.
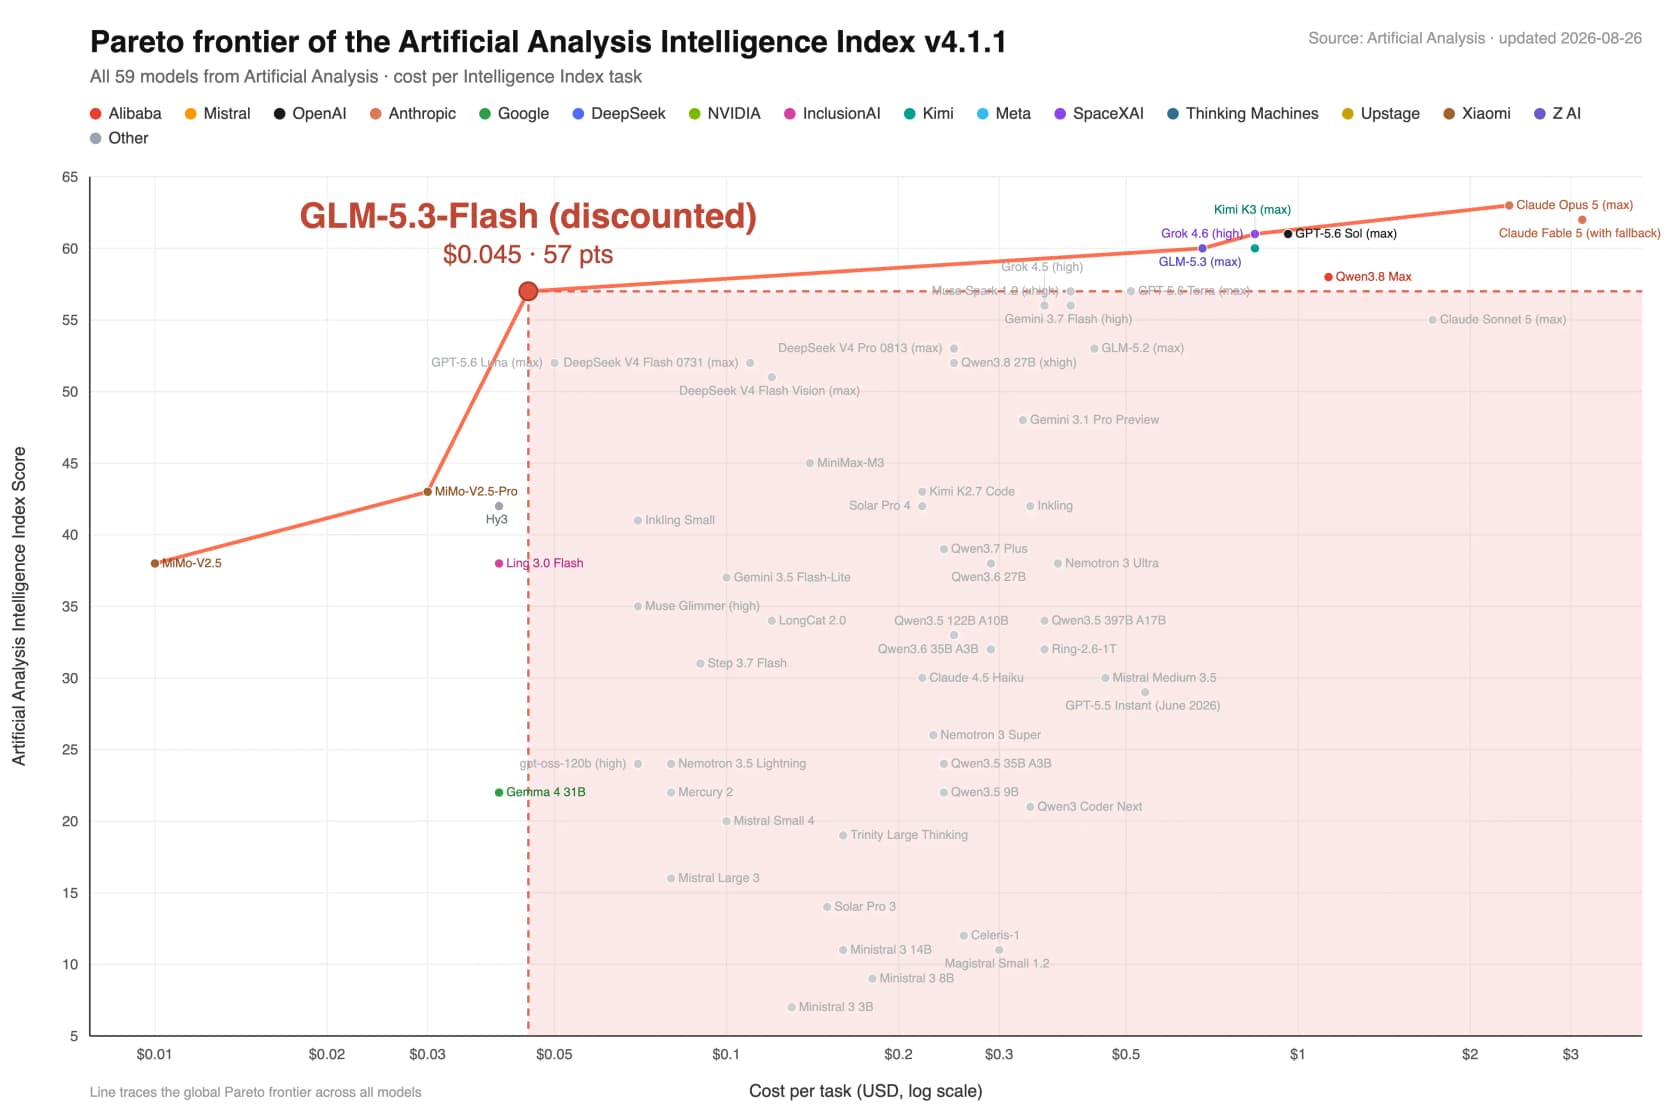
Aquele ponto vermelho é o argumento de venda. O GLM-5.3 Flash empurra a fronteira de Pareto: para a inteligência que entrega, nada no gráfico é mais barato, e a própria frase da Z.ai é que isto é "a level of intelligence previously only available at roughly 10x the cost." A reação da comunidade foi, em geral, de incredulidade justamente com isso.
"Noticeably cheaper even than Gemini Flash 3.7, while being only slightly worse performing. That's actually really impressive."

Vale mencionar o caminho do Coding Plan, porque é por onde a maioria das pessoas vai realmente conhecer este modelo. O GLM Coding Plan da Z.ai custa US$ 18, US$ 80 e US$ 168 por mês para Lite, Pro e Max, funciona dentro do Claude Code, Cline, OpenCode, Cursor e Roo Code, e o Flash dá 3 vezes a cota utilizável do GLM-5.3 no mesmo plano. Se você já paga uma assinatura de programação, o Flash é a configuração que faz os créditos durarem três vezes mais. Para ver como ele se compara a outras opções de ponta baratas, a análise do DeepSeek V4 Flash e a análise do Kimi K3 cobrem os rivais mais próximos, e o Qwen 3.8 Max é o degrau acima em preço.
Escolha o que mais importa para você e eu dou a avaliação honesta.
Por que ele pode ser tão barato
Um preço tão baixo costuma significar um modelo pequeno e fraco. Este não é nenhum dos dois, e o motivo é arquitetural, não um desconto que vai evaporar. A explicação da Z.ai é que o custo vem de três camadas trabalhando juntas, não de um truque só.
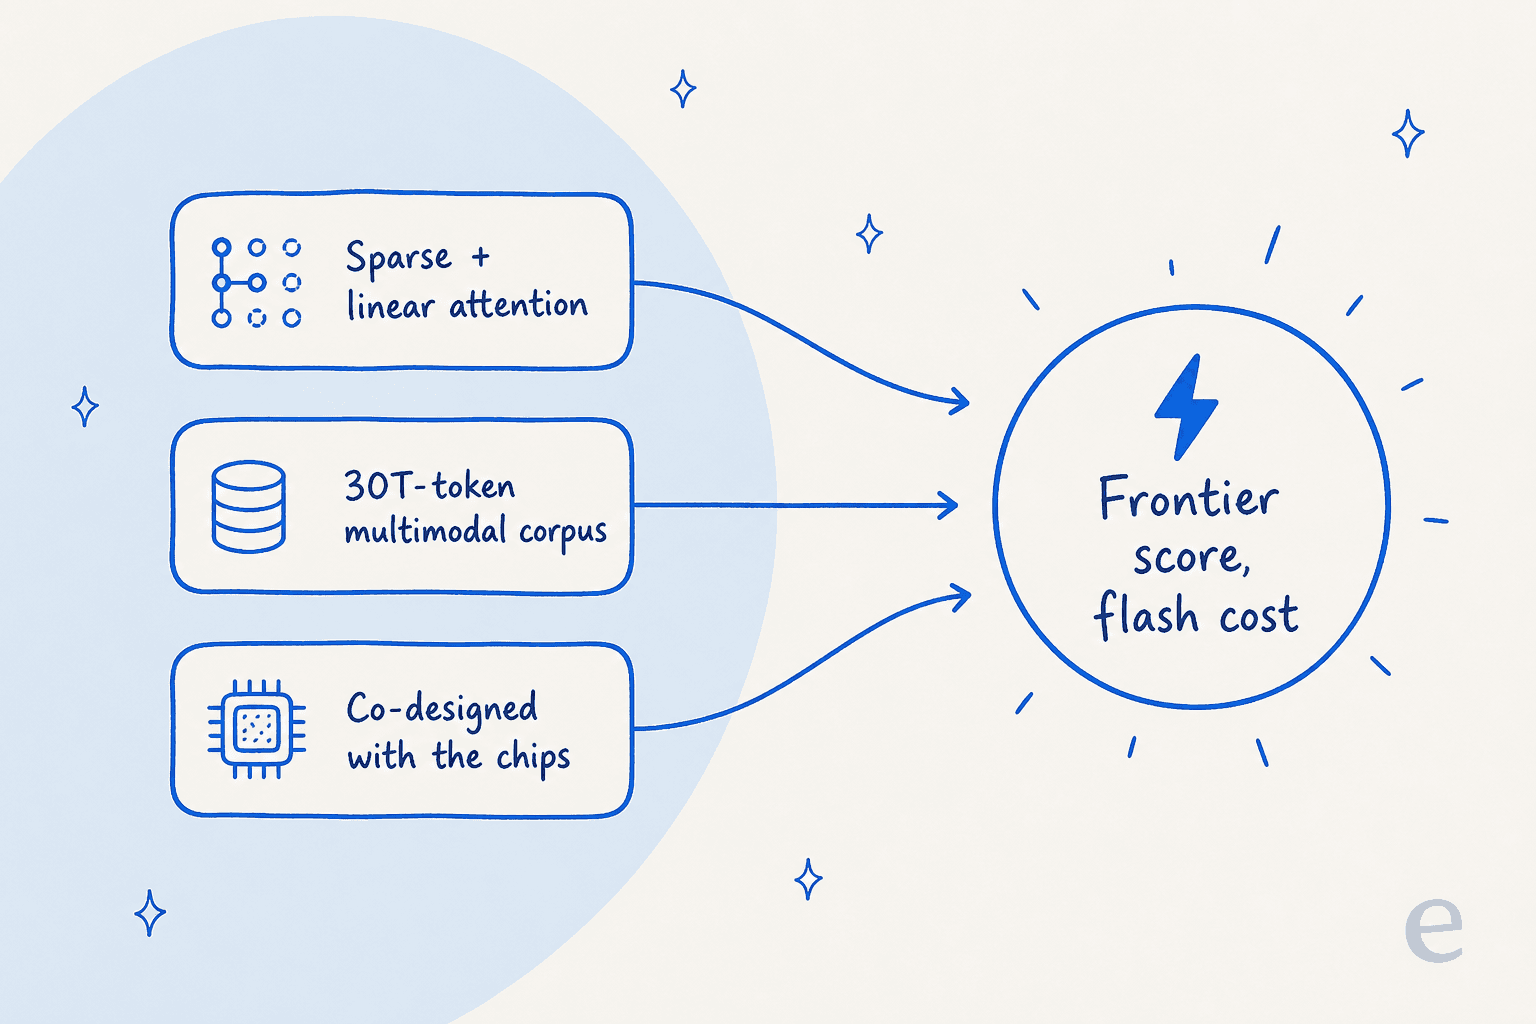
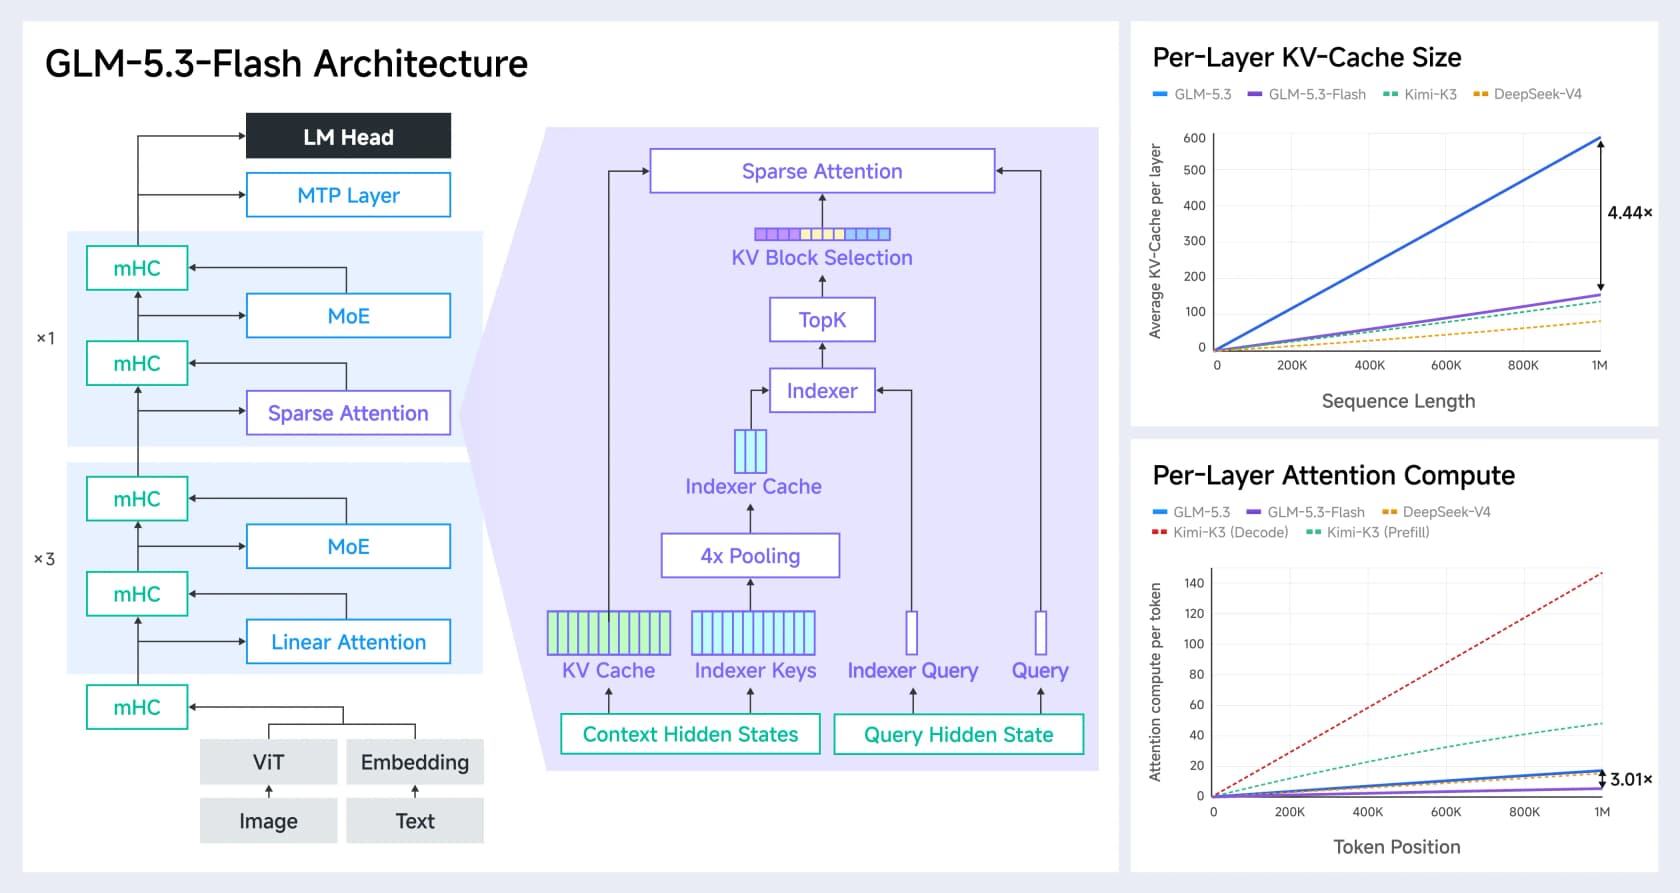
A peça principal é o desenho da atenção. O GLM-5.3 Flash é o primeiro modelo aberto a combinar atenção esparsa e linear: a atenção linear trata dependências locais por modelagem de estado, enquanto um indexador leve recupera o contexto global. O resultado, segundo a Z.ai, é 3 vezes menos computação de atenção e um cache KV 4,4 vezes menor do que o GLM-5.3 principal, que é a maior parte do motivo pelo qual servi-lo com 1M de tokens de contexto continua acessível.
As outras duas camadas importam menos no dia a dia, mas vale conhecê-las. Ele foi treinado em um corpus multimodal de 30 trilhões de tokens, e tudo foi projetado em conjunto com hardware de inferência chinês, ponto a que a Z.ai volta sempre: "Chinese chips can support frontier-model inference efficiently and economically at scale." Em comparação com o antigo GLM-4.5, o Flash quase divide pela metade tanto os parâmetros ativos (18B contra 32B) quanto o número de camadas (45 contra 92), com tamanho total semelhante. É uma história real de eficiência, não uma isca da semana de lançamento.
A aposta multimodal: visão dentro do ciclo de programação
O mais interessante que o GLM-5.3 Flash faz não está na tabela de benchmarks. Ele integra a visão ao ciclo de programação, de modo que o modelo pode renderizar a própria saída, olhar para ela e corrigir o que estiver errado. A frase da Z.ai é a mais certeira: "Code lets the model build and change the world. Vision lets it enter the world people see and use."
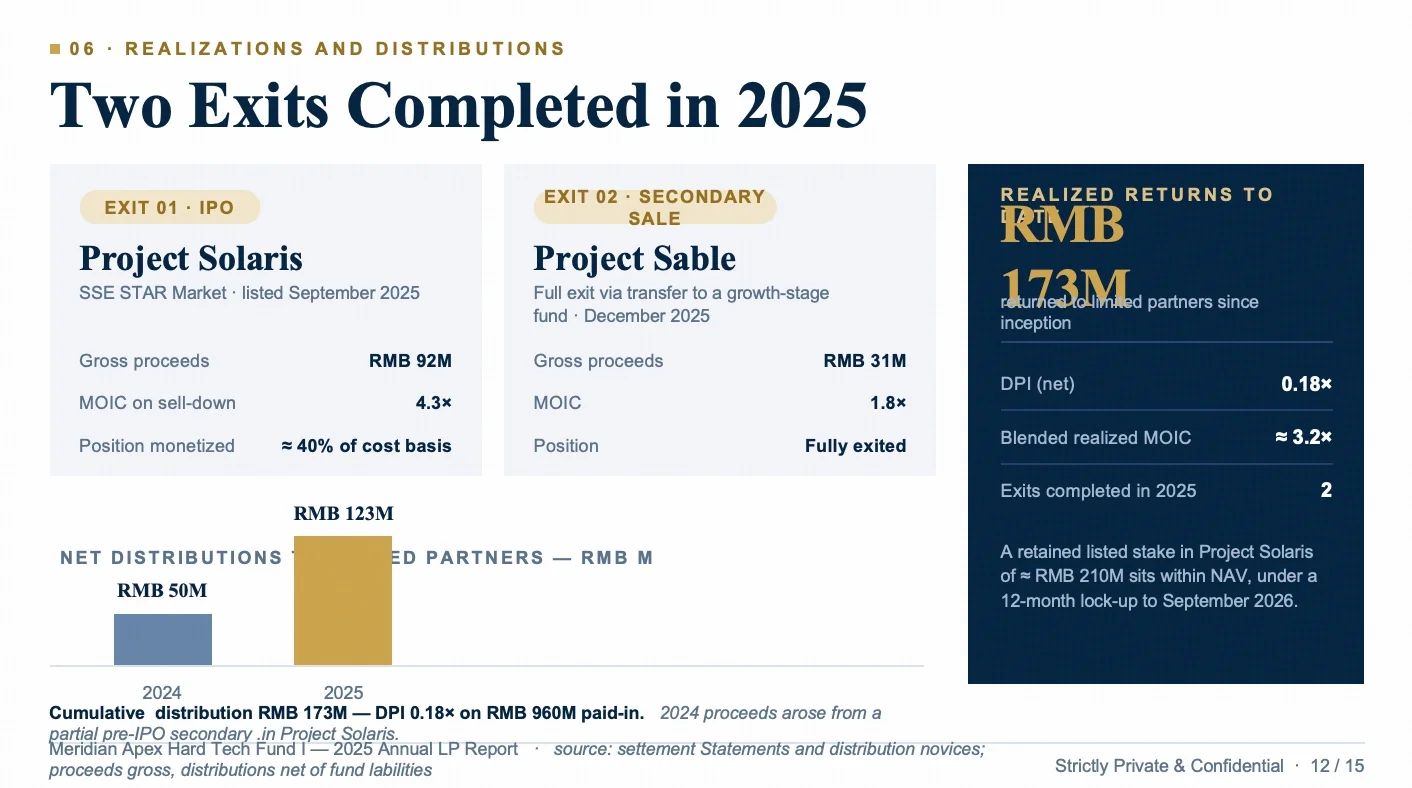
A demonstração mais clara é um slide que ele gerou e depois consertou sozinho. Aqui está a primeira tentativa, com texto sobreposto e layout quebrado:
E aqui o mesmo slide depois que o modelo olhou o próprio render e corrigiu a colisão:
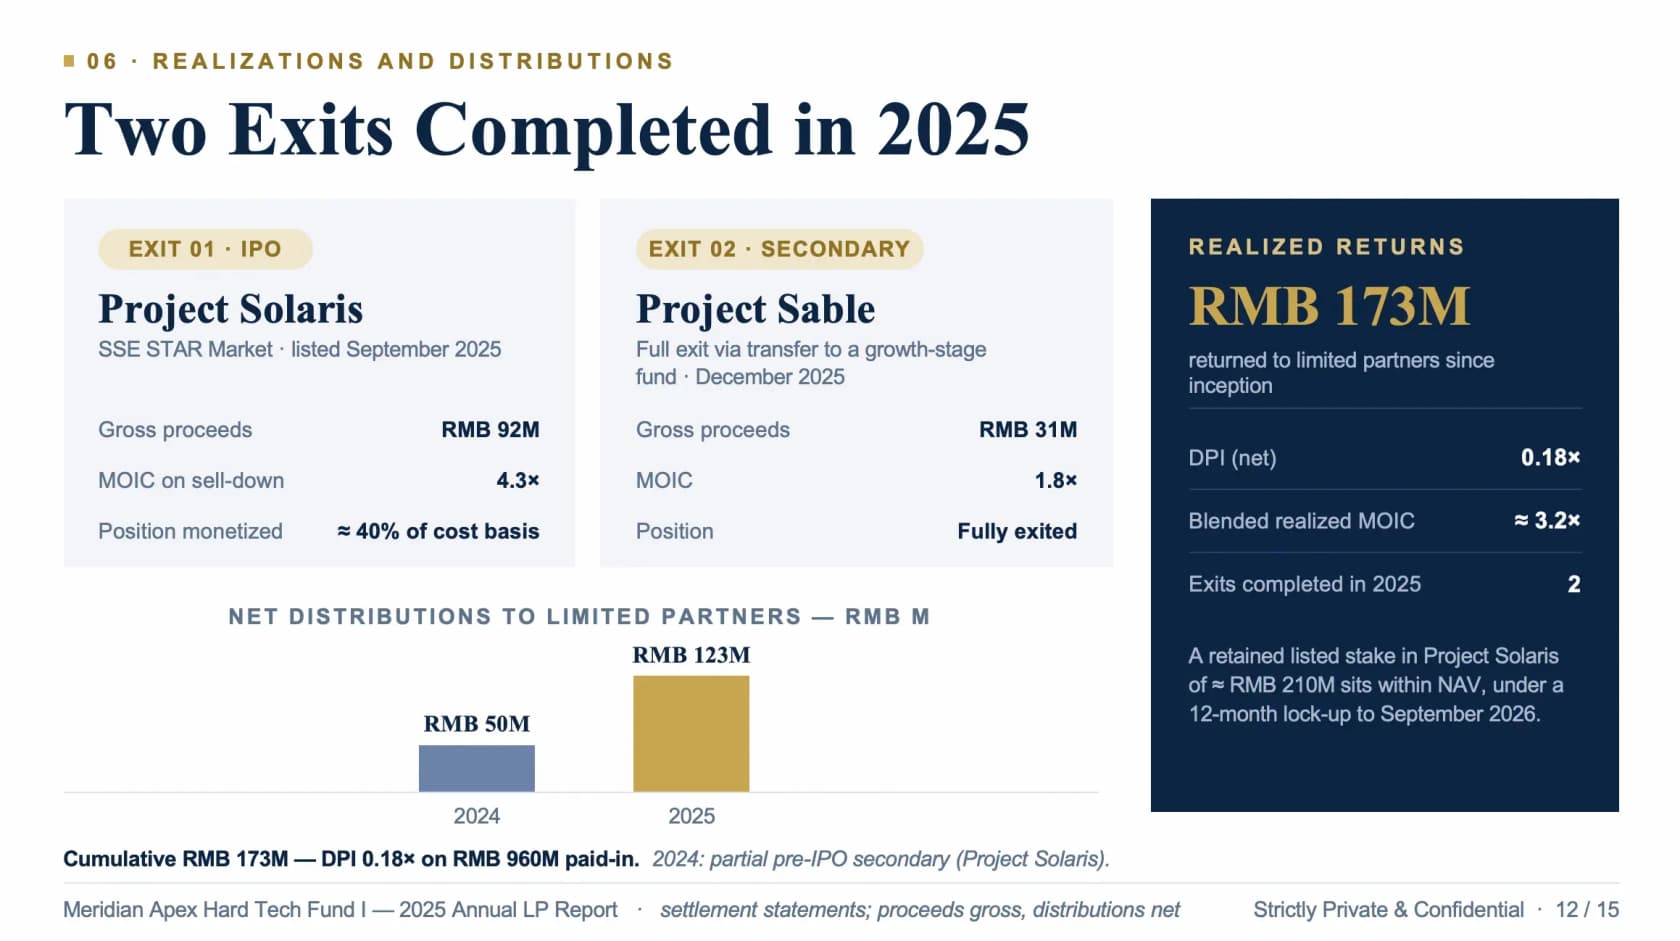
É um ciclo útil para frontend, jogos e 3D, onde "compila" e "parece certo" são perguntas diferentes. Ele também vai além do código, até a leitura de painéis, planilhas e apresentações, além de agentes de uso de computador e de navegador dentro do ZCode. Os profissionais que testaram o lado de visão saíram convencidos:
"GLM-5.3-Flash vision. With 1,500 samples it scored an 81% accuracy rate, which is reasonable. It works very well."
Eu ainda trataria a autoverificação como um reflexo útil, não como garantia. Ela pega erros visuais óbvios; não substitui uma pessoa olhando tudo o que vai ao ar. Mas, para um primeiro lançamento nativamente multimodal, a qualidade de visão está bem acima do que o preço sugere.
Onde ele falha
Uma análise que só lista pontos fortes é um comunicado de imprensa. O GLM-5.3 Flash tem dois pontos fracos que vale conhecer antes de integrá-lo a qualquer coisa.
A API própria é lenta, e a fama é real. No endpoint da própria Z.ai ele roda a cerca de 49 tokens por segundo, contra cerca de 86 do GLM-5.3 completo, e um tópico foi direto ao ponto.
"GLM 5.3 Flash is one of the slowest models AA [has ever seen]. GLM's visible context grows half as fast as Deepseek Flash and is much more precise and direct."
A nuance importante, e o motivo pelo qual eu não deixaria essa citação encerrar o assunto, é que ela descreve o serviço próprio, não os pesos. A Artificial Analysis lista 11 provedores, e a diferença é enorme.
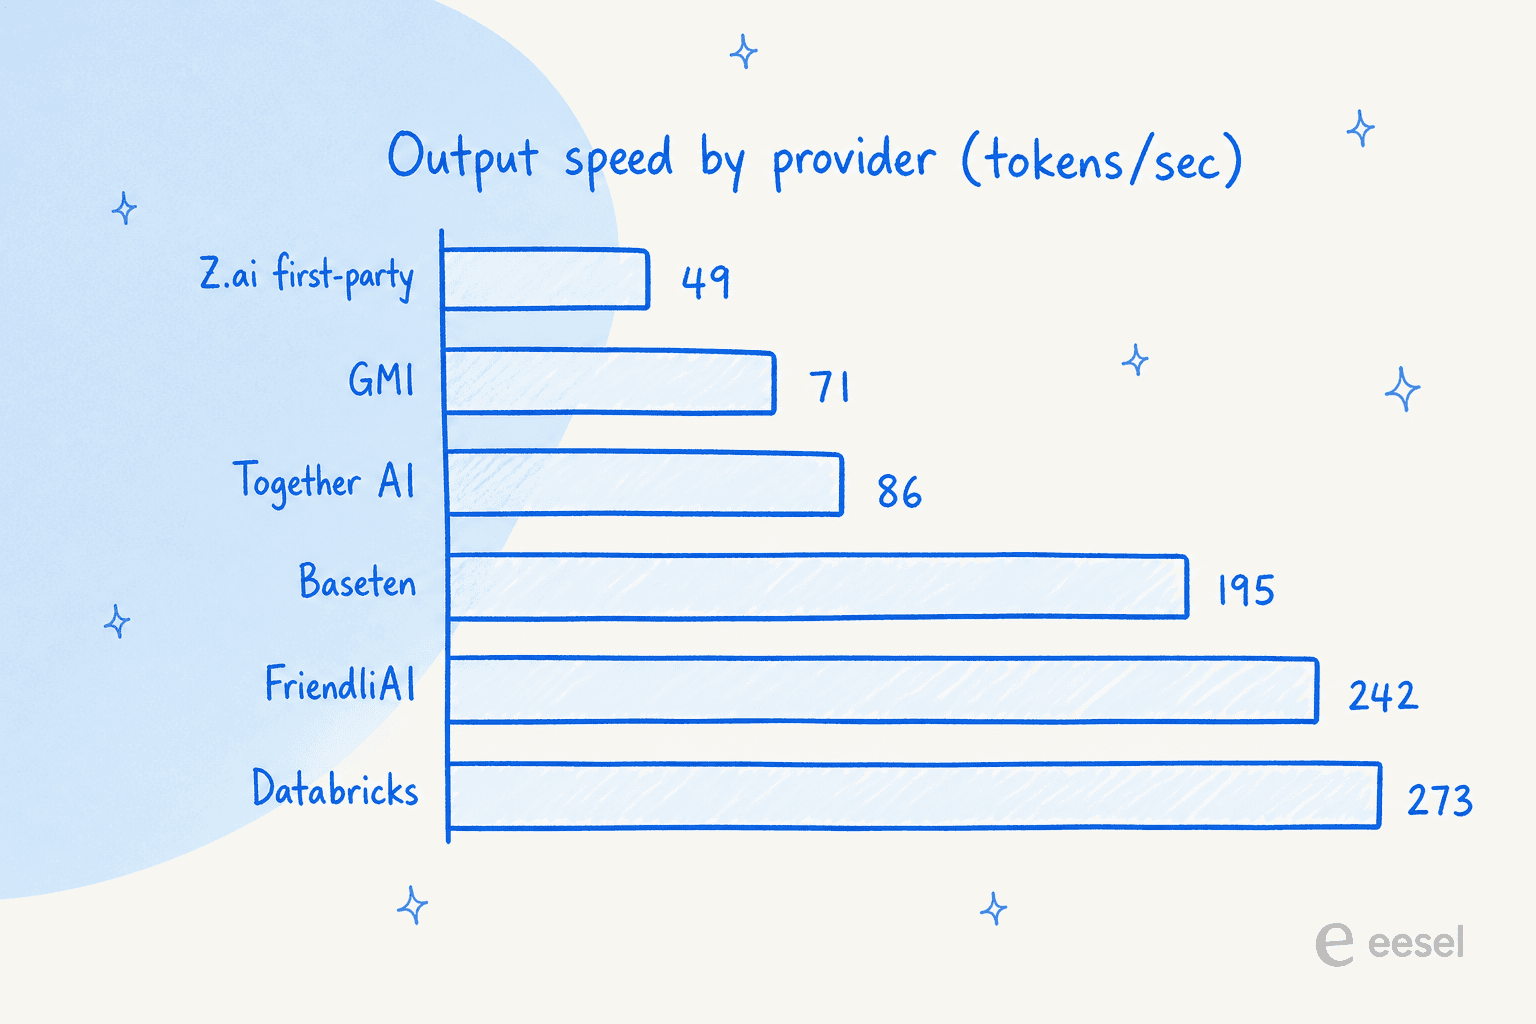
A Databricks serve o mesmo modelo a 272,9 tokens por segundo, mais de cinco vezes a taxa da API própria, com tempo até o primeiro token de 8 segundos. Então "o GLM-5.3 Flash é lento" na verdade é "a API da própria Z.ai é lenta". Escolha o host com critério e o problema praticamente some. A página de benchmark de provedores é o que se deve conferir antes de se comprometer, e se você vai rotear tráfego real, uma boa configuração de acompanhamento de uso evita um susto na fatura.
O cenário de dados é frágil se você lida com conteúdo de clientes. A API própria não tem acordo de processamento de dados publicado nem opção de retenção zero, e o serviço opera sob a lei da RPC. É uma restrição real, não uma crítica ao modelo, e a solução honesta são os pesos abertos: hospedar por conta própria com SGLang, vLLM ou TokenSpeed é como se obtém um caminho de dados controlado. Se algo disso tocar dados de clientes, SOC 2 e LGPD/GDPR é o que deve ser lido primeiro.
Mais uma coisa para planejar: a série GLM-5.3 pensa primeiro, então reserve orçamento para tokens de raciocínio nos seus custos. A Cloudflare expõe um controle reasoning_effort com níveis low, medium e high, para que você reduza em tarefas simples, mas não há um modo gratuito de "não pensar nada" como alguns modelos oferecem. Isso também é uma observação sobre alucinação disfarçada: mais raciocínio não significa mais precisão, e a autoverificação visual não se estende a afirmações factuais.
O que as pessoas estão realmente construindo com ele
O sinal mais revelador não é um benchmark, é que fornecedores e desenvolvedores o adotaram em poucos dias. James Grugett o colocou em um produto gratuitamente no lançamento:
"GLM 5.3 Flash is 100% free in our [product]. Leading capabilities at a highly competitive price - Natively multimodal with a 1M-token context window. Previously previewed as Ox Alpha."
O uso em revisão de segurança é onde a relação preço-valor gerou a reação mais forte. Uma equipe o rodou em um benchmark de vulnerabilidades e fez as contas:
"We benchmarked the new GLM-5.3 Flash on VulnPR-100. It found 34/100 vulnerabilities at a total model-review cost of just $4.21. That makes it the strongest sub-$10 model we've tested."
Esse é o formato de um bom trabalho para o GLM-5.3 Flash: alto volume, tolerante a uma execução um pouco mais lenta e com preço tão baixo que dá para jogá-lo em tarefas pelas quais você nunca pagaria um modelo de ponta. O levantamento dos melhores agentes de IA de código aberto tem mais desses padrões, e se o trabalho for suporte especificamente, o artigo sobre o melhor modelo para tickets de suporte é uma leitura mais focada no que realmente importa ali.
Meu veredito, por tarefa
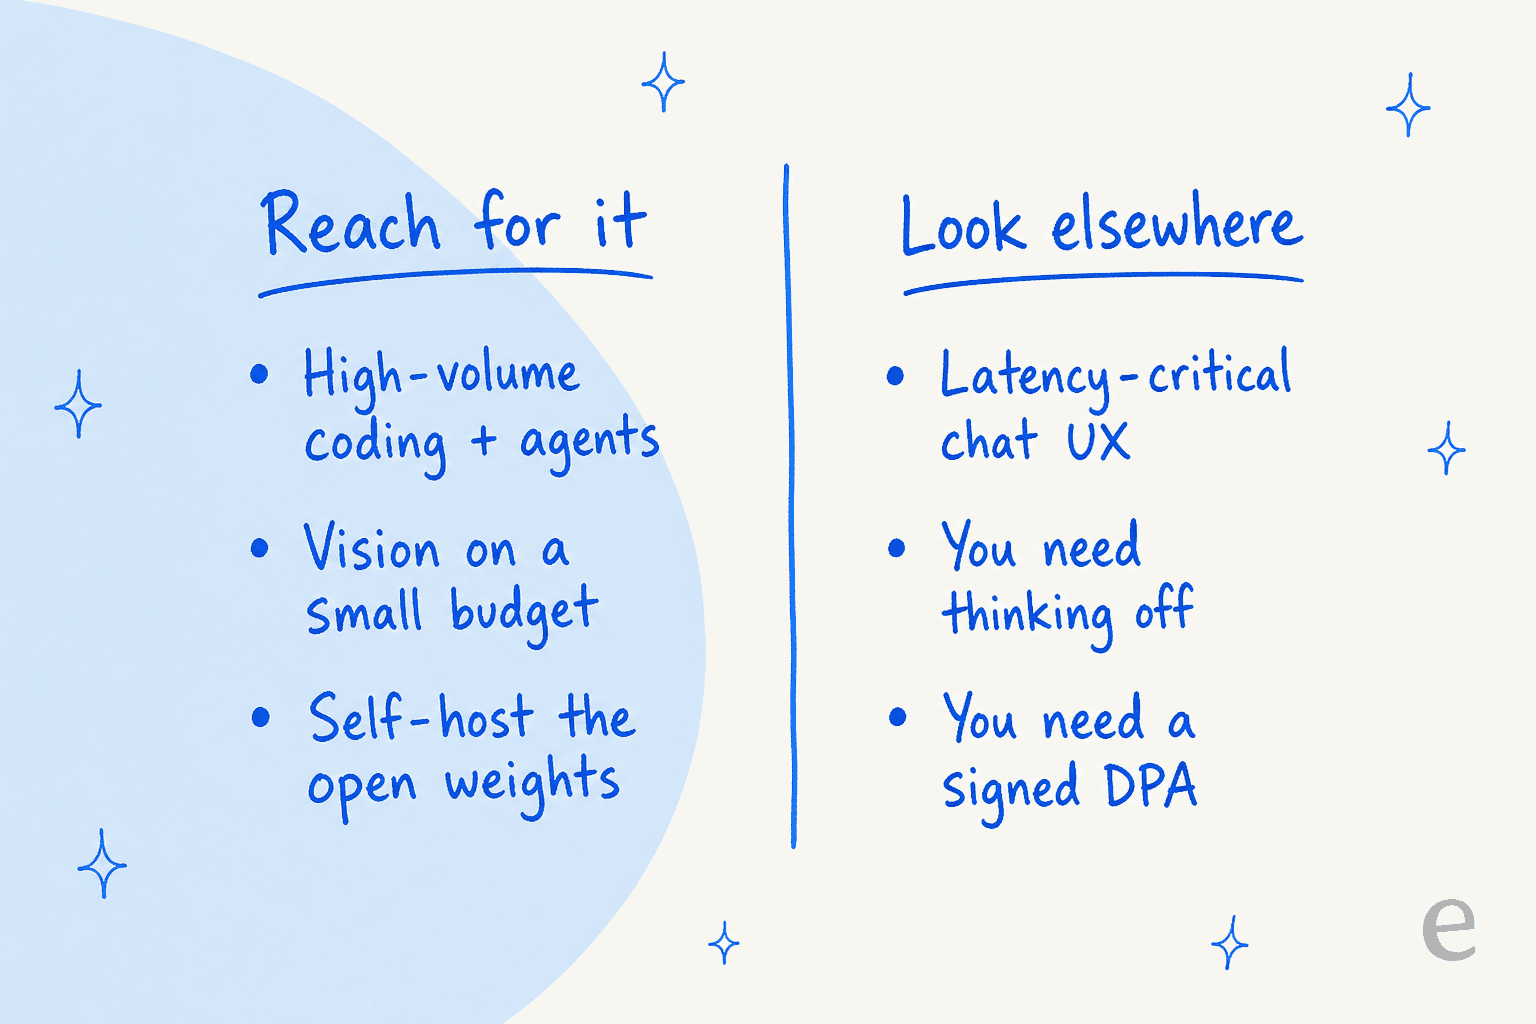
Use o GLM-5.3 Flash se você faz programação em alto volume ou trabalho com agentes, se quer qualidade de visão real sem o preço de ponta, ou se quer hospedar pesos abertos por conta própria e manter seus dados em casa. Nos três casos, é uma das melhores opções de custo-benefício disponíveis hoje, e a visão geral do GLM-5.3 Flash é para onde eu mandaria você para configurá-lo.
Procure outra opção se a latência é o seu produto e você não controla o provedor, se precisa de um modo que pule o raciocínio por completo, ou se precisa de um acordo de dados assinado que não consegue sem hospedar por conta própria. Nenhum é fatal, mas são as situações em que um modelo mais caro, mais rápido ou mais regulado merece o seu prêmio. Se você o compara com uma opção fechada de ponta, os preços do Claude Opus 5 são a referência na outra ponta da escala.
A versão em uma linha: o GLM-5.3 Flash é o modelo que eu usaria por padrão para trabalho barato, de alto volume e tolerante à lentidão, e o que eu testaria com cuidado antes de apostar nele um produto sensível à latência.
Try eesel
Se você chegou aqui comparando preços por token porque quer que uma IA cuide do suporte, eis o que eu diria num café: o preço do token nunca foi a parte difícil. Um modelo como o GLM-5.3 Flash é o motor. Conectá-lo ao seu helpdesk, fundamentá-lo nas suas macros e tickets anteriores reais e saber o que ele vai dizer antes de um cliente ver, esse é o trabalho de verdade, e é um produto totalmente diferente.
É aí que a eesel entra. A eesel oferece colegas de equipe de IA prontos para trabalhar em tarefas específicas, um agente de suporte com IA que se conecta ao Zendesk ou ao seu helpdesk atual, e um redator de blog com IA para conteúdo. Cada um chega com as habilidades, integrações e contexto de empresa para a sua função, então você contrata um colega de equipe, em vez de alugar acesso bruto a um modelo.
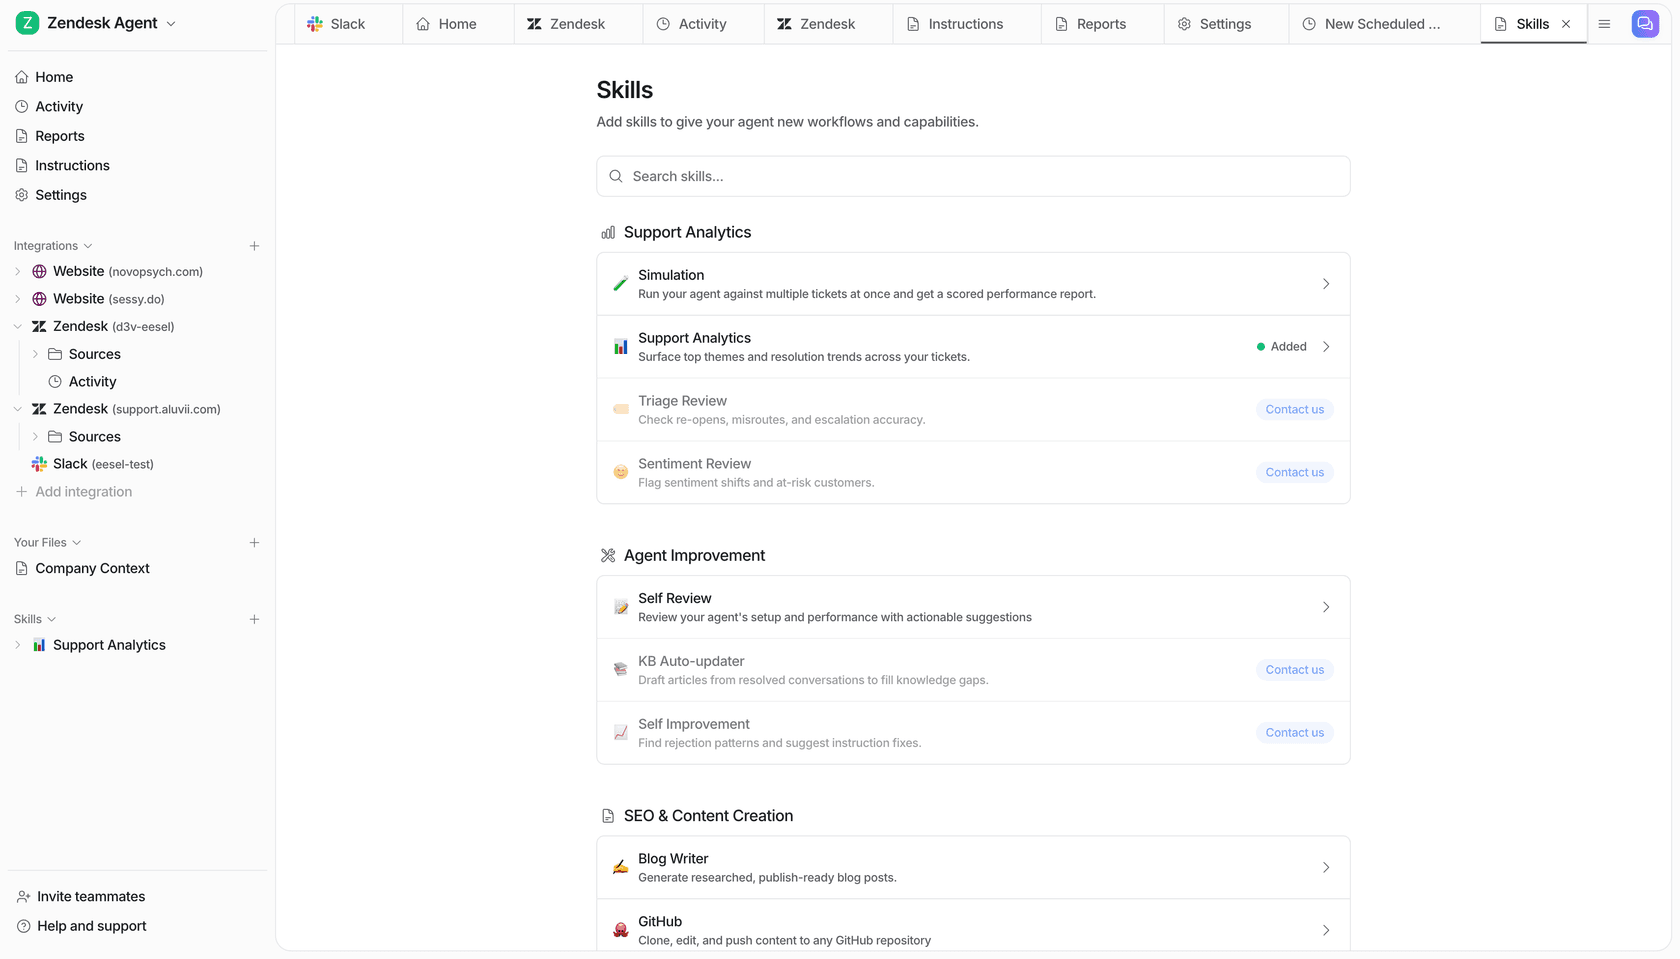
O que mais importa no suporte: há anos colocamos agentes de IA em filas de suporte ao vivo e já vimos um bot de aparência confiante narrar um trabalho que nunca fez. É exatamente por isso que toda implantação da eesel é simulada com tickets passados antes de tocar uma conversa real. O preço é uma mensalidade fixa dimensionada ao volume (1 crédito por ticket ou chat), e não por usuário, então uma implantação gradual é real, e há 100 créditos grátis para começar. Esse modelo de créditos também é o motivo pelo qual o custo da IA no atendimento ao cliente sai diferente de uma fatura bruta de tokens. Rode uma simulação nos tickets do mês passado e você saberá em uma hora se vale o seu tempo, o que é melhor do que testar um modelo no escuro.