O que "automatizar o suporte pela linha de comando" realmente significa
Eu construo produto e agentes de IA na eesel, então passo muito tempo em APIs de helpdesk e nos terminais de outras pessoas. Quando um time de suporte com perfil mais técnico diz "quero automatizar isso pela linha de comando", quase nunca estão pedindo um único binário mágico que digita support resolve #4821 e fecha um ticket com a resposta correta. Essa ferramenta não existe, e vale a pena ser direto sobre isso.
O que eles realmente querem é uma escada de autonomia: parar de clicar em uma interface e deixar que scripts façam o trabalho repetitivo, primeiro sob demanda, depois em um horário, depois automaticamente em eventos. É o mesmo instinto por trás das buscas por uma CLI de suporte ao cliente. Esse instinto está completamente certo, e para a metade mecânica do suporte ele compensa imediatamente. A armadilha é achar que o terminal também entrega a metade difícil, a resposta em si. Não entrega, e depois de anos colocando agentes de IA em filas ao vivo, sei exatamente onde essa linha está.
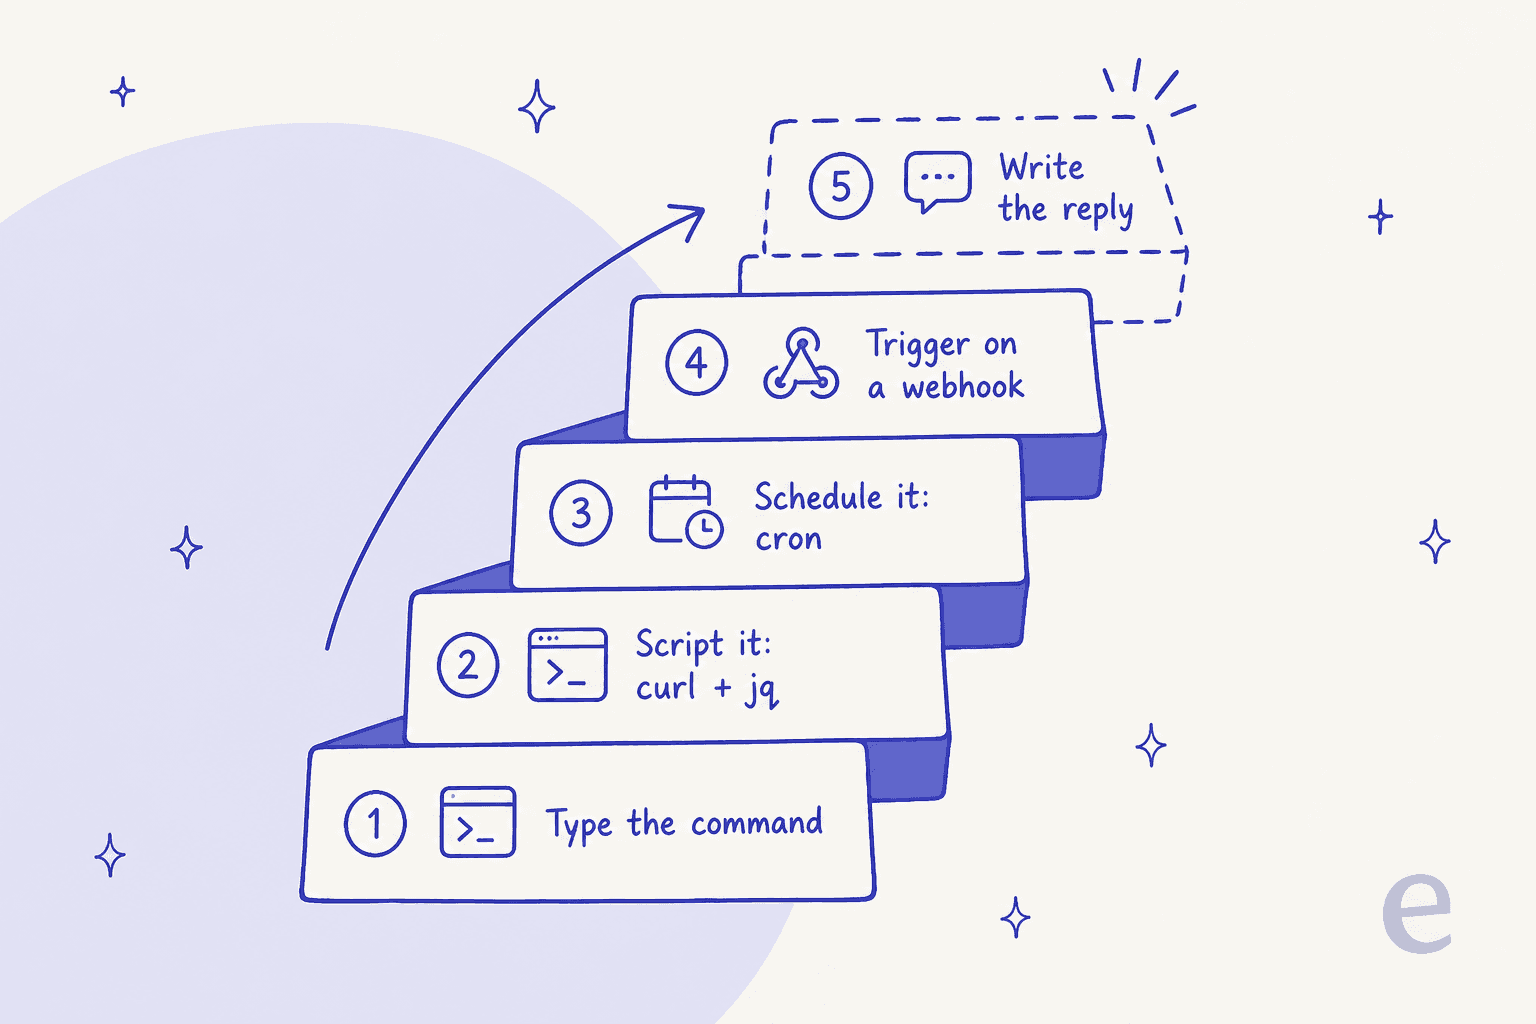
Todo degrau abaixo do tracejado é real, possível de construir hoje, e o resto deste post sobe por ele.
Degraus 1 e 2: scriptar o trabalho mecânico
Todo helpdesk relevante expõe uma API REST, então bash, curl e jq já conseguem tocar uma parcela surpreendente do dia a dia. É aqui que a linha de comando ganha seu espaço, porque transforma uma tarde de cliques em um único loop.
Triagem e roteamento em massa. Reatribua todos os tickets de uma view, adicione uma tag em um segmento inteiro, ou eleve a prioridade de um backlog. É o mesmo trabalho da automação de roteamento de tickets, só que conduzido por um shell em vez de um construtor de regras. Se você usa Zendesk especificamente, isso se sobrepõe bastante a automatizar tickets do Zendesk:
# Tag every unassigned ticket in a view, using the helpdesk REST API
curl -s -u "$AUTH" "$HELPDESK/api/v2/views/$VIEW/tickets.json" \
  | jq -r '.tickets[].id' \
  | while read -r id; do
      curl -s -u "$AUTH" -X PUT "$HELPDESK/api/v2/tickets/$id.json" \
        -H 'Content-Type: application/json' \
        -d '{"ticket":{"tags":["needs-review"]}}'
    done
Exportações e análise. Extraia um mês de conversas em JSON e jogue em uma planilha, um notebook, ou uma contagem rápida de frequência de palavras sobre do que os clientes realmente reclamam. Esse tipo de análise de tickets é bem mais fácil pelo terminal do que por qualquer aba de relatórios.
Sincronização de conhecimento. Envie sua central de ajuda, macros ou documentação para uma base de conhecimento para que as respostas se mantenham atualizadas. É o tecido conjuntivo por trás de qualquer fluxo real de IA para helpdesk, seja você usuário de Freshdesk, Gorgias ou Help Scout, e a API de base de conhecimento do Freshdesk é um bom exemplo do que esses endpoints expõem.
Tudo isso é scriptável, repetível e revisável. O detalhe é que tudo isso só move dados de um lado para outro. Nada disso decide o que dizer.
Degrau 3: programar com cron
No momento em que um script existe, envolva-o em uma linha de cron e ele roda sozinho. Esse é o primeiro degrau em que o suporte roda sem supervisão, sem nenhum humano disparando nada.
# Every night at 2am, run the stale-ticket sweep and log the result
0 2 * * * /opt/support/close-stale.sh >> /var/log/support-cron.log 2>&1
Um job noturno que fecha tickets parados, uma exportação semanal, uma sincronização de conhecimento a cada hora, uma checagem de SLA que avisa o Slack quando um ticket está prestes a violar o prazo, nenhum deles precisa de uma pessoa no meio do caminho. Esse é o padrão por trás da maior parte da automação de tickets de suporte leve: você não precisa de uma plataforma, precisa de um script e de um horário. Se você quer um ângulo concreto de SLA, a mesma ideia se aplica bem a um fluxo de gestão de SLA.
Aqui está um exemplo pequeno mas útil, um alerta de violação de SLA que roda a cada 15 minutos:
# Alert on tickets within 30 min of an SLA breach (cron: */15 * * * *)
curl -s -u "$AUTH" "$HELPDESK/api/v2/search.json?query=type:ticket+status<solved" \
  | jq -r '.results[] | select(.sla_minutes_left < 30) | .id' \
  | while read -r id; do
      curl -s -X POST "$SLACK_WEBHOOK" \
        -d "{\"text\":\"Ticket $id is about to breach SLA\"}"
    done
Isso é automação de verdade. Ela lê o estado, aplica uma regra e executa uma ação, tudo sem você. Mesmo assim, ela ainda não está respondendo nada.
Degrau 4: disparar por webhook
Cron roda por horário. O degrau scriptável mais alto roda por eventos. Em vez de fazer polling a cada 15 minutos, você registra um webhook para que seu helpdesk faça um POST para o seu endpoint no instante em que um ticket é criado, marcado com tag ou atualizado, e seu script reage em tempo real.
É assim que você sai de uma marcação de tags automatizada que roda em um horário para uma marcação que dispara no instante em que o ticket chega, e é a rampa de entrada para a classificação de tickets de verdade. Um handler minúsculo já basta:
# Minimal webhook handler: classify and route a new ticket on arrival
# (Ticket payload arrives as JSON on POST from the helpdesk)
read -r payload
id=$(echo "$payload" | jq -r '.ticket.id')
subject=$(echo "$payload" | jq -r '.ticket.subject')
case "$subject" in
  *refund*|*charge*) queue="billing" ;;
  *bug*|*error*)     queue="engineering" ;;
  *)                 queue="general" ;;
esac
curl -s -u "$AUTH" -X PUT "$HELPDESK/api/v2/tickets/$id.json" \
  -d "{\"ticket\":{\"group_id\":\"$queue\"}}"
Roteamento por palavra-chave como este é baseado em regras, não IA, e tudo bem, boa parte do roteamento realmente é só correspondência de palavras-chave. Mas repare no que acontece se você levar isso adiante: quanto mais você quer que o handler entenda o ticket em vez de só fazer pattern matching na linha de assunto, mais você silenciosamente saiu do domínio das instruções case e entrou no domínio de um sistema de IA de verdade.
O degrau que você não consegue scriptar: a resposta
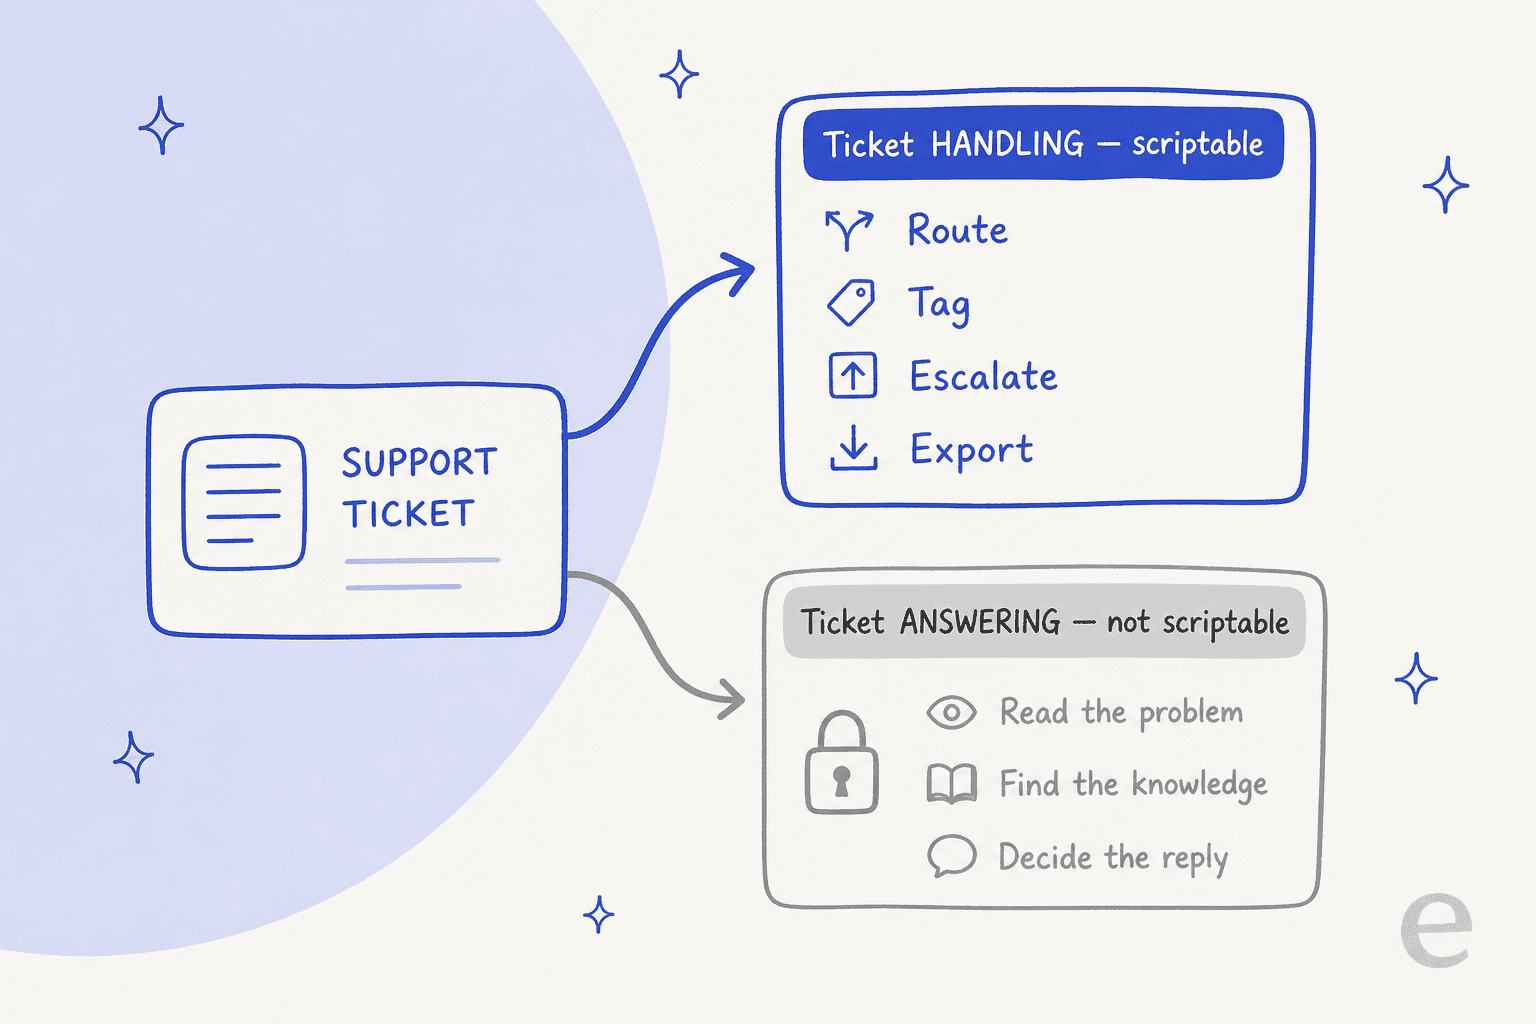
Aqui está a linha honesta. Você consegue scriptar o ticket, mas não consegue scriptar a resposta. No momento em que uma tarefa precisa ler o problema de um cliente, encontrar o conhecimento certo e decidir uma resposta, curl e jq chegam ao limite, e você está construindo um sistema de IA, não uma função de bash.
Pergunte a qualquer um que realmente já lançou um. Só a recuperação de informação já é uma stack completa, não uma única chamada de busca:
"So few developers realize that you need more than just vector search for RAG, so I still spend many of my talks emphasizing the FULL retrieval stack for RAG."

E no momento em que o modelo consegue tanto decidir quanto agir sobre um ticket, você assumiu um problema de controle que uma linha de cron não resolve:
"The failure mode I keep seeing isn't hallucination per se... it's blurred responsibility between intent and execution. Once a model can both decide and act, you've already lost determinism."
Então o custo real de um agente de suporte automatizado não está no endpoint. Está na sincronização e recuperação de conhecimento, no estado da conversa ao longo dos turnos, nas ações de ferramentas contra o helpdesk, nas regras de escalonamento, nos guardrails e em uma forma de testar tudo isso. É o mesmo iceberg que qualquer time que constrói uma configuração de suporte headless encontra: a ponta, seu terminal e seu canal, nunca foi a parte difícil. O corpo abaixo dela é, e é exatamente o que uma API de helpdesk com IA precisa carregar.
Teste a automação antes de ela responder um ticket ao vivo
Se há um hábito que vale a pena roubar do software, é este, e é o passo que os setups scriptados pulam. Você nunca lançaria código sem testes. Uma automação que fala com seus clientes merece o mesmo padrão, e o instinto de terminal de "tornar isso reproduzível" é exatamente o que torna o teste possível.
O problema é que a maioria dos times simplesmente liga um agente e torce. A comunidade de suporte continua girando em torno da mesma preocupação:
"How do you test that an AI agent won't do something catastrophic? Do people actually red-team their agents before they go live?"

Você já tem a suíte de testes: seu histórico de tickets. A jogada é reproduzir milhares dos seus tickets reais passados contra o agente e ver o que ele teria dito, onde teria escalado e onde teria ficado em silêncio, tudo antes de um cliente estar envolvido. É o que a simulação da eesel faz, e ela transforma "entrar no ar e torcer" em "entrar no ar com números". É a coisa mais próxima que o suporte tem de um pytest, e é por isso que eu simulo todo lançamento contra tickets históricos primeiro.
Quanto custa automatizar a resposta
O custo é onde o instinto de construir você mesmo encontra a realidade, e os dois caminhos cobram de formas bem diferentes.
Se você faz o script de um agente sobre uma API de modelo crua, paga por token em cada mensagem, cada nova tentativa, cada trecho recuperado, resolvido ou não. Um time do nosso dossiê queimou 200 chamadas de API em um único dia de teste e ficou nervoso com a conta diante das 9.000 interações esperadas por mês. E isso antes de contar o tempo de engenharia para construir e manter recuperação, estado, guardrails e avaliações.
Veja como as opções terminal-first realmente se comparam:
| Abordagem | Nível de autonomia | Você mantém | Formato de cobrança | Melhor para |
|---|---|---|---|---|
| Scripts curl + jq | Sob demanda | Cada script | Incluído no plano | Edições em massa, exportações, roteamento |
| Jobs de cron | Programado, sem supervisão | Scripts + horário | Incluído no plano | Varreduras noturnas, sincronizações, alertas de SLA |
| Handlers de webhook | Orientado a eventos | Endpoint + scripts | Incluído no plano | Roteamento e marcação de tags em tempo real |
| API de modelo + MCP | Autônomo, DIY | Toda a stack de IA | Por token, resolvido ou não | Controle total, se você tem o time |
| Colega de equipe pronto | Autônomo, gerenciado | Nada | Por ticket resolvido (~US$ 0,40) | Tickets resolvidos sem construir o motor |
A última linha é a que merece um segundo olhar se seu objetivo são tickets resolvidos, e não um projeto de manutenção. Você ainda ganha uma superfície programável para scriptar com curl e cron, só não reconstrói a inteligência de resolução por baixo dela.
Automatizando a resposta com a eesel
Se você chegou até aqui querendo automatizar o suporte ao cliente pela linha de comando, você é do tipo de time que quer uma superfície programável, não um dashboard trancado. Esse é exatamente o meio-termo para o qual a eesel foi construída.
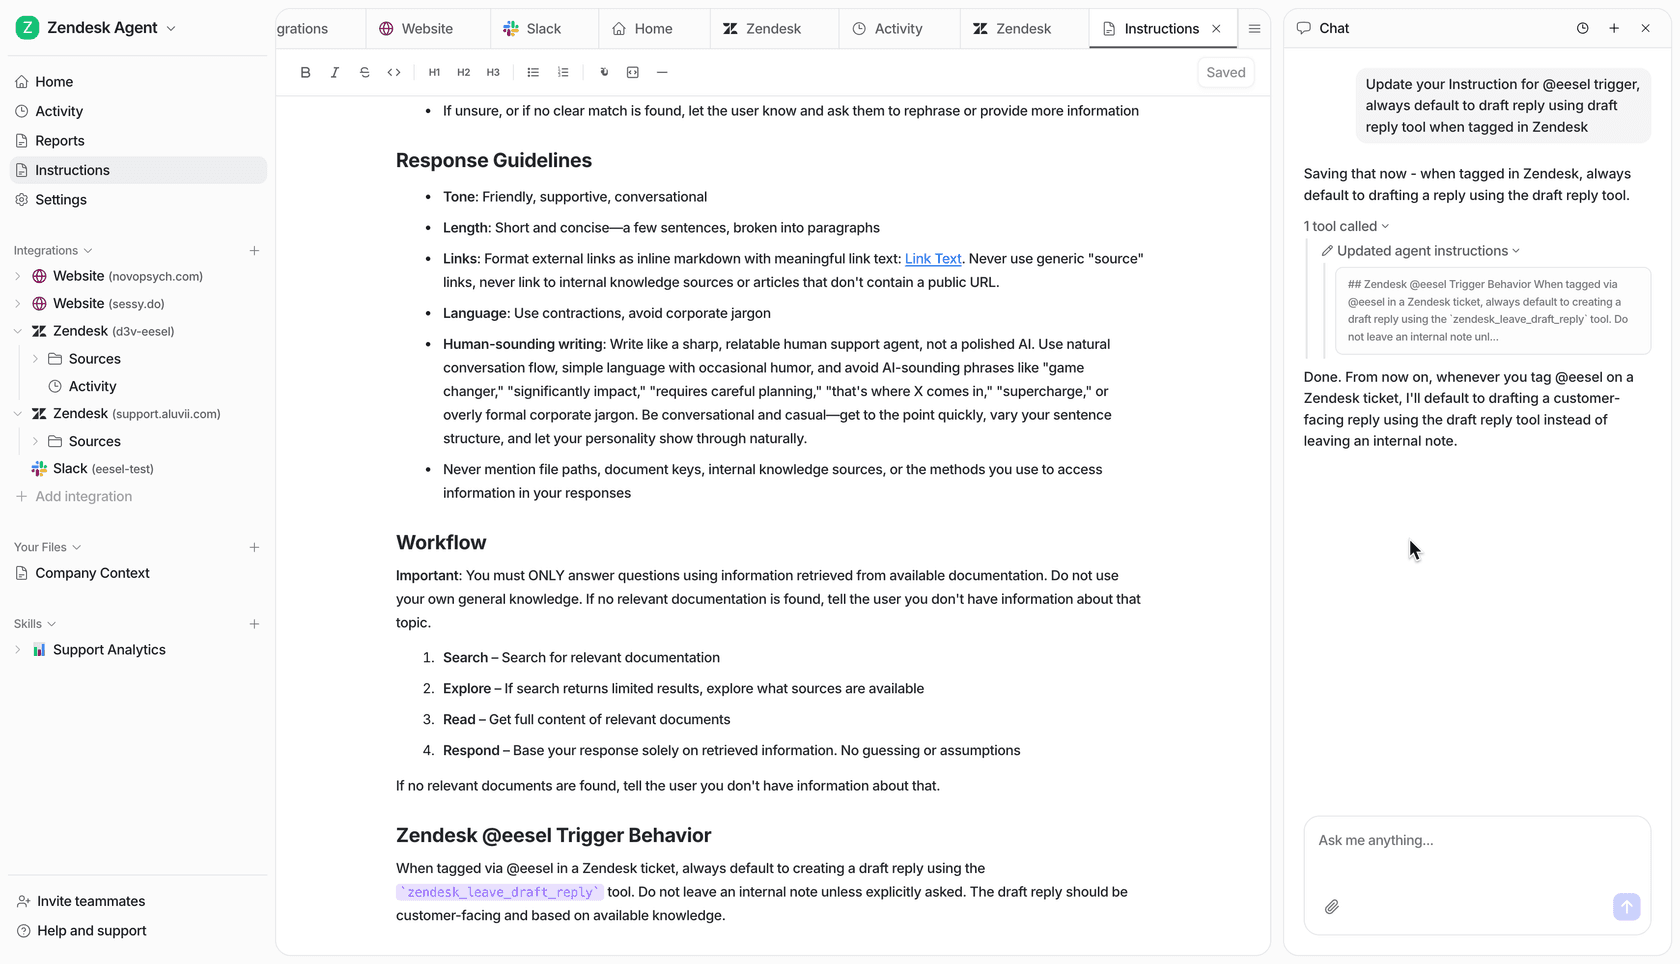
A eesel é um colega de equipe de IA que se conecta ao helpdesk que você já usa, Zendesk, Freshdesk, Gorgias, Front, Help Scout, e já chega sabendo sincronizar seu conhecimento, consultar pedidos, marcar tickets com tags e redigir ou enviar respostas. Ela traz todo o motor de resolução pronto, então você não reconstrói recuperação, estado e guardrails do zero, e mantém a superfície programável pela qual você veio: uma API para ações, webhooks e skills personalizadas que você pode operar a partir de um shell. E aí a parte que mais importa: ela simula em tickets passados antes de entrar em produção, então você faz o deploy com números em vez de esperança. É grátis para testar, sem cartão de crédito e sem ligação de vendas, e a cobrança é por ticket resolvido em vez de por token ou por assento.
Mantenha seus scripts de curl e jobs de cron para a gestão de tickets, na qual eles são ótimos. Deixe um colega de equipe cuidar do único degrau que a linha de comando não alcança.
Perguntas frequentes
Como automatizo o suporte ao cliente pela linha de comando?
Quais tarefas de suporte eu realmente consigo scriptar pelo terminal?
Posso rodar automações de suporte programadas com cron?
Qual a diferença entre automação por webhook e cron?
Um script consegue realmente resolver um ticket, e não só movê-lo?
Como testo uma automação de suporte antes de ela entrar em produção?
Quanto custa o suporte automatizado por IA comparado a fazer o script você mesmo?


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.