

Cohere Parse 5 (parse-v5.0) est un petit modèle de vision axé sur le coût qui transforme les pages de documents en Markdown propre pour la recherche, le RAG et les agents. Il est devenu généralement disponible le 27 août 2026.
Le verdict honnête : Parse 5 n'est pas l'analyseur le plus précis du marché, et il ne cherche pas à l'être. Sur le ParseBench de Cohere lui-même, il obtient 79,2, derrière les LLM de pointe (GPT-5.5 à 84,4, Opus 4.8 à 84,3, Gemini 3.5 Flash à 81,8) mais devant la plupart des outils OCR dédiés. Il gagne sur le prix et le débit : 1,50 $ pour 1 000 pages et 4,5 pages par seconde, Model Vault réduisant encore le coût par page à grande échelle.
Prenez-le si vous analysez des centaines de milliers à des millions de pages pour un pipeline RAG et voulez un coût prévisible. Soyez prudent si vous avez besoin dès aujourd'hui d'une intégration rigide (le point d'accès en production prend des images, pas des PDF), d'une sortie JSON structurée ou de scores de confiance par champ, car Parse 5 n'offre rien de tout cela. Et rappelez-vous que Parse n'est que la première étape : il vous remet du texte propre, pas des réponses.
Cohere Parse 5 est arrivé avec un discours très précis. Pas « le meilleur analyseur de documents », mais « le meilleur profil qualité-prix du marché ». C'est une chose rafraîchissante à admettre pour un lancement, et c'est aussi toute l'histoire de savoir si ce modèle vous convient.
Je construis des intégrations et de la plomberie d'API au quotidien, et chez eesel j'ai passé beaucoup de temps sur la partie peu glamour de ce travail : faire entrer des documents d'entreprise désordonnés dans une forme qu'une IA peut réellement exploiter. L'analyse est l'endroit où un pipeline de recherche gagne ou perd en silence. Un analyseur qui massacre un tableau de prix ou perd un champ de formulaire empoisonne chaque réponse en aval, et on le remarque rarement avant qu'un client reçoive le mauvais chiffre. J'ai donc lu la documentation de Parse 5 comme je lis n'importe quel analyseur : pas « la démo est-elle bonne », mais « qu'est-ce qui casse en production ».
Voici ce que j'ai trouvé.
Ce qu'est réellement Cohere Parse 5
Parse est l'entrée de Cohere dans l'intelligence documentaire d'entreprise. La phrase du produit est « transformez vos documents d'entreprise en données prêtes pour l'IA », et mécaniquement cela signifie qu'il convertit des fichiers complexes et multimodaux (tableaux, formulaires, schémas, images intégrées) en Markdown structuré et lisible par machine, que vous pouvez injecter dans l'indexation, la recherche et les flux d'agents.
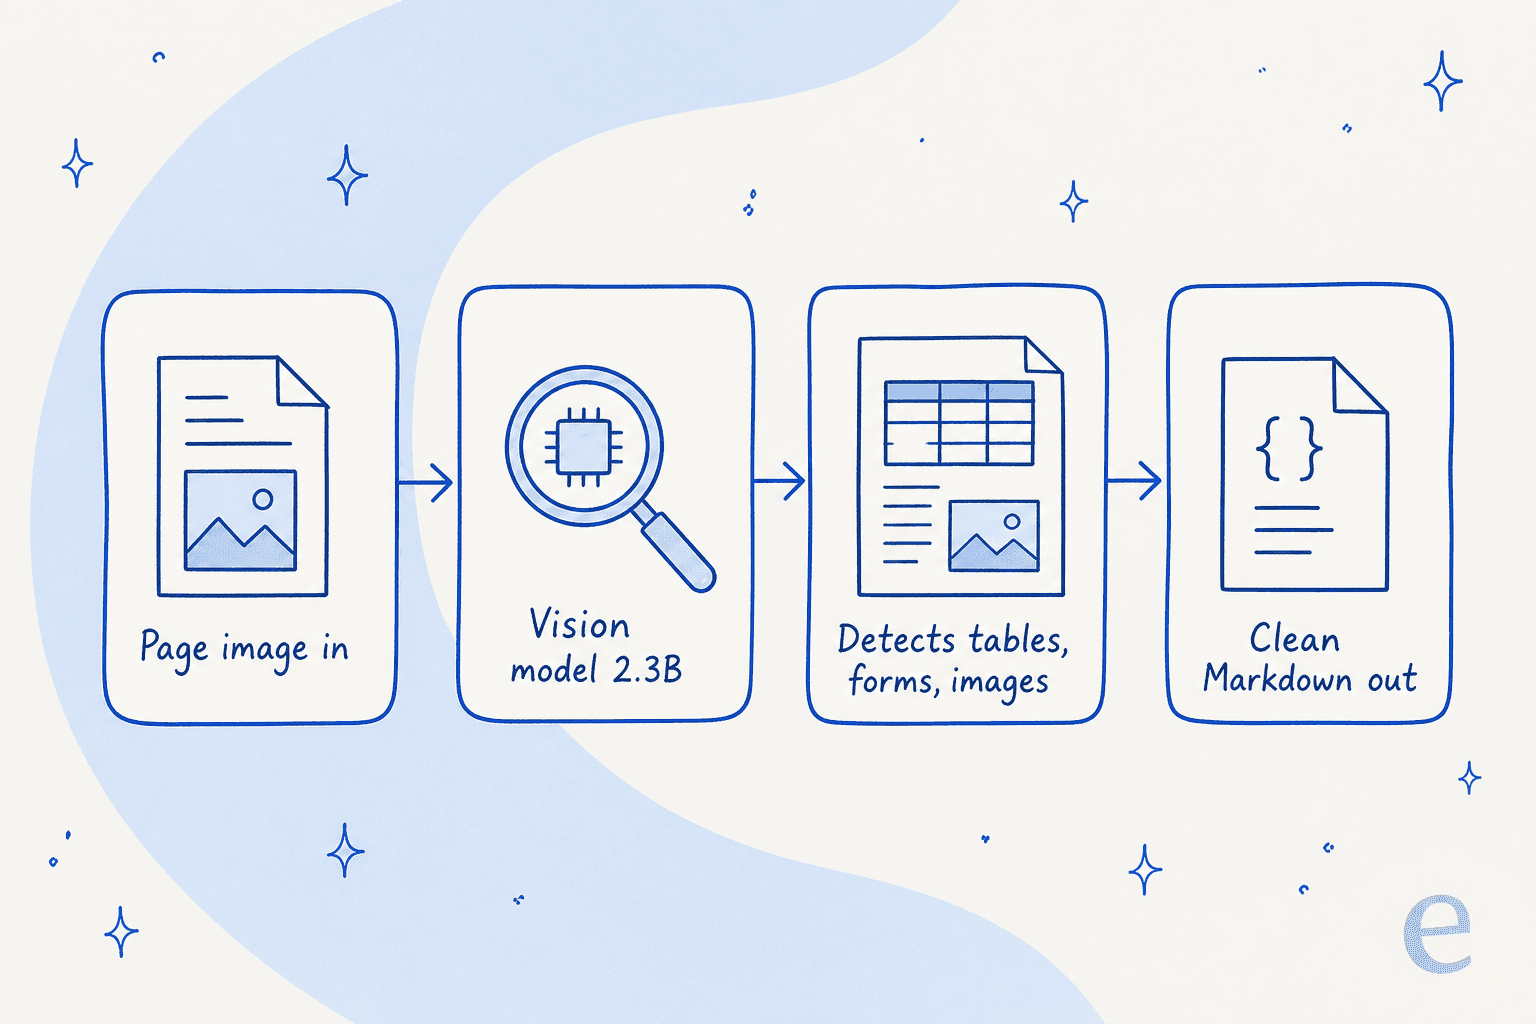
Les détails comptent, car « modèle vision-langage pour documents » couvre beaucoup de terrain. D'après la documentation du modèle, parse-v5.0 est un modèle de 2,3 milliards de paramètres, d'environ 4,6 Go, avec un contexte de 8 192 jetons, construit sur l'architecture north-micro-vision-instruct de Cohere. C'est un modèle volontairement petit. Cohere est franche sur le fait que les LLM de pointe auxquels il est comparé sont « chacun généralistes et nettement plus gros que Parse ». La petite taille est le but : c'est ce qui fait fonctionner le prix et le débit.
Le flux est simple. Vous lui donnez une image de page, il détecte la structure visuelle et renvoie du Markdown propre avec les tableaux intégrés en HTML et des cadres englobants pour les éléments visuels.
Le benchmark : solide, mais pas en tête
Cohere a construit son propre benchmark, ParseBench, pour mesurer la « performance d'analyse adaptée aux agents » selon trois dimensions : extraction de tableaux, fidélité du contenu (omissions, hallucinations, ordre de lecture cassé) et mise en forme sémantique (styles qui changent le sens, comme le texte barré).
Parse atteint 79,2 sur la moyenne des trois dimensions, et la forme de ce score est intéressante. Il est vraiment solide sur les tableaux (87,0) et la fidélité du contenu (86,6), et plus faible sur la mise en forme sémantique (64,0). Il lit donc et structure votre contenu de façon fiable, mais il est moins soigneux pour préserver des nuances comme l'italique ou le barré, qui changent parfois le sens du texte.
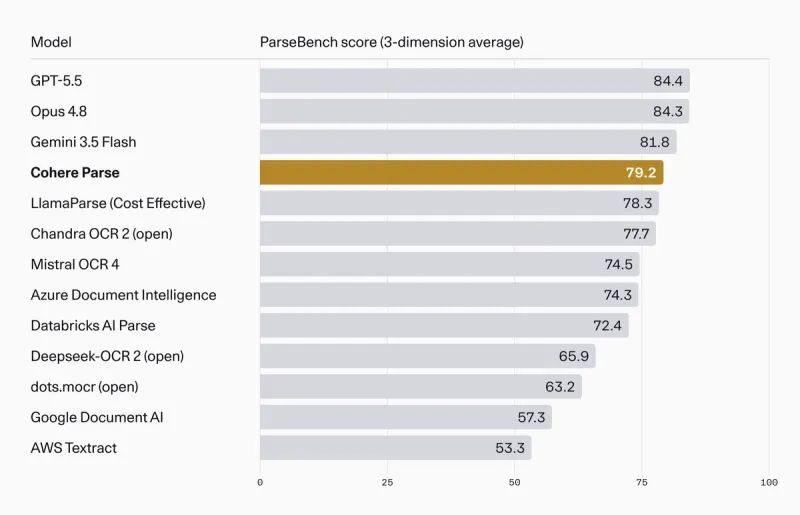
Si l'on lit honnêtement le graphique, deux choses sont vraies à la fois. Parse est battu par les trois modèles de pointe : GPT-5.5 (84,4), Opus 4.8 (84,3) et Gemini 3.5 Flash (81,8). Et Parse bat tous les analyseurs dédiés testés par Cohere, y compris l'offre économique de LlamaParse (78,3), Chandra OCR 2 (77,7), Mistral OCR 4 (74,5) et Databricks AI Parse (72,4). Face aux services OCR cloud de la vieille garde, il n'y a pas photo : Cohere annonce une amélioration de plus de 20 points à la fois sur AWS Textract (53,3) et Google Document AI (57,3).
Une réserve à nommer : c'est le benchmark du fournisseur, et le modèle qu'il vend gagne dans la lecture ajustée au prix. Cela ne rend pas les chiffres faux, mais c'est pourquoi le graphique suivant est plus utile, celui où la précision est tracée en fonction du coût.
Débit et prix : là où Parse gagne vraiment
C'est tout l'argument en faveur de Parse, il vaut donc la peine de ralentir ici.
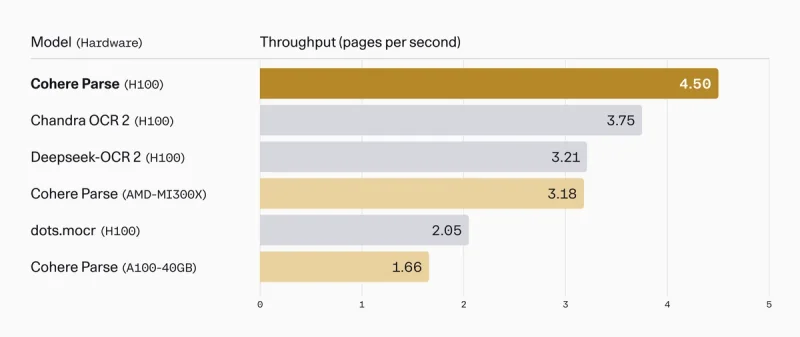
Côté prix, l'API Cohere facture 1,50 $ pour 1 000 pages. Côté débit, le modèle traite 4,5 pages par seconde, ce que Cohere indique comme 36 pages par seconde (2 160 pages par minute) sur un nœud 8×H100, soit environ 1,4 fois le débit de dots.mocr de RedNote et 2,2 fois celui de Chandra OCR 2 sur le même matériel, le tout servi avec vLLM.
En plaçant précision et prix sur les mêmes axes, la vraie position de Parse saute aux yeux. Sur le graphique de Pareto ParseBench, il se situe dans le quadrant bon marché et bien noté, tandis que les LLM de pointe offrent quelques points de précision en plus pour 30 à 50 fois le coût par page.
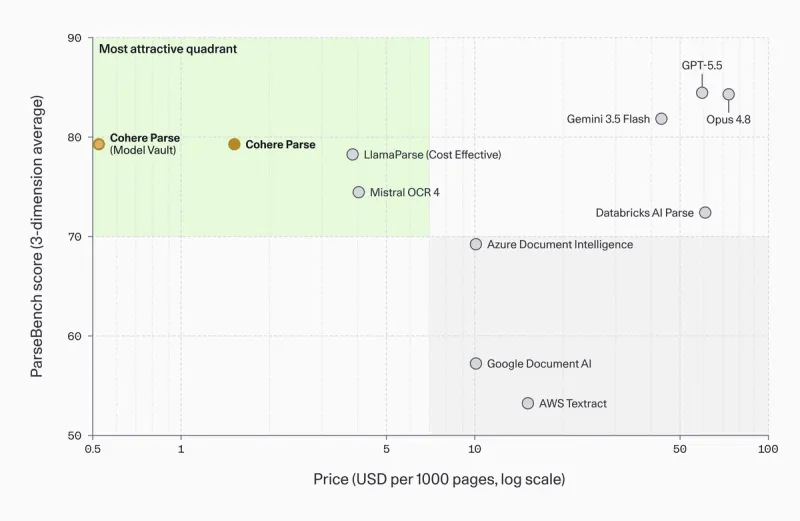
Les économies deviennent plus concrètes à grande échelle. L'exemple chiffré de Cohere : un flux de comptabilité fournisseurs traitant environ 13 millions de pages par mois sur Model Vault plutôt que sur l'API économise environ 12 000 $ par mois, soit 144 000 $ par an. Face à un analyseur d'hyperscaler à 10 $ pour 1 000 pages, ce même flux économiserait environ 1,47 million de $ par an. Ce sont le genre de chiffres qui font remonter une décision d'analyse jusqu'à la finance, et c'est la raison d'être de Parse.
Les tarifs de Cohere Parse 5 en détail
Parse est vendu par plusieurs voies, et la moins chère dépend de la régularité de votre utilisation. Voici le tableau complet.
| Voie d'accès | Ce que vous obtenez | Prix |
|---|---|---|
| API Cohere | Point d'accès géré, paiement à la page, sans infrastructure | 1,50 $ pour 1 000 pages |
| Model Vault (50 % d'utilisation du GPU) | Instance mono-locataire facturée à l'heure | ~23 % sous l'API |
| Model Vault (pleine utilisation) | Instance mono-locataire facturée à l'heure | jusqu'à 61 % sous l'API |
| Microsoft Foundry | Modèle Cohere-parse-v5 dans Azure | Tarif d'instance Azure |
| Amazon SageMaker | Déploiement via la marketplace | Tarif d'instance AWS |
| Hugging Face Space | Démo gratuite pour l'essayer | Gratuit |
Ma lecture : l'API est le bon choix pour un travail irrégulier ou à faible volume, car vous ne payez que les pages envoyées. Model Vault l'emporte dès que vous avez un volume régulier et élevé pour occuper les instances, ce qui correspond exactement à la charge de type comptabilité fournisseurs pour laquelle Parse est conçu. Si votre volume est irrégulier, faites le calcul avant de vous engager sur une instance dédiée, car le temps GPU inactif efface vite les économies par page.
Pour voir comment cela s'inscrit dans le catalogue et les offres plus larges de Cohere, notre analyse des tarifs de Cohere AI couvre les tarifs de Command, Embed et Rerank.
Ce qu'il extrait et ce qu'il ignore
Un analyseur se définit autant par ce qu'il laisse de côté que par ce qu'il capte, et Parse a quelques aspérités à connaître avant de construire dessus.
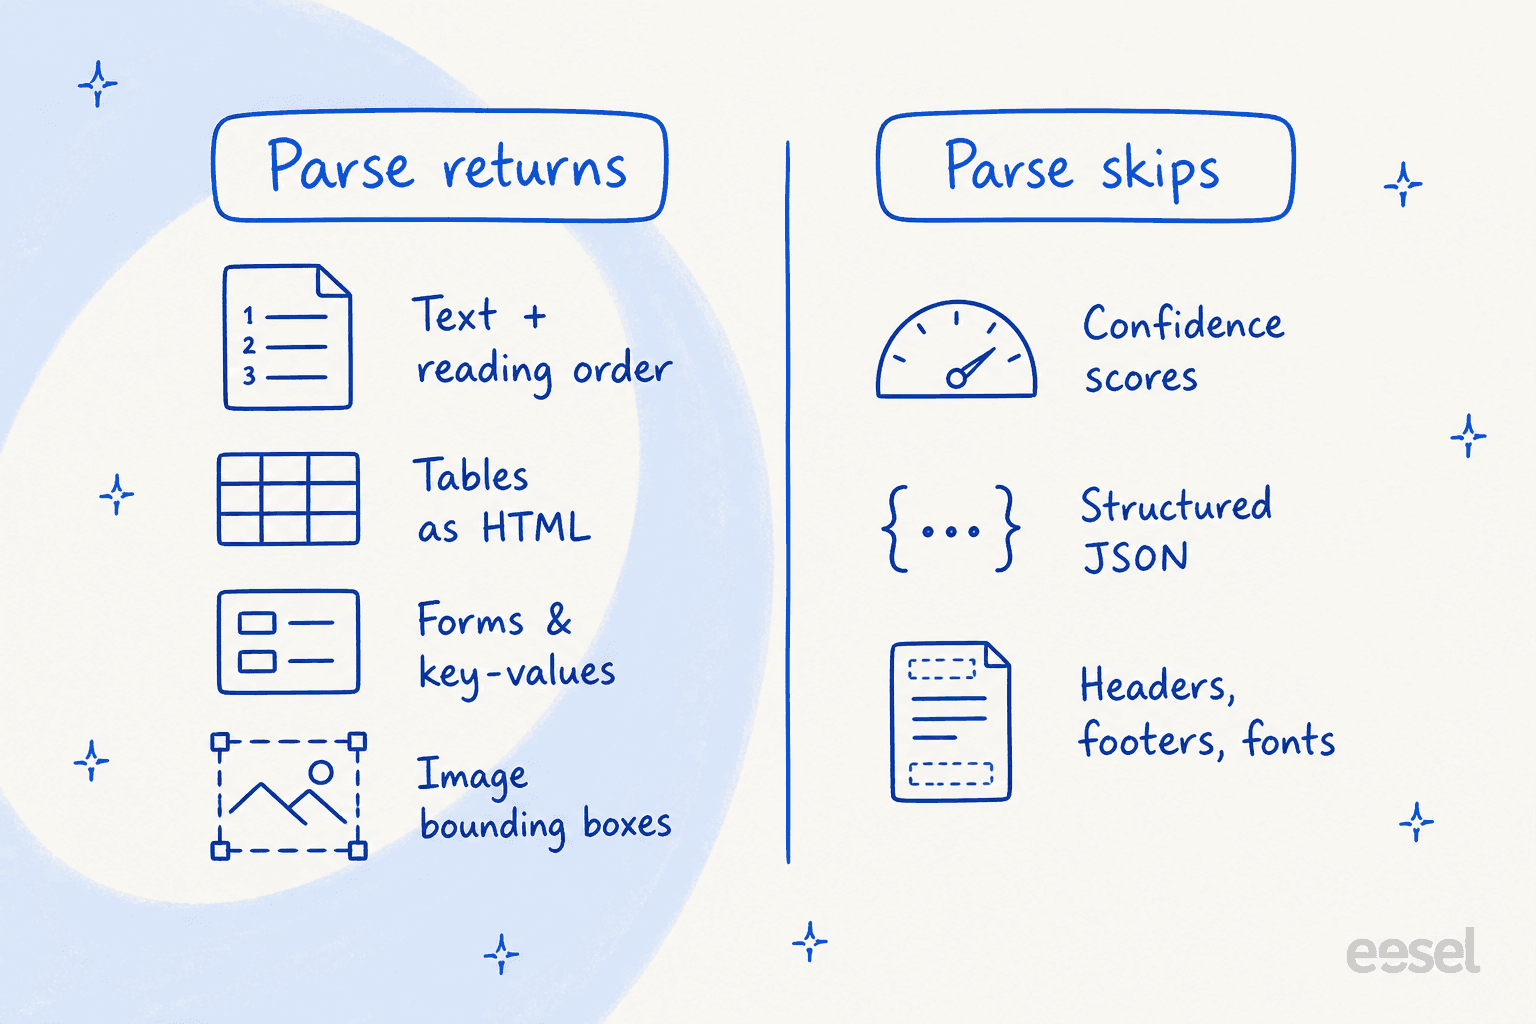
Côté positif, Parse renvoie du texte dans le bon ordre de lecture, des tableaux en HTML, des formulaires et des paires clé-valeur, ainsi que des descriptions d'images avec cadres englobants. C'est un ensemble de fonctions solide pour alimenter une base de connaissances ou un chatbot de base de connaissances IA.
Les limites, directement issues de la documentation, sont là où il faut être attentif :
- Pas de scores de confiance. Vous ne pouvez pas demander à Parse son degré de certitude sur une extraction, ce qui complique le contrôle qualité automatisé. Dans un flux de comptabilité fournisseurs ou de sinistres, c'est une vraie lacune.
- Markdown uniquement, pas de JSON structuré. Si votre pipeline veut des champs typés d'emblée, vous retraitez le Markdown vous-même.
- Pas de détection des en-têtes, pieds de page ou de la hiérarchie typographique. Il lit le contenu mais ne balise ni les éléments annexes du document ni les niveaux de titre.
- Cadres englobants pour les tableaux et les images uniquement. Selon la note de bas de page 2 du lancement, Parse n'émet pas de cadres par élément pour le texte. Cohere présente cela comme un choix intentionnel sur l'ordre de lecture, pas comme un bug, et pour la plupart des cas RAG cela n'a pas d'importance, mais si vous avez besoin de coordonnées au niveau du mot, cherchez ailleurs.
Aucune de ces limites n'est rédhibitoire pour le cas d'ingestion que vise Parse. Elles le sont si vous espériez intégrer Parse dans un produit d'extraction de documents structurés qui exige des champs typés et un contrôle de confiance. Adaptez l'outil à la tâche.
Appeler l'API (et le seul piège)
L'expérience développeur est propre. Vous installez le SDK, créez un client et appelez co.parse sur l'API Cohere v2.
L'appel minimal du démarrage rapide est aussi simple que l'analyse peut l'être :
import base64, cohere

co = cohere.ClientV2("COHERE_API_KEY")

with open("document.png", "rb") as f:
    b64 = base64.b64encode(f.read()).decode("utf-8")
data_uri = f"data:image/png;base64,{b64}"

response = co.parse(
    model="parse-v5.0",
    document={"type": "image_url", "image_url": data_uri},
)

for page in response.pages:
    print(page.markdown.content)
Voici le piège, et il est de taille pour quiconque prévoit de construire dès aujourd'hui. La documentation liste PDF, PPT et JPEG comme types pris en charge, mais la référence de l'API est explicite : le point d'accès ne prend actuellement en charge que document.type = image_url, c'est-à-dire un data URI ou une URL d'image distante. Les entrées directes de PDF et d'URL de fichier ne sont pas encore prises en charge. En pratique, vous rastérisez donc d'abord les pages de votre PDF en images, puis vous les envoyez une par une. Les limites d'image sont généreuses (20 Mo de taille de fichier, 50 mégapixels), et vous pouvez passer output_format à blocks lorsque vous voulez le tableau ordonné de régions de texte, de tableaux et d'images avec leurs cadres englobants plutôt que du Markdown à plat.
La couverture linguistique compte neuf langues d'entrée stables aujourd'hui : arabe, anglais, français, allemand, japonais, coréen, italien, portugais et espagnol, avec une prise en charge zero-shot d'autres langues à précision moindre.
Où se place Parse : c'est la première étape, pas tout le pipeline
C'est la partie que la plupart des articles sur le lancement survolent. Parse transforme des documents en texte propre. Il ne les intègre pas, ne les retrouve pas et ne répond à rien. C'est la porte d'entrée d'un pipeline de recherche, pas le pipeline.
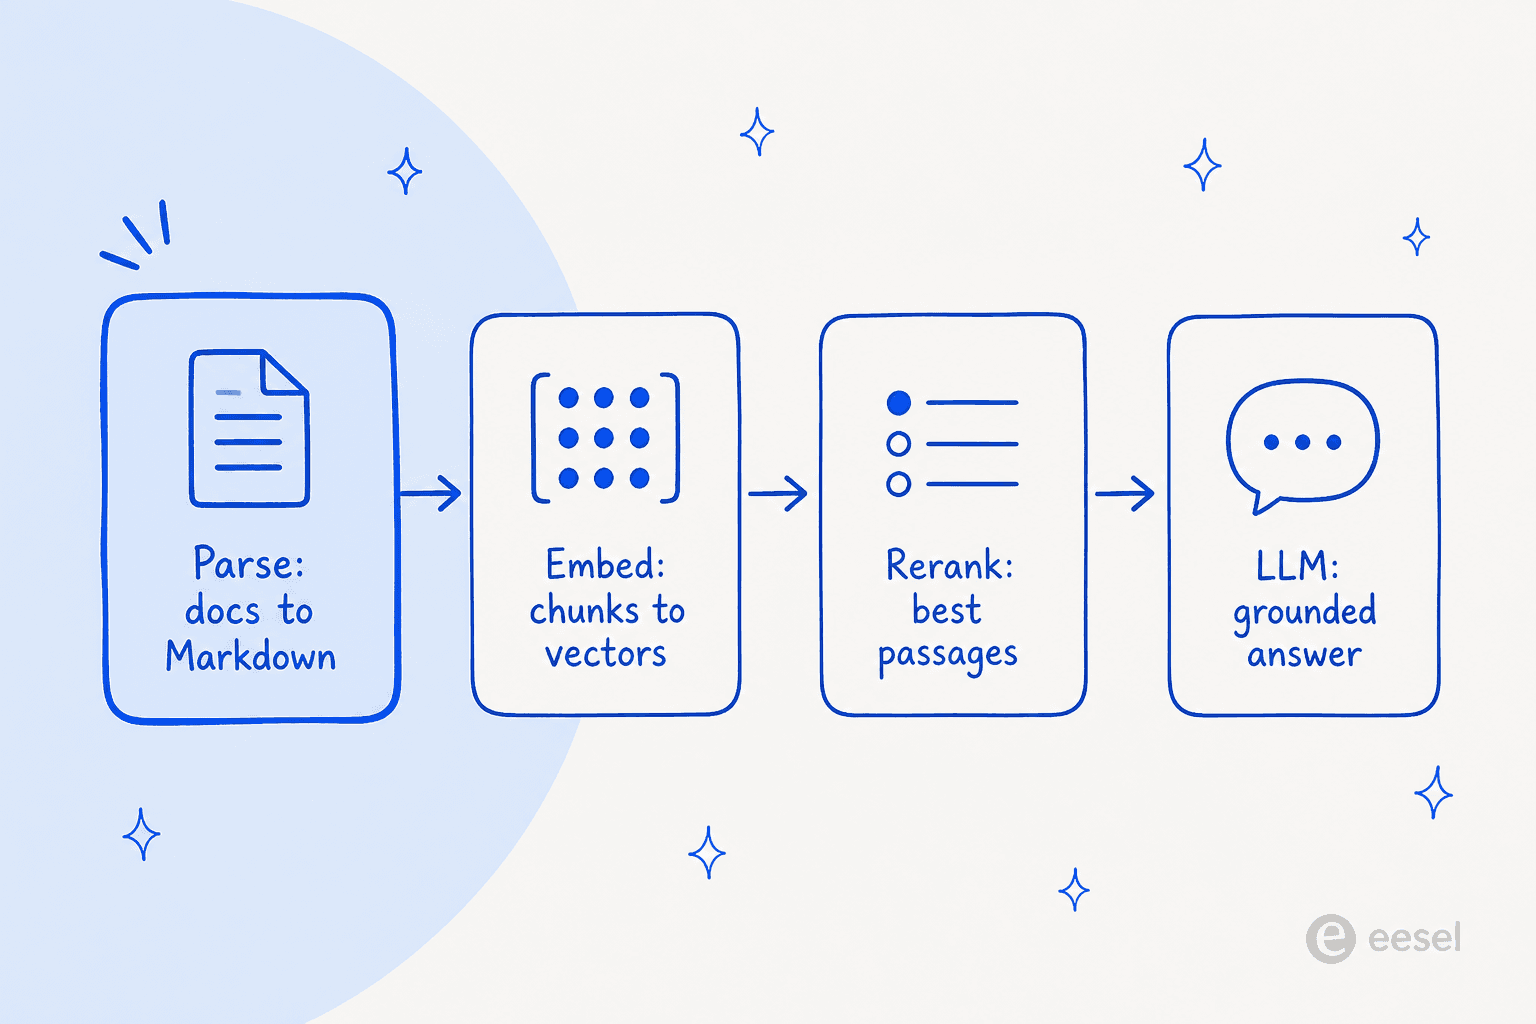
Cohere le sait, c'est pourquoi Parse est livré comme composant de Compass, sa pile d'intelligence documentaire et de recherche, aux côtés d'Embed et de Rerank. Si vous êtes déjà tout-Cohere, ce chemin intégré est vraiment pratique. Sinon, il vaut la peine de comparer des alternatives à Cohere avant de standardiser sur une seule pile.
La seule voix extérieure crédible que j'ai trouvée sur le lancement faisait la même remarque : l'analyse est plus difficile qu'il n'y paraît. Le journaliste spécialisé dans la tech d'entreprise Sean Kerner l'a bien dit :
"Text, document parsing should be a solved problem at this point right? But it's not.. every few weeks there is another option that claims to make it better. This week it's @cohere Parse 5."
Ce scepticisme est légitime. Parse 5 est une bonne version, mais c'est un analyseur solide dans un domaine en perpétuel mouvement, et il résout exactement un maillon d'une chaîne qui en compte quatre ou cinq. Si votre objectif réel est de répondre à des questions à partir de vos documents, choisir un analyseur est le début du projet, pas la fin.
Qui devrait vraiment utiliser Cohere Parse 5
Après examen, voici où j'atterris.
Choisissez Parse 5 si vous ingérez de gros volumes de documents d'entreprise (pensez à des centaines de milliers à des millions de pages) dans un système RAG ou de gestion des connaissances, que vous tenez à un coût par page prévisible et que « une précision proche de celle des modèles de pointe pour une fraction du prix » est le compromis que vous voulez. L'option Model Vault et sur site en fait aussi un choix solide pour les secteurs réglementés qui ne peuvent pas envoyer de documents à une API publique.
Passez votre tour, pour l'instant, si vous avez besoin dès aujourd'hui de l'ingestion directe de PDF, d'une sortie JSON structurée, de scores de confiance par champ ou des derniers points de précision de mise en forme que seul un modèle de pointe procure. Et passez votre tour si ce que vous vouliez vraiment, c'étaient des réponses plutôt que du texte propre, car un analyseur seul ne vous y mène pas.
eesel : quand vous voulez des réponses, pas seulement du texte analysé
Si vous êtes arrivé à Parse 5 parce que vous voulez qu'une IA réponde réellement aux questions à partir des documents de votre entreprise (tickets de support, articles d'aide, wikis internes), il faut nommer ce que l'analyseur ne fait pas. Parse vous donne du Markdown propre. Il vous reste à construire par-dessus les couches d'embedding, de recherche, de classement et de réponse, puis à les garder exactes à mesure que votre contenu change.
eesel est la version prête à l'emploi de toute cette chaîne. Plutôt qu'une infrastructure à assembler, c'est un coéquipier de helpdesk IA que vous embauchez : il se connecte à votre centre d'aide, à vos anciens tickets et à des outils comme Zendesk ou Confluence, apprend le contexte de votre entreprise et répond à de vraies questions de clients et d'employés. C'est l'une des meilleures options de helpdesk IA précisément parce que toute la chaîne est prise en charge pour vous. Parse 5 est une brique ; eesel est le travail fini.

Le point que je mettrais en avant, car c'est ce que j'aimerais voir dans tout pipeline qui commence par l'analyse : eesel vous permet de simuler un déploiement sur vos propres tickets historiques avant qu'il réponde à un vrai client, pour voir le vrai taux de résolution et les réponses exactes sur votre contenu réel, pas une démo. C'est la différence entre livrer un analyseur et livrer quelque chose en quoi vous avez confiance. Vous pouvez essayer eesel gratuitement.
Questions fréquentes
Qu'est-ce que Cohere Parse 5 ?
parse-v5.0) est un modèle de vision de 2,3 milliards de paramètres qui convertit les pages de documents en Markdown propre et lisible par machine pour la recherche, le RAG et les agents IA. Il est devenu généralement disponible le 27 août 2026 et se positionne sur le rapport qualité-prix plutôt que sur la précision maximale.