

Cohere Parse 5 (parse-v5.0) est un analyseur de documents solide et bon marché : il transforme les pages en Markdown propre à 1,50 $ les 1 000 pages et obtient 79,2 sur ParseBench. On cherche des alternatives pour trois raisons : on veut plus de précision, on veut un outil intégré à un cloud déjà payé, ou on veut l'héberger soi-même pour garder la main sur les données.
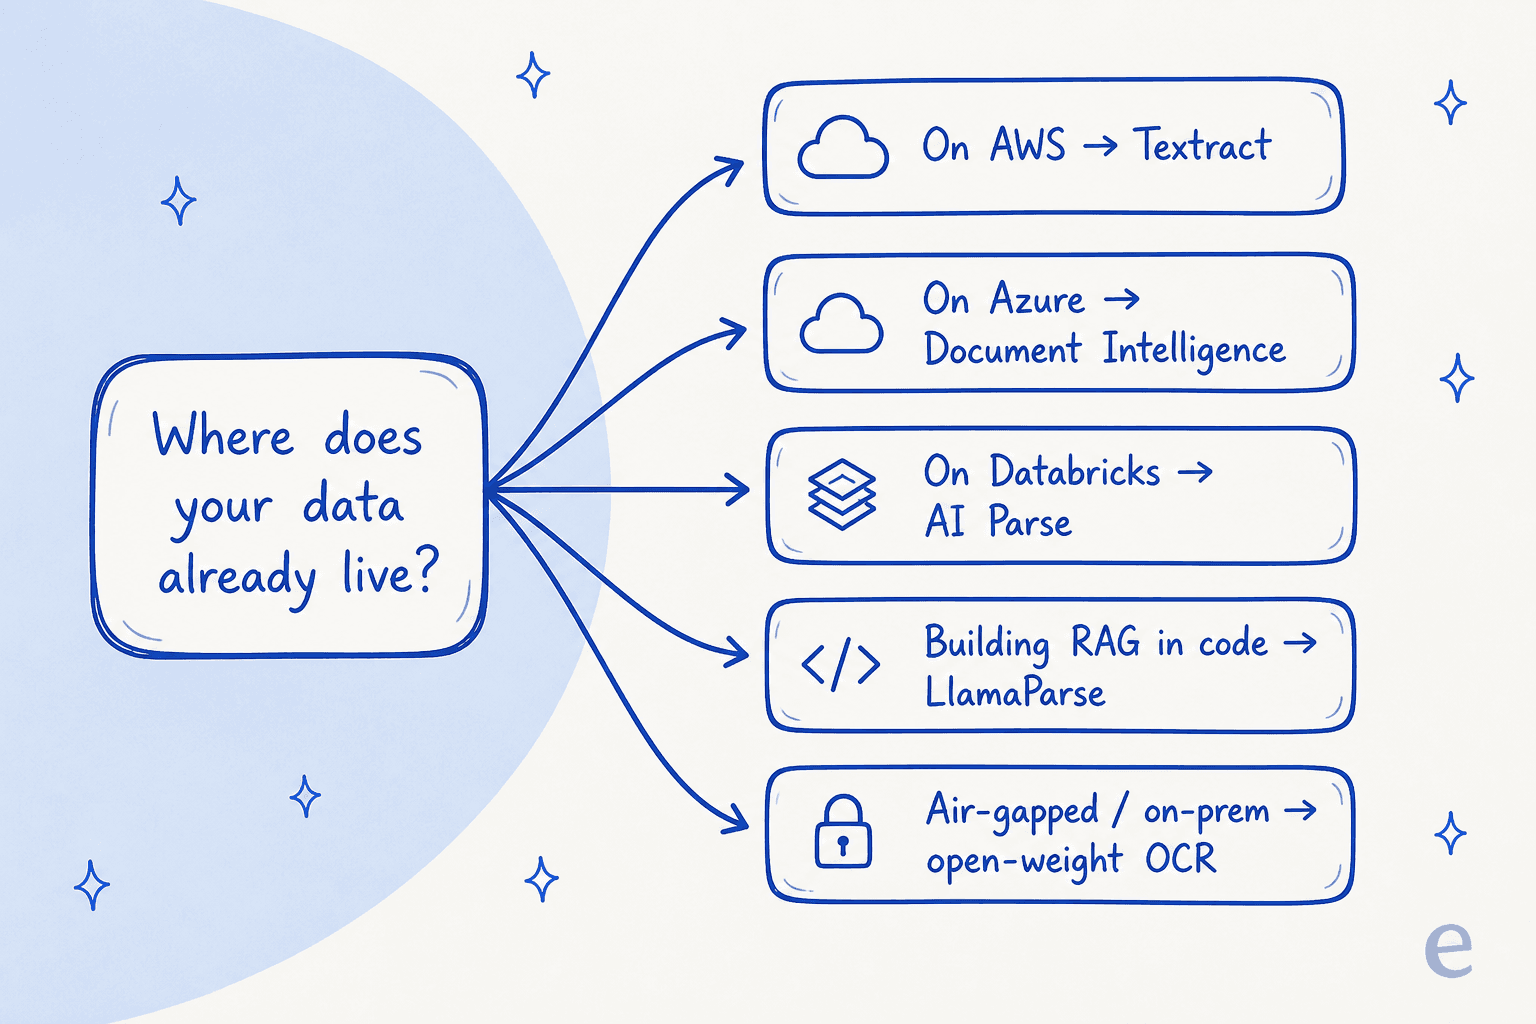
Voici la version courte de la direction à prendre :
- Vous voulez la meilleure précision, coûte que coûte ? Un modèle de pointe, GPT-5.5 (84,4) ou Gemini 3.5 Flash (81,8), domine le tableau.
- Vous voulez une API à la page comme Parse ? Mistral OCR est le remplaçant le plus proche.
- Vous construisez du RAG en code ? LlamaParse s'intègre à la stack LlamaIndex.
- Déjà sur AWS, Azure ou Databricks ? Utilisez leur analyseur natif (Textract, Document Intelligence, AI Parse) et évitez un fournisseur de plus.
- Besoin d'un contrôle total des données ? Hébergez vous-même un modèle OCR à poids ouverts.
Une chose à dire d'emblée : tous les outils de cette liste ne font que convertir des documents en texte. Si votre vrai but est de répondre à des questions à partir de ces documents, l'analyse n'est que l'étape un sur quatre. C'est là qu'intervient un agent d'IA pour helpdesk prêt à travailler comme eesel, qui gère toute la chaîne et pas seulement le premier maillon.
Pourquoi regarder au-delà de Cohere Parse 5 ?
Soyons d'abord justes envers Parse, car c'est une vraie belle sortie. Cohere l'a lancé le 27 août 2026 comme « un modèle d'analyse visuelle à haut débit au meilleur profil prix-performance du marché », et les chiffres appuient cette description. Il traite 4,5 pages par seconde, renvoie du Markdown propre qui s'insère directement dans un pipeline de RAG et coûte un tarif fixe de 1,50 $ les 1 000 pages. Si vous ingérez des centaines de milliers de pages par mois, ce rapport prix-performance est difficile à contester. J'ai tout détaillé dans notre test complet de Cohere Parse 5.
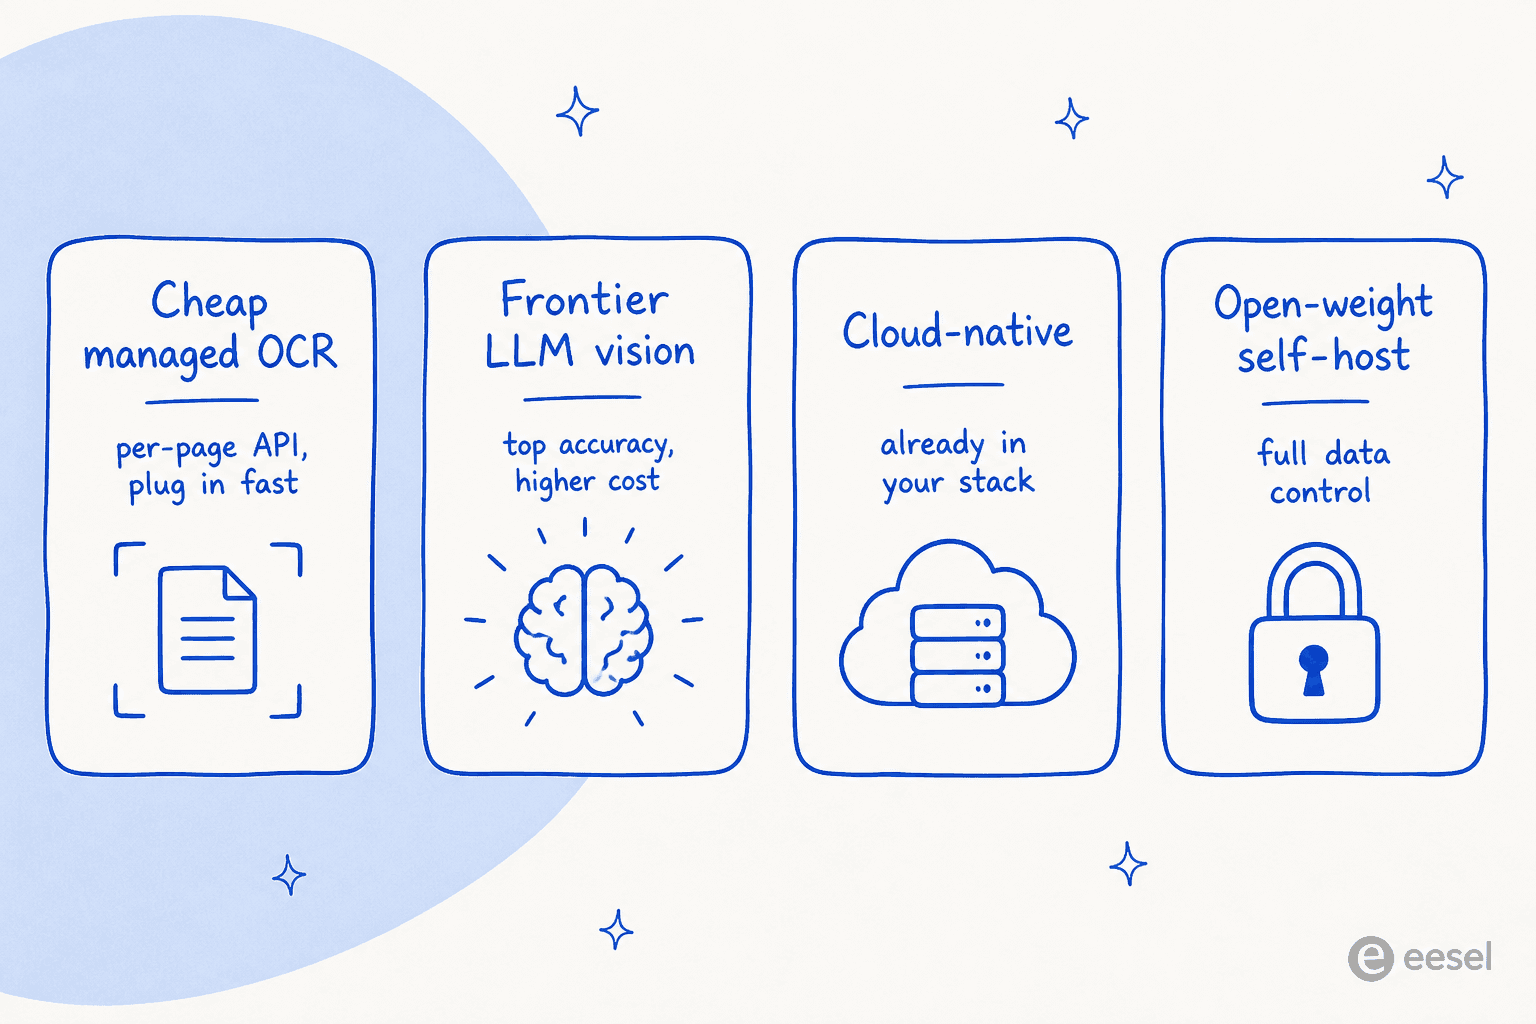
Alors pourquoi comparer ? Trois vraies raisons reviennent sans cesse.
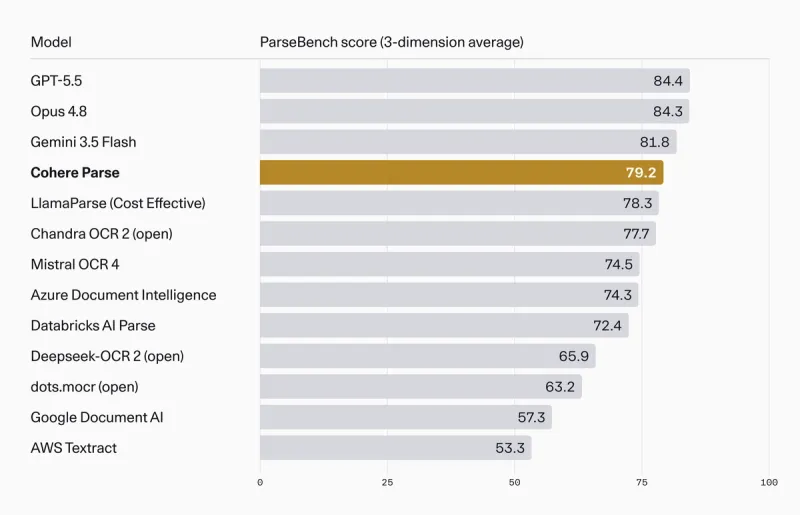
Précision. Parse se positionne explicitement sur le prix-performance, pas sur le fait d'être l'analyseur le plus précis du marché. Sur ParseBench, il obtient 79,2 et n'est « surpassé que par les LLM de pointe » (GPT-5.5, Opus 4.8, Gemini 3.5 Flash). Si vos documents sont désordonnés, denses ou pleins de tableaux imbriqués, ces points supplémentaires comptent, et vous paierez peut-être volontiers plus par page pour les obtenir.
Adéquation à la stack. Si vos données vivent déjà sur AWS, Azure ou Databricks, ajouter Cohere signifie un fournisseur de plus, une clé de plus, une facture de plus et un accord de traitement des données de plus. L'analyseur natif de votre cloud est souvent « assez bon » et épargne toute cette friction.
Limites d'entrée et contrôle des données. Le point d'accès en direct de Parse n'accepte pour l'instant que des images, il faut donc convertir les PDF d'abord, et c'est une API gérée. Les équipes de secteurs réglementés veulent souvent un traitement direct des PDF ou un modèle exécutable entièrement sur leur propre matériel. Certaines alternatives offrent les deux.
Rien de tout cela n'est une critique de Parse. Ce sont simplement les coutures où un autre outil s'adapte mieux. Voici comment se répartit le marché.
Comment j'ai choisi et comparé ces alternatives
Chaque outil ici fait le même travail de base que Parse : il prend des pages de documents et renvoie du texte ou du Markdown structuré et lisible par machine. Je les ai classés selon quatre critères qui comptent vraiment pour un acheteur :
- Précision - où ils se situent sur ParseBench, le benchmark utilisé par Cohere elle-même, pour une comparaison à armes égales.
- Modèle de coût - à la page, au token ou avec votre propre calcul, et ce que cela donne à grand volume.
- Déploiement - API gérée, dans un cloud déjà utilisé, ou auto-hébergé.
- Gestion des entrées - images seulement, PDF directement, ou large éventail de types de fichiers.
Voici tout le paysage en un coup d'œil. Les scores ParseBench viennent directement du tableau publié par Cohere.
| Outil | Moyenne ParseBench | Idéal pour | Déploiement | Entrée | Modèle de coût |
|---|---|---|---|---|---|
| Cohere Parse 5 | 79,2 | Analyse bon marché à grand volume | API, Model Vault, places de marché cloud | Images | 1,50 $ / 1 000 pages |
| GPT-5.5 | 84,4 | Documents les plus désordonnés, précision maximale | API | Images, PDF (via LLM) | Au token |
| Opus 4.8 | 84,3 | Précision maximale, long contexte | API | Images, PDF (via LLM) | Au token |
| Gemini 3.5 Flash | 81,8 | Analyse bon marché de niveau pointe | API | Images, PDF (via LLM) | Au token |
| LlamaParse | 78,3 | Pipelines RAG pilotés par le code | API / cloud | PDF, Office, images | Crédits par page |
| Mistral OCR 4 | 74,5 | API à la page avec auto-hébergement | API, auto-hébergé | Images, PDF | 4 $ / 1 000 pages |
| Databricks AI Parse | 72,4 | Équipes sur le lakehouse | Dans Databricks | PDF, images | DBU |
| Azure Document Intelligence | 69,3 | Formulaires structurés, modèles prêts à l'emploi | Azure | PDF, images | Par 1 000 pages |
| AWS Textract | 53,3 | Stacks natives AWS et réglementées | AWS | PDF, images | Par 1 000 pages |
| Unstructured | Absent de ParseBench | Ingestion ouverte, nombreux types de fichiers | API, open source | 25+ types de fichiers | À la page / open source |
Une remarque rapide pour lire ce tableau : un score ParseBench plus bas n'est pas automatiquement « pire pour vous ». Textract est en bas de ce benchmark général, mais si vous voulez seulement du texte propre à partir de PDF standard dans une entreprise AWS, cela reste un choix parfaitement sensé. Adaptez l'outil à la tâche, pas au classement.
1. LlamaParse
Idéal pour : les équipes qui construisent un pipeline RAG en code et vivent déjà dans l'écosystème LlamaIndex.
LlamaParse est le service d'analyse de LlamaIndex, le framework open source populaire pour créer des applications LLM sur vos propres données. Il est conçu exactement pour le travail que vise Parse : transformer des PDF complexes, des présentations et des tableurs en Markdown propre, prêt à être découpé pour la récupération. Sur ParseBench, son offre Cost Effective obtient 78,3, presque à égalité avec les 79,2 de Parse.
Fonctionnalités. LlamaParse accepte directement les PDF, les fichiers Office et les images (sans étape de conversion en image), propose plusieurs modes d'analyse qui arbitrent entre coût et profondeur, et s'intègre directement à un pipeline de récupération LlamaIndex. Il gère les tableaux, les images intégrées et les mises en page multicolonnes, et peut suivre des instructions d'analyse en langage naturel par document.
Avantages. Si vous écrivez déjà du Python et utilisez LlamaIndex, c'est l'option la plus fluide de la liste. La prise en charge directe des PDF et d'Office fait gagner un vrai temps d'ingénierie, et les 10 000 crédits gratuits mensuels facilitent le prototypage avant de dépenser quoi que ce soit.
Inconvénients. C'est un outil pour développeurs, pas un produit en pointer-cliquer. Le modèle de crédits demande un instant de réflexion, car les modes d'analyse consomment un nombre de crédits différent par page. Et vous assemblez toujours vous-même les couches de récupération et de réponse.
Tarifs. LlamaParse facture en crédits : 1 000 crédits coûtent 1,25 $, et l'analyse de base commence à 1 crédit par page (les modes Agentic, sensibles à la mise en page, coûtent plus). Le forfait gratuit inclut 10 000 crédits par mois, et un Auto Mode oriente chaque page vers le palier le moins cher qui fait l'affaire.
Verdict : le choix naturel si vous construisez du RAG en code et voulez une analyse qui s'emboîte avec le reste de votre stack. Si vous n'êtes pas déjà dans l'univers LlamaIndex, l'enfermement dans l'écosystème est une raison de regarder ailleurs.
2. Mistral OCR
Idéal pour : les équipes qui veulent l'expérience simple d'API à la page de Parse chez un autre fournisseur, avec une voie d'auto-hébergement.
Mistral OCR est le cousin philosophique le plus proche de Cohere Parse : un modèle OCR dédié à haut débit, vendu comme une API propre à la page. Mistral le positionne comme de la compréhension de documents qui renvoie du Markdown structuré avec tableaux et images préservés, depuis un modèle que vous pouvez aussi exécuter vous-même. Sur ParseBench, Mistral OCR 4 obtient 74,5, un cran sous Parse mais encore devant la plupart des options natives du cloud.
Fonctionnalités. Il gère directement images et PDF, extrait tableaux et figures intégrées, prend en charge un large éventail de langues et renvoie du Markdown conçu pour l'indexation en aval. Mistral propose aussi un déploiement auto-hébergé pour les équipes qui doivent garder les documents sur leur propre infrastructure.
Avantages. Rapide et très simple à intégrer si vous avez déjà appelé une API de type OpenAI. L'option d'auto-hébergement est un vrai différenciateur face au point d'accès uniquement géré de Parse, et l'argument de la résidence des données en Europe séduit les équipes soumises à la conformité UE.
Inconvénients. Il est derrière Parse et les modèles de pointe sur ParseBench, notamment en mise en forme sémantique, et le modèle actuel n'est plus l'aubaine tarifaire qu'était l'original. Sur les documents financiers ou scientifiques les plus denses, l'écart de précision peut se traduire par un tableau cassé de temps en temps.
Tarifs. L'actuel Mistral OCR 4 coûte 4 $ les 1 000 pages, descendant à 2 $ les 1 000 via l'API par lots ; la couche Document AI sans code coûte 5 $ les 1 000. C'est au-dessus du tarif fixe de 1,50 $ de Parse, le passage vous coûte donc un peu plus par page.
Verdict : si l'idée de Parse vous plaisait mais que vous voulez une seconde source, la résidence des données dans l'UE ou une voie d'auto-hébergement, Mistral OCR est le remplaçant le plus direct. Sachez simplement que vous échangez quelques points de précision et payez un peu plus par page.
3. GPT-5.5
Idéal pour : les documents les plus désordonnés et les plus précieux, où la précision compte plus que la facture à la page.
Vous n'avez pas besoin d'utiliser un analyseur conçu pour cela. Un modèle multimodal de pointe comme GPT-5.5 peut lire une image de page et renvoyer du texte structuré, et il domine tout le tableau ParseBench avec 84,4, soit plus de cinq points devant Parse. Cohere reconnaît elle-même que Parse « n'est surpassé que par les LLM de pointe », et GPT-5.5 en fait partie.
Fonctionnalités. Modèle généraliste, GPT-5.5 ne se contente pas de transcrire ; il raisonne sur une page. Vous pouvez lui demander d'extraire des champs précis, de suivre des règles de mise en forme complexes ou de gérer une mise en page jamais vue, le tout en un seul appel. Il lit les images et, via l'API, les PDF.
Avantages. La meilleure précision du benchmark et une souplesse inégalée. Si un document a une mise en page étrange sur laquelle un analyseur à schéma fixe bute, un LLM s'en sort souvent tout simplement. C'est aussi probablement le même modèle que vous utilisez déjà ailleurs, donc pas de nouveau fournisseur.
Inconvénients. Le coût. Vous payez au token, et une page dense peut représenter beaucoup de tokens, si bien qu'à des millions de pages la note grimpe vite comparée au tarif fixe à la page de Parse. Il est aussi plus lent par page, et les modèles généralistes peuvent halluciner du contenu, ce à quoi un modèle OCR étroit est moins sujet.
Tarifs. Au token, facturé en entrée et en sortie, le coût dépend donc de la complexité de la page plutôt que d'un chiffre fixe par page. Le modèle phare actuel d'OpenAI, GPT-5.6 Sol, coûte 4 $ par million de tokens d'entrée et 20 $ par million de sortie à son tarif promotionnel, avec des cousins moins chers (Luna à 0,20 $ / 1,20 $) pour les tâches plus légères. Une page dense brûle beaucoup de tokens, donc à des millions de pages, cela s'additionne vite.
Verdict : choisissez GPT-5.5 quand les documents sont de grande valeur et en faible volume, ou quand les mises en page sont trop variées pour un analyseur fixe. Pour des pages prévisibles à grand volume, la facture au token fait d'un analyseur dédié comme Parse l'achat le plus malin.
4. Gemini 3.5 Flash
Idéal pour : les équipes qui veulent une précision d'analyse de niveau pointe sans le prix complet d'un modèle de pointe.
Gemini 3.5 Flash est le modèle multimodal rapide et peu cher de Google, et c'est le bon compromis entre les deux extrêmes de cette liste. Il obtient 81,8 sur ParseBench, devançant Parse et tous les analyseurs natifs du cloud, tout en étant bien moins cher au token qu'un modèle phare comme GPT-5.5 ou Opus 4.8.
Fonctionnalités. Comme GPT-5.5, c'est un modèle généraliste qui lit des images de pages et des PDF et peut extraire des données structurées sur instruction. Flash est optimisé pour la vitesse et le faible coût, avec une grande fenêtre de contexte qui permet de lui fournir de longs documents d'un coup.
Avantages. Une combinaison rare : une précision supérieure à Parse et la souplesse d'un LLM, à un prix qui reste raisonnable à grande échelle. Si vous êtes déjà sur Google Cloud ou utilisez Vertex AI, l'intégration est triviale.
Inconvénients. Toujours facturé au token, donc moins prévisible qu'un analyseur à tarif fixe par page, et à très grand volume les 1,50 $ les 1 000 pages de Parse peuvent encore l'emporter sur le coût total. Comme avec tout LLM, vous portez un petit risque d'hallucination qu'un modèle OCR étroit n'a pas.
Tarifs. Au token, aux tarifs bas de Flash. L'actuel Gemini 3.7 Flash coûte 0,75 $ par million de tokens d'entrée et 3,75 $ par million de sortie à son tarif promotionnel, et il existe un palier réellement gratuit (à débit limité) pour prototyper. C'est une fraction du coût au token d'un modèle phare.
Verdict : ma recommandation par défaut pour les équipes qui veulent plus de précision que Parse mais reculent devant les tarifs d'un modèle phare. Flash est le meilleur rapport qualité-prix du groupe des modèles de pointe.
5. Databricks AI Parse
Idéal pour : les équipes data dont les documents vivent déjà dans le lakehouse Databricks.
Databricks AI Parse (ai_parse_document) est une analyse de documents intégrée directement à la plateforme Databricks, appelable comme fonction SQL sur des données que vous avez déjà dans le lakehouse. Il obtient 72,4 sur ParseBench. L'argument n'est pas la précision maximale, c'est zéro déplacement de données.
Fonctionnalités. Vous appelez l'analyse en ligne dans un flux SQL ou notebook, et le texte extrait retombe directement dans vos tables Delta, prêt pour la gestion des connaissances et l'analytique en aval. Pas de service séparé, aucune donnée ne quitte la plateforme.
Avantages. Si votre pipeline est déjà sur Databricks, c'est la voie de moindre résistance : aucun nouveau fournisseur, aucune sortie de données, et la gouvernance assurée par Unity Catalog. Pour unifier l'analyse de documents avec le reste de votre ingénierie de données, rien n'est aussi fluide.
Inconvénients. Cela n'a de sens que si vous êtes une entreprise Databricks ; monter la plateforme uniquement pour analyser des documents serait absurde. Et à 72,4, il est derrière Parse et les modèles de pointe en qualité d'analyse générale.
Tarifs. Facturé en DBU (Databricks Units) dans le cadre de votre calcul habituel, plutôt qu'à un tarif public par page. Consultez la page de tarifs Databricks et le tarif de votre espace de travail.
Verdict : un oui facile pour les équipes Databricks existantes qui préfèrent garder les données sur place plutôt que de gratter les derniers points de précision. Sans intérêt pour tous les autres.
6. Azure AI Document Intelligence
Idéal pour : les équipes sur Azure qui ont besoin d'extraction structurée de formulaires, factures et pièces d'identité avec des modèles prêts à l'emploi.
Azure AI Document Intelligence (anciennement Form Recognizer) est le service mature de traitement de documents de Microsoft. Il obtient 69,3 sur ParseBench, mais ce score général sous-estime sa vraie force : des modèles prêts à l'emploi qui extraient des champs structurés de types de documents précis, factures, reçus, formulaires fiscaux et pièces d'identité, sans rien entraîner.
Fonctionnalités. Au-delà de l'OCR de texte simple (le modèle Read), il fournit des extracteurs prêts à l'emploi pour les documents d'entreprise courants et un flux de modèles personnalisés pour entraîner le vôtre sur une poignée d'exemples. Il accepte directement PDF et images et renvoie du JSON structuré avec des scores de confiance par champ, ce que le point d'accès en direct de Parse n'émet pas actuellement.
Avantages. Pour les formulaires structurés, c'est un cran au-dessus de l'analyse générique : il ne se contente pas de lire la facture, il vous donne le total, le fournisseur et l'échéance sous forme de champs étiquetés avec confiance. L'intégration profonde à Azure et la conformité entreprise en font une vente facile dans les entreprises Microsoft.
Inconvénients. Il est davantage orienté extraction de champs de formulaire que Markdown propre pour le RAG, donc pour la conversion générale de document en texte, il est en retrait face aux analyseurs plus récents. Les scores de confiance et les modèles prêts à l'emploi ajoutent une configuration inutile si vous voulez seulement du texte.
Tarifs. Par 1 000 pages, selon le type de modèle : le modèle Read OCR coûte 1,50 $ les 1 000 pages (comme Parse), tandis que les modèles prêts à l'emploi coûtent 10 $ et l'extraction personnalisée 30 $ les 1 000. Un palier gratuit F0 couvre 500 pages par mois.
Verdict : le meilleur choix quand votre vrai problème est l'extraction structurée de formulaires connus, pas l'analyse générale, et que vous êtes déjà sur Azure. Pour du Markdown propre destiné à un index RAG, un analyseur plus récent convient mieux.
7. AWS Textract
Idéal pour : les équipes natives AWS et les stacks réglementées qui veulent de l'OCR de documents dans leur cloud existant.
AWS Textract est le service d'OCR et d'analyse de documents d'Amazon, présent de longue date. Il se situe en bas du tableau général ParseBench avec 53,3, et Cohere annonce une « amélioration de plus de 20 points » par rapport à lui, donc personne ne choisit Textract pour une qualité de Markdown de pointe. On le choisit parce qu'il est déjà dans son compte AWS.
Fonctionnalités. Textract détecte le texte, les tableaux et les paires clé-valeur de formulaires, avec des API spécialisées pour les notes de frais et les pièces d'identité. Il accepte PDF et images, s'intègre nativement à S3, Lambda et au reste d'AWS, et hérite d'office des certifications de conformité d'AWS.
Avantages. Pour une entreprise AWS, l'intégration et la gouvernance sont imbattables : aucun nouveau fournisseur, aucune sortie de données, IAM et journaux d'audit auxquels vous faites déjà confiance. Il a fait ses preuves à l'échelle de l'entreprise et son extraction de tableaux et de formulaires sur des documents standard propres est fiable.
Inconvénients. Sur le benchmark moderne, il est loin derrière le reste, surtout en mise en forme sémantique (un 2,8 sur ce critère). C'est un moteur OCR de génération précédente, pas un modèle vision-langage, et sur des mises en page désordonnées ou inhabituelles il peine là où les outils plus récents se débrouillent.
Tarifs. Par 1 000 pages, tarifé séparément par API : le Detect Text simple coûte 1,50 $ les 1 000 pages, tandis qu'Analyze Document grimpe à 15 $ pour les tableaux et 50 $ pour les formulaires, si bien qu'extraire des champs structurés devient vite coûteux. Les nouveaux comptes bénéficient de trois mois de palier gratuit.
Verdict : le choix sûr, sans surprise et correct pour les équipes natives AWS qui analysent des documents standard et préfèrent rester dans le cloud plutôt que viser les scores de benchmark. Si la qualité d'analyse sur des mises en page difficiles est votre goulot d'étranglement, regardez plus haut dans cette liste.
8. Unstructured
Idéal pour : les équipes qui doivent ingérer un large éventail de types de fichiers dans un seul pipeline propre, avec une option open source.
Unstructured est moins un modèle OCR unique qu'une couche d'ingestion complète : il prend plus de 25 types de fichiers (PDF, Word, PowerPoint, HTML, e-mails, images) et les normalise en JSON propre et découpé, prêt pour l'embedding. Il n'est pas sur ParseBench car il joue un rôle un peu différent, la tuyauterie qui amène tout dans votre base vectorielle, pas seulement les PDF.
Fonctionnalités. Des connecteurs vers des dizaines de sources, une immense variété de formats d'entrée, un découpage sensible à la mise en page et une bibliothèque open source bien connue en plus de l'API gérée. C'est un choix courant dans les stacks RAG faites maison précisément parce qu'il gère la longue traîne de types de fichiers que les analyseurs mono-usage ignorent, ce qui compte si votre gestion des connaissances est éparpillée dans une douzaine d'applications.
Avantages. L'étendue. Si vos connaissances vivent dans des PDF, des exports Confluence, des e-mails et des présentations, Unstructured les traite tous dans un seul pipeline. Le cœur open source permet de démarrer gratuitement et d'auto-héberger.
Inconvénients. Sa qualité d'OCR brute sur les documents complexes n'est pas la meilleure de sa catégorie, beaucoup d'équipes l'associent donc à un analyseur plus fort pour les PDF difficiles. Et exécuter la version open source à grande échelle est un vrai travail d'ingénierie, pas un confort géré.
Tarifs. La bibliothèque open source est gratuite à auto-héberger ; la Unstructured Platform gérée est facturée à la page. Consultez leur site pour les tarifs d'API actuels.
Verdict : le meilleur choix quand votre problème est la variété des formats, pas la précision d'analyse brute sur un seul type. Beaucoup d'équipes utilisent Unstructured pour l'étendue et un modèle comme Parse ou Gemini pour les documents délicats.
Une note sur les analyseurs à poids ouverts
Si le contrôle des données est votre moteur, le coin de cet espace qui évolue le plus vite est celui des modèles OCR à poids ouverts que vous hébergez vous-même : des choses comme dots.ocr, Chandra OCR 2 et DeepSeek-OCR 2 figurent tous sur ParseBench (Chandra OCR 2 obtient un respectable 77,7). dots.ocr est distribué sous licence MIT et s'exécute en local via vLLM, le marché est donc simple : aucun frais à la page, jamais, et un contrôle total sur le lieu de traitement des documents, en échange de la possession des GPU et de l'exploitation. Pour un environnement isolé ou très réglementé, ce marché vaut souvent le coup. Pour tous les autres, une API gérée demande moins d'efforts.
Ce que chaque outil de cette liste vous laisse à construire
C'est la partie facile à manquer quand on compare des analyseurs. Chaque option ci-dessus, Parse compris, ne fait qu'un travail : transformer des documents en texte propre. Ce texte n'est pas une réponse. Pour vraiment utiliser vos documents, il faut encore découper et générer des embeddings du texte, le stocker, récupérer le bon passage pour une question donnée et générer une réponse fondée par-dessus.
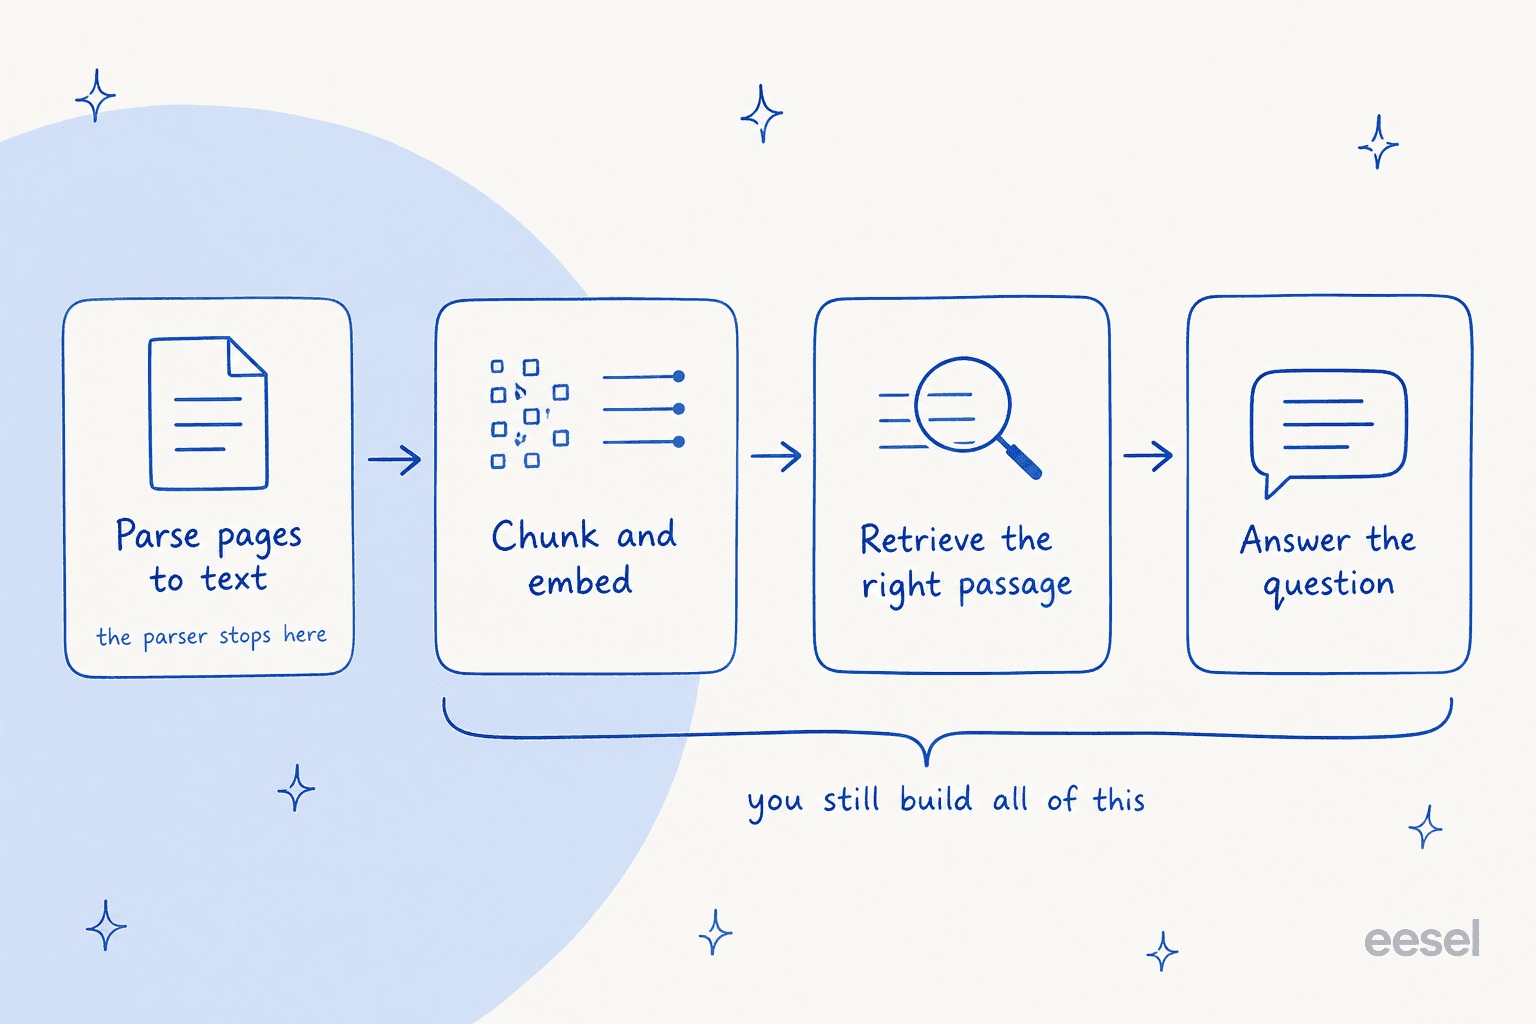
Si vous êtes une équipe data qui construit un produit sur mesure, relier ces quatre étapes est exactement le travail que vous avez choisi, et choisir le bon analyseur dans cette liste est une vraie décision. Mais beaucoup de gens qui cherchent « alternatives à Cohere Parse » ne construisent pas un pipeline d'analyse pour lui-même. Ils veulent le résultat : des réponses aux questions de clients ou d'employés, tirées de leurs propres documents. Pour eux, choisir un modèle OCR est un moyen pour une fin située trois étapes plus loin dans la chaîne.
Essayer eesel
C'est le vide que comble eesel. eesel est une plateforme de coéquipiers IA : au lieu d'une boîte à outils à assembler, vous embauchez un coéquipier prêt à travailler pour une mission précise. L'agent d'IA pour helpdesk est celui qui nous intéresse ici, et en tant qu'agent d'IA pour le service client, il ingère votre centre d'aide, vos documents internes et vos anciens tickets, s'occupe de l'analyse, de l'embedding et de la récupération à votre place, puis répond réellement aux questions, en direct dans votre helpdesk.

La formulation honnête est donc la suivante : si vous construisez un pipeline de documents et avez besoin d'un analyseur comme composant, choisissez parmi les huit ci-dessus. Si votre vrai but est de répondre à des questions à partir de vos connaissances, vous n'avez pas à choisir de modèle OCR du tout, il vous faut la couche qui se place au-dessus. eesel est gratuit à essayer, se connecte en quelques minutes, et vous pouvez le pointer vers vos documents existants et le voir répondre avant de vous engager. (Il y a aussi un coéquipier rédacteur de blog IA dans l'équipe, pour un tout autre travail.)
Comment les alternatives à Cohere Parse 5 se comparent-elles en précision ?