

Un agent vocal IA pour le support client répond seul aux appels téléphoniques : il transcrit ce que dit l'appelant (reconnaissance vocale), raisonne sur vos connaissances et vos systèmes avec un LLM, puis répond à voix haute (synthèse vocale), le tout en une seconde environ. Le plus dur n'est pas l'IA, c'est la plomberie en temps réel. Les appelants remarquent un retard au-delà de 800 ms, donc tout l'aller-retour est chronométré.
Côté coût, la voix est facturée à la minute. Les plateformes clés en main situent la plupart des appels de support dans une fourchette de 0,07 à 0,16 $ la minute avant la ligne téléphonique, soit environ 0,35 à 0,80 $ pour un appel de 5 minutes, plus la téléphonie.
Ce que je tatouerais sur chaque déploiement : l'IA vocale marche quand elle passe la main à un humain, et échoue quand elle cherche à le remplacer. Je mets de l'IA sur des files de support en direct depuis des années, et la plus grande leçon est la confiance avant la couverture. Laissez l'agent traiter ce dont il est sûr et passez le reste. Cette leçon vaut pour tous les canaux, ce qui explique pourquoi il vaut la peine de réussir l'approche de l'agent IA pour helpdesk qui résout vos chats et tickets avant d'y ajouter une ligne téléphonique.
Ce qu'est vraiment un agent vocal IA
Sans le marketing, un agent vocal IA est un système qui décroche le téléphone, comprend un appelant en langage naturel, fait le travail et répond à voix haute, sans humain en ligne pendant la majeure partie de l'appel. La conception dominante enchaîne trois modèles spécialisés : la reconnaissance vocale (STT), un grand modèle de langage (LLM) pour réfléchir et la synthèse vocale (TTS), le tout posé sur une couche de téléphonie qui relie l'appel réel. Twilio appelle cela l'architecture d'agent vocal en cascade, où "the user's speech is transcribed, the transcript is processed by an LLM, then the resulting tokens are synthesized into audio."
Une variante plus récente fusionne cette chaîne en un seul modèle. La Realtime API d'OpenAI fonctionne directement de la parole à la parole, ce qui "reduces latency, preserves nuance in speech, and produces more natural, expressive responses."
Deux comparaisons font comprendre :
- Ce n'est pas l'ancien serveur vocal à touches. "Tapez 1 pour la facturation" (IVR) ne comprend que les tonalités du clavier ou quelques mots scriptés et envoie chaque appelant dans le même menu rigide. Un agent vocal laisse l'appelant décrire le problème avec ses propres mots, puis oriente ou résout à partir de là.
- C'est le cousin vocal d'un chatbot écrit, sur un support bien plus difficile. Le chat se joue au tour par tour et pardonne un ou deux secondes de délai. La voix est synchrone et en temps réel, et cette différence fait tout le défi d'ingénierie. Si vous avez lu la différence entre un agent IA et un chatbot à règles, c'est le même saut, avec en plus un problème audio en temps réel.
Comment fonctionne un agent vocal IA, étape par étape
Voici le chemin complet d'un appel de support, de la sonnerie à la réponse.
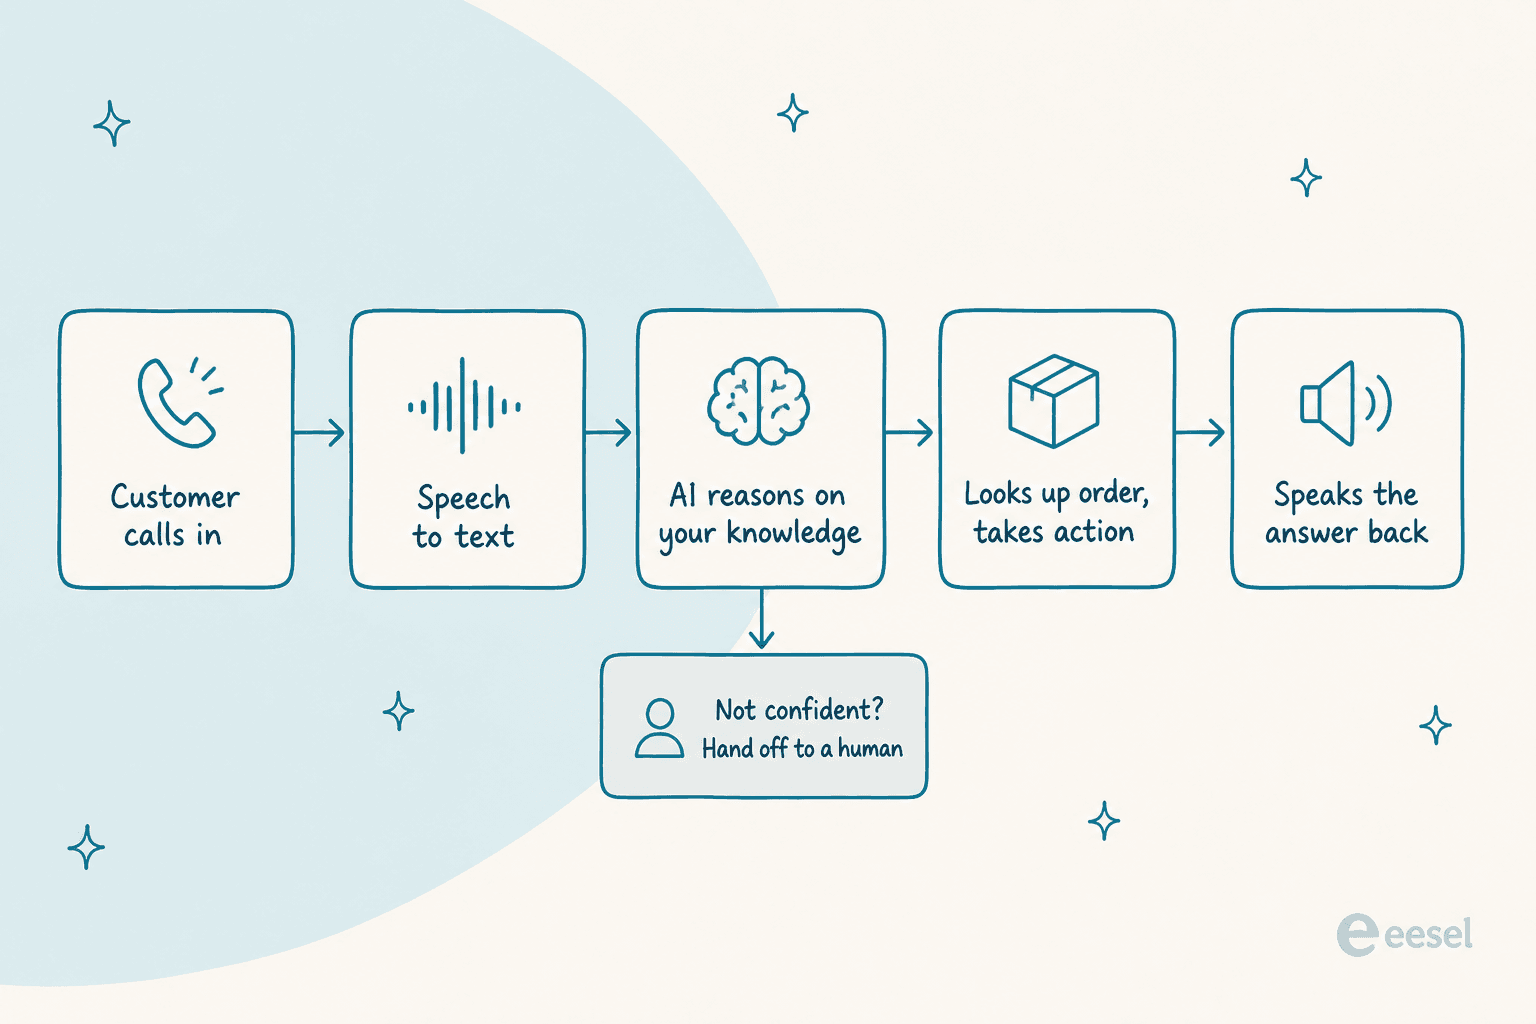
Téléphonie (la ligne téléphonique). L'appel arrive par le réseau téléphonique (PSTN) ou une connexion SIP. Twilio l'expose sous la forme d'un élément <ConversationRelay> qui "handles the complexities of live, synchronous voice calls," et OpenAI a récemment ajouté les appels téléphoniques via SIP à sa Realtime API.
Reconnaissance vocale. L'audio de l'appelant est transcrit en direct. Le vrai point difficile n'est pas la reconnaissance, c'est la détection de fin de parole : savoir quand l'appelant a réellement fini de parler, car une courte pause au milieu d'une phrase "can sound identical to an end-of-turn pause." Les bons systèmes gardent deux tampons de transcription, une hypothèse provisoire et un enregistrement validé, pour commencer à réfléchir tôt et corriger ensuite.
LLM plus recherche de connaissances. La transcription part vers un LLM qui détermine ce dont l'appelant a besoin et tire des réponses fondées d'une base de connaissances au lieu de deviner. Le montage de référence d'AWS associe Amazon Connect, Lex et Bedrock Knowledge Bases pour que l'agent réponde à partir du contenu de l'entreprise. Cette étape de recherche est la même raison pour laquelle un bon agent écrit doit être entraîné sur votre base de connaissances avant de dire un mot.
Actions dans les systèmes métier. Un agent en production ne fait pas que parler, il appelle des outils : consulter une commande, vérifier une fiche CRM, ouvrir un ticket. gpt-realtime d'OpenAI a ajouté la prise en charge des serveurs MCP distants pour que vous puissiez relier une session à un ensemble d'outils, et rendu les appels longs asynchrones pour que "the model can continue a fluid conversation while waiting on results."
Synthèse vocale. Les mots du modèle sont renvoyés en flux sous forme de parole synthétisée. Flux TTS de Deepgram entrelace la génération de texte et d'audio pour que la longueur de la réponse n'augmente pas la latence du premier son, avec un premier son "as low as 80ms."
Ce dernier chiffre laisse deviner la vraie histoire. Chacune de ces étapes court contre la montre, ce qui fait l'objet de la section suivante.
Pourquoi la voix est bien plus difficile qu'un chatbot
Si vous avez construit un agent écrit, votre instinct est que la voix, c'est "pareil, mais parlé." Ce n'est pas le cas. La voix ajoute des contraintes de temps réel que le chat n'a tout simplement pas.
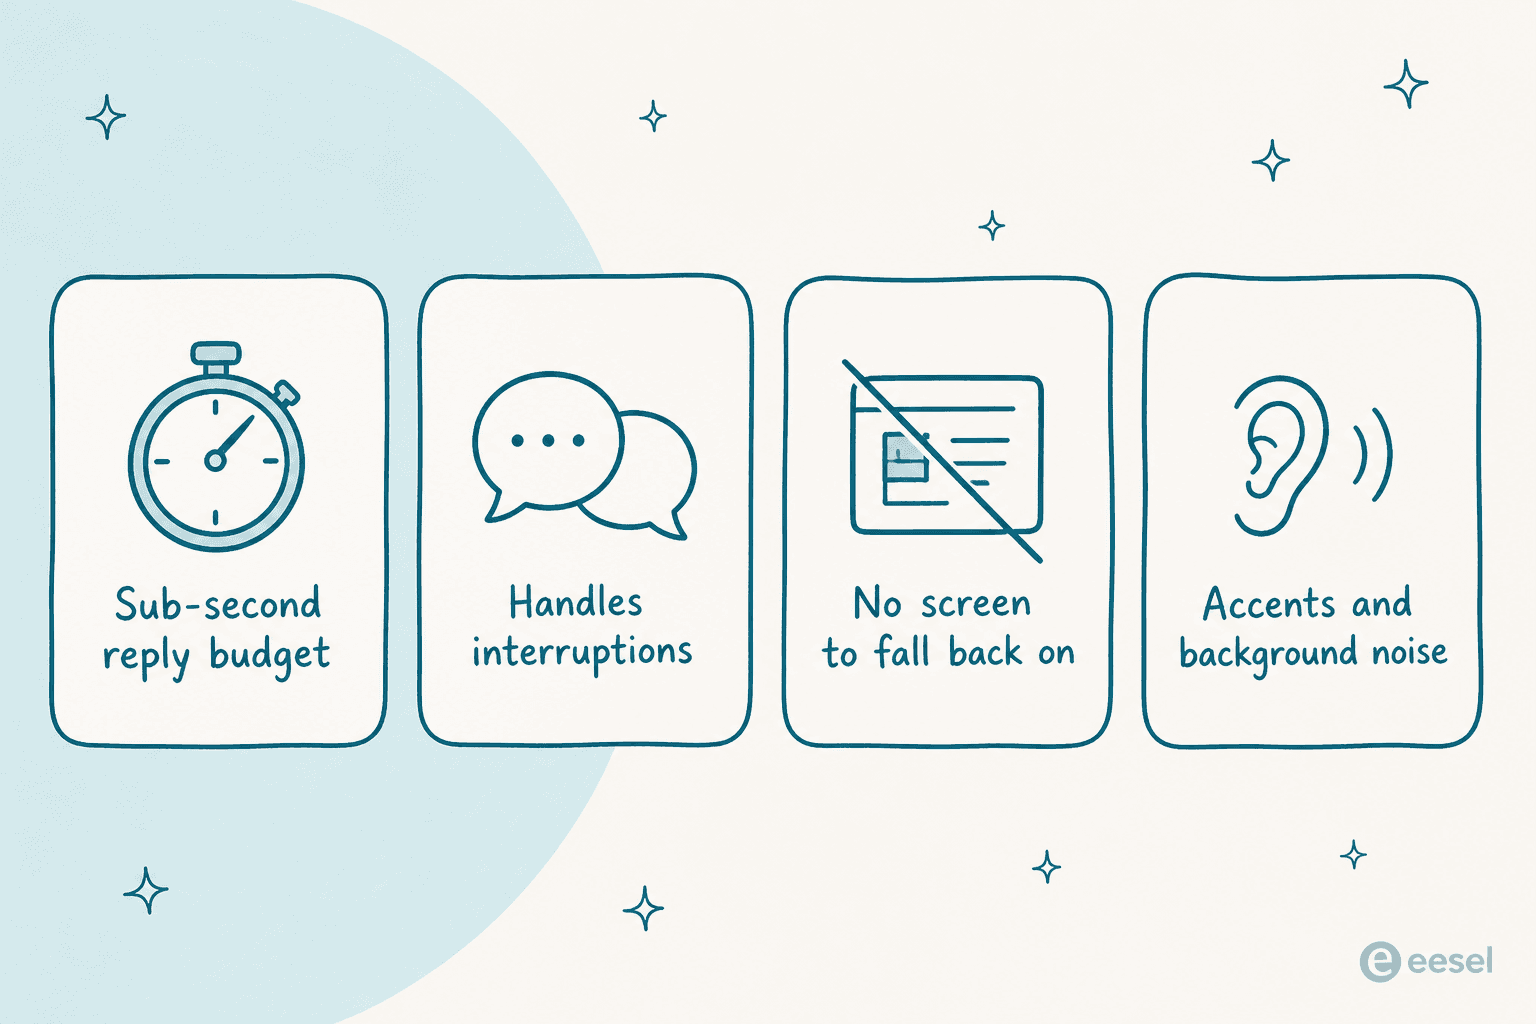
L'horloge est le point principal. Twilio, en publiant ses propres objectifs de lancement fin 2025, définit la latence comme le "mouth-to-ear turn gap" et fixe un objectif de bout en bout de 1 115 ms, avec une limite haute de 1 400 ms. Ce budget n'est pas dépensé à un seul endroit. Il s'additionne à peu près ainsi : STT 350 ms, LLM 375 ms, TTS 100 ms, plus réseau et mise en tampon, et comme ces chiffres se cumulent, "acceptable numbers at each stage can still sum to a broken conversation." Deepgram place le seuil de perception encore plus bas : les appelants "start noticing lag near 800ms of total round-trip time."
Il y a aussi tout ce que fait un appelant et qu'un utilisateur de chat ne fait jamais. Il interrompt. Gérer cette "prise de parole" (barge-in) signifie annuler la réponse en cours à l'instant où l'appelant coupe la parole, ce qui explique pourquoi l'API d'agents de Deepgram propose une détection de barge-in intégrée et une prédiction des tours de parole. Les appelants sont aussi dans des endroits bruyants, avec des accents, et sans écran de secours : il n'y a donc pas de "cliquez sur le bouton ci-dessous" quand le son est peu clair.
Un développeur qui a reconstruit une boucle vocale de zéro a placé la difficulté exactement là où elle se trouve :
"The hard part isn't STT, LLMs, or TTS in isolation, but turn-taking: detecting when the user starts and stops speaking, cancelling in-flight generation instantly, and pipelining everything to minimize time-to-first-audio... By colocating Twilio, Deepgram, ElevenLabs, and the orchestration layer, I reached ~790ms end-to-end latency."

Les modèles sont devenus vraiment bons, il faut le reconnaître. gpt-realtime obtient 82,8 % à l'évaluation de raisonnement Big Bench Audio, contre 65,6 % pour le modèle d'OpenAI de fin 2024, et il peut capter des signaux non verbaux comme les rires et changer de langue en pleine phrase. L'intelligence n'est généralement pas ce qui fait échouer une démo vocale. C'est la plomberie autour.
Ce que coûte vraiment un agent vocal IA
Voici la partie que la plupart des pages de fournisseurs enterrent : l'IA vocale est facturée à la minute de conversation, et le tarif à la minute affiché en gros n'est presque jamais toute la facture. Selon le fournisseur, s'ajoutent la téléphonie (la ligne téléphonique), le STT, le LLM et le TTS, parfois groupés, parfois refacturés "au prix coûtant", parfois facturés en lignes séparées que vous assemblez vous-même.
Trois formes de tarification dominent :
- Tout compris à la minute (Bland, Retell, ElevenLabs Agents) : un tarif unique qui intègre déjà STT, LLM et TTS. Plus simple, avec en général un tarif affiché un peu plus élevé.
- Frais de plateforme plus refacturation (Vapi) : de minces frais d'orchestration à la minute, puis vous payez STT, LLM et TTS au prix coûtant. Le plancher le plus bas, avec le plus de pièces mobiles.
- Composant ou infrastructure (Twilio, Deepgram, OpenAI, Amazon Connect) : vous achetez une couche et câblez le reste vous-même.
| Fournisseur | Offre / palier | Tarif publié | Ce qui est inclus | Refacturé ou en supplément |
|---|---|---|---|---|
| Bland AI | Start (dev) | $0.14 / min | LLM, STT, TTS tous inclus, "no model pass-throughs" | Numéro entrant ~15 $/mois ; 0,05 $/min de transfert |
| Retell AI | Pay-as-you-go | $0.07-$0.31 / min (~$0.115 point médian) | Infrastructure vocale + LLM + TTS combinés | 10 $ de crédits offerts ; téléphonie ~0 $ si vous apportez la vôtre |
| Ringly | Paiement par conversation | 99 $/mois incluant 50 conversations ; puis 1,99 $/conversation | Support téléphonique IA relié à Shopify | Les appels où Seth aide avant le transfert sont facturables ; tarifs sur mesure à partir de 1 000+ appels/mois |
| Vapi | Build (à l'usage) | $0.05 / min frais de plateforme | Orchestration Vapi uniquement | STT/LLM/TTS au prix coûtant ; 10 $/ligne/mois au-delà de 10 |
| Deepgram | Voice Agent API (Standard) | $0.075 / min | Bundle Deepgram STT + LLM + TTS | LLM personnel 0,065 $/min ; Advanced 0,163 $/min |
| ElevenLabs Agents | Tarif de dépassement | $0.08 / min (burst $0.16) | TTS + orchestration + minutes du forfait | LLM facturé à part ; téléphonie à part |
| Twilio | ConversationRelay | $0.07 / min | Orchestration vocale IA uniquement | + PSTN $0.0085-$0.014/min + votre propre STT/LLM/TTS |
| Amazon Connect | Voix (à l'usage) | $0.038 / min vocale | Téléphonie de centre de contact + plateforme | Téléphonie + modules Amazon Q / Contact Lens |
| OpenAI Realtime | gpt-realtime-2.1 | $32 / 1M tokens audio en entrée, $64 / 1M en sortie | Le modèle uniquement | ~0,06-0,24 $/min en pratique ; pas de téléphonie |
Ringly est un autre type d'achat : un service axé Shopify facturé à la conversation, plutôt qu'une infrastructure vocale facturée à la minute. L'exemple ci-dessous s'applique aux plateformes à la minute.
Un exemple chiffré rend l'empilement concret. Imaginons 2 000 appels de support par mois d'une durée moyenne de 4 minutes. Sur une plateforme tout compris à environ 0,12 $/min, cela fait 8 000 minutes, soit environ 960 $ de coût de plateforme. Ajoutez une ligne de type Twilio à ~0,01 $/min et vous approchez 1 040 $, plus la location du numéro et les éventuelles minutes de transfert à chaud. Bon marché par appel, mais cela grimpe avec le volume, et les appels longs et confus (ceux qu'un cas limite crée) sont les plus chers.
Quelques pièges à intégrer avant de signer quoi que ce soit :
- La téléphonie est presque toujours facturée à part, même chez les fournisseurs "tout compris". C'est une vraie ligne à la minute plus 1 à 2 $ par numéro, et les tarifs internationaux sont bien plus élevés.
- "Au prix coûtant" ne veut pas dire gratuit. Le plancher de 0,05 $/min de Vapi est réel, mais STT plus LLM plus TTS au prix coûtant ajoutent facilement 0,05 à 0,10 $, ce qui vous replace dans la même fourchette que les fournisseurs tout compris.
- La conformité est une option. HIPAA et Zero Data Retention sont des paliers payants sur certaines plateformes ; un BAA est souvent réservé à l'offre Enterprise.
Si votre instinct après ce tableau est que le prix à la minute est imprévisible, c'est la lecture honnête. C'est l'une des raisons pour lesquelles les canaux écrits, où eesel utilise des forfaits mensuels de crédits avec un crédit par ticket ou chat client plutôt qu'à la minute de conversation, sont souvent plus faciles à prévoir. Notre analyse complète du coût d'un agent IA face à un agent humain détaille le calcul.
Trois plateformes vocales IA à comparer pour le support client
Les options ci-dessous couvrent différents besoins de déploiement. Testez chacune avec vos propres appels, vos systèmes connectés et vos exigences de transfert avant de choisir.
1. Bland AI : une pile vocale groupée
Bland AI réunit le modèle de langage, la reconnaissance vocale et la génération de parole dans sa plateforme vocale. C'est une option pour les équipes qui veulent ces composants chez un seul fournisseur. Vérifiez les frais de numéro de téléphone et de transfert en plus du tarif de plateforme.
2. Retell AI : une infrastructure vocale à l'usage
Retell AI propose une infrastructure vocale avec une tarification à l'usage. Comparez la configuration complète dont vous avez besoin, y compris le modèle, la voix et la téléphonie, plutôt que de traiter le tarif affiché le plus bas comme le coût de chaque appel.
3. Ringly : le support téléphonique IA pour les boutiques Shopify
Seth, de Ringly, est un système de réponse téléphonique IA conçu pour les boutiques Shopify. Il répond aux appels entrants, consulte les commandes et les produits, traite les questions courantes sur les retours et transfère les appelants à votre équipe en cas de besoin. Il convient aux équipes e-commerce qui veulent un agent vocal relié aux données de la boutique sans assembler leur propre pile de parole et de téléphonie.
Contrairement aux options d'infrastructure à la minute ci-dessus, Ringly facture à la conversation. Son tarif publié est de 99 $/mois pour les 50 premières conversations, puis 1,99 $ pour chaque conversation facturable supplémentaire. Les appels où Seth aide avant de transférer comptent quand même ; les spams, raccrochages, faux numéros et demandes immédiates d'un humain ne comptent pas. Vérifiez comment ces règles s'appliquent à votre répartition d'appels avant d'estimer la facture. Son orientation Shopify le rend moins adapté à d'autres secteurs ou aux appels sortants.
Ce que les gens disent vraiment quand ils appellent une IA
Les démos montrent toujours la même chose : un appelant demande "quels sont vos horaires" et une IA répond avec fluidité. La réalité est plus nuancée, et l'écart entre les deux est ce qu'il y a de plus utile à comprendre avant de déployer.
Quand ça marche, ça marche vraiment. Voici un vrai appelant qui décrit un appel de support hors des heures d'ouverture, pas un fournisseur :
"It was after hours, and a dreaded robot voice answered my call. I was fully prepared to spend the next 10 minutes rewording my issue... Surprisingly, this robot understood every single sentence I said... That's the most pleasant customer service call I have ever experienced. I don't mind talking to AI. In fact, instead of a live agent, I actually prefer to talk to your LLM, so my issue can be quickly triaged to the right human who actually understand my situation."
Remarquez ce qui a rendu cet appel bon : il a été orienté vers le bon humain. C'est le schéma. Voici maintenant le mode d'échec, d'un appelant tombé dans une impasse de déviation :
"One (recently) even told me, after wandering through the menu options, that they were going to text me a link to their app - and then hung up on me. I already tried the app, their system was broken - that's why I was trying to call and talk to a human!"
Et la formulation la plus incisive de la tension centrale, qui mérite d'être lue deux fois :
"The problem with the call center A.I. is that almost every time I need to call somewhere that uses them, I have some kind of edge case. They always give examples of how the automated agent can handle simple queries like 'what's my balance'... but I never need to call with something straightforward like that."
C'est tout le jeu en un commentaire. Les gens n'appellent pas pour le simple, ils appellent pour le cas limite, et un agent incapable d'admettre clairement "celui-ci est pour un humain" transforme un canal de support en mur.
Ce que tout le monde rate : la confiance avant la couverture
L'erreur que je vois les équipes commettre sans cesse est d'optimiser la quantité de réponses que l'agent vocal peut donner plutôt que sa capacité à savoir quand ne pas répondre. Pendant un appel en direct, une mauvaise réponse énoncée avec assurance est pire qu'un transfert rapide, car l'appelant agit en conséquence et vous ne l'apprenez que plus tard.
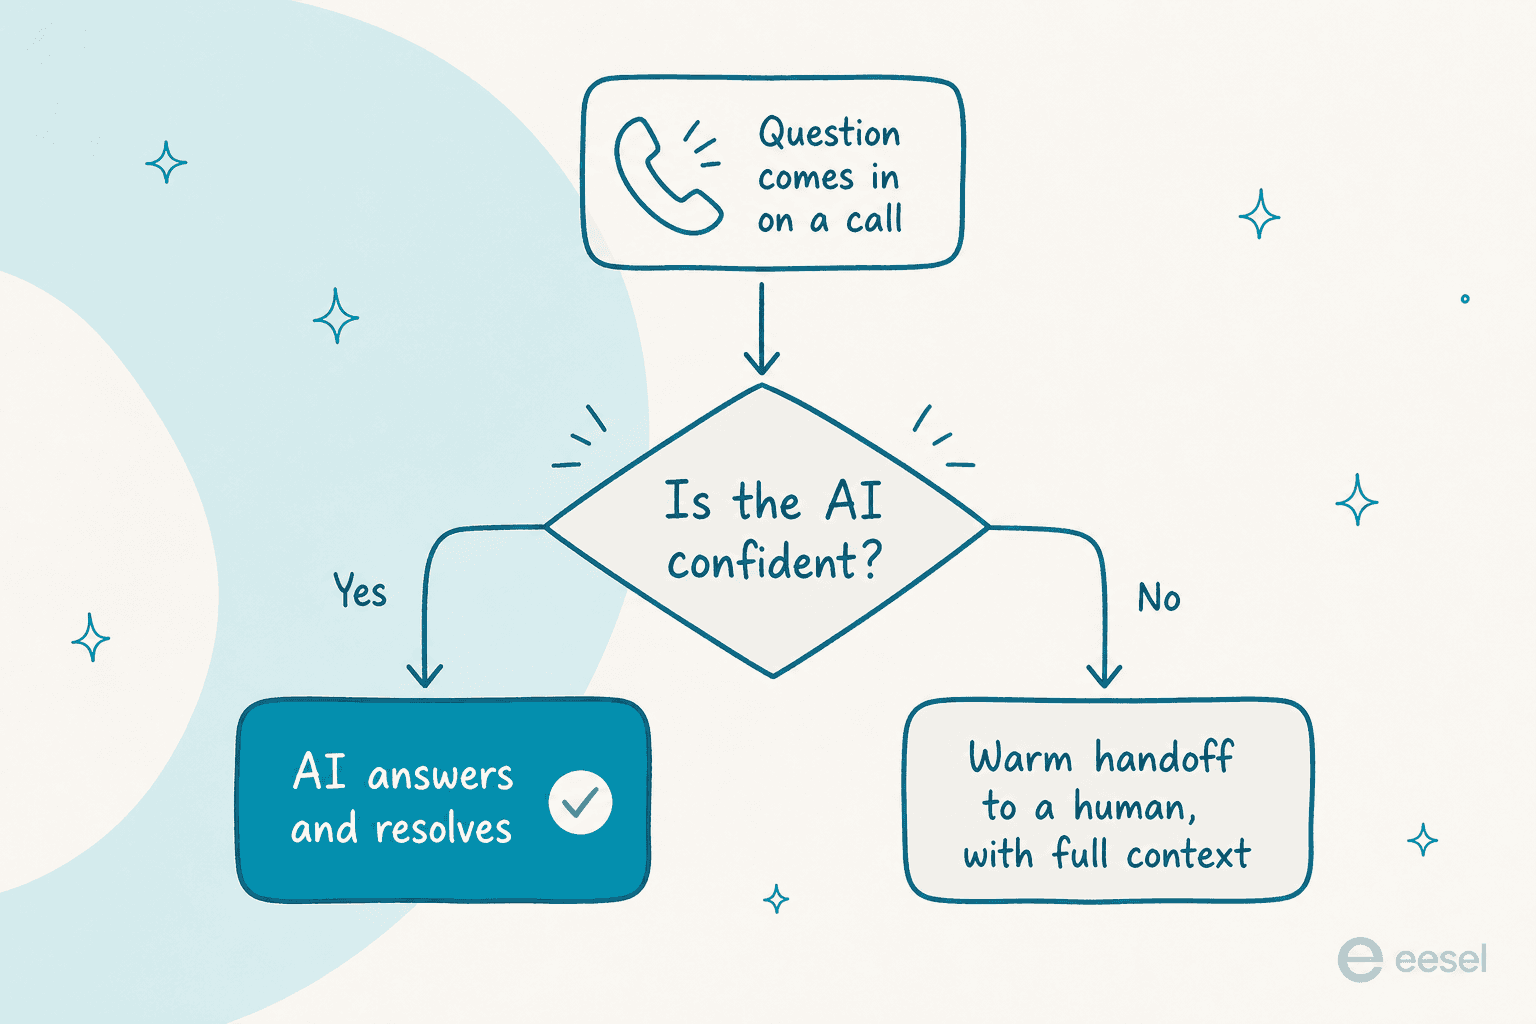
Ce n'est pas une idée propre à la voix, c'est la leçon de années passées à faire tourner de l'IA sur des files de support en direct, tous canaux confondus. L'un de nos clients, responsable CX d'une marque de compléments alimentaires en vente directe, l'a mieux dit que n'importe quelle présentation commerciale :
"The AI will never be able to answer 100% of the questions. I need an AI who is only handling the tickets that it's confident to handle, and all the other ones, leave them alone."
C'est le principe de conception. En pratique, cela signifie trois choses, que le canal soit la voix ou l'écrit :
- Fondez chaque réponse sur vos vraies connaissances, pour que l'agent puise dans votre centre d'aide et vos résolutions passées au lieu d'improviser. C'est ce qui l'empêche d'halluciner sur les questions de support.
- Conditionnez à la confiance, pour qu'il ne résolve que ce dont il est sûr et passe le reste à un humain avec tout le contexte, exactement le schéma du bon appel ci-dessus.
- Testez sur votre propre historique avant la mise en service, pas sur les scénarios de démonstration d'un fournisseur. Vous voulez savoir comment il aurait traité vos mille derniers vrais appels ou tickets, pas un "quels sont vos horaires" scripté.
Ce dernier point est celui que les équipes sautent et regrettent. C'est la différence entre espérer et savoir, et c'est pourquoi la simulation sur des tickets passés avant de toucher un seul client est devenue la règle de base côté écrit du support.
Où la voix IA s'intègre dans votre pile de support
Faut-il donc mettre un agent IA sur votre ligne téléphonique ? Mon avis honnête : la voix est un canal, et pour la plupart des équipes de support, ce n'est pas le plus gros. Le chat, l'e-mail et les tickets portent généralement bien plus de volume, et ils sont moins risqués à automatiser d'abord, car un agent écrit peut rédiger, attendre une relecture et transférer sans qu'un appelant attende en temps réel.
Une séquence raisonnable pour la plupart des équipes :
- Automatisez d'abord les canaux écrits, où les mêmes connaissances et le même filtrage par la confiance s'appliquent avec un mode d'échec bien plus doux. C'est là qu'un outil de service client IA se rentabilise le plus vite.
- Apprenez ce dont votre agent est vraiment sûr grâce aux données réelles, en vous guidant sur le taux de résolution et d'autres indicateurs.
- Étendez à la voix quand vous faites confiance à l'orientation des demandes, en réutilisant la même base de connaissances et la même logique de transfert déjà validées à l'écrit.
Les connaissances et la logique de confiance sont les parties réutilisables. La plomberie propre à la voix (téléphonie, latence, barge-in) est la couche supplémentaire que vous ajoutez par-dessus, et c'est un vrai projet, pas une case à cocher. Réussir d'abord la base écrite, c'est ce qui rend la couche vocale utile à ajouter plus tard.
Essayez eesel pour le côté écrit du support
eesel est un coéquipier IA pour helpdesk qui gère les canaux où se trouve réellement la majeure partie de votre volume : tickets, chat en direct et e-mail dans le helpdesk que vous utilisez déjà. Ce n'est pas un agent téléphonique ou vocal, et je préfère vous le dire clairement plutôt que d'en promettre trop. Ce qu'il fait bien, c'est la base que tout cet article vous invite à construire d'abord : il s'entraîne sur vos tickets passés et votre centre d'aide, conditionne ses réponses à la confiance pour ne répondre qu'à ce dont il est sûr, et vous laisse simuler sur votre vrai historique de tickets avant qu'il ne touche une conversation en direct, pour voir le taux de résolution avant de vous engager.

Il se branche sur Zendesk, Freshdesk, Gorgias, Front, Help Scout et Slack, et utilise des forfaits mensuels de crédits plutôt qu'une facturation à la minute, que vous pouvez vérifier sur la page tarifs. Faites d'abord bien résoudre les canaux écrits, et la couche vocale devient le prolongement de quelque chose en quoi vous avez déjà confiance, pas un saut dans le vide. Vous pouvez essayer eesel gratuitement, sans carte bancaire et sans appel commercial.
Comment empêcher un agent vocal IA de donner de mauvaises réponses pendant un appel ?