Was „Support über die Kommandozeile automatisieren“ wirklich bedeutet
Ich baue Produkt und KI-Agenten bei eesel, deshalb verbringe ich viel Zeit in Helpdesk-APIs und in den Terminals anderer Leute. Wenn ein entwicklerorientiertes Support-Team sagt „Ich will das über die Kommandozeile automatisieren“, meinen sie damit fast nie ein einziges magisches Binary, das support resolve #4821 eintippt und ein Ticket mit einer korrekten Antwort schließt. Dieses Tool existiert nicht, und das sollte man ehrlich vorab sagen.
Was sie tatsächlich wollen, ist eine Leiter der Autonomie: aufhören, sich durch eine UI zu klicken, und Skripte die Wiederholungsarbeit erledigen lassen – erst auf Abruf, dann nach Zeitplan, dann automatisch bei Ereignissen. Es ist derselbe Instinkt hinter Suchanfragen nach einer Customer-Support-CLI. Dieser Instinkt ist völlig richtig, und für die mechanische Hälfte des Supports zahlt er sich sofort aus. Die Falle ist die Annahme, dass das Terminal Ihnen auch die schwere Hälfte abnimmt, die eigentliche Antwort. Das tut es nicht, und nach Jahren, in denen ich KI-Agenten auf Live-Queues gesetzt habe, weiß ich genau, wo diese Grenze verläuft.
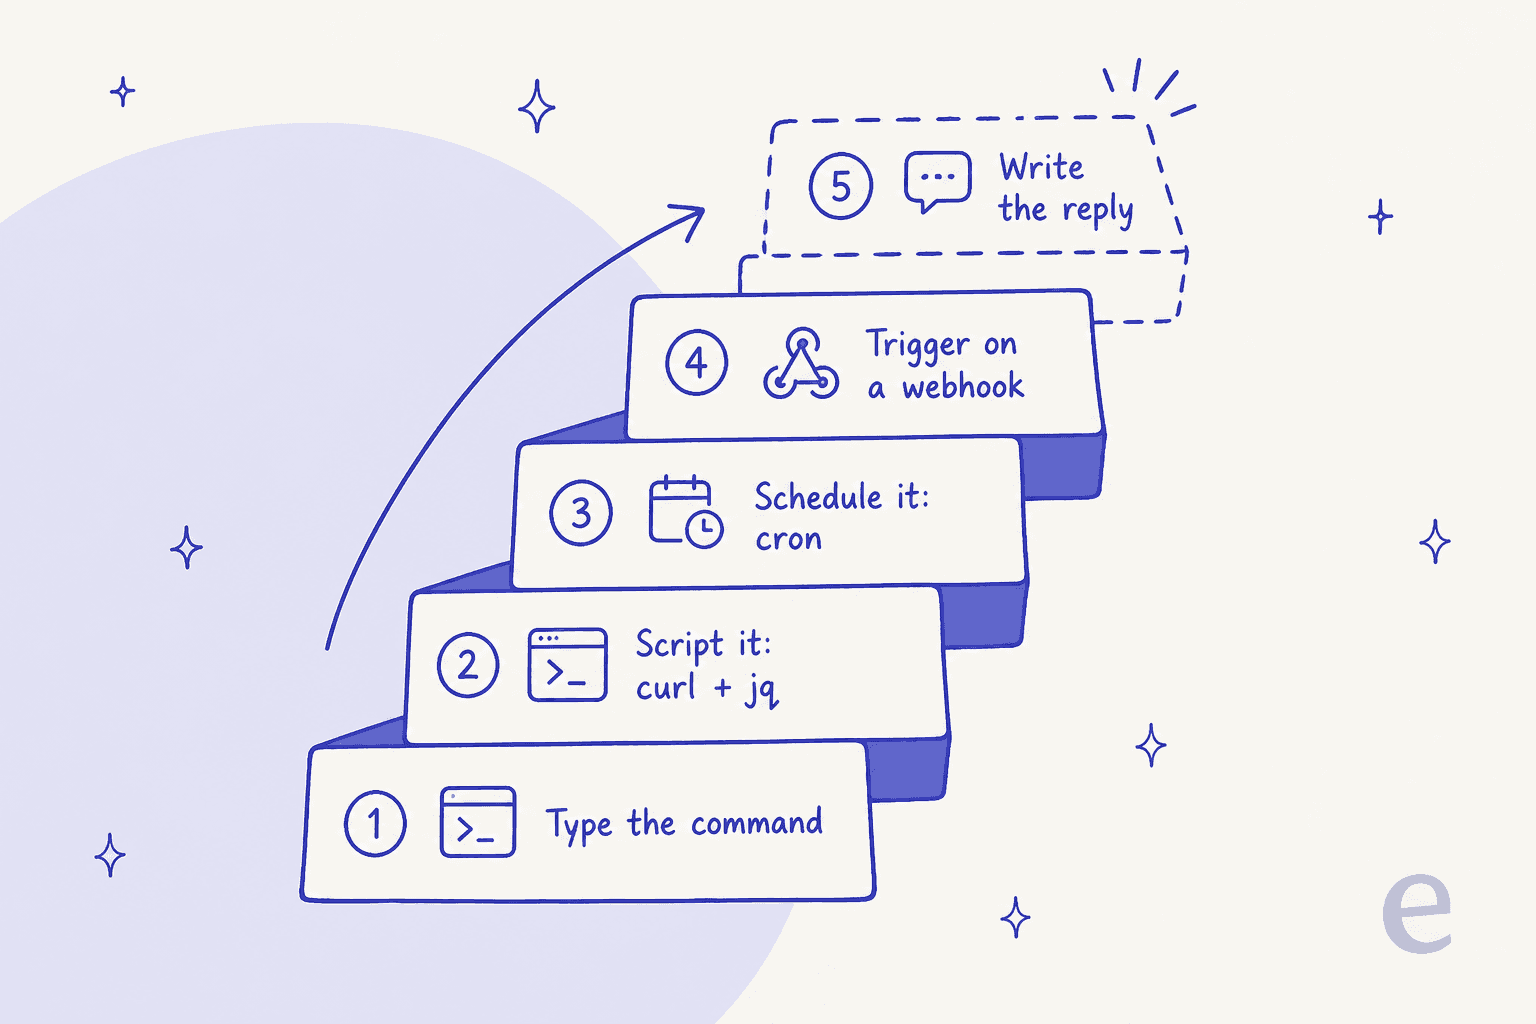
Jede Sprosse unterhalb der gestrichelten ist real, heute baubar, und der Rest dieses Beitrags klettert sie hoch.
Sprosse 1 und 2: die mechanische Arbeit skripten
Jeder große Helpdesk stellt eine REST-API bereit, sodass bash, curl und jq schon überraschend viel vom Tagesgeschäft steuern können. Hier verdient sich die Kommandozeile ihren Platz, denn sie macht aus einem Nachmittag Klicken eine einzige Schleife.
Massen-Triage und Routing. Jedes Ticket in einer Ansicht neu zuweisen, einen Tag über ein Segment hinweg hinzufügen oder die Priorität in einem Backlog anheben. Das ist derselbe Job wie Ticket-Routing-Automatisierung, nur gesteuert von einer Shell statt von einem Regel-Builder. Wenn Sie speziell Zendesk nutzen, überschneidet sich das stark mit Zendesk-Tickets automatisieren:
# Tag every unassigned ticket in a view, using the helpdesk REST API
curl -s -u "$AUTH" "$HELPDESK/api/v2/views/$VIEW/tickets.json" \
  | jq -r '.tickets[].id' \
  | while read -r id; do
      curl -s -u "$AUTH" -X PUT "$HELPDESK/api/v2/tickets/$id.json" \
        -H 'Content-Type: application/json' \
        -d '{"ticket":{"tags":["needs-review"]}}'
    done
Exporte und Analyse. Ziehen Sie einen Monat an Konversationen als JSON und leiten Sie sie in eine Tabelle, ein Notebook oder eine schnelle Wortfrequenz-Auswertung dessen, worüber Kunden sich tatsächlich beschweren. Diese Art von Ticket-Analyse ist vom Terminal aus weit einfacher als jeder Reporting-Tab.
Knowledge-Sync. Spielen Sie Ihr Help Center, Ihre Makros oder Docs in eine Knowledge Base ein, damit Antworten aktuell bleiben. Das ist das Bindegewebe hinter jedem echten KI-Helpdesk-Workflow, egal ob Sie Freshdesk, Gorgias oder Help Scout nutzen, und die Freshdesk-Knowledge-Base-API ist ein gutes Beispiel dafür, was diese Endpunkte offenlegen.
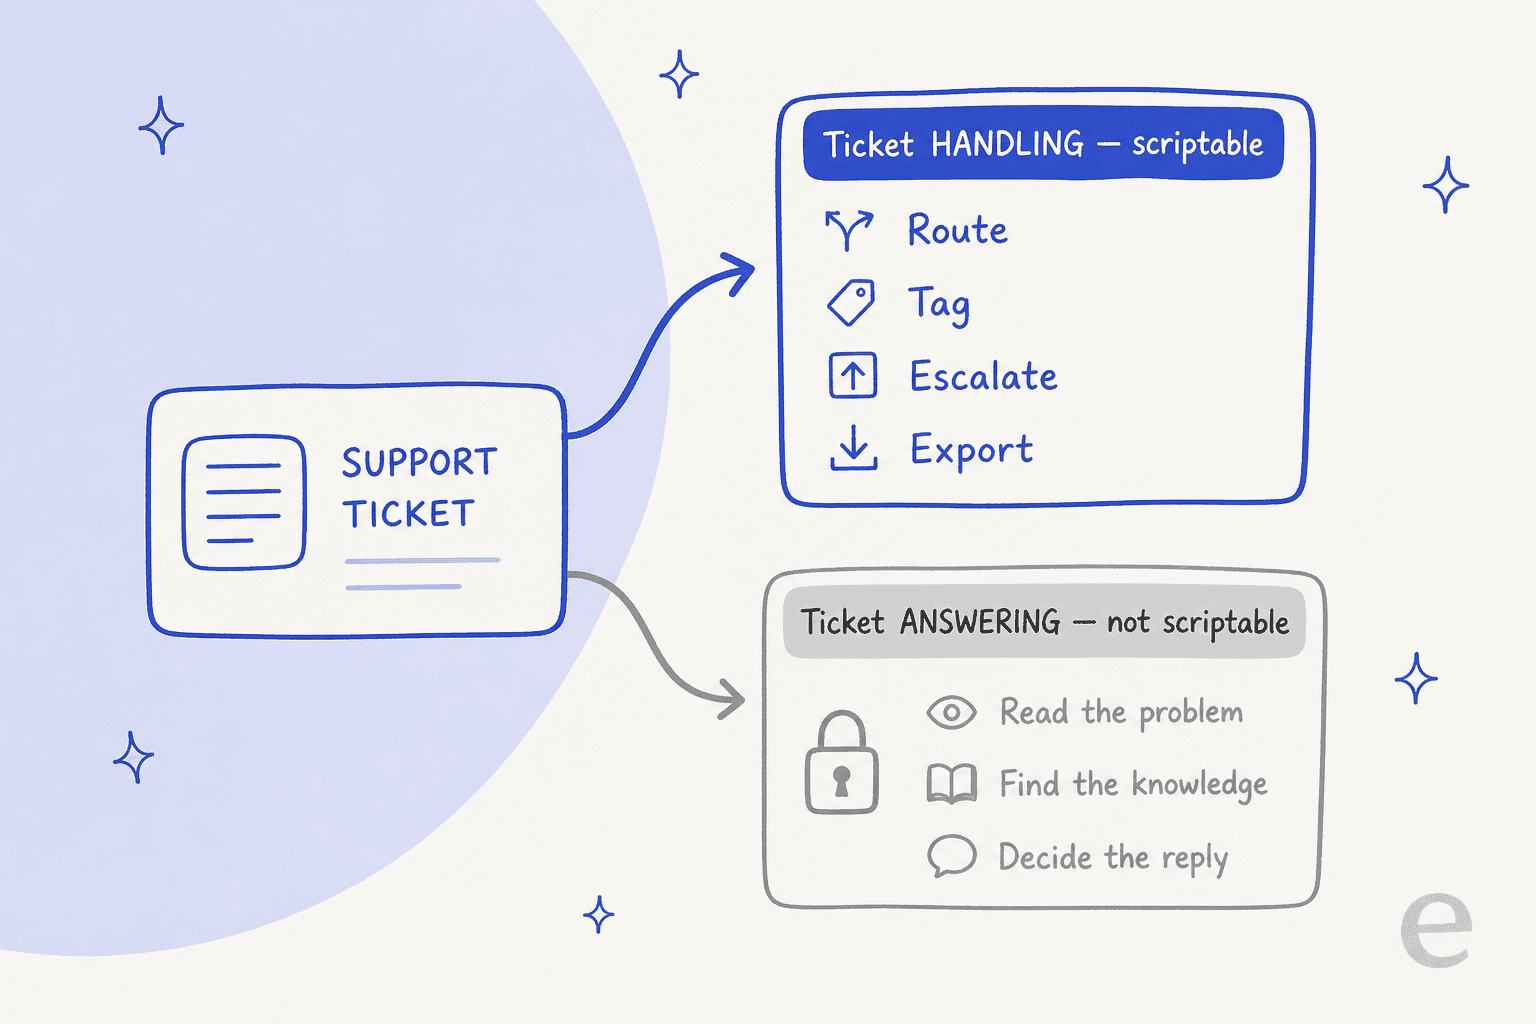
Alles hier ist skriptbar, wiederholbar und überprüfbar. Der Haken ist, dass all das nur Daten bewegt. Nichts davon entscheidet, was Sie sagen.
Sprosse 3: mit cron planen
Sobald ein Skript existiert, verpacken Sie es in eine cron-Zeile, und es läuft von selbst. Das ist die erste Sprosse, auf der Support unbeaufsichtigt läuft – kein Mensch löst irgendetwas aus.
# Every night at 2am, run the stale-ticket sweep and log the result
0 2 * * * /opt/support/close-stale.sh >> /var/log/support-cron.log 2>&1
Ein nächtlicher Job, der veraltete Tickets schließt, ein wöchentlicher Export, ein stündlicher Knowledge-Sync, eine SLA-Prüfung, die Slack anpingt, wenn ein Ticket kurz vor der Verletzung steht – keines davon braucht einen Menschen im Loop. Das ist das Muster hinter den meisten leichtgewichtigen Support-Ticket-Automatisierungen: Sie brauchen keine Plattform, Sie brauchen ein Skript und einen Zeitplan. Wenn Sie einen konkreten SLA-Blickwinkel wollen, überträgt sich dieselbe Idee sauber auf einen SLA-Management-Workflow.
Hier ist ein kleines, aber nützliches Beispiel, ein SLA-Breach-Alert, der alle 15 Minuten läuft:
# Alert on tickets within 30 min of an SLA breach (cron: */15 * * * *)
curl -s -u "$AUTH" "$HELPDESK/api/v2/search.json?query=type:ticket+status<solved" \
  | jq -r '.results[] | select(.sla_minutes_left < 30) | .id' \
  | while read -r id; do
      curl -s -X POST "$SLACK_WEBHOOK" \
        -d "{\"text\":\"Ticket $id is about to breach SLA\"}"
    done
Das ist echte Automatisierung. Sie liest Status, wendet eine Regel an und führt eine Aktion aus, alles ohne Sie. Sie beantwortet trotzdem nichts.
Sprosse 4: per Webhook auslösen
Cron läuft nach der Uhr. Die oberste skriptbare Sprosse läuft bei Ereignissen. Statt alle 15 Minuten zu pollen, registrieren Sie einen Webhook, sodass Ihr Helpdesk in dem Moment, in dem ein Ticket erstellt, getaggt oder aktualisiert wird, einen POST an Ihren Endpunkt sendet, und Ihr Skript in Echtzeit reagiert.
So kommen Sie von automatisiertem Tagging, das nach Zeitplan läuft, zu Tagging, das in dem Moment auslöst, in dem ein Ticket eintrifft – und das ist die Einstiegsrampe zu echter Ticket-Klassifizierung. Ein winziger Handler reicht:
# Minimal webhook handler: classify and route a new ticket on arrival
# (Ticket payload arrives as JSON on POST from the helpdesk)
read -r payload
id=$(echo "$payload" | jq -r '.ticket.id')
subject=$(echo "$payload" | jq -r '.ticket.subject')
case "$subject" in
  *refund*|*charge*) queue="billing" ;;
  *bug*|*error*)     queue="engineering" ;;
  *)                 queue="general" ;;
esac
curl -s -u "$AUTH" -X PUT "$HELPDESK/api/v2/tickets/$id.json" \
  -d "{\"ticket\":{\"group_id\":\"$queue\"}}"
Keyword-Routing wie dieses ist regelbasiert, nicht KI, und das ist völlig in Ordnung, viel Routing ist tatsächlich nur Keyword-Matching. Aber beachten Sie, was passiert, wenn Sie das weitertreiben: Je mehr Sie wollen, dass der Handler das Ticket versteht, statt nur seine Betreffzeile per Mustererkennung abzugleichen, desto mehr haben Sie leise die Domäne der case-Anweisungen verlassen und die Domäne eines echten KI-Systems betreten.
Die Sprosse, die Sie nicht skripten können: die Antwort
Hier ist die ehrliche Grenze. Sie können das Ticket skripten, aber Sie können nicht die Antwort skripten. In dem Moment, in dem eine Aufgabe verlangt, das Problem eines Kunden zu lesen, das richtige Wissen zu finden und sich für eine Antwort zu entscheiden, gehen curl und jq nicht mehr weiter, und Sie bauen ein KI-System, keine bash-Funktion.
Fragen Sie jeden, der tatsächlich einen gebaut hat. Allein das Retrieval ist ein vollständiger Stack, kein einzelner Suchaufruf:
"So few developers realize that you need more than just vector search for RAG, so I still spend many of my talks emphasizing the FULL retrieval stack for RAG."

Und in dem Moment, in dem das Modell bei einem Ticket sowohl entscheiden als auch handeln kann, haben Sie sich ein Kontrollproblem eingehandelt, das eine cron-Zeile nicht löst:
"The failure mode I keep seeing isn't hallucination per se... it's blurred responsibility between intent and execution. Once a model can both decide and act, you've already lost determinism."
Die eigentlichen Kosten eines automatisierten Support-Agenten liegen also nicht im Endpunkt. Sie liegen in Knowledge-Sync und Retrieval, Konversationsstatus über mehrere Turns hinweg, Tool-Aktionen gegen den Helpdesk, Eskalationsregeln, Guardrails und einer Möglichkeit, das Ganze zu testen. Das ist derselbe Eisberg, auf den jedes Team trifft, das ein Headless-Support-Setup baut: die Spitze, Ihr Terminal und Ihr Kanal, war nie der schwere Teil. Der Körper darunter ist es, und genau das muss eine KI-Helpdesk-API tragen.
Testen Sie die Automatisierung, bevor sie ein Live-Ticket beantwortet
Wenn es eine Angewohnheit aus der Softwareentwicklung gibt, die sich zu klauen lohnt, dann diese – und es ist der Schritt, den geskriptete Setups überspringen. Sie würden nie Code ohne Tests ausliefern. Eine Automatisierung, die mit Ihren Kunden spricht, verdient denselben Maßstab, und der Terminal-Instinkt „mach es reproduzierbar“ ist genau das, was Testen möglich macht.
Das Problem ist, dass die meisten Teams einen Agenten einfach einschalten und hoffen. Die Support-Community kreist immer wieder um dieselbe Sorge:
"How do you test that an AI agent won't do something catastrophic? Do people actually red-team their agents before they go live?"

Sie haben die Test-Suite bereits: Ihre Ticket-Historie. Der Schachzug ist, Tausende Ihrer echten vergangenen Tickets gegen den Agenten laufen zu lassen und zu sehen, was er gesagt hätte, wo er eskaliert hätte und wo er still geblieben wäre – alles, bevor auch nur ein Kunde involviert ist. Genau das macht eesels Simulation, und sie macht aus „live gehen und hoffen“ ein „live gehen mit Zahlen“. Es ist das Nächste, was der Support zu pytest hat, und deshalb simuliere ich jeden Rollout zuerst gegen historische Tickets.
Was es kostet, die Antwort zu automatisieren
Bei den Kosten trifft der Selbstbau-Instinkt auf die Realität, und die beiden Wege rechnen auf sehr unterschiedliche Weise ab.
Wenn Sie einen Agenten auf einer rohen Modell-API skripten, zahlen Sie pro Token bei jeder Nachricht, jedem Retry, jedem abgerufenen Chunk, egal ob das Ticket am Ende gelöst wird oder nicht. Ein Team in unserem Dossier verbrannte an einem einzigen Testtag 200 API-Aufrufe und wurde bei den erwarteten 9.000 Interaktionen im Monat nervös wegen der Rechnung. Das, bevor Sie die Engineering-Zeit einrechnen, um Retrieval, Status, Guardrails und Evals zu bauen und zu pflegen.
So schneiden die Terminal-first-Optionen tatsächlich im Vergleich ab:
| Ansatz | Autonomie-Level | Sie pflegen | Abrechnungsform | Am besten für |
|---|---|---|---|---|
| curl + jq-Skripte | Auf Abruf | Jedes Skript | Im Plan enthalten | Massenbearbeitungen, Exporte, Routing |
| Cron-Jobs | Geplant, unbeaufsichtigt | Skripte + Zeitplan | Im Plan enthalten | Nächtliche Sweeps, Syncs, SLA-Alerts |
| Webhook-Handler | Ereignisgesteuert | Endpunkt + Skripte | Im Plan enthalten | Echtzeit-Routing und -Tagging |
| Modell-API + MCP | Autonom, DIY | Der gesamte KI-Stack | Pro Token, gelöst oder nicht | Volle Kontrolle, wenn Sie das Team haben |
| Fertiger Teamkollege | Autonom, verwaltet | Nichts | Pro gelöstem Ticket (~0,40 $) | Gelöste Tickets, ohne die Engine zu bauen |
Die unterste Zeile lohnt einen zweiten Blick, wenn Ihr Ziel gelöste Tickets sind statt ein Wartungsprojekt. Sie bekommen weiterhin eine programmierbare Oberfläche, gegen die Sie mit curl und cron skripten können, Sie bauen nur die Resolution-Intelligenz darunter nicht neu.
Die Antwort mit eesel automatisieren
Wenn Sie hierher gekommen sind, weil Sie Kundensupport über die Kommandozeile automatisieren wollten, sind Sie die Art von Team, die eine programmierbare Oberfläche will, kein zugesperrtes Dashboard. Genau für diesen Mittelweg ist eesel gebaut.
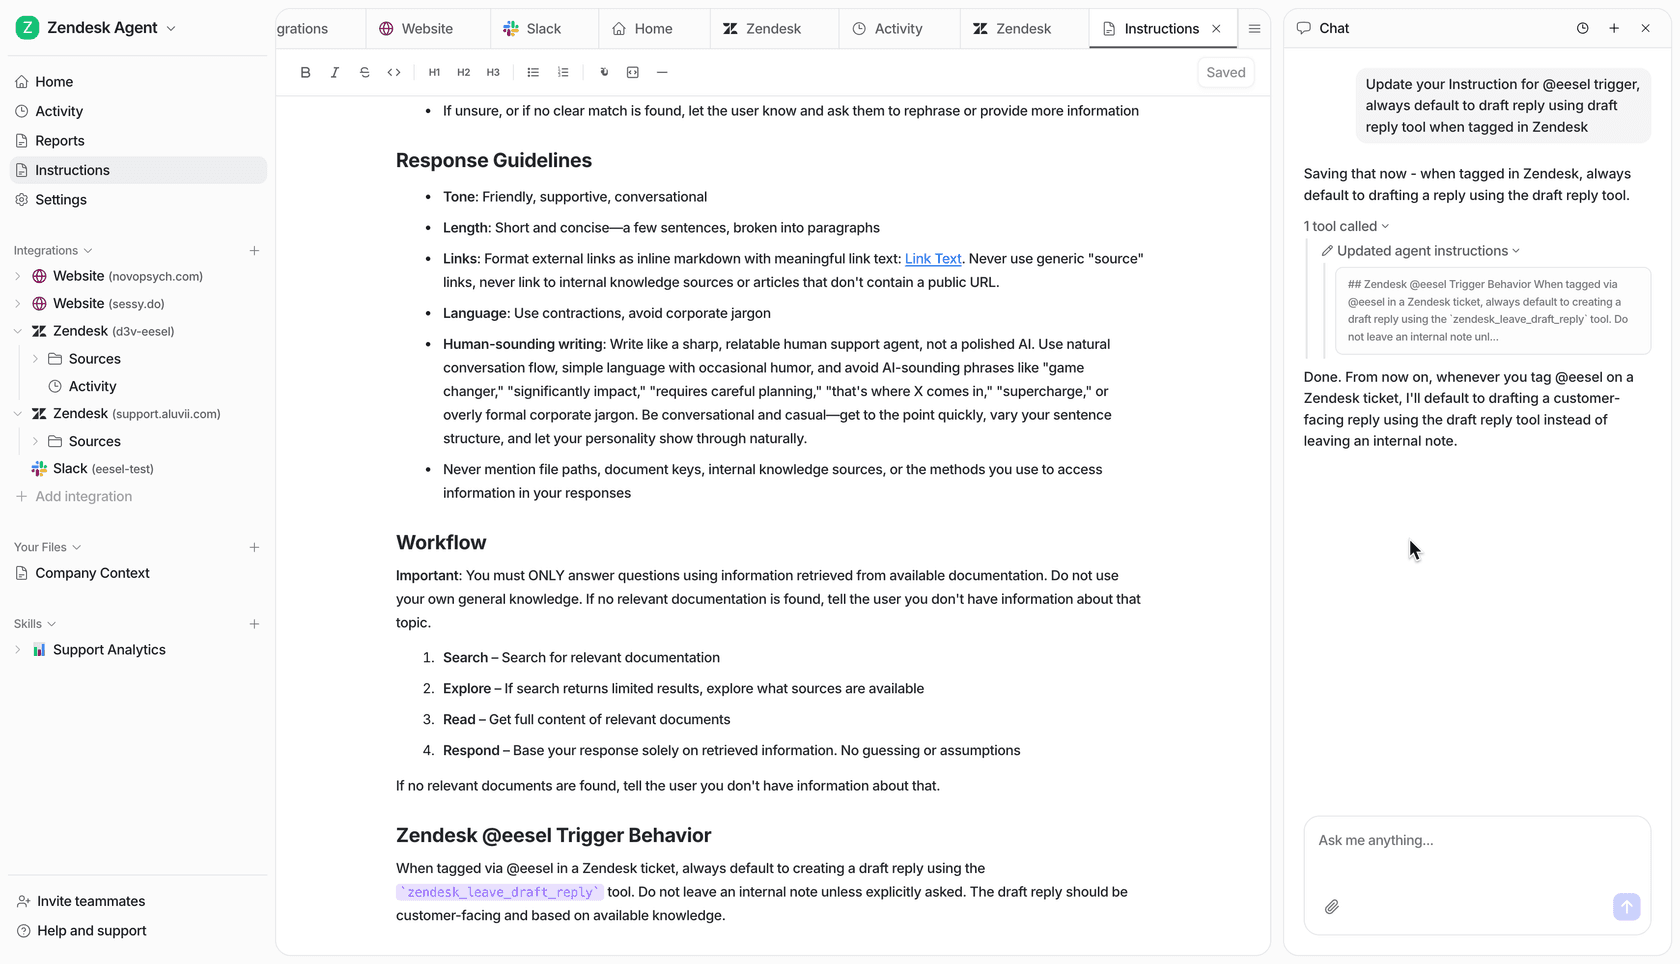
eesel ist ein KI-Teamkollege, der sich in den Helpdesk einklinkt, den Sie bereits nutzen – Zendesk, Freshdesk, Gorgias, Front, Help Scout –, und er kommt schon mit dem Wissen an, wie er Ihr Wissen synchronisiert, Bestellungen nachschlägt, Tickets taggt und Antworten entwirft oder sendet. Er liefert die gesamte Resolution-Engine, sodass Sie Retrieval, Status und Guardrails nicht von Grund auf neu bauen, und er behält die programmierbare Oberfläche, wegen der Sie hergekommen sind: eine API für Aktionen, Webhooks und Custom Skills, die Sie von einer Shell aus steuern können. Und dann der Teil, der am meisten zählt: Er simuliert an vergangenen Tickets, bevor er live geht, sodass Sie mit Zahlen statt mit Hoffnung deployen. Er ist kostenlos zum Testen, ohne Kreditkarte und ohne Sales-Call, und die Abrechnung erfolgt pro gelöstem Ticket statt pro Token oder Sitz.
Behalten Sie Ihre curl- und cron-Jobs für die Ticket-Bearbeitung, in der sie großartig sind. Lassen Sie einen Teamkollegen die eine Sprosse übernehmen, die die Kommandozeile nicht erreicht.
Häufig gestellte Fragen
Wie automatisiere ich Kundensupport über die Kommandozeile?
Welche Support-Aufgaben kann ich vom Terminal aus wirklich skripten?
Kann ich geplante Support-Automatisierungen mit cron ausführen?
Wie unterscheidet sich webhook-gesteuerte Automatisierung von cron?
Kann ein Skript ein Ticket wirklich lösen und nicht nur verschieben?
Wie teste ich eine Support-Automatisierung, bevor sie live geht?
Wie viel kostet automatisierter KI-Support im Vergleich zum Selbst-Skripten?


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.