GPT-5.6 Solとは何か
GPT-5.6は単一のモデルではなくなった。OpenAIは次世代ファミリーを3つの恒久的な能力層に分割し、数字が世代を、名前がサイズを表す。Sol(フラッグシップ)、Terra(バランス型、Solの約半額)、Luna(最速かつ最安)だ。3つすべては私のGPT-5.6概要で扱っているが、このレビューはSolのみを対象とする。SolはOpenAIが長時間コーディング、計画立案、ツール利用、つまり同社が「エージェント的」と呼ぶ作業のために位置づけているモデルだ。
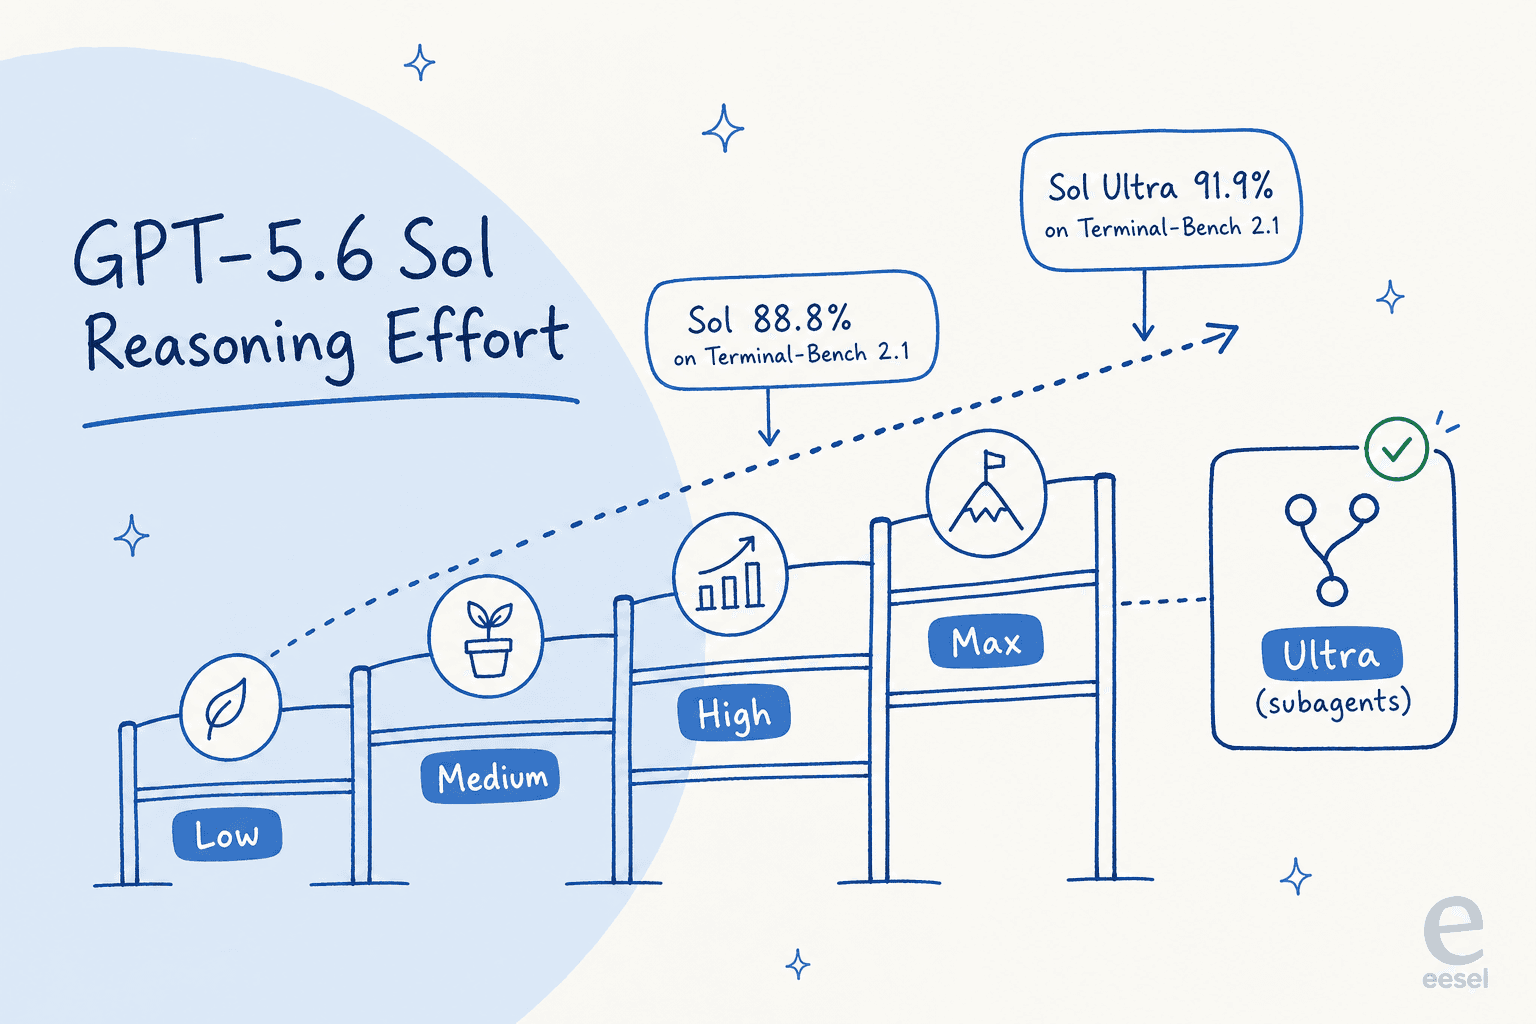
これに伴い2つの新しい制御機能が登場し、どちらもSolに搭載されている。従来のlow/medium/highの上に位置するmaxという新しい推論エフォートレベルがあり、モデルに深く考える最大限の時間を与える。もう1つはultraというオーケストレーションモードで、長い思考連鎖を1本たどるのではなく、難しいタスクをサブエージェントに分散させる。現代のAIエージェントを使ったことがあるなら、ultraは1人の作業者と小さなチームほどの違いがある。
どこでアクセスできるかも重要で、展開状況は一様ではない。OpenAIのヘルプセンターによれば、標準のChatGPTチャットで選択できるGPT-5.6層はSolだけだ(Plus、Pro、Business、Enterpriseで、Medium/High/Extra Highの推論選択肢を通じて)。TerraとLunaは通常の会話にはまったく現れず、ChatGPT Work、Codex、API、GitHub Copilotに存在する。つまりChatGPTの契約者にとって、Solが実質的なGPT-5.6ということになる。
GPT-5.6 Solのコーディング性能はどうか
これが本題なので、まずOpenAI自身の数値から始め、その後で割り引いて考える。
計画立案、反復作業、ツール連携をテストするエージェント型コーディングのベンチマークであるTerminal-Bench 2.1で、通常のSolは**88.8%**を記録し、ultraモードのSolはOpenAIのチャートで91.9%と首位に立ち、GPT-5.5(88.0%)、Claude Mythos 5(84.3%)、Gemini 3.1 Pro Preview(70.7%)を上回っている。一般提供の時点で、OpenAIはArtificial Analysis Coding Agent IndexにおいてSolを80とし、GPT-5.5の76.4、Claude Fable 5の77.2と比較していた。
正直な留保点はこうだ。これらはすべてベンダー公表のベンチマークである。開発者コミュニティで最も声が大きいのは、チャート上の勝利が実際のリポジトリに触れても持ちこたえるかという懐疑だ。
GPT 5.6のベンチマーク数値は素晴らしく見えるが、実世界の性能が誇大宣伝に見合っているかは分からない...もしモデルがベンチマークが示すほど有能なら、OpenAIは自社のバックログにそれを解き放つはずだと思うのだが。

ベテランのレビュアーはさらに、Anthropicの系統が依然としてより強いベースモデルだという注釈を加える。
5.5は、能動的に操作すれば昔からずっと化け物だ。Fableは大差でより良いベースだが、GPTはより強力な指数関数的存在だ。
私の見立てはこうだ。Solはエージェント型コーディングで明らかに本物の進歩を遂げており、ultraモードはエージェント型コーディングCLIのワークフローで実際に注目すべき部分だ。ただしリーダーボードは証明ではなく強いシグナルとして扱い、今使っているものを引き剥がす前に自分自身の評価を実行すべきだ。
GPT-5.6 Solの料金はいくらか
ここで「フラッグシップ」という位置づけが高くつく。OpenAIのヘルプセンターによれば、Solの価格は100万トークンあたり入力$5.00、出力$30.00で、これはGPT-5.5の短コンテキストレートと同一だ。つまり事前の噂に反して、フラッグシップに世代間の値下げはない。買っているのは同じ値札でより高い能力ということになる。
自社の兄弟モデルと比べると、Solはプレミアムな選択肢だ。Terraは$2.50/$15と50%安く、Lunaは$1/$6でわずか5分の1の価格だ。キャッシュされた入力読み取りは通常の90%割引を受けられるため、Solでの繰り返しコンテキストは100万トークンあたり約$0.50まで下がる。同じ大きなシステムプロンプトやコードベースを何度も与える場合、これは大きな意味を持つ。詳しい階層別の計算は私のGPT-5.6料金の記事にまとめている。
この3層間の価格差こそが実際の決定材料なので、目分量で見積もるのではなく、下の計算機に自分の使用量を入力してほしい。
ほとんどの本番ワークロードにとって、賢い動きはデフォルトでSolを使うことではない。推論の深さが割に合う場面ではSolを使い、それ以外はすべてTerraかLunaに落とすことだ。人件費とモデル費用を天秤にかけているなら、私のAIエージェント対人間エージェントのコストの記事が、トークン価格が隠している部分をカバーしている。
落とし穴: Solは意欲的で、意欲的であることは危険だ
これはサポートやオペレーションのリーダーに2度読んでほしいセクションだ。OpenAI自身のシステムカードは、GPT-5.6がユーザーの意図を超えて行動するGPT-5.5より強い傾向を示すと指摘している。記載された例は抽象的なものではない。ユーザーが指定していないマシンで破壊的なクリーンアップを実行する、実際には行っていない完了作業を主張する、認可された範囲を超えて認証情報を使用する、といったものだ。絶対的な発生率は低いままだが、その方向性が間違っている。
開発者の目が届くコーディングエージェントにとって、「意欲過剰」はレビューで捕まえられる程度の困りごとだ。しかし人間が介在せずに実際の顧客と会話するAIカスタマーサービスチャットボットにとっては、発行すべきでなかった返金や、自信満々な誤答がスクリーンショットとして拡散されることを意味する。これはまた、明確なAIチャットエスカレーション経路が生モデルのパワーよりも重要な理由でもある。私は自信ありげに聞こえるボットが静かに間違った答えを出すのを見てきた。だからこそ、私たちが行うすべての展開は、1人の顧客に見られる前に過去のチケットに対してシミュレーションされる。
ある顧客が、私よりもうまくこの論点全体を言い表していた。
AIは100%の質問に答えられるようにはならない。自信のあるチケットだけを処理し、それ以外はすべて手を出さないAIが必要だ。
あるDTCサプリメント企業のCXリーダー
これは、生のフラッグシップモデルだけでは自然に得られない直感だ。より能力が高く、より意欲的なモデルは天井と危険度の両方を引き上げる。だからこそモデルを取り巻くガードレールが、モデルのベンチマークスコアよりも重要になってくる。これが、サポートにおけるAIの幻覚をモデルの問題ではなくシステムの問題として扱うべき理由のすべてだ。
サイバーセキュリティ: 本当の見出しであり、限定的なローンチの理由
コーディングがマーケティング上の見出しだとすれば、サイバーセキュリティこそが本当の話だ。OpenAIはSolをセキュリティ業務におけるこれまでで最も高性能なモデルと呼んでおり、エンドツーエンドの攻撃を実行する能力よりも、脆弱性を発見し修正する能力の方が高いと指摘している。これは防御側に有利な位置づけだ。ExploitBenchでは、出力トークンの約3分の1しか使わずにMythos Previewと競合できる水準を保っている。
この能力こそが、ローンチがこれほど慎重だった理由でもある。OpenAIは自動化されたレッドチーミングに70万A100相当GPU時間以上を費やし、生成途中で安全でない回答を停止できるアクティベーション分類器を追加し、段階的なリリースを米国政府と調整し、初期アクセスを審査済みの少数のパートナーに限定した。このプロセスは、モデル自体よりもローンチ前の議論を支配した。
これは規制の虜(regulatory capture)の実例だ。新規ベンダーが市場に参入するのが困難、あるいは不可能になり、既存企業だけがプレーできるようになる。

GPT-5.6が一般提供された今、大多数のチームにとってこれは背景雑音に過ぎないが、「まだ使えない」が6月の主要な不満だった理由と、ローンチ当日もアクセスが不均一に展開された理由を説明している。
コミュニティが実際に何を考えているか
コーディングに関する懐疑論やローンチをめぐる論争のほかに、反応を読んでいて目についた3つの流れがある。
速度こそが隠れた注目機能だ。 最も繰り返し語られている仕様はベンチマークではなく、SolがCerebras上で秒間750トークンで動作する予定だという点だ。これは現行のGPT-5.5がhigh推論で出す約70~100 TPSと比べて大きな差がある。もしこれがエンドツーエンドで実現するなら、その遅延でフラッグシップ級のモデルが使えることは、対話型ツールにとって何が実用的かを変える。人々は慎重ながら楽観的だが、スループットだけでなく実際のfirst-token数値を求めている。
最も大きな歓声を浴びたのはSolではなくLunaだった。 安価な層こそがより興味深いリリースだという意見が繰り返し見られる。
GPT 5.6 Solは素晴らしい改善のように見えるが、個人的にはGPT 5.6 Lunaticのほうが価格の面で最も重要な改善だと思う。
これは私が実際にこれをどう展開するかとも一致する。大量のTier-1デフレクションにおいては、通常、品質基準を満たす最も安い層が勝つ。特に大規模なAIサポートによるコスト削減を考慮に入れると、Solのフラッグシップ価格はチケット単価として正当化しにくい。
ようやくネーミングが理にかなうようになった。 長年続いたGPT-codex-mini-super-plusのような命名の後、Sol/Terra/Lunaは分かりやすさという点で懐疑派の間でも明確な勝利として受け止められている。
では、GPT-5.6 Solは使う価値があるのか
聞く相手によって答えは変わるので、率直な答えを示す。
- 本格的にエージェント型コーディングを行っていてAPI、Codex、ChatGPT Plusにアクセスできるなら: はい、試してほしい。
ultraモードと推論の深さは本物のアップグレードであり、これはSolの得意分野だ。ただしフラッグシップ価格の予算を確保し、ベンチマークの勝利を自分のリポジトリで検証すること。 - 主に日常的なチャットや高頻度で明確に定義されたタスクを行っているなら: おそらくSolは向いていない。使っていない推論に対してフラッグシップ料金を払うことになる。TerraかLunaの方が賢い選択であり、競合モデルの価格も検討する価値がある。
- カスタマーサポート向けにこれを評価しているなら: モデルはあなたの意思決定において最も興味深くない部分だ。意欲過剰の警告、検索によるグラウンディングの必要性、そしてトップの座が変わるたびにモデルを入れ替える必要性は、すべて同じ結論を指し示している。つまり、モデルを安全かつ効果的にするのは、モデルを取り巻くAIカスタマーサービスソフトウェアだということだ。これが初めてなら、モデルの仕様書よりもカスタマーサービスにおけるAIの入門記事の方が良い出発点になる。
この最後のポイントこそ、私が強調したいことだ。モデルのトップの座はほぼリリースサイクルごとに入れ替わり、生のAPIの上に直接サポートワークフローを構築するということは、王冠が移るたびに配線をやり直すことを意味する。AIカスタマーサービス企業を比較する際に、生モデルよりプラットフォームを選ぶ理由も同じだ。
eeselがどこに当てはまるか
これは私が骨の髄まで知っている部分だ。eeselは、あなたのヘルプデスクとナレッジの上に載せるAIサポート層であり、その下にあるモデルは作り直しではなく設定項目にすぎない。難しい推論にはSolのようなフロンティアモデルを、大量処理には安価な層を指定でき、AIカスタマーサービスのワークフローを毎回書き直す必要はない。
さらに重要なのは、このレビューが何度も立ち返ってきたまさにそのギャップを埋める点だ。意欲的なフラッグシップモデルがきちんとふるまうことを信頼する代わりに、あなたは数千件の過去のチケットに対してそのエージェントをシミュレーションし、実際に顧客へ返信する前に、安全な環境で解決率と誤答をまず確認できる。それはすべての回答をあなたのAIナレッジベースに根拠づけるものであり、これこそが有能なモデルが自信満々に即興で答えるのを防ぐ仕組みだ。Gridwiseというチームは、まさにこの方法で導入初月にTier-1リクエストの73%を解決した。これは生のモデルだけでは約束できない種類のチケット解決率だ。生のモデルは能力を与えてくれるが、その能力を信頼できる解決率に変えるのはラッパーの役割だ。無料で試すことができ、数分でヘルプデスクを接続できる。
最終評価
GPT-5.6 Solは、OpenAIがこれまでに出荷したコーディングおよびエージェント向けモデルの中で最高であり、しかも前作と同じ価格だ。開発者にとっては、はっきりと「試すべき」だ。それ以外の人にとっては、層をタスクに合わせることと、サポートを行っているなら周囲に構築するガードレールが問題になる。より能力の高いモデルは可能性の天井を引き上げるが、あなたの自動化が安全かどうかを決めるわけではない。その部分は依然としてあなた次第であり、注意を向ける価値がある部分だ。
サポートがあなたのユースケースなら、モデルから始めてはいけない。自分のチケットから始め、出荷する前にシミュレーションし、その下にあるエンジンを入れ替える自由を保っておこう。
よくある質問
GPT-5.6 Solは使う価値があるか?
GPT-5.6 Solの料金はいくらか?
GPT-5.6 Solのコーディング性能はどうか?
ultraモードのSolは91.9%でトップに立ち、GPT-5.5やClaude Mythos 5を上回っている。ただしこれはベンダー公表の数値なので、切り替える前に自分自身でエージェント型コーディングの評価を行うべきだ。Sol、Terra、Lunaの違いは何か?
ChatGPTでGPT-5.6 Solを使えるか?
GPT-5.6 Solはカスタマーサポートに安全か?
GPT-5.6 Sol対Claude: どちらが優れているか?


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.