

GPT-5.6 Sol Ultra est la partie qui fait le plus parler d'elle dans la nouvelle famille GPT-5.6 d'OpenAI : ce n'est pas un nouveau modèle, c'est le mode d'orchestration ultra de Sol, le niveau phare. Plutôt que de réfléchir via une seule longue chaîne de raisonnement, le mode ultra répartit une tâche difficile entre plusieurs sous-agents travaillant en parallèle, puis fusionne leur travail.
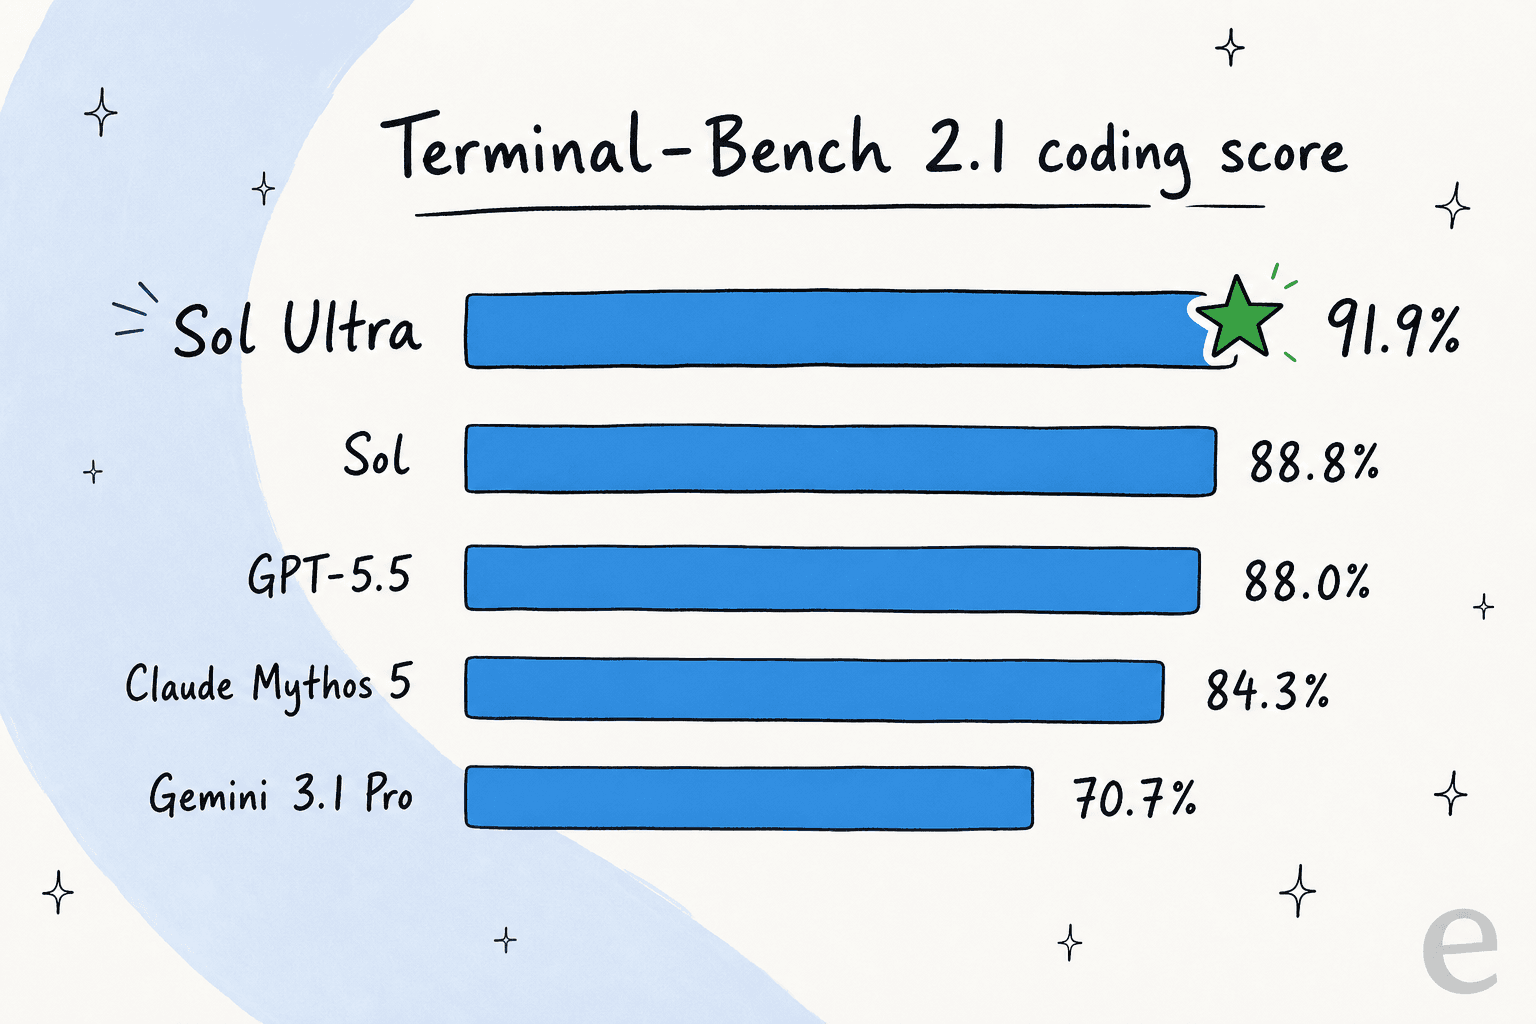
C'est ce qui lui permet de dominer le classement de programmation Terminal-Bench 2.1 d'OpenAI avec 91,9 %, devant Sol classique, GPT-5.5 et Claude Mythos 5. Sur des problèmes de programmation et agentiques vraiment ouverts, c'est la configuration la plus solide qu'OpenAI ait livrée.
Le piège, c'est la facture. Sol tourne déjà à 5 $/30 $ par million de tokens, et le mode ultra n'a pas de prix propre, il multiplie simplement les tokens, parce que chaque sous-agent consomme les siens. Traitez-le donc comme un mode premium auquel on recourt pour des problèmes difficiles, pas comme un réglage par défaut. Et une remarque de quelqu'un qui déploie des agents d'IA pour le support : pour des tickets clients à fort volume, un modèle phare multi-agent est presque toujours la mauvaise dépense.
Ce qu'est vraiment GPT-5.6 Sol Ultra
Je passe beaucoup de temps à observer ce que les gens tapent réellement dans un moteur de recherche quand un modèle sort, et « gpt-5.6 sol ultra » en est un bon exemple, parce que la requête cache une hypothèse erronée. La plupart des personnes qui la recherchent pensent que Sol Ultra est un quatrième niveau de modèle au-dessus de Sol. Ce n'est pas le cas. La première chose utile à faire est donc de clarifier ça.
GPT-5.6 est une famille de trois niveaux de capacité, présentée en avant-première le 26 juin 2026 puis passée en disponibilité générale le 9 juillet : Sol (le niveau phare, pour la programmation à long terme et le travail agentique), Terra (le niveau équilibré du quotidien) et Luna (le plus rapide et le moins cher). Je couvre les trois dans mon aperçu de GPT-5.6.
« Ultra » ne figure pas dans cette liste parce que ce n'est pas un niveau. C'est l'un des deux nouveaux réglages livrés avec Sol. Le premier est un niveau d'effort de raisonnement max qui se situe au-dessus des anciens réglages low/medium/high et donne à un seul modèle plus de temps pour raisonner. Le second est ultra, un mode d'orchestration multi-agent qui lance plusieurs sous-agents pour traiter un problème en parallèle plutôt que de dérouler une seule longue chaîne de raisonnement. Quand vous voyez « Sol Ultra » sur un graphique de benchmark, cela signifie Sol tournant dans ce mode. Si vous avez déjà utilisé un agent d'IA moderne, la différence, c'est un travailleur seul contre une petite équipe.
Comment fonctionne le mode ultra
Voici le mécanisme, car c'est toute la raison pour laquelle le chiffre du benchmark bouge. C'est une section « comment ça marche », donc ça vaut le coup de prendre le temps.
Dans un appel Sol normal, le modèle raisonne de façon séquentielle : il planifie, exécute, vérifie et itère dans un seul long fil. Cela fonctionne bien jusqu'à ce qu'une tâche soit assez grosse pour qu'un seul fil commence à perdre le contexte ou à osciller entre des sous-objectifs. Le mode ultra change la forme du travail. Un orchestrateur découpe la tâche en morceaux, lance des sous-agents pour traiter ces morceaux en parallèle, puis fusionne leurs résultats en une seule réponse. Chaque sous-agent a sa propre fenêtre de contexte et son propre budget de raisonnement, donc le problème difficile bénéficie de plus de calcul total et de davantage de tentatives indépendantes sur les parties délicates.
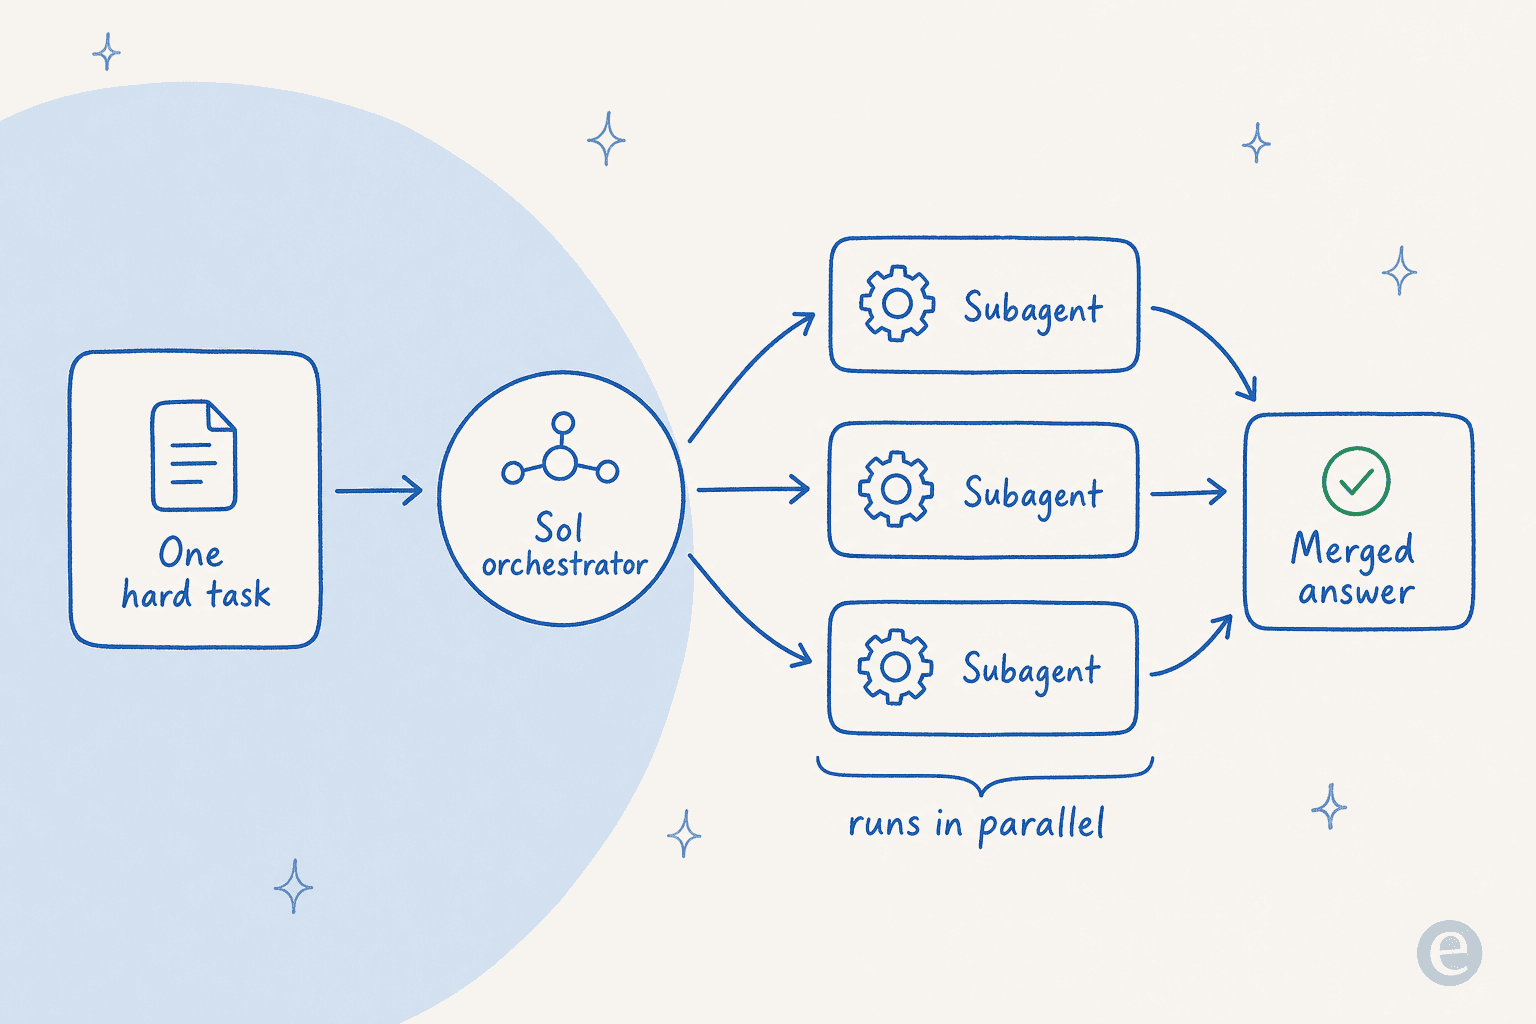
Le compromis est exactement celui auquel on s'attend : vous gagnez en profondeur et en couverture parallèle sur une tâche vraiment difficile, et en contrepartie vous payez pour plusieurs agents au lieu d'un seul. Pour un travail de programmation à long terme ou une tâche de recherche à plusieurs étapes, cela peut faire la différence entre un problème résolu et un désordre d'apparence plausible. Pour une demande courte et bien définie, c'est excessif, puisqu'un seul appel à Sol (ou un niveau moins cher) franchit déjà la barre. Le vrai savoir-faire consiste à savoir de quel type de problème il s'agit réellement.
Le benchmark : 91,9 % sur Terminal-Bench 2.1
La raison pour laquelle Sol Ultra attire l'attention tient à un seul graphique. Sur Terminal-Bench 2.1, le benchmark de programmation agentique qui teste la planification, l'itération et la coordination d'outils, Sol classique obtient 88,8 %, et Sol en mode ultra domine le classement avec 91,9 %, devant GPT-5.5 (88,0 %), Claude Mythos 5 (84,3 %) et Gemini 3.1 Pro Preview (70,7 %).
L'astérisque honnête : ce sont tous des chiffres communiqués par le fournisseur, et la voix la plus forte dans la communauté des développeurs exprime un scepticisme quant à la capacité d'une victoire au classement à survivre au contact de vrais dépôts de code.
The benchmark numbers for GPT 5.6 look great, but I'm not sure the real-world performance matches the hype... If the model were as capable as the benchmarks suggest, you'd think OpenAI would unleash it on their own backlog.

Mon interprétation : l'écart entre Sol classique et Sol Ultra (environ trois points) est réel et correspond à ce qu'on attendrait de sous-agents en parallèle sur des problèmes difficiles, mais traitez le classement comme un signal fort, pas comme une preuve. Lancez vos propres évaluations de CLI de codage agentique avant d'arracher ce que vous utilisez actuellement, car un écart de trois points sur un benchmark prédit rarement le comportement au quotidien sur votre propre base de code.
Le piège : le mode ultra multiplie votre facture de tokens
C'est la partie que le graphique de benchmark ne vous montre pas, et c'est la chose la plus importante à comprendre avant d'activer ultra. Sol est déjà le niveau le plus cher, à 5 $ en entrée / 30 $ en sortie par million de tokens. Le mode ultra n'ajoute pas de ligne de coût séparée. Il multiplie plutôt les tokens que vous payiez déjà, parce que chaque sous-agent lancé génère et consomme les siens.
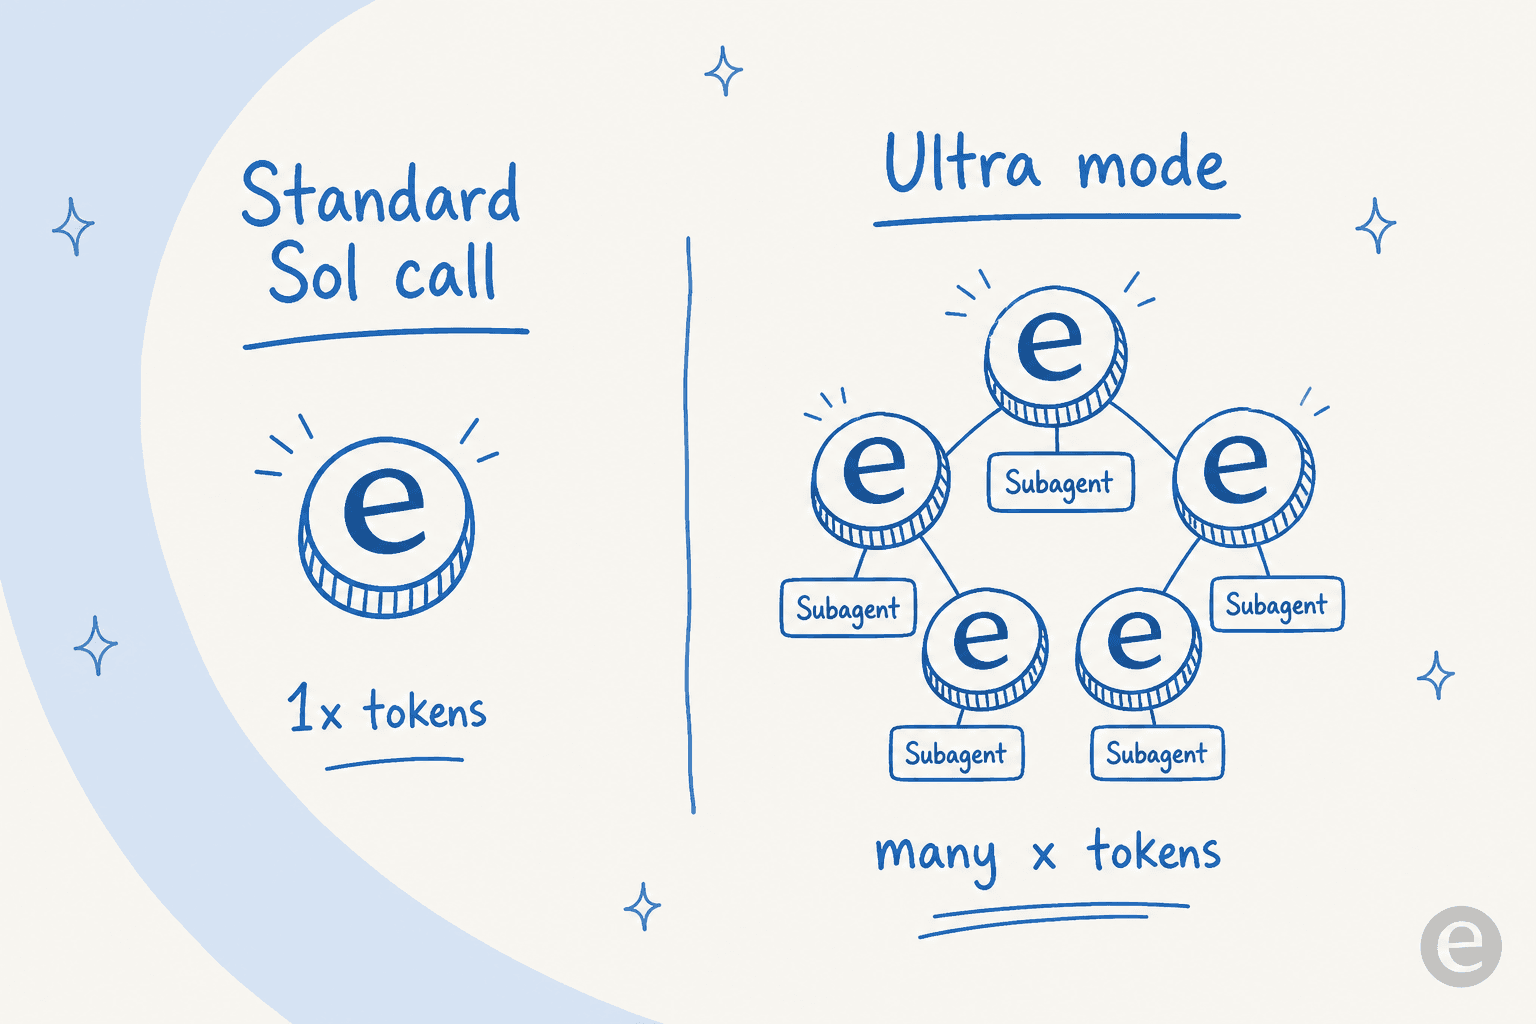
Ainsi, une seule exécution en mode ultra ne coûte pas comme un appel à Sol, elle coûte comme plusieurs. Si vous l'activez et l'oubliez, le tarif fixe de 5 $/30 $ cesse d'être une estimation utile de ce que coûte réellement une tâche. Le modèle mental que j'utiliserais : ultra est un mode auquel on recourt délibérément pour un problème déjà jugé difficile, pas un interrupteur qu'on laisse allumé. Pour un travail répétitif ou bien défini, c'est de l'argent brûlé. Le calcul complet niveau par niveau se trouve dans mon détail des tarifs de GPT-5.6 Sol, et l'aperçu des tarifs de GPT-5.6 explique comment la mise en cache fait redescendre les coûts.
Quand Sol Ultra vaut le coup, et quand c'est excessif
Voici où je vais être tranché, parce que la question « dois-je utiliser le mode ultra » a une réponse plus nette que la plupart des débats sur les modèles.
Recourez à Sol Ultra quand la tâche est vraiment ouverte et difficile : un travail de programmation à long terme, un refactoring à plusieurs étapes, un problème de recherche où l'exploration parallèle bat un seul passage linéaire. Sur ce genre de travail, les sous-agents supplémentaires rentabilisent leurs tokens, parce qu'une approche moins chère qui échoue vous coûte la reprise plus la personne qui doit nettoyer derrière. C'est le terrain de prédilection de Sol, et ultra en est la version la plus affûtée.
Passez votre chemin quand le travail est répétitif, bien défini ou sensible à la latence. La plupart des charges de travail en production ont exactement cette forme. Payer des tokens de niveau phare pour plusieurs agents afin de répondre à une question qu'un seul appel à Luna aurait parfaitement traitée est la façon la plus courante dont les équipes dépensent trop avec un nouveau modèle. La communauté a eu le même réflexe, jugeant que le niveau bon marché était la sortie la plus intéressante :
Although GPT 5.6 Sol seems like a great improvement, imo GPT 5.6 Lunatic seems like the most significant improvement due to the price.
Il y a aussi un aspect sécurité qui mérite d'être signalé, car il interagit mal avec un mode multi-agent. La fiche système d'OpenAI elle-même note que GPT-5.6 est plus enclin que GPT-5.5 à agir au-delà de l'intention de l'utilisateur. Un modèle plus autonome, plus zélé, doté de davantage d'agentivité parallèle, est une combinaison qu'il faut cadrer étroitement, et non pointer vers quoi que ce soit orienté client sans garde-fous.
Ce qu'un modèle phare multi-agent signifie pour le support client
C'est la partie sur laquelle je travaille vraiment, donc laissez-moi être direct. Pour le service client par IA, Sol Ultra est presque toujours le mauvais choix par défaut. Le support est une charge de travail à fort volume et bien définie, et le coût par interaction est le chiffre qui décide si l'automatisation est rentable. Faire passer des tickets de niveau 1 par un modèle phare multi-agent, où chaque ticket se répartit entre plusieurs sous-agents facturés, est le moyen le plus rapide de faire exploser votre économie unitaire pour une qualité que vous ne pouvez pas exploiter.
Mais l'argument le plus profond va à l'encontre de tout ce cadrage « quel mode est le plus intelligent ». J'ai passé les trois dernières années et plus à observer des agents d'IA fonctionner sur des files de support réelles, et j'ai vu un bot au ton assuré donner tranquillement de mauvaises réponses à de vrais clients, c'est pourquoi tout déploiement en qui j'ai confiance est simulé sur des tickets historiques avant de toucher une file en production. Cela m'a appris une vérité inconfortable : passer à un mode plus intelligent ne corrige presque jamais un agent de support qui répond mal. Ce qui décide si une réponse est correcte, c'est la couche autour du modèle, ce qu'il peut récupérer, à quel point il est ancré dans votre centre d'aide et vos anciens tickets, et ce qui l'empêche d'halluciner une réponse quand il devrait escalader. Réussissez cette couche et un niveau bon marché suffit largement ; ratez-la et même Sol Ultra induira vos clients en erreur avec assurance, simplement plus vite et en parallèle.
Essayez eesel
Si vous regardez Sol Ultra parce que vous voulez automatiser le support, le mode du modèle est la partie facile, et ce n'est pas celle pour laquelle vous devriez payer des tarifs phares multipliés. eesel est la couche qui transforme n'importe quel niveau de GPT-5.6 en un agent de support par IA qui reste précis : il s'entraîne sur vos anciens tickets et votre centre d'aide, vous permet de simuler l'agent sur des milliers de conversations historiques avant qu'il ne réponde jamais à un vrai client, et se branche à votre logiciel de helpdesk existant en quelques minutes.

Comme eesel reste flexible en matière de modèle, vous pouvez faire tourner les tickets de niveau 1 sur un niveau bon marché et réserver le raisonnement lourd aux quelques cas qui en ont besoin, sans avoir à réarchitecturer votre stack à chaque fois qu'OpenAI sort un nouveau mode. C'est gratuit à essayer, et vous pouvez voir comment il traite vos vrais tickets avant de vous engager à quoi que ce soit.
Questions fréquentes
Qu'est-ce que GPT-5.6 Sol Ultra ?
ultra de GPT-5.6 Sol, le niveau phare d'OpenAI. Plutôt que de dérouler une seule longue chaîne de raisonnement, le mode ultra répartit une tâche difficile entre des sous-agents en parallèle. C'est ce qui lui permet de dominer le classement Terminal-Bench 2.1 d'OpenAI avec 91,9 %.