

Ce que les gens veulent vraiment quand ils disent "gérer des agents IA depuis le terminal"
Je développe les intégrations et les API chez eesel, donc cette requête de recherche me touche de près. Quand quelqu'un la tape, il ne demande presque jamais un prompt de chat dans son shell. C'est un platform engineer, un responsable ops ou un founding engineer qui pilote déjà tout le reste depuis la ligne de commande, et qui vient de se voir confier un agent de support IA qui vit entièrement derrière un tableau de bord web. Cela semble anormal, de la même façon qu'un serveur qu'on ne peut configurer qu'en cliquant sur des boutons semble anormal.
L'instinct est le bon, et pas mal d'ingénieurs l'ont formulé de façon plus tranchante que je ne le ferais :
"Devs spent decades building CI/CD, monitoring, rollbacks, and circuit breakers because deploying software and hoping it works was never acceptable. Then they built AI agents and somehow went back to hoping."

C'est la démangeaison derrière la recherche. Tout le reste dans une stack moderne est du code que l'on peut versionner, relire, déployer et rétablir. Puis l'agent IA apparaît comme une page de paramètres où quelqu'un bascule des comportements dans un navigateur, sans piste d'audit et sans moyen de tester un changement avant que de vrais clients ne le rencontrent. Le terminal, ici, est un raccourci pour toute une discipline : si c'est un système de production, il devrait pouvoir être exploité comme tel.
La vraie question n'est donc pas "y a-t-il une CLI". C'est "puis-je traiter cet agent comme je traite le reste de mon infrastructure ?". Cela recadre tout, et c'est le cadre qu'il vaut la peine de garder pour la suite de cet article.
Le changement de perspective : un agent est un service que l'on exploite, pas un bot que l'on configure
La plupart des contenus sur les agents de support IA s'arrêtent à la configuration initiale. Connectez votre centre d'aide, choisissez un ton, activez-le. Mais la configuration, c'est le jour un. Le travail qui compte vraiment, c'est le jour deux et tous les jours suivants : la configuration dérive, un article de la base de connaissances devient obsolète, un nouveau produit est lancé et l'agent se met à répondre faux avec assurance. Gérer un agent, c'est une boucle, pas un lancement.
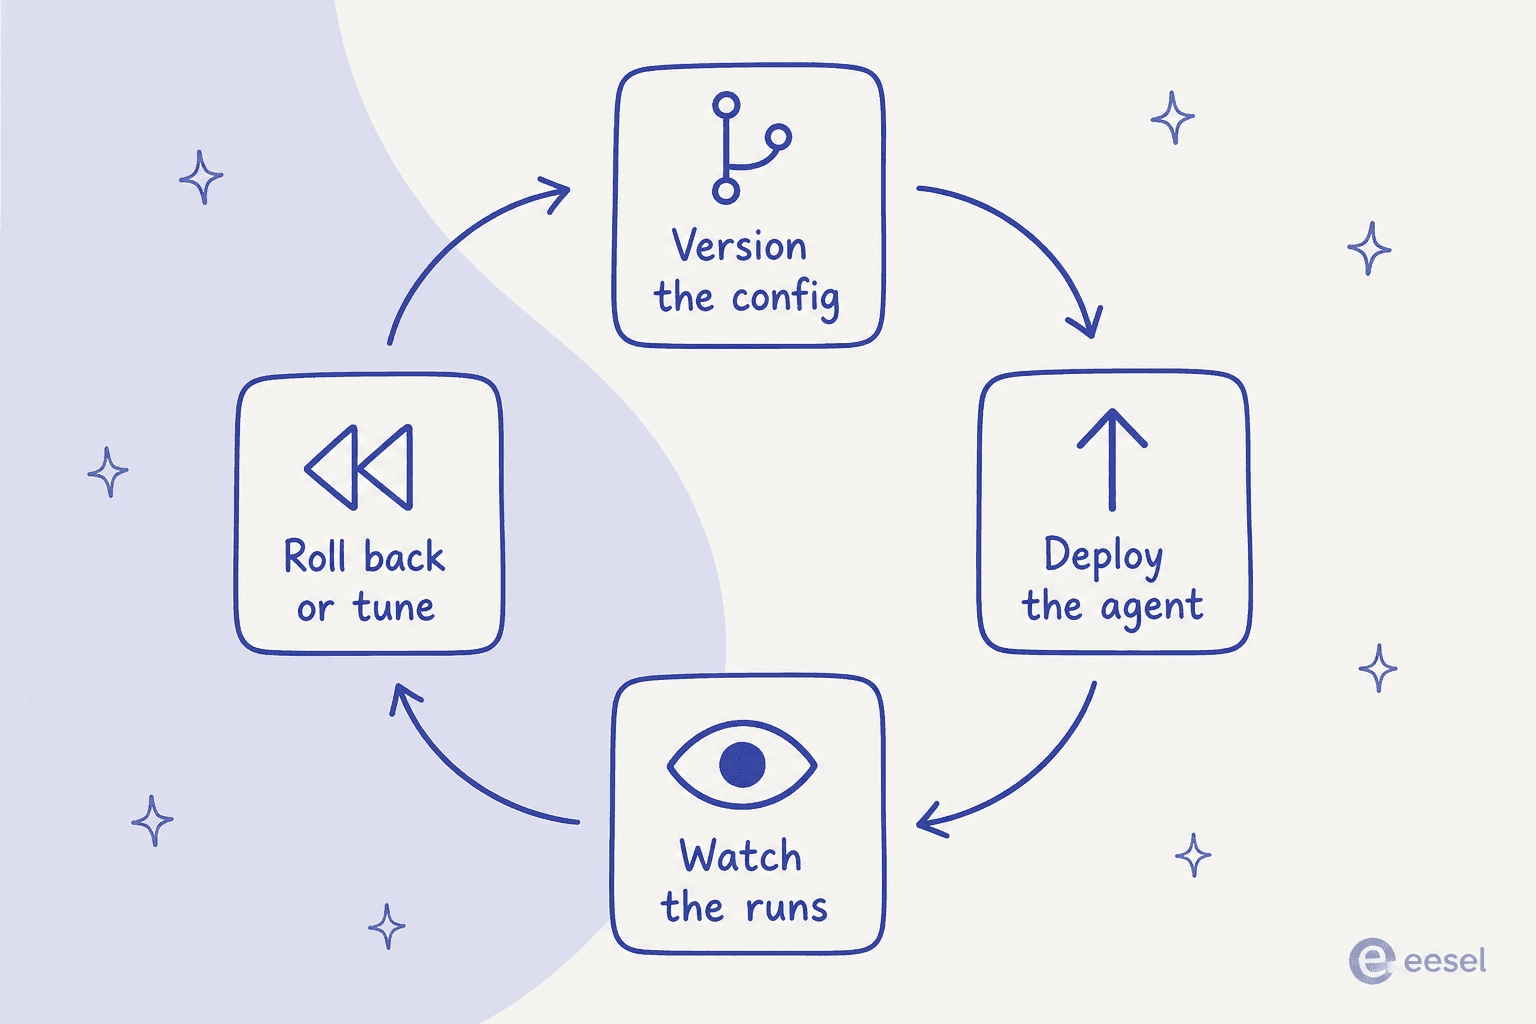
C'est exactement pour cette boucle que "l'ops-as-code" offre un cadre. Versionnez la configuration pour qu'un changement soit un diff que quelqu'un peut relire. Déployez via un pipeline pour qu'un déploiement soit reproductible. Surveillez les exécutions pour savoir ce que l'agent a réellement fait. Revenez en arrière ou ajustez quand quelque chose cloche. Rien de tout cela n'est exotique ; c'est ainsi que l'on exploiterait n'importe quel service. La seule raison pour laquelle cela semble nouveau pour un agent IA, c'est que tant d'outils ont d'abord été construits comme des tableaux de bord et n'ont jamais développé de surface programmable. Une équipe qui construit un framework agents-as-code a formulé l'objectif clairement :
"Orloj treats agents the way infrastructure-as-code treats cloud resources. You write a manifest that declares an agent's model, tools, permissions, and execution limits."

Une fois que l'on adopte ce cadre, le terminal cesse d'être l'objectif et devient l'interface vers l'objectif. Vous voulez que le comportement de l'agent soit quelque chose que vous puissiez differ, pas quelque chose dont vous devez vous souvenir avoir changé mardi dernier.
Ce que vous pouvez vraiment scripter aujourd'hui
Voici la partie pratique. Si votre outil expose une API ou une CLI, une quantité surprenante de gestion d'agent fonctionne déjà depuis un shell. Le schéma universel, quel que soit le fournisseur, est le même que pour n'importe quel service : le fichier de configuration est la source de vérité, l'API est la cible du déploiement, et le contrôle de version est le journal d'audit. Sous sa forme brute, ce n'est que curl et jq, par exemple pour récupérer la dernière journée d'exécutions et compter les escalades :
curl -s https://api.yourtool.com/v1/agent/runs \
  -H "Authorization: Bearer $AGENT_TOKEN" \
  --data-urlencode "since=$(date -u -v-1d +%FT%TZ)" \
| jq '[.runs[] | select(.outcome == "escalated")] | length'
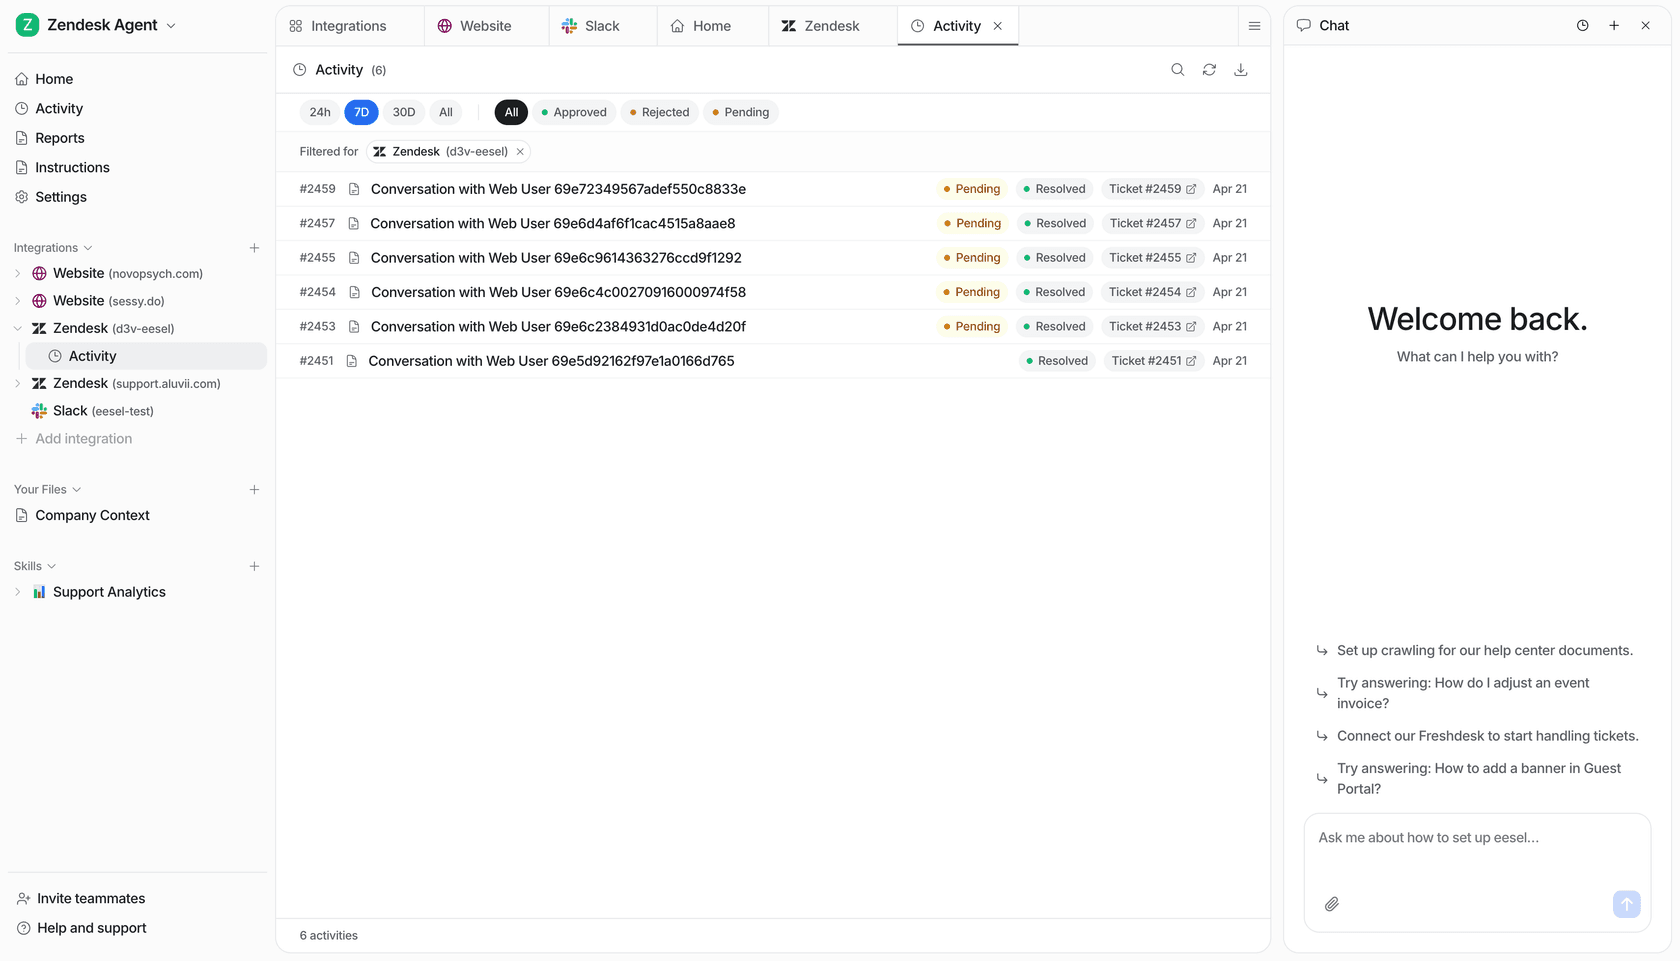
Certains outils sautent l'étape REST brute et vous donnent une CLI de premier ordre. eesel en fait partie : son outil en ligne de commande est un vrai binaire npm (@eesel/cli), et la documentation dit sans détour que le terminal est l'interface prévue, pas une porte dérobée : tout sur le site "peut être fait depuis le terminal". Une session typique ressemble à ceci :
eesel login                 # browser once, or set EESEL_API_TOKEN for CI
eesel status                # what's connected, is knowledge current, plan
eesel activity              # every run, newest first (JSON by default)
eesel instructions          # read or edit the agent's standing rules
eesel approvals list        # actions held, waiting on a human
Chaque commande affiche du JSON, les erreurs reviennent sous forme d'une ligne structurée sur stderr, et définir EESEL_API_TOKEN (plus EESEL_AGENT_ID) permet de faire tourner le tout sans interface graphique en CI, sans connexion par navigateur. Accrochez n'importe laquelle de ces étapes à un cron job ou une GitHub Action, et vous obtenez une gestion d'agent planifiée, vérifiable et versionnée, sans tableau de bord requis.
Le piège, c'est l'ampleur de ce "si". Beaucoup d'IA de support n'ont pas d'API digne de ce nom, donc le plafond de ce que vous pouvez scripter est fixé entièrement par le fournisseur. C'est la chose la plus importante à vérifier avant d'acheter : un outil sans surface programmable ne pourra jamais être géré depuis le terminal, peu importe à quel point vous le souhaitez. Cela vaut la peine de parcourir le spectre de la gérabilité avant de vous engager.
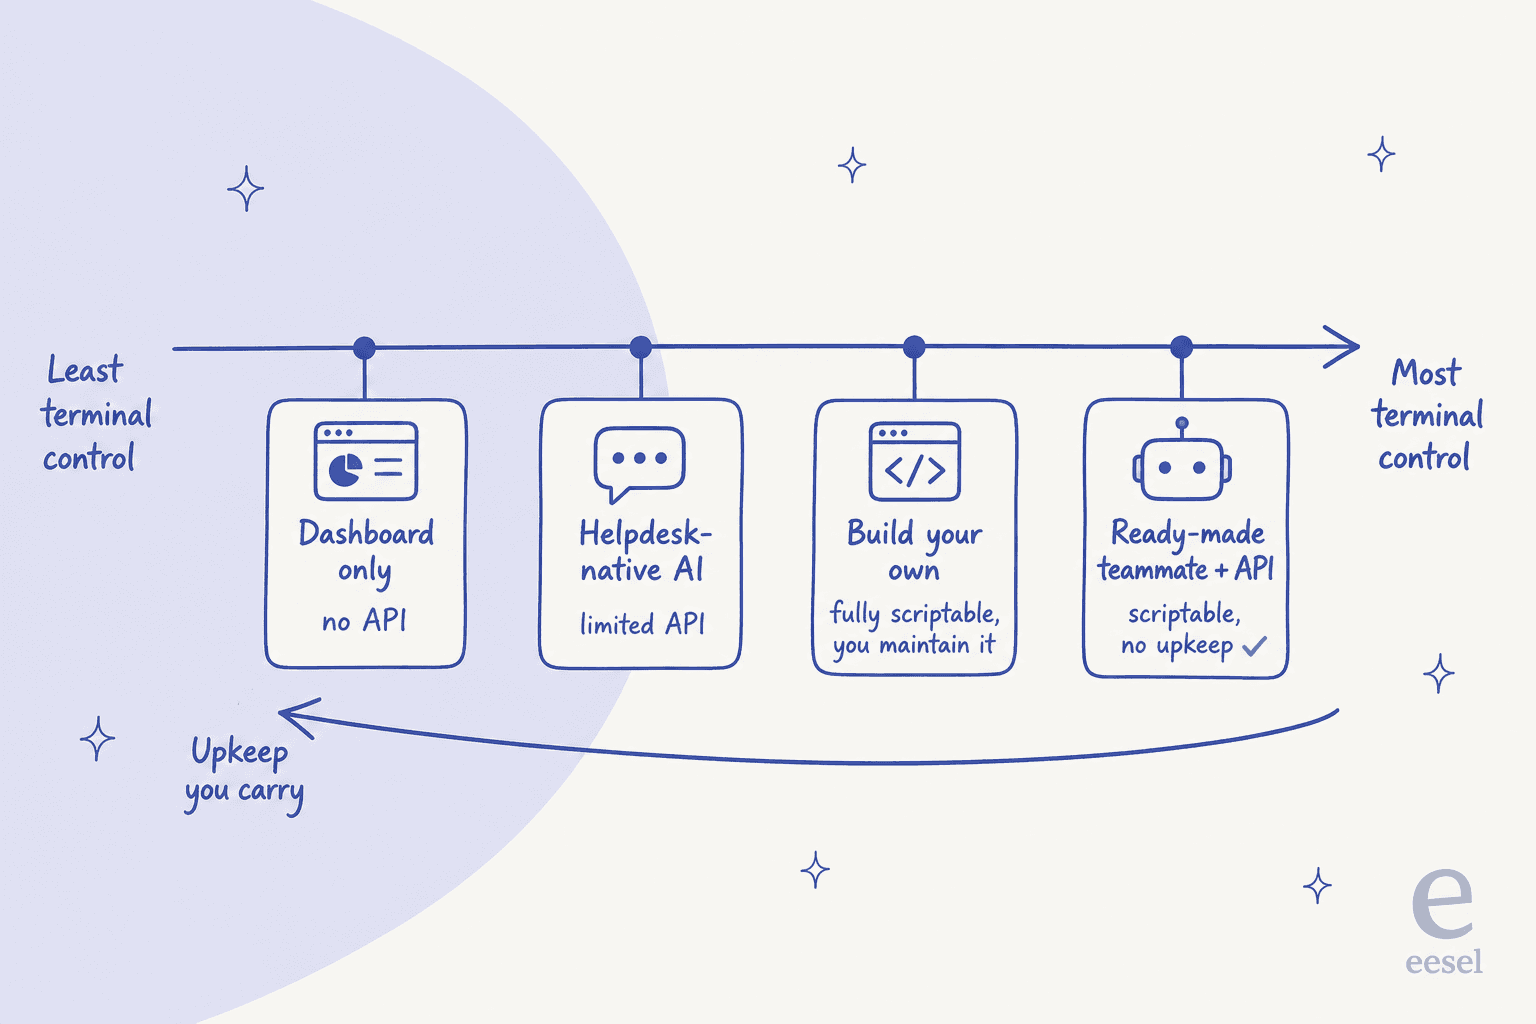
Il y a un vrai compromis le long de cette ligne. Construire votre propre agent sur une API de modèle vous donne un contrôle total et une maintenance totale : vous possédez le retrieval, les guardrails, le harnais d'évaluation et chaque alerte à 2 heures du matin quand une régression de prompt est déployée. Un agent prêt à l'emploi avec une bonne API vous donne l'essentiel de la programmabilité sans la traîne de maintenance. L'extrémité que vous voulez dépend du fait que gérer l'agent est votre travail ou une taxe sur votre vrai travail. (Si vous pesez le côté construction, nous approfondissons cela dans nos analyses API d'agent de support client et API de helpdesk IA.)
La moitié que le terminal ne peut pas vous donner : voir ce que l'agent a fait
Voici le piège. Déployer depuis la ligne de commande est la moitié facile, et elle vous berce dans l'idée que vous avez le contrôle. Votre script s'exécute, l'API renvoie 200, votre terminal affiche exit 0, et vous passez à autre chose. Mais un code de sortie propre vous dit que le changement a été livré. Il ne vous dit rien sur le fait que l'agent fasse ou non ce qu'il faut.
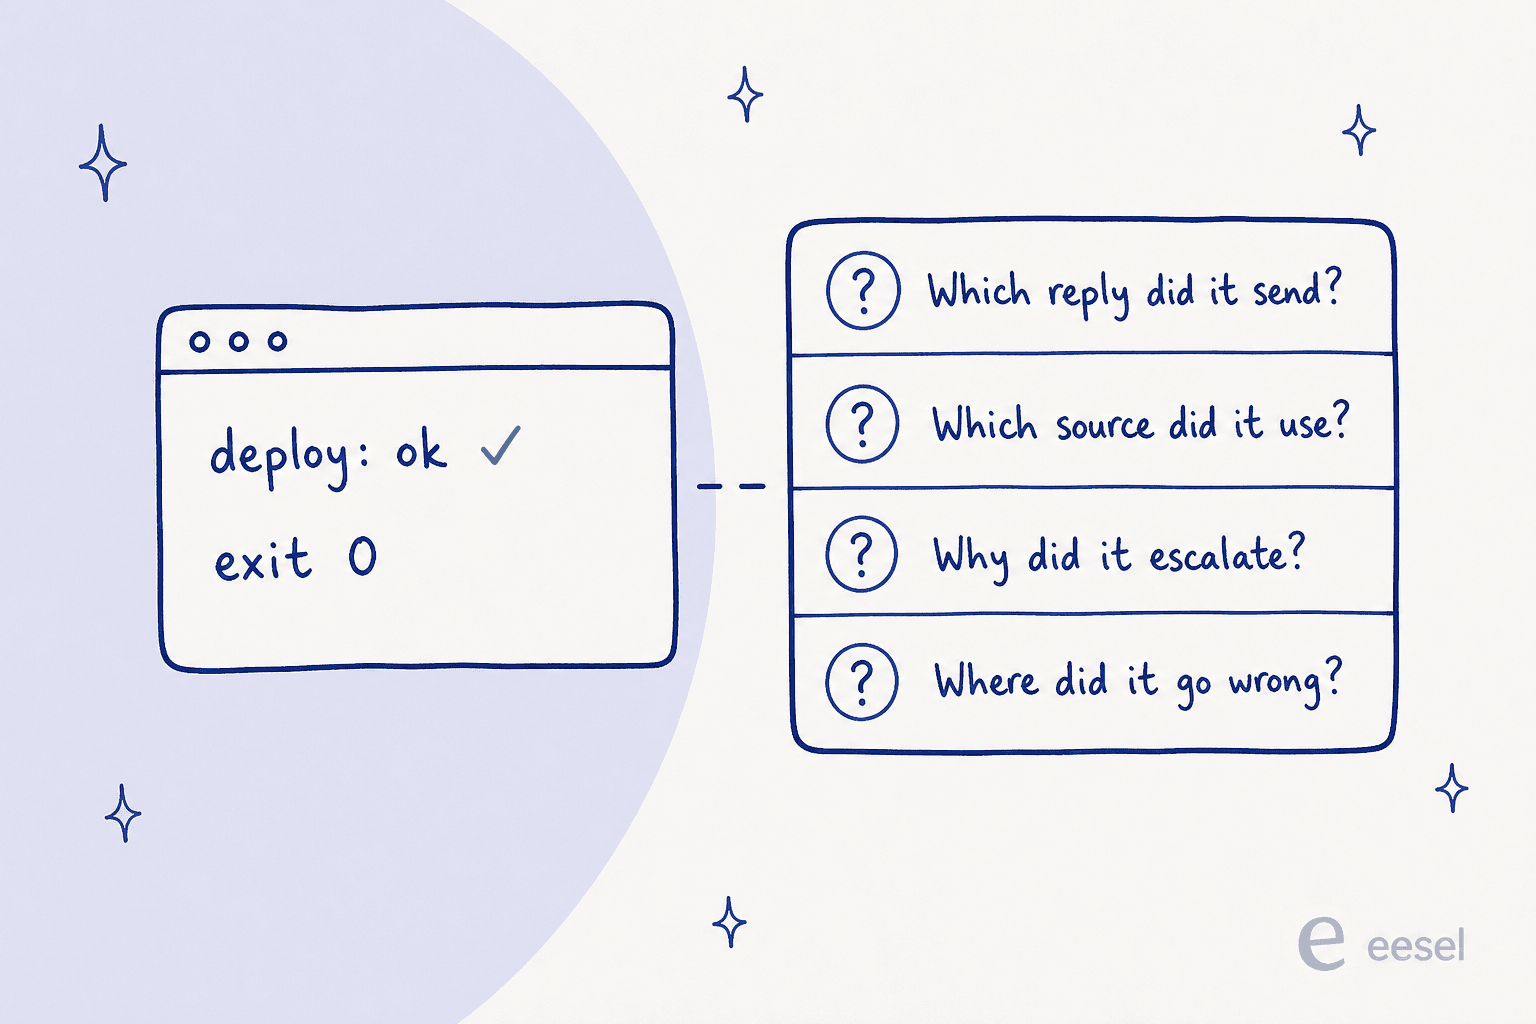
C'est là que beaucoup de projets d'agents maison s'effondrent silencieusement. Vous pouvez automatiser le déploiement en un après-midi ; vous ne pouvez pas automatiser le besoin de savoir quelle réponse est allée à quel client, sur quelle source de connaissance l'agent s'est appuyé, et pourquoi il a décidé d'escalader un ticket et d'en traiter un autre. Le témoignage d'un ingénieur sur six mois de pannes en production a résumé parfaitement le mode de défaillance :
"Agent works in testing. Works in the demo. Ships to production. Two weeks later - same input, different output. No error. No log that helps. Just a wrong answer delivered confidently."
C'est ça, l'observabilité, et c'est la partie coûteuse à construire et la partie facile à négliger. C'est aussi pourquoi le sentiment sur les forums de développeurs est passé silencieusement de "quel modèle" à "puis-je voir ce qu'il a fait" :
"honestly I'm starting to think observability is becoming more important than the model itself"
La leçon que l'on continue de réapprendre : un terminal n'est utile que dans la mesure de l'historique des exécutions derrière l'outil qu'il pilote. Si l'agent peut déployer mais ne peut pas vous montrer son travail, vous avez automatisé la partie qui n'a jamais été le problème. Quand vous évaluez un outil, poussez le côté lecture aussi fort que le côté écriture. Pouvez-vous récupérer la transcription complète d'une exécution ? Pouvez-vous voir la confiance et les sources derrière une réponse ? Pouvez-vous être alerté quand quelque chose dérive ? Un tableau de bord qui montre magnifiquement tout cela mais n'en expose rien à un script reste une boîte noire pour votre automatisation.
C'est la partie dont je suis le plus fier de notre côté : eesel activity liste chaque exécution de la plus récente à la plus ancienne et vous permet d'en lire une en détail complet, et comme c'est le même JSON que celui affiché par le tableau de bord, une réponse n'est jamais quelque chose qui s'est simplement produit quelque part où vous ne pouvez pas voir. Associez cela à eesel approvals, et un humain peut retenir, approuver ou refuser une action en file d'attente sans jamais quitter le shell.
Tester avant de déployer : l'environnement de staging pour les agents
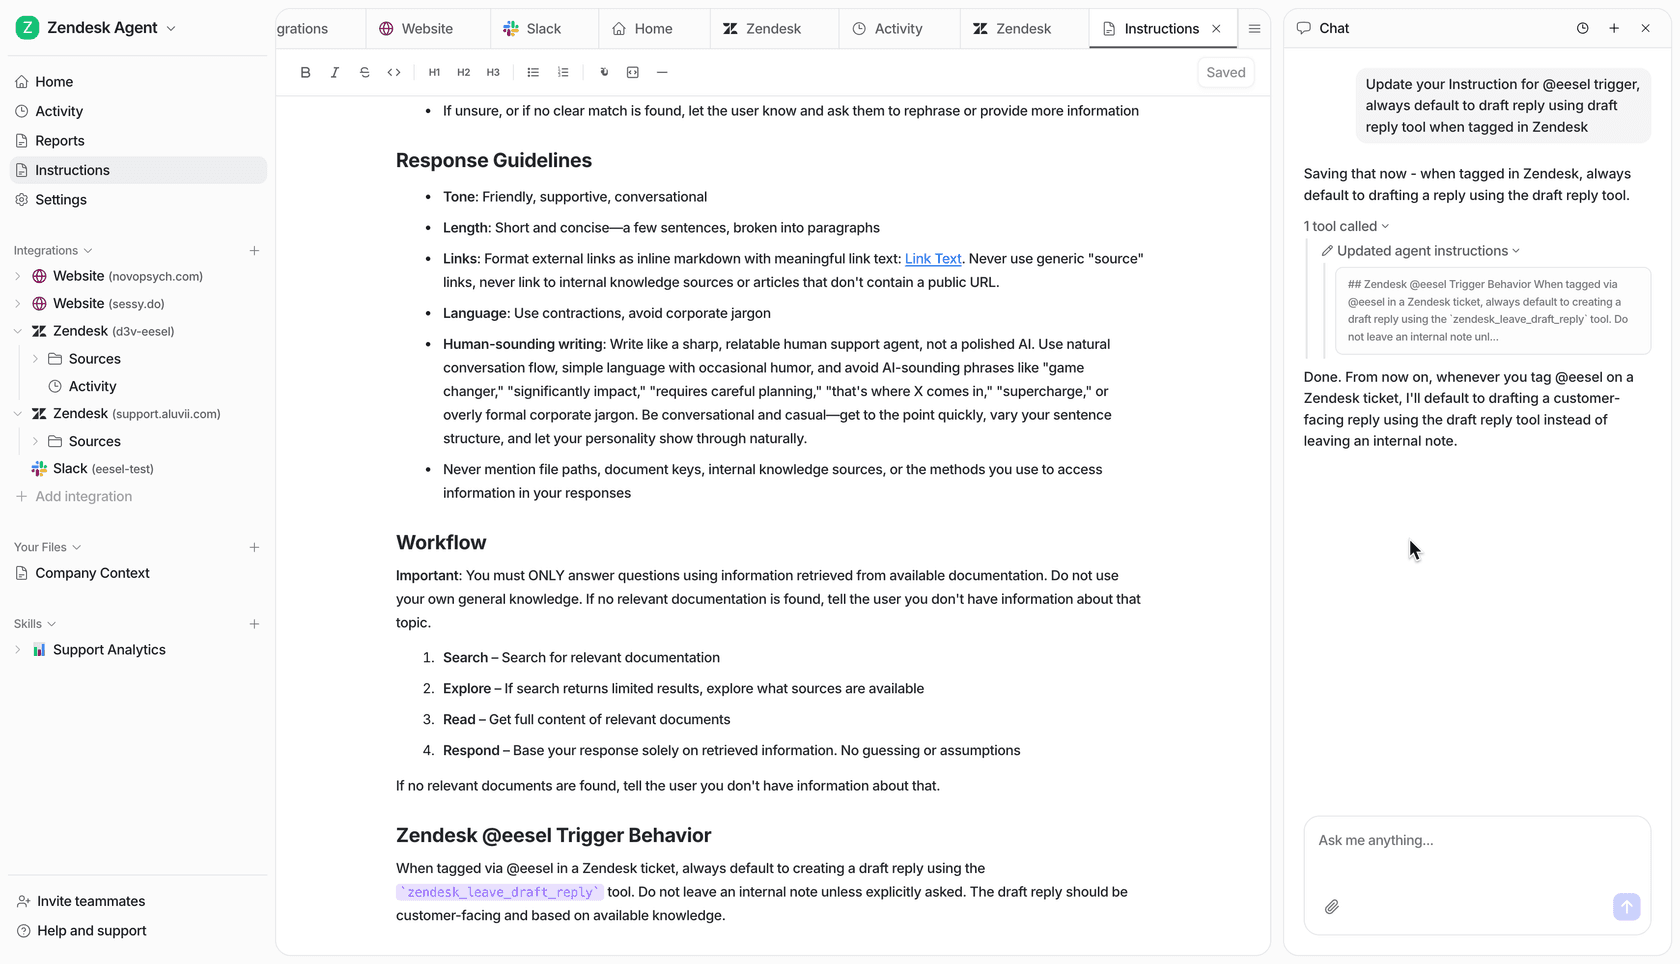
Si vous ne devez retenir qu'une habitude issue de l'exploitation de services et l'appliquer aux agents, que ce soit celle-ci : ne livrez jamais un changement de configuration directement aux clients. Dans un logiciel normal, vous avez un environnement de staging. Pour un agent IA, l'équivalent consiste à rejouer vos propres anciens tickets contre la nouvelle configuration et à vérifier ce qui se serait passé, avant qu'un seul vrai client ne le voie. Un développeur qui est passé par ce cycle a décrit la solution comme des tests de snapshot :
"What finally fixed the cycle for me was treating agent behavior like snapshot tests. Record the trajectory when it's working, save it as baseline, diff after every change. If the tool path shifted or output drifted - block the deploy before it hits prod."
La raison pour laquelle cela compte n'est pas théorique. Sur τ-bench, le benchmark d'agents à outils de l'équipe de recherche de Sierra, le meilleur agent a obtenu moins de 50 % sur des tâches de support réalistes, et un agent GPT-4o qui atteignait son score pass^1 est retombé à environ 25 % en pass^8, soit un effondrement de fiabilité d'environ 60 % rien qu'en réexécutant la même tâche huit fois. La précision affichée n'est pas le chiffre effrayant. C'est l'incohérence d'une exécution à l'autre, et la seule façon de la détecter avant vos clients est d'exécuter d'abord la nouvelle configuration face à la réalité.
Nous avons appris la même chose à la dure sur plus de trois ans à faire tourner de l'IA sur des files de support en direct. Nous avons vu un bot au ton assuré délivrer silencieusement de mauvaises réponses, c'est pourquoi chaque déploiement est désormais simulé contre des tickets historiques au préalable. Cette simulation est votre suite de régression. Au niveau de la commande, un flag --dry-run fait la petite version de la même idée : il affiche l'appel exact qu'une écriture ferait sans l'envoyer, pour que vous voyiez ce qu'un changement fait avant qu'il ne le fasse.
C'est aussi la limite honnête du scriptable. Vous pouvez automatiser le rejeu. Vous pouvez conditionner le déploiement au résultat. Ce que vous ne pouvez pas scripter, c'est le jugement sur le fait qu'une baisse de 4 points dans une catégorie de tickets est acceptable pour le gain de 10 points ailleurs. Le terminal rend le test bon marché et reproductible ; une personne lit tout de même le résultat. Comme je l'ai entendu dire en interne : vous pouvez scripter le ticket, mais vous ne pouvez pas scripter la réponse.
Ce que coûte l'exploitation, et où se cache la facture
Faire tourner un agent a un compteur, et c'est ce compteur qui transforme silencieusement "gérer depuis le terminal" en question de budget. L'unité compte plus que le chiffre, parce que les unités ne sont pas les mêmes. Certains outils facturent à la résolution, certains à la conversation, certains au token d'API, et un script qui déclenche des milliers d'appels API par jour pour interroger les exécutions peut générer une facture surprenante si vous êtes facturé à l'appel.
La version honnête d'un tableau de coûts pour un agent de support ressemble à ceci :
| Approche | Ce que vous scriptez | Qui maintient | Modèle de coût approximatif |
|---|---|---|---|
| Outil tableau de bord uniquement | Rien, pas d'API | Fournisseur | Par résolution ou par siège |
| IA native au helpdesk | Configuration limitée via l'API du helpdesk | Fournisseur | Par résolution (souvent 1,50 à 2,00 $) |
| Solution maison sur une API de modèle | Tout | Vous | Par token, à chaque message et chaque nouvelle tentative |
| Agent prêt à l'emploi avec CLI (eesel) | Configuration, exécutions, actions | Fournisseur | 0,40 $ par ticket traité |
Les deux extrémités sont les plus intéressantes. La solution maison vous donne une facture au token qui est facturée que le ticket soit résolu ou non, plus le coût salarial de la personne qui maintient le retrieval et les guardrails. Un modèle au ticket comme celui d'eesel est forfaitaire par conversation traitée quel que soit le nombre de messages nécessaires, sans frais par siège ni par plateforme, ce qui rend la dépense assez prévisible pour vraiment la mettre dans un script et un budget. À 1 000 tickets par mois, cela fait environ 400 $, et vous ne payez que pour les tickets que vous routez vers l'agent, pas pour ceux que vos humains traitent encore.
Essayez eesel pour un agent de support que vous pouvez vraiment piloter
Si toute la raison pour laquelle vous avez cherché cela, c'est que vous voulez exploiter un agent de support comme un service au lieu de surveiller un tableau de bord, c'est exactement le vide que eesel a été conçu pour combler. C'est un coéquipier IA qui rejoint votre helpdesk existant (Zendesk, Freshdesk, Front, Gorgias, Help Scout et d'autres), s'entraîne sur vos anciens tickets et documents, et vous donne une véritable surface programmable : une CLI, un serveur MCP par workspace, des webhooks et un Network Access sortant pour que l'agent puisse appeler vos propres systèmes.
Vous pouvez l'installer et le piloter entièrement depuis un shell :
npx @eesel/cli init chat-bubble --site https://your-site.com
eesel chat "what's our refund policy?"   # test an answer before go-live
eesel activity                            # watch what it actually did
Les deux habitudes de cet article qui comptent le plus sont intégrées : vous simulez face à vos tickets historiques avant la mise en production, et vous déployez progressivement, en gardant chaque réponse comme brouillon jusqu'à ce qu'elle mérite le droit d'être envoyée seule. Et comme cela coûte 0,40 $ par ticket sans frais par siège, vous pouvez commencer avec quelques types de tickets et monter en charge à partir d'un script plutôt que d'un appel commercial.
Vous pouvez démarrer gratuitement sans carte de crédit, le connecter à votre helpdesk en quelques minutes, et voir comment il gère vos vrais tickets avant de vous engager sur quoi que ce soit. C'est tout l'intérêt : un agent que vous pouvez tester, observer et piloter, pas un agent auquel vous devez faire confiance aveuglément.
Questions fréquentes
Peut-on vraiment gérer des agents IA depuis le terminal ?
Que signifie 'ops-as-code' pour un agent de support IA ?
Combien coûte l'exploitation d'un agent de support IA ?
Que se passe-t-il si un agent IA donne une mauvaise réponse en production ?


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.




Comment déployer des changements sur un agent IA depuis la ligne de commande ?