Ce qu'est vraiment un serveur MCP
Commençons par le mot « serveur », car c'est ce qui perturbe presque tout le monde. Un serveur MCP n'est pas une grosse machine dans un datacenter, et ce n'est pas l'IA. C'est un programme qui expose des capacités spécifiques aux applications d'IA via une interface standard. Il peut tourner localement sur votre ordinateur portable ou à distance sur une plateforme. C'est tout.
La description la plus claire que j'ai lue vient d'un développeur sur Hacker News, qui démêle exactement cette confusion :
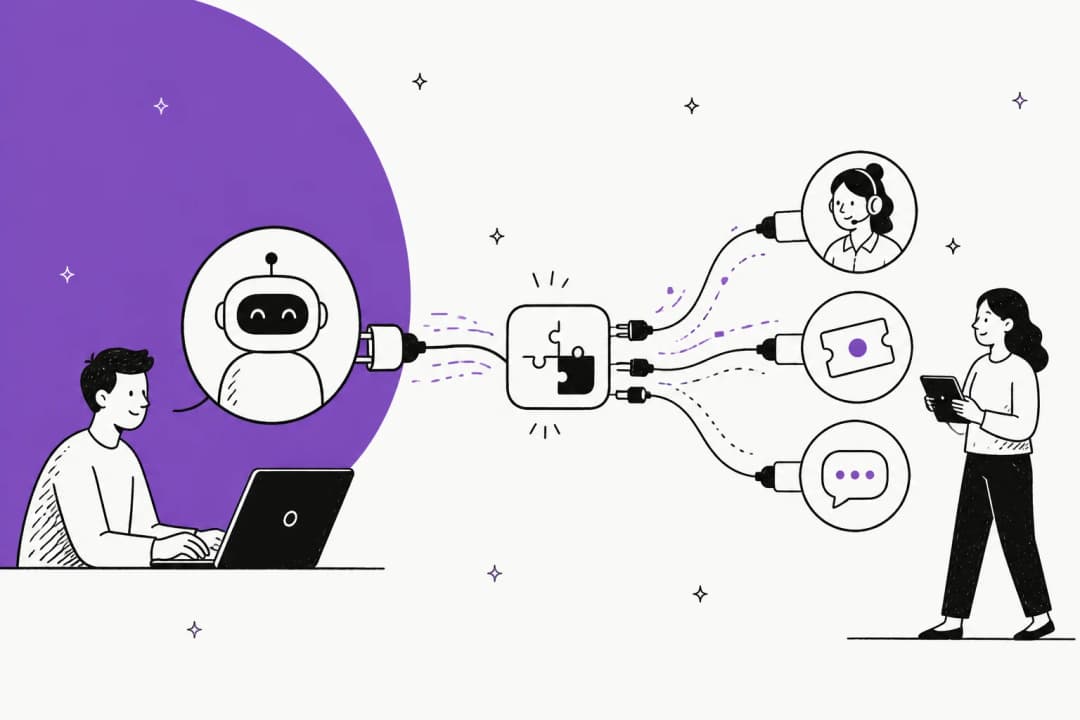
"One confusing thing to me was the word 'server'. An 'MCP server' is a server to the LLM 'client'. But the MCP server itself is a client to the thing it's connecting the LLM to. So it's more like an adapter or proxy."

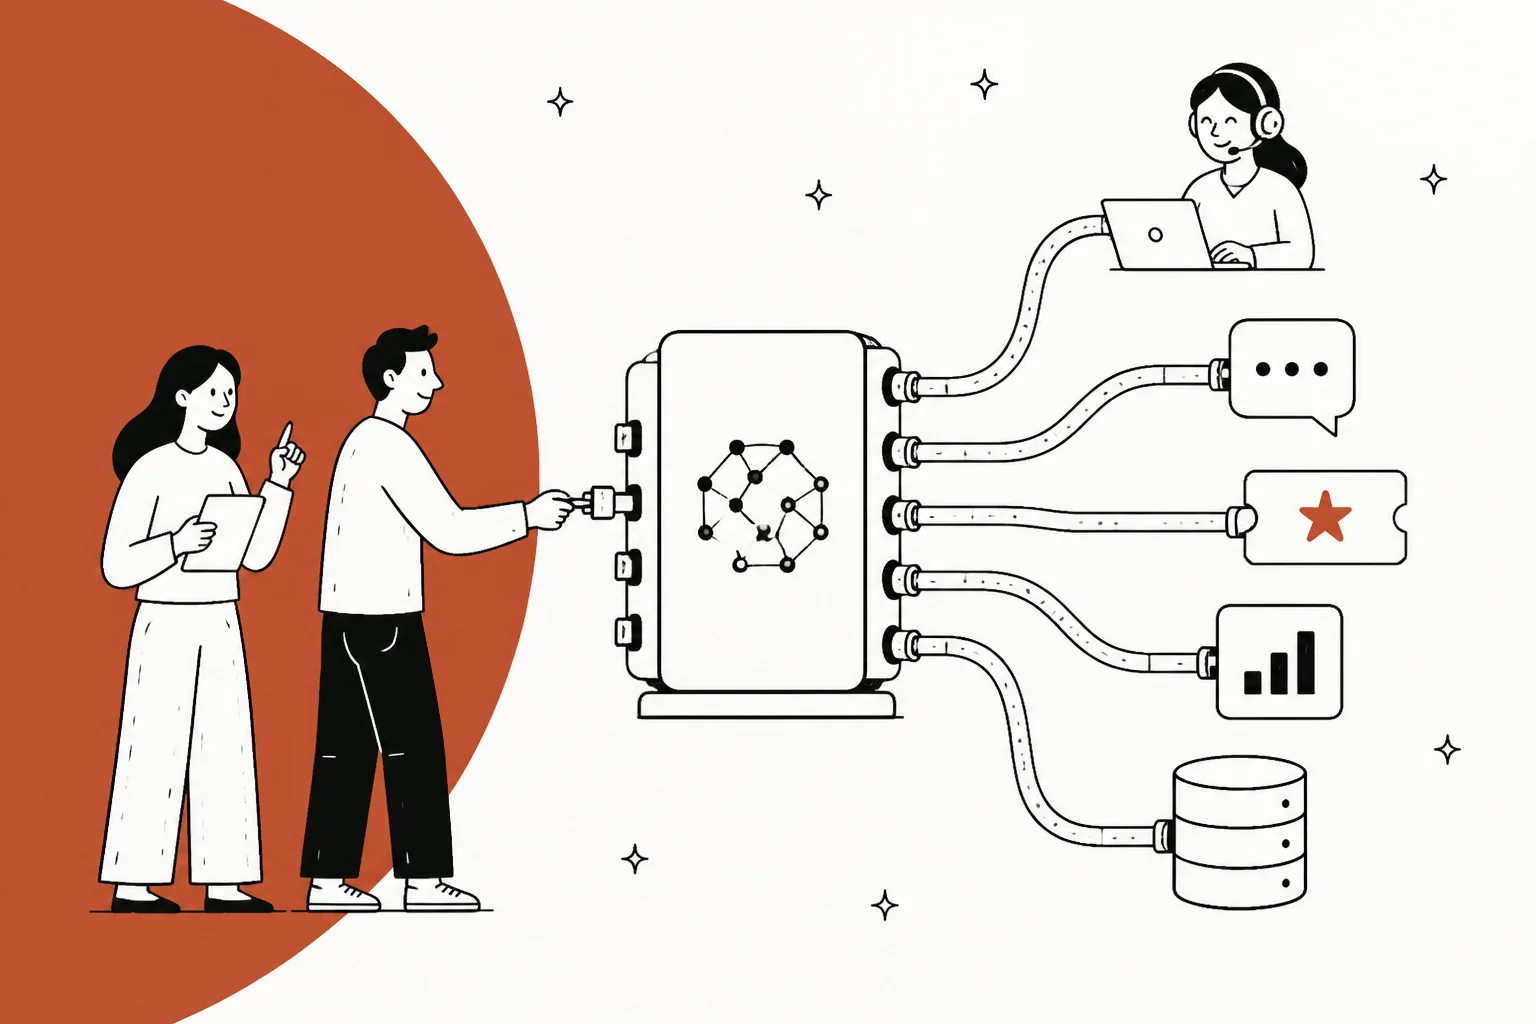
C'est le modèle mental à retenir. Le serveur se situe entre votre agent IA et votre système réel (votre helpdesk, votre base de données, votre recherche de commandes) et traduit entre les deux.
MCP lui-même est le standard qui rend cette traduction universelle. Anthropic l'a publié en open source fin 2024 pour résoudre un problème précis : chaque nouvelle source de données que l'on voulait rendre accessible à une IA nécessitait sa propre implémentation sur mesure. MCP remplace ce tas de connecteurs ponctuels par un protocole unique, si bien que vous construisez une fois et intégrez partout.
L'architecture comporte trois parties, et il vaut la peine de bien les distinguer, car « serveur MCP d'agent IA » en mélange deux :
- L'hôte MCP est l'application d'IA. Claude Desktop, Claude Code, Cursor, ou un produit support qui intègre un agent. C'est là que vit le modèle.
- Le client MCP est un connecteur à l'intérieur de l'hôte. L'hôte lance un client par serveur avec lequel il communique.
- Le serveur MCP est le programme qui expose les outils et les données.
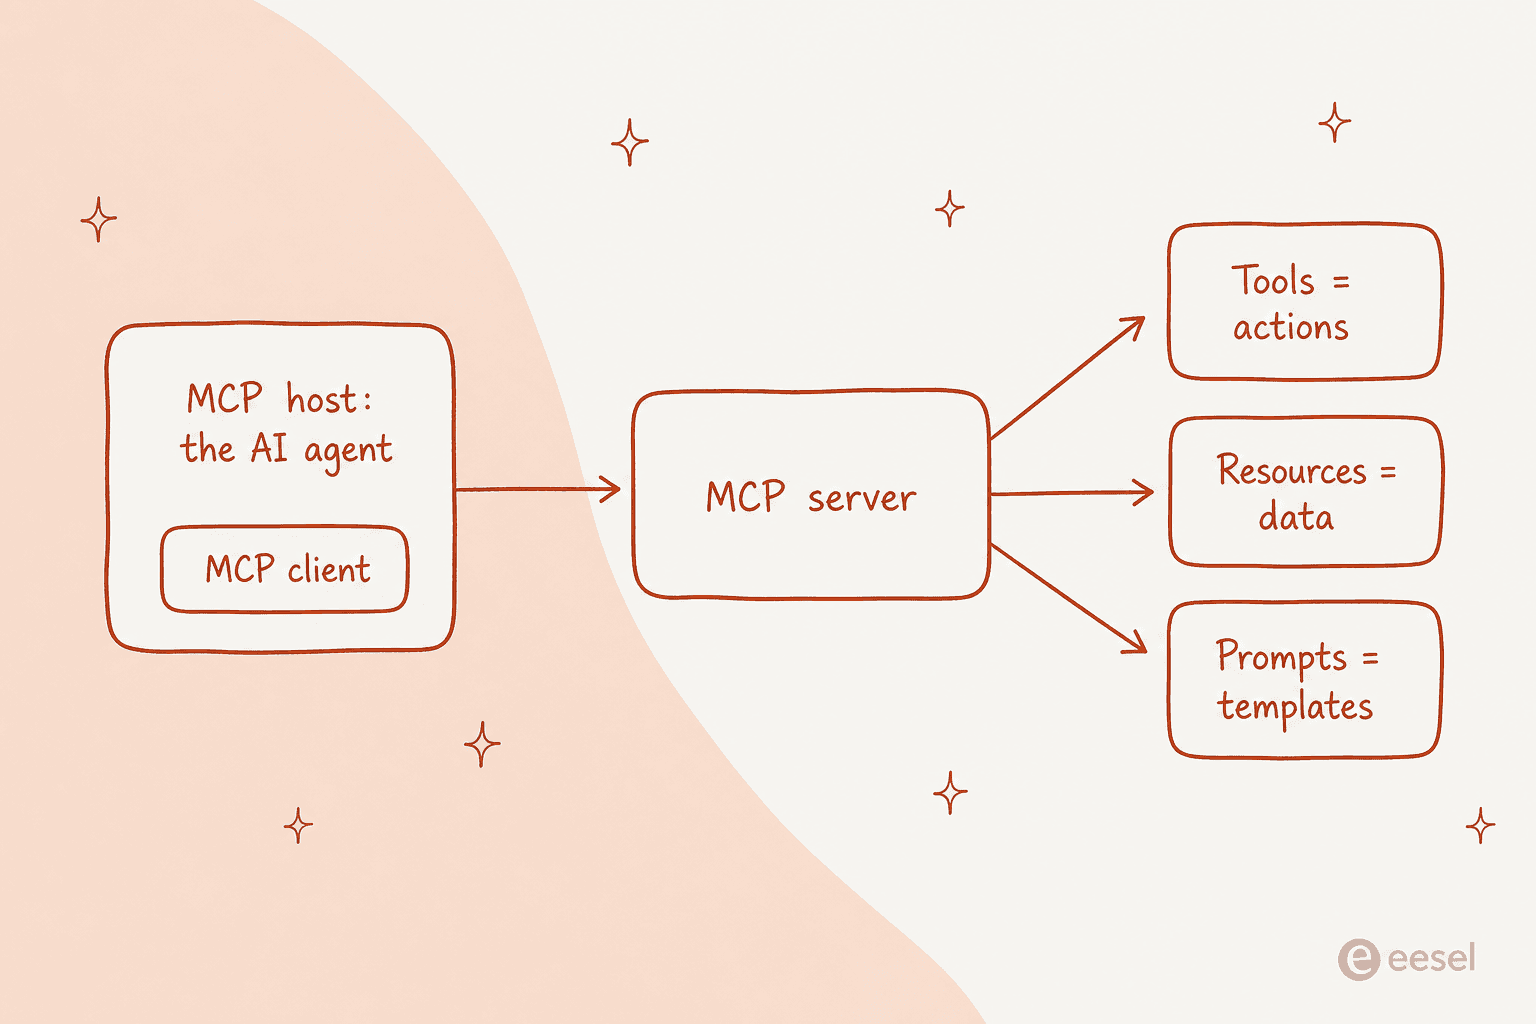
Donc quand quelqu'un dit « serveur MCP d'agent IA », il veut généralement parler du serveur auquel un agent se connecte. L'agent, c'est l'hôte plus le modèle ; le serveur, c'est ce qui se trouve à l'autre bout du fil.
Les trois choses qu'un serveur expose
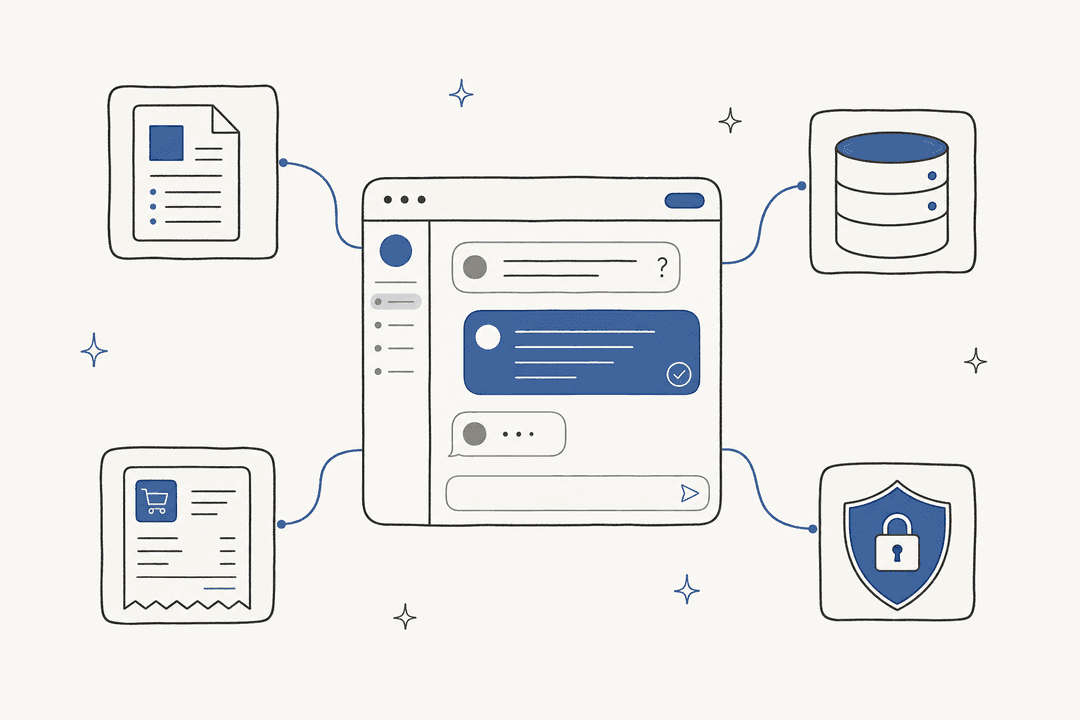
Un serveur MCP peut proposer trois types de capacités, et la documentation officielle sur les concepts de serveur trace la ligne selon qui contrôle chacune d'elles. Cette distinction compte plus qu'il n'y paraît :
| Élément | Ce que c'est | Qui le contrôle |
|---|---|---|
| Outils | Des actions que le modèle peut invoquer : consulter une commande, taguer un ticket, envoyer une réponse | Le modèle |
| Ressources | Des données en lecture seule que l'application intègre comme contexte : articles du centre d'aide, historique des tickets | L'application |
| Prompts | Des modèles réutilisables déclenchés par un utilisateur : « résume ce fil » | L'utilisateur |
Pour un agent support, les outils sont la partie intéressante, car ce sont eux qui permettent à l'agent d'agir plutôt que de simplement lire. Et la documentation est prudente sur ce point : les outils peuvent nécessiter le consentement de l'utilisateur avant exécution. Un agent capable d'envoyer une réponse à un client est exactement le genre d'action sur laquelle vous voulez une étape de validation humaine, au moins au début.
Serveurs MCP locaux ou distants
Encore une distinction, puis on passe au support. Les serveurs MCP existent en deux versions selon la façon dont ils se connectent :
- Les serveurs locaux (stdio) tournent sur la même machine que l'hôte et communiquent via l'entrée/sortie standard, sans réseau entre les deux. Quand Claude Desktop lance un serveur de système de fichiers, c'est local.
- Les serveurs distants (HTTP en streaming) tournent ailleurs et se connectent via HTTP, avec une authentification standard comme les jetons porteurs ou OAuth.
Un « serveur MCP distant » est celui qui compte pour le support. Votre helpdesk vit dans le cloud, donc quand Gorgias ou Front expose un serveur MCP, c'est un serveur distant auquel plusieurs agents peuvent se connecter à la fois. Gardez ce mot, « authentification », en tête, car il revient vous mordre plus loin.
À quoi cela ressemble dans le support client
C'est là que ça devient concret. Au cours de la dernière année, les grands helpdesks ont commencé à sortir leurs propres serveurs MCP, et le schéma est constant : ils sont excellents pour lire votre compte et prudents dès qu'il s'agit d'agir dessus.
Gorgias dispose d'un serveur MCP propriétaire sur mcp.gorgias.com, gratuit sur tous les plans Helpdesk, et sa propre documentation de configuration vous guide pour y connecter Claude. Le modèle, c'est vous qui l'apportez. Mais les lectures sont actives tandis que les modifications de macros et les écritures de configuration de l'AI Agent restent verrouillées pendant la bêta ouverte. Claude peut donc voir votre compte Gorgias via le serveur ; il ne peut pas encore le piloter entièrement.
Front en propose un aussi, sur mcp.frontapp.com, documenté sur son site développeurs, en bêta ouverte, sans barrière Enterprise, sans frais par action. Le design est la partie intéressante : chaque jeton est lié à un seul coéquipier Front et vérifié en direct par rapport au rôle de cette personne, et send_message est délibérément séparé de create_draft et signalé pour que le client confirme chaque envoi. C'est un assistant vraiment bon. Il est aussi, par conception, structurellement incapable de gérer la file d'attente tout seul.
Le serveur MCP Rovo d'Atlassian couvre Jira Service Management, et c'est l'exemple le plus net de l'écart entre accessible et résolu. Son groupe d'outils JSM compte quatre outils, tous liés aux opérations d'astreinte (alertes et plannings), sans aucun outil pour les demandes, les types de demande, les files d'attente, les SLA ou les clients du portail. Un ticket de service desk n'est accessible que via les outils Jira génériques, si bien que l'agent voit un élément de travail, pas une demande client, et ne peut pas savoir si un commentaire qu'il rédige est même visible par la personne qui a ouvert le ticket.
Mettez ces trois exemples côte à côte, et un schéma se dégage. Les serveurs MCP des helpdesks aujourd'hui se concentrent fortement à l'extrémité « accessible » du spectre :
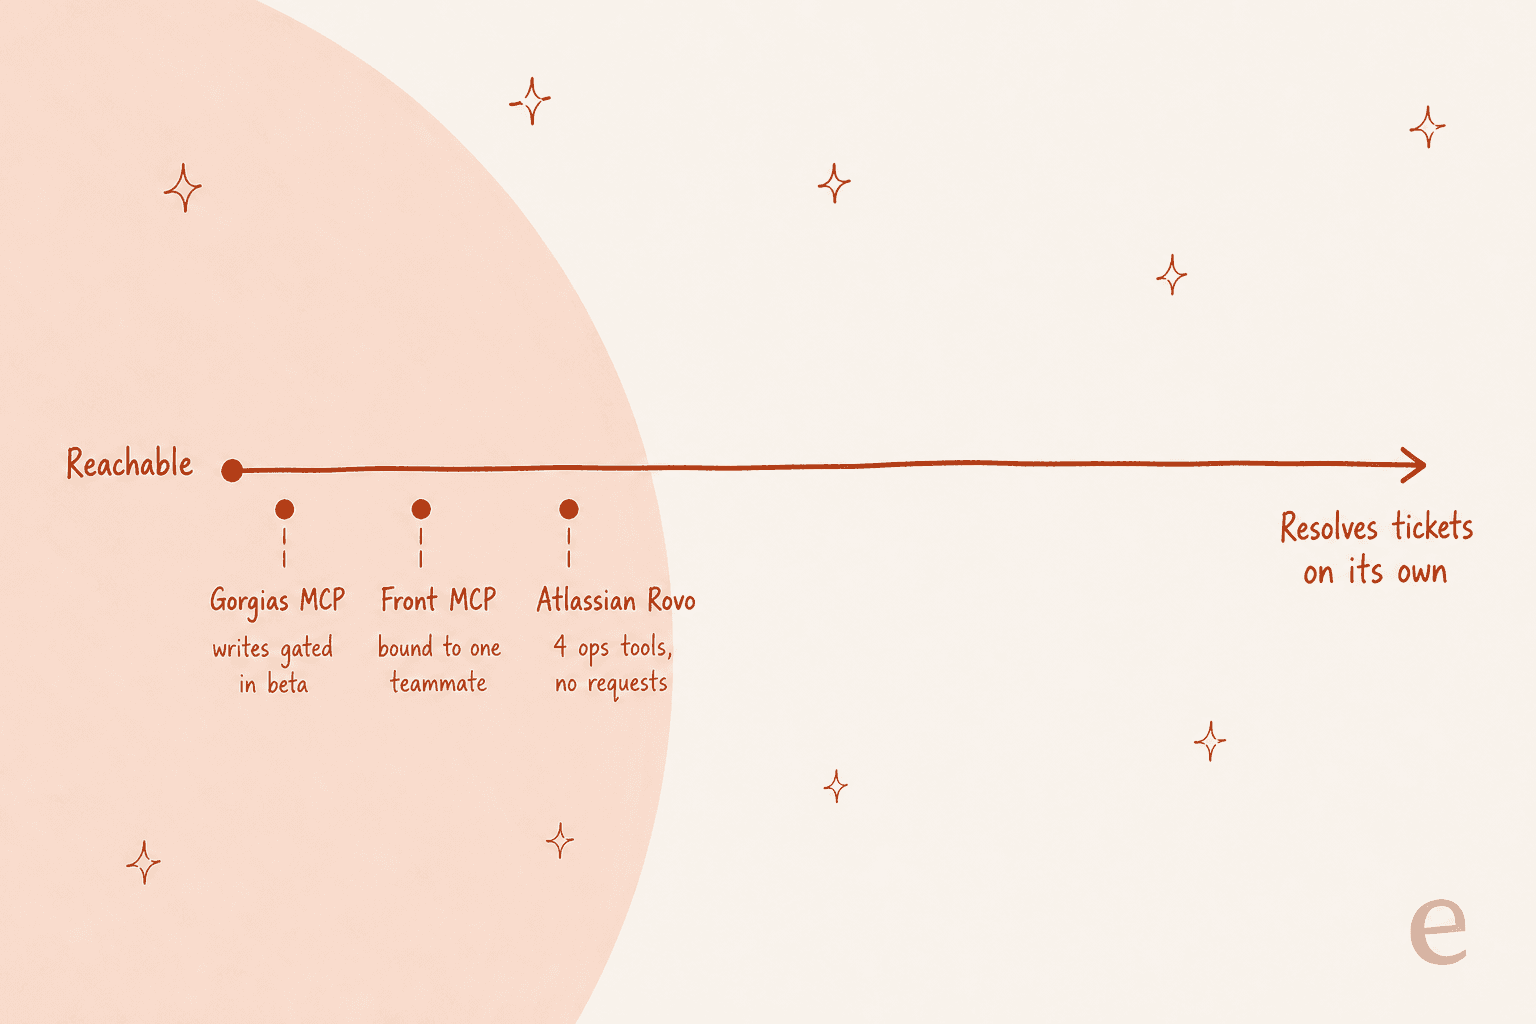
Ce n'est une critique d'aucun d'entre eux. Un serveur qui privilégie la lecture et reste prudent sur l'écriture est la manière responsable de livrer cela. Mais cela signifie que le serveur MCP vous donne un assistant bien informé, pas un agent qui ferme des tickets pendant que vous dormez. La distance entre les deux, c'est le reste de cet article.
Le piège : accessible n'est pas la même chose qu'intelligent
C'est la partie que je veux le plus voir les responsables support intégrer avant de donner le feu vert à un projet d'« intégration MCP », car il est facile de confondre la connexion avec la capacité.
Un serveur MCP est, structurellement, une fine couche de traduction. Le point le plus répété dans tous les fils techniques que j'ai lus tenait à peu près en ceci :
"Regardless of whether the MCP 'server' is local or remote, it is JUST a wrapper around APIs. It's basically a translation layer to make your APIs adhere to the MCP spec, that's it."
Si le serveur est un wrapper, où se déroule le vrai travail de support ? En dessous. Mettre en place le serveur est la petite partie visible. Ce qui détermine si votre agent vaut quelque chose, c'est la pile sous la ligne de flottaison :
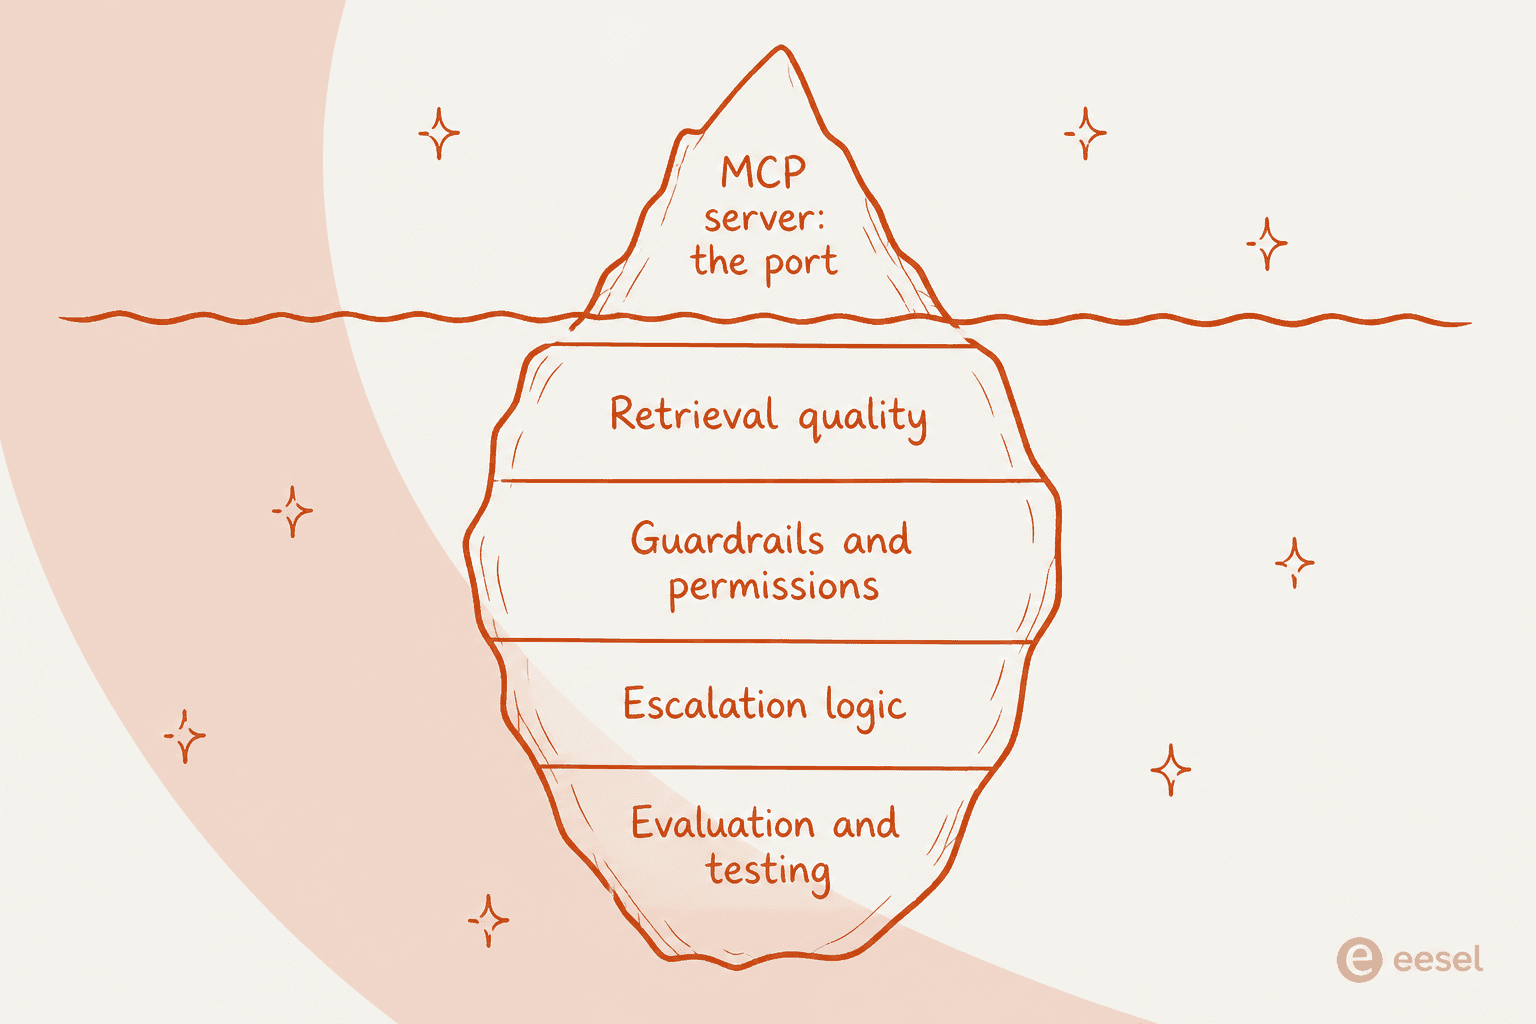
Trois de ces couches méritent d'être détaillées, car chacune est un endroit où un serveur MCP brut vous laisse seul.
Qualité de la recherche documentaire. Exposer votre base de connaissances comme une ressource est facile ; amener un agent à bien s'en servir ne l'est pas. Un développeur a décrit précisément le mode d'échec :
"There's very little actual engineering going in to designing MCP interfaces to actually efficiently work with the way LLM workflows actually operate. Many MCPs offer tools that allow an LLM to retrieve a list of 'things that exist' with the expectation the LLM will then pick something out of that list... massive lists of 'things that exist' eat tokens and context."
Un agent support qui déverse 400 articles d'aide dans son contexte en espérant que le modèle choisisse le bon est une démo, pas un produit. La conception de la recherche documentaire (comment vous découpez, classez et cadrez ce que voit l'agent) est ce qui fait gagner ou perdre le taux de résolution, et MCP ne fait rien pour vous sur ce plan.
Sécurité et permissions. Rappelez-vous ce signal « authentification » évoqué plus haut. Le protocole est sorti avec un dispositif d'authentification notoirement mince, et les avertissements les plus tranchants portent précisément sur les données avec lesquelles travaille le support :
"Most providers don't support auth in their client implementations yet. Means it's only good for calling into public data. Private enterprise data is where there's huge value."
Tickets clients, historiques de commandes, dossiers de comptes : ce sont toutes des données privées d'entreprise. Il existe aussi une véritable surface d'injection de prompts, où les paramètres mêmes d'un outil deviennent la voie d'exfiltration. Rien de tout cela n'est résolu par la simple existence du serveur ; c'est résolu par les garde-fous que vous construisez autour de lui.
Le jugement de l'agent. MCP standardise la connexion et, délibérément, ne dicte pas la façon dont l'application utilise le modèle ni la manière dont elle gère le contexte. Ce qui est la lecture honnête de ce qu'est ce protocole :
"MCP 'universal plugin system' claims are oversold. It is really just a standardized tool calling for AI agents... The 'system integration' benefits only matter when you have an LLM in the loop making decisions about which tools to use."
Le LLM dans la boucle, en train de prendre des décisions, c'est le produit. Le serveur MCP est le câble qui le relie. Les deux sont nécessaires. Un seul des deux est la partie difficile.
Le construire soi-même, ou embaucher un coéquipier qui l'est déjà
Vous avez donc deux voies honnêtes, et celle qui vous convient dépend de la part de cette pile immergée que vous voulez posséder vous-même.
Le construire soi-même. Reliez un agent au serveur MCP de votre helpdesk (ou écrivez votre propre wrapper), puis construisez autour la recherche documentaire, les garde-fous, la logique d'escalade et le harnais d'évaluation, et assumez la facture du modèle au token sur chaque message, résolu ou non. C'est le bon choix si l'automatisation du support est un produit que vous construisez, pas une tâche que vous voulez voir accomplie. Vous obtenez un contrôle total et vous le payez en temps d'ingénierie. Les articles sur l'API d'agent de support client et l'API de helpdesk IA approfondissent cette voie si vous l'envisagez.
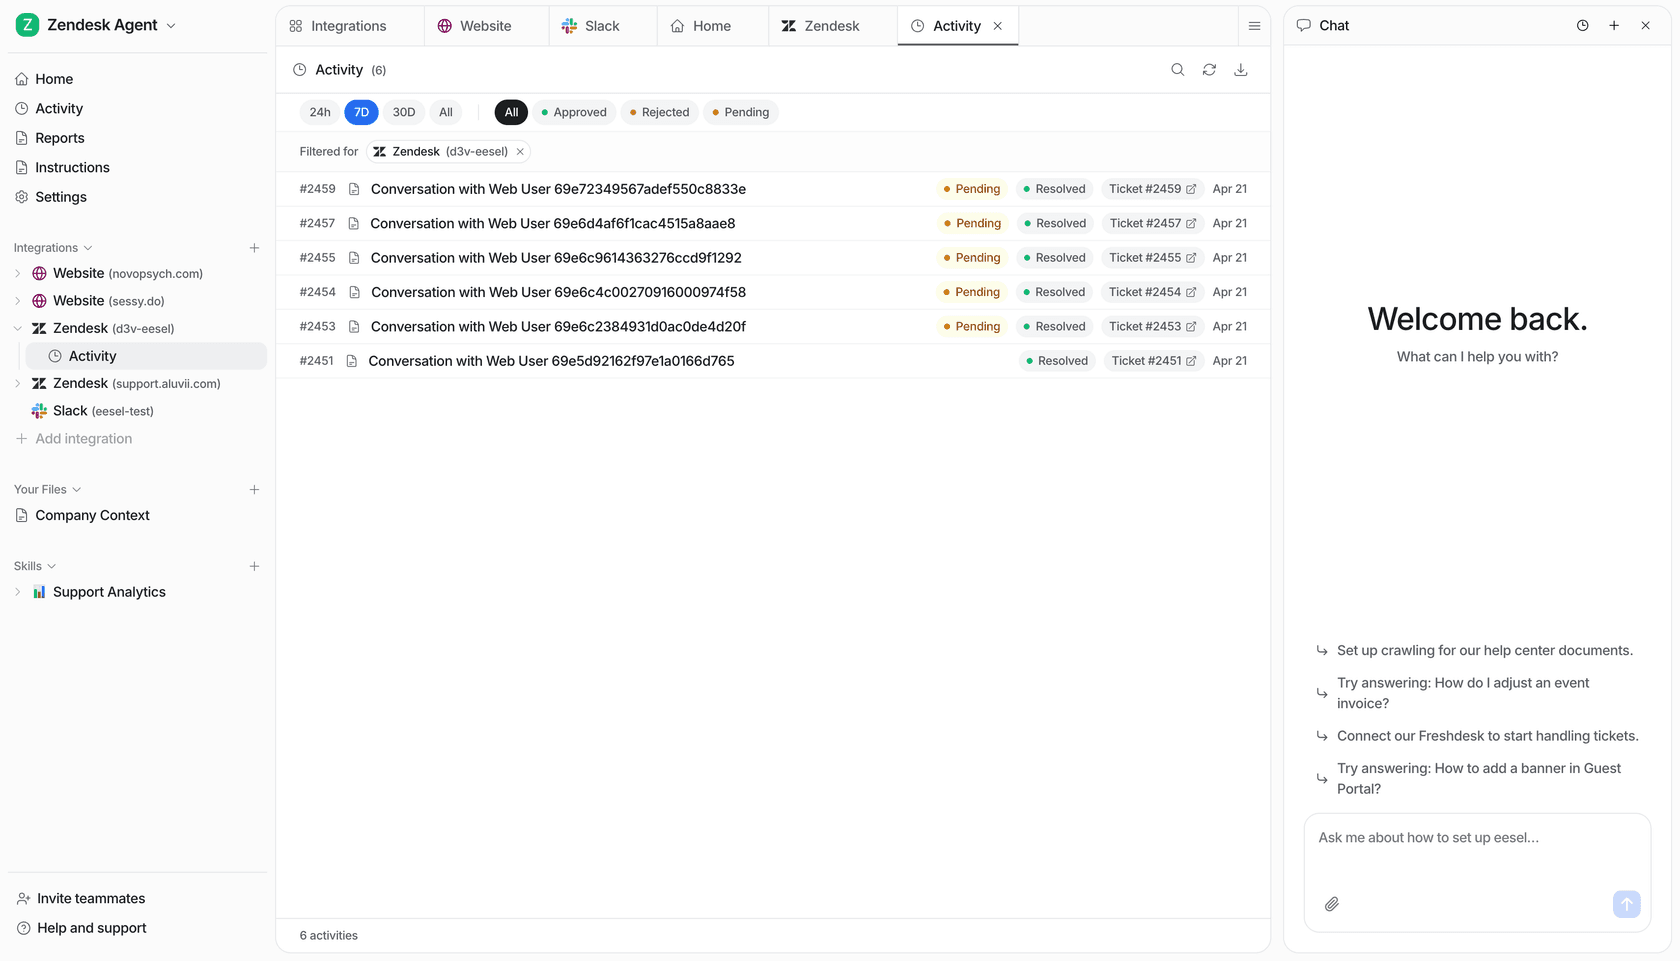
Embaucher un coéquipier qui fournit toute la pile. C'est là que j'orienterais la plupart des équipes support, et c'est ce pour quoi eesel est conçu. Au lieu d'un serveur MCP qu'il faut envelopper dans quatre couches supplémentaires, eesel est un coéquipier IA pour helpdesk prêt à l'emploi, qui arrive avec la recherche documentaire, les garde-fous, la logique d'escalade et le contexte de l'entreprise déjà en place. Il se branche sur le helpdesk que vous utilisez déjà (Zendesk, Freshdesk, Gorgias, Front, Help Scout) et s'entraîne sur vos tickets passés et votre centre d'aide, ce qui le rapproche davantage d'une nouvelle recrue que d'un protocole.
Et pour boucler la boucle de tout cet article : chaque espace de travail eesel est lui-même un serveur MCP. Exécuter npx @eesel/cli mcp token affiche une URL et un jeton pour que Claude, Cursor ou n'importe quel client MCP puisse piloter votre agent eesel, et cette même surface programmable inclut une véritable CLI, des webhooks et un accès API sortant avec authentification par domaine. Vous obtenez ainsi la partie accessible et la partie intelligente au même endroit.
Le point de différenciation que je soulignerais le plus fort est celui que le chemin du MCP brut ne peut pas vous offrir : une simulation que vous exécutez sur des milliers de vos propres tickets historiques avant que l'agent ne touche un client réel. Nous avons construit cela parce que nous avons vu des bots à l'air sûr d'eux donner discrètement de mauvaises réponses, et un 200 OK renvoyé par un serveur MCP vous dit seulement que la connexion a fonctionné, jamais que la réponse était correcte. La simulation, c'est comment vous le découvrez avant vos clients.
Essayez eesel
Si vous êtes arrivé jusqu'ici, vous connaissez déjà la version honnête : un serveur MCP est le connecteur, pas l'agent. En câbler un à votre helpdesk représente le travail d'un bon après-midi ; construire la recherche documentaire, les garde-fous et l'évaluation autour, c'est le travail d'un trimestre.
eesel fait l'impasse là-dessus. C'est un coéquipier IA pour helpdesk qui s'installe sur votre helpdesk existant en quelques minutes, s'entraîne sur vos tickets et documents passés, et arrive avec toute la pile, serveur MCP inclus. Vous pouvez le simuler sur vos propres tickets historiques pour voir le taux de résolution avant la mise en service, conserver une étape de validation humaine sur les réponses, et c'est en libre-service à 0,40 $ par ticket résolu, sans frais par poste. Gratuit à l'essai.
Questions fréquentes
Qu'est-ce qu'un serveur MCP d'agent IA ?
Un serveur MCP est-il la même chose qu'un agent IA ?
Les grands helpdesks ont-ils un serveur MCP ?
Combien coûte l'exploitation d'un serveur MCP d'agent IA pour le support ?
Quels sont les risques de sécurité d'un serveur MCP ?


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.