Ce que les gens veulent vraiment dire par "API d'agent de support client"
Cherche "customer support agent API" et tu obtiendras des résultats qui n'ont presque rien à voir entre eux. C'est parce que l'expression regroupe trois métiers vraiment différents en une seule formule, et le lecteur derrière chaque résultat veut une chose différente.
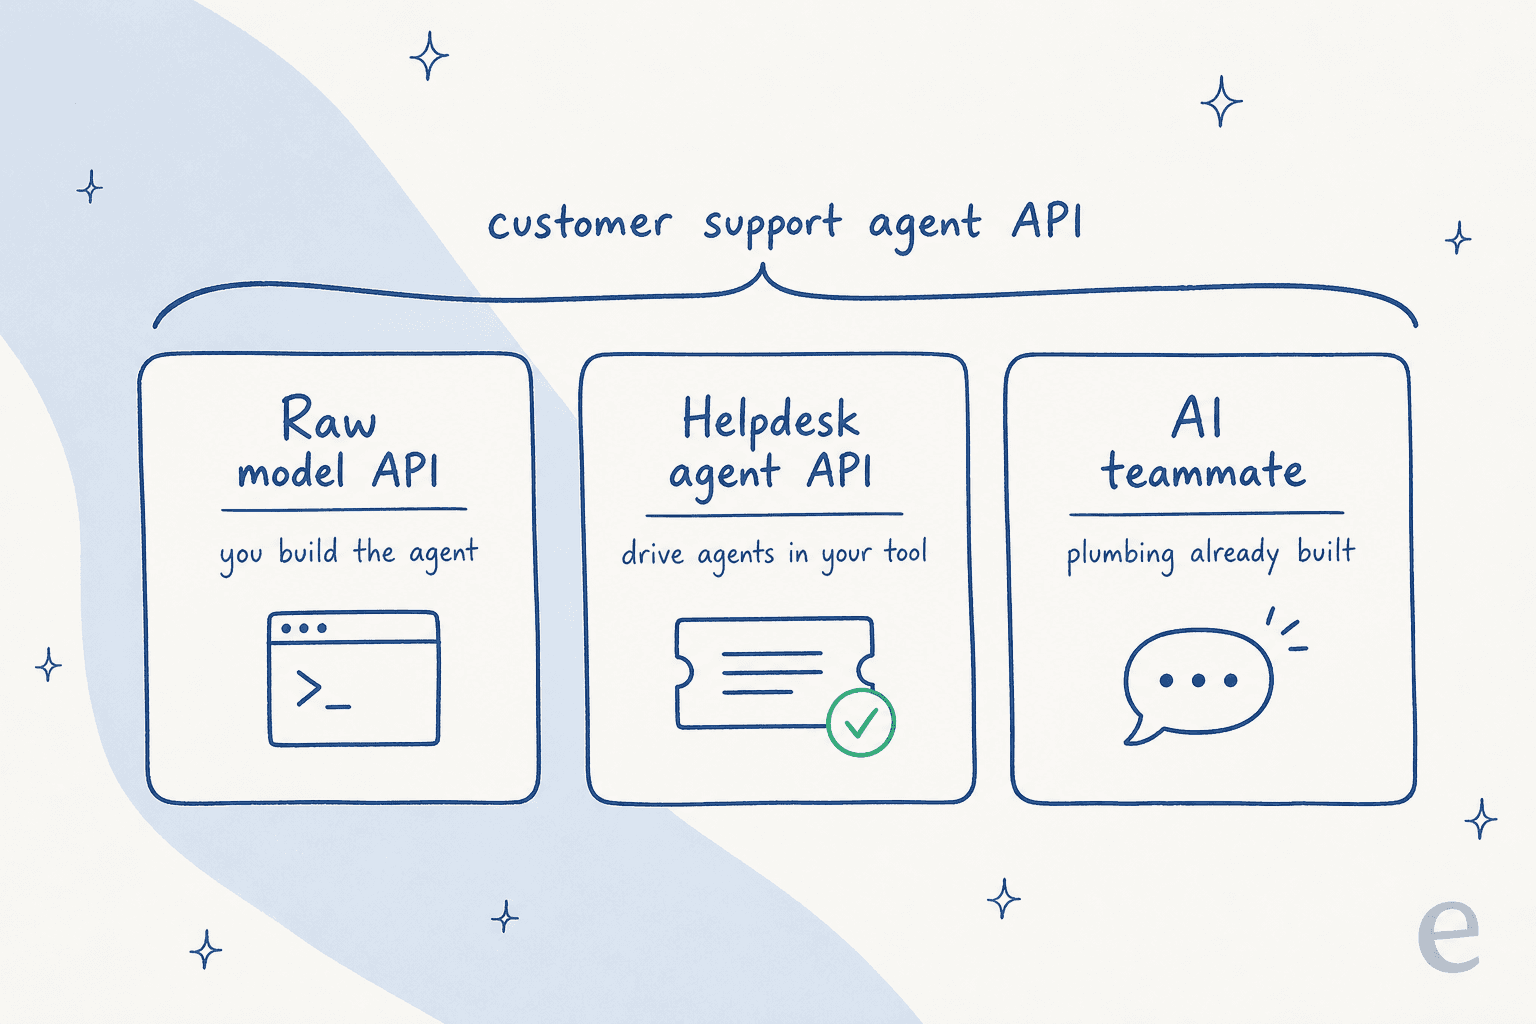
Les trois voies, classées selon la part que tu construis toi-même :
- Construis le tien sur une API de modèle de fondation. Tu obtiens un modèle et des primitives ; tu assembles l'agent.
- Pilote ton helpdesk via son API d'agent, de conversations ou MCP. Le fournisseur possède la surface de support ; tu y pointes un agent.
- Embauche un coéquipier déjà prêt qui sait déjà faire du support. La tuyauterie est construite ; tu configures et tu passes en production.
Je vais parcourir chacune, ce qu'elle t'apporte réellement, et où se cache le travail invisible. Si tu ne dois retenir qu'une chose de cet article : l'API n'est jamais l'agent. Voyons pourquoi.
Voie 1 : construire soi-même sur une API de modèle brute
C'est la voie que la plupart des ingénieurs imaginent en premier, et c'est celle qui se transforme silencieusement en projet de neuf mois. OpenAI et Anthropic vendent tous deux de l'infrastructure de modèle, pas un agent de support fini. Ils excellent dans ce qu'ils font. Ils couvrent simplement une part bien plus réduite de "l'agent de support client" que ce que l'expression laisse entendre.
Voici ce que tu obtiens. La Responses API d'OpenAI est la principale surface d'appel, et l'Agents SDK open source fait tourner la boucle de l'agent dans ton propre processus. La documentation d'OpenAI est sans détour sur la répartition : tu possèdes "le déploiement, les implémentations d'outils, le stockage d'état et les décisions d'approbation, tandis que le SDK exécute la boucle de l'agent". Chez Anthropic, la logique est la même. La Messages API associée à l'utilisation d'outils te donne un appel d'outil structuré ; ton code l'exécute. Le Claude Agent SDK ajoute des sessions, des hooks, des sous-agents et des permissions, mais la boucle tourne toujours dans ton processus et la persistance reste ton intégration.
Les deux te donnent les mêmes briques : un modèle, un moyen de définir des outils, une boucle d'agent, des primitives de récupération hébergées (la recherche de fichiers d'OpenAI, l'utilisation d'outils côté serveur chez Anthropic) et, pour le support vocal, la Realtime API d'OpenAI. Ce qu'aucun des deux ne te donne, c'est l'agent de support à proprement parler.
Ce que l'API te livre par rapport à ce que tu construis
L'écart est plus grand qu'il n'y paraît sur un quickstart. Une fonction "retrouver la commande et émettre le remboursement" est un appel d'outil que le modèle émet ; le code qui parle à Shopify et à ton système de facturation est entièrement le tien. C'est vrai pour chaque autre pièce structurelle d'un agent de support.
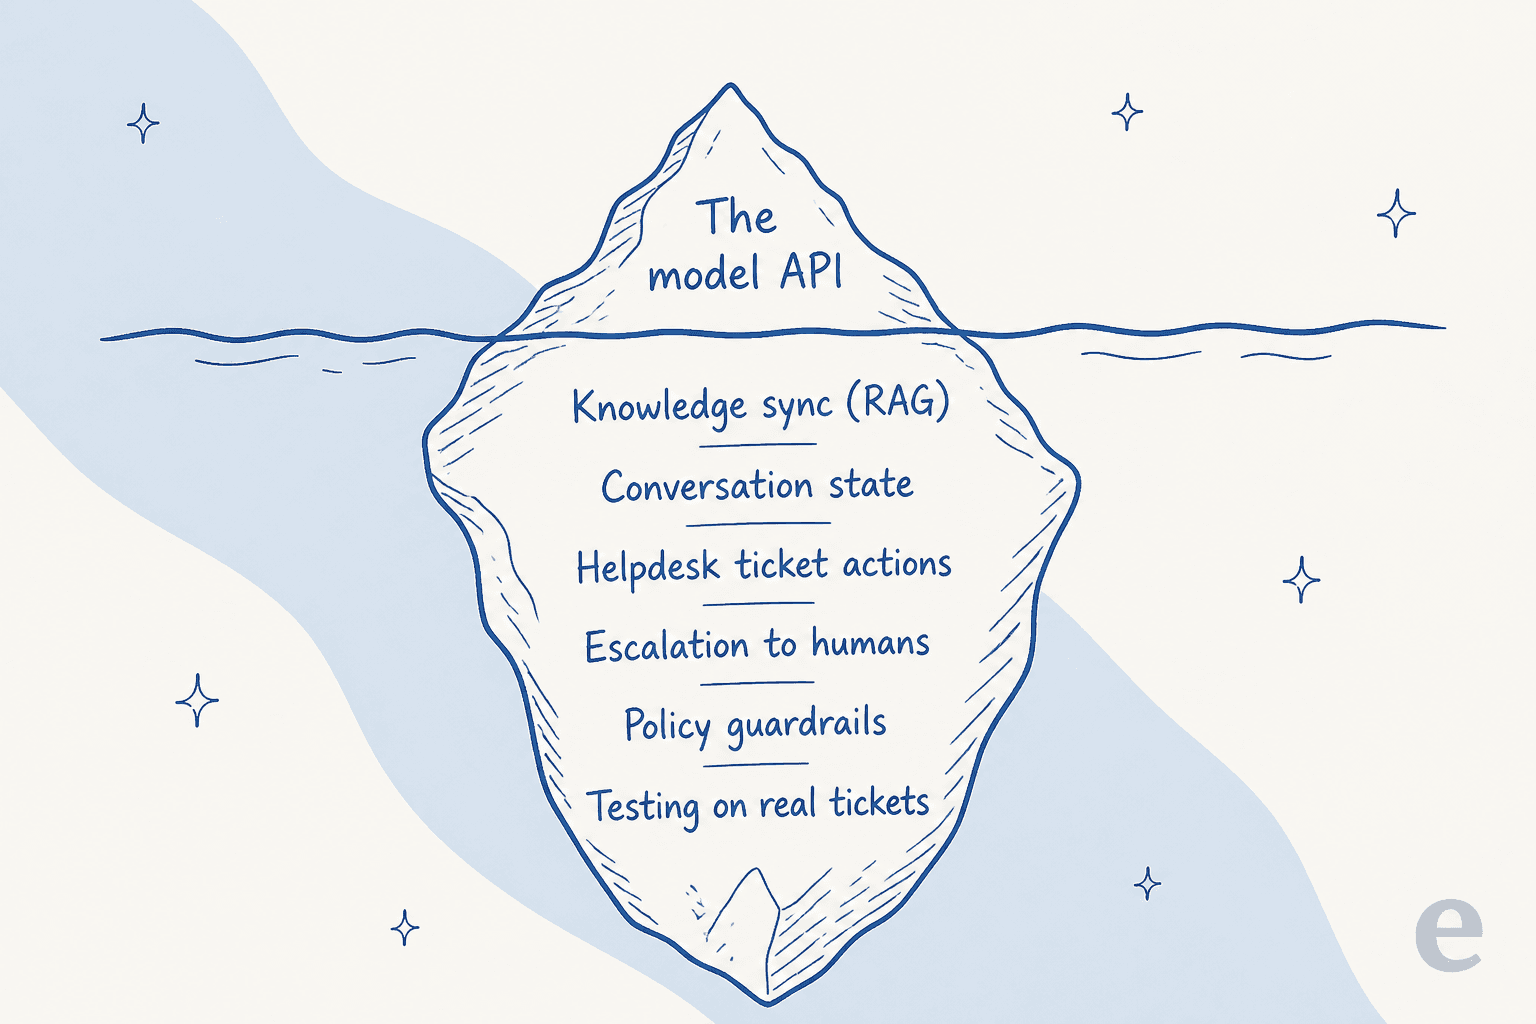
Tout ce qui se trouve sous la ligne de flottaison, c'est ton ingénierie :
- Synchronisation des connaissances et récupération. La recherche de fichiers et l'utilisation d'outils te donnent un mécanisme de récupération, mais le garder synchronisé avec ton centre d'aide en production, plus le chunking, le reranking et le contrôle d'accès, c'est à toi de le faire.
- État de la conversation. Les API de base sont sans état d'un appel à l'autre. Tu stockes et renvoies l'historique toi-même.
- Actions sur les tickets. Mettre à jour un ticket Zendesk, escalader vers le niveau 2, appliquer un tag : autant d'outils fonctionnels que tu implémentes.
- Guardrails et escalade. Les deux SDK exposent des guardrails d'entrée, de sortie et d'outil, plus une approbation humaine, mais chacun est du code que tu écris selon ta politique.
- Tests contre des tickets réels. Tu obtiens du tracing et des hooks d'évaluation. La suite qui rejoue ton historique et note les réponses, c'est ta construction.
Ce n'est pas une critique des fournisseurs de modèles. C'est simplement le périmètre honnête. Si tu veux la comparaison plus poussée des primitives, notre analyse AgentKit vs Anthropic API passe en revue outil par outil.
La facture au token que personne n'anticipe
Le modèle de coût est la surprise la plus aiguë. Tu paies au token pour chaque message, que le ticket soit résolu ou non, pour le prompt système, les extraits de connaissances récupérés, les allers-retours des appels d'outils, le raisonnement du modèle et chaque nouvelle tentative.
Tarifs approximatifs des fournisseurs eux-mêmes, par million de tokens sur le palier standard :
| Modèle | Entrée | Entrée en cache / hit | Sortie |
|---|---|---|---|
| OpenAI gpt-6-astra | 10,00 $ | 1,00 $ | 50,00 $ |
| OpenAI gpt-5.6-terra | 2,00 $ | 0,20 $ | 12,00 $ |
| Anthropic Claude Opus 5 | 5,00 $ | 0,50 $ | 25,00 $ |
| Anthropic Claude Sonnet 5 | 2,00 $ | 0,20 $ | 10,00 $ |
| Anthropic Claude Haiku 4.5 | 1,00 $ | 0,10 $ | 5,00 $ |
La mise en cache des prompts aide beaucoup en support, puisque tu renvoies le même contexte de centre d'aide à chaque tour : un hit de cache est facturé à environ 10 % du prix standard en entrée. Mais la mise en cache adoucit le chiffre, elle ne change pas l'unité de facturation. Une conversation de support qui dure dix tours, récupère douze extraits à chaque tour et échoue deux fois avant de réussir, facture tout cela, même si le client repart mécontent.
Voie 2 : piloter ton helpdesk via sa propre API d'agent
La deuxième voie fait l'impasse sur la construction de l'agent complet et pointe plutôt un agent vers le helpdesk que tu utilises déjà. Chaque grand helpdesk expose une surface programmatique, et la forme de cette surface a beaucoup changé au cours de la dernière année.
La version classique est une API REST plus des webhooks. Prends Zendesk. Tu peux brancher un modèle externe par quatre voies : un connecteur propriétaire avec ta propre clé, un webhook depuis un déclencheur vers ton propre service et retour via l'API REST, une app en barre latérale qui appelle le modèle via le proxy de Zendesk, ou un serveur MCP. Ça fonctionne, mais le pipeline fait maison (voie deux) signifie que tu es responsable de l'authentification, du polling, des nouvelles tentatives et, surtout, des limites de débit. Ces limites sont le plafond dur de toute intégration :
| Plan Zendesk Suite | Requêtes API / minute |
|---|---|
| Team | 200 |
| Growth | 400 |
| Professional | 400 |
| Enterprise | 700 |
| Enterprise Plus | 2 500 |
Chaque enrichissement, chaque réécriture et chaque retraitement de tickets historiques puise dans le même budget par minute. On l'oublie facilement jusqu'à ce qu'un job de retraitement en masse le dépasse.
Le MCP change discrètement cette voie
Le changement le plus important, c'est que les helpdesks sont passés de "voici une API REST, débrouille-toi" à la fourniture de leurs propres serveurs Model Context Protocol. Le MCP est un standard ouvert, introduit par Anthropic, pour connecter des agents à des systèmes externes via un protocole standardisé unique, plutôt qu'une intégration sur mesure par outil. La façon dont Zendesk décrit lui-même l'ancienne douleur en dit long : connecter des données en temps réel à l'IA aujourd'hui "nécessite des API, un développeur expérimenté (ou deux) et de longs délais", et l'entreprise met désormais en avant un client MCP Zendesk où, "contrairement aux API, les intégrations MCP n'ont besoin d'être configurées qu'une seule fois".
La liste des serveurs propriétaires s'allonge rapidement :
- Gorgias propose un serveur MCP gratuit sur
mcp.gorgias.com/mcp, désormais en bêta ouverte, qui connecte un espace de travail à n'importe quel client compatible MCP. - Front documente un serveur sur
mcp.frontapp.com/mcpavec un modèle de permissions étonnamment propre : OAuth 2.1 avec PKCE, des tokens par utilisateur, et les scopesread,write,send, de sorte que "les permissions effectives de l'agent sont exactement celles du coéquipier qui autorise". - Atlassian exploite un serveur MCP distant officiel qui connecte Jira, Confluence et Jira Service Management à des agents via OAuth. Pour un public ITSM, c'est le principal moyen de piloter un service desk depuis un agent.
C'est une vraie bonne nouvelle pour le calcul acheter contre construire. La tuyauterie qu'il fallait autrefois écrire à la main, le fournisseur la maintient désormais. Ce que le MCP ne résout pas, c'est l'agent lui-même : le serveur expose des outils, mais le cerveau, la qualité de la récupération et les guardrails qui décident quand réellement émettre ce remboursement restent à ta charge. Si tu veux la version sans code pour connecter un modèle à un helpdesk, notre guide sur l'intégration de ChatGPT avec Zendesk couvre ça.
Voie 3 : embaucher un coéquipier qui apporte la tuyauterie
La troisième voie est celle qui correspond à ce que la plupart des gens qui tapent "customer support agent API" veulent réellement : un agent qui sait déjà faire du support, qu'ils peuvent pointer vers leur propre stack et configurer, plutôt que d'assembler. C'est là qu'un outil comme eesel se positionne, et il vaut la peine d'être précis sur ce qui en fait une catégorie différente des deux premières voies plutôt qu'un simple emballage plus joli.
Un coéquipier de helpdesk IA arrive avec tout l'iceberg déjà construit. Il s'entraîne sur tes tickets passés et ton centre d'aide, rejoint la file d'attente à l'intérieur du helpdesk que tu utilises déjà, consulte les commandes, tague et trie, et rédige ou envoie des réponses. La pile de récupération, l'état de la conversation, les actions sur les tickets et la logique d'escalade sont tous pris en charge. Tu configures un comportement, tu n'implémentes pas d'infrastructure.
Ce qui compte le plus pour un développeur, c'est que "déjà prêt" ne veut pas dire "boîte fermée". eesel conserve une véritable surface programmable pour les cas limites que les réglages par défaut ne couvrent pas :
- Network Access permet à l'agent d'appeler n'importe quelle API REST que tu autorises, avec GET, POST, PATCH et DELETE, et des en-têtes d'authentification par domaine. Les identifiants sont stockés en en-têtes et ne sont jamais montrés au modèle.
- Webhooks donnent à n'importe quel outil une URL unique qui réveille l'agent avec ce qu'il envoie.
- Une CLI et des skills personnalisées te permettent de scripter les parties que tu veux garder la main dessus, et une seule skill peut couvrir plusieurs outils en une exécution : lire le helpdesk, vérifier Shopify, poster sur Slack.
La distinction que je retiendrais : une API de modèle brute, c'est de l'infrastructure, et eesel, c'est l'employé. Tu continues d'écrire du code là où le code apporte de la valeur ; tu n'as simplement pas besoin de reconstruire la récupération, l'état et les connecteurs de helpdesk à partir de zéro pour y arriver.
Les 90 % que le mot "API" cache toujours
Voici où je remettrais en question le réflexe de construire soi-même. Le consensus des développeurs qui ont réellement livré des agents de support est remarquablement cohérent, et ce n'est pas "ne construis jamais". C'est que l'appel au modèle est la partie facile, et que la maintenance continue est là où se trouve le coût.
Commence par la récupération, que tout le monde sous-estime. Le fil RAG le plus commenté sur Hacker News (551 points) est un post-mortem sur le traitement de plus de 5 millions de documents, et un ingénieur de Microsoft qui maintient un template RAG open source populaire s'est opposé fermement au réflexe "ajoute juste une base vectorielle" :
"So few developers realize that you need more than just vector search for RAG, so I still spend many of my talks emphasizing the FULL retrieval stack for RAG."

La conclusion de l'auteur original lui-même était qu'une récupération en un seul coup ne suffit pas ; on finit par avoir besoin d'une boucle agentique qui évalue les résultats et fait des requêtes de suivi. C'est un vrai système, pas une option de configuration.
Ensuite, il y a le problème qu'un agent de support peut agir, pas seulement parler. Sur un Ask HN à propos de la prévention des hallucinations en production, la formulation la plus percutante portait exactement là-dessus :
"The failure mode I keep seeing isn't hallucination per se... it's blurred responsibility between intent and execution. Once a model can both decide and act, you've already lost determinism."
Un agent capable d'émettre des remboursements ou de modifier l'état d'un compte a besoin d'espaces d'action contraints et de listes d'autorisation/interdiction, pas seulement d'un meilleur prompt. Et tu ne peux pas savoir si tes guardrails tiennent sans tests, ce que presque personne ne fait correctement. Comme le formulait un fil r/AI_Agents, "aucune erreur levée" et "tâche accomplie" peuvent être vrais tous les deux alors que la réponse était fausse d'une manière qui compte. C'est l'argument le plus fort en faveur de la simulation : rejouer de vrais tickets passés et noter les réponses de l'agent par rapport à ce que ton équipe a réellement envoyé, dans un bac à sable, avant qu'il ne touche une file en production. C'est l'une des skills centrales d'eesel exactement pour cette raison, et c'est ce qu'une construction à partir de zéro omet presque toujours.
Enfin, la maintenance continue, qui est le vrai chiffre. Le rappel à la réalité le plus cité, tiré d'un fil r/AI_Agents avec plus de 460 commentaires, le nomme directement :
"The hardest part wasn't the LLM or voice quality - it was keeping the agent's knowledge current as policies changed and edge cases emerged."

C'est la maintenance que la plupart des plans de construction maison ne budgétisent jamais. Nous faisons tourner de l'IA sur des files de support en production depuis des années, et les cas limites, c'est tout le travail : la politique qui a changé la semaine dernière, la gamme de produits lancée hier, ce flux de remboursement bizarre qui casse tout agent générique. C'est exactement le travail qui n'apparaît pas dans un quickstart et qui ne s'arrête jamais.
Au token contre au résultat : le modèle de coût qui décide vraiment
Prends du recul, et les trois voies se répartissent nettement selon un seul axe : la façon dont tu paies. Les voies un et deux te placent sur un compteur au token. Un agent déjà prêt facture plutôt, typiquement, à l'unité de travail résolu.
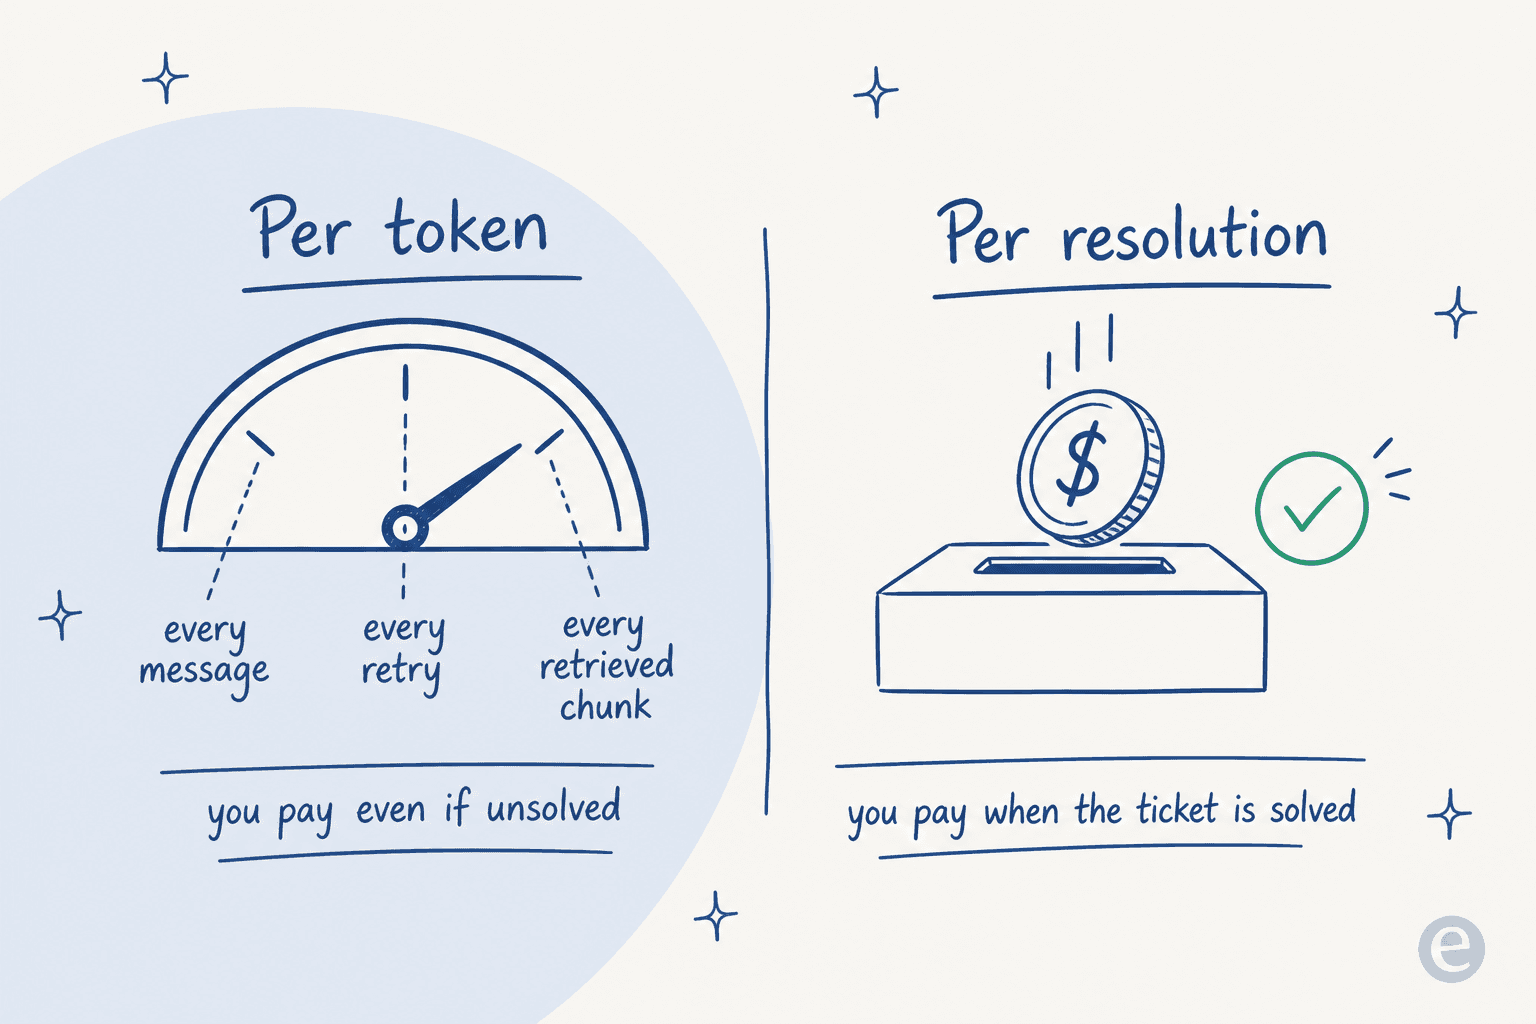
La différence n'est pas académique. Au token signifie une facture illimitée, à la forme de l'usage, que tu dois anticiper et plafonner, et elle grimpe avec chaque nouvelle tentative et chaque conversation longue, résolue ou non. La tarification au résultat lie la dépense au travail réalisé. eesel, par exemple, est facturé à l'usage, environ 40 centimes de dollar par ticket traité, facturé par ticket ou par conversation de helpdesk plutôt que par réponse, sans frais par siège, sans frais de plateforme et sans minimum mensuel. Ajoute le salaire d'ingénierie derrière un agent construit maison et les heures de maintenance qu'il consomme chaque semaine, et la voie DIY "moins chère" ne l'est souvent pas. Comme le disait un développeur, les agents qui "font gagner 10 minutes par jour mais coûtent discrètement des heures par semaine en maintenance" sont le piège ; le vrai coût n'est jamais dans la construction.
Alors, quelle voie devrais-tu vraiment choisir ?
Aucune de ces voies n'est mauvaise. Elles conviennent à des équipes différentes. Voici la version courte, puis un moyen rapide de te situer.
Et les mêmes arbitrages sous forme de tableau :
| Dimension | API de modèle brute | Agent de helpdesk / API MCP | Coéquipier déjà prêt |
|---|---|---|---|
| Tu construis l'agent | Oui, entièrement | Le cerveau et les guardrails | Non, tu le configures |
| Récupération / synchronisation des connaissances | À toi | À toi | Intégré |
| Connecteurs de helpdesk | À toi | Au fournisseur (une plateforme) | Intégrés (1000+) |
| Tester avant la mise en production | Tu construis le harnais de test | Tu construis le harnais de test | Simulation sur des tickets passés |
| Unité de facturation | Au token | Au token + limites de plan | Par ticket traité |
| Délai avant le premier ticket résolu | Semaines à mois | Jours à semaines | Minutes à heures |
| Code sur mesure toujours possible | Totalement | Totalement | Network Access, CLI, skills |
Si tu explores encore le paysage plus large, nos comparatifs des meilleurs agents IA et de la meilleure IA pour le triage des tickets passent en revue outil par outil.
Essayer eesel
Si tu es arrivé jusqu'ici en pesant "construire sur une API de modèle" contre "acheter un agent", la réponse honnête pour la plupart des équipes de support est que la construction maison paraît moins chère sur un quickstart et coûte plus cher en année deux. eesel est la troisième voie faite correctement : un coéquipier de support IA qui se branche sur le helpdesk que tu utilises déjà, s'entraîne sur tes tickets et documents passés, et, la partie qu'une construction à partir de zéro saute presque toujours, simule sur ton historique réel de tickets avant de répondre à un ticket en production.
Tu conserves la surface programmable là où elle compte, Network Access pour n'importe quelle API REST, des webhooks, une CLI et des skills personnalisées, sans devoir d'abord reconstruire la récupération, l'état et les connecteurs. C'est gratuit pour démarrer, sans carte bancaire et sans appel commercial, et la tarification se fait par ticket traité, donc tu paies pour le travail effectué plutôt que pour les tokens consommés. Si tu préfères pointer un agent vers ta file plutôt que passer un trimestre à en construire un, c'est le moyen le plus rapide de le voir à l'œuvre sur tes propres tickets.
Questions fréquentes
Qu'est-ce qu'une API d'agent de support client ?
Dois-je construire un agent de support sur une API de modèle ou en acheter un ?
Combien coûte une API d'agent de support client ?
Qu'est-ce que le MCP et quel est son rapport avec une API d'agent de support ?
Puis-je connecter un agent IA à mon helpdesk existant via une API ?


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.