Ce que signifie vraiment « API helpdesk IA »
Cherchez « API helpdesk IA » et les résultats tirent dans deux directions, parce que deux personnes différentes tapent cette phrase. L'une veut activer l'IA que son helpdesk vend déjà et la piloter de façon programmatique. L'autre veut apporter son propre modèle et le connecter aux données et aux actions du helpdesk. Ce ne sont pas les mêmes projets, et l'outil qui résout l'un touche à peine l'autre.
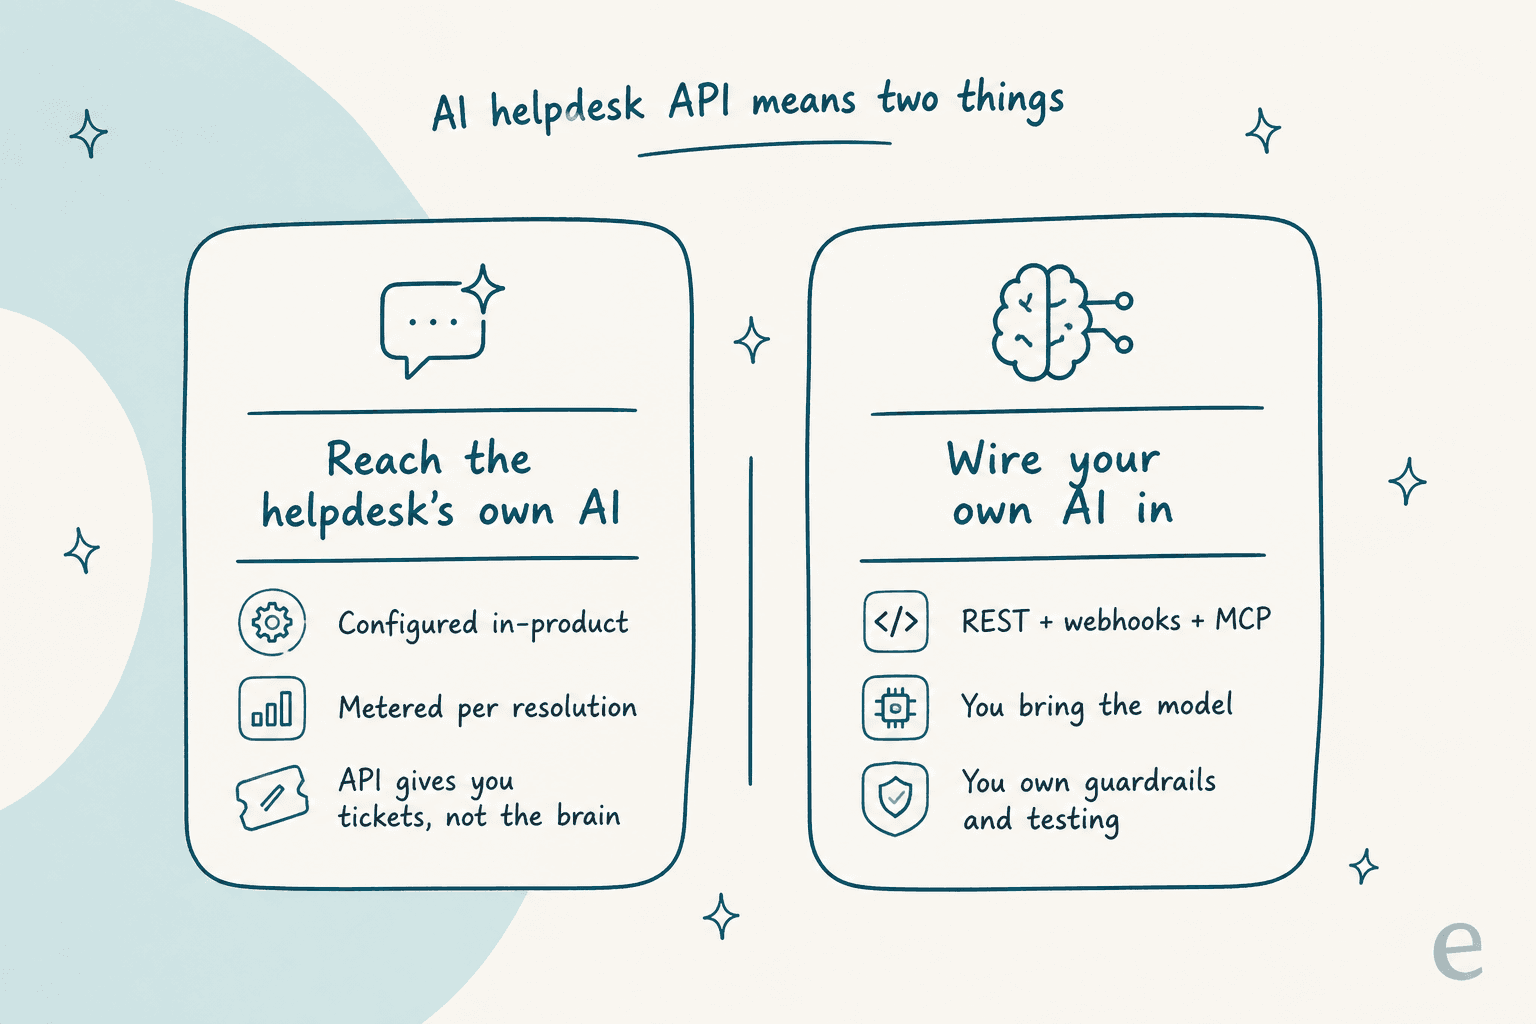
Donc avant de passer éditeur par éditeur, gardez cette distinction en tête :
- Accéder à l'IA propre du helpdesk. Activez l'agent IA de l'éditeur, nourrissez-le avec votre centre d'aide et laissez-le répondre. L'API sert surtout à déplacer les tickets autour de lui, pas à le reprogrammer.
- Connecter votre propre IA. Utilisez l'API REST, les webhooks et le serveur MCP pour lire les tickets et écrire des réponses avec un modèle que vous contrôlez.
J'ai construit de l'automatisation de support des deux côtés de cette ligne, et l'erreur que je vois le plus souvent est une équipe qui choisit la seconde tâche alors qu'elle voulait la première, ou qui paie une équipe pour reconstruire à partir de zéro ce que l'éditeur propose déjà. Voyons ce que chaque helpdesk expose réellement, puis le coût honnête de chaque voie.
La surface d'API du helpdesk, éditeur par éditeur
Tout helpdesk sérieux vous donne trois choses : une API REST pour lire et écrire des tickets, des webhooks pour réagir aux événements, et, depuis un an, certains proposent un serveur MCP propre pour qu'un agent se connecte une seule fois au lieu de câbler chaque endpoint à la main. Par-dessus se trouve l'agent IA propre de l'éditeur, qui est presque toujours une fonctionnalité séparée, avec un prix séparé.
Voici l'état des lieux sur les plateformes où se trouvent réellement la plupart des équipes. La colonne de facturation concerne l'IA native, pas l'API elle-même, généralement incluse dans votre forfait (sous réserve de limites de débit).
| Helpdesk | API REST + webhooks | Serveur MCP propre | Unité de facturation de l'IA native |
|---|---|---|---|
| Zendesk | Oui, limité en débit selon le forfait | Oui (client MCP) | 1,50 à 2,00 $ par résolution automatisée |
| Freshdesk | Oui (API v2) | Pas encore propre | Freddy par session résolue ; Copilot en add-on par siège |
| Gorgias | Oui | Oui (mcp.gorgias.com) | Par résolution automatisée (dépassement ~1,50 $) |
| Front | Oui | Oui (mcp.frontapp.com) | Copilot + Autopilot en add-ons payants |
| HubSpot Service Hub | Oui | Via des connecteurs | Crédits Breeze ; ~60 résolutions/mois, puis facturation à l'usage |
| Salesforce Service Cloud | Oui | Via Agentforce / MCP | Agentforce ~2 $ par conversation ou en crédits |
| Jira Service Management | Oui | Oui (Rovo MCP) | Rovo / agent virtuel, réservé à partir de Premium |
Deux tendances se dégagent. D'abord, la base REST plus webhooks est universelle et ennuyeuse dans le bon sens du terme : si vous voulez lire un ticket, le taguer ou poster une réponse depuis votre propre service, toutes ces plateformes vous le permettent. Ensuite, la colonne MCP est celle où s'est concentré le mouvement de la dernière année, et c'est inégal : certains éditeurs livrent un serveur propre bien conçu, d'autres s'attendent à ce que vous passiez par un connecteur partenaire.
L'IA native est une fonctionnalité, pas un endpoint
Voici la partie qui piège les gens. Quand Zendesk ou Freshdesk dit avoir de « l'IA », cette IA est un produit que vous activez dans leur back-office, que vous pointez vers vos connaissances et que vous payez à la résolution. Elle est vraiment utile. C'est simplement quelque chose que vous ne pouvez pas reprogrammer via l'API.
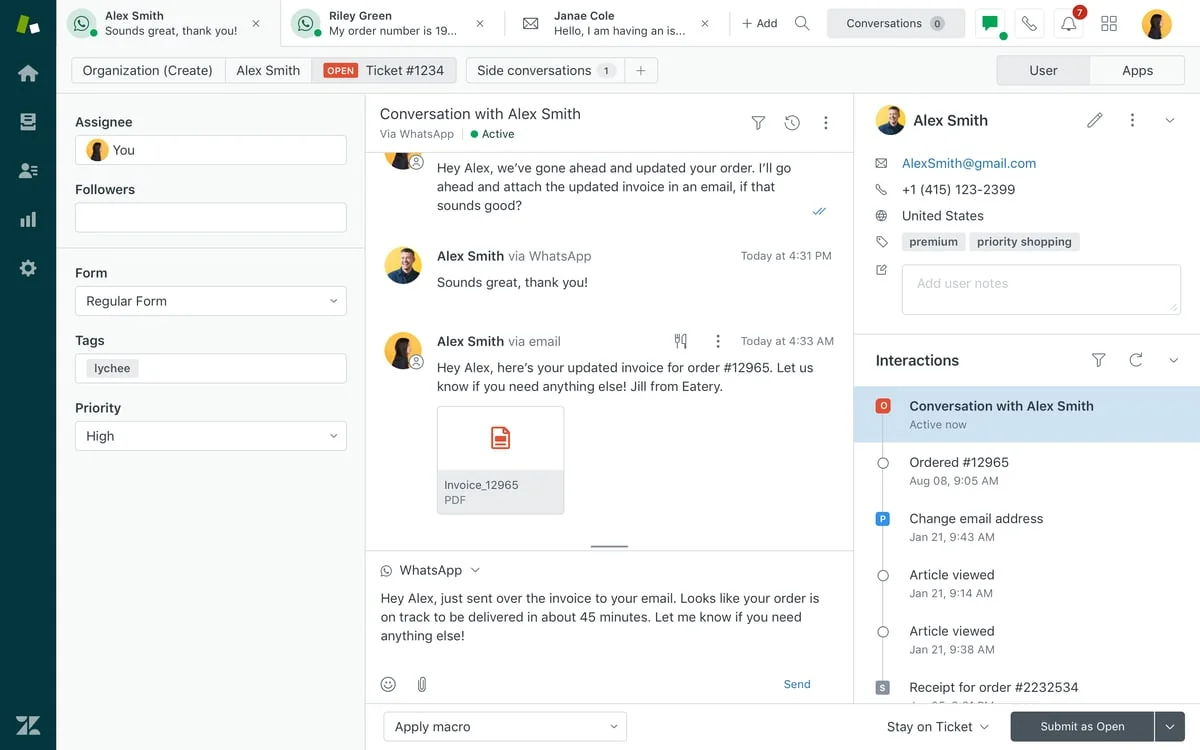
Prenez Zendesk. Ses agents IA sont configurés dans le produit, et les résolutions sont facturées 1,50 $ sur un forfait Suite et 2,00 $ en autonome. L'API REST est excellente pour les tickets, les utilisateurs, les déclencheurs et les macros, et Zendesk a même lancé un client MCP propre pour qu'un agent puisse accéder à des données en direct. Mais le raisonnement du moteur de réponse leur appartient. Vous l'ajustez ; vous ne composez pas votre propre boucle d'agent autour. Pour la vue d'ensemble, notre guide des agents IA Zendesk détaille la configuration et les coûts.
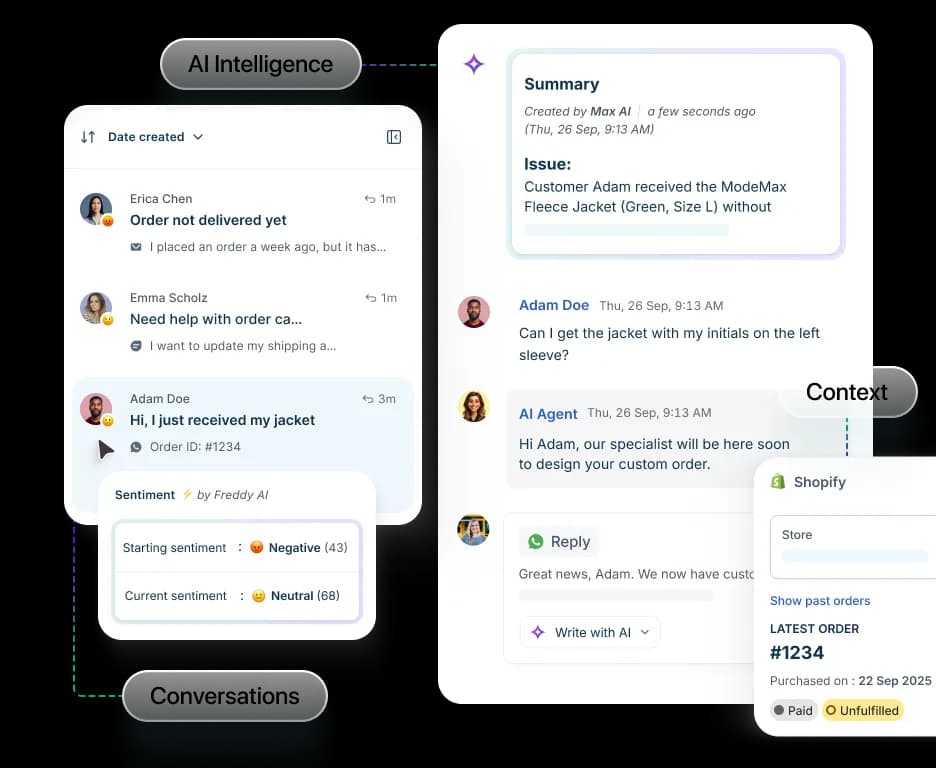
Freshdesk suit le même schéma. Freddy AI répond aux clients et rédige des brouillons pour les agents, facturé par session résolue, avec Copilot en add-on par siège, et l'API v2 pilote les tickets et les contacts. Le montage ci-dessous est une image marketing, mais il montre la vraie chose que fait Freddy : un résumé de ticket, une carte de sentiment et le contexte d'une commande, affichés à côté de la conversation.
Donc si votre objectif était « appeler l'IA de mon helpdesk depuis mon propre code et changer sa façon de penser », la réponse honnête chez presque tous les éditeurs est : ce n'est pas à ça que sert l'API. L'API déplace des tickets. L'IA est un réglage dans le back-office. Si vous avez besoin d'un vrai contrôle programmatique de l'agent, vous êtes en réalité dans la seconde tâche, celle qui consiste à connecter un modèle que vous possédez.
Connecter votre propre IA au helpdesk
C'est la construction que la plupart des développeurs imaginent quand ils cherchent « API helpdesk IA » : garder le helpdesk, apporter un modèle, connecter les deux. C'est une voie réelle et raisonnable, qui se divise en une version classique et une version plus récente.
La version classique, c'est REST plus webhooks. Un ticket arrive, un webhook se déclenche vers votre service, vous appelez votre modèle, et vous réécrivez la réponse via l'API REST. Ça fonctionne partout. Le hic, c'est que vous êtes propriétaire de chaque partie peu glorieuse de tout ça : l'authentification, le polling, les nouvelles tentatives et les limites de débit. Ces limites sont un vrai plafond, pas une note de bas de page. Zendesk, par exemple, plafonne les requêtes par minute selon le forfait :
| Forfait Zendesk Suite | Requêtes API / minute |
|---|---|
| Team | 200 |
| Growth | 400 |
| Professional | 400 |
| Enterprise | 700 |
| Enterprise Plus | 2 500 |
Chaque appel d'enrichissement, chaque réécriture et chaque réimportation de tickets historiques puise dans ce même budget par minute. Un job de retraitement en masse qui semblait inoffensif finira par le dépasser, et c'est alors votre intégration qui vous réveille à 2h du matin.
MCP est en train de redessiner discrètement cette voie
La version plus récente est le Model Context Protocol, un standard ouvert introduit par Anthropic pour connecter un agent à un système via un seul protocole plutôt qu'une intégration sur mesure par outil. Les helpdesks ont commencé à livrer leurs propres serveurs MCP, et la façon dont Zendesk décrit l'ancienne douleur est révélatrice : connecter des données en temps réel à l'IA exigeait auparavant « des API, un développeur expérimenté (voire deux) et de longs délais », alors qu'une intégration MCP « ne doit être configurée qu'une seule fois ».
Les serveurs propres à connaître :
- Gorgias propose un serveur gratuit sur
mcp.gorgias.com/mcp, désormais en bêta ouverte, qui connecte un espace de travail à n'importe quel client compatible MCP. Pour une vue plus large, voir notre analyse des agents IA dans Gorgias. - Front documente un serveur sur
mcp.frontapp.com/mcpavec un modèle de permissions étonnamment propre : OAuth 2.1 avec PKCE, des jetons par utilisateur, et des scopesread,write,send, de sorte que les permissions de l'agent sont exactement celles du coéquipier qui autorise. - Atlassian exploite un serveur MCP distant officiel qui connecte Jira, Confluence et Jira Service Management aux agents via OAuth. Pour une équipe ITSM, c'est le principal moyen de piloter un service desk depuis un agent.
Cela améliore vraiment le calcul acheter contre construire : la plomberie que vous deviez auparavant écrire à la main, l'éditeur la maintient désormais. Ce que MCP ne résout pas, c'est l'IA elle-même. Le serveur expose des outils ; la qualité de la recherche documentaire, le raisonnement et les garde-fous qui décident si ce remboursement est vraiment émis restent à apporter par vous-même. Si vous voulez la version no-code pour connecter un modèle à un helpdesk, notre guide sur l'intégration de ChatGPT avec Zendesk couvre ce sujet.
Où vit réellement l'IA dans la pile
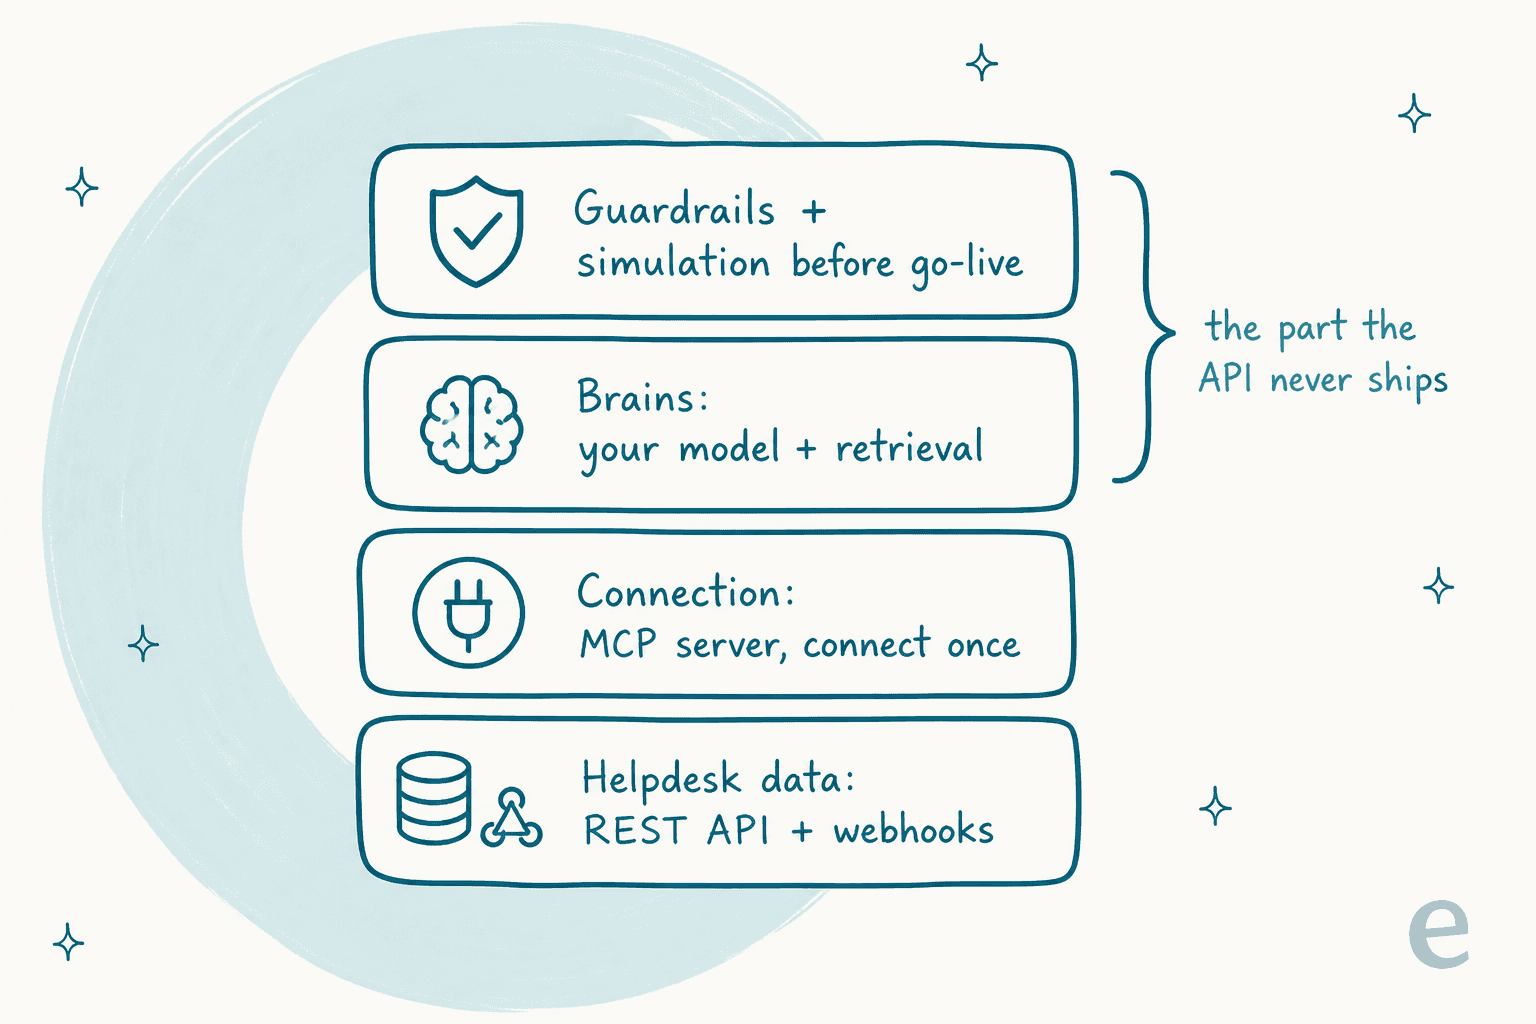
Il est utile d'imaginer les couches. L'API du helpdesk et ses webhooks forment la base de la pile : vos données et vos actions. MCP est la couche de connexion au-dessus. Mais les deux couches qui rendent un agent réellement bon en support sont celles qu'aucune API ne fournit pour vous.
Si vous empruntez cette voie avec une API de modèle brute en dessous, le modèle de coût est au token, sur chaque message, que le ticket soit résolu ou non. Tarifs approximatifs des éditeurs eux-mêmes, par million de tokens sur le palier standard :
| Modèle | Entrée | Entrée mise en cache / hit | Sortie |
|---|---|---|---|
| OpenAI gpt-5.6-terra | 2,00 $ | 0,20 $ | 12,00 $ |
| Anthropic Claude Sonnet 5 | 2,00 $ | 0,20 $ | 10,00 $ |
| Anthropic Claude Haiku 4.5 | 1,00 $ | 0,10 $ | 5,00 $ |
La mise en cache des prompts aide beaucoup en support, puisque vous renvoyez le même contexte de centre d'aide à chaque tour, et un hit de cache se lit à environ 10 % du prix d'entrée standard. Mais la mise en cache adoucit le chiffre, elle ne change pas l'unité. Une conversation de dix tours qui récupère une dizaine de fragments par tour et retente deux fois facture tout, même quand le client repart mécontent. Pour une comparaison plus poussée des briques de base, notre analyse AgentKit contre API Anthropic passe en revue outil par outil.
Les 90 % que le mot « API » cache toujours
Voici où je ralentirais tout le monde avant de s'engager dans la construction. Le consensus des développeurs qui ont réellement lancé des agents de support est remarquablement cohérent, et ce n'est pas « ne construisez jamais ». C'est que l'appel au modèle et les connecteurs d'API sont les 10 % faciles, et que la traîne de maintenance est là où se trouve le vrai coût.
Commencez par la recherche documentaire, que tout le monde sous-estime. Le fil RAG le plus commenté sur Hacker News (551 points) est un post-mortem sur le traitement de millions de documents, et un ingénieur Microsoft qui maintient un modèle RAG open source populaire s'est fermement opposé au réflexe « ajoutez juste une base de données vectorielle » :
« So few developers realize that you need more than just vector search for RAG, so I still spend many of my talks emphasizing the FULL retrieval stack for RAG. »

Garder cette recherche documentaire synchronisée avec un centre d'aide vivant, avec découpage en chunks, reranking et contrôle d'accès, est un vrai système, pas une case à cocher dans une configuration. Notre article explicatif sur RAG contre un simple LLM explique pourquoi.
Vient ensuite la traîne de maintenance, le chiffre que personne n'anticipe. Le constat le plus cité, tiré d'un fil r/AI_Agents avec plus de 460 commentaires, le nomme directement :
« The hardest part wasn't the LLM or voice quality - it was keeping the agent's knowledge current as policies changed and edge cases emerged. »

Cela correspond à ce que j'ai observé en exploitant de l'IA sur des files de support réelles : les cas limites sont tout le travail. La politique qui a changé la semaine dernière, la gamme de produits lancée hier, ce flux de remboursement bizarre qui casse tout agent générique. Rien de tout cela n'apparaît dans un guide de démarrage rapide, et ça ne s'arrête jamais. Et vous ne pouvez même pas savoir si vos garde-fous tiennent sans rejouer de vrais tickets contre eux, ce qui est justement l'étape qu'une construction faite de zéro omet presque toujours. Cet écart, la simulation avant la mise en production, est exactement ce que la couche API ne peut pas vous donner.
La troisième option : une couche qui livre toute la pile
Il existe une voie qui correspond à ce que la plupart des gens qui tapent « API helpdesk IA » veulent réellement : une IA qui sait déjà faire du support, qui se branche sur le helpdesk que vous exploitez et passe en production, plutôt qu'un kit que vous assemblez vous-même. C'est là que se situe un outil comme eesel, et il vaut la peine d'être précis sur pourquoi c'est une catégorie différente, et pas seulement un emballage plus joli des deux voies ci-dessus.
Un agent helpdesk IA arrive avec toute la pile déjà construite. Il s'entraîne sur vos anciens tickets et votre centre d'aide, rejoint la file à l'intérieur du helpdesk que vous exploitez déjà, consulte les commandes, tague et trie, et rédige ou envoie des réponses. La recherche documentaire, l'état de la conversation, les actions sur les tickets et la logique d'escalade sont pris en charge, si bien que vous configurez un comportement au lieu d'implémenter une infrastructure. Et contrairement à l'IA native ancrée dans un seul helpdesk, il est portable : eesel se connecte à plus de 1000 intégrations au lieu de vous enfermer dans le moteur de réponse d'un seul éditeur.
Ce qui compte pour un développeur, c'est que « déjà construit » ne signifie pas « boîte fermée ». eesel conserve une véritable surface programmable pour les cas particuliers que les valeurs par défaut ne couvrent pas :
- Network Access permet à l'agent d'appeler n'importe quelle API REST que vous autorisez, avec GET, POST, PATCH et DELETE, et des en-têtes d'authentification par domaine. Les identifiants sont stockés comme en-têtes et ne sont jamais montrés au modèle.
- Webhooks donnent à n'importe quel outil une URL unique qui réveille l'agent avec tout ce qu'il envoie.
- Une CLI et des skills personnalisés vous permettent de scripter les parties que vous voulez garder sous votre contrôle, et un seul skill peut couvrir plusieurs outils en une seule exécution : lire le helpdesk, vérifier Shopify, poster sur Slack.
La distinction que je retiendrais : une API de modèle brute est de l'infrastructure, l'IA native du helpdesk est une fonctionnalité, et eesel est le coéquipier qui se situe entre les deux. Vous continuez à écrire du code là où le code apporte de la valeur ; vous ne reconstruisez simplement pas la recherche documentaire, l'état et les connecteurs depuis zéro pour y arriver.
Par résolution contre par ticket : le modèle de coût qui tranche
Prenez du recul, et les voies se séparent nettement selon la façon dont vous payez. Apporter votre propre modèle vous place sur un compteur au token. L'IA native du helpdesk vous place sur un compteur par résolution, en plus de vos sièges. Une couche déjà construite tarife généralement par ticket traité.
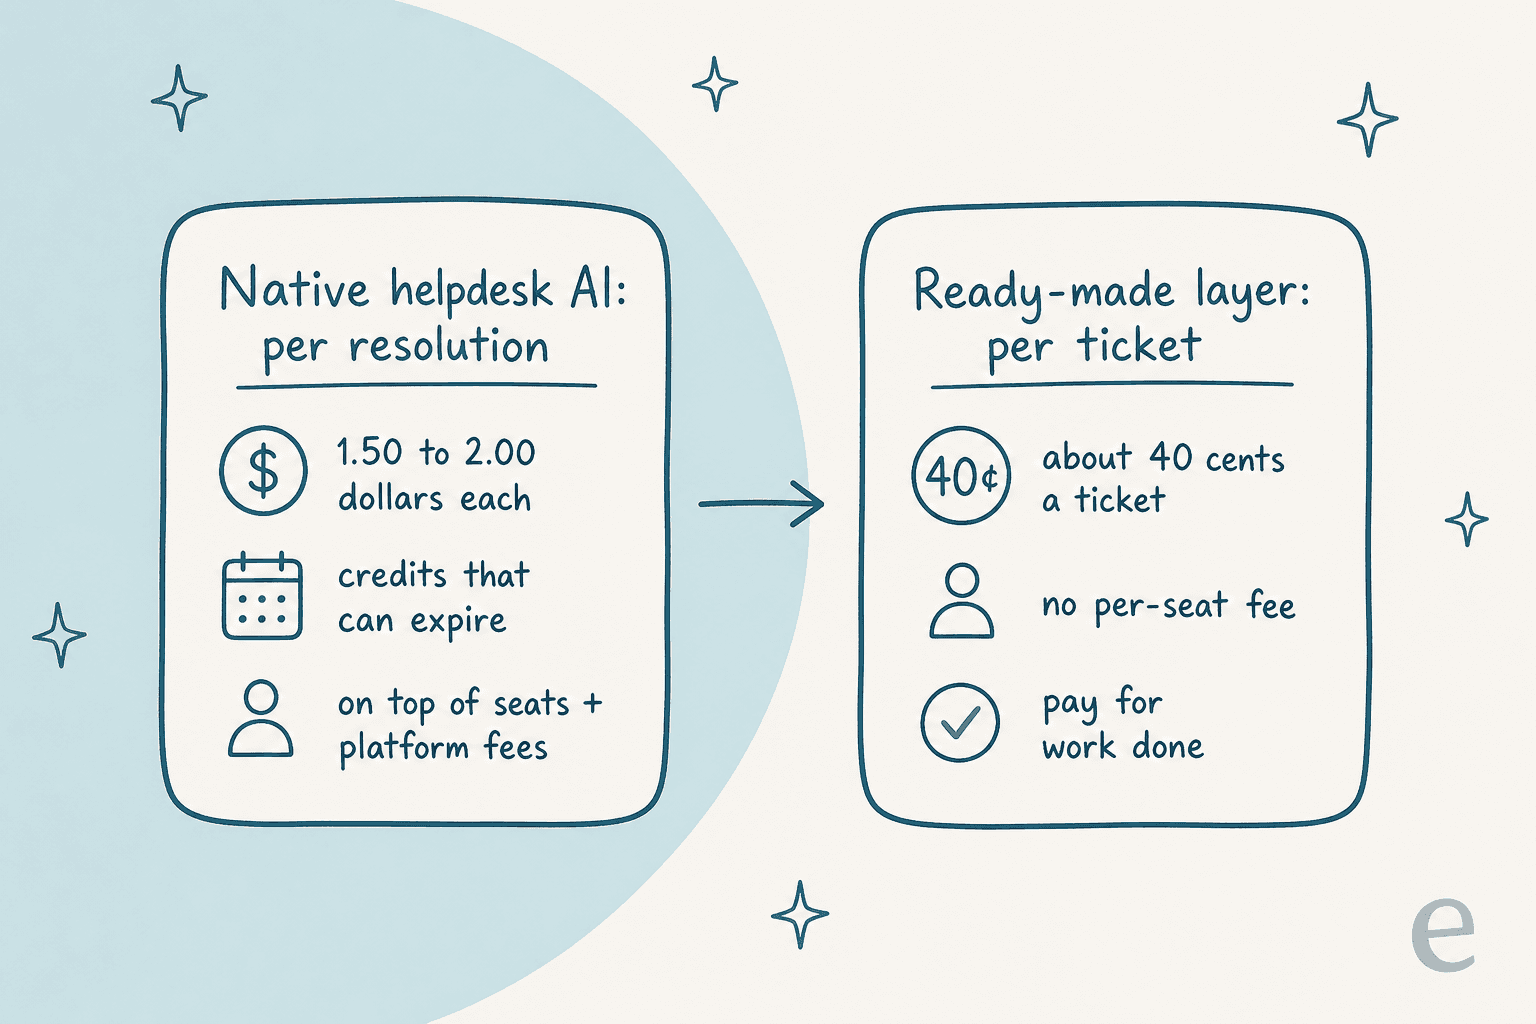
La différence n'est pas académique. Le prix à la résolution paraît juste jusqu'à ce que vous remarquiez qu'il s'ajoute au coût par siège, et que « résolution » est souvent défini par l'éditeur d'une manière qui en compte plus que ce à quoi vous vous attendiez. Le prix au token est une facture illimitée, à la forme de l'usage, que vous devez prévoir et plafonner. eesel, en revanche, est facturé à l'usage, à environ 40 centimes par ticket traité, facturé par ticket ou par conversation de helpdesk plutôt que par réponse, sans frais par siège, sans frais de plateforme et sans minimum mensuel. Ajoutez le salaire d'ingénieur derrière un agent construit maison et les heures de maintenance qu'il consomme chaque semaine, et la voie DIY « moins chère » ne l'est souvent pas. Le piège, comme l'a formulé un développeur, c'est l'agent qui fait gagner dix minutes par jour mais coûte discrètement des heures par semaine à maintenir en vie.
Alors, quelle voie choisir ?
Aucune de ces options n'est mauvaise. Elles conviennent à des situations différentes. En résumé : si vous voulez accéder à l'IA de votre helpdesk, vous configurez en réalité une fonctionnalité, vous n'appelez pas une API. Si vous voulez connecter votre propre modèle, partez de l'API REST et du serveur MCP propre de votre éditeur, et budgétez les 90 % que les connecteurs ne couvrent pas. Si vous voulez des tickets résolus sans construction, utilisez une couche qui livre toute la pile.
Voici les compromis sous forme de tableau :
| Dimension | IA native du helpdesk | Connecter votre propre modèle | Couche déjà construite |
|---|---|---|---|
| Vous construisez l'agent | Non, c'est une fonctionnalité | Oui, le cerveau et les garde-fous | Non, vous le configurez |
| Contrôle programmatique de l'IA | Limité (configuration dans le produit) | Total | Network Access, CLI, skills |
| Recherche documentaire / synchronisation des connaissances | Celle de l'éditeur, une seule plateforme | La vôtre | Intégré |
| Connecteurs helpdesk | Un seul (votre éditeur) | À votre charge | Intégrés (plus de 1000) |
| Test avant mise en production | Limité | Vous construisez le harnais de test | Simulation sur d'anciens tickets |
| Unité de facturation | Par résolution + sièges | Par token | Par ticket traité |
| Délai jusqu'au premier ticket résolu | Jours | Semaines à mois | Minutes à heures |
Si vous êtes encore en train de cartographier le paysage plus large, nos comparatifs des meilleurs agents IA et de la meilleure IA pour le tri des tickets passent en revue outil par outil, et notre article sur l'API d'agent de support client creuse spécifiquement la voie du fait-maison.
Essayez eesel
Si vous en êtes arrivé là en pesant « activer l'IA de mon helpdesk » contre « connecter mon propre modèle », et qu'aucune des deux options ne vous convenait vraiment, voici la réponse honnête : la première est une fonctionnalité verrouillée et la seconde représente un trimestre d'ingénierie. eesel est cette troisième voie faite correctement, un coéquipier de support IA qui se branche sur le helpdesk que vous exploitez déjà, s'entraîne sur vos anciens tickets et vos documents et, l'étape que les deux autres voies sautent, simule sur votre historique réel de tickets avant de répondre à un ticket en production.
Vous gardez la surface programmable là où elle compte, Network Access pour n'importe quelle API REST, des webhooks, une CLI et des skills personnalisés, sans avoir à reconstruire d'abord la recherche documentaire, l'état et les connecteurs. C'est gratuit pour commencer, sans carte bancaire ni appel commercial, et la tarification se fait par ticket traité, donc vous payez pour le travail effectué plutôt que pour des tokens brûlés ou des résolutions comptées. Si vous préférez pointer un agent vers votre file plutôt que de passer un trimestre à en construire un, c'est le moyen le plus rapide de le voir à l'œuvre sur vos propres tickets.
Questions fréquentes
Qu'est-ce qu'une API helpdesk IA ?
Puis-je appeler l'IA intégrée de mon helpdesk via son API ?
Combien coûte une API helpdesk IA ?
Qu'est-ce que MCP et quel est son rapport avec une API helpdesk ?
Puis-je connecter un agent IA à Zendesk ou Freshdesk via une API ?


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.