Qué significa realmente «automatizar el soporte desde la línea de comandos»
Construyo producto y agentes de IA en eesel, así que paso mucho tiempo en APIs de helpdesk y en las terminales de otras personas. Cuando un equipo de soporte con perfil técnico dice «quiero automatizar esto desde la línea de comandos», casi nunca están pidiendo un único binario mágico que escriba support resolve #4821 y cierre un ticket con la respuesta correcta. Esa herramienta no existe, y vale la pena dejarlo claro desde el principio.
Lo que en realidad quieren es una escalera de autonomía: dejar de hacer clic en una interfaz y empezar a dejar que los scripts hagan el trabajo repetitivo, primero bajo demanda, luego según un horario, luego automáticamente ante eventos. Es el mismo instinto detrás de las búsquedas de una CLI de soporte al cliente. Ese instinto es completamente correcto, y para la mitad mecánica del soporte da resultado de inmediato. La trampa es asumir que la terminal también te da la mitad difícil, la respuesta en sí. No lo hace, y después de años poniendo agentes de IA en colas en producción, sé exactamente dónde está esa línea.
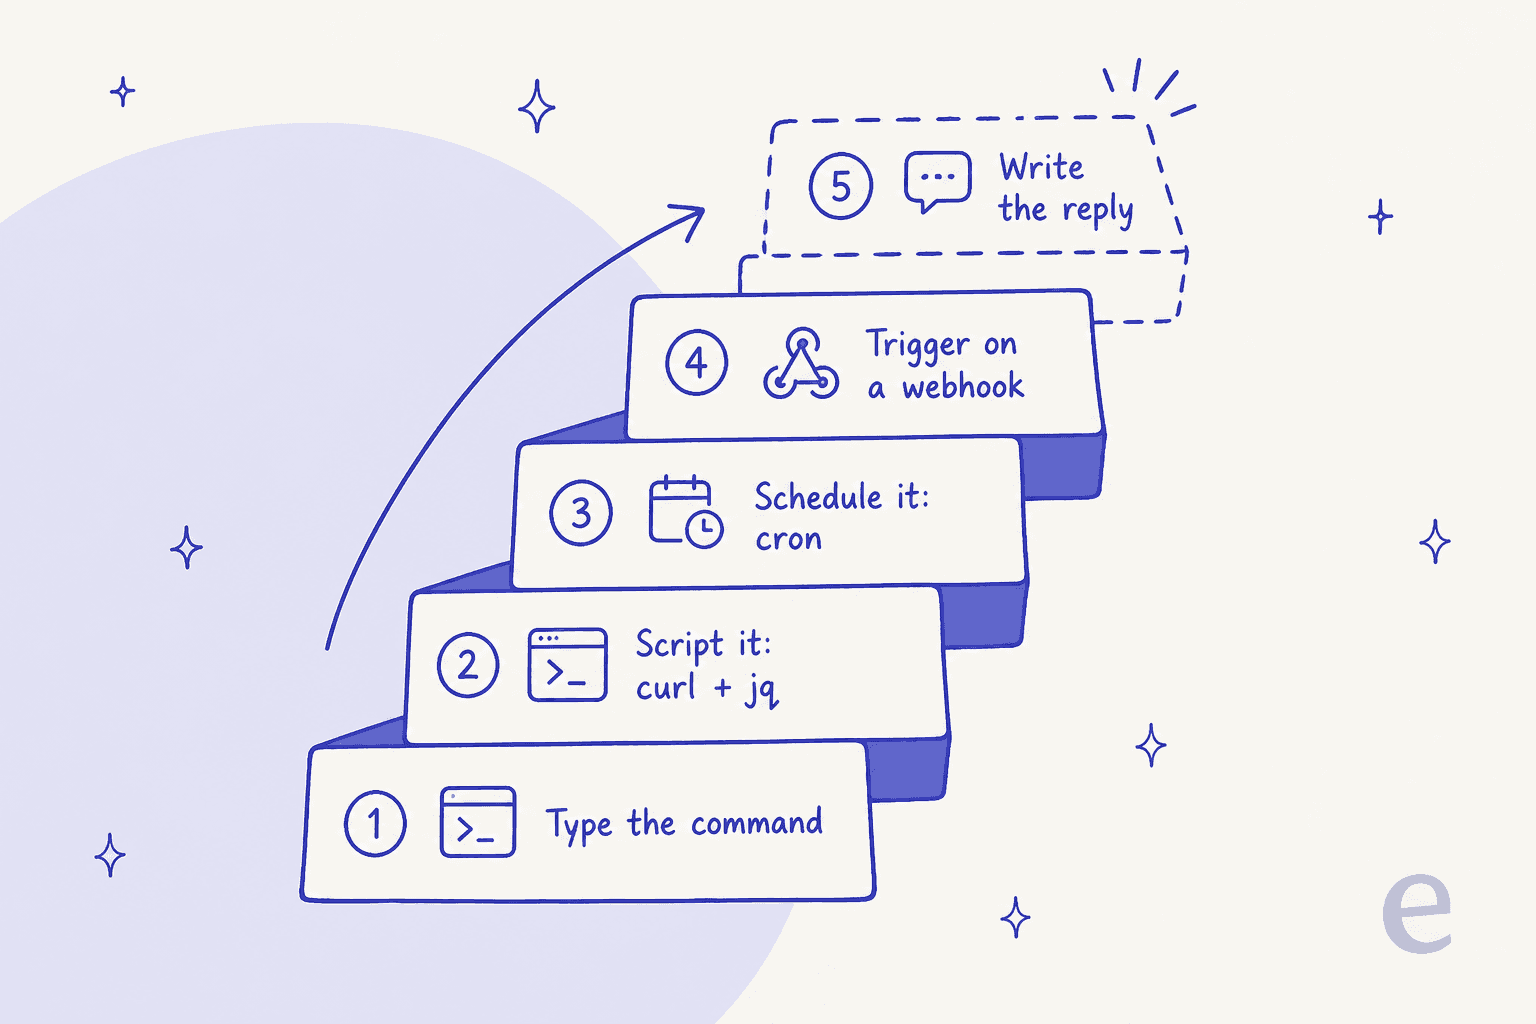
Todo peldaño debajo del punteado es real, construible hoy, y el resto de este artículo lo recorre.
Peldaños 1 y 2: scriptear el trabajo mecánico
Todo helpdesk importante expone una API REST, así que bash, curl y jq ya pueden manejar una cantidad sorprendente del día a día. Aquí es donde la línea de comandos se gana su lugar, porque convierte una tarde de clics en un solo loop.
Triage y enrutamiento masivo. Reasigna todos los tickets de una vista, agrega una etiqueta en un segmento completo, o sube la prioridad de un backlog. Es el mismo trabajo que la automatización de enrutamiento de tickets, solo que manejado desde una shell en lugar de un constructor de reglas. Si usas Zendesk en particular, esto se solapa mucho con automatizar tickets de Zendesk:
# Tag every unassigned ticket in a view, using the helpdesk REST API
curl -s -u "$AUTH" "$HELPDESK/api/v2/views/$VIEW/tickets.json" \
  | jq -r '.tickets[].id' \
  | while read -r id; do
      curl -s -u "$AUTH" -X PUT "$HELPDESK/api/v2/tickets/$id.json" \
        -H 'Content-Type: application/json' \
        -d '{"ticket":{"tags":["needs-review"]}}'
    done
Exportaciones y análisis. Extrae un mes de conversaciones a JSON y pásalo a una hoja de cálculo, un notebook, o un rápido conteo de frecuencia de palabras sobre de qué se quejan realmente los clientes. Este tipo de análisis de tickets es mucho más fácil desde la terminal que desde cualquier pestaña de reportes.
Sincronización de conocimiento. Sube tu centro de ayuda, tus macros o tu documentación a una base de conocimiento para que las respuestas se mantengan al día. Es el tejido conectivo detrás de cualquier flujo real de IA para helpdesk, ya sea que uses Freshdesk, Gorgias o Help Scout, y la API de la base de conocimiento de Freshdesk es un buen ejemplo de lo que exponen estos endpoints.
Todo esto es scripteable, repetible y revisable. La trampa es que todo mueve datos de un lado a otro. Nada de esto decide qué decir.
Peldaño 3: programarlo con cron
En el momento en que existe un script, envuélvelo en una línea de cron y corre solo. Este es el primer peldaño en el que el soporte corre sin supervisión, sin que ningún humano dispare nada.
# Every night at 2am, run the stale-ticket sweep and log the result
0 2 * * * /opt/support/close-stale.sh >> /var/log/support-cron.log 2>&1
Un job nocturno que cierra tickets obsoletos, una exportación semanal, una sincronización de conocimiento cada hora, una verificación de SLA que avisa a Slack cuando un ticket está por incumplirse, ninguno de estos necesita a una persona en el medio. Este es el patrón detrás de la mayoría de la automatización de tickets de soporte ligera: no necesitas una plataforma, necesitas un script y un horario. Si quieres un ángulo concreto de SLA, la misma idea se traslada perfectamente a un flujo de gestión de SLA.
Aquí hay uno pequeño pero útil, una alerta de incumplimiento de SLA que corre cada 15 minutos:
# Alert on tickets within 30 min of an SLA breach (cron: */15 * * * *)
curl -s -u "$AUTH" "$HELPDESK/api/v2/search.json?query=type:ticket+status<solved" \
  | jq -r '.results[] | select(.sla_minutes_left < 30) | .id' \
  | while read -r id; do
      curl -s -X POST "$SLACK_WEBHOOK" \
        -d "{\"text\":\"Ticket $id is about to breach SLA\"}"
    done
Eso es automatización real. Lee el estado, aplica una regla y ejecuta una acción, todo sin ti. Aun así no está respondiendo nada.
Peldaño 4: disparar con un webhook
Cron corre según un reloj. El peldaño scripteable más alto corre según eventos. En lugar de hacer polling cada 15 minutos, registras un webhook para que tu helpdesk haga un POST a tu endpoint en el instante en que se crea, etiqueta o actualiza un ticket, y tu script reacciona en tiempo real.
Así es como pasas de un etiquetado automatizado que corre según un horario a un etiquetado que se dispara en el instante en que llega un ticket, y es la rampa de entrada a la clasificación de tickets real. Un handler diminuto es suficiente:
# Minimal webhook handler: classify and route a new ticket on arrival
# (Ticket payload arrives as JSON on POST from the helpdesk)
read -r payload
id=$(echo "$payload" | jq -r '.ticket.id')
subject=$(echo "$payload" | jq -r '.ticket.subject')
case "$subject" in
  *refund*|*charge*) queue="billing" ;;
  *bug*|*error*)     queue="engineering" ;;
  *)                 queue="general" ;;
esac
curl -s -u "$AUTH" -X PUT "$HELPDESK/api/v2/tickets/$id.json" \
  -d "{\"ticket\":{\"group_id\":\"$queue\"}}"
El enrutamiento por palabras clave como este es basado en reglas, no IA, y eso está bien, mucho enrutamiento en realidad es solo coincidencia de palabras clave. Pero fíjate qué pasa si lo llevas más allá: cuanto más quieras que el handler entienda el ticket en lugar de solo hacer pattern-matching sobre su línea de asunto, más habrás abandonado silenciosamente el dominio de las sentencias case y entrado en el dominio de un sistema de IA real.
El peldaño que no puedes scriptear: la respuesta
Aquí está la línea honesta. Puedes scriptear el ticket, pero no puedes scriptear la respuesta. En el momento en que una tarea necesita leer el problema de un cliente, encontrar el conocimiento correcto y decidir una respuesta, curl y jq se quedan cortos, y estás construyendo un sistema de IA, no una función de bash.
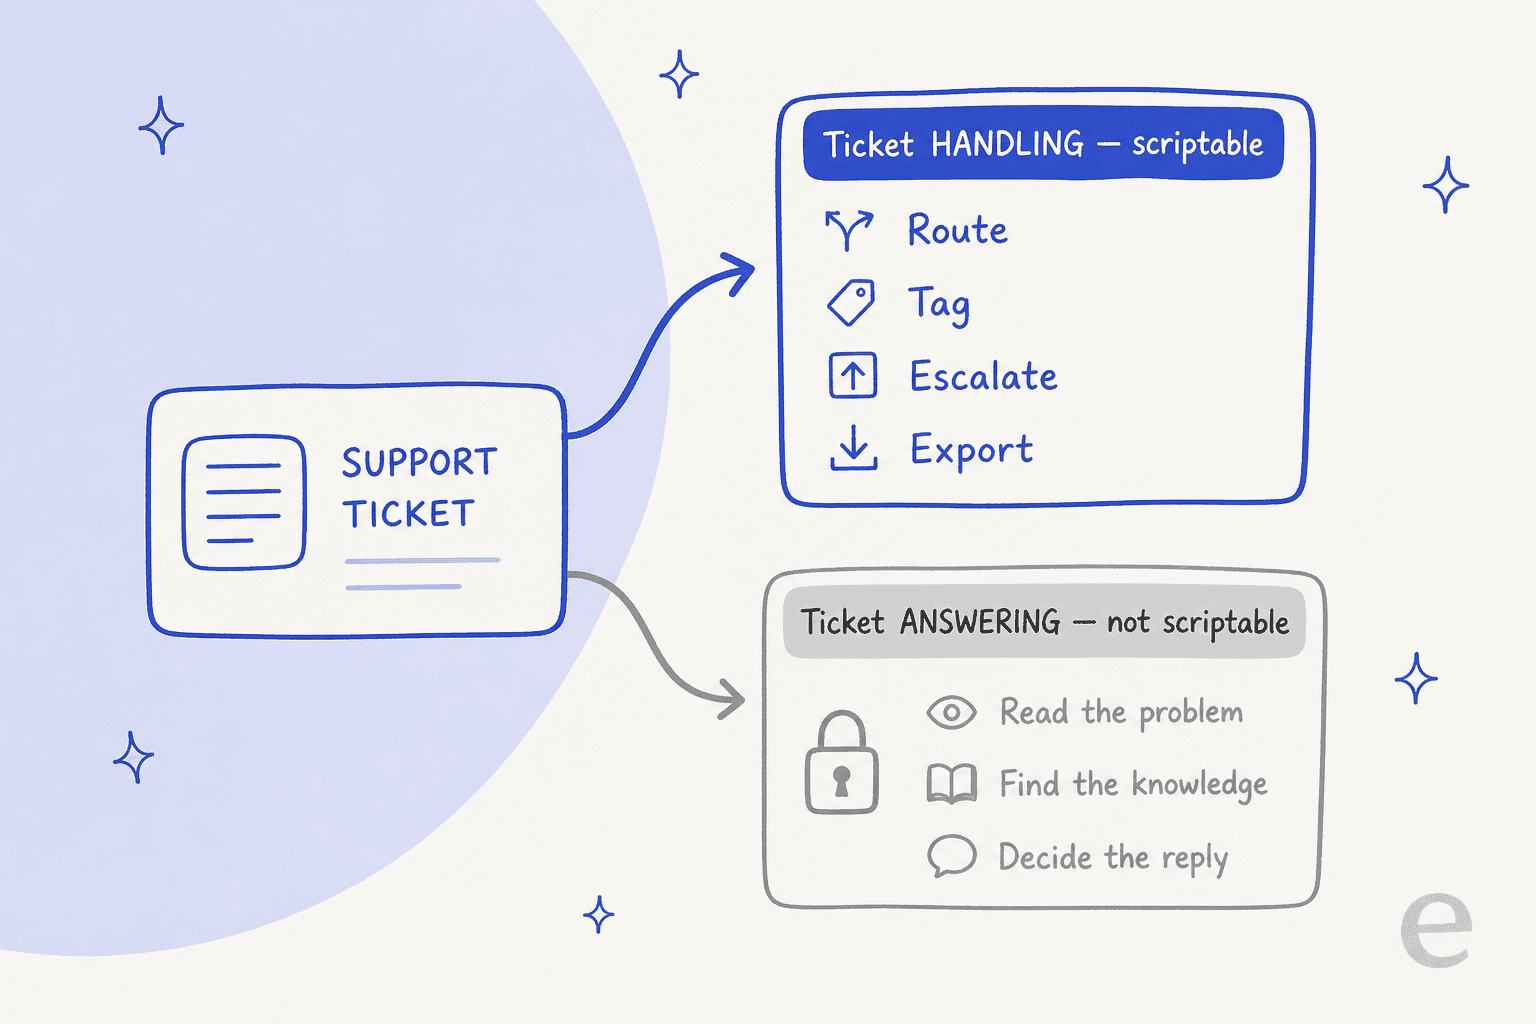
Pregúntale a cualquiera que realmente haya lanzado uno. Solo la recuperación de información ya es un stack completo, no una única llamada de búsqueda:
"So few developers realize that you need more than just vector search for RAG, so I still spend many of my talks emphasizing the FULL retrieval stack for RAG."

Y en el momento en que el modelo puede tanto decidir como actuar sobre un ticket, has adquirido un problema de control que una línea de cron no resuelve:
"The failure mode I keep seeing isn't hallucination per se... it's blurred responsibility between intent and execution. Once a model can both decide and act, you've already lost determinism."
Así que el costo real de un agente de soporte automatizado no está en el endpoint. Está en la sincronización y recuperación de conocimiento, el estado de la conversación a lo largo de los turnos, las acciones de herramientas contra el helpdesk, las reglas de escalado, los guardrails y una forma de probar todo el conjunto. Es el mismo iceberg con el que se topa cualquier equipo que construye una configuración de soporte headless: la punta, tu terminal y tu canal, nunca fue la parte difícil. El cuerpo debajo de ella sí lo es, y es exactamente lo que una API de helpdesk con IA tiene que cargar.
Prueba la automatización antes de que responda un ticket en producción
Si hay un hábito que vale la pena robarle al software, es este, y es el paso que las configuraciones scripteadas se saltan. Nunca lanzarías código sin pruebas. Una automatización que habla con tus clientes merece el mismo estándar, y el instinto de terminal de «hazlo reproducible» es exactamente lo que hace posible probar.
El problema es que la mayoría de los equipos simplemente encienden un agente y esperan lo mejor. La comunidad de soporte sigue dando vueltas a la misma preocupación:
"How do you test that an AI agent won't do something catastrophic? Do people actually red-team their agents before they go live?"

Ya tienes la suite de pruebas: tu historial de tickets. La jugada es reproducir miles de tus tickets reales pasados contra el agente y ver qué habría dicho, dónde habría escalado y dónde se habría quedado callado, todo antes de que un cliente esté involucrado. Eso es lo que hace la simulación de eesel, y convierte «lanzar y esperar lo mejor» en «lanzar con datos». Es lo más parecido que tiene el soporte a pytest, y por eso simulo cada lanzamiento contra tickets históricos primero.
Cuánto cuesta automatizar la respuesta
El costo es donde el instinto de construirlo tú mismo se encuentra con la realidad, y los dos caminos cobran de formas muy distintas.
Si scripteas un agente sobre una API de modelo en bruto, pagas por token en cada mensaje, cada reintento, cada fragmento recuperado, se resuelva el ticket o no. Un equipo de nuestro dossier quemó 200 llamadas a la API en un solo día de pruebas y se puso nervioso por la factura ante sus 9.000 interacciones esperadas al mes. Y eso sin contar el tiempo de ingeniería para construir y mantener recuperación, estado, guardrails y evaluaciones.
Así es como se comparan realmente las opciones centradas en la terminal:
| Enfoque | Nivel de autonomía | Tú mantienes | Forma de facturación | Ideal para |
|---|---|---|---|---|
| Scripts curl + jq | Bajo demanda | Cada script | Incluido en el plan | Ediciones masivas, exportaciones, enrutamiento |
| Jobs de cron | Programado, sin supervisión | Scripts + horario | Incluido en el plan | Barridos nocturnos, sincronizaciones, alertas de SLA |
| Handlers de webhook | Basado en eventos | Endpoint + scripts | Incluido en el plan | Enrutamiento y etiquetado en tiempo real |
| API de modelo + MCP | Autónomo, DIY | Todo el stack de IA | Por token, se resuelva o no | Control total, si tienes el equipo |
| Compañero de equipo ya hecho | Autónomo, gestionado | Nada | Por ticket resuelto (~$0.40) | Tickets resueltos sin construir el motor |
La última fila es la que merece una segunda mirada si tu objetivo son tickets resueltos en lugar de un proyecto de mantenimiento. De todas formas obtienes una superficie programable contra la que scriptear con curl y cron, solo que no reconstruyes la inteligencia de resolución que hay debajo.
Automatizar la respuesta con eesel
Si llegaste hasta aquí queriendo automatizar el soporte al cliente desde la línea de comandos, eres del tipo de equipo que quiere una superficie programable, no un dashboard cerrado. Ese es exactamente el punto medio para el que está construido eesel.
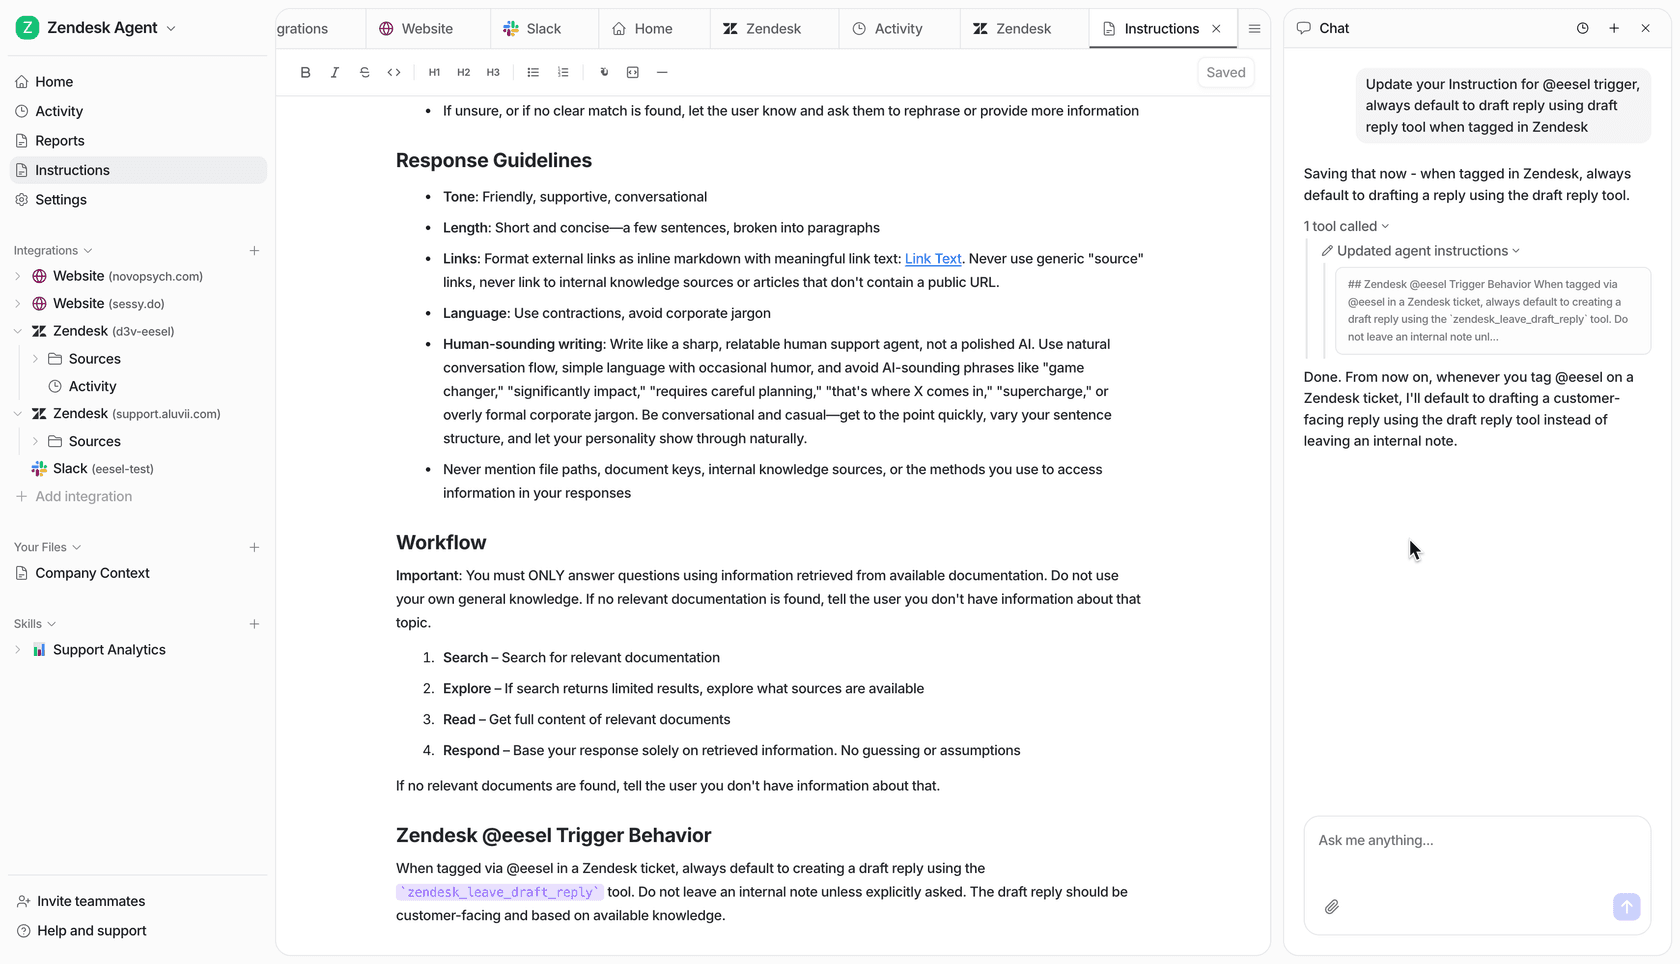
eesel es un compañero de equipo de IA que se conecta al helpdesk que ya usas, Zendesk, Freshdesk, Gorgias, Front, Help Scout, y llega ya sabiendo cómo sincronizar tu conocimiento, buscar pedidos, etiquetar tickets y redactar o enviar respuestas. Trae todo el motor de resolución, así que no reconstruyes recuperación, estado y guardrails desde cero, y conserva la superficie programable por la que viniste: una API para acciones, webhooks y skills personalizadas que puedes manejar desde una shell. Y luego la parte que más importa: simula sobre tickets pasados antes de salir a producción, así que despliegas con datos en lugar de esperanza. Es gratis para probar, sin tarjeta de crédito y sin llamada de ventas, y la facturación es por ticket resuelto en lugar de por token o por asiento.
Conserva tus scripts de curl y tus jobs de cron para la gestión de tickets, en la que son excelentes. Deja que un compañero de equipo se encargue del único peldaño que la línea de comandos no puede alcanzar.
Preguntas frecuentes
¿Cómo automatizo el soporte al cliente desde la línea de comandos?
¿Qué tareas de soporte puedo scriptear realmente desde la terminal?
¿Puedo ejecutar automatizaciones de soporte programadas con cron?
¿En qué se diferencia la automatización por webhook de cron?
¿Puede un script realmente resolver un ticket, no solo moverlo?
¿Cómo pruebo una automatización de soporte antes de ponerla en producción?
¿Cuánto cuesta el soporte de IA automatizado frente a scriptearlo yo mismo?


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.