Lo que la gente realmente quiere decir con "una CLI para atención al cliente"
Paso la mayor parte de mi semana en APIs de helpdesks y en las terminales de otras personas. La petición que más escucho de equipos de soporte con inclinación técnica es alguna versión de "solo quiero ejecutar esto desde la línea de comandos". Normalmente se imaginan un binario limpio: support resolve #4821, y el ticket se cierra con una respuesta correcta.
Ese binario no es real, pero el deseo subyacente merece tomarse en serio. Cuando un ingeniero pide una CLI, rara vez está pidiendo una estética de terminal. Está pidiendo las cosas que implica una buena línea de comandos: automatización en lugar de clics manuales, reproducibilidad en lugar de "lo que sea que hizo Steve en la interfaz el martes pasado", y la capacidad de poner la lógica de soporte en un archivo que puedas revisar, probar y revertir.
Vemos esto una y otra vez. Un cliente de mercado medio que se dio de baja lo dijo sin rodeos al salir por la puerta:
"Nos cambiamos a un sistema que funciona bien a la mitad del costo. Pero a largo plazo simplemente construiremos el nuestro, lo cual es tan posible ahora con la IA."
Un cliente de mercado medio que se dio de baja y se fue a una herramienta más barata tras una integración rota, diciendo que se habría quedado si el soporte hubiera sido más rápido y mejor
Ese instinto, "lo construiremos nosotros mismos ahora que la IA lo hace posible", es exactamente la energía detrás de una búsqueda de "CLI para atención al cliente". Es real, y para la mitad mecánica del trabajo es completamente correcto. La trampa es asumir que la terminal también te da la mitad difícil. No lo hace, y hemos pasado suficientes años poniendo agentes de IA en colas en vivo para saber exactamente dónde está esa línea.
El verdadero cambio: tratar el soporte como código
El replanteamiento más útil es dejar de buscar un binario de soporte mágico y empezar a tratar las automatizaciones de soporte de la misma forma en que ya tratas el código de aplicación. Esta es la idea detrás de "soporte como código", y es la misma disciplina que aplicas a la infraestructura: si importa, vive en un repositorio, se prueba y corre según un calendario en lugar de según la memoria de alguien.
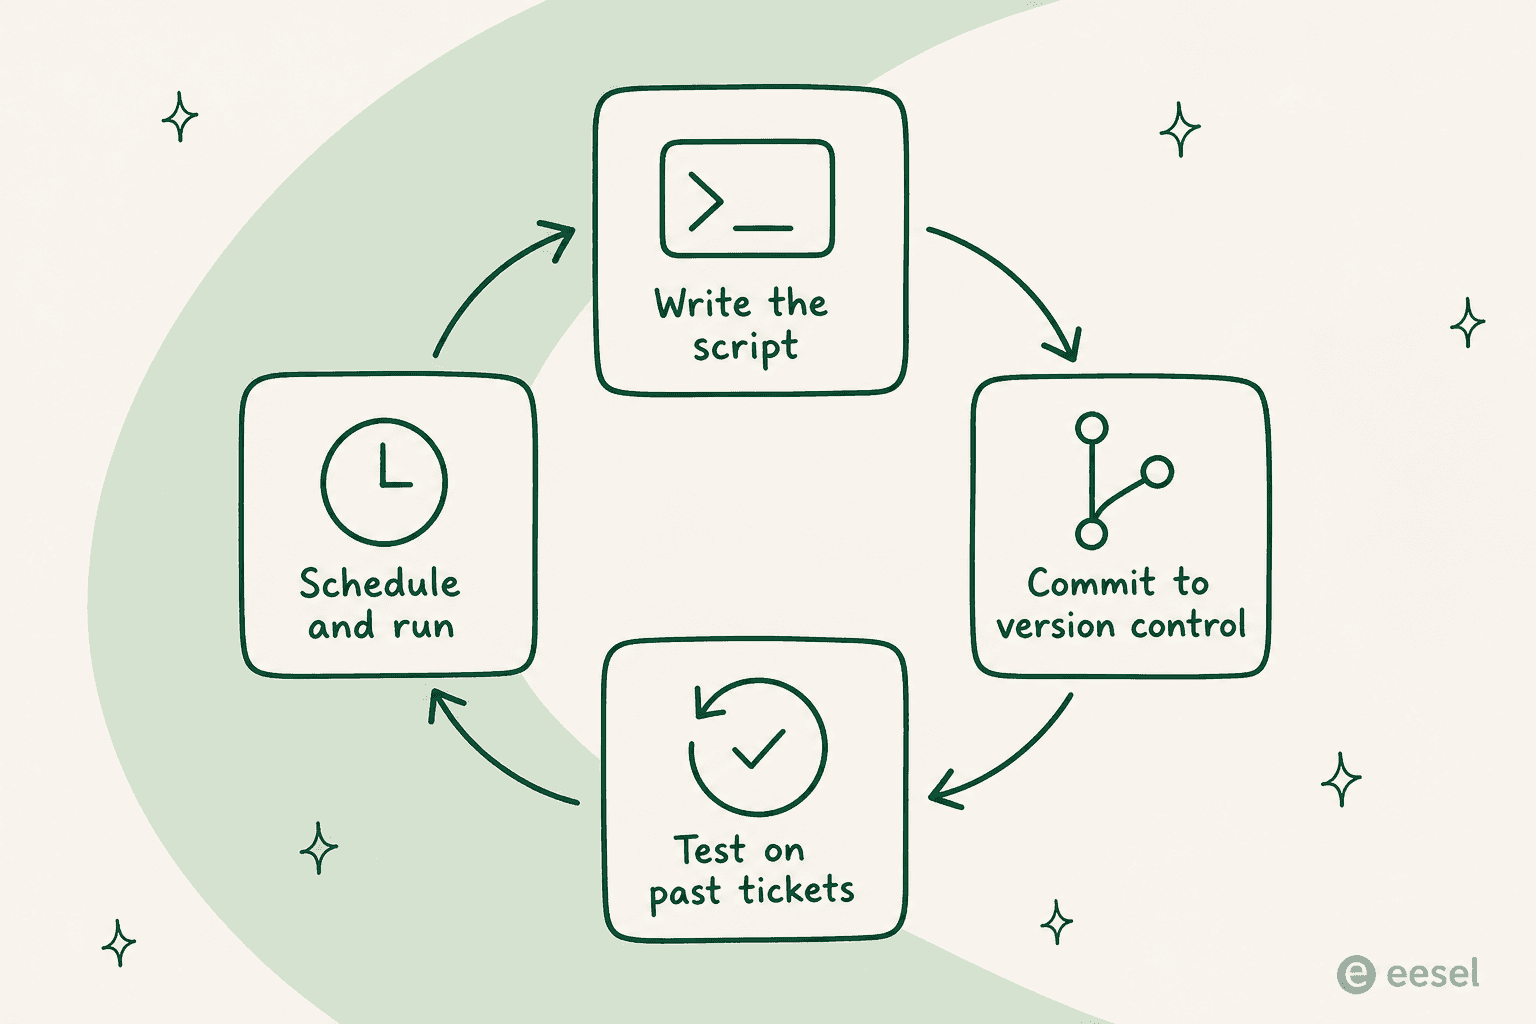
El ciclo es simple, y es la razón por la que el enfoque de la CLI vale algo. Escribes una automatización como un script, la subes a control de versiones para que haya un historial y un revisor, la pruebas contra tickets reales pasados antes de que toque a un cliente, y la programas para que corra sola. Una macro que configuraste en un panel no tiene nada de eso: sin diff, sin prueba, sin rollback, sin dueño. En el momento en que tu lógica de soporte es texto en un archivo, todo eso viene gratis, y ese es el verdadero beneficio de ir primero por la terminal.
Lo que puedes scriptear desde la terminal hoy
Cada helpdesk importante expone una API REST, así que bash, curl y jq ya pueden manejar una sorprendente cantidad del trabajo diario. Esta es la parte donde la línea de comandos realmente se gana su lugar.
Algunas cosas que encajan bien con un script, no con un panel:
Ediciones masivas y triaje. Reasignar todos los tickets en una vista, agregar una etiqueta a un segmento, o subir la prioridad de un backlog. Un solo bucle hace lo que una tarde de clics haría:
# Tag every unassigned ticket in a view, using the helpdesk REST API
curl -s -u "$AUTH" "$HELPDESK/api/v2/views/$VIEW/tickets.json" \
  | jq -r '.tickets[].id' \
  | while read -r id; do
      curl -s -u "$AUTH" -X PUT "$HELPDESK/api/v2/tickets/$id.json" \
        -H 'Content-Type: application/json' \
        -d '{"ticket":{"tags":["needs-review"]}}'
    done
Exportaciones y análisis. Extrae un mes de conversaciones en JSON y pásalo a lo que quieras: una hoja de cálculo, un notebook, un conteo rápido de frecuencia de palabras sobre de qué se quejan realmente los clientes. Esto es mucho más fácil desde la terminal que desde cualquier pestaña de reportes.
Sincronización de conocimiento. Envía tu centro de ayuda, macros o documentos a una base de conocimiento según un calendario para que las respuestas se mantengan al día. Este es el tejido conectivo detrás de cualquier flujo real de helpdesk con IA, ya sea que uses Freshdesk, Gorgias o Help Scout.
Trabajos programados. Envuelve cualquiera de los anteriores en una línea de cron y correrá solo. Un trabajo nocturno que cierra tickets obsoletos, una exportación semanal, una sincronización cada hora: ninguno necesita un humano en el bucle:
# Every night at 2am, run the stale-ticket sweep and log the result
0 2 * * * /opt/support/close-stale.sh >> /var/log/support-cron.log 2>&1
Esta es la capa donde "CLI para atención al cliente" no solo es real, sino que es rotundamente mejor que la interfaz. Es scripteable, repetible y revisable. La trampa es que todo lo anterior mueve datos. Nada de eso decide qué decir a un cliente.
Lo único que una CLI no te puede dar
Aquí es donde está la línea honesta. Puedes scriptear el ticket, pero no puedes scriptear la respuesta. En el momento en que una tarea necesita leer el problema de un cliente, encontrar el conocimiento correcto y decidir una respuesta, has dejado el dominio de curl y entrado en el dominio de un sistema de IA real. Y ese sistema es mucho más que una llamada a un modelo.
Pregúntale a cualquiera que realmente haya lanzado uno. La recuperación por sí sola ya es un stack completo, no una única llamada de búsqueda:
"Muy pocos desarrolladores se dan cuenta de que se necesita más que solo búsqueda vectorial para RAG, así que sigo dedicando muchas de mis charlas a enfatizar el stack COMPLETO de recuperación para RAG."

Y en el momento en que el modelo puede tanto decidir como actuar sobre un ticket, has adquirido un problema de control que un script no resuelve por ti:
"El modo de fallo que sigo viendo no es la alucinación en sí... es la responsabilidad difuminada entre la intención y la ejecución. En cuanto un modelo puede decidir y actuar, ya perdiste el determinismo."
Así que el costo real de un agente de soporte scripteado no es el endpoint. Es la sincronización y recuperación de conocimiento, el estado de la conversación entre turnos, las acciones de herramientas contra el helpdesk, las reglas de escalación, los guardarraíles y una forma de probar todo el conjunto. Ese es el mismo iceberg con el que se topa cada equipo en esta conversación de soporte al cliente headless: la cabeza (tu terminal, tu canal) nunca fue la parte difícil. El cuerpo debajo sí lo es.
Probar el soporte como código es el movimiento que importa
Si hay una idea de "soporte como código" que vale la pena robar, es esta, y es la que las configuraciones scripteadas se saltan. Nunca lanzarías código de aplicación sin pruebas. La lógica de soporte que habla con tus clientes merece el mismo estándar, y el instinto de terminal, "hazlo reproducible", es exactamente lo que hace posible probar.
El problema es que la mayoría de la gente simplemente enciende un agente de IA y espera. La comunidad de soporte sigue dando vueltas a la misma preocupación:
"¿Cómo pruebas que un agente de IA no hará algo catastrófico? ¿La gente realmente hace red-teaming a sus agentes antes de que salgan en vivo?"

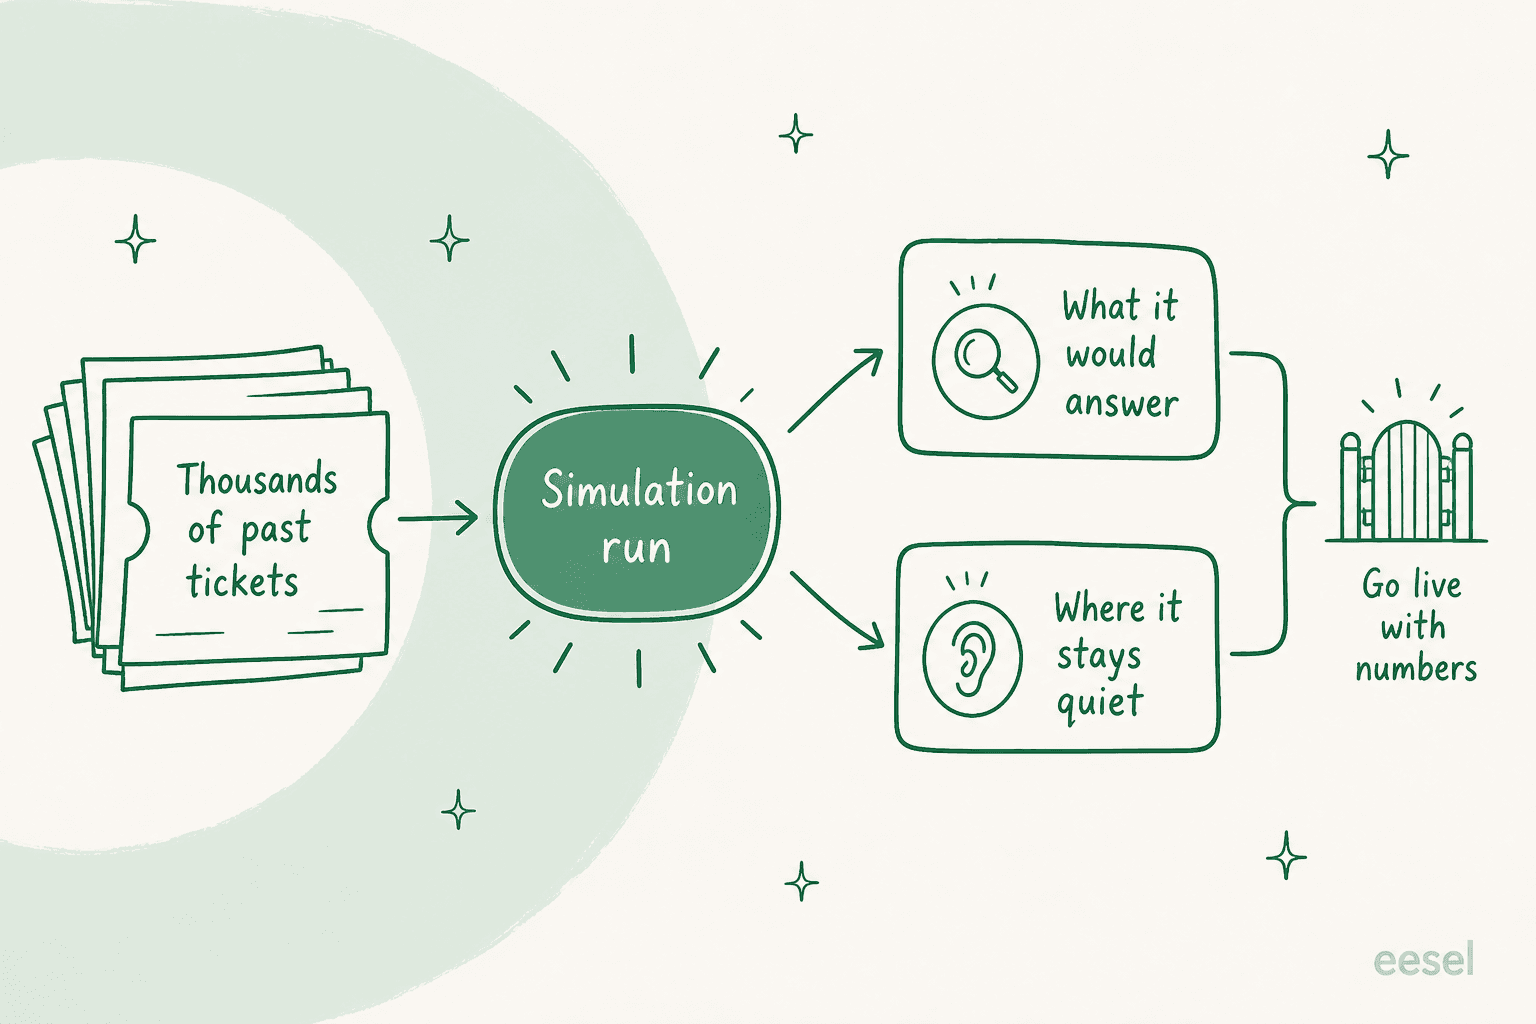
Ya tienes la suite de pruebas. Es tu historial de tickets. La respuesta de soporte como código es reproducir miles de tus tickets reales pasados contra el agente y ver qué habría dicho, dónde habría escalado, y dónde se habría quedado callado, todo antes de que un solo cliente esté involucrado. Eso es exactamente lo que hace la simulación de eesel, y convierte "sal en vivo y espera" en "sal en vivo con números". Es lo más parecido que tiene el soporte a pytest, y es la razón por la que simulamos cada lanzamiento contra tickets históricos primero.
Lo que realmente cuesta
El costo es donde el instinto de construirlo tú mismo se encuentra con la realidad, y los dos caminos facturan en formas muy diferentes.
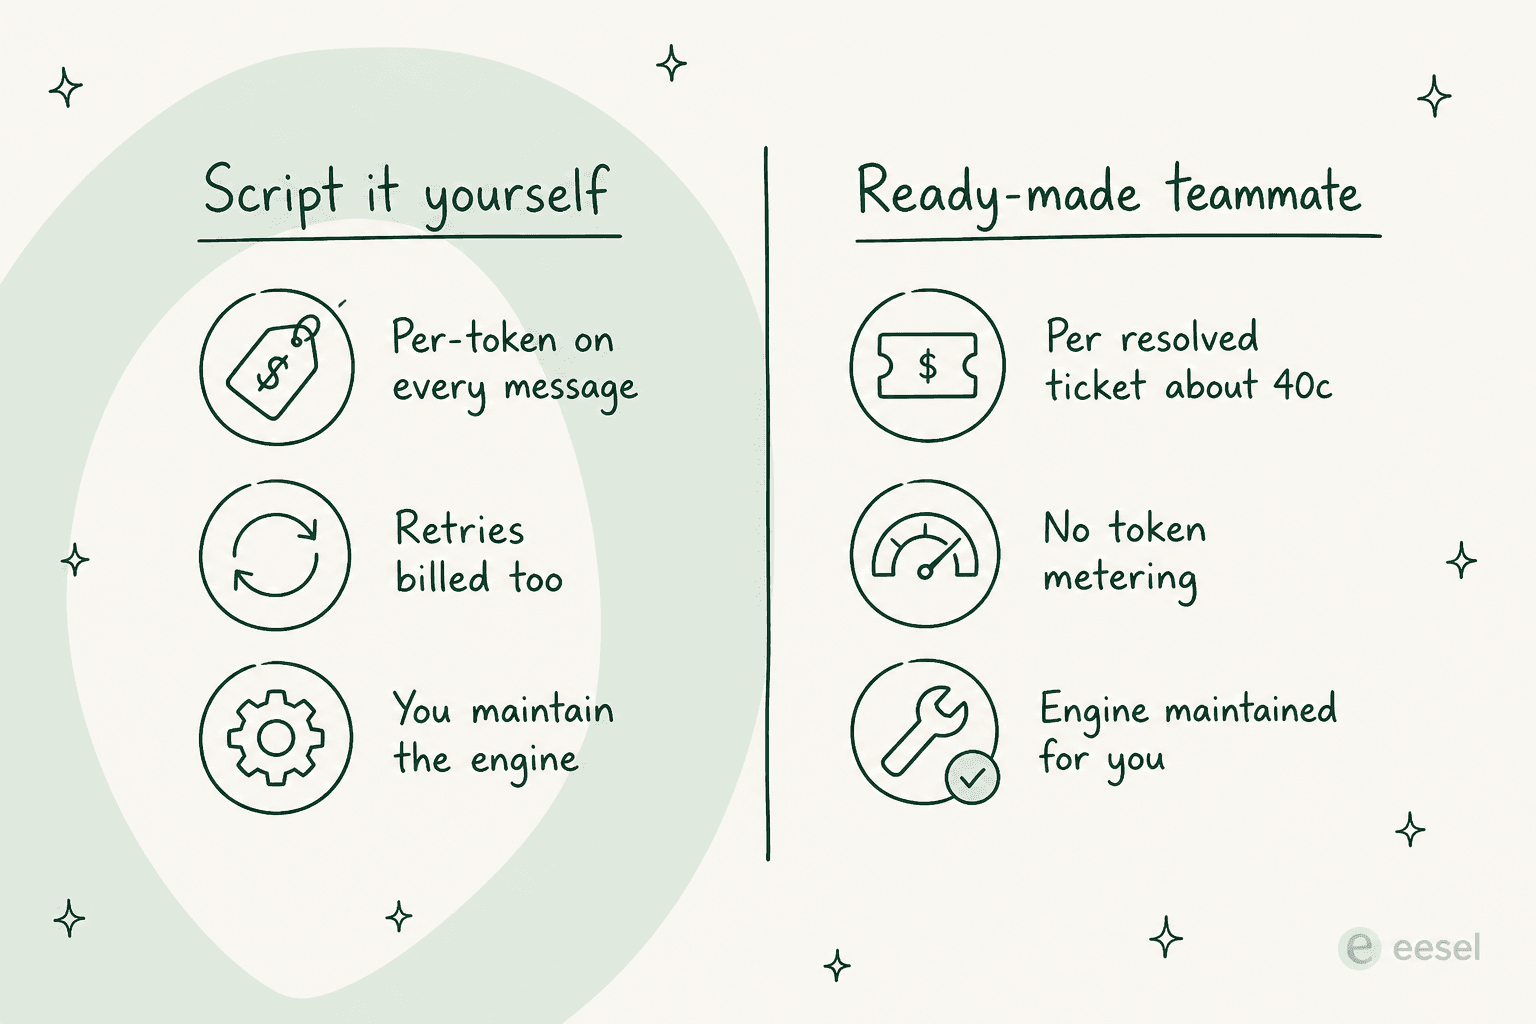
Si scripteas un agente sobre una API de modelo en crudo, pagas por token en cada mensaje, cada reintento, cada fragmento recuperado, se resuelva o no el ticket. Un equipo en el dossier quemó 200 llamadas a la API en un solo día de pruebas y se puso nervioso por la factura ante sus 9,000 interacciones esperadas al mes. Eso es antes de contar el tiempo de ingeniería para construir y mantener recuperación, estado, guardarraíles y evaluaciones.
Así es como se comparan realmente las opciones terminal-first:
| Enfoque | Con qué lo ejecutas | Tú mantienes | Forma de facturación | Mejor para |
|---|---|---|---|---|
CLI de desarrollador del helpdesk (p. ej. zcli) | La CLI del proveedor | Código de app/tema | Herramienta gratis, costo del plan | Construir apps y conectores, no responder tickets |
| API REST + curl/jq | Scripts de bash, cron | Cada script | Normalmente incluido en el plan | Ediciones masivas, exportaciones, configuración, sincronización |
| API de modelo + MCP | Tu propio código de agente | Todo el stack de IA | Por token, resuelto o no | Control total, si tienes el equipo para ello |
| Compañero de equipo listo para usar | Panel + superficie de API | Nada | Por ticket resuelto (~0,40 $) | Tickets resueltos sin construir el motor |
La fila de abajo es la que vale la pena mirar dos veces si tu objetivo es tickets resueltos en lugar de un proyecto de mantenimiento. Igual obtienes una superficie programable contra la cual scriptear, solo que no tienes que construir la inteligencia de resolución debajo.
Prueba eesel para un soporte amigable con la terminal
Si llegaste aquí buscando una "CLI para atención al cliente", probablemente eres del tipo de equipo que quiere una superficie programable, no un panel cerrado. Ese es exactamente el punto medio para el que está construido eesel.
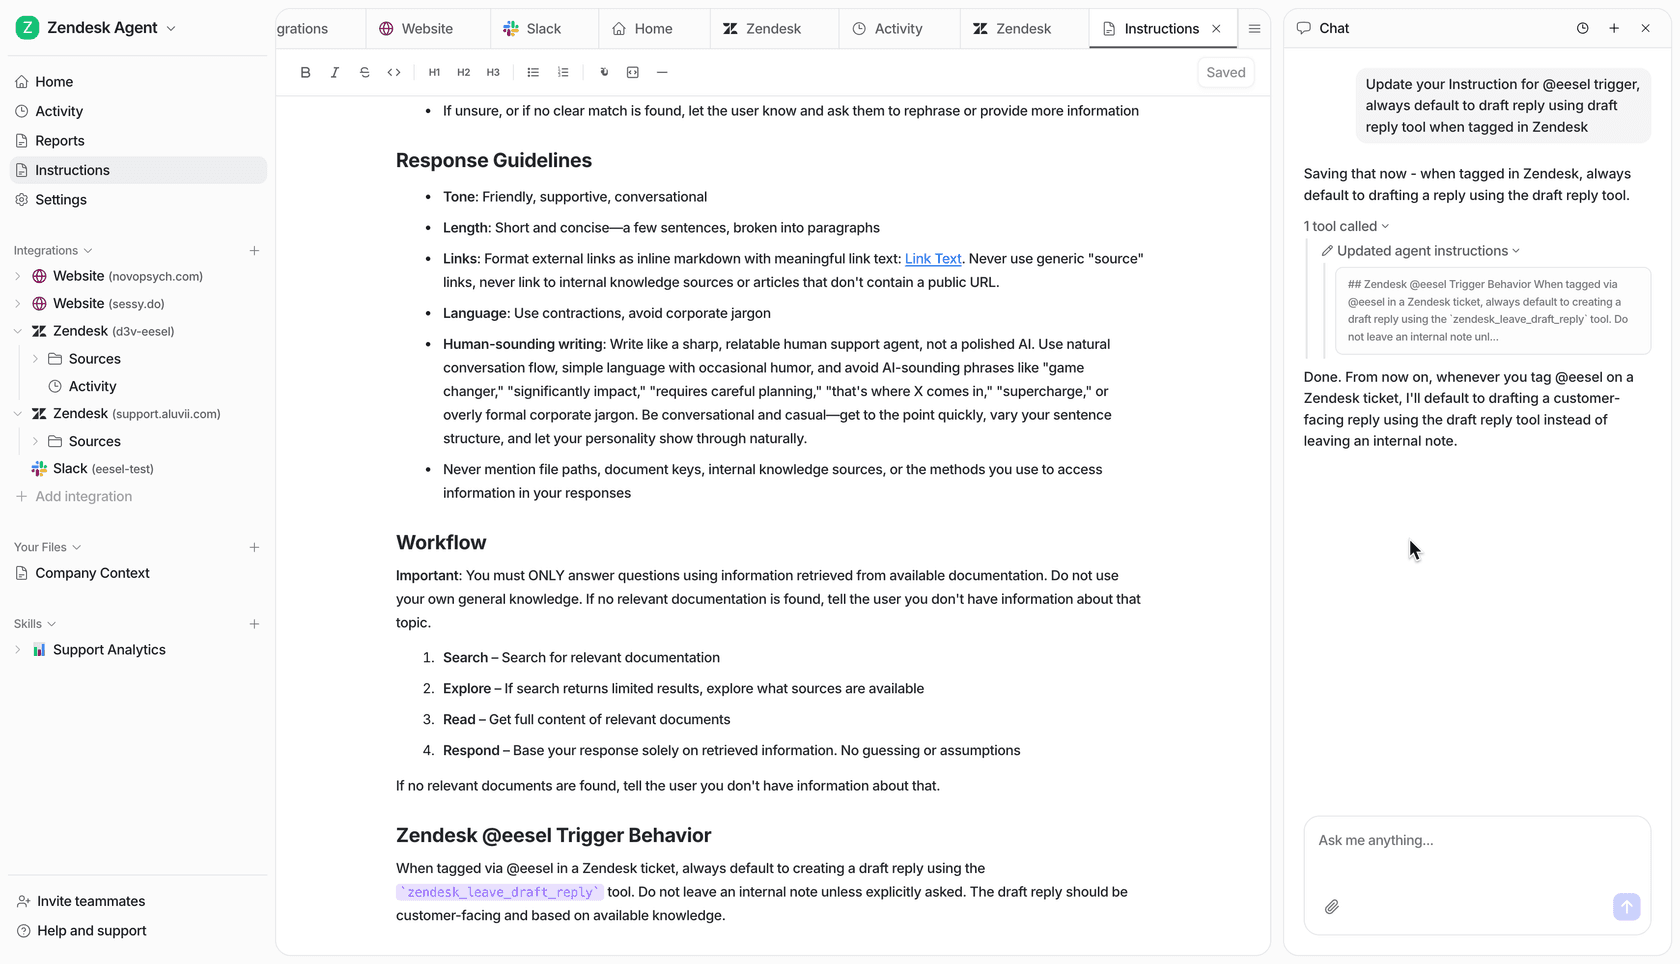
eesel es un compañero de equipo de IA que se conecta al helpdesk que ya usas, Zendesk, Freshdesk, Gorgias, Front, Help Scout, y llega ya sabiendo cómo sincronizar tu conocimiento, buscar pedidos, etiquetar tickets y redactar o enviar respuestas. Trae todo el motor de resolución para que no tengas que reconstruir la recuperación, el estado y los guardarraíles desde cero, y mantiene la superficie programable por la que viniste: una API REST para acciones, webhooks y skills personalizadas que puedes scriptear desde una shell. Luego la parte que más importa: simula sobre tickets pasados antes de salir en vivo, así que despliegas con números en lugar de esperanza. Es gratis para probar, sin tarjeta de crédito y sin llamada de ventas, y la facturación es por ticket resuelto en lugar de por token o por asiento.
Preguntas Frecuentes
¿Existe una única CLI para atención al cliente que resuelva tickets?
support resolve #4821 que entienda el ticket y lo cierre correctamente a la vez. Lo que existe es la CLI de desarrollador propia de un helpdesk (para construir apps, no para responder tickets), la API REST que puedes manejar con curl y jq, y servidores MCP que permiten a un agente de IA en tu terminal actuar sobre los tickets. La inteligencia de resolución todavía tiene que venir de algún lado, y ahí es donde encaja un compañero de equipo listo para usar como eesel.¿Qué puedo automatizar realmente desde la línea de comandos para atención al cliente?
¿En qué se diferencia el 'soporte como código' de simplemente usar la API del helpdesk?
¿Cuánto cuesta una configuración de atención al cliente scripteada frente a una lista para usar?
¿Puedo probar un agente de soporte de IA antes de que salga en vivo desde la terminal?


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.