

Mein Urteil auf einen Blick
Wenn Sie nur einen Abschnitt lesen, lesen Sie diese Tabelle. Sie fasst den Test in den sechs Dimensionen zusammen, die mir wichtig sind, wenn ein solches Modell auf meinem Tisch landet.
| Dimension | Note | Was ich gefunden habe |
|---|---|---|
| Geschwindigkeit | A | 32,8 ms p50 pro gerouteter Frage, etwa 7,8-mal schneller als Jevs 236-276 ms |
| Kalibrierung | A | ECE 0.081 nach Temperatur-Neuanpassung vs. Jevs 0.246, echte 3x |
| Zero-Shot-Genauigkeit | D | ~0.362 Basis, kaum über der Zufallsbasis von 0.318 |
| Genauigkeit nach Fine-Tuning | A- | 0.766 auf dem typisierten Set, über der Teacher-Obergrenze von 0.735 |
| Aufgaben mit vielen Klassen | C | Verschlechtert sich ab ~20 Optionen; 0.425 bei 77 Klassen in Banking77 |
| Kosten und Lizenz | A+ | Apache 2.0, $0 beim Self-Hosting, läuft Air-Gapped |
Die Form dieser Bewertung ist der ganze Test: brillant bei Schnelligkeit, Ehrlichkeit und Preis; mittelmäßig, bis Sie in Fine-Tuning investieren; schwach bei breiter Klassifikation. Wenn Sie statt des Urteils die vollständige Architektur-Durchsicht möchten, habe ich sie separat im Laya AI Deep Dive beschrieben.
Was Laya AI ist, in einem Absatz
Die meiste KI, die Sie bisher genutzt haben, ist autoregressiv: Sie sagt das nächste Token voraus, dann das nächste und baut so einen Satz. Das ist ideal, um eine Antwort zu schreiben, und verschwenderisch für eine Ja-Nein-Entscheidung. Genau diese Lücke trennt eine echte Conversational-AI-Plattform von einem rohen Modell. Laya ist die andere Art: ein bidirektionaler Encoder, der die gesamte Eingabe auf einmal liest und eine feste Frage beantwortet, indem er Ihre Optionen bewertet, statt sie auszuschreiben. Convai nennt es ein System-1-Modell, das instinktive Sofort-Urteil, im Gegensatz zum langsamen System-2-Denken eines generativen LLM. Der Entwickler, Nandakishor Mukkunnoth, fasst die Motivation in einem Satz zusammen:
"Not every AI problem requires an autoregressive chatbot."
Er hat recht. Wenn Sie je ein 8B-Modell an einen Prompt gehängt haben, der mit „respond only with JSON" endet, nur um ein Ticket zu routen, kennen Sie genau den Schmerz, den er löst. Dieser Test setzt voraus, dass Sie die Prämisse teilen, und prüft, ob die Umsetzung hält.
Sollten Sie Laya AI nutzen? Ein kurzer Eignungs-Check
Die Kaufentscheidung ist hier ungewöhnlich klar, deshalb zeige ich sie nicht im Fließtext, sondern so, wie ich sie einem Kollegen erklären würde. Wählen Sie den Zweig, der zu Ihnen passt.
Was die Benchmarks tatsächlich sagen
Hier der vollständige Vergleich, den das Projekt gegen Jev veröffentlicht hat. Er ist dicht, aber die Kernaussage lautet: Laya (geroutet) liegt auf den gemeinsamen öffentlichen Datensätzen leicht vor Jev und ist dabei deutlich schneller und besser kalibriert.
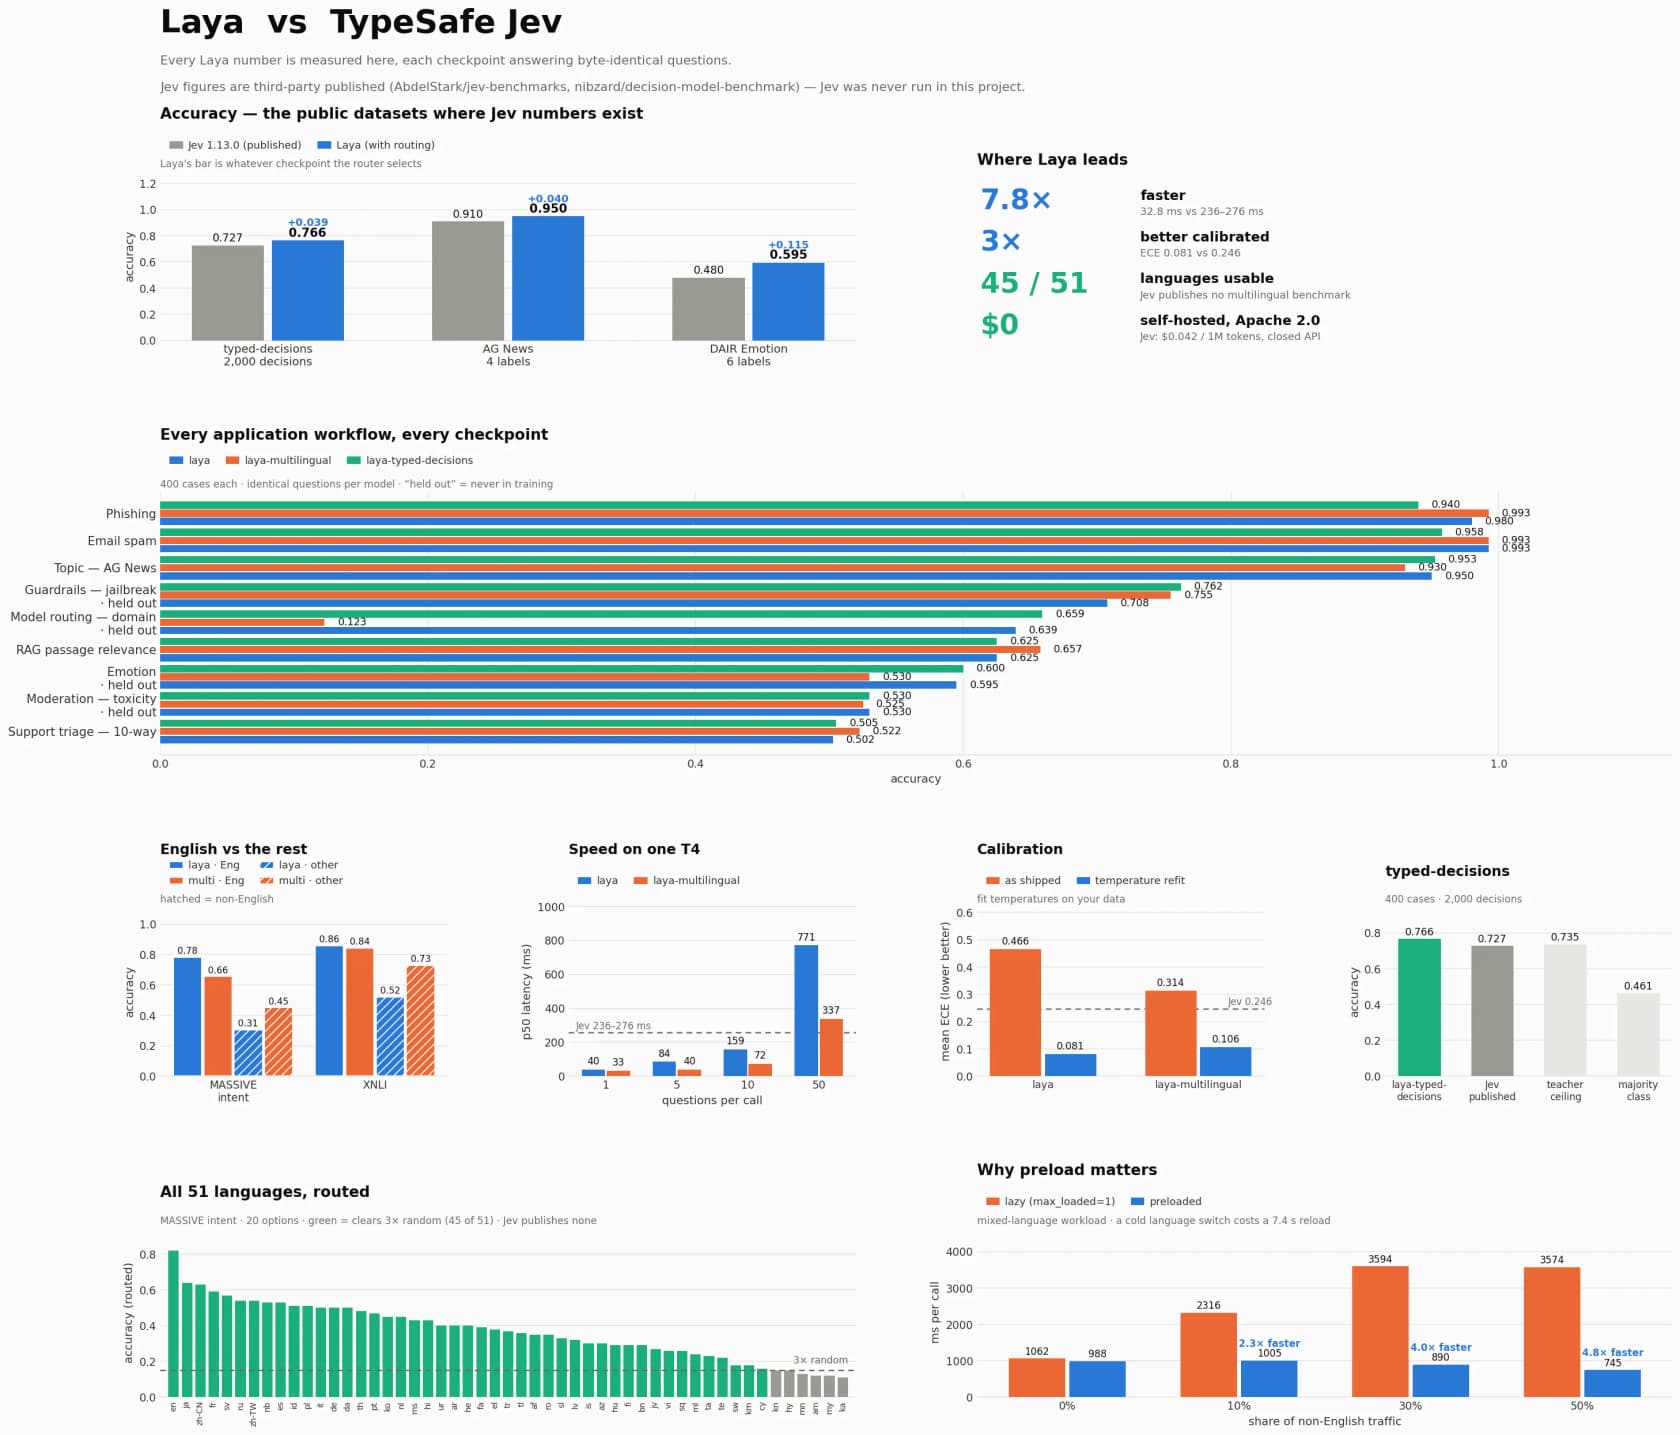
Die drei Zahlen, die man mitnehmen sollte, alle auf einer einzelnen Tesla T4 gemessen, wobei die Jev-Werte von Dritten veröffentlicht wurden (Convai hatte keinen API-Zugang):
- Latenz: 32,8 ms p50 für eine geroutete Frage, gegenüber Jevs 236 bis 276 ms. Das sind die 7,8x.
- Kalibrierung: ECE von 0.081 nach Temperatur-Neuanpassung, gegenüber Jevs 0.246, ein 3x besserer Kalibrierungswert.
- Genauigkeit: 0.766 auf dem typisierten Set mit 2.000 Entscheidungen, gegenüber Jevs 0.727, und es übertrifft die Teacher-Obergrenze von 0.735.
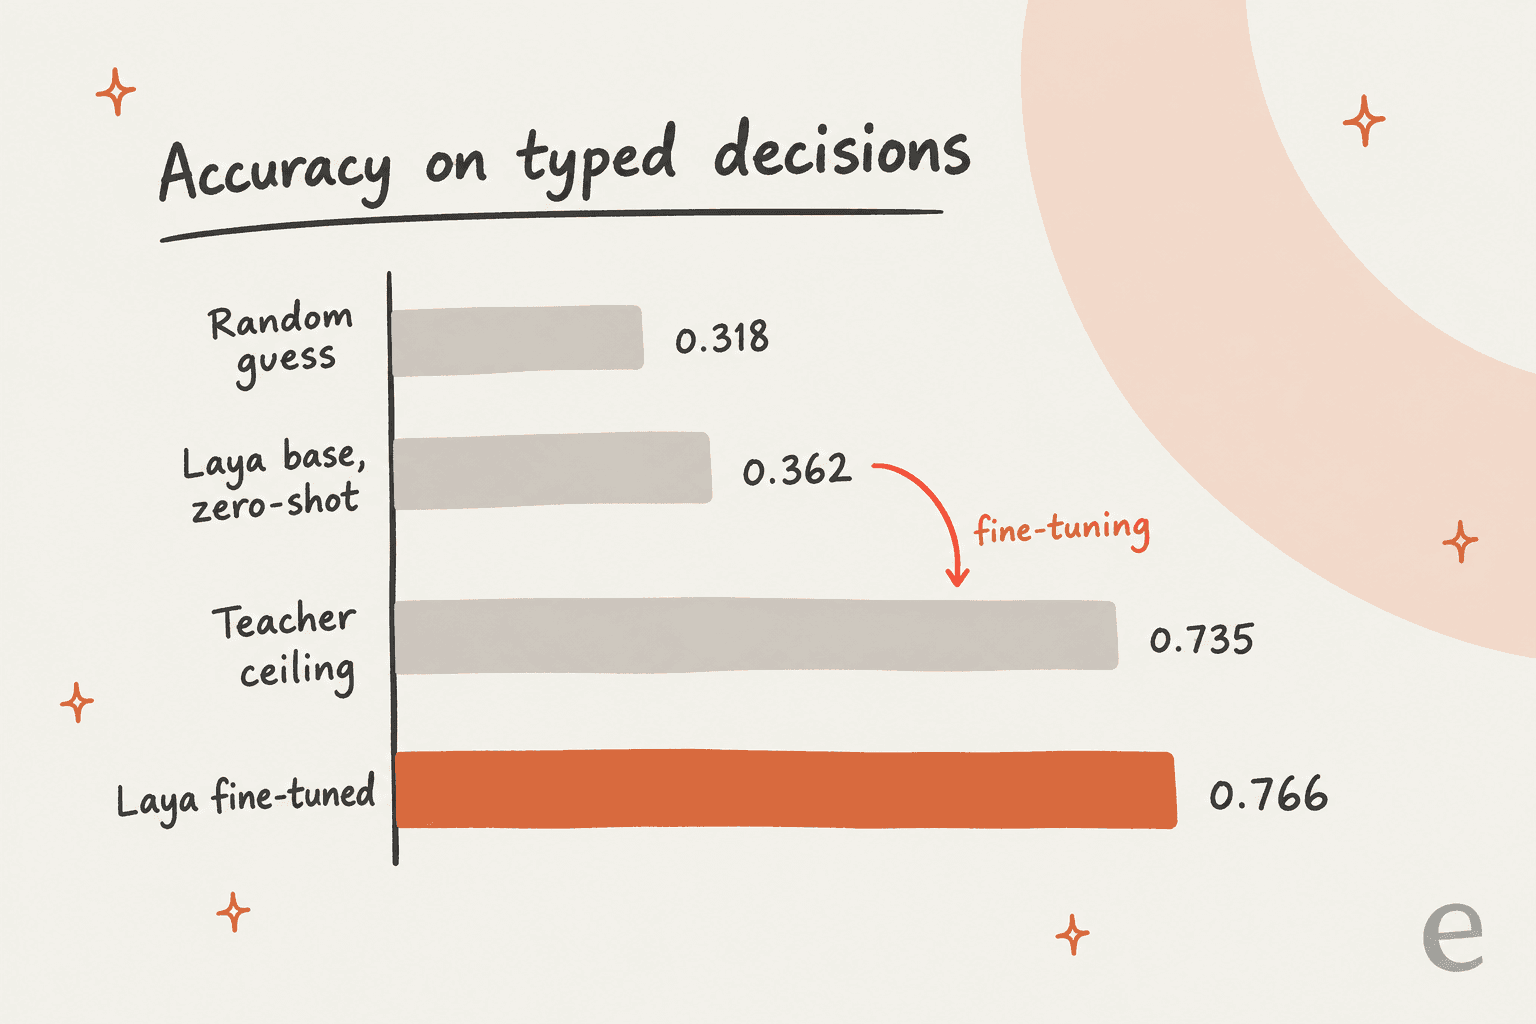
Und dann das Sternchen, das jede ernsthafte Diskussion des Launchs dominierte. Diese 0.766 sind der feinabgestimmte Checkpoint. Die unveränderten Basismodelle erreichen im selben Benchmark etwa 0.362, einen Hauch über der Zufallsbasis von 0.318. Convais eigener Abschnitt zu den Einschränkungen sagt das offen, was ich respektiere. Auf Hacker News, wo der Launch über 1.300 Punkte erreichte, lautete der wichtigste kritische Kommentar genau so:
"This should be way up in the article. Fine tuning is a pain, requiring it for good results put Laya in a whole different category vs Jev"

Das ist ein berechtigter Treffer und die wichtigste Zeile in diesem ganzen Test. Jev wird als zero-shot nutzbar verkauft; Laya ist, ehrlich gelesen, eine Basis, die man spezialisiert.
Wo Laya wirklich glänzt
Lässt man das Jev-Drama weg, ist Laya ein schneller Klassifikator mit ehrlicher Konfidenz, und das ist viel wert. Die Kalibrierung würde ich mir am ehesten holen, und sie deckt sich mit etwas, das ich im Betrieb von Support-Automatisierung hart gelernt habe: Der gefährliche Fehler ist nicht ein Bot, der „Ich weiß es nicht" sagt, sondern einer, der selbstsicher falsch liegt. Ein Modell mit ehrlichen Wahrscheinlichkeiten lässt Sie nach Konfidenz filtern und unsichere Fälle eskalieren, und das ist mir mehr wert als ein Punkt rohe Genauigkeit. Convai trainiert es mit einem Verfahren namens RLCD, Reinforcement Learning gegen streng korrekte Scoring-Regeln, und Nandakishors Satz dazu, warum naives Training scheitert, ist der schärfste der ganzen Beschreibung:
"Naive RL maximizes accuracy by destroying calibration. It turns your model into a confidently wrong machine."
Die Ergebnisse pro Workflow belegen, wo es stark ist. Laya meldet:
- E-Mail-Spamfilter: 0.993
- Phishing-Erkennung: 0.980
- LLM-Guardrails und Jailbreak-Erkennung: 0.755 bis 0.762 (0.931 bei 50 % selektiver Abdeckung)
- RAG-Passagenrelevanz: 0.657
- Support-Ticket-Routing, 10 Klassen: 0.522
Die binären Sicherheitsentscheidungen sind exzellent, und der Routing-Wert ist eine solide Basis für die Art von KI-Agent-Beispielen, die Teams tatsächlich ausliefern. Der Betrieb ist ebenso gut: Geroutet liegen 45 von 51 Sprachen über dem 3-Fachen des Zufalls, während Jev keine veröffentlichten mehrsprachigen Zahlen hat.
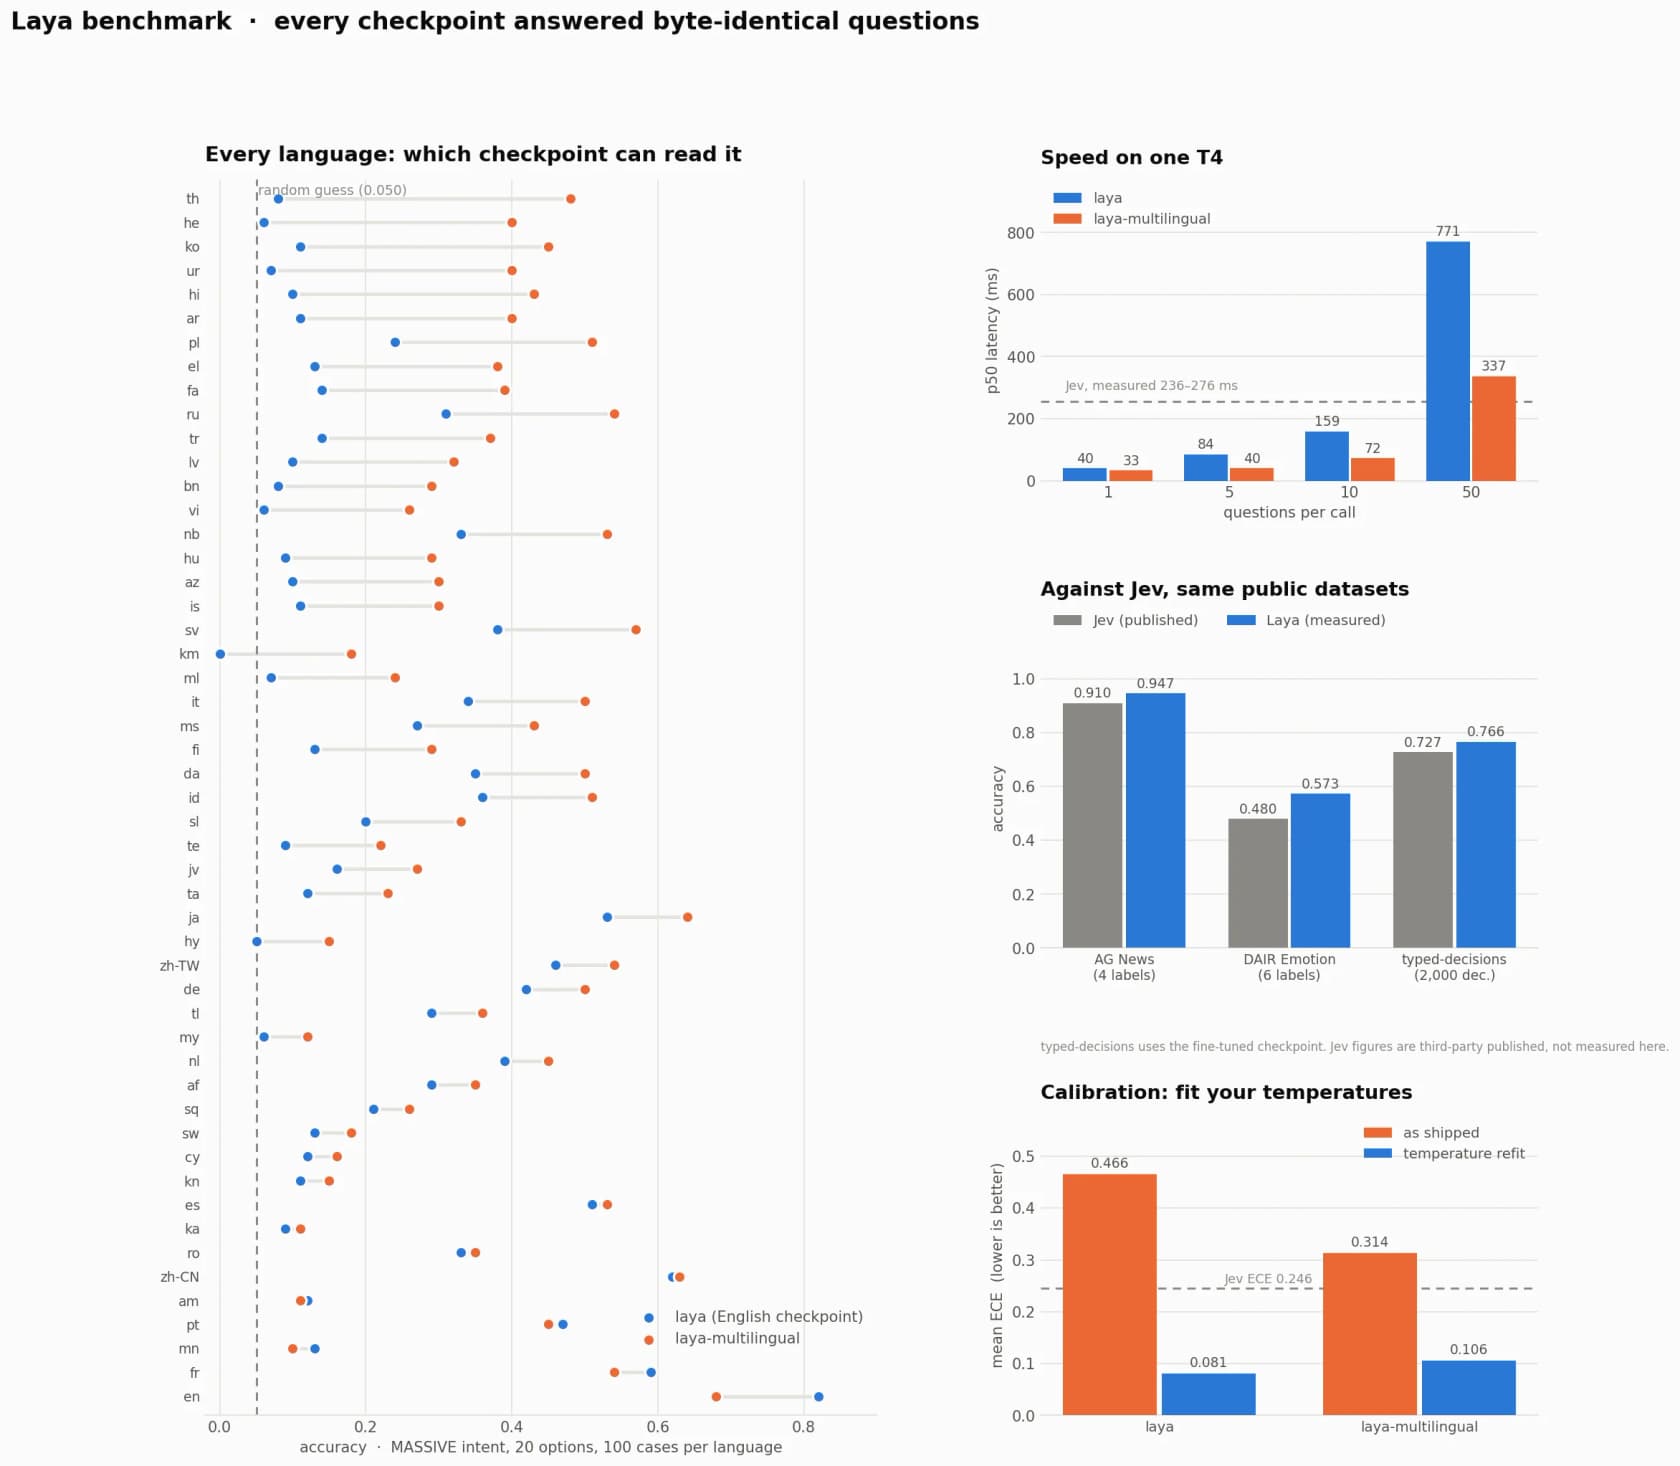
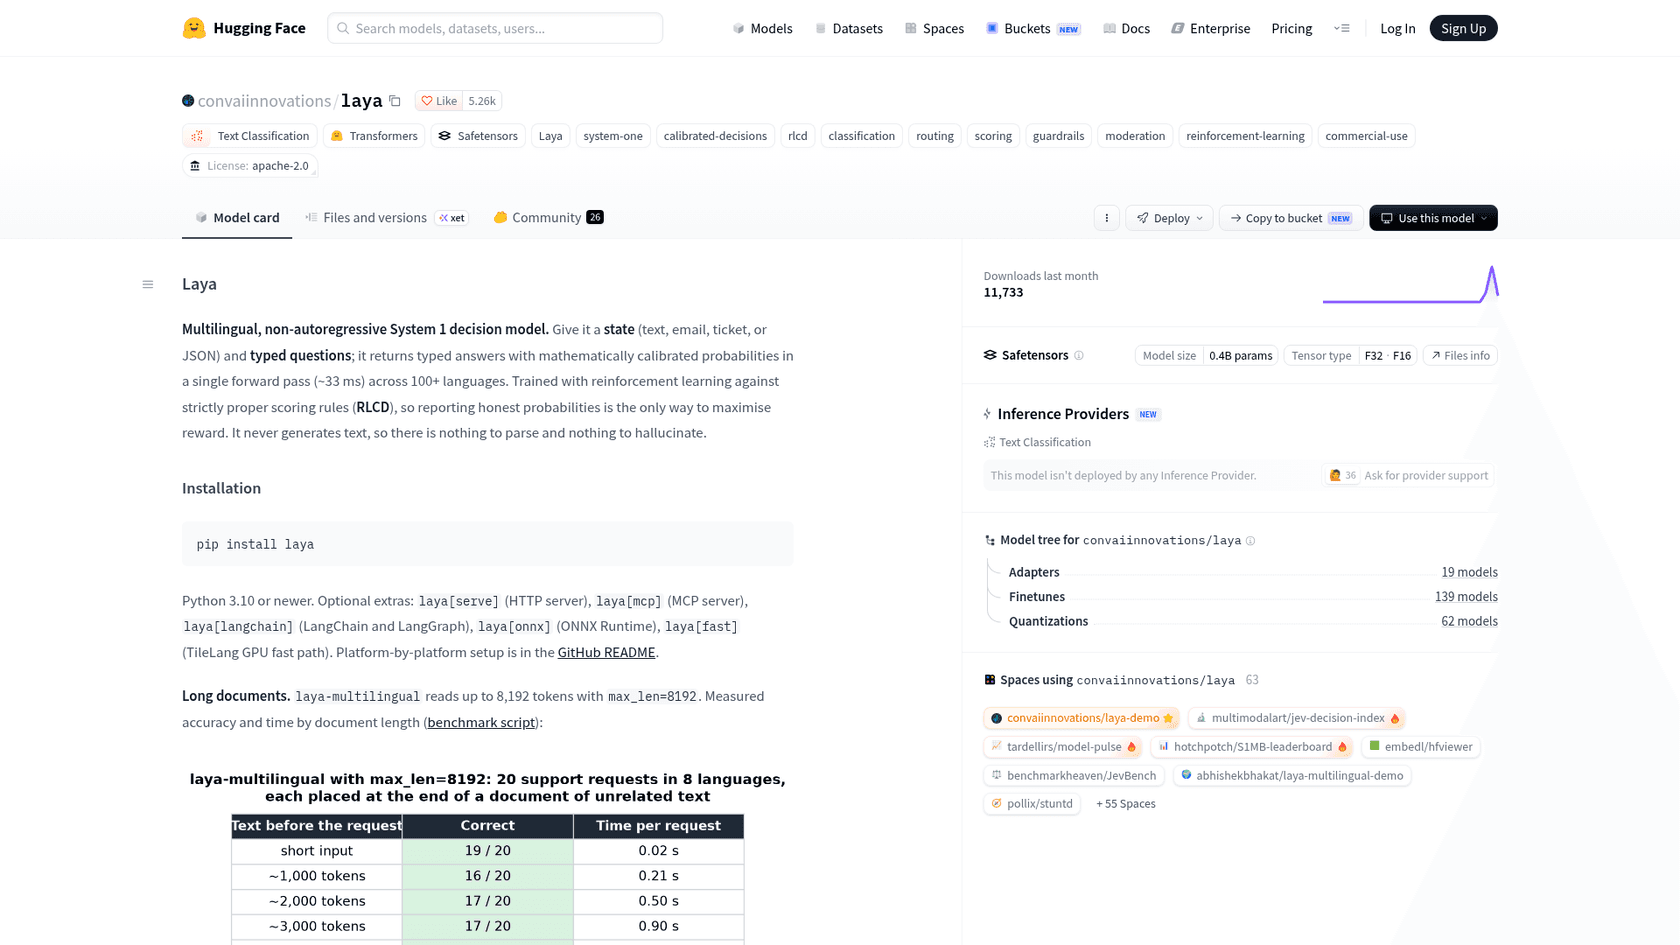
Bei den Kosten gilt: Apache 2.0 und Self-Hosting bedeuten $0.00 pro Million Tokens gegenüber Jevs $0.042, eine Lücke, die schnell wächst, wenn man sie mit den Kosten eines menschlichen Agenten vergleicht. Außerdem läuft es Air-Gapped auf Ihrer eigenen Hardware, was für alle mit HIPAA- oder DSGVO-Auflagen zählt. Die Installation ist ein Einzeiler, pip install laya, und Router(preload=True) hält alle Checkpoints im Speicher, sodass Sie ein 7- bis 10-sekündiges Nachladen beim Sprachwechsel vermeiden.
Die Modellkarte listet inzwischen optionale Extras für einen HTTP-Server, einen MCP-Server, LangChain und ONNX. Das GitHub-Repo dokumentiert außerdem einen Jev-kompatiblen Endpunkt /v1/systemone, sodass Sie Laya als API bereitstellen können, statt es im selben Prozess aufzurufen.
Wo es Schwächen zeigt
Ich will fair sein, denn die Lücken sind real, aber enger, als das Internet sie dargestellt hat. Im Test fielen drei Dinge auf.
Erstens ist das Fine-Tuning für Genauigkeitsarbeit nicht optional, was Laya als No-Code-Chatbot für Nicht-Entwickler ausschließt. Die Zero-Shot-0.362 ist die ehrliche Zahl, und ein Praktiker auf HN beschrieb die Kosten davon besser, als ich es könnte:
"Idk, your limitations section sure makes it seem less drop in and less general than Jev... I don't want to manage GPUs / CPUs now. I don't want to maintain my corpus and retrain as my product's data distribution shifts... I do just want a reasonably good general classifier served to me with a great devex and calibrated confidence scores to help me figure out when to fallback."
Zweitens tut sich Laya bei Klassifikation mit vielen Klassen schwer, was zählt, wenn Sie gehofft hatten, eine ganze Flotte eigener KI-Modelle durch einen Router zu ersetzen. Auf Banking77 (77 Labels) erreichte Laya 0.425 gegenüber Jevs 0.870, weil jede Option beim Standardbudget nur 3 bis 4 Tokens hat, um sich abzuheben. Die Lösung ist ein höheres Token-Budget oder eine Aufteilung in eine Hierarchie von grob zu fein, aber ab Werk ist ein Router mit 10 Klassen komfortabel und einer mit 77 nicht.
Drittens ist der mehrsprachige Fehlermodus übel, wenn Sie den Router ignorieren. Das englische Wurzelmodell versagt außerhalb lateinischer Schriften: Im Test über 51 Sprachen erreichte es 0.000 Genauigkeit bei Khmer und meldete dabei 0.952 Konfidenz, genau die Falle des „selbstsicher falsch", die das Modell vermeiden soll. Laya liefert einen eingebauten Router, der die Schrift in unter einer halben Millisekunde erkennt und den mehrsprachigen Checkpoint wählt. Das ist also lösbar, aber Sie müssen ihn nutzen.
Nichts davon ist ein Ausschlusskriterium. Es sind die Grenzen einer Komponente, und sie sind alle dokumentiert, was mehr ist, als die meisten Launches schaffen.
Was die Community tatsächlich denkt
Die Reaktion war laut und, wenn man das Drama um Urheberschaft ausfiltert, nützlich. Der am häufigsten wiederholte Kritikpunkt war der Zero-Shot-Hinweis nahe am Zufall, wörtlich zitiert von mehreren Leuten, die ihn an den Anfang der Ankündigung gehören fanden. Die Gegenposition der Begeisterten war genauso einheitlich:
"In the limitations you say that 'Out-of-the-box base models score ~0.35 on the typed-decisions benchmark (near random)...' - but that's the whole point, you can obviously fine-tune specialized models but having a model follow you instructions and be promotable and fast makes it massively easier to use."
Und der praktische Wert war klar, als jemand den Lärm durchschnitt:
"The ability to knock out any arbitrary classification problem in minutes instead of in a week is a big deal... I don't want to spend a week to create a dataset, finetune a model, and set up infrastructure to run the model, every time I have a small routing or classification problem."
Es gab auch breite Erleichterung, dass die offene Version überhaupt existiert, selbst bei Skeptikern, die die „can't hallucinate"-Formulierung beim Jev-Launch als Köder für Risikokapital lasen. Dort lande ich ungefähr auch, und es erinnert daran, wie die Community auf Anthropics Claude-Updates für den Support reagierte: Verdientes Vertrauen schlägt laute Versprechen.
Die Kontroverse, kurz gefasst
Man kann Laya nicht testen, ohne die Entstehungsgeschichte zu erwähnen, denn sie ist der halbe Grund für den viralen Erfolg. Nandakishors Darstellung ist ein Prioritätsanspruch: Er sagt, er habe diesen nicht-autoregressiven, per RL trainierten Ansatz in einem arXiv-Paper vom März 2025 veröffentlicht, ein volles Jahr bevor TypeSafe Jev startete.
Die Community war dazu fair gespalten, einige merkten an, dass sauberes Branding und eine nutzbare API selbst das Produkt sind. Mein Standpunkt: Der Streit um die Urheberschaft lenkt von einer starken Veröffentlichung ab. Ob Laya zuerst da war oder nicht, es ist offen, schnell, ehrlich dokumentiert und funktioniert gut für die Aufgaben, bei denen es ehrlich ist. Die vollständige Chronologie schildere ich in der Laya-AI-Übersicht, falls Sie sie lesen möchten.
Wo ein Entscheidungsmodell hinpasst und wo ein KI-Teammate
Das ist der Teil, der mir am wichtigsten ist, denn ich baue das beruflich. Ein Entscheidungsmodell und ein KI-Teammate sind keine Konkurrenten, sie leben auf unterschiedlichen Ebenen.
Laya ist Infrastruktur. Es beantwortet „in welche Warteschlange gehört dieses Ticket" oder „ist das dringend" in 33 ms und macht diese eine Sache wunderbar. Aber es liest Ihr Help-Center nicht, entwirft keine Antwort, prüft keinen Bestellstatus und schließt die Konversation nicht. Das sind die eigentlichen Aufgaben, die ein Support-Team erledigt braucht, und dafür braucht es ein Modell, das handelt, nicht nur klassifiziert. Das ist der Unterschied zwischen Komponente und Mitarbeiter.
eesel ist eine Plattform für KI-Teammates, und der KI-Helpdesk-Teammate ist der für den Support eingestellte. Er schließt sich Ihrer bestehenden Warteschlange an, in Zendesk, Freshdesk oder wo auch immer Sie schon arbeiten, liest Ihre früheren Tickets und Dokumente und löst das ganze Ticket von Anfang bis Ende. Unter der Haube trifft er dieselben schnellen, kalibrierten Routing- und Konfidenz-Entscheidungen, in denen Laya gut ist, aber er umgibt sie mit dem Lesen, Entwerfen und Handeln, das aus einer Klassifikation eine gelöste Konversation macht. Wenn Sie Entwickler sind und diesen Teammate lieber skripten als anklicken, lassen Sie mit der eesel CLI und dem MCP-Server eine Person, ein Skript oder einen Coding-Agenten wie Claude Code denselben Workspace steuern, den auch das Dashboard nutzt. Das ist die natürliche Heimat für genau die Art programmatischer Klassifikation, die Laya-Fans wollen.
eesel ausprobieren
Wenn Sie sich Laya ansehen, weil Sie klügere, schnellere Support-Entscheidungen wollen, sollten Sie klar benennen, was Sie kaufen. Ein Entscheidungsmodell gibt Ihnen eine Komponente zum Bauen. Ein KI-Support-Teammate gibt Ihnen den fertigen Mitarbeiter.

Dem Kalibrierungsargument von Laya traue ich, weil ich die Alternative erlebt habe. Ich habe gesehen, wie selbstsicher klingende Bots in Live-Warteschlangen stillschweigend falsche Antworten gaben. Deshalb läuft jeder eesel-Rollout zuerst als Simulation über Ihre eigenen historischen Tickets, sodass Sie die genaue Lösungsquote und die genauen Antworten sehen, bevor ein einziger Kunde berührt wird. Die Preisgestaltung ist ein fester Monatspreis, ab $299/Monat für 500 Credits (1 Credit pro Ticket oder Chat), ohne Gebühren pro Nutzer, und es gibt einen kostenlosen Plan mit 100 Credits. Wenn Sie die Entscheidung umgesetzt statt nur etikettiert haben wollen, ist das die Ebene, die Sie sich ansehen sollten.
Was ich einem Freund sagen würde
Laya ist ein echter Beitrag, und ich bin froh, dass es offen ist. Wenn Sie Entwickler mit Klassifikations- oder Routing-Problemen sind und bereit zum Fine-Tuning, ist es eines der interessantesten neuen Werkzeuge des Jahres: schnell, kalibriert, mehrsprachig und kostenlos. Lesen Sie zuerst die Modellkarte, sie ist erfrischend ehrlich über die eigenen Grenzen, und diese Ehrlichkeit ist ein großer Teil davon, warum dieser Test positiv ausfällt.
Aber lesen Sie den Abschnitt zu den Einschränkungen, bevor Sie darauf aufbauen. Die Zero-Shot-Werte liegen nahe am Zufall, die Konfidenz muss an Ihren Daten neu angepasst werden, und breite Klassifikation braucht Fine-Tuning. Behandeln Sie es als das hervorragende Fundament, das es nach eigener Aussage ist. Und wenn Sie eigentlich die ganze Support-Arbeit erledigt haben wollen statt einer einzelnen zurückgegebenen Entscheidung, greifen Sie zu einem Teammate, nicht zu einer Komponente.
Häufig gestellte Fragen
Lohnt sich Laya AI im Jahr 2026?
Für die richtige Aufgabe, ja. Mein Laya AI Test kommt zu diesem Ergebnis: Wenn Sie Entwickler sind, Routing- oder Klassifizierungsprobleme haben und bereit zum Fine-Tuning sind, ist Laya eine der interessantesten offenen Veröffentlichungen des Jahres: schnell, kalibriert, mehrsprachig und kostenlos. Wenn Sie ein ganzes Support-Ticket lösen statt nur etikettieren wollen, brauchen Sie stattdessen einen KI-Helpdesk-Teammate.
Was kostet Laya AI?
Laya ist kostenlos. Die Gewichte stehen unter Apache 2.0 auf Hugging Face, Self-Hosting kostet also $0.00 pro Million Tokens gegenüber den $0.042 pro Million Tokens der geschlossenen Jev-API. Ihre einzigen echten Kosten sind die GPU oder CPU, auf der Sie es betreiben. Wenn Sie lieber gar kein Modell betreiben möchten: eesel kostet einen festen Monatspreis ab $299/Monat für 500 Credits (1 Credit pro Ticket oder Chat) ohne Gebühren pro Nutzer.
Eignet sich Laya AI für das Routing von Support-Tickets?
Es ist eine starke Basis dafür, aber kein fertiger Router. Auf einem Triage-Set mit 10 Klassen erreicht das Basismodell 0.522, und jede Antwort liefert einen kalibrierten Konfidenzwert, auf den Sie Schwellen setzen können. Mehr dazu in unserer Übersicht der besten KI für Support-Ticket-Triage und zur Funktionsweise der Ticket-Triage selbst.
Muss ich Laya AI feinabstimmen?
Für ernsthafte Genauigkeit meistens ja. Ohne Anpassung liegen die Basis-Checkpoints im Benchmark für typisierte Entscheidungen nahe am Zufall (~0.362); die Schlagzeilenzahl 0.766 stammt aus dem Fine-Tuning auf genau diese Aufgabe. Sehen Sie Laya als schnelles Fundament zum Spezialisieren und passen Sie die Temperatur an Ihren eigenen Daten neu an, bevor Sie den Konfidenzwerten trauen. Tools wie eesel sparen sich diesen Schritt, weil sie direkt aus Ihrer Wissensdatenbank lernen.
Kann Laya AI wirklich nicht halluzinieren?
Innerhalb seines Ausgaberaums, ja. Laya gibt nie Text-Tokens aus, nur Wahrscheinlichkeiten über eine feste Menge von Optionen, die Sie definieren. Eine erfundene Kategorie oder fehlerhaftes JSON ist daher konstruktionsbedingt unmöglich. Es kann trotzdem falsch liegen. Deshalb zählt der kalibrierte Konfidenzwert weit mehr als der Marketing-Spruch, und deshalb schlägt eine ehrliche Lösungsquote jede selbstsichere Vermutung.
Laya AI vs. Jev: Was ist besser?
Sie zielen auf unterschiedliche Käufer. Jev wird als nutzbare Zero-Shot-API angeboten; Laya ist eine offene Basis, die Sie spezialisieren, und nach den eigenen Benchmarks ist es etwa 7,8-mal schneller und 3-mal besser kalibriert. Das Fazit meines Laya AI Tests: Wählen Sie Laya, wenn Sie selbst hosten und feinabstimmen, und Jev, wenn Sie eine API wollen, die ungetunt funktioniert. Einen breiteren Blick bietet unsere vollständige Laya-AI-Analyse.
Was lässt sich mit Laya AI konkret bauen?
Schnelle strukturierte Entscheidungen: Spam- und Phishing-Filter, LLM-Guardrails, Passagenrelevanz für RAG, Sentiment-Scoring und Routing. Es passt überall dort, wo Sie bisher ein generatives Modell für eine kleine Entscheidung überbezahlen. In einem Support-Stack ergänzt es sich natürlich mit KI-Stimmungsanalyse und automatischem Ticket-Tagging.