

要約
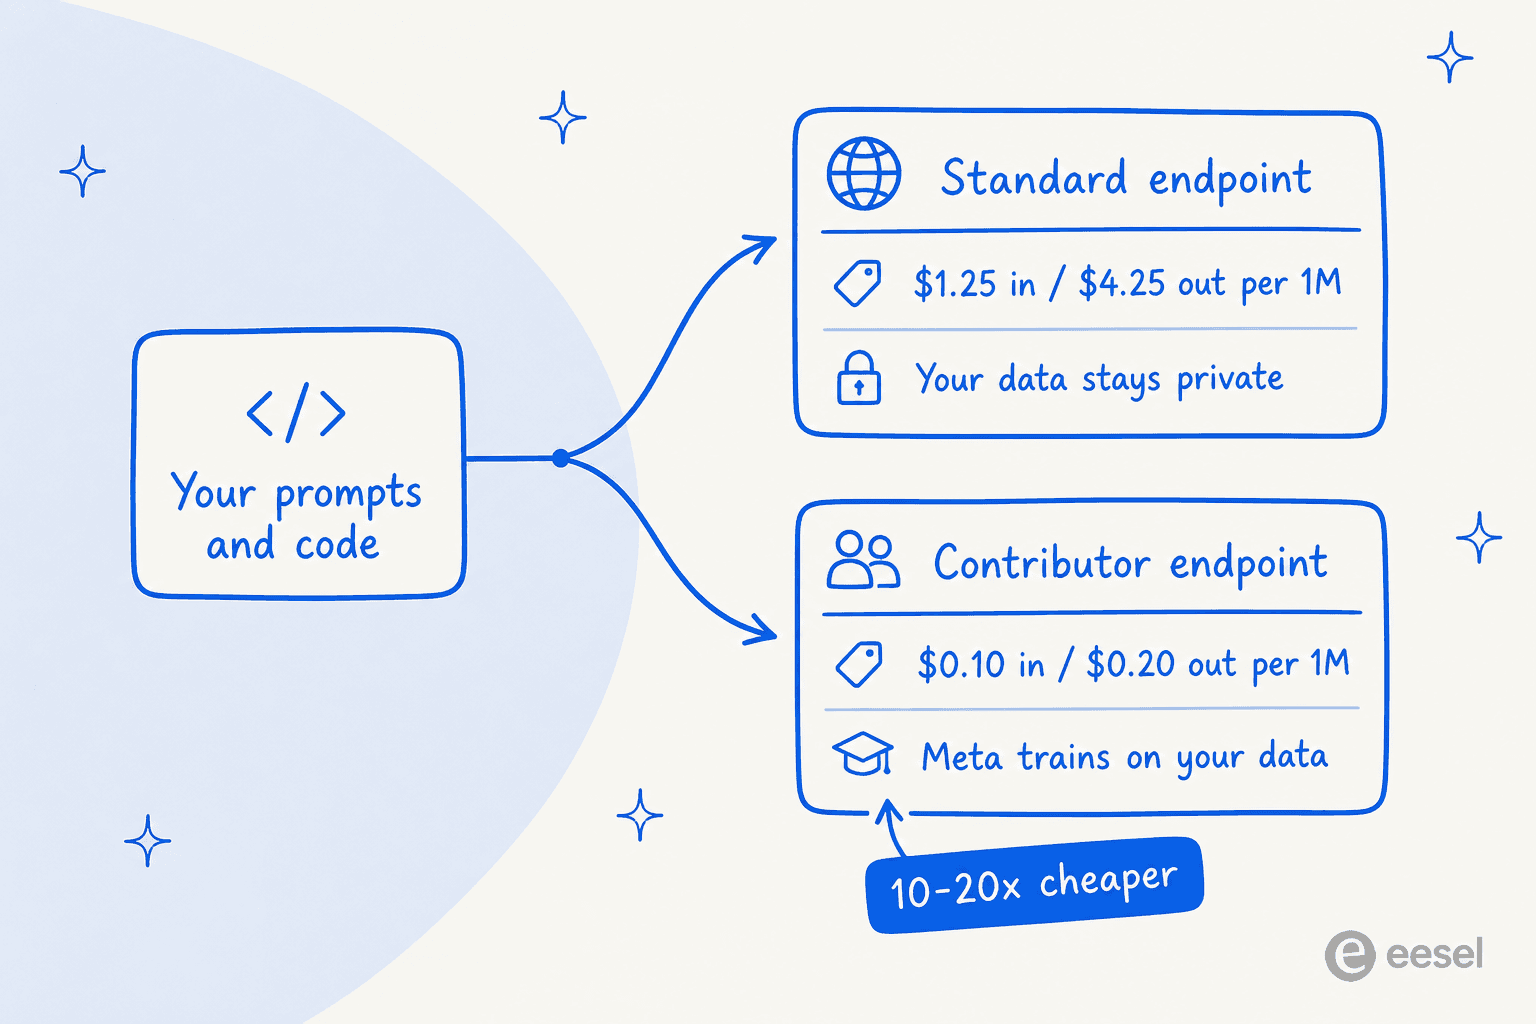
MetaのMuse Spark 1.3には、同じモデルに対して2つの価格設定があり、その差は完全に「データ」の扱いに依存します。標準エンドポイントはxhighティアにおいて入力100万トークンあたり$1.25、出力100万トークンあたり$4.25で、トラフィックのプライバシーは守られます。一方、コントリビューター・エンドポイントは100万トークンあたり約$0.10 / $0.20と10〜20倍安価ですが、送信したデータをMetaが学習に使用することに同意する必要があります。
表示価格は物語の半分に過ぎません。Muse Spark 1.3は異例なほど冗長(話し好き)であるため、トークン単価が低くても、タスクごとの最終的な請求額が高くなる可能性があります。Artificial Analysisの試算では、標準エンドポイントの加重平均コストは100万トークンあたり約$0.78、Intelligence Indexのタスク1つを完了するのに約$1.37かかります。また、知っておくべき88%のキャッシュ割引も存在します。
私は2年以上にわたり、入力価格だけでモデルを選び、請求書の出力項目を見て驚くチームを多く見てきました。開発者としての正直な意見を言えば、生のモデルAPIは、トークン単位で管理しなければならないコストセンターです。もしあなたが本当に求めているのが、予測可能な価格で仕事をしてくれるサポートエージェントやブログライターであるなら、それはeeselのようなAIチームメイトの領域です。eeselはトークン単位ではなく、解決単位(レゾリューション)で課金されます。
実際に支払うコストの内訳
まず理解しておくべきは、「Muse Spark 1.3の価格」は一つの数字ではないということです。Metaは、Meta Model APIを通じて同じモデルを2つのエンドポイントで提供しており、それぞれ価格設定が大きく異なります。
| エンドポイント | 入力 / 100万 | 出力 / 100万 | データの扱い | 最適な用途 |
|---|---|---|---|---|
| 標準 (xhigh) | $1.25 | $4.25 | 非公開、学習には使用されない | 本番環境、顧客データ、独自のコード |
| コントリビューター | 約$0.10 | 約$0.20 | Metaの製品改善に使用される | ホビープロジェクト、使い捨てスクリプト、非機密データのバッチ処理 |
標準のxhighレートはArtificial Analysisによって確認されており、新バージョンになってもMuse Spark 1.2から据え置かれました。これは朗報です。コントリビューターの数値は、リリース時のスレッドでMetaの価格ページを引用したユーザーによるものですが、正確なセント単位の数字は、公式ページがより読みやすくなるまでは「信頼性は高いが確定ではない」ものとして扱ってください。いずれにせよ、その差は約10〜20倍であり、このモデルを使用する上で最も重要な価格決定要素となります。
この価格差がなぜ存在するのかについて、コミュニティの分析はどの報道記事よりも鋭いものでした。
「Metaがあなたのデータを喉から手が出るほど欲しがっていて、高い報酬を払おうとしているわけではありません。企業がMetaにデータを渡したくないと強く思っていて、そのために高い料金を支払う準備ができているということなのです」

この一文にすべてが集約されています。標準エンドポイントの割増料金は税金ではなく、それ自体が「製品」なのです。数値の小ささではなく、入力データの機密性に基づいてエンドポイントを選んでください。
月間の請求額を予測する
表示価格は、実際のボリュームを当てはめてみるまで実感がわかないものです。そこで計算ツールを用意しました。月間に使用する想定のトークン数(100万単位)を入力し、エンドポイントを選択すると、入力と、悪名高いほど重い出力の両方のコストを算出します。
特に出力の入力欄を動かしてみてください。Muse Spark 1.3は出力トークンに大きく依存し、出力単価は入力の3.4倍であるため、この数値が請求額に最も大きく影響します。これが、表示価格には隠されている部分です。
冗長性による税
価格ページには載っていない「落とし穴」があります。Muse Spark 1.3は、思考を外部に出力する量(独り言)が非常に多いのです。Artificial Analysisの測定によると、Intelligence Indexを完了するために、他モデルの中央値が約9,000万トークンであるのに対し、このモデルは1億4,000万トークンもの出力を生成しました。リリース時のコミュニティによるテストでは、1.2の約3倍のトークンを使用していると指摘されています。
支払いは出力トークンごとに行われます。つまり、出力単価が低くても大量のトークンを生成するモデルが、必ずしも安価な選択肢になるとは限りません。単価が少し高くても簡潔に応答するモデルの方が、最終的な請求額が安くなることもあるのです。これが冒頭で述べた罠であり、トークン単価よりも「タスクあたりのコスト」が重要である理由です。冗長性を考慮すると、Artificial Analysisは標準エンドポイントでの1タスク完了コストを約$1.37としています。なお、出力速度は毎秒約198トークン、最初のトークンが出るまでの時間(TTFT)は約29秒です。
ただし、実際のコストを抑える2つの要素があります。
- 88%のキャッシュ割引: 繰り返される入力トークン(長いシステムプロンプトや、毎回送信するナレッジベースなど)は、入力単価の数分の一で請求されます。同じコンテキストを再送する検索重視のワークロードやエージェント型の業務では、これは大きな節約になります。
- Meta独自の最適化: MetaはこのモデルをMuse Codeと共同でトレーニングしたため、Muse Code内で実行すると、サードパーティのエージェント経由よりもトークン消費やターン数が少なくなる傾向があります。他所でテストして高く感じた場合、その環境設定が原因かもしれません。
予算管理のポイント:入力単価だけで判断しないでください。実際の出力ボリュームを正直に見積もり、キャッシュ割引を適用し、本番に近いトラフィックの一部でシミュレーションしてから導入を決定しましょう。
まだ購入できないmaxティア
見落としがちな注釈があります。Metaが発表した輝かしいベンチマークスコアは、推論特化の「max」ティアで記録されたものですが、maxはリリース時点で追加の安全性テストのために制限されています。そのため、現在実際に呼び出し、支払うことができるのは「xhigh」ティアのみです。maxの一般公開価格はまだ不明です。
これには2つの意味があります。第一に、リリース時のスコアを基準に予算を組んでいるなら、それはまだ買えない製品を基準にしていることになります。第二に、maxが公開された際、それはxhighよりも高価になり、さらに冗長になることが予想されます。推論が増えるということは、100万トークンあたり$4.25の出力トークンが増えることを意味するからです。ベンチマークの詳細解説では、1.2から1.3への進化のうち、どれだけが純粋な世代交代ではなく、単にmaxとxhighの差によるものかを分析しています。課金を開始する前に一読の価値があります。
他のモデルとの価格比較
表示価格だけで見れば、Muse Spark 1.3の標準エンドポイントは安価な最先端モデルのカテゴリーに入ります。多くのチームが比較検討する他モデルとの位置付けは以下の通りです。これらは同等のティアにおけるリスト価格であり、実際のコストは冗長性や構成によって変動します。
| モデル | 入力 / 100万 | 出力 / 100万 | 備考 |
|---|---|---|---|
| eesel AI | 解決1件あたり$0.40 | ブログ記事1件あたり$4.00 | $50の無料トライアルあり(月額最低料金なし)。トークン単位ではなく成果単位の課金。詳細はこちら |
| Muse Spark 1.3 (標準 xhigh) | $1.25 | $4.25 | 非常に冗長、88%キャッシュ割引、コントリビューターは約10〜20倍安価 |
| Muse Spark 1.3 (コントリビューター) | 約$0.10 | 約$0.20 | Metaがデータを学習に使用 |
| Claude Opus 5 | 高 | 高 | 多くのエージェント評価で1.3を上回る、プレミアムティア |
| GPT-6 Astra | 中 | 中 | 異なる価格構造、詳細は個別解説を参照 |
| Gemini 3.8 Flash | 低 | 低 | 1.3リリース当日に同じインデックスで一時首位 |
| DeepSeek V4 Flash | 極めて低 | 極めて低 | オープンソース、MITライセンス、真の最安値 |
| Kimi K3 | 中 | 中 | もう一つの有力なオープンウェイトモデル |
率直な見解として、コントリビューター・エンドポイントの1.3は、ほとんどのホスト型最先端モデルよりも安く、あるコメントが指摘するように、一部の旧世代の低価格モデルすら下回ります。標準エンドポイントも競争力はありますが最安ではなく、その冗長性のために実質的なコストは表示価格よりも早く上昇します。機密性のない作業でトークン単価のみを重視するなら、コントリビューター・エンドポイントやDeepSeek V4 Flashのようなオープンモデルは非常に強力です。しかし、実際のデータを用いた「完了した仕事」あたりのコストを考えるなら、計算はより複雑になります。
トークン課金から「成果」への課金へ
開発者としての視点、そして多くの価格関連記事が飛ばしてしまう重要なポイントがここにあります。上記の数字はすべて「原材料のコスト」であり、「仕事が完了するまでのコスト」ではありません。トークン価格はエンジンの価格を教えてくれますが、それをヘルプデスクに接続し、自社のコンテキストを読み込ませ、エッジケースでテストし、顧客にメールを送る前に確認させる、といった一連の構築コストについては何も教えてくれません。これらはすべて、あなたがその上に構築し、支払うべきものです。
そのギャップを埋めるのがeeselです。Muse Spark 1.3のようなモデルがインフラであるのに対し、eeselはその上で働く「チームメイト」です。ティアを選んだり、インテグレーションを自前で組んだり、冗長な出力を自腹で賄ったりする必要はありません。特定の業務のために訓練されたチームメイトを採用すれば、その役割に必要なスキル、連携機能、会社のコンテキストを最初から備えた状態でやってきます。
最大の違いは課金モデルにあります。eeselはトークン単位ではなく、解決単位(レゾリューション)で課金されます。そのため、モデルが3倍多く独り言を言っても、それがあなたの予測予算に影響することはありません。AIヘルプデスク・チームメイトは、サポートキューに参加し、注文を照会し、既存のヘルプデスク内で回答案を作成または送信します。また、AIブログライターは、この記事のような長編コンテンツをリサーチして執筆します。どちらの場合も、価格は消費されたトークンではなく、完了した仕事に紐付いています。
eeselを試す
もしあなたが「何を使って構築するか」を決めるためにMuse Spark 1.3の価格記事を読んでいるなら、今こそeeselを検討すべき瞬間です。生のモデルAPIではなく、すぐに働けるAIチームメイトを手に入れることで、トークン単価の計算はあなたの悩みではなくなります。
最大の特徴は、生のモデルでは提供できない「確実性」です。ヘルプデスク・チームメイトは本番導入前に過去のチケットでシミュレーションされるため、ベンチマークの結果を信じるのではなく、実際の会話をどう処理するかを事前に確認できます。数分でツールと連携でき、お試しは無料です。そして解決単位での課金(チケット/チャット1件あたり$0.40、ブログ記事1件あたり$4.00、$50の無料トライアルあり)であるため、どれほど冗長なモデルが思考を巡らせても、予算を圧迫することはありません。