

Strands harnessとは?
Strands harnessは、公式ドキュメントで「a state-of-the-art, fully assembled agent harness」と説明されています。部品を一つずつ組み立てる代わりに、import一つで最適化されたエージェントが手に入るという発想です。Pythonならpip install strands-harnessのあとcreate_harness()、TypeScriptならnpm install @strands-agents/harnessのあとcreateHarness()です。タスクを渡せば動き出します。
これは、AWSが公開しているStrands Agentsという、より広いオープンソースツールキットの「全部入り」の入り口です。harnessはより古く下位レイヤーの部品であるStrands Agents SDKの上に載っています。このSDKはAWSが2025年5月に初めてオープンソース化したもので、Amazon Q DeveloperやAWS GlueといったAWSの本番システムの内部ですでに動いています。harness-sdkリポジトリは注目度を示しており、執筆時点で星7.8k、フォーク1.2kで、すべてApache 2.0です。
大事なのは、harnessが何ではないかです。ホスト型の製品でも、サインインして使うチャットボットでも、自社サイトに置く顧客向けエージェントでもありません。自分のプロセス内で、自分のインフラ上にインストールして動かすコードです。この違いが以下のすべてを方向づけます。
まず、エージェントharnessとは?
「harness」という言葉が重いのに意味がよくわからないとしても、あなただけではありません。Strandsの公式ドキュメントには、私が読んだ中で最も明快な一文があります。「A language model can answer questions. An agent can do things. The agent loop is what makes that difference possible.」
素の大規模言語モデルは、学習でカバーされた範囲のことしか知りません。ファイルを読む、APIを叩く、コマンドを実行するなど、その外側が必要になった瞬間に、モデルは外の世界へ手を伸ばさなければなりません。エージェントループはそれを可能にするオーケストレーション層で、モデルを呼び出し、ツールを使いたいかを確認し、ツールを実行し、結果を戻し、モデルが最終回答を出すまで繰り返します。
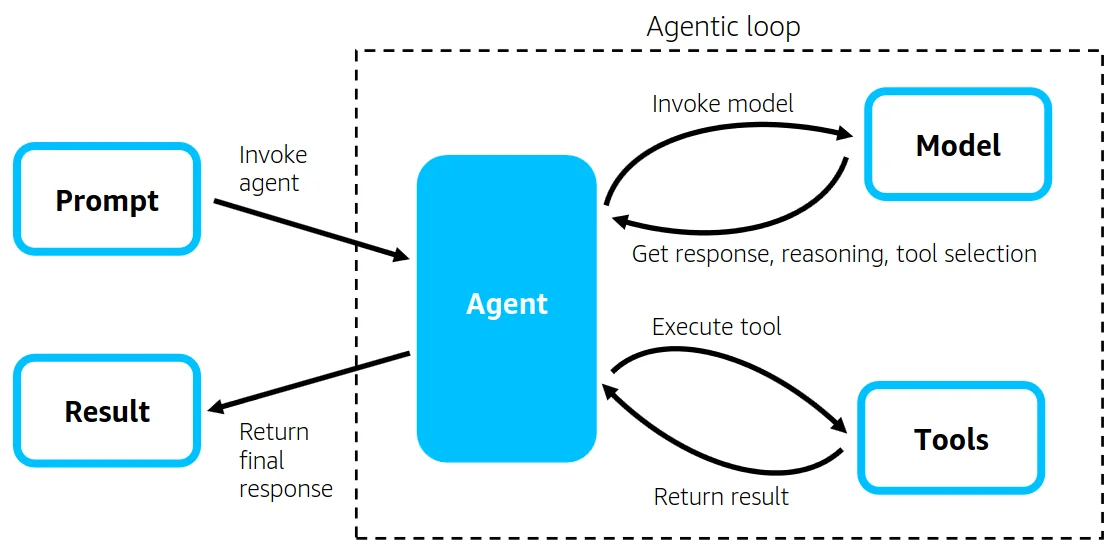
「harness」とは、そのループを取り巻く足場のことです。システムプロンプト、ツールの集合、コンテキストが増えたときの刈り込み方、実行間でのメモリの保持、エラーの捕捉などが含まれます。これらはすべて自分で書けますし、実際に書いている人も多くいます。Strands harnessのような製品が存在する理由は、その足場の地味で土台となる部分はほぼ誰にとっても同じであり、きちんと作るのが面倒だからです。
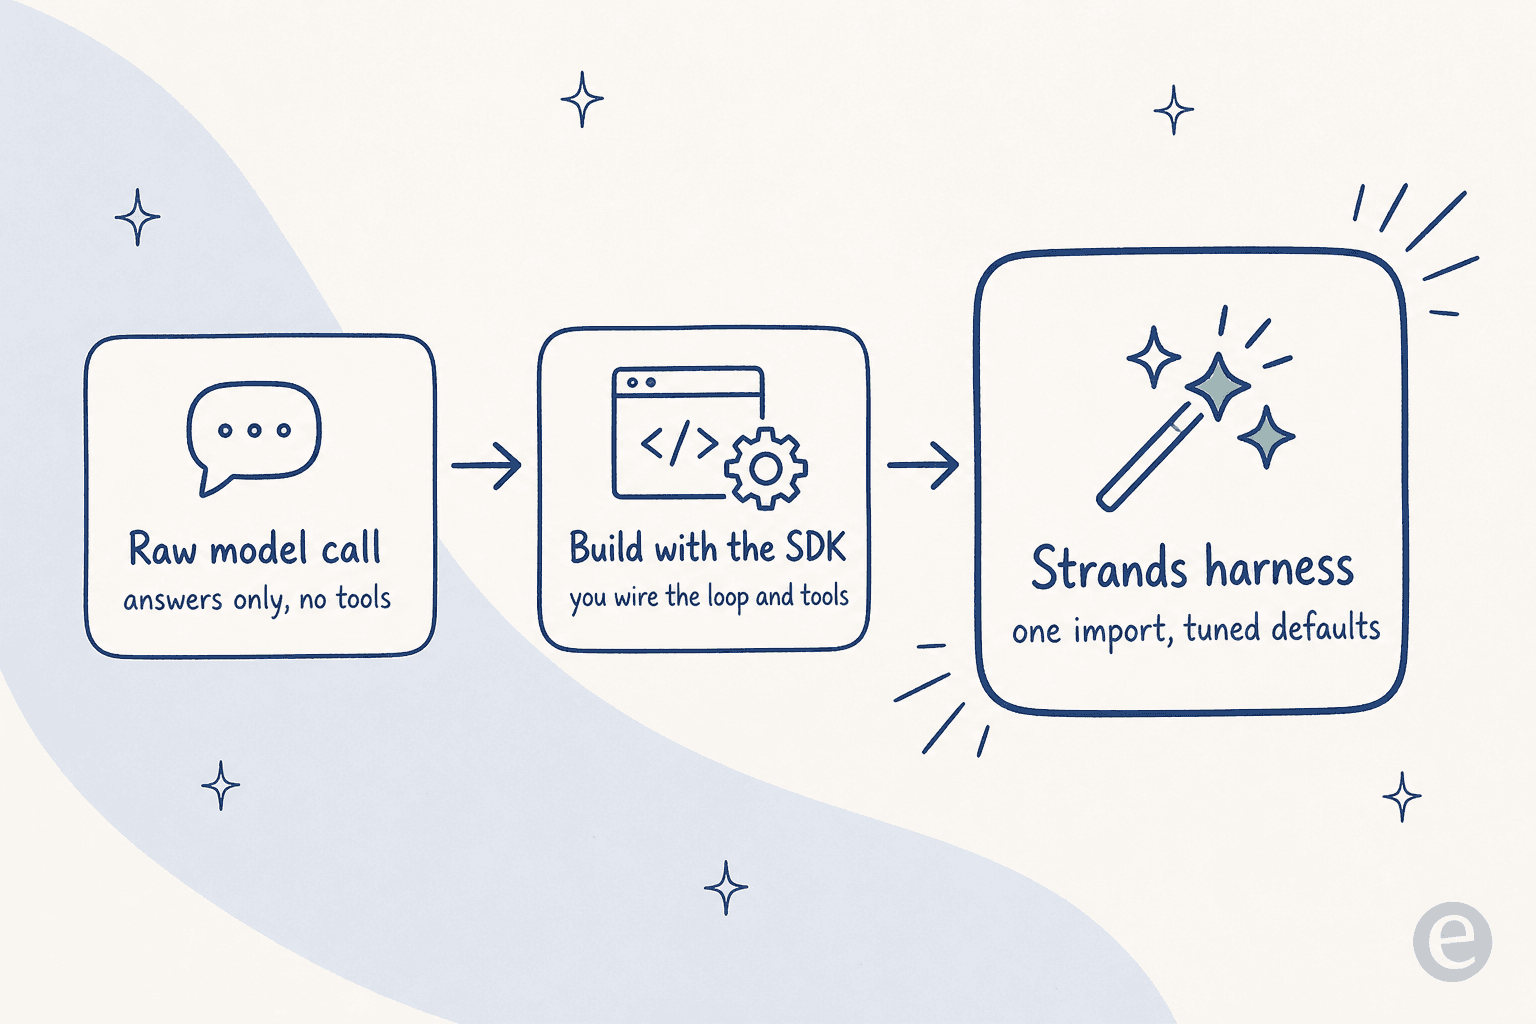
これが全体像です。素のモデル呼び出しは答えるだけで、行動はできません。SDK(Strands自身のもの、あるいはOpenAI Agents SDKやClaude Agent SDKなど)で作れば完全な制御が得られますが、すべての部品の配線は自分でやることになります。harnessはその中間で、調整済みのデフォルトから始めて、ユースケースに本当に必要な部分だけを上書きします。
最初から手に入るもの
引数なしでcreate_harness()を実行すれば、完全に機能するエージェントが手に入ります。デフォルトの面白いところは、AWSによればそのすべてが上書き可能で、返ってくるのは隠れたラッパーのない標準のStrands Agentだという点です。デフォルトで付属するものは次のとおりです。
| デフォルト | 内容 |
|---|---|
| 好きなモデル | Bedrock(デフォルト)、Anthropic、OpenAI、Google、Ollamaで動作し、推論はオン |
| 調整済みシステムプロンプト | 「まず探索し、次に行動し、元に戻せない操作の前に確認し、終える前に検証する」という方針に従う |
| シェルとファイルのツール | 組み込みのread、write、editに加え、コマンド実行 |
| Webアクセス | Webから取得するためのツール |
| コンテキスト管理 | タスクが大きくなるにつれてかさばるツール結果を脇に置き、再利用されるリクエスト部分をキャッシュしてコストを節約 |
| 長期メモリ | 実行をまたいでメモリを保持 |
| セッション | セッションIDから以前の会話を再開 |
| サブエージェントへの引き継ぎ | 自由度の高いサブタスクを組み込みのヘルパーエージェントに渡す |
| タスク管理 | 複数ステップの作業用のチェックリストを保持 |
システムプロンプトの方針は、見過ごしたくない部分です。「元に戻せない操作の前に確認し、終える前に検証する」は、実際の仕事で信頼できるエージェントと、自信満々に間違ったことをするエージェントを分ける規律そのものです。実際のサポートキューでAIを動かして痛い目に遭いながら学んだのと同じ教訓で、失敗のパターンは「ボットが何もしなかった」ではなく「ボットが間違ったことを素早くやった」です。この慎重さをデフォルトのプロンプトに組み込んだのは良い判断です。
好きなモデルを持ち込める
みんなが飛びついた機能は、モデルのポータビリティです。ドキュメントははっきり述べています。「the model is one object you hand to the agent; the rest of your code stays the same.」global.anthropic.claude-sonnet-5をOpenAIやGoogleのモデルに差し替えても、他は何も変わりません。
これは見た目以上に重要で、Hacker Newsのローンチスレッドでのコミュニティの反応は、マーケティングよりもうまくその点を言い表していました。
"This is the very reason why I avoid to use native harness. They are optimized for the economic benefit of the provider, not for mine."

これこそがモデル非依存のharnessを支持する本当の理由です。特定のラボに縛られたコーディングエージェントには、そのラボのトークンをより多く消費させる動機があります。自分で所有するオープンなharnessにはそれがありません。CursorとWindsurfを比べるときやCodexの代替を検討するときに、チームがロックインに神経質になるのも同じ理由です。今四半期に気に入っているモデルが次の四半期も気に入るとは限らず、書き直しなしで乗り換えたいのです。
「28%安い」という主張を検証する
では、みんなが繰り返した数字です。公式のローンチ記事は「frontier performance with 28% lower token cost」で始まり、同じモデルを動かす他のharnessと比べた6つのベンチマークの平均として測定されています。AWSはさらに、Terminal-Bench 2.1でAnthropicのFable 5を使った場合、harnessのコストはClaude Codeより77%低く、スコアも上だったと述べています。示されている仕組みは地味で説得力があります。しきい値を超えたツール結果を切り詰め、コンテキストがいっぱいになったら圧縮し、各リクエストの再利用部分をキャッシュする、というものです。
ここで私は少し立ち止まります。モデル非依存の設計を称賛した同じHNスレッドは、ベンチマークの見せ方にも穴を指摘していました。
"Terminal Bench 2.1 is saturated. Many token saving techniques would save money and score basically the same running Fable 5 against Terminal Bench 2.1... This is at least the fourth time I've seen a project hit front page with a 'save money with same score on saturated benchmark' claim."
もっともな批判です。飽和した単一のベンチマークは、コストの主張を支える足場として弱いものです。しかし、請求額を左右するのはモデルだけでなくharnessでもあるという根本的な点は本当で、別のコメント投稿者が具体的なデータでそれを裏付けました。
"Fable 5 on Claude Code scored 61.8% at a cost of $248.05 while Fable 5 on OpenCode beat it at 66.3% at $73.42. The same model, the same benchmark; only the harness is different with a ~5 point difference in accuracy while costing significantly less."
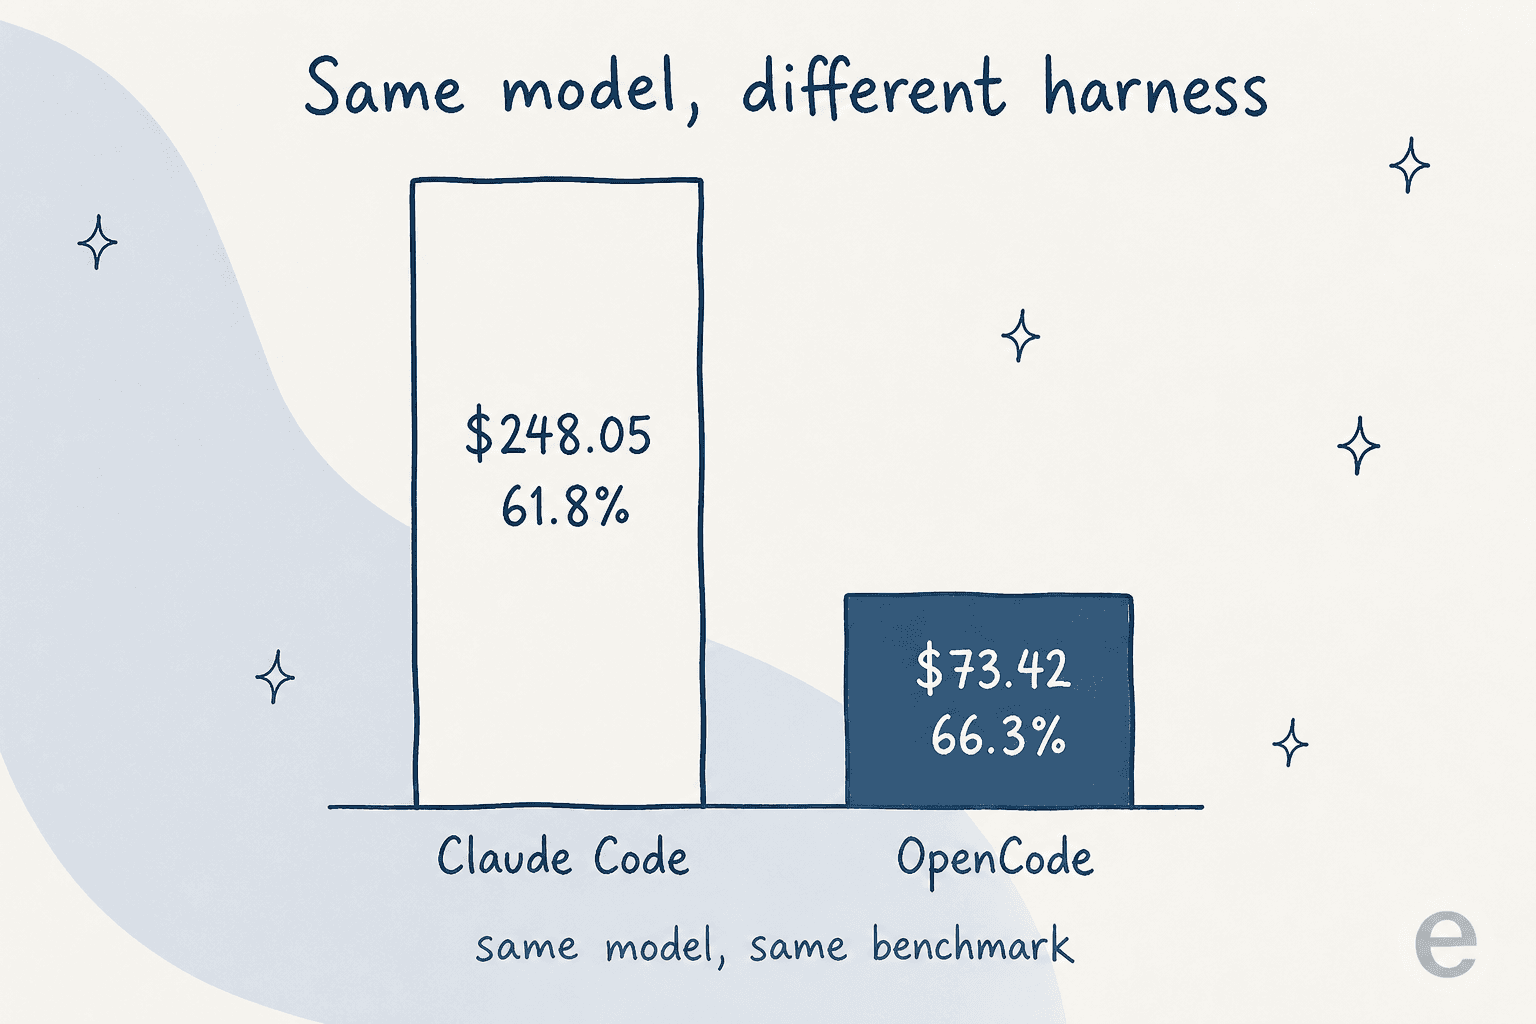
同じモデル、同じベンチマークで、片方は3分の1のコストで精度もわずかに高い。これがharnessに注目する価値がある理由のすべてです。私の結論は、「28%安い」という見出しは方向性として正しく仕組みも筋が通っているものの、予算に数字を載せる前に自分のタスクで試す、というものです。ベンチマーク上の節約と本番での節約は同じ通貨ではありません。
Strandsツールキットのその他の部分
harnessはAWSが公開した複数の入り口の一つで、掘り下げるなら知っておく価値のあるものがいくつかあります。
- Strands Harness SDKは下位レイヤーで、ループを自分で握り、
@toolデコレーターで任意の関数をツールにでき、外部ツールが必要なときはMCPサーバーに接続できます。 - Strands Shellは、自分のプロセス内で動くBourne互換のシェルで、エージェントにgrep、sed、jq、curlを「without fork, exec, or a raw syscall」で提供するため、触れてよいディレクトリと認証情報を正確に宣言できます。
- Strands EvalsはPython専用のSDKで、25種類以上の組み込み評価器により、エージェントの採点、失敗したステップの診断、リリース前のマルチターン会話のシミュレーションができます。
- Strands Labsは実験的な部門で、そのロボティクスプロジェクトは自然言語での制御のために70台以上のロボットを一つのインターフェースの背後に置いており、コーディングエージェントとはまったく違うユースケースです。
ターミナルからエージェントをプロトタイピングするstrands CLI(@strands-agents/cli)もあり、ローンチに合わせて組織が再編された後、すべて一つのharness-sdkモノレポにまとめられています。
harnessが向いている場面と向かない場面
公平に言うと、harnessは本来の用途では優れています。カスタムエージェント(リサーチエージェント、社内の自動化、コーディングアシスタント)を作る開発者で、ループを自分で握り、モデルのロックインを避け、自分のインフラにデプロイしたいなら、Strands harnessは私が見た中でも整った選択肢の一つです。ノートPCからECSまで、Linuxコンテナが動く場所ならどこでも動きます。
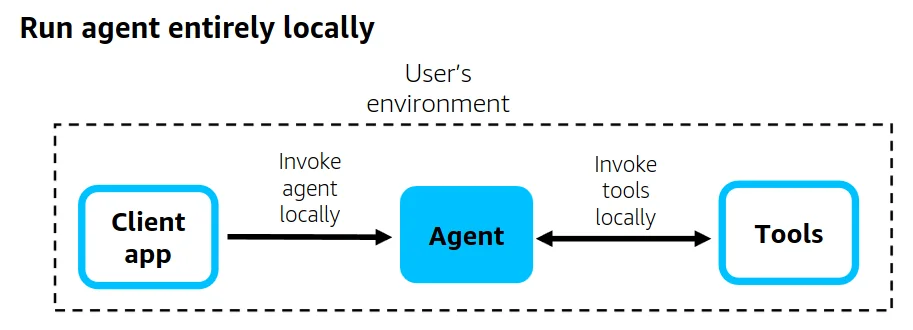
しかし「自分のインフラにデプロイする」ことは同時に落とし穴でもあり、ローンチスレッド全体で最も鋭い一言がそれを突いていました。
"I'm more and more hesitant to use third party harnesses. It's so easy to take opencode or pi and build my own for exactly what I want that I'm seeing projects like this to be noisy and less valuable over time."
harnessは配線の手間は省いてくれますが、オーナーシップの負担は省いてくれません。モデルを選び、ツールをつなぎ、コンテナをホストし、請求を見張り、モデルやAPIが変わるたびに保守するのは自分です。作る側にとってはそれが仕事であり楽しみです。しかし、チケットを解決したい、あるいはブログ記事を書いてほしいだけのサポートリーダーや運用マネージャーにとっては、成果との間に立ちはだかる一つの大きなエンジニアリングプロジェクトです。
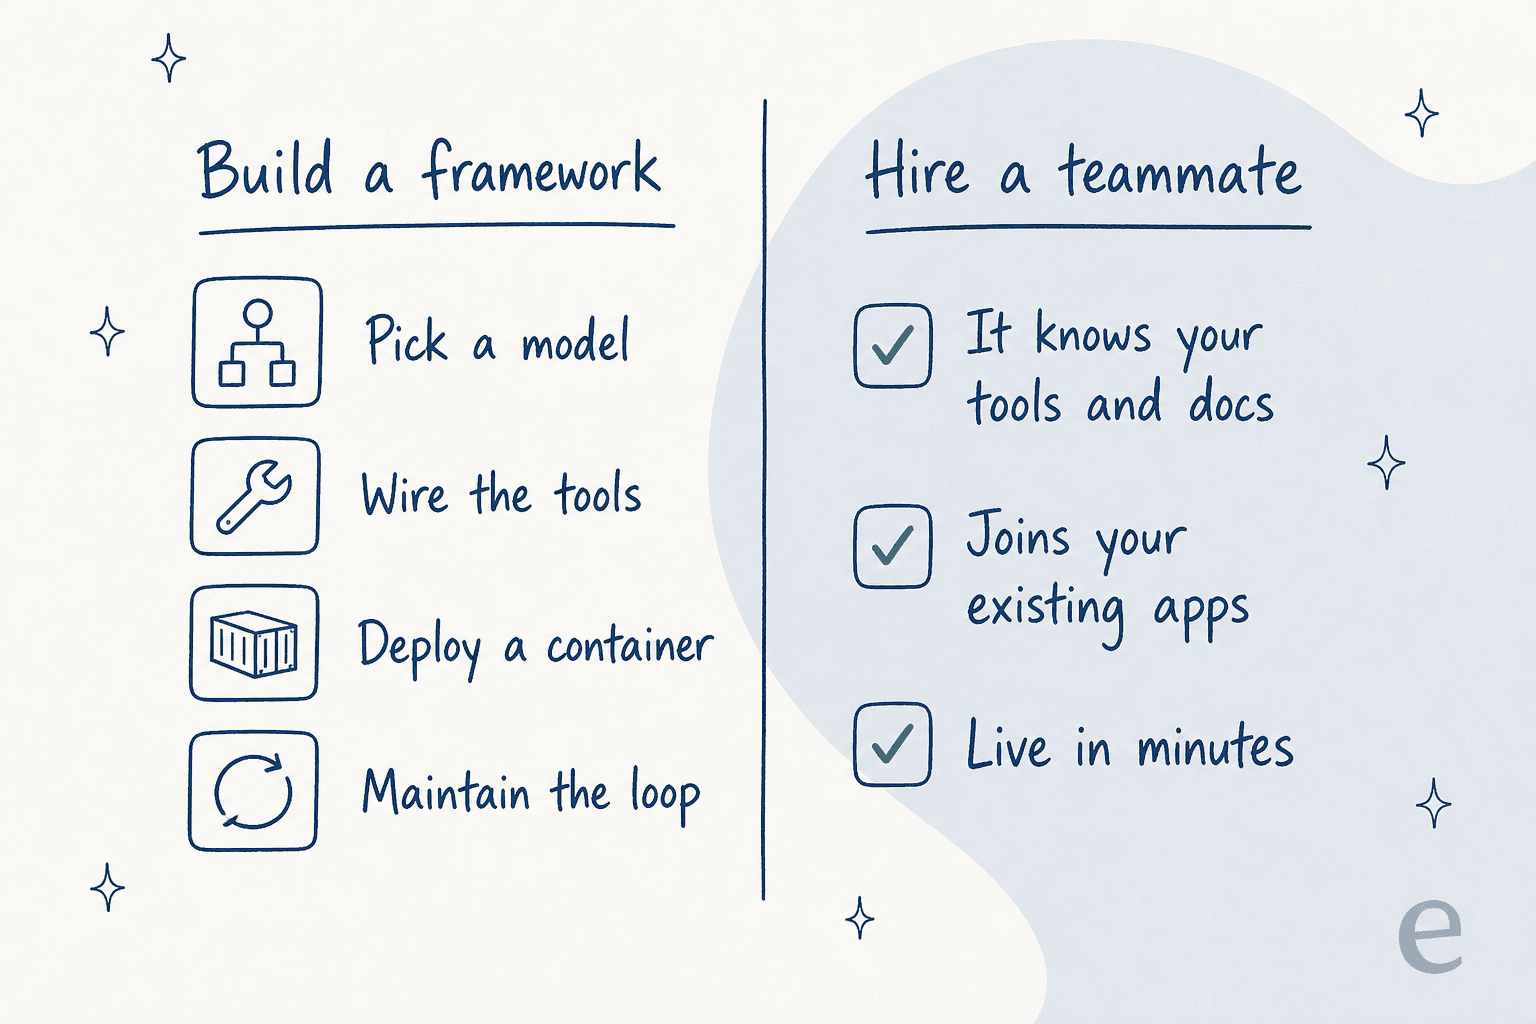
この「作る」か「雇う」かの分け方が、正直な判断基準です。目的がシステムを作ることではなく特定の仕事を片付けることなら、欲しいのはツールキットではなくチームメイトです。
eeselを試す
わかりやすく言えば、Strands harnessはインフラであり、eeselは従業員です。AWSは、エージェントを組み立てるためのループ、ツール、モデルの配線を作り手に提供します。eesel AIは、特定の仕事向けにすぐ働けるチームメイトを雇えるAIチームメイトのプラットフォームで、各チームメイトは役割に必要なスキル、連携、会社の文脈を備えて着任します。現在のラインナップは、既存のサポートキューに加わるAIヘルプデスクチームメイトと、リサーチして長文記事を下書きするAIブログライターです。配線するループも動かすコンテナもありません。ヘルプデスクのチームメイトは過去のチケットとヘルプセンターで学習し、顧客に返信する前に過去のチケットでシミュレーションできます。

ターミナルで過ごすのが好きだからこそharnessに惹かれたのなら、eeselにもそのための入り口があります。eesel CLIは同じチームメイトをターミナルに持ってきます。npx @eesel/cli initでエージェントのセットアップ、ヘルプデスクの接続、ナレッジのアップロード、自動化の配線を、ダッシュボードを開かずに行えます。意図的に別製品にはしていないので、CLIで設定したものはダッシュボードに表示され、その逆も同様です。しかもすべてのコマンドがJSONを出力するため、Claude Code、Cursor、Codexのようなコーディングエージェントがワークスペース全体のセットアップを代行し、稼働中のチームメイトを引き渡してくれます。Strands harnessを魅力的にしているのと同じ、エージェント的でスクリプト化できる使い勝手を、すでに仕上がっている仕事に向けたものです。
コストについては、eeselは月額299ドルから500クレジット(チケットまたはチャット1件につき1クレジット)の固定月額料金で、シート単位の料金はないため、価格は埋まった席数ではなく件数に連動します。100クレジットで無料で始められ、CLIならテスト用にアカウント不要の匿名ワークスペースも立ち上げられます。本当の目的が、保守するフレームワークではなく、解決されたチケットや公開された記事なら、そのほうが近道です。
よくある質問
Strands harnessとは何ですか?
Strands harnessは、AWSが2026年9月21日にApache 2.0ライセンスで公開した、完全に組み上げ済みのオープンソースAIエージェントです。import一つで、ツール、メモリ、セッション、コンテキスト管理について検証済みのデフォルトを備えたエージェントが手に入り、Bedrock、Anthropic、OpenAI、Google、またはローカルのOllamaモデルに接続できます。下位レイヤーのStrands Harness SDKの上に構築されています。
Strands harnessは無料ですか?
harness自体は無料のオープンソース(Apache 2.0)です。ただし、接続するモデルプロバイダーの料金と、harnessを動かすコンテナの運用コストは別途かかります。自前でホストするのではなくマネージドなAIエージェントがよい場合は、eesel AIのような選択肢があり、月額299ドルから(500クレジット、チケット1件につき1クレジット)の固定料金で、シート単位の料金はありません。
Strands harnessとClaude Codeの違いは何ですか?
Claude CodeはAnthropic自身のコーディングエージェントで、Anthropicのモデル向けに調整されています。Strands harnessはモデル非依存で、同じharnessが主要なプロバイダーのどれでも動くため、特定のラボに縛られません。AWSのベンチマークでは、あるコーディングタスクをClaude Codeより77%低いコストで、より高いスコアで実行したとされていますが、これは単一のベンチマークでの結果です。
「トークンコスト28%減」とは実際に何を意味しますか?
6つのベンチマークの平均で、同じモデルを同程度の精度で動かす他のharnessとStrands harnessを比較した数値です。節約の源は、大きなツール結果の切り詰め、コンテキストがいっぱいになった際の圧縮、各リクエストの再利用部分のキャッシュです。Strandsの公式な数字ですが、あくまでベンチマーク上の主張なので、目安として受け止めてください。
Strands harnessを使うには開発者である必要がありますか?
はい。PythonとTypeScriptのパッケージとCLIとして提供され、インストール、設定、デプロイは自分で行います。コードを書いたりホストしたりせずに、カスタマーサービス用のAIエージェントや日々のビジネス業務用のAIが欲しいなら、フレームワークよりもすぐ使えるチームメイトのほうが向いています。