

要約
Metaは2026年9月2日、前バージョンの1.2から約4週間という速さで、コーディングエージェント「Muse Code」および「Meta Model API」の内部モデルとしてMuse Spark 1.3をリリースしました。これは大きな飛躍と言えます。Artificial Analysis Intelligence Indexでは636モデル中第6位に位置しており、100万トークンのコンテキストウィンドウ(context window)を備え、テキスト、画像、動画の入力に対応しています。
このモデルが真に優れている点についての正直な評価:長いコンテキストの処理とコーディングにおける向上が本物であるということです。長いコンテキストの検索テストでは98.5および98.1というほぼ完璧な数値を叩き出し、Meta独自のスコアカードでもコーディングに関するすべての項目で勝利しています。しかし、純粋なエージェントベンチマークでは、Opus 5 (max) が依然として6項目中4項目でリードしています。また、華々しい数値には注意点があります。Metaのスコアカードは、1.3の「max」モード(リリース時点では安全性テストのためまだ制限されています)と1.2の「xhigh」モードを比較しているため、この飛躍の一部は純粋な世代交代ではなく、推論ティアの変更によるものです。さらに、1.2に比べて出力が約3倍冗長になっています。
最も話題になっているのは価格設定です。標準エンドポイントは100万トークンあたり1.25ドル(入力)/ 4.25ドル(出力)ですが、Metaがデータを学習に利用することを許可する「コントリビューター」エンドポイントは約10倍から20倍安くなります。どちらを選ぶにせよ、生のモデルはインフラであり、完成された労働力ではありません。もし、あなたのビジネスをすでに理解しているサポートエージェントやブログライターを求めているのであれば、それはeesel AIのようなAIチームメイトがこのようなモデルの上で果たすべき役割です。
Muse Spark 1.3の実態
私は仕事でこれらのモデルAPIを使って開発を行っているため、リリース時にまず行うのは、マーケティングの言葉からモデルの実態を切り離すことです。Muse Spark 1.3は、Metaの最先端のクローズドウェイト(closed-weights)推論モデルであり、Metaはリサーチブログの発表の中で、これを「個人的なスーパーインテリジェンスへのさらなる一歩」と位置づけています。アクセス方法は、Meta独自のコーディングエージェント基盤であるMuse Code経由、またはMeta Model API経由の2通りです。
ベンチマークの騒音に惑わされる前に、いくつかの事実を整理しておきましょう。
- 2つのバリアントが公開されています:
max(最高推論モード)とxhigh(高速モード)。Metaのブログによると、max推論は「追加の安全性テストが完了次第、間もなく提供開始」とされており、リリース時点で完全に利用可能なのはmaxではなくxhighです。 - コンテキストウィンドウは100万トークンで、テキスト、画像、動画を入力として受け取ります。
- **プロプライエタリ(独占的)**なモデルです。Artificial Analysisはこれを「クローズド」としてリストしており、オープンウェイトでのリリースは発表されていません。これはMetaのオープンなLlamaシリーズとは異なるカテゴリーに属します。
このバリアントの違いは見た目以上に重要であり、リリース時の数値に大きく影響しているため、後ほど詳しく説明します。
ベンチマーク:1.3が勝っている点、そうでない点
Metaはリリースの際、Muse Spark 1.3、Muse Spark 1.2、GPT-5.6 Sol、Claude Opus 5の4つのモデルについて、エージェント、コーディング、指示遂行、長いコンテキストのタスクにわたるスコアカードを公開しました。以下がそのデータです。
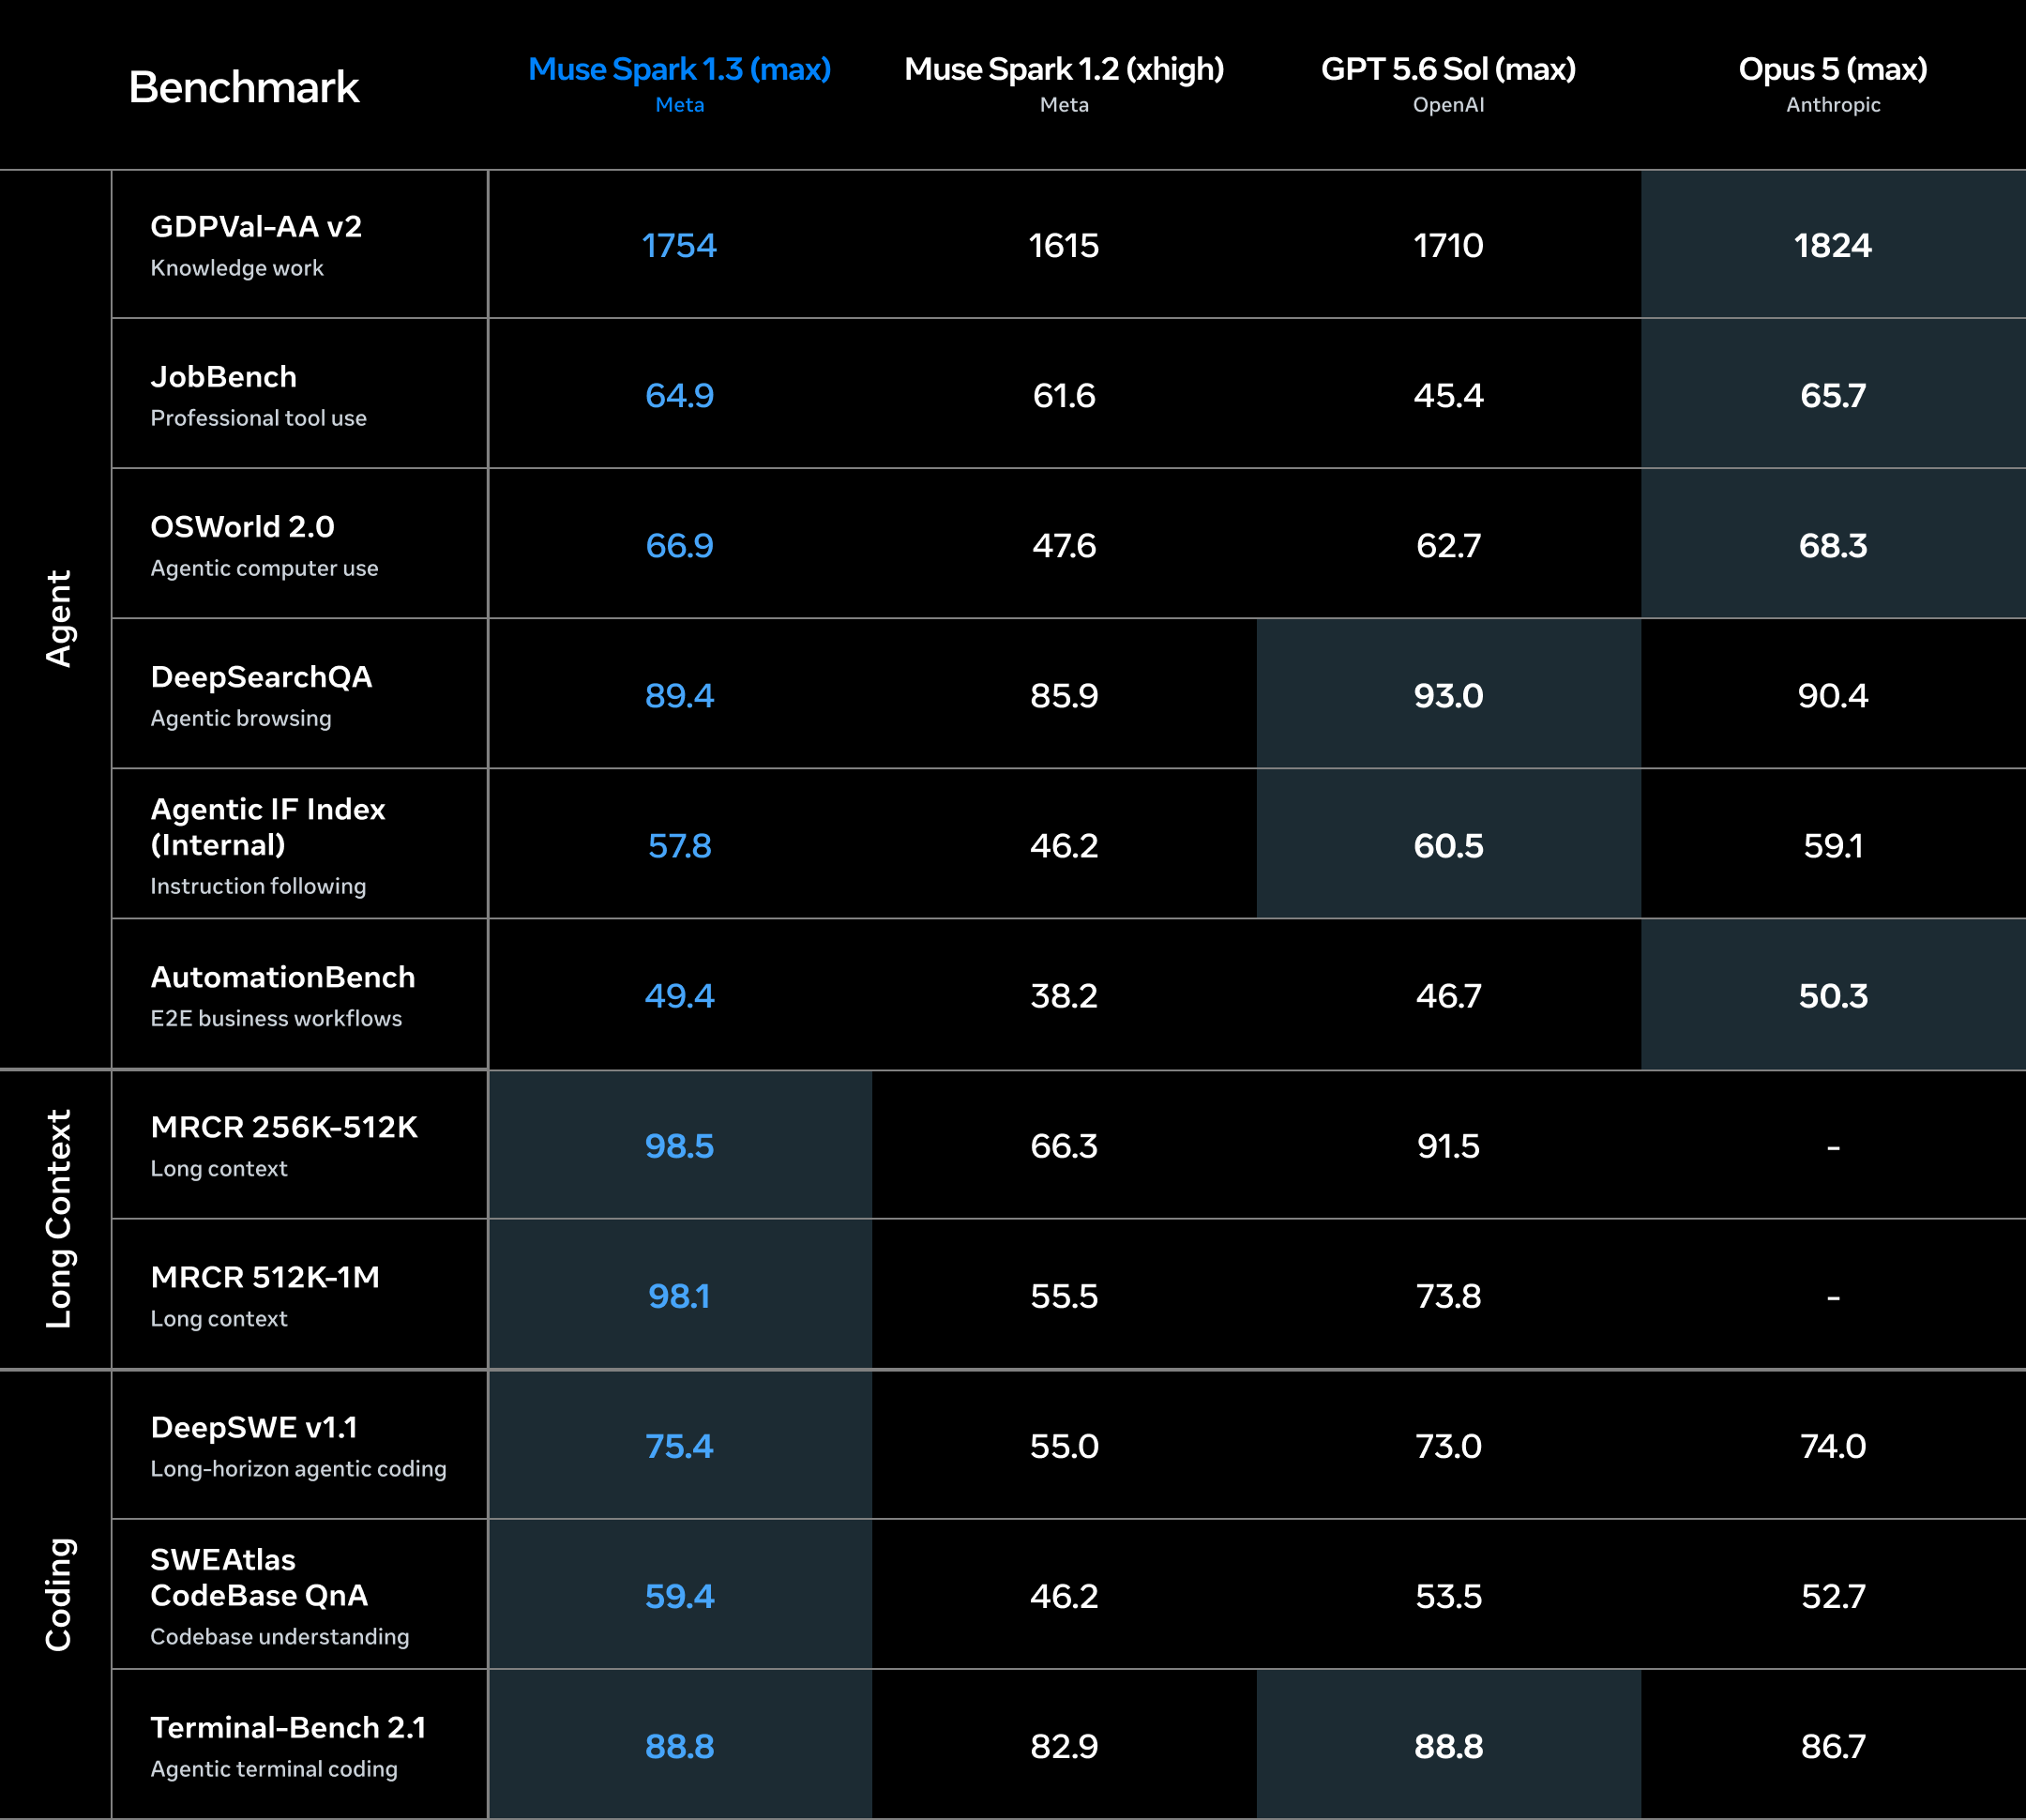
各行を見ていくと、単一のヘッドライン数値よりも有用な、明確なパターンが見えてきます。
| ベンチマーク | Muse Spark 1.3 (max) | Muse Spark 1.2 (xhigh) | GPT-5.6 Sol (max) | Opus 5 (max) |
|---|---|---|---|---|
| GDPVal-AA v2 (ナレッジワーク) | 1754 | 1615 | 1710 | 1824 |
| JobBench (専門的ツール利用) | 64.9 | 61.6 | 45.4 | 65.7 |
| OSWorld 2.0 (コンピュータ操作) | 66.9 | 47.6 | 62.7 | 68.3 |
| DeepSearchQA (エージェントブラウジング) | 89.4 | 85.9 | 93.0 | 90.4 |
| Agentic IF Index (指示遂行) | 57.8 | 46.2 | 60.5 | 59.1 |
| AutomationBench (E2Eワークフロー) | 49.4 | 38.2 | 46.7 | 50.3 |
| MRCR 256K-512K (長いコンテキスト) | 98.5 | 66.3 | 91.5 | – |
| MRCR 512K-1M (長いコンテキスト) | 98.1 | 55.5 | 73.8 | – |
| DeepSWE v1.1 (エージェントコーディング) | 75.4 | 55.0 | 73.0 | 74.0 |
| SWEAtlas CodeBase QnA | 59.4 | 46.2 | 53.5 | 52.7 |
| Terminal-Bench 2.1 (ターミナルコーディング) | 88.8 | 82.9 | 88.8 | 86.7 |
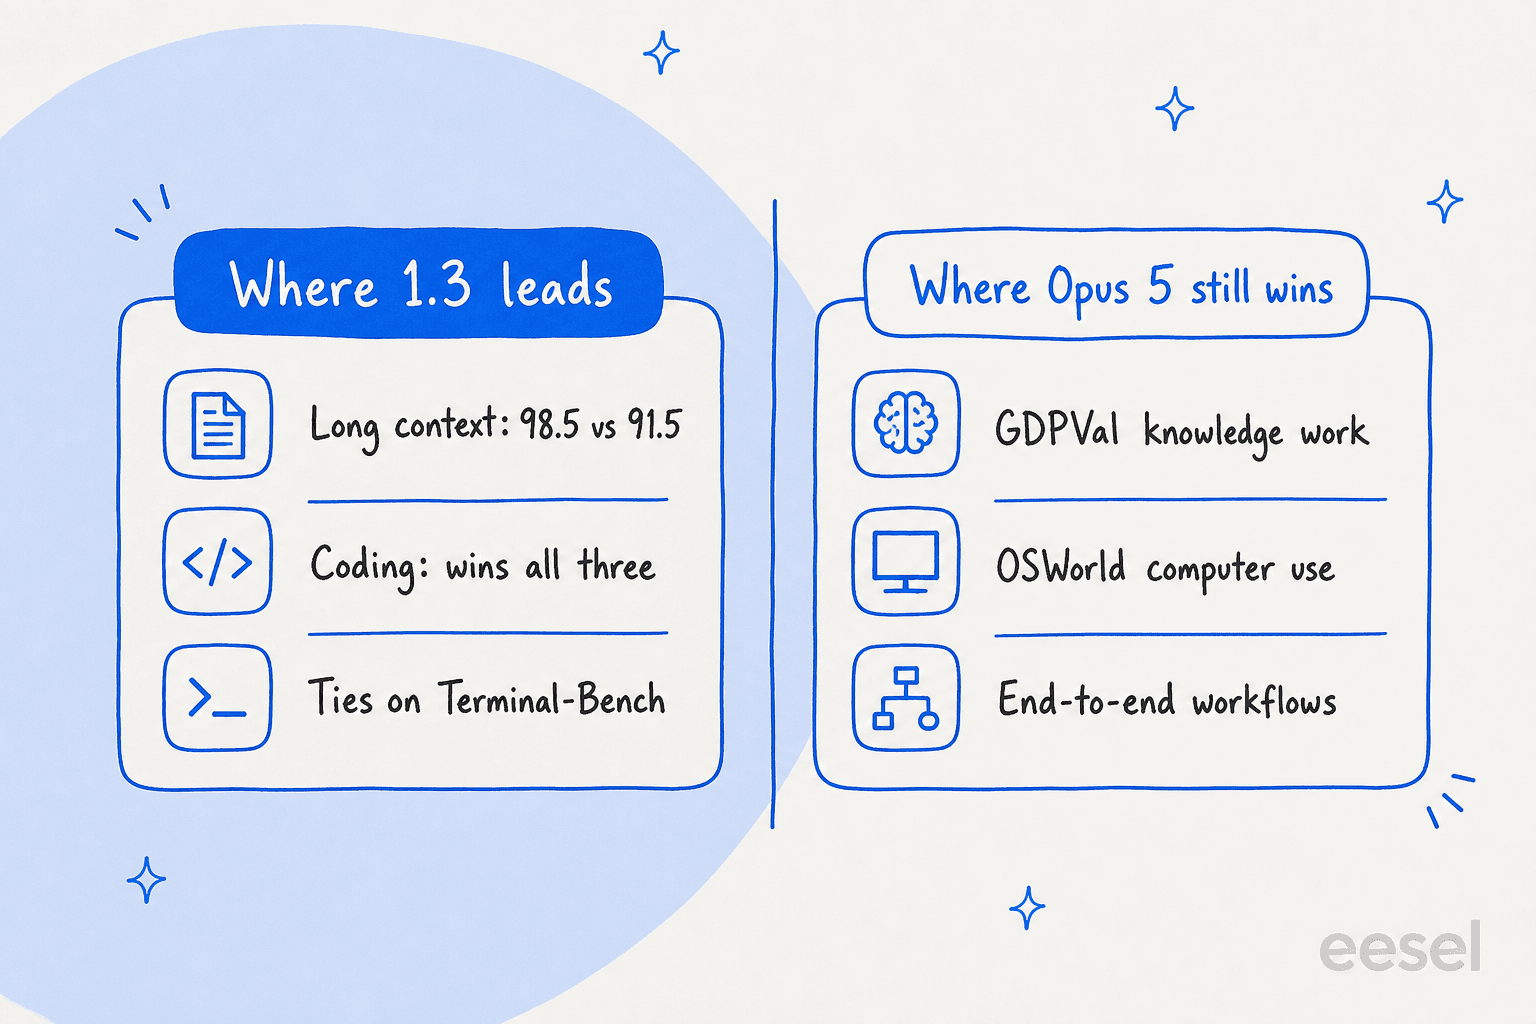
この表が語るストーリー:Muse Spark 1.3は長いコンテキストとコーディングを支配しているということです。MRCRロングコンテキストテストでの98.5と98.1という数値は単なる勝利ではなく、GPT-5.6 Sol (91.5と73.8) や自身の前身モデル (66.3と55.5) を大きく引き離しています。Opus 5に関しては数値すら公開されていません。コーディングにおいても、DeepSWE v1.1 (75.4) やコードベースの理解 (59.4) で勝利し、Terminal-Bench (88.8) ではGPT-5.6 Solと並んでトップに立っています。これは検証可能な確かな結果であり、1.3は1.2よりも約20%少ないツール呼び出し、約25%少ないトークンでコーディング作業を完了できるというMetaの主張とも一致します。
しかし、エージェントの列を冷静に見てみましょう。6つのエージェントベンチマークのうち、Opus 5 (max) は4つの項目 (GDPVal, JobBench, OSWorld, AutomationBench) で1.3を上回っており、残りの2つ (DeepSearchQA, Agentic IF) はGPT-5.6 Solが獲得しています。つまり、「エージェント機能とコーディングの向上」という表現はコーディングに関しては妥当ですが、エージェント評価においては1.3は強力な2位であって、リーダーではありません。総合評価として、Artificial AnalysisはmaxバリアントのIntelligence Indexを62(636モデル中6位)としています。これは比較対象モデルの中央値である17を大きく上回っていますが、順位は僅差であり、あるHacker Newsのユーザーが指摘したように、同日にGemini 3.8 Flashが一時的に首位を獲得したほど競争は激化しています。
見出しの数値に隠された注意点
ここで、同僚が私に指摘してくれたら嬉しいと思うような点をお伝えします。もう一度スコアカードの列見出しを見てください。1.3の列は**max、1.2の列はxhigh**となっています。これらは異なる推論ティアです。そのため、OSWorldが47.6から66.9に、MRCRが66.3から98.5に向上したといった目を引くジャンプの一部は、純粋なバージョン間の向上ではなく、maxとxhighの差によるものです。同じxhigh同士で比較すれば、その差は間違いなく縮まるでしょう。
この見せ方に不満を持つ人もいました。リリーススレッドのあるコメントはこう述べています。
「ベンチマークにmax推論の数値しか表示されていないのは、ある意味で不誠実だ。」

この注意点は非常に重要です。なぜなら、華々しいスコアを叩き出しているmaxモードは、リリース時点では安全性テストのために利用が制限されているからです。今日実際に呼び出すことができるのは、Intelligence Indexで61を記録したxhighです。62と大差はありませんが、今すぐ提供されるものについての誠実な数値はこちらです。
2つ目の注意点は、饒舌さ(verbosity)です。Artificial Analysisの測定によると、1.3がIntelligence Indexの全タスクを完了するのに放出した出力トークンは1億2,000万トークンでした(同分野の中央値は7,200万トークン)。コミュニティ独自のテストでも、1.2の約3倍のトークンを消費することが確認されています。出力トークンごとにお金を払うことになるため、トークン単価が安くても、3倍多く「独り言」を言うモデルが自動的に安上がりになるとは限りません。提示価格を鵜呑みにせず、実際のワークロードでシミュレーションしてみる価値があります。
価格設定:データ提供による割引の分岐点
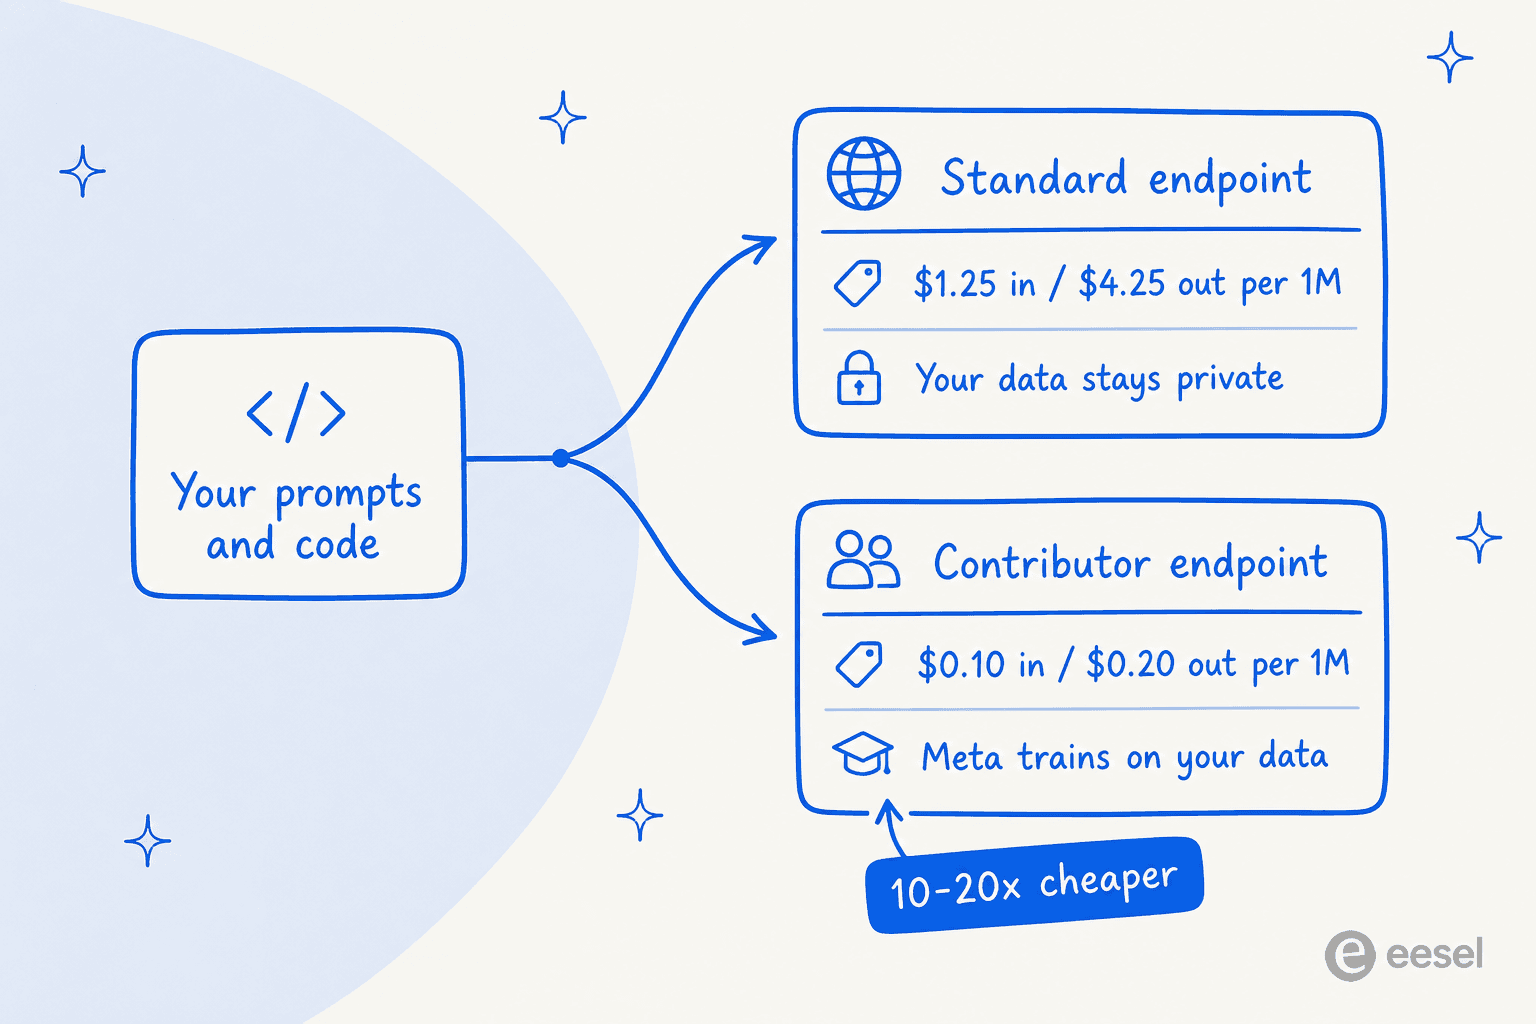
ここはリリースの興味深い部分であり、Metaらしい動きでもあります。同じモデルに対して2つのエンドポイントが用意されており、その価格差はひとえにユーザーデータの扱いにあります。
| エンドポイント | 入力 / 100万 | 出力 / 100万 | データの扱い |
|---|---|---|---|
| 標準 (xhigh) | 1.25ドル | 4.25ドル | プライベートを維持、学習には使用しない |
| コントリビューター | 約0.10ドル | 約0.20ドル | Metaの製品向上のために使用される |
標準のxhighの数値はArtificial Analysisで確認されており、Intelligence Indexの1タスクあたりのコストは0.55ドル、出力速度は182トークン/秒、最初のトークンが出るまでの時間は38.51秒とされています。コントリビューターの数値はリリーススレッドでMetaの料金ページを引用したユーザーによるものなので、Metaのページがより分かりやすくなるまでは、確定値ではなく信頼性の高い推定値として扱ってください。いずれにせよ、その差は約10倍から20倍に及びます。
なぜこのような分岐があるのか、コミュニティの洞察はどのメディア記事よりも鋭いものでした。
「Metaがあなたのデータを喉から手が出るほど欲しがっていて、高い金を払ってでも買い取ろうとしているのではない。企業がMetaにデータを渡したくないがために、渡さないための権利に高い金を払おうとしているのだ。」
これがすべてを物語っています。コントリビューターエンドポイントはChatGPT Lunaや、かつてのDeepSeek V4 Flashよりも100万トークンあたりの単価が安いと指摘されており、趣味のプロジェクトや使い捨てのスクリプトには最適です。一方、顧客データや独自のコードを扱う場合は、標準エンドポイントの割増料金こそが「安心料」としての価値を持ちます。単に数字の小ささで選ぶのではなく、入力データの機密性に見合ったエンドポイントを選択すべきです。
コミュニティの実際の評価
リリース当日の雰囲気はHacker News(391ポイント、261コメント)に凝縮されており、過剰な期待(hype)一色ではなく、健全に意見が分かれていました。1.2を実際のコーディング環境で使用していた人々は、そのスピードと価格を好意的に受け止めており、1.3でその「癖」が修正されたかどうかに注目していました。
「古いゲームバイナリの逆コンパイルと再実装に1.2を使っていますが、かなり高速で優秀です。ただ1.2は、バグの解決を求めたときに、進展がないまま似たような思考の要約を延々と出力し続けて詰まってしまうことがあります。」
一方で、前世代のモデルに全く納得していない人々もいます。ベンチマークの数値をそのまま実際の体験として受け取らないようにという、妥当な警告です。
「Muse Spark 1.2を使ってみましたが、全く感心しませんでした。速くて安いですが、GPT 5.6 Terraの方がはるかに有能だと感じました。」
実用的なヒントもいくつか浮上しており、参考にする価値があります。Metaはこのモデルを自社のプラットフォーム向けに共同トレーニングしているため、サードパーティ製のエージェント経由よりも、Muse Code内で実行する方がトークン消費量やターン数が少なく済む傾向があるようです。他社のツールでベンチマークをして「コストが高い」と感じた場合、それが理由の一つかもしれません。
Metaが設計したエージェントの動作
ベンチマークはさておき、より興味深いエンジニアリング上の主張は「動作」に関するものです。Metaによると、1.3は「熱心なインターン」というよりも「慎重なインターン」のように振る舞うようトレーニングされているとのことです。不明な点は質問し、行き詰まったら助けを求め、重大なアクションや取り消し不能なアクションの前には確認を行い、初期の要件を見失うことなく一つの長い乱雑なスレッドを維持できるよう設計されています。
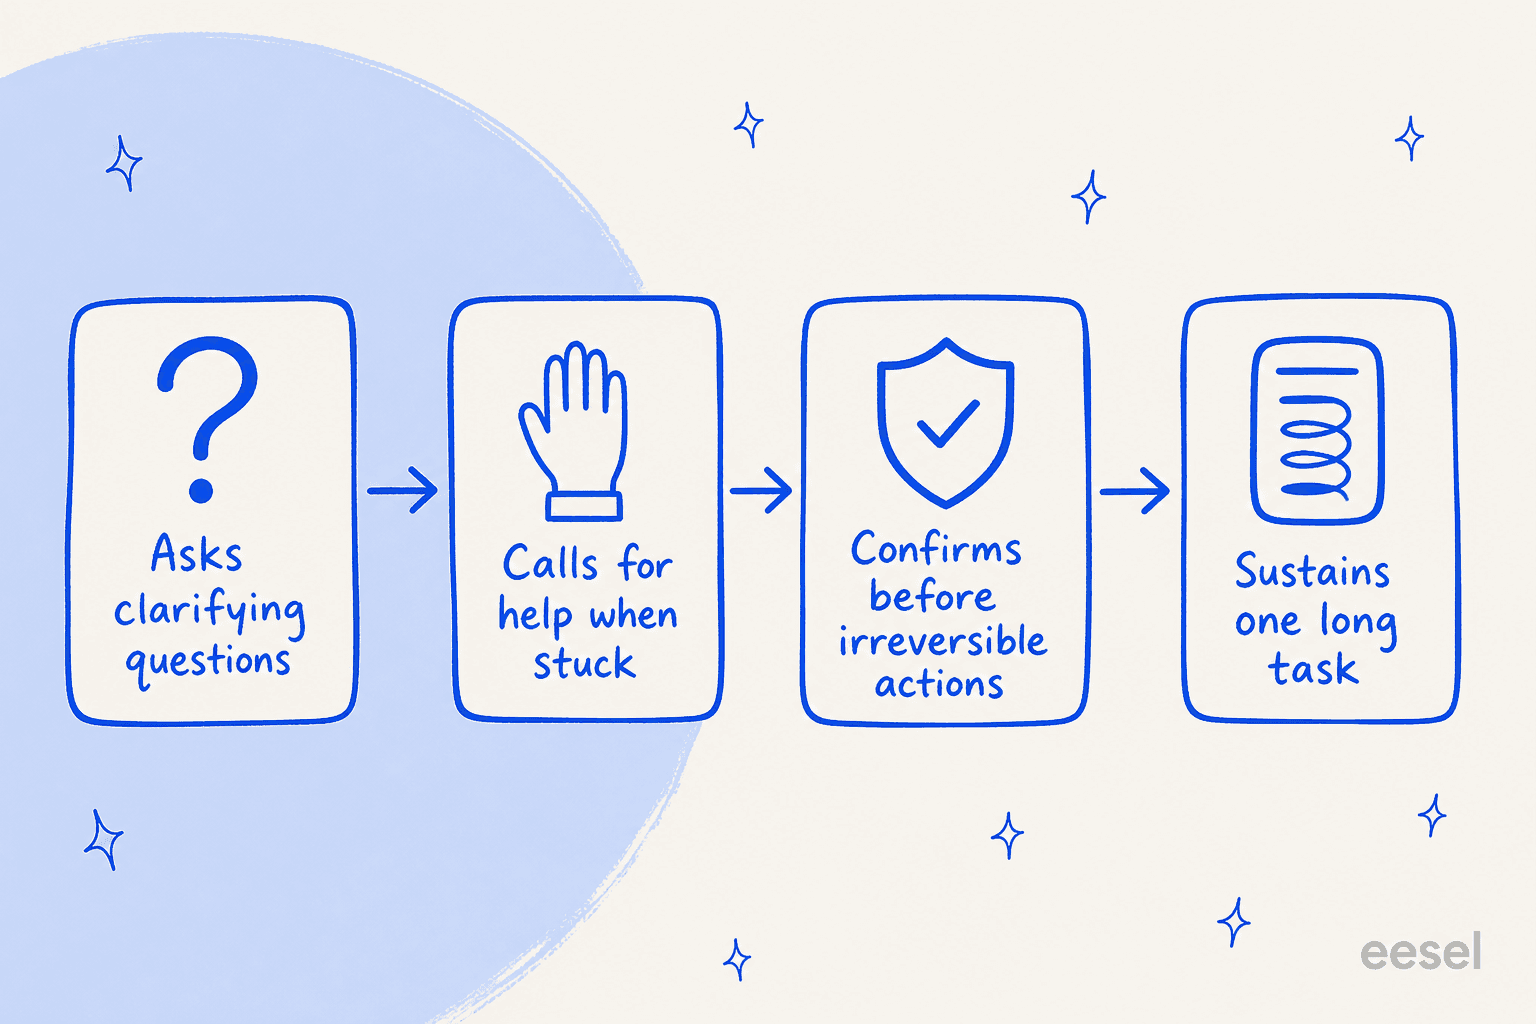
Metaはこれに加えて、敵対的攻撃への耐性、プロンプトインジェクションへの防御、取り消し不能なアクションに関する調整など、安全性についても強調しています。3年以上AIエージェントが実際の現場で動く様子を見てきた私にとって、「取り消し不能なアクションの前に確認する」というのは、この発表全体の中で最も重要な一文です。黙って間違ったことをする自信満々なモデルよりも、確認を行う慎重なモデルの方が優れています。これこそが、私が携わっている製品において、ベンチマークの結果を鵜呑みにして本番環境の挙動を予測するのではなく、実際のお客様に触れる前に、過去のリアルなデータですべてのエージェントをシミュレーションしている理由です。
この直感は、多くのリリース記事が見落としがちな部分への架け橋でもあります。強力なモデルは「原材料」であって、「完成された労働者」ではないということです。
フロンティアモデルから採用されたチームメイトへ
開発者としての率直な意見を言えば、Muse Spark 1.3は素晴らしいエンジンです。しかし、それ単体では従業員にはなり得ません。モデルはあなたの製品を知りませんし、ヘルプデスクやCMS(コンテンツ管理システム)とも繋がっていません。例外的なケースに対するテストもされていませんし、それらすべてを周囲に構築しない限り、顧客にメールを送る前に確認してくれることもありません。「フロンティアモデル」と「仕事をするもの」の間のこのギャップこそが、eesel AIが存在する理由そのものです。
例えるなら、このようなモデルは「インフラ」であり、eesel AIはその上に雇う「チームメイト」です。ユーザーがモデルを選び、インテグレーションを配線し、安全装置をプログラムする必要はありません。特定の役割のために、すぐに働けるチームメイトを雇えば、その仕事に必要なスキル、インテグレーション、そして会社のコンテキストをすでに備えた状態でやってきます。
eesel AIを試す
もしあなたがMuse Spark 1.3を使って「何を構築するか」を決めるためにこの記事を読んでいるなら、それこそがeesel AIが構築された目的です。eesel AIはAIチームメイトプラットフォームです。生のモデルAPIではなく、定義された仕事に対して、すぐに働けるチームメイトを採用できます。現在、サポートキューに参加し、注文を照会し、既存のヘルプデスク内で返信の下書きや送信を行う「AIヘルプデスクチームメイト」や、このような長文の投稿をリサーチして執筆する「AIブログライター」がラインナップされています。
生のモデルでは提供できない決定的な違いは、ヘルプデスクチームメイトが本番稼働前に実際の過去のチケットを使用してシミュレーションされることです。ベンチマークの数値を信じるのではなく、実際に行われた会話をどのように処理したかを事前に確認できます。数分でツールに接続でき、100クレジットが含まれる無料プランも用意されています。料金体系は、1チケットまたは1チャットセッションあたり0.40ドル、ブログ記事1件あたり4.00ドルの固定価格で、50ドルの無料トライアルも提供されており、月額最低料金やプラットフォーム手数料はありません。饒舌なモデルがどれだけ「独り言」を言おうとも、トークン消費量を気にする必要はないのです。