

「超高速」とはどれくらい速いのか?
この記事では速度がすべてなので、まずTypeSafeが実際に公表している数字を挙げ、そのうえで検証します。
TypeSafeによると、Jevのエンドツーエンドの応答時間は70msから500msで、System One型のクエリにおけるフロンティアLLMの3〜329秒と比較されています。ホームページではさらに大きく、ワークフローベンチマークで193.6倍速く444.6倍安いとしていますが、ローンチ記事は、それらが「実際の改善幅としては高い側」にあると正直に認めています。同じページのデモでは、1回の判断が0.114秒・0.000081ドルで、LLMベースラインの8.566秒・0.013880ドルと比べられています。
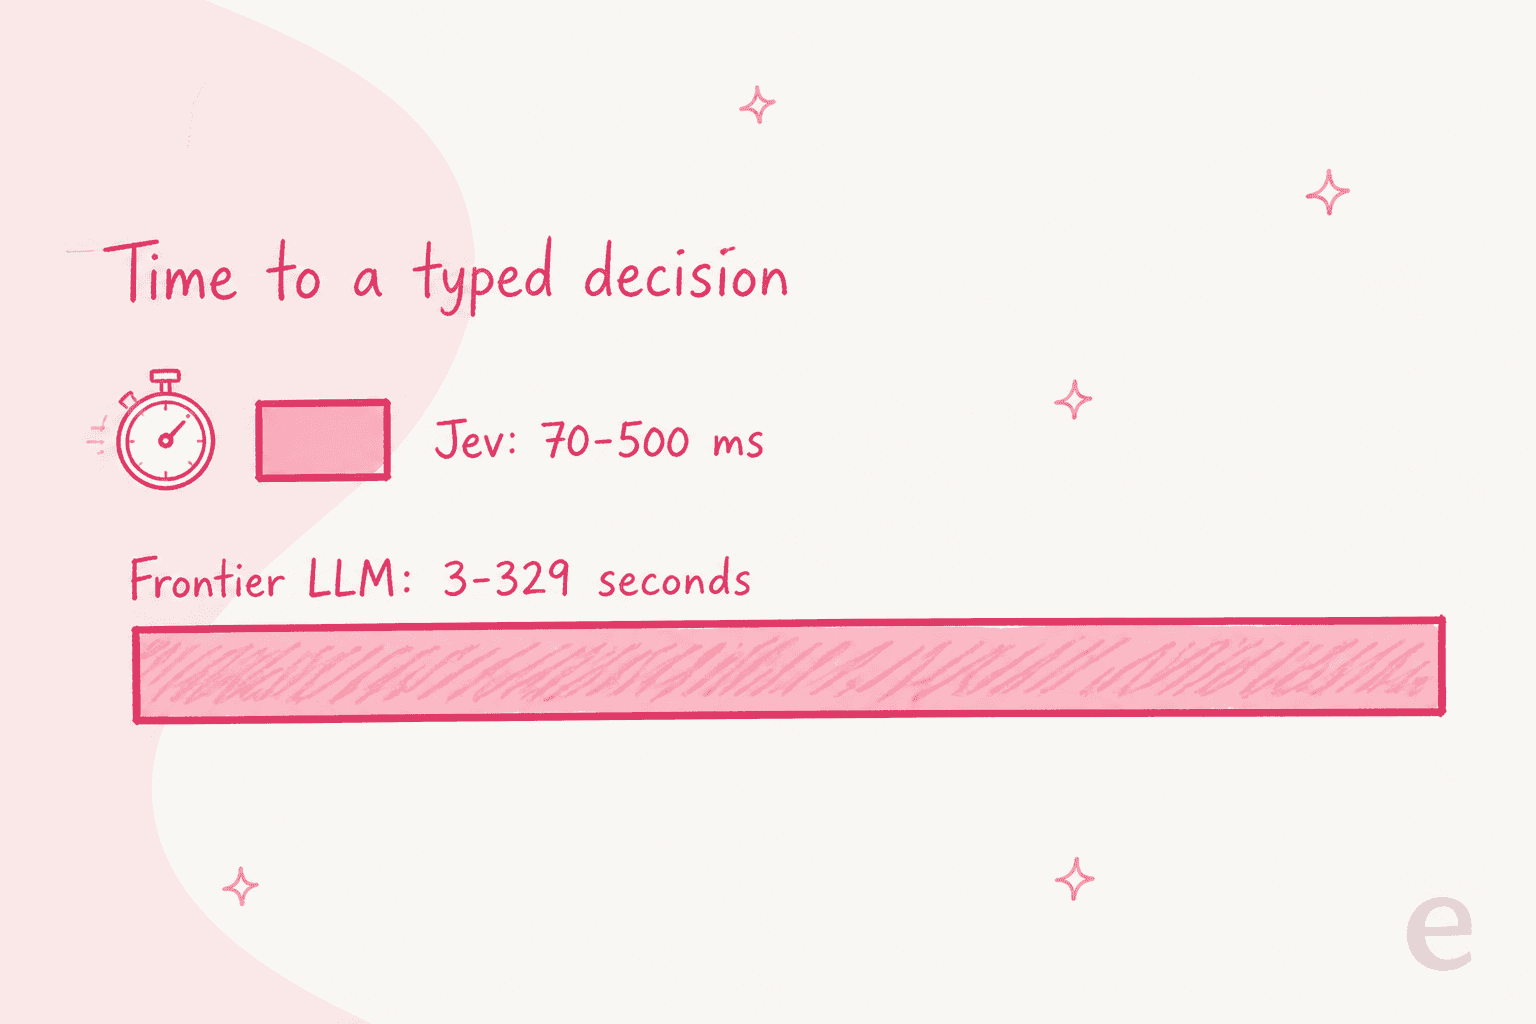
ベースラインも数字と同じくらい重要なので、注意点を添えて同じ内容を表にまとめます。
| 主張 | Jev | TypeSafeが示すベースライン |
|---|---|---|
| エンドツーエンドのレイテンシ | 70msから500ms | フロンティアLLMで3〜329秒 |
| 速度の倍率 | 40倍から200倍速い | System One型のクエリで |
| ワークフローの見出し | 193.6倍速い | 「実際の改善幅としては高い側」 |
| 単一判断のデモ | 0.114秒 | LLMベースラインは8.566秒 |
| コンテキストウィンドウ | 32,000トークン | モデルバージョン jev-1.13.0 |
私が実際に計画の基準にするのは70〜500msの範囲です。ワークフロー全体ではなく1回のリクエストを表しているからです。このレイテンシなら、ユーザーが待っているリクエストの中に判断を組み込めます。分類の工程に8秒かかるとそれはできません。
Jevが速い理由:トークンの流れではなく1回の並列処理
この速度はチューニングの小技ではなく、設計の違いから生まれています。LLMは人が読む文字列を作るまで、1トークンずつ順番にサンプリングします。Jevはすべての出力を1回の並列処理で生成し、自由なテキストはまったく作りません。
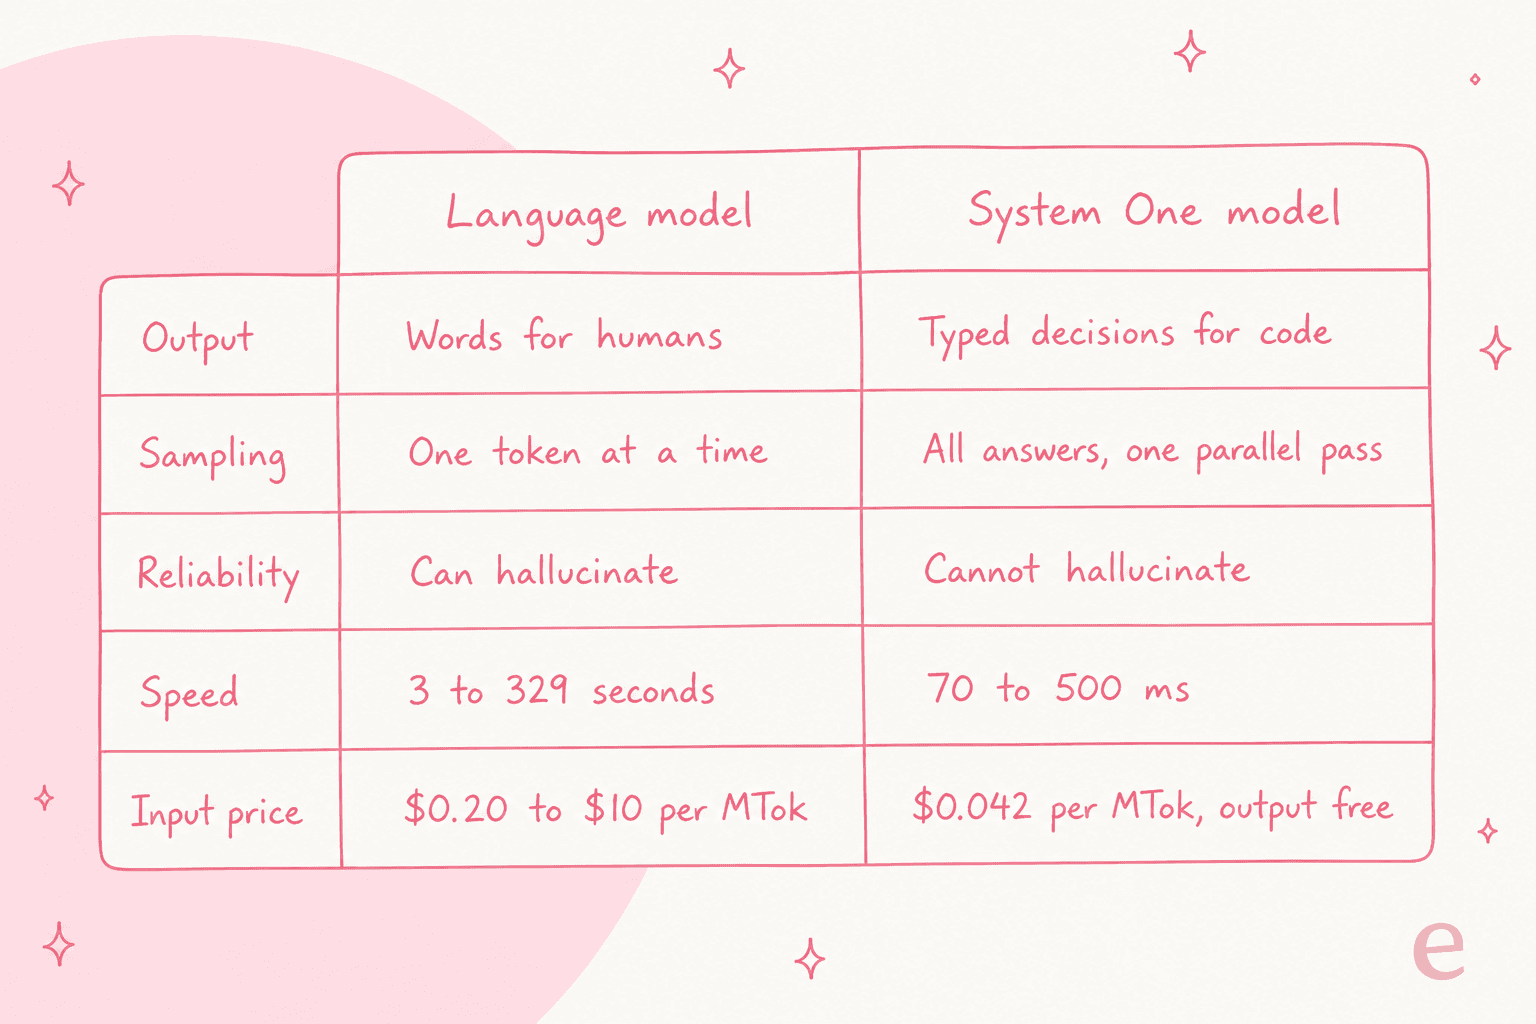
Jevには、ステート(文字列または構造化オブジェクト)と、型付きの質問のセットを送ります。Jevは同じステートに対して各質問を並列に評価し、確率と信頼度スコアを伴う型付きの回答を返します。各質問は個別にスコア付けされるため、質問を増やしても応答時間はほとんど変わらないとTypeSafeは述べています。そのため「緊急か」「どの部署か」「どれくらい不満か」を1回の呼び出しで尋ねても、レイテンシの予算内に収まります。
だからこそ、Jevを「より速いLLM」と呼ぶより、速い部品と捉えるほうが公平です。言語モデルに無理やりJSONを出力させ、有効であることを祈りながらパースしている場面にぴったりはまります。AgentKitとAnthropic APIの比較でも出てくる「どの層を選ぶか」という同じ問いです。文章の作成、説明、複数ステップの推論が必要な場面には向きません。
速度比較は完全な同条件ではない
ローンチ当日の読者が1時間以内に気づいた点で、率直に触れておく価値があります。Jevが速いのは、一部には、やっている仕事が少ないからです。1,929ポイントを集めたHacker Newsのスレッドのトップコメントがローンチ全体の見方を変え、その直後にさらに鋭いレイテンシ批判が続きました。
"'70-500ms vs 3-329 seconds' are apples-to-oranges unless the LLM baseline is doing comparable work... If Jev is skipping generation entirely for a narrow structured task, of course it's faster."

もっともな指摘です。3つの型付きの値を出すモデルと、段落を書くモデルを比べて前者を200倍速いと呼ぶのは、別々のものを測っています。正直に読めば、Jevは狙っている「判断の形をした仕事」に対して極めて速く、その領域は現実に存在し、よくあるものです。ただ、やらない仕事で速いわけではありません。
そのため、私が最も信頼する数字はTypeSafeのサイトにはありません。VercelのCEOがJevを実際の製品に組み込んで出したものです。
"We're seeing extraordinary results from @typesafeai... Jev is up to 18x faster (p95) and more accurate."
実際の安全性レビュー工程でのp95の18倍は、マーケティング上の200倍より小さいものの、はるかに根拠がしっかりしており、超高速が効く場所を的確に示しています。
速度が本当に効く場面
1秒未満のレイテンシが価値を持つのは、判断がクリティカルパス上にあり、その答えを待っている処理があるときだけです。探すべきパターンは遅いシステムの前に置く高速なチェッカーです。
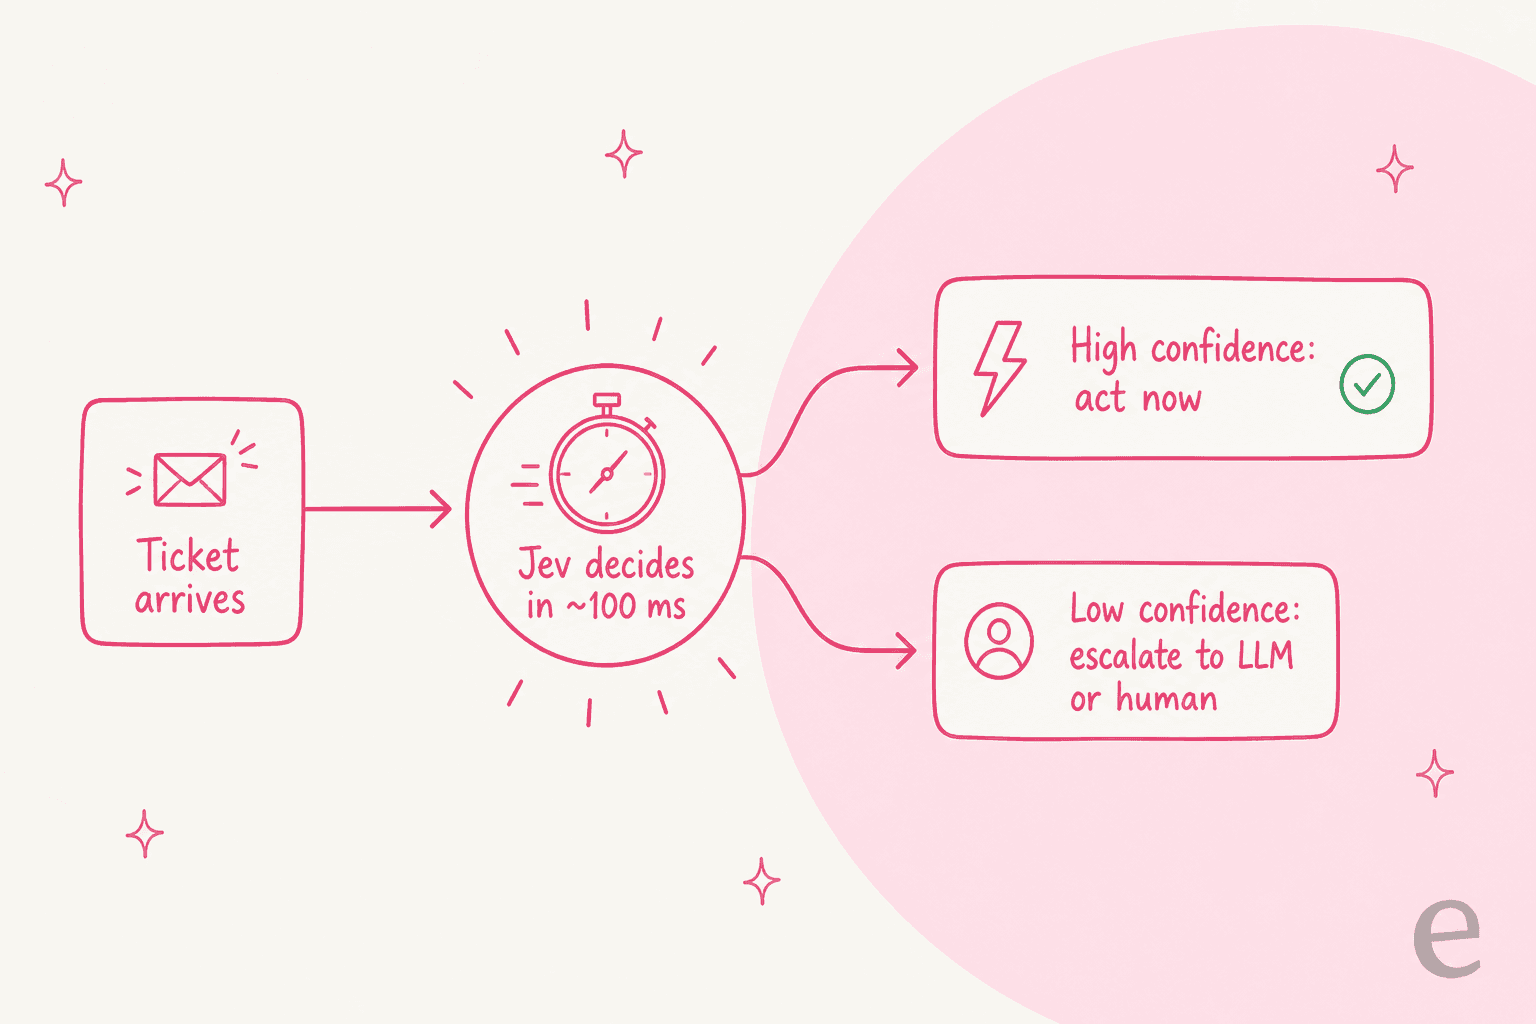
Cloudflareが公開している実例が、象徴的にサポートチケットです。Jevに「Help! My payouts have been failing for 3 days」を渡すと、is_urgentが0.95、departmentが信頼度0.8で請求、さらに不満度スコアが、1回の呼び出しで返ります。1回のリクエストでトリアージ、ルーティング、感情分析をこなすもので、まさにAIチケットトリアージのフローが1日に何千回も実行する工程です。呼び出しが8秒ではなく100msなら、遅いバックグラウンドキューではなく、チケットが届いた瞬間に同期的に実行できます。
その需要を最もよくまとめた開発者は、すでに手作業で同じことをしていました。
"this is exactly how I am using LLMs in production, to narrowly make choices and return structured data... Jev's focus on structured I/O and confidence scores are game changing."
信頼度スコアがあるからこそ、このようなループで速度を活かせます。確かな回答はすぐに実行し、不確かなものは大きなモデルか人に回します。これは優れたAIエージェント設計や本格的なエージェントアシストの工程にも通じる規律で、自信満々の誤った判断が顧客に届かないようにしつつ速さを得ることが目的です。
これだけ速く動かすコスト
「超高速」のもう一方の側面は、絶えず呼び出せるほど安いことです。TypeSafeはJevを入力100万トークンあたり0.042ドル、出力は無料としており、入力でClaude Fable 5.1の238分の1だと説明し、出力は「too cheap to meter」と表現しています。独立した料金ページはまだなく、持続可能性についてはローンチ記事が率直です。「We can't prove it isn't subsidized; we'll need the long-term to prove the sustainability of our pricing (which we expect to go down, not up).」
呼び出しあたりの安さと速さが組み合わさることで、モデル名の由来であるジェヴォンズのパラドックスという売り文句が成り立ちます。判断のコストが1セントの何分の一かで、100msで返ってくるなら、出し惜しみせずあらゆる場所で呼び出すようになります。すでにAIワークフロー自動化全般で安価な部品に頼っているのと同じです。分類のたびにLLMの価格を払うのとは、まったく異なる姿勢です。
Jevの速度を前提に構築すべきか?
ドキュメント、デモ、反論を一通り見たうえでの私の結論です。コードが利用する狭く明確な判断で、レイテンシがクリティカルパス上にあるなら、Jevを選んでください。たとえばルーティング、モデレーション、インテント検出、スコアリング、大きなモデルの前に置く高速な安全ゲートなどです。70〜500msと無料の出力が、作れるものを本当に変える場面です。
より速いChatGPTを期待して使うのはやめましょう。文章を書かず、説明もせず、会話もしません。これだけ速いと、単純な分類器やルールで足りる仕事にまで使いすぎがちです。守るべき線は、Jevは部品だということです。ミリ秒で優れた判断を返してくれますが、パイプライン、エスカレーションのロジック、自己解決の戦略、そして判断後のあらゆるアクションは、あなたが担います。判断の速さは、そのどれも肩代わりしてくれません。
eeselを試す
サポートを運営しているなら、正直な言い換えはこうです。Jevは見事なエンジンですが、車ではありません。約114ミリ秒で、チケットが緊急で、請求関連で、不満を抱えた顧客からのものだと教えてくれます。チケットを開くことも、ヘルプセンターに基づく返信を作成することも、返金を実行することも、自信がないときに人へ引き継ぐこともしません。その層は誰かが作る必要があります。
eeselは、その完成したチームメイトです。ヘルプデスクに接続するAIサポートチームメイトで、Jevが部品として提供するトリアージ、ルーティング、エスカレーションの判断をすでに行い、そのうえで最後まで実行します。過去のチケットとヘルプセンターから学習し、実際の顧客に触れる前に過去のチケットでシミュレーションすることもできます。

Jevの開発者向けの使いやすさが気に入ったなら、これも気に入るはずです。eeselはダッシュボードだけではありません。eesel CLI(npx @eesel/cli)は同じチームメイトをターミナルから操作でき、人がeesel chatやeesel activityを手で実行することも、スクリプトでCIから自動化することも、Claude Code、Codex、Cursorなどのコーディングエージェントから操作することもできます。すべてのコマンドがJSONを出力し、--dry-runで実行前に正確な呼び出しを確認できるからです。すべてのワークスペースはMCPサーバーでもあります。Jevは素早い判断をくれ、eeselはその判断に基づいて動くチームメイトをくれます。eeselを無料で試せます。
よくある質問
TypeSafe Jevはどれくらい速いですか?
TypeSafeはJevのエンドツーエンドの応答時間を70msから500msとし、同種の作業におけるフロンティアLLMの3〜329秒と比較しています。ただしJevが返すのはテキストではなく型付きの判断だけなので、厳密に同じ条件の比較ではありません。ティア1の自己解決の裏側にある分類と振り分けの作業では、確かに速いです。
なぜJevは通常のAIモデルよりずっと速いのですか?
LLMは人が読む文字列を書き終えるまで、1トークンずつサンプリングします。Jevはすべての質問を1回の並列処理で評価し、自由なテキストを一切生成しないため、最も遅い部分を省けます。つまりJevは判断のための部品であり、文章を書いたり推論したりするモデルの代わりではありません。ルールベースとAIエージェントの違いと同じ分け方です。
Jevの速度比較は公平ですか?
部分的には公平です。信頼できる実測値はVercelのCEOから出ており、実際の安全性レビュー工程でJevをp95で18倍高速と測定しています。マーケティング上の193.6倍はワークフロー全体の数字で、TypeSafe自身の言葉でも実際の改善幅としては高い側にあり、Hacker Newsもすぐに指摘しました。
超高速のJevモデルの料金はいくらですか?
TypeSafeはJevを入力100万トークンあたり0.042ドル、出力は無料としており、Claude Fable 5.1より入力価格が238分の1だと説明しています。プラン別の料金表はまだなく、アクセスは早期アクセスのウェイトリスト経由です。Cloudflare Workers AIでも利用できます。