

Cohere Parse 5(parse-v5.0)は、文書のページを検索、RAG、エージェント向けのクリーンな Markdown に変換する、小型でコスト重視のビジョンモデルです。2026年8月27日に一般提供が始まりました。
正直な結論はこうです。Parse 5 は市場で最も精度の高いパーサーではなく、それを目指してもいません。 Cohere 自身の ParseBench でのスコアは79.2で、最先端 LLM(GPT-5.5 が84.4、Opus 4.8 が84.3、Gemini 3.5 Flash が81.8)には及びませんが、専用 OCR ツールの大半を上回ります。強みは価格とスループットです。1,000ページあたり1.50ドル、毎秒4.5ページで、Model Vault を使えば大規模時のページ単価はさらに下がります。
数十万から数百万ページを RAG パイプライン向けにパースし、予測しやすいコストを求めるなら選ぶ価値があります。今すぐ確実な統合が必要な場合(本番エンドポイントは PDF ではなく画像を受け付けます)、構造化 JSON 出力やフィールドごとの信頼度スコアが必要な場合は注意してください。Parse 5 はそのどれも提供しません。そして Parse は最初の一歩にすぎません。渡されるのはクリーンなテキストで、回答ではありません。
Cohere Parse 5 は非常に具体的な売り文句とともに登場しました。「最高の文書パーサー」ではなく、「市場で最も強い価格性能比」です。発表でそう認めるのは新鮮で、このモデルがあなたに合うかどうかの話はそれに尽きます。
私は仕事として連携や API の配管を作っており、eesel でも、その地味な部分、つまり雑多な企業文書を AI が実際に使える形にする作業に多くの時間を費やしてきました。検索パイプラインの勝敗は、静かにパースで決まります。価格表を壊したりフォームの項目を落としたりするパーサーは、下流のすべての回答を汚染し、顧客に間違った数字が伝わるまで気づかないことがほとんどです。そこで Parse 5 のドキュメントを、どのパーサーでもそうするように読みました。「デモがどれだけ良いか」ではなく、「本番で何が壊れるか」です。
見つけたことを紹介します。
Cohere Parse 5 とは何か
Parse は、Cohere の企業向け文書インテリジェンスへの参入製品です。製品の一言説明は「企業文書を AI 対応データに変える」で、仕組みとしては、複雑でマルチモーダルなファイル(表、フォーム、図、埋め込み画像)を、インデックス作成、検索、エージェントのワークフローに渡せる構造化された機械可読の Markdown に変換します。
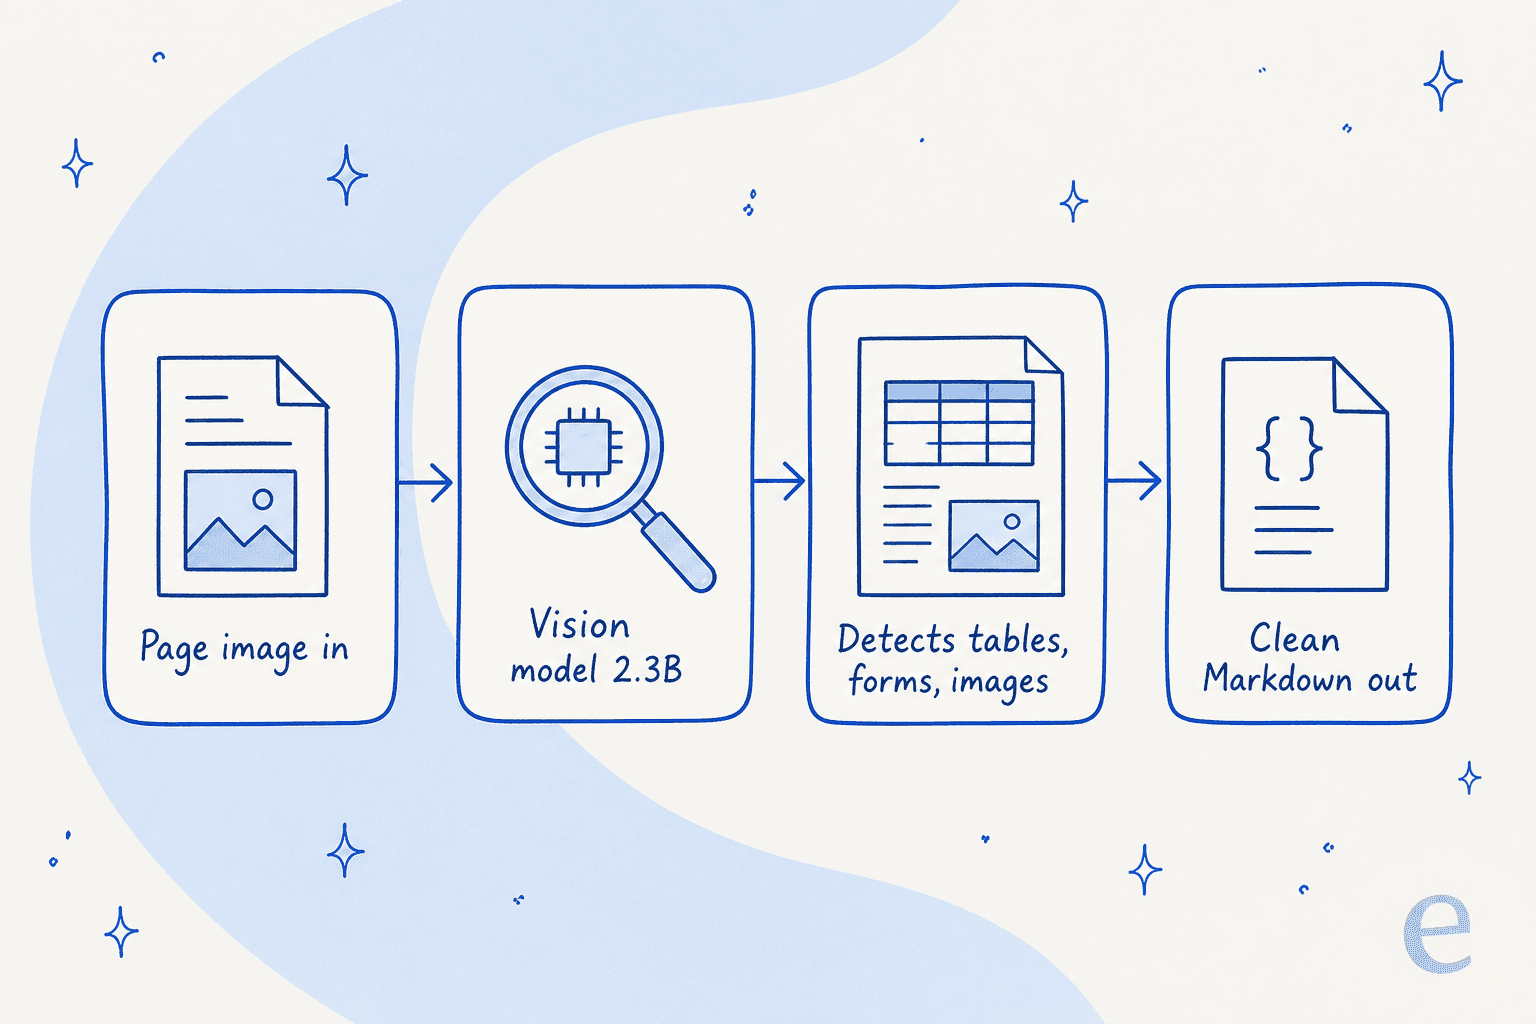
「文書向けビジョン言語モデル」は範囲が広いので、仕様が重要です。モデルドキュメントによると、parse-v5.0 は23億パラメータ、約4.6GB、コンテキスト8,192トークンのモデルで、Cohere の north-micro-vision-instruct アーキテクチャを基盤にしています。意図的に小さなモデルです。Cohere は、比較対象の最先端 LLM が「いずれも汎用で、Parse よりはるかに大きい」と率直に述べています。小さいことが要点であり、それが価格とスループットを成り立たせています。
流れはシンプルです。ページ画像を渡すと、視覚的な構造を検出し、表を HTML として埋め込んだクリーンな Markdown と、視覚要素のバウンディングボックスを返します。
ベンチマーク:強いが、トップではない
Cohere は独自のベンチマーク ParseBench を作り、「エージェントに適したパース性能」を3つの観点で測定しています。表の抽出、内容の忠実性(欠落、幻覚、読み順の崩れ)、意味を変える書式(取り消し線など)の保持です。
Parse の3観点平均は79.2で、このスコアの内訳が興味深いところです。表(87.0)と内容の忠実性(86.6)は本当に強く、意味的な書式(64.0)は弱めです。つまり内容を確実に読み取って構造化する一方で、斜体や取り消し線のように、ときに文章の意味を変えてしまうニュアンスの保持はやや雑です。
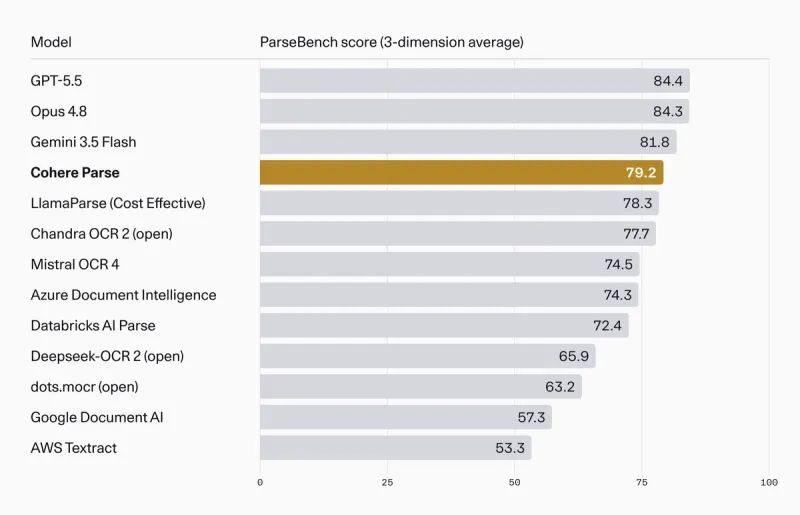
グラフを正直に読むと、2つのことが同時に成り立ちます。Parse は最先端の3モデル、GPT-5.5(84.4)、Opus 4.8(84.3)、Gemini 3.5 Flash(81.8)には負けています。一方で、Cohere が試したすべての専用パーサーには勝っており、LlamaParse のコスト重視ティア(78.3)、Chandra OCR 2(77.7)、Mistral OCR 4(74.5)、Databricks AI Parse(72.4)を上回ります。従来型のクラウド OCR サービスとは比較になりません。Cohere は AWS Textract(53.3)と Google Document AI(57.3)の双方に対して20ポイント以上の改善を報告しています。
名指ししておくべき注意点が1つあります。これはベンダー自身のベンチマークで、販売しているモデルが価格調整後の見せ方で勝っています。数字が間違いだという意味ではありませんが、だからこそ次のグラフ、つまり精度とコストを並べたものの方が有用です。
スループットと価格:Parse が本当に勝つ点
これが Parse を選ぶ理由のすべてなので、ここはじっくり見る価値があります。
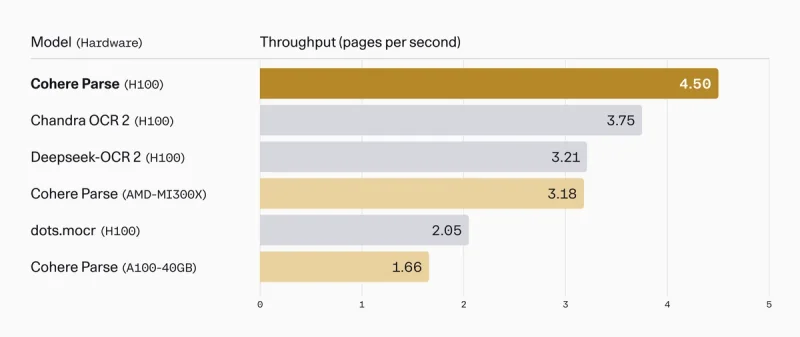
価格は、Cohere API で1,000ページあたり1.50ドルです。スループットは毎秒4.5ページで、Cohere は8×H100 ノードで毎秒36ページ(毎分2,160ページ)と報告しています。同じハードウェアで RedNote の dots.mocr の約1.4倍、Chandra OCR 2 の約2.2倍で、いずれも vLLM 上で動かした結果です。
精度と価格を同じ軸に載せると、Parse の本当の立ち位置が浮かび上がります。ParseBench のパレート図では、安くて高スコアの領域にあり、最先端 LLM は数ポイント高い精度をページあたり30倍から50倍のコストで提供しています。
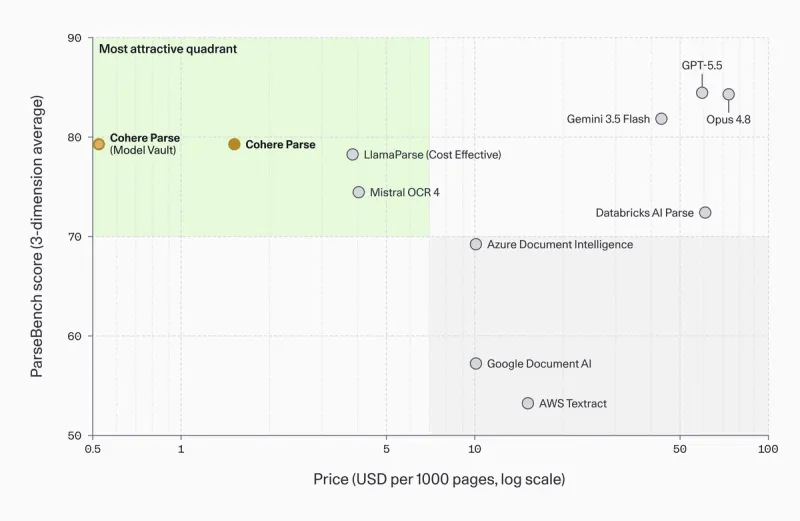
規模が大きくなるほど節約額は具体的になります。Cohere の試算では、月約1,300万ページを処理する買掛金ワークフローを API ではなく Model Vault で動かすと、月およそ12,000ドル、年間144,000ドルの節約になります。1,000ページ10ドルのハイパースケーラー製パーサーと比べると、同じ1つのワークフローで年間およそ147万ドルの節約です。パース選定が経理部門まで上がるような数字で、これが Parse の存在理由です。
Cohere Parse 5 の料金一覧
Parse は複数の経路で販売され、最も安い経路は稼働の安定度によって変わります。全体像は次のとおりです。
| アクセス経路 | 内容 | 価格 |
|---|---|---|
| Cohere API | マネージドエンドポイント、ページ従量課金、インフラ不要 | 1,000ページあたり1.50ドル |
| Model Vault(GPU 使用率50%) | シングルテナントの時間課金インスタンス | API より約23%安い |
| Model Vault(フル稼働) | シングルテナントの時間課金インスタンス | API より最大61%安い |
| Microsoft Foundry | Azure 上のモデル Cohere-parse-v5 | Azure のインスタンス料金 |
| Amazon SageMaker | マーケットプレイスでのデプロイ | AWS のインスタンス料金 |
| Hugging Face Space | 試せる無料デモ | 無料 |
私の見立てでは、送ったページの分だけ支払う API は、波のある用途や少量の用途に向いています。Model Vault は、インスタンスを稼働させ続けられる安定した大量処理で有利になります。これはまさに、Parse が想定する買掛金規模のワークロードです。量にムラがあるなら、専用インスタンスを契約する前に計算してください。GPU のアイドル時間は、ページ単価の節約をすぐに帳消しにします。
Cohere のより広いカタログとプランの中での位置づけは、Command、Embed、Rerank の料金も扱う Cohere AI の料金の解説をご覧ください。
抽出するもの、しないもの
パーサーは、何を拾うかと同じくらい、何を捨てるかで決まります。Parse には、その上に構築する前に知っておくべき癖がいくつかあります。
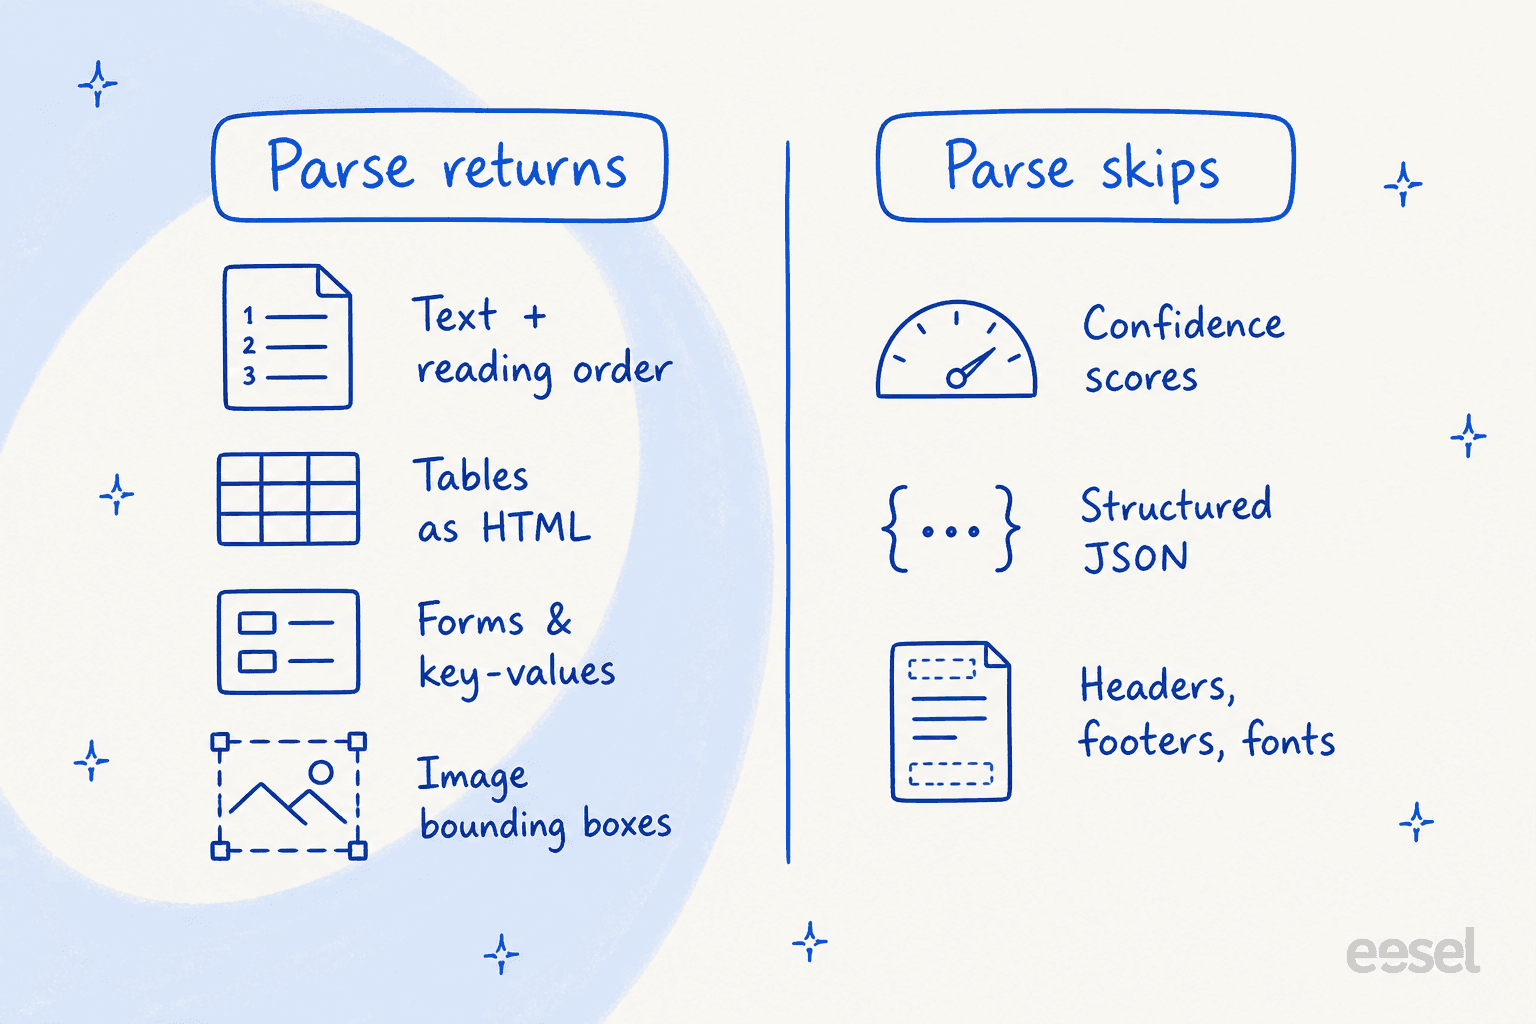
良い点として、Parse は正しい読み順のテキスト、HTML の表、フォームとキーと値のペア、バウンディングボックス付きの画像説明を返します。ナレッジベースや AI ナレッジベースチャットボットに流し込むには十分な機能セットです。
ドキュメントの記載どおりの制限は、注意が必要な部分です。
- 信頼度スコアなし。 抽出結果にどれだけ自信があるかを Parse に尋ねられないため、自動の品質ゲートが難しくなります。買掛金や保険金請求のフローでは、これは実際の穴です。
- Markdown のみで、構造化 JSON はなし。 パイプラインが型付きフィールドを最初から求めるなら、Markdown を自分で後処理することになります。
- ヘッダー、フッター、フォント階層の検出なし。 内容は読みますが、文書の付随要素や見出しレベルのタグ付けはしません。
- バウンディングボックスは表と画像のみ。 ローンチ時の脚注2によると、Parse はテキストの要素ごとのボックスを出力しません。Cohere はこれをバグではなく読み順のための意図的な選択と説明しており、ほとんどの RAG 用途では問題になりませんが、単語レベルの座標が必要なら別の選択肢を探してください。
Parse が狙う取り込み用途では、どれも致命的ではありません。型付きフィールドと信頼度ゲートが必要な構造化文書抽出プロダクトに Parse を組み込むつもりだったなら、致命的になります。道具は仕事に合わせて選びましょう。
API の呼び出し(と1つの落とし穴)
開発者体験はすっきりしています。SDK をインストールし、クライアントを作成し、Cohere v2 API の co.parse を呼び出します。
クイックスタートの最小の呼び出しは、パースとしてはこれ以上ないほど単純です。
import base64, cohere

co = cohere.ClientV2("COHERE_API_KEY")

with open("document.png", "rb") as f:
    b64 = base64.b64encode(f.read()).decode("utf-8")
data_uri = f"data:image/png;base64,{b64}"

response = co.parse(
    model="parse-v5.0",
    document={"type": "image_url", "image_url": data_uri},
)

for page in response.pages:
    print(page.markdown.content)
ここに落とし穴があり、今日構築しようとしている人にとっては大きなものです。ドキュメントは対応形式として PDF、PPT、JPEG を挙げていますが、API リファレンスは、現在エンドポイントが対応するのは document.type = image_url のみ、つまりデータ URI かリモート画像 URL だけだと明記しています。PDF とファイル URL の直接入力はまだ未対応です。 そのため実際には、PDF のページをまず画像にラスタライズし、1枚ずつ送ります。画像の上限は余裕があり(ファイルサイズ20MB、5,000万画素)、フラットな Markdown ではなく、テキスト、表、画像の領域をバウンディングボックス付きで順に並べた配列がほしい場合は、output_format を blocks に切り替えられます。
言語対応は、現在安定している入力言語が9つで、アラビア語、英語、フランス語、ドイツ語、日本語、韓国語、イタリア語、ポルトガル語、スペイン語です。それ以外の言語はゼロショットで、精度は下がります。
Parse の位置づけ:パイプライン全体ではなく、最初の一歩
ローンチ報道の多くが素通りする部分です。Parse は文書をクリーンなテキストに変えます。埋め込みも、検索も、回答もしません。検索パイプラインの入り口であって、パイプラインそのものではありません。
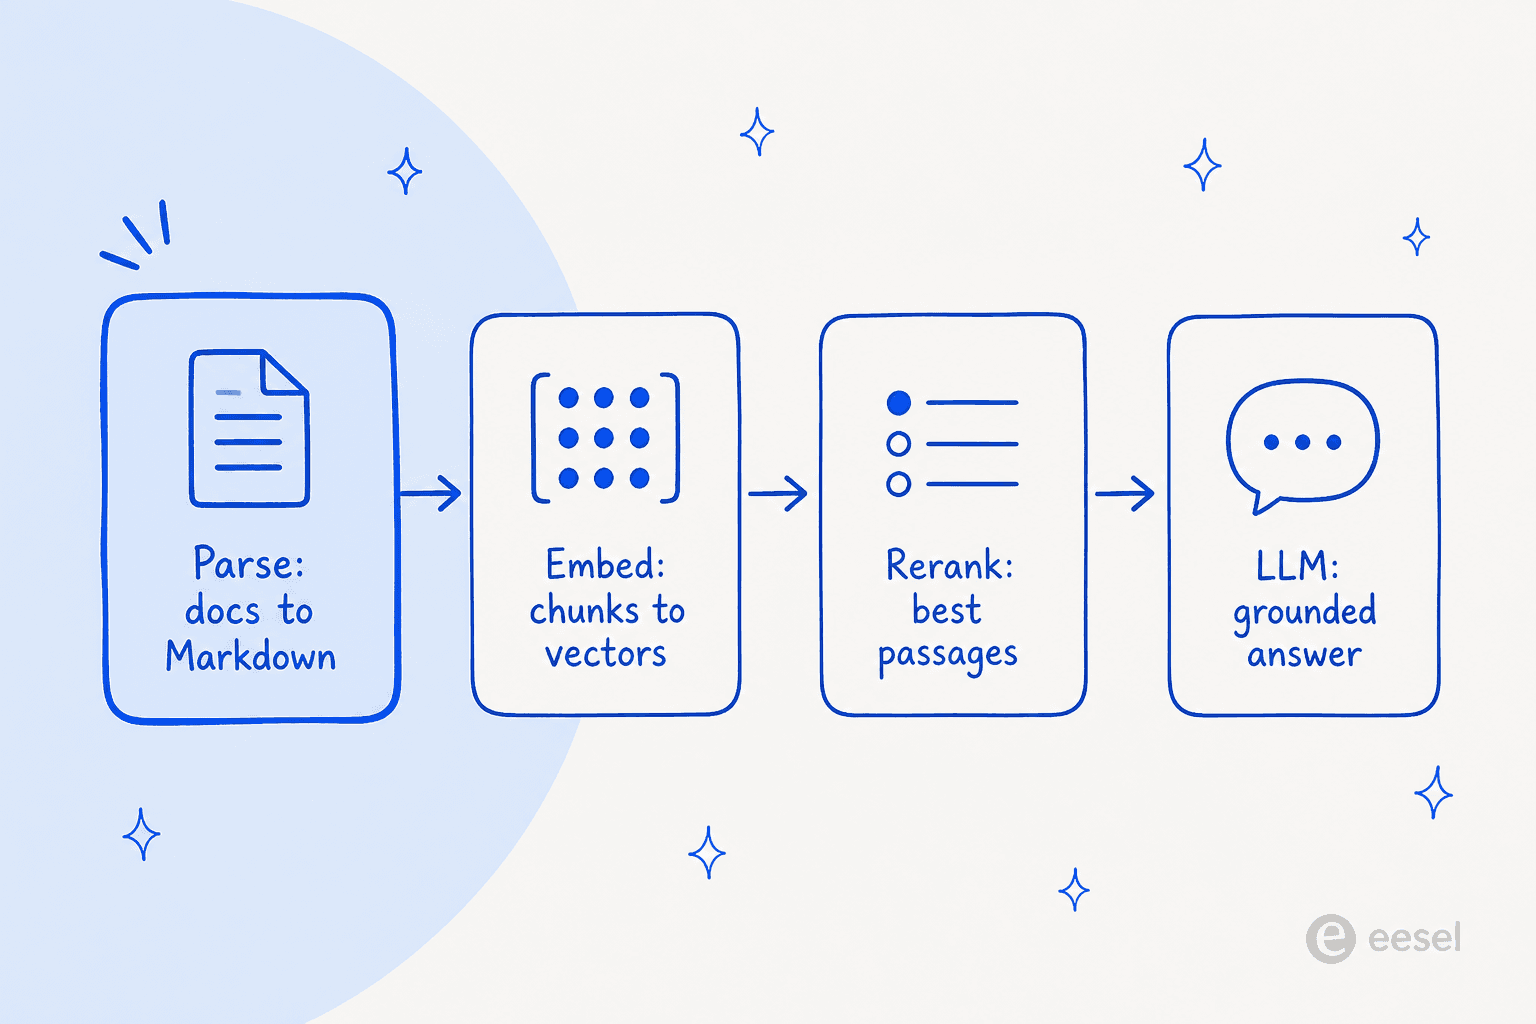
Cohere もそれを承知しており、そのため Parse は文書インテリジェンスと検索のスタックである Compass の一部として、Embed や Rerank とともに提供されます。すでに Cohere に全面的に乗っているなら、その統合ルートは本当に便利です。そうでなければ、1つのスタックに統一する前に Cohere の代替を比較する価値があります。
このローンチについて見つけた、信頼できる外部の声は1つだけで、パースは見かけより難しいという同じ指摘でした。エンタープライズ技術ジャーナリストの Sean Kerner 氏はこう述べています。
"Text, document parsing should be a solved problem at this point right? But it's not.. every few weeks there is another option that claims to make it better. This week it's @cohere Parse 5."
この懐疑はもっともです。Parse 5 は良いリリースですが、めまぐるしく変わる分野の中の1つの強力なパーサーにすぎず、4つか5つの輪でできた鎖のうち、ちょうど1つの輪を解決するだけです。本当の目的が文書から質問に答えることなら、パーサーの選択はプロジェクトの終わりではなく始まりです。
誰が Cohere Parse 5 を使うべきか
一通り見たうえでの結論です。
Parse 5 を選ぶべき人: 大量の企業文書(数十万から数百万ページ規模)を RAG やナレッジマネジメントのシステムに取り込み、ページ単価の予測しやすさを重視し、「最先端に近い精度を何分の一かの価格で」というトレードオフを望む人です。Model Vault とオンプレミスの選択肢は、文書を公開 API に送れない規制業界にも有力です。
今は見送るべき人: 今すぐ PDF の直接取り込み、構造化 JSON 出力、フィールドごとの信頼度スコア、あるいは最先端モデルでしか買えない最後の数ポイントの書式精度が必要な人です。また、本当にほしかったのがクリーンなテキストではなく回答なら、見送ってください。パーサー単体ではそこに届きません。
eesel:パース済みテキストではなく、回答がほしいとき
自社の文書(サポートチケット、ヘルプ記事、社内 Wiki)から AI に実際に質問へ答えさせたくて Parse 5 にたどり着いたのなら、パーサーがしないことをはっきりさせておく価値があります。Parse が渡すのはクリーンな Markdown です。その上に埋め込み、検索、ランキング、回答の層を自分で構築し、コンテンツが変わるたびに精度を保ち続ける必要があります。
eesel は、そのパイプライン全体をすぐ使える形にしたものです。自分で組み立てるインフラではなく、採用する AI ヘルプデスクのチームメイトです。ヘルプセンター、過去のチケット、Zendesk や Confluence のようなツールに接続し、会社の文脈を学び、顧客や従業員の実際の質問に答えます。パイプライン全体が任せられるからこそ、最良の AI ヘルプデスクの選択肢の1つです。Parse 5 は部品で、eesel は完成した仕事です。

パース優先のパイプラインすべてに備わっていてほしいと願う点が、一番の見どころです。eesel なら、実際の顧客に回答する前に、自社の過去のチケットで導入をシミュレーションできます。デモではなく、実際のコンテンツでの本当の解決率と正確な回答が見えます。パーサーを出荷することと、信頼できるものを出荷することの違いはそこにあります。eesel は無料で試せます。
よくある質問
Cohere Parse 5 とは何ですか?
parse-v5.0)は、文書のページを検索、RAG、AI エージェント向けのクリーンで機械可読な Markdown に変換する、23億パラメータのビジョンモデルです。2026年8月27日に一般提供が始まり、最高精度ではなく価格性能比を売りにしています。