

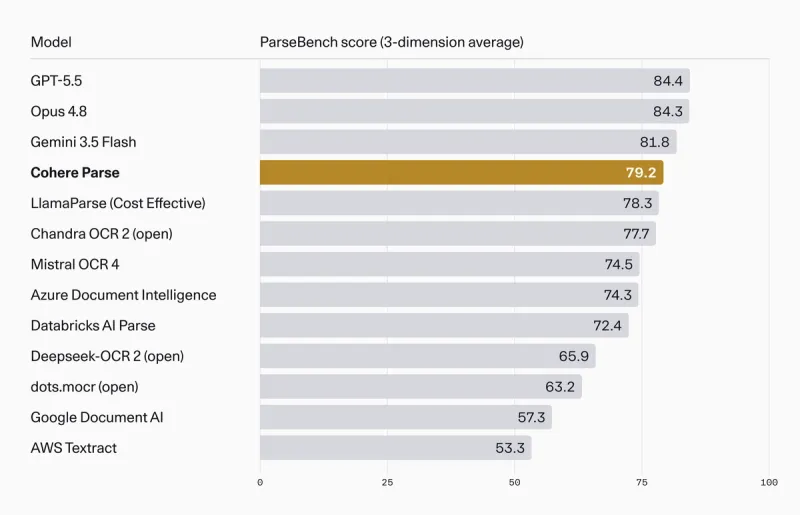
Cohere Parse 5(parse-v5.0)は、強力で安価なドキュメントパーサーです。ページをきれいな Markdown に変換し、料金は 1,000 ページあたり $1.50、ParseBench のスコアは 79.2 です。代替を探す理由は主に3つあります。より高い精度がほしい、すでに契約しているクラウドの中で完結させたい、データを管理するために自前でホストしたい、の3点です。
どこへ向かえばよいかを短くまとめます。
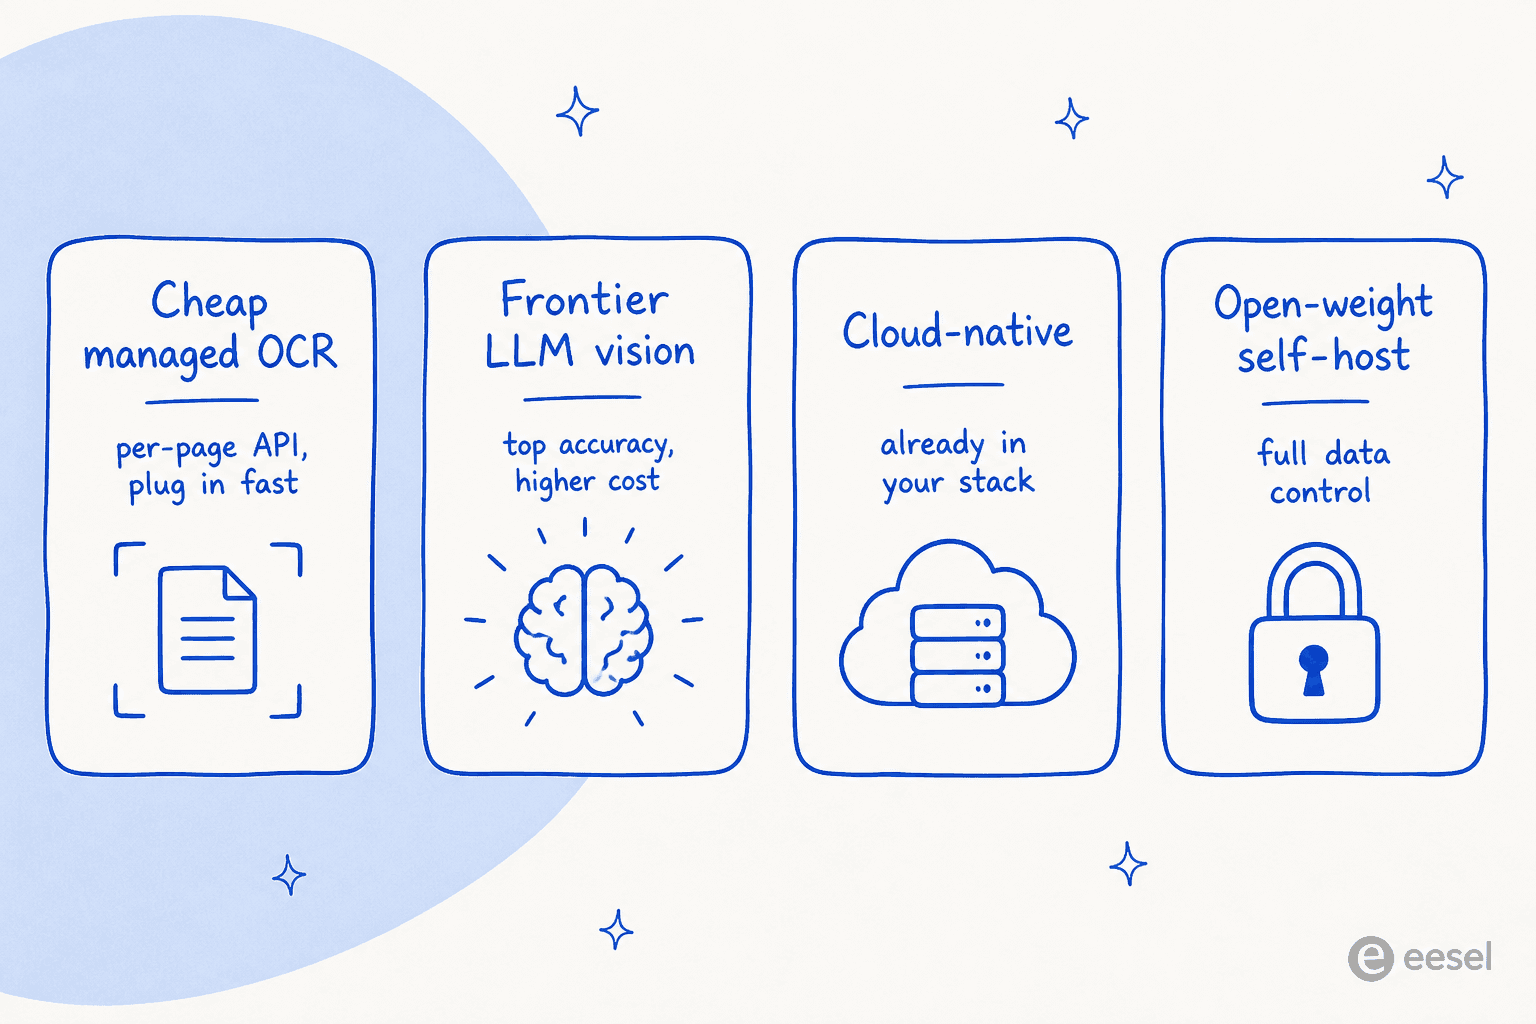
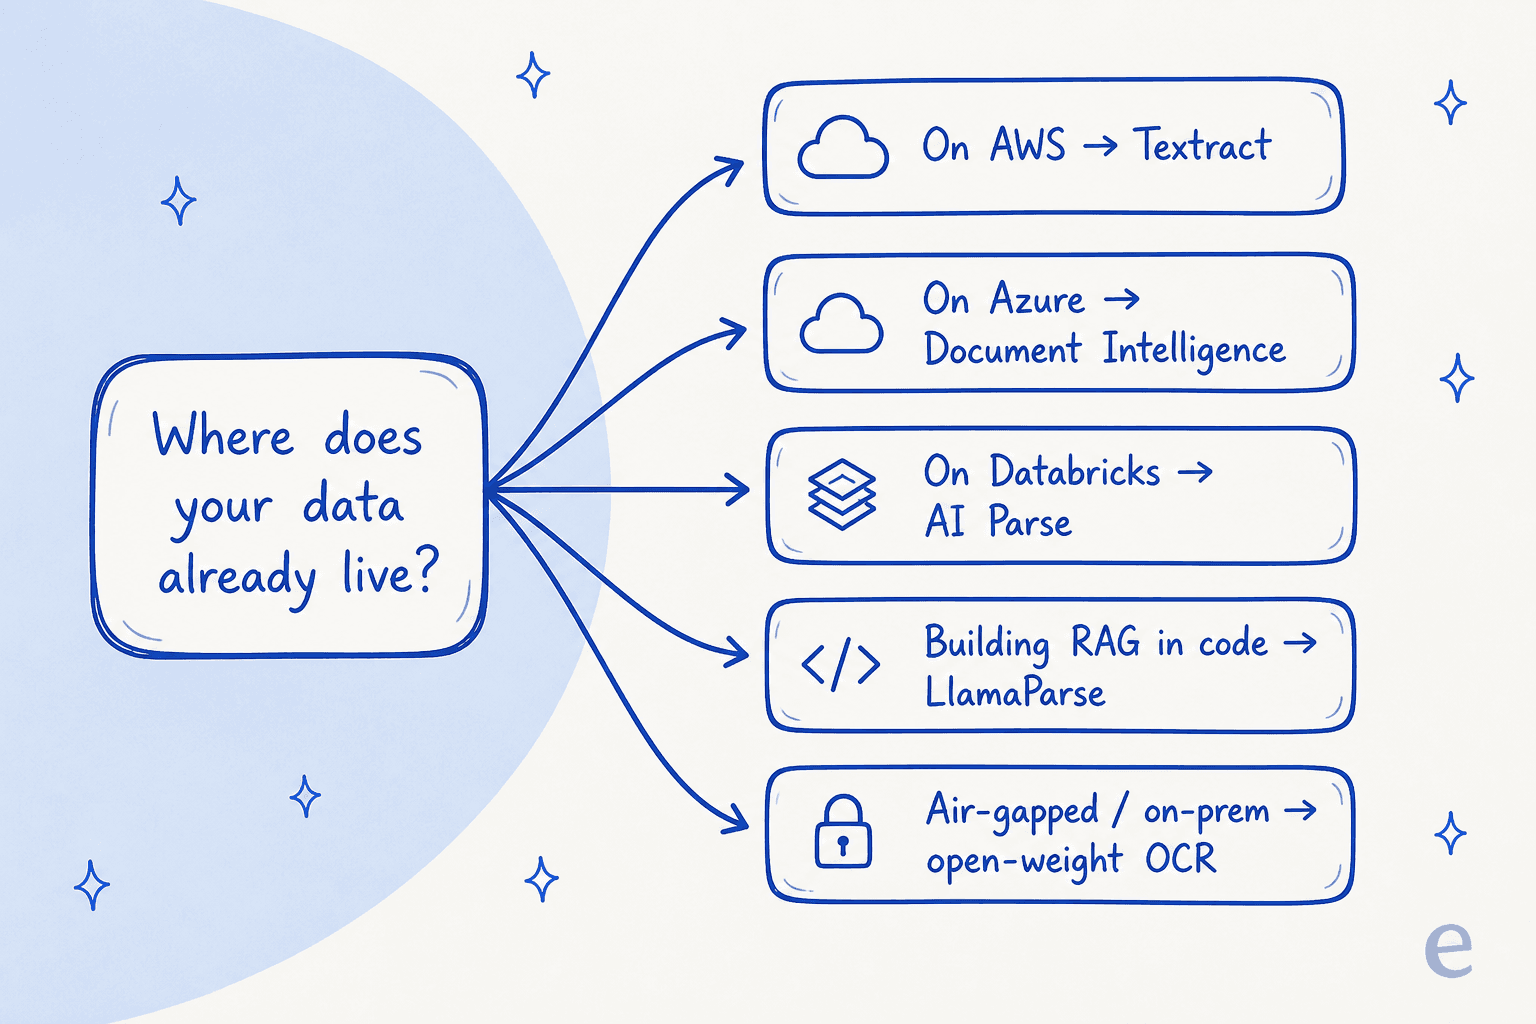
- コストは度外視で最高の精度がほしい? 最先端モデルのGPT-5.5(84.4)や Gemini 3.5 Flash(81.8)が表の上位です。
- Parse のようなページ単位の API がほしい? Mistral OCR が最も近い乗り換え先です。
- コードで RAG を組んでいる? LlamaParse は LlamaIndex のスタックにそのまま組み込めます。
- すでに AWS、Azure、Databricks を使っている? ネイティブのパーサー(Textract、Document Intelligence、AI Parse)を使えば、ベンダーを増やさずに済みます。
- データを完全に管理したい? オープンウェイトの OCR モデルを自前でホストしましょう。
最初に言っておくべきことがあります。このリストのツールはすべて、ドキュメントをテキストに変換するだけです。本当の目的がそのドキュメントから質問に答えることなら、解析は4つのステップのうちの最初の1つにすぎません。そこで登場するのが、eesel のようにすぐ使える AI ヘルプデスクエージェントです。最初の1工程だけでなく、全体の流れを引き受けます。
なぜ Cohere Parse 5 以外も見るのか?
まず Parse にはフェアでいたいと思います。これは本当に優れたリリースです。Cohere は 2026年8月27日に、「市場で最も強い価格性能比を持つ、高スループットのビジョン解析モデル」として公開しており、数字もその説明を裏付けています。毎秒 4.5 ページを処理し、RAG パイプラインにそのまま入るきれいな Markdown を返し、料金は 1,000 ページあたり一律 $1.50 です。月に数十万ページを取り込むなら、この価格性能比は反論しにくいものです。これらについては、Cohere Parse 5 の詳細レビューで深く掘り下げました。
それでも、なぜ他を探す人がいるのか。本当の理由が繰り返し3つ挙がります。
精度。 Parse は価格性能比を明確に打ち出しており、買える中で最も精度の高いパーサーを目指してはいません。ParseBench のスコアは 79.2 で、「上回るのは最先端 LLM だけ」(GPT-5.5、Opus 4.8、Gemini 3.5 Flash)です。ドキュメントが雑然としていたり、密度が高かったり、入れ子の表だらけなら、その数ポイントの差は重要で、ページあたり多く払ってでも得たいかもしれません。
スタックとの相性。 データがすでに AWS、Azure、Databricks にあるなら、Cohere を加えると、ベンダー、キー、請求書、データ処理契約がそれぞれ1つ増えます。自社クラウドのネイティブパーサーは「十分良い」ことが多く、その手間をすべて省けます。
入力の制限とデータ管理。 Parse のライブエンドポイントは現在、画像入力のみを受け付けるため、PDF は先に画像へ変換する必要があり、マネージド API です。規制の厳しい業界のチームは、PDF の直接処理や、自社ハードウェア上で完全に動かせるモデルを求めることがよくあります。代替の中には両方を満たすものがあります。
どれも Parse への批判ではありません。別のツールのほうが合う「継ぎ目」にすぎません。市場は次のように分かれます。
代替ツールの選び方と比較方法
ここにあるツールはすべて Parse と同じ中核の仕事をします。ドキュメントのページを受け取り、構造化された機械可読のテキストか Markdown を返すことです。購入者が実際に気にする4つの基準で順位づけしました。
- 精度 - Cohere 自身が使ったベンチマークである ParseBench での位置。条件をそろえた比較になります。
- コストモデル - ページ単位か、トークン単位か、自社の計算資源か、大量処理時にいくらになるか。
- デプロイ方法 - マネージド API、すでに使っているクラウド内、または自前ホスト。
- 入力の扱い - 画像のみか、PDF を直接扱えるか、幅広いファイル形式に対応するか。
全体を一目で見られる表です。ParseBench のスコアは Cohere が公開した表からそのまま引用しています。
| ツール | ParseBench 平均 | 向いている用途 | デプロイ | 入力 | コストモデル |
|---|---|---|---|---|---|
| Cohere Parse 5 | 79.2 | 安価な大量解析 | API、Model Vault、クラウドマーケットプレイス | 画像 | $1.50 / 1,000 ページ |
| GPT-5.5 | 84.4 | 最も雑然とした文書、最高精度 | API | 画像、PDF(LLM 経由) | トークン単位 |
| Opus 4.8 | 84.3 | 最高精度、長いコンテキスト | API | 画像、PDF(LLM 経由) | トークン単位 |
| Gemini 3.5 Flash | 81.8 | 安価な最先端級の解析 | API | 画像、PDF(LLM 経由) | トークン単位 |
| LlamaParse | 78.3 | コード主体の RAG パイプライン | API / クラウド | PDF、Office、画像 | ページあたりのクレジット |
| Mistral OCR 4 | 74.5 | 自前ホストもできるページ単位 API | API、自前ホスト | 画像、PDF | $4 / 1,000 ページ |
| Databricks AI Parse | 72.4 | レイクハウスを使うチーム | Databricks 内 | PDF、画像 | DBU |
| Azure Document Intelligence | 69.3 | 構造化フォーム、構築済みモデル | Azure | PDF、画像 | 1,000 ページあたり |
| AWS Textract | 53.3 | AWS ネイティブ、規制対応のスタック | AWS | PDF、画像 | 1,000 ページあたり |
| Unstructured | ParseBench には未掲載 | オープンな取り込み、多様なファイル形式 | API、オープンソース | 25 種類以上のファイル形式 | ページ単位 / オープンソース |
表の読み方について一言。ParseBench のスコアが低いことが、そのままあなたにとって「悪い」わけではありません。Textract はこの汎用ベンチマークでは最下位ですが、AWS 環境で標準的な PDF からきれいなテキストを取り出すだけなら、十分に妥当な選択です。順位表ではなく、仕事に合わせてツールを選びましょう。
1. LlamaParse
向いている用途: コードで RAG パイプラインを組み、すでに LlamaIndex のエコシステムにいるチーム。
LlamaParse は、自社データに対する LLM アプリを作る人気のオープンソースフレームワーク LlamaIndex の解析サービスです。Parse が狙うのとまさに同じ仕事、つまり複雑な PDF、スライド、スプレッドシートを、検索用にチャンク化しやすいきれいな Markdown に変えることを目的に作られています。ParseBench では Cost Effective プランが 78.3 で、Parse の 79.2 とほぼ互角です。
機能。 LlamaParse は PDF、Office ファイル、画像を直接受け付け(画像変換のステップは不要)、コストと深さのバランスを取る複数の解析モードを備え、LlamaIndex の検索パイプラインにそのまま組み込めます。表、埋め込み画像、複数段組みのレイアウトを扱え、ドキュメントごとに自然言語の解析指示にも従えます。
長所。 すでに Python を書いて LlamaIndex を使っているなら、このリストで最も手間の少ない選択肢です。PDF と Office の直接サポートでエンジニアリングの時間を実際に節約でき、毎月 10,000 クレジットが無料なので、お金をかける前に試作しやすいです。
短所。 開発者向けのツールで、ポイント&クリックの製品ではありません。解析モードごとに1ページあたりの消費クレジットが違うため、クレジットモデルは理解に少し時間がかかります。そして検索と回答の層は引き続き自分で組み立てる必要があります。
料金。 LlamaParse はクレジット課金です。1,000 クレジットが $1.25 で、基本の解析は1ページ1クレジットから始まります(レイアウトを考慮する Agentic モードはそれ以上)。無料プランには月 10,000 クレジットが含まれ、Auto Mode が各ページを、仕事をこなせる最も安いティアに振り分けます。
総評: コードで RAG を組み、残りのスタックにぴたりとはまる解析がほしいなら自然な選択です。LlamaIndex の世界にまだいないなら、エコシステムへの囲い込みは他を見る理由になります。
2. Mistral OCR
向いている用途: Parse のシンプルなページ単位 API の使い勝手を別のベンダーで得たい、自前ホストの道も欲しいチーム。
Mistral OCR は、思想の面で Cohere Parse に最も近い存在です。専用の高スループット OCR モデルを、すっきりしたページ単位の API として売っています。Mistral はこれを、表や画像を保ったまま構造化 Markdown を返すドキュメント理解として位置づけており、自分で動かすこともできるモデルです。ParseBench では Mistral OCR 4 が 74.5 で、Parse より一段下ですが、クラウドネイティブの多くの選択肢よりは上です。
機能。 画像と PDF を直接扱い、表や埋め込み図を抽出し、幅広い言語に対応し、後工程のインデックス化向けに作られた Markdown を返します。Mistral は、ドキュメントを自社インフラ内に置きたいチーム向けに、自前ホストのデプロイも提供しています。
長所。 OpenAI 形式の API を呼んだことがあれば、速くてきわめて簡単に組み込めます。自前ホストの選択肢は、マネージドのみの Parse のエンドポイントに対する本当の差別化ポイントで、欧州データレジデンシーは EU のコンプライアンス要件があるチームに響きます。
短所。 ParseBench では Parse や最先端モデルに劣り、特にセマンティックな書式で差が出ます。また、現行モデルは初代ほどの価格のお得感はありません。最も密度の高い財務文書や科学文書では、精度の差が、たまに表が崩れるという形で現れることがあります。
料金。 現行の Mistral OCR 4 は 1,000 ページあたり $4 で、バッチ API なら 1,000 ページあたり $2 に下がります。ノーコードの Document AI 層は 1,000 ページあたり $5 です。Parse の一律 $1.50 より高いため、乗り換えるとページあたりのコストは少し上がります。
総評: Parse の考え方は気に入ったが、第二の調達先、EU データレジデンシー、自前ホストの道がほしいなら、Mistral OCR が最も直接的な乗り換え先です。ただし、精度を数ポイント手放し、ページあたりの支払いも少し増えることは承知しておいてください。
3. GPT-5.5
向いている用途: ページあたりの費用より精度が重要な、最も雑然としていて価値の高いドキュメント。
専用に作られたパーサーを使う必要はまったくありません。GPT-5.5 のような最先端のマルチモーダルモデルは、ページ画像を読んで構造化テキストを返せます。ParseBench の表全体で 84.4 とトップで、Parse を 5 ポイント以上上回っています。Cohere 自身も、Parse は「最先端 LLM にしか上回られない」と認めており、GPT-5.5 はその1つです。
機能。 汎用モデルである GPT-5.5 は、単に書き起こすだけでなく、ページについて推論します。特定のフィールドの抽出、複雑な書式ルールへの対応、見たことのないレイアウトの処理を、すべて1回の呼び出しで頼めます。画像を読み、API 経由なら PDF も読めます。
長所。 ベンチマークで最高の精度と、比類のない柔軟性。固定スキーマのパーサーが詰まるような変わったレイアウトでも、LLM ならたいていうまく処理します。おそらくすでに他の場所で使っているのと同じモデルなので、新しいベンダーも不要です。
短所。 コストです。トークン単位で支払い、密度の高いページはトークン数が多くなるため、数百万ページになると、Parse のページ単位の一律料金と比べてすぐに高くなります。ページあたりの処理も遅く、汎用モデルは、特化型 OCR モデルより内容を作り出して(ハルシネーション)しまうことがあります。
料金。 トークン単位で、入力と出力の両方に課金されるため、ページあたりの固定額ではなくページの複雑さに応じてコストが変わります。OpenAI の現行フラッグシップ GPT-5.6 Sol は、プロモーション価格で入力 100 万トークンあたり $4、出力 100 万トークンあたり $20 で、軽い用途向けにはより安い兄弟モデル(Luna は $0.20 / $1.20)があります。密度の高いページは大量のトークンを消費するため、数百万ページでは積み上がります。
総評: ドキュメントが高価値で少量の場合や、レイアウトが多様すぎて固定パーサーでは対応しきれない場合は GPT-5.5 を選びましょう。大量で予測しやすいページなら、トークン課金のせいで、Parse のような専用パーサーのほうが賢い買い物になります。
4. Gemini 3.5 Flash
向いている用途: 最先端モデルの価格までは払わず、最先端級の解析精度がほしいチーム。
Gemini 3.5 Flash は Google の高速で安価なマルチモーダルモデルで、このリストの両極端の中間にあるおいしいポイントです。ParseBench で 81.8 を記録し、Parse とあらゆるクラウドネイティブのパーサーを上回りつつ、GPT-5.5 や Opus 4.8 のようなフラッグシップよりトークン単価がはるかに安くなっています。
機能。 GPT-5.5 と同様、ページ画像と PDF を読み、指示に応じて構造化データを抽出できる汎用モデルです。Flash は速度と低コストに調整されており、大きなコンテキストウィンドウで長い文書を一度に渡せます。
長所。 珍しい組み合わせです。Parse より高い精度と LLM の柔軟性を兼ね備え、規模が大きくなっても妥当な価格に収まります。すでに Google Cloud や Vertex AI を使っているなら、統合は簡単です。
短所。 依然としてトークン課金なので、ページ単位の一律料金のパーサーより予測しにくく、本当に膨大な量では、総コストで Parse の 1,000 ページあたり $1.50 が勝つこともあります。どの LLM でも同じで、特化型 OCR モデルにはない、わずかなハルシネーションのリスクを負います。
料金。 トークン単位で、Flash の低い料金です。現行の Gemini 3.7 Flash はプロモーション価格で入力 100 万トークンあたり $0.75、出力 100 万トークンあたり $3.75 で、試作用にはレート制限付きの本当の無料枠もあります。フラッグシップモデルのトークン費用のほんの一部です。
総評: Parse より精度がほしいが、フラッグシップの価格には尻込みするチームへの、私の第一のおすすめです。Flash は最先端モデル群のなかで、コスパのよい選択です。
5. Databricks AI Parse
向いている用途: ドキュメントがすでに Databricks レイクハウスにあるデータチーム。
Databricks AI Parse(ai_parse_document)は Databricks プラットフォームに直接組み込まれたドキュメント解析で、すでにレイクハウスにあるデータに対して SQL 関数として呼び出せます。ParseBench では 72.4 です。売りは最高の精度ではなく、データ移動がゼロであることです。
機能。 SQL やノートブックのワークフロー内で解析をインラインで呼び出し、抽出されたテキストはそのまま Delta テーブルに戻り、後続のナレッジマネジメントや分析に使えます。別サービスは不要で、データがプラットフォームの外に出ることもありません。
長所。 パイプラインがすでに Databricks 上にあるなら、最も抵抗の少ない道です。新しいベンダーも、データの持ち出しも不要で、ガバナンスは Unity Catalog が担います。ドキュメント解析を他のデータエンジニアリングと統合する点では、これほどシームレスなものはありません。
短所。 Databricks を使っている組織でなければ意味がなく、ドキュメントを解析するためだけにプラットフォームを立ち上げるのは馬鹿げています。また 72.4 では、一般的な解析品質で Parse と最先端モデルに劣ります。
料金。 公開されたページ単価ではなく、通常の計算利用の一部として DBU(Databricks Units)で課金されます。Databricks の料金ページと、お使いのワークスペースの料金をご確認ください。
総評: 精度の最後の数ポイントを絞り出すより、データをその場に置いておくことを重視する既存の Databricks チームには、迷わずおすすめです。それ以外の人には無関係です。
6. Azure AI Document Intelligence
向いている用途: フォーム、請求書、身分証明書から、構築済みモデルで構造化抽出をしたい Azure チーム。
Azure AI Document Intelligence(旧 Form Recognizer)は、Microsoft の成熟したドキュメント処理サービスです。ParseBench では 69.3 ですが、この汎用スコアは本当の強みを過小評価しています。請求書、領収書、税務フォーム、身分証明書などの特定の文書タイプから、何も学習させずに構造化フィールドを取り出す構築済みモデルです。
機能。 通常のテキスト OCR(Read モデル)に加え、一般的なビジネス文書向けの構築済み抽出器と、数点のサンプルで独自モデルを学習させるカスタムモデルのワークフローを備えています。PDF と画像を直接受け付け、フィールドごとの信頼度スコア付きで構造化 JSON を返します。これは Parse のライブエンドポイントが現在出力しないものです。
長所。 構造化フォームでは、汎用の解析より一段上です。請求書を読むだけでなく、合計、取引先、支払期日を、信頼度付きのラベル付きフィールドとして返します。Azure との深い統合とエンタープライズ向けのコンプライアンスにより、Microsoft 環境では導入しやすいです。
短所。 RAG 向けのきれいな Markdown というより、フォームのフィールド抽出に重点があるため、一般的なドキュメントからテキストへの変換では、新しいパーサーに後れを取ります。信頼度スコアや構築済みモデルは、テキストだけがほしい場合には不要な設定の手間を増やします。
料金。 モデルの種類ごとに 1,000 ページあたりで課金されます。Read OCR モデルは 1,000 ページあたり $1.50(Parse と同額)、構築済みモデルは $10、カスタム抽出は $30 です。無料の F0 ティアで月 500 ページまで対応します。
総評: 本当の課題が、一般的な解析ではなく既知のフォームからの構造化抽出で、すでに Azure を使っているなら最良の選択です。RAG のインデックスに流し込むきれいな Markdown が目的なら、新しいパーサーのほうが合います。
7. AWS Textract
向いている用途: 既存のクラウド内でドキュメント OCR を行いたい、AWS ネイティブのチームや規制対応のスタック。
AWS Textract は、Amazon の長年の OCR・ドキュメント分析サービスです。ParseBench の汎用表では 53.3 で最下位にあり、Cohere はこれに対して「20 ポイント以上の改善」を報告しているため、最先端の Markdown 品質を求めて Textract を選ぶ人はいません。すでに AWS アカウントにあるから選ぶのです。
機能。 Textract はテキスト、表、フォームのキーと値のペアを検出し、経費や身分証明書向けの専用 API もあります。PDF と画像を受け付け、S3、Lambda など AWS の各サービスとネイティブに統合され、AWS のコンプライアンス認証もそのまま引き継ぎます。
長所。 AWS 環境にとって、統合とガバナンスの面では他の追随を許しません。新しいベンダーもデータの持ち出しも不要で、すでに信頼している IAM と監査ログが使えます。エンタープライズ規模で実績があり、きれいな標準文書での表とフォームの抽出は信頼できます。
短所。 現代的なベンチマークでは大きく後れを取っており、特にセマンティックな書式(そこでは 2.8)で顕著です。ビジョン言語モデルではなく旧世代の OCR エンジンなので、雑然とした、あるいは珍しいレイアウトでは、新しいツールが対応できるところで苦戦します。
料金。 API ごとに別々の 1,000 ページあたりの料金です。単純な Detect Text は 1,000 ページあたり $1.50 ですが、Analyze Document は表で $15、フォームで $50 に跳ね上がるため、構造化フィールドの抽出はすぐに高くつきます。新規アカウントには3か月間の無料枠があります。
総評: 標準的なドキュメントを解析し、ベンチマークのスコアよりクラウド内にとどまることを重視する AWS ネイティブのチームにとって、無難で退屈で、正しい選択です。難しいレイアウトでの解析品質がボトルネックなら、このリストのもっと上を見てください。
8. Unstructured
向いている用途: 幅広いファイル形式を1つのきれいなパイプラインに取り込む必要があり、オープンソースの選択肢もほしいチーム。
Unstructured は、単一の OCR モデルというより、取り込み層全体です。25 種類以上のファイル形式(PDF、Word、PowerPoint、HTML、メール、画像)を受け取り、エンベディングに向いたきれいなチャンク化済みの JSON に正規化します。役割が少し違うため ParseBench には載っていません。PDF だけでなく、あらゆるものをベクトルストアに送り込む配管にあたります。
機能。 数十のソースへのコネクタ、膨大な入力フォーマット、レイアウトを考慮したチャンク化、そしてマネージド API と並ぶ有名なオープンソースライブラリ。単一目的のパーサーが無視するロングテールのファイル形式を扱えるため、自作の RAG スタックでよく使われます。ナレッジマネジメントが十数個のアプリに散らばっているなら、これが重要になります。
長所。 幅広さです。知識が PDF、Confluence のエクスポート、メール、スライドに分散していても、Unstructured は1つのパイプラインですべて扱います。オープンソースのコアがあるので、無料で始めて自前でホストできます。
短所。 複雑なドキュメントでの素の OCR 品質は最高クラスではないため、難しい PDF には、より強力なパーサーと組み合わせて使うチームが多いです。また、オープンソース版を大規模に運用するのは本格的なエンジニアリング作業で、マネージドの手軽さはありません。
料金。 オープンソースライブラリは無料で自前ホストでき、マネージドの Unstructured Platform はページ単位で課金されます。現在の API 料金は同社のサイトでご確認ください。
総評: 課題が、1つの形式での素の解析精度ではなく形式の多様さなら、最良の選択です。幅広さには Unstructured、難しい文書には Parse や Gemini のようなモデル、という使い分けをするチームが多いです。
オープンウェイトパーサーについて
データ管理が目的なら、この分野で最も動きが速いのは、自前でホストするオープンウェイトの OCR モデルです。dots.ocr、Chandra OCR 2、DeepSeek-OCR 2 などはいずれも ParseBench に載っています(Chandra OCR 2 は立派な 77.7)。dots.ocr は MIT ライセンスで、vLLM 経由でローカルに動かせるため、取引はわかりやすいです。ページ単位の料金は永久にかからず、ドキュメントをどこで処理するかを完全に管理できる代わりに、GPU と運用を自分で抱えます。エアギャップ環境や厳しく規制された環境では、この取引が見合うことが多いです。それ以外の人には、マネージド API のほうが手間がかかりません。
このリストのどのツールも、あなたに作らせるもの
パーサーを比べているときに見落としがちな点です。上のどの選択肢も、Parse も含めて、1つの仕事しかしません。ドキュメントをきれいなテキストに変えることです。そのテキストは答えではありません。ドキュメントを実際に使うには、テキストをチャンク化してエンベディングし、保存し、質問に応じて適切な箇所を検索し、その上に根拠のある回答を生成する必要があります。
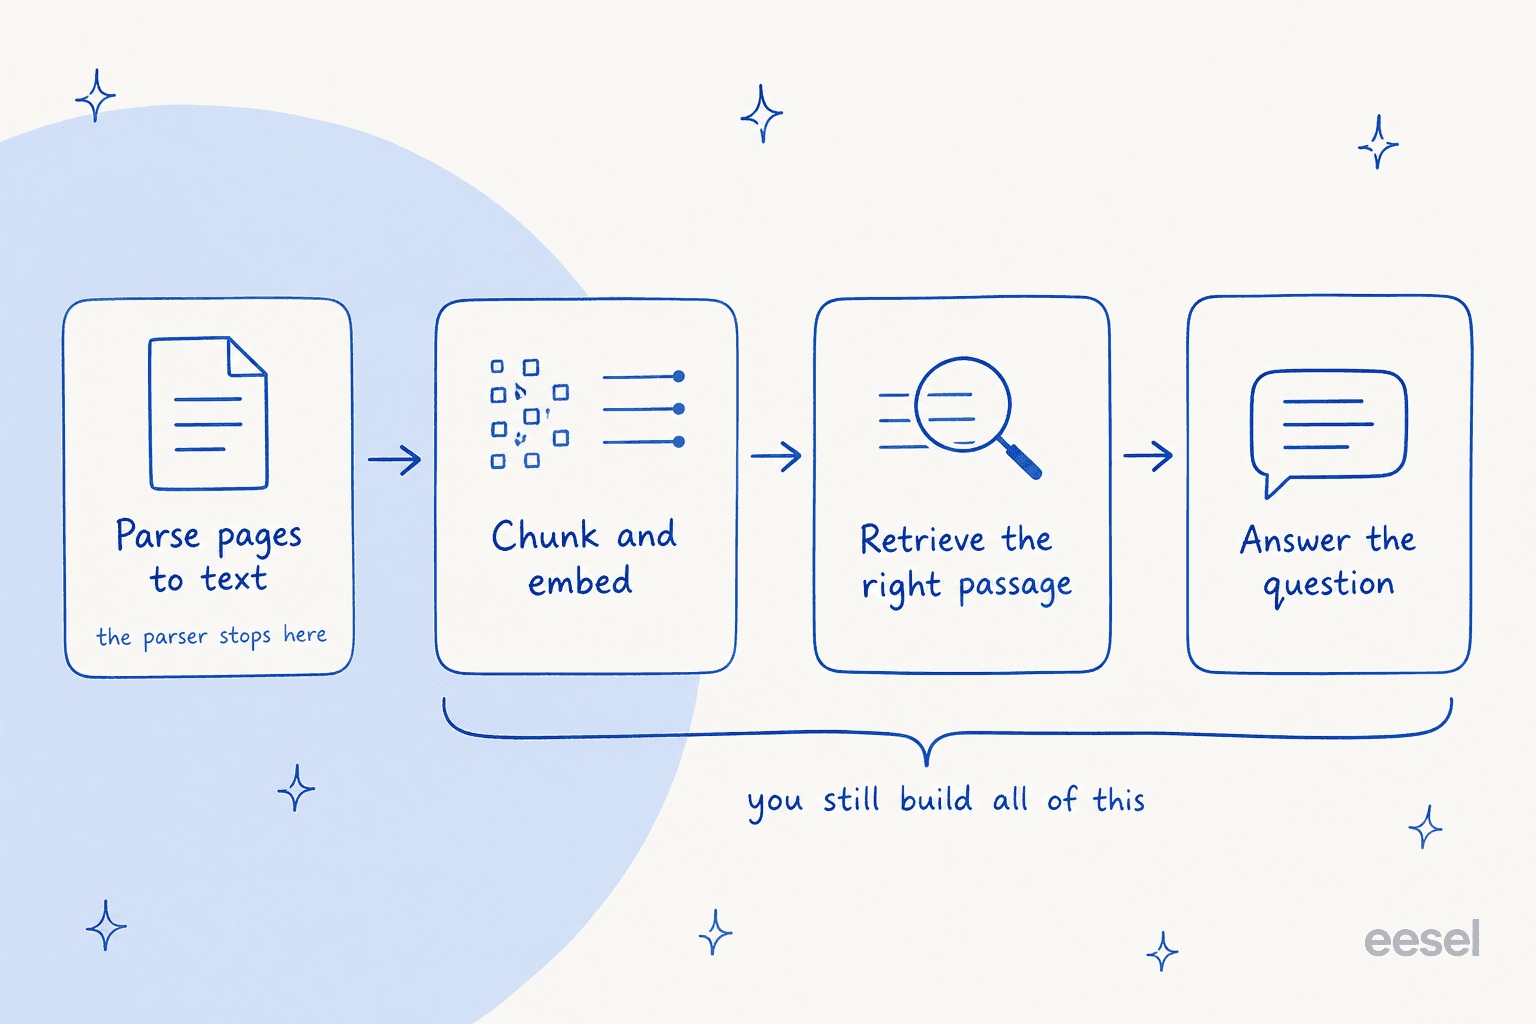
カスタムプロダクトを作るデータチームなら、その4段階をつなぐのはまさに引き受けた仕事で、このリストから適切なパーサーを選ぶのは本物の意思決定です。しかし、「Cohere Parse 代替」で検索する人の多くは、パーサーのパイプラインそのものを作りたいわけではありません。ほしいのは結果、つまり自分のドキュメントから引き出した、顧客や従業員の質問への回答です。彼らにとって OCR モデルを選ぶことは、チェーンの3ステップ先にある目的のための手段にすぎません。
eesel を試す
その隙間を埋めるのが eesel です。eesel は AI チームメイトのプラットフォームです。自分で組み立てるツールキットではなく、特定の仕事に向けて、すぐ働けるチームメイトを採用します。ここで関係するのは AI ヘルプデスクエージェントで、カスタマーサービス向け AI エージェントとして、ヘルプセンター、社内ドキュメント、過去のチケットを取り込み、解析、エンベディング、検索を代わりに行い、ヘルプデスク上でそのまま質問に回答します。

正直に言えば、こういうことです。ドキュメントのパイプラインを作っていて、部品の1つとしてパーサーが必要なら、上の8つから選んでください。本当の目的が自社の知識から質問に答えることなら、OCR モデルを選ぶ必要はまったくなく、その上に乗る層が必要です。eesel は無料で試せ、数分で接続でき、既存のドキュメントを指定して、何かを決める前に回答する様子を確認できます。(チームには、まったく別の仕事をする AI ブログライターのチームメイトもいます。)