

Ein KI-Sprachagent für den Kundensupport nimmt Telefonanrufe selbstständig an: Er transkribiert, was der Anrufer sagt (Speech-to-Text), denkt mit einem LLM über Ihr Wissen und Ihre Systeme nach und antwortet dann per Sprache (Text-to-Speech), alles in etwa einer Sekunde. Das Schwierige ist nicht die KI, sondern die Echtzeit-Infrastruktur. Anrufer bemerken Verzögerungen ab 800 ms, der gesamte Durchlauf steht also unter Zeitdruck.
Bei den Kosten wird Sprache pro Minute abgerechnet. Schlüsselfertige Plattformen liegen bei den meisten Support-Anrufen im Bereich von 0,07 bis 0,16 $ pro Minute vor der Telefonleitung, ein 5-Minuten-Anruf kostet also grob 0,35 bis 0,80 $ plus Telefonie.
Was ich mir bei jedem Rollout auf den Arm tätowieren würde: Sprach-KI funktioniert, wenn sie an einen Menschen weiterleitet, und scheitert, wenn sie einen ersetzen will. Ich setze seit Jahren KI in Live-Support-Warteschlangen ein, und die wichtigste Lehre lautet: Sicherheit vor Abdeckung. Lassen Sie den Agenten übernehmen, wobei er sicher ist, und geben Sie den Rest ab. Diese Lehre gilt kanalübergreifend. Deshalb lohnt es sich, den Ansatz des KI-Helpdesk-Agenten, der Ihre Chats und Tickets löst, richtig hinzubekommen, bevor Sie eine Telefonleitung anschließen.
Was ein KI-Sprachagent wirklich ist
Ohne das Marketing ist ein KI-Sprachagent ein System, das den Hörer abnimmt, einen Anrufer in natürlicher Sprache versteht, die Arbeit erledigt und antwortet, bei den meisten Anrufen ohne einen Menschen in der Leitung. Das dominierende Design verkettet drei spezialisierte Modelle: Speech-to-Text (STT), ein großes Sprachmodell (LLM) zum Denken und Text-to-Speech (TTS), alles auf einer Telefonieschicht, die den eigentlichen Anruf verbindet. Twilio nennt das die kaskadierte Sprachagenten-Architektur, bei der "the user's speech is transcribed, the transcript is processed by an LLM, then the resulting tokens are synthesized into audio."
Eine neuere Variante fasst diese Kette in einem einzigen Modell zusammen. Die Realtime API von OpenAI arbeitet direkt Sprache-zu-Sprache, was "reduces latency, preserves nuance in speech, and produces more natural, expressive responses."
Zwei Vergleiche machen es greifbar:
- Es ist nicht das alte Telefonmenü. "Drücken Sie 1 für Abrechnung" (IVR) versteht nur Tastentöne oder ein paar vorgegebene Wörter und schickt jeden Anrufer durch dasselbe starre Menü. Ein Sprachagent lässt den Anrufer das Problem in eigenen Worten beschreiben und leitet von dort weiter oder löst es.
- Es ist der Sprach-Verwandte eines Text-Chatbots, nur auf einem viel schwierigeren Medium. Chat läuft rundenbasiert und verzeiht ein bis zwei Sekunden Verzögerung. Sprache ist synchron und in Echtzeit, und dieser Unterschied ist die gesamte technische Herausforderung. Wenn Sie schon über den Unterschied zwischen einem KI-Agenten und einem regelbasierten Chatbot gelesen haben: Das ist derselbe Sprung, plus ein Echtzeit-Audioproblem obendrauf.
So funktioniert ein KI-Sprachagent, Schritt für Schritt
Hier der gesamte Weg eines Support-Anrufs, vom Klingeln bis zur Antwort.
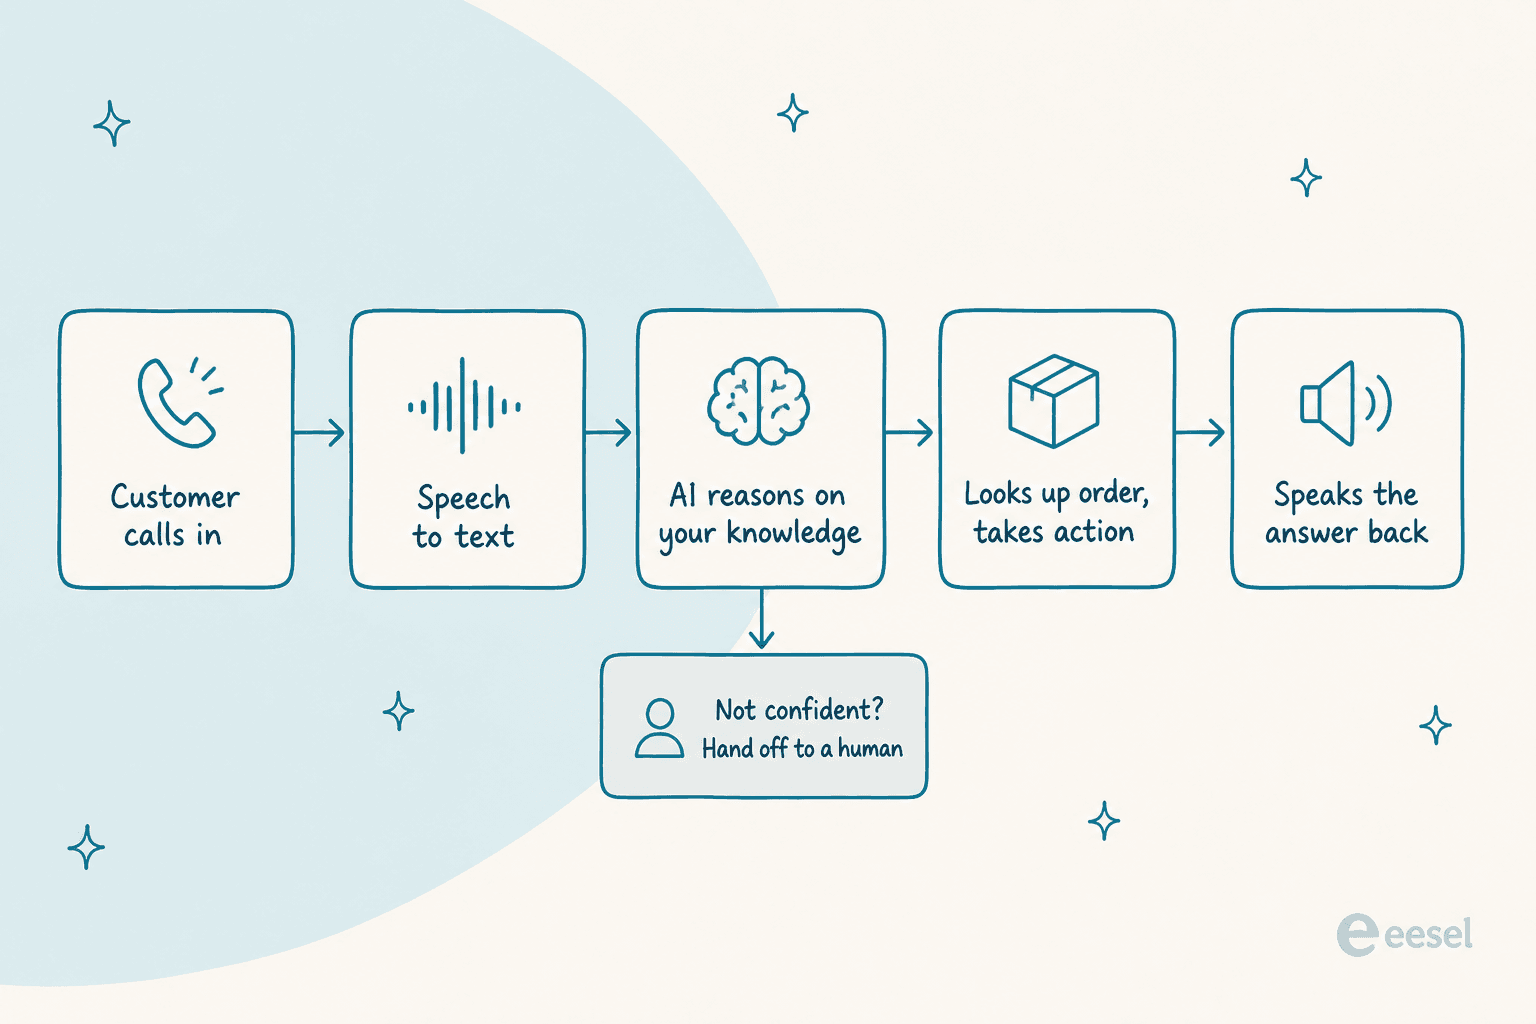
Telefonie (die Telefonleitung). Der Anruf kommt über das Telefonnetz (PSTN) oder eine SIP-Verbindung an. Twilio stellt das als <ConversationRelay>-Element bereit, das "handles the complexities of live, synchronous voice calls," und OpenAI hat seiner Realtime API kürzlich Telefonie über SIP hinzugefügt.
Speech-to-Text. Das Audio des Anrufers wird live transkribiert. Das wirklich Schwierige ist hier nicht die Erkennung, sondern das Endpointing: zu wissen, wann der Anrufer wirklich fertig gesprochen hat, denn eine kurze Pause mitten im Satz "can sound identical to an end-of-turn pause." Gute Systeme führen zwei Transkript-Puffer, eine vorläufige Vermutung und ein festgeschriebenes Protokoll, damit sie früh mit dem Denken beginnen und später korrigieren können.
LLM plus Wissensabruf. Das Transkript geht an ein LLM, das herausfindet, was der Anrufer braucht, und fundierte Antworten aus einer Wissensdatenbank zieht, statt zu raten. Der Referenzaufbau von AWS verbindet Amazon Connect, Lex und Bedrock Knowledge Bases, sodass der Agent aus abgerufenen Unternehmensinhalten antwortet. Dieser Abrufschritt ist derselbe Grund, warum ein guter Text-Agent auf Ihrer Wissensdatenbank trainiert sein muss, bevor er ein Wort sagt.
Aktionen in Geschäftssystemen. Ein Produktivagent redet nicht nur, er ruft Tools auf: eine Bestellung nachschlagen, einen CRM-Eintrag prüfen, ein Ticket anlegen. gpt-realtime von OpenAI hat Unterstützung für Remote-MCP-Server bekommen, sodass Sie eine Sitzung auf eine Reihe von Tools richten können, und lange Aufrufe asynchron gemacht, damit "the model can continue a fluid conversation while waiting on results."
Text-to-Speech. Die Worte des Modells werden als synthetisierte Sprache zurückgestreamt. Flux TTS von Deepgram verschränkt Text- und Audioerzeugung, sodass die Antwortlänge die Latenz bis zum ersten Audio nicht erhöht, mit erstem Audio "as low as 80ms."
Diese letzte Zahl deutet die eigentliche Geschichte an. Jede dieser Stufen läuft gegen die Uhr, darum geht es im nächsten Abschnitt.
Warum Sprache so viel schwieriger ist als ein Chatbot
Wenn Sie einen Text-Agenten gebaut haben, ist Ihr Instinkt: Sprache ist "dasselbe, nur gesprochen." Das stimmt nicht. Sprache bringt Echtzeit-Einschränkungen mit, die Chat schlicht nicht kennt.
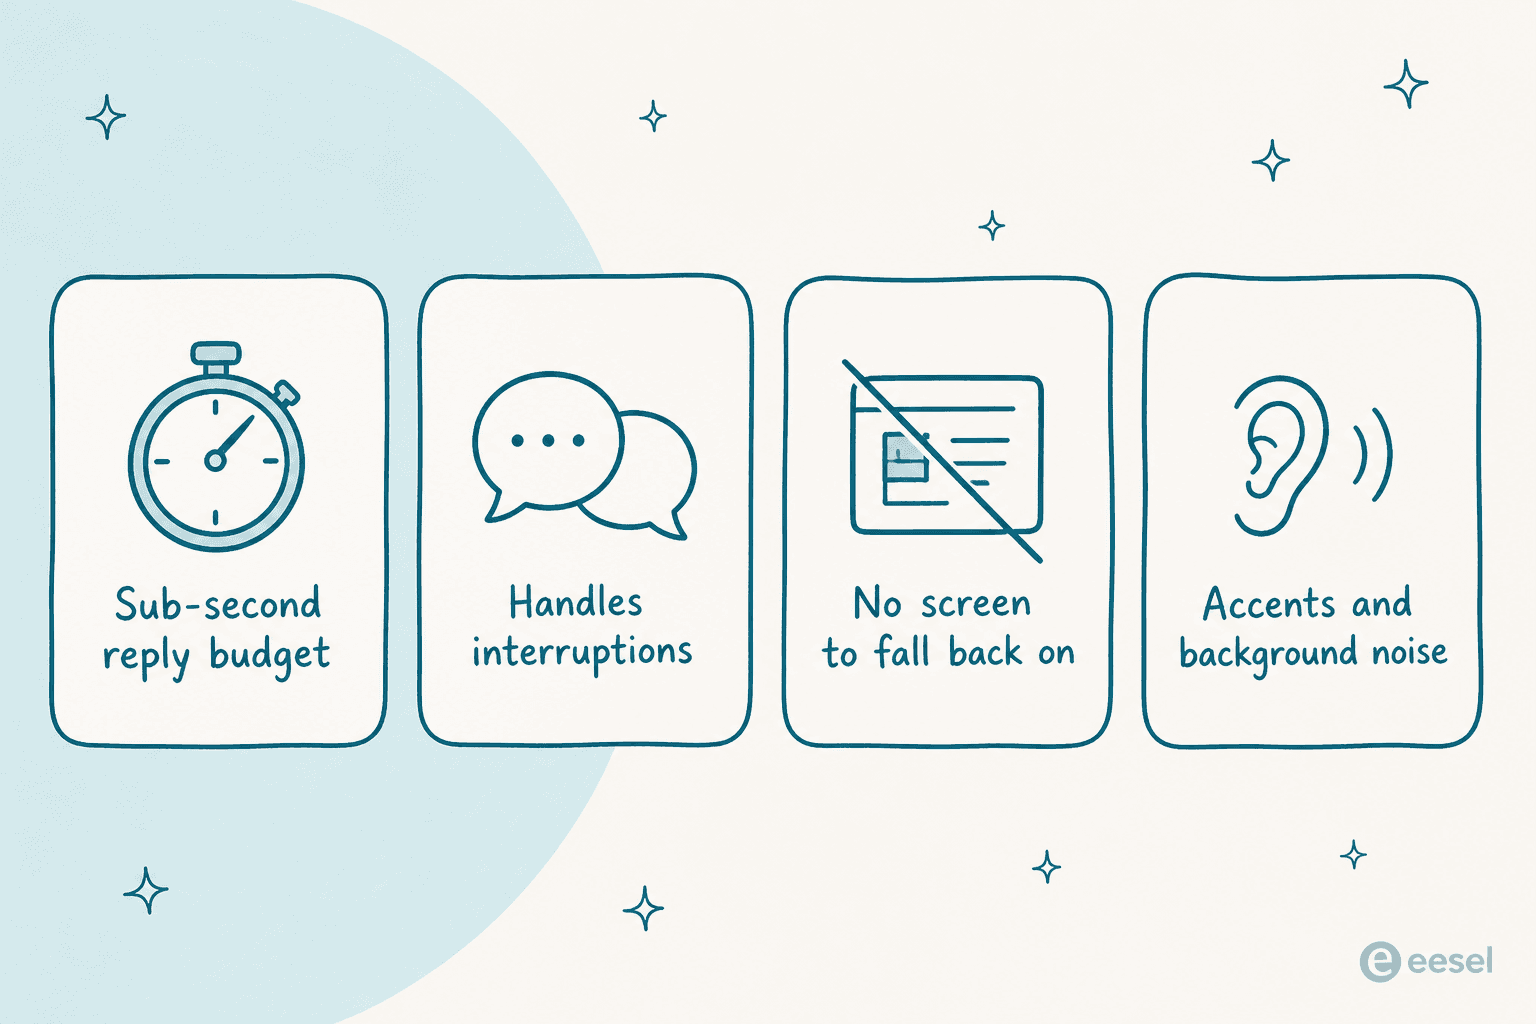
Die Uhr ist das Größte. Twilio definiert in seinen eigenen, Ende 2025 veröffentlichten Startzielen die Latenz als "mouth-to-ear turn gap" und setzt ein Ende-zu-Ende-Ziel von 1.115 ms mit einer Obergrenze von 1.400 ms. Dieses Budget wird nicht an einer Stelle verbraucht. Es summiert sich grob auf STT 350 ms, LLM 375 ms, TTS 100 ms, plus Netzwerk und Pufferung, und weil sich diese Werte aufaddieren, können "acceptable numbers at each stage can still sum to a broken conversation." Deepgram setzt die Wahrnehmungsschwelle noch enger: Anrufer "start noticing lag near 800ms of total round-trip time."
Dazu kommt alles, was ein Anrufer tut und ein Chat-Nutzer nie. Sie unterbrechen. Dieses "Barge-in" zu behandeln heißt, die laufende Antwort sofort abzubrechen, wenn der Anrufer einsetzt. Deshalb liefert die Agenten-API von Deepgram eine integrierte Barge-in-Erkennung und Vorhersage des Sprecherwechsels mit. Sie rufen auch von lauten Orten an, mit Akzenten und ohne Bildschirm als Rückfallebene. Es gibt also kein "Klicken Sie auf die Schaltfläche unten", wenn der Ton unklar ist.
Ein Entwickler, der eine Sprachschleife von Grund auf neu gebaut hat, traf die Schwierigkeit genau dort, wo sie hingehört:
"The hard part isn't STT, LLMs, or TTS in isolation, but turn-taking: detecting when the user starts and stops speaking, cancelling in-flight generation instantly, and pipelining everything to minimize time-to-first-audio... By colocating Twilio, Deepgram, ElevenLabs, and the orchestration layer, I reached ~790ms end-to-end latency."

Die Modelle sind fairerweise wirklich gut geworden. gpt-realtime erreicht 82,8 % im Big-Bench-Audio-Reasoning-Test, gegenüber 65,6 % beim Modell von OpenAI Ende 2024, und es erfasst nonverbale Signale wie Lachen und wechselt mitten im Satz die Sprache. Die Intelligenz ist meist nicht das, woran eine Sprach-Demo scheitert. Es ist die Infrastruktur drumherum.
Was ein KI-Sprachagent wirklich kostet
Hier der Teil, den die meisten Anbieterseiten verstecken: Sprach-KI wird pro Gesprächsminute abgerechnet, und der Minutenpreis in der Überschrift ist fast nie die ganze Rechnung. Je nach Anbieter kommen Telefonie (die Telefonleitung), STT, das LLM und TTS obendrauf, mal gebündelt, mal "zum Selbstkostenpreis" durchgereicht, mal als einzelne Posten, die Sie selbst zusammensetzen.
Drei Preismodelle dominieren:
- Alles inklusive pro Minute (Bland, Retell, ElevenLabs Agents): ein gemischter Satz, der STT, LLM und TTS schon enthält. Einfacher, meist mit etwas höherem Listenpreis.
- Plattformgebühr plus Durchreichung (Vapi): eine geringe Orchestrierungsgebühr pro Minute, dann zahlen Sie STT, LLM und TTS zum Selbstkostenpreis. Niedrigste Untergrenze, die meisten beweglichen Teile.
- Komponente oder Infrastruktur (Twilio, Deepgram, OpenAI, Amazon Connect): Sie kaufen eine Schicht und verdrahten den Rest selbst.
| Anbieter | Plan / Stufe | Veröffentlichter Preis | Was enthalten ist | Durchgereicht oder extra |
|---|---|---|---|---|
| Bland AI | Start (dev) | $0.14 / min | LLM, STT, TTS alle gebündelt, "no model pass-throughs" | Eingehende Nummer ca. 15 $/Monat; 0,05 $/Transfer-Minute |
| Retell AI | Pay-as-you-go | $0.07-$0.31 / min (~$0.115 Mittelwert) | Sprachinfrastruktur + LLM + TTS gemischt | 10 $ Startguthaben; Telefonie ca. 0 $ bei eigener Anbindung |
| Ringly | Abrechnung pro Gespräch | 99 $/Monat inkl. 50 Gespräche; danach 1,99 $/Gespräch | Shopify-verbundener KI-Telefonsupport | Anrufe, bei denen Seth vor der Übergabe hilft, sind abrechenbar; individuelle Preise ab 1.000+ Anrufen/Monat |
| Vapi | Build (nutzungsbasiert) | $0.05 / min Plattformgebühr | Nur Vapi-Orchestrierung | STT/LLM/TTS zum Selbstkostenpreis; 10 $/Leitung/Monat ab der 11. |
| Deepgram | Voice Agent API (Standard) | $0.075 / min | Deepgram-Bundle aus STT + LLM + TTS | Eigenes LLM 0,065 $/min; Advanced 0,163 $/min |
| ElevenLabs Agents | Überschreitungspreis | $0.08 / min (Burst $0.16) | TTS + Orchestrierung + Tarifminuten | LLM separat abgerechnet; Telefonie separat |
| Twilio | ConversationRelay | $0.07 / min | Nur KI-Sprachorchestrierung | + PSTN $0.0085-$0.014/min + eigenes STT/LLM/TTS |
| Amazon Connect | Sprache (nutzungsbasiert) | $0.038 / Sprachminute | Contact-Center-Telefonie + Plattform | Telefonie + Amazon Q / Contact Lens Add-ons |
| OpenAI Realtime | gpt-realtime-2.1 | $32 / 1M Audio-Eingabe-, $64 / 1M Audio-Ausgabe-Tokens | Nur das Modell | In der Praxis ca. 0,06-0,24 $/min; keine Telefonie |
Ringly ist eine andere Art von Kauf: ein auf Shopify ausgerichteter Dienst, der pro Gespräch abgerechnet wird, statt Sprachinfrastruktur pro Minute. Das folgende Beispiel gilt für die Plattformen mit Minutenabrechnung.
Ein durchgerechnetes Beispiel macht die Aufschläge greifbar. Sagen wir, Sie haben 2.000 Support-Anrufe im Monat mit durchschnittlich 4 Minuten. Auf einer Alles-inklusive-Plattform zu etwa 0,12 $/min sind das 8.000 Minuten oder rund 960 $ Plattformkosten. Mit einer Twilio-artigen Telefonleitung zu ca. 0,01 $/min liegen Sie bei etwa 1.040 $, plus Nummernmiete und eventuelle Minuten für Weiterleitungen. Günstig pro Anruf, aber es steigt mit dem Volumen, und die längeren, unübersichtlicheren Anrufe (die, die ein Sonderfall erzeugt) sind die teuren.
Ein paar Stolperfallen, die Sie vor dem Unterschreiben einpreisen sollten:
- Telefonie ist fast immer separat, auch bei "Alles-inklusive"-Anbietern. Das ist ein echter Minutenposten plus 1 bis 2 $ pro Nummer, und internationale Tarife liegen deutlich höher.
- "Zum Selbstkostenpreis" durchgereicht heißt nicht gratis. Die Untergrenze von 0,05 $/min bei Vapi ist real, aber STT plus LLM plus TTS zum Selbstkostenpreis summieren sich leicht auf 0,05 bis 0,10 $ und landen im selben Bereich wie die Alles-inklusive-Anbieter.
- Compliance ist ein Zusatz. HIPAA und Zero Data Retention sind bei manchen Plattformen kostenpflichtige Stufen; ein BAA ist oft dem Enterprise-Tarif vorbehalten.
Wenn Ihr Eindruck nach dieser Tabelle ist, dass die Minutenabrechnung schwer vorhersehbar ist, ist das die ehrliche Lesart. Das ist ein Grund, warum die Textkanäle, bei denen eesel monatliche Credit-Pläne mit einem Credit pro Ticket oder Kunden-Chat statt pro Gesprächsminute nutzt, oft leichter zu planen sind. Unsere ausführliche Aufschlüsselung der Kosten von KI-Agent versus menschlichem Agenten rechnet das durch.
Drei KI-Sprachplattformen im Vergleich für den Kundensupport
Die folgenden Optionen decken unterschiedliche Einsatzbedürfnisse ab. Testen Sie jede mit Ihren eigenen Anrufen, angebundenen Systemen und Übergabeanforderungen, bevor Sie sich entscheiden.
1. Bland AI: ein gebündelter Sprach-Stack
Bland AI vereint Sprachmodell, Spracherkennung und Spracherzeugung in seiner Sprachplattform. Es ist eine Option für Teams, die diese Komponenten bei einem Anbieter wollen. Prüfen Sie Gebühren für Telefonnummern und Weiterleitungen zusätzlich zum Plattformpreis.
2. Retell AI: nutzungsbasierte Sprachinfrastruktur
Retell AI bietet Sprachinfrastruktur mit nutzungsbasierter Preisgestaltung. Vergleichen Sie die gesamte benötigte Konfiguration, einschließlich Modell, Stimme und Telefonie, statt den niedrigsten beworbenen Preis als Kosten jedes Anrufs zu behandeln.
3. Ringly: KI-Telefonsupport für Shopify-Shops
Ringlys Seth ist ein KI-Telefonannahmesystem für Shopify-Shops. Es nimmt eingehende Anrufe an, schlägt Bestellungen und Produkte nach, beantwortet Routinefragen zu Retouren und leitet Anrufer bei Bedarf an Ihr Team weiter. Es passt zu E-Commerce-Teams, die einen Sprachagenten mit Shop-Daten verbinden wollen, ohne einen eigenen Sprach- und Telefonie-Stack zusammenzubauen.
Anders als die oben genannten Infrastrukturoptionen mit Minutenabrechnung berechnet Ringly pro Gespräch. Der veröffentlichte Preis beträgt 99 $/Monat für die ersten 50 Gespräche, danach 1,99 $ für jedes weitere abrechenbare Gespräch. Anrufe, bei denen Seth vor der Übergabe hilft, zählen trotzdem; Spam, aufgelegte Anrufe, falsche Nummern und sofortige Wünsche nach einem Menschen nicht. Prüfen Sie, wie diese Regeln auf Ihren Anrufmix zutreffen, bevor Sie die Rechnung schätzen. Der Shopify-Fokus macht es für andere Branchen oder ausgehende Anrufe weniger geeignet.
Was Menschen wirklich über Anrufe bei einer KI sagen
Die Demos zeigen immer dasselbe: ein Anrufer fragt "Wie sind Ihre Öffnungszeiten" und eine KI antwortet souverän. Die Realität ist gemischter, und die Lücke dazwischen ist das Nützlichste, was Sie vor dem Einsatz verstehen sollten.
Wenn es funktioniert, funktioniert es wirklich. Hier beschreibt ein echter Anrufer einen Support-Anruf außerhalb der Geschäftszeiten, kein Anbieter:
"It was after hours, and a dreaded robot voice answered my call. I was fully prepared to spend the next 10 minutes rewording my issue... Surprisingly, this robot understood every single sentence I said... That's the most pleasant customer service call I have ever experienced. I don't mind talking to AI. In fact, instead of a live agent, I actually prefer to talk to your LLM, so my issue can be quickly triaged to the right human who actually understand my situation."
Beachten Sie, was diesen Anruf gut gemacht hat: Er wurde an den richtigen Menschen weitergeleitet. Das ist das Muster. Hier nun der Fehlerfall, von einem Anrufer, der in einer Abwehr-Sackgasse landete:
"One (recently) even told me, after wandering through the menu options, that they were going to text me a link to their app - and then hung up on me. I already tried the app, their system was broken - that's why I was trying to call and talk to a human!"
Und die schärfste Formulierung des Kernkonflikts, die man zweimal lesen sollte:
"The problem with the call center A.I. is that almost every time I need to call somewhere that uses them, I have some kind of edge case. They always give examples of how the automated agent can handle simple queries like 'what's my balance'... but I never need to call with something straightforward like that."
Das ist das ganze Spiel in einem Kommentar. Menschen rufen nicht wegen der einfachen Dinge an, sondern wegen des Sonderfalls, und ein Agent, der nicht sauber zugeben kann "das ist etwas für einen Menschen", macht aus einem Support-Kanal eine Mauer.
Was alle falsch machen: Sicherheit vor Abdeckung
Der Fehler, den ich bei Teams immer wieder sehe: Sie optimieren darauf, wie viel der Sprachagent beantworten kann, statt darauf, wie gut er weiß, wann er es nicht tun sollte. Im Live-Gespräch ist eine selbstsichere falsche Antwort schlimmer als eine schnelle Übergabe, weil der Anrufer danach handelt und Sie es erst später erfahren.
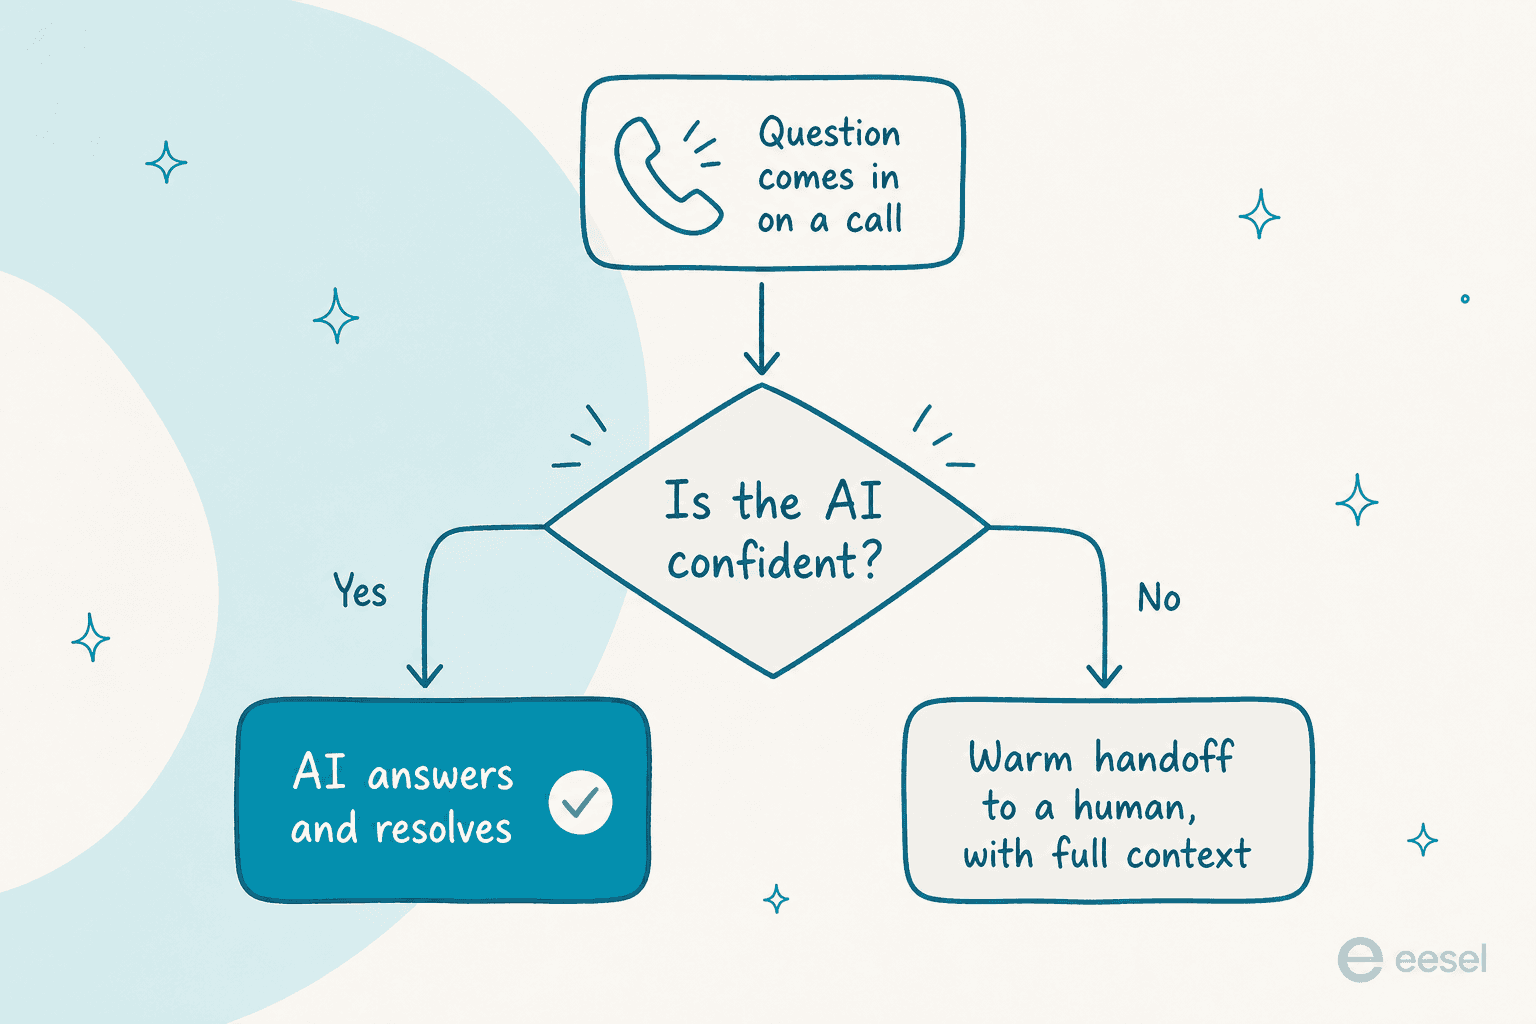
Das ist keine Sprach-spezifische Idee, sondern die Lehre aus Jahren mit KI in Live-Support-Warteschlangen über alle Kanäle hinweg. Einer unserer Kunden, ein CX-Leiter bei einer DTC-Nahrungsergänzungsmarke, hat es besser formuliert als jede Pitch-Präsentation:
"The AI will never be able to answer 100% of the questions. I need an AI who is only handling the tickets that it's confident to handle, and all the other ones, leave them alone."
Das ist das Designprinzip. In der Praxis bedeutet es drei Dinge, ob der Kanal Sprache oder Text ist:
- Verankern Sie jede Antwort in Ihrem echten Wissen, damit der Agent aus Ihrem Help Center und früheren Lösungen abruft, statt zu improvisieren. So verhindern Sie, dass er bei Support-Fragen halluziniert.
- Setzen Sie eine Sicherheitsschwelle, sodass er nur löst, wobei er sicher ist, und den Rest mit vollem Kontext an einen Menschen übergibt, genau das Muster des guten Anrufs oben.
- Testen Sie vor dem Go-live mit Ihrer eigenen Historie, nicht mit den Demo-Szenarien eines Anbieters. Sie wollen wissen, wie er Ihre letzten tausend echten Anrufe oder Tickets bearbeitet hätte, nicht ein vorgefertigtes "Wie sind Ihre Öffnungszeiten."
Dieser letzte Punkt wird von Teams übersprungen und bereut. Er ist der Unterschied zwischen Hoffen und Wissen, und deshalb ist die Simulation gegen frühere Tickets, bevor ein einziger Kunde berührt wird, für die Textseite des Supports zum Standard geworden.
Wo KI-Sprache in Ihren Support-Stack passt
Sollten Sie also einen KI-Agenten an Ihre Telefonleitung setzen? Meine ehrliche Meinung: Sprache ist ein Kanal, und für die meisten Support-Teams nicht der größte. Chat, E-Mail und Tickets tragen meist deutlich mehr Volumen und lassen sich risikoärmer zuerst automatisieren, weil ein Text-Agent Entwürfe schreiben, auf Prüfung warten und übergeben kann, ohne dass ein Anrufer in Echtzeit wartet.
Eine sinnvolle Reihenfolge für die meisten Teams:
- Automatisieren Sie zuerst die Textkanäle, wo dasselbe Wissen und dieselbe Sicherheitsschwelle gelten, mit einem viel milderen Fehlerbild. Hier verdient sich ein KI-Kundenservice-Tool am schnellsten sein Geld.
- Lernen Sie aus echten Daten, wobei Ihr Agent wirklich sicher ist, und nutzen Sie dafür Lösungsquote und andere Kennzahlen als Richtschnur.
- Erweitern Sie auf Sprache, sobald Sie dem Routing vertrauen, und nutzen Sie dieselbe Wissensdatenbank und dieselbe Übergabelogik, die Sie schon im Text validiert haben.
Das Wissen und die Sicherheitslogik sind die wiederverwendbaren Teile. Die sprachspezifische Infrastruktur (Telefonie, Latenz, Barge-in) ist die zusätzliche Schicht obendrauf, und sie ist ein echtes Projekt, kein Häkchen. Erst das Text-Fundament richtig zu bauen macht die Sprachschicht später lohnenswert.
eesel für die Textseite des Supports testen
eesel ist ein KI-Helpdesk-Teammitglied, das die Kanäle bearbeitet, auf denen der Großteil Ihres Volumens tatsächlich liegt: Tickets, Live-Chat und E-Mail im Helpdesk, den Sie bereits betreiben. Es ist kein Telefon- oder Sprachagent, und das sage ich lieber offen, als zu übertreiben. Es ist gut in dem Fundament, das dieser ganze Beitrag als erstes empfiehlt: Es trainiert auf Ihren früheren Tickets und Ihrem Help Center, setzt seine Antworten unter eine Sicherheitsschwelle, sodass es nur beantwortet, wobei es sicher ist, und lässt Sie gegen Ihren echten Ticketverlauf simulieren, bevor es ein Live-Gespräch berührt. So sehen Sie die Lösungsquote, bevor Sie sich festlegen.

Es lässt sich an Zendesk, Freshdesk, Gorgias, Front, Help Scout und Slack anbinden und nutzt monatliche Credit-Pläne statt Minutenabrechnung, die Sie auf der Preisseite prüfen können. Bringen Sie zuerst die Textkanäle zum Laufen, dann wird die Sprachschicht zur Erweiterung von etwas, dem Sie bereits vertrauen, und nicht zum Sprung ins Ungewisse. Sie können eesel kostenlos testen, ohne Kreditkarte und ohne Verkaufsgespräch.