
Já alguma vez escreveu uma pergunta a um chatbot de IA e sentiu aquela ligeira e estranha pausa antes de ele começar a debitar uma resposta? É um atraso minúsculo, mas suficiente para o lembrar de que está a falar com uma máquina. Uma empresa chamada Groq tem a missão de eliminar essa pausa por completo, tornando as interações com IA tão fluidas e naturais como falar com uma pessoa.
Enquanto muitas empresas no mundo da IA estão focadas em construir modelos maiores e mais complexos, a Groq está a atacar um problema diferente, mas igualmente importante: a velocidade. Eles não estão apenas a tornar a IA um pouco mais rápida; estão a visar um nível de desempenho que muda o que é possível com IA em tempo real.
Se já viu o nome a aparecer e se perguntou o que é todo este entusiasmo, está no sítio certo. Vamos explicar o que é a Groq, como a sua tecnologia única funciona, a quem se destina e algumas das limitações do mundo real que deve conhecer.
O que é a Groq?
Vamos começar pelo básico. A Groq é uma empresa americana de chips de IA fundada por Jonathan Ross, uma das mentes por trás do chip de IA personalizado da Google, a Tensor Processing Unit (TPU). Em vez de tentar fazer tudo, a Groq foca-se numa coisa específica: construir hardware para inferência de IA.
Então, o que é esta "inferência" em que eles estão tão focados? Pense nela como a parte de "desempenho" da IA. Depois de um modelo de IA massivo ter sido treinado com toneladas de dados, a inferência é o processo de usar efetivamente esse modelo para obter uma resposta. Sempre que faz uma pergunta a um chatbot ou recebe uma recomendação alimentada por IA, isso é uma tarefa de inferência.
E não, antes que pergunte, isto não tem nada a ver com o modelo de IA "Grok" de Elon Musk. Grafias diferentes, empresas completamente diferentes. É uma confusão comum, por isso vamos esclarecer isso desde já. O objetivo da Groq é tornar a inferência de IA incrivelmente rápida e acessível, o que poderia abrir as portas a uma nova onda de ferramentas de IA em tempo real.
A tecnologia por trás da Groq: Como atinge uma velocidade recorde
Então, como é que a Groq consegue esta velocidade incrível? Não é apenas um pequeno ajuste na tecnologia existente; é uma forma completamente diferente de pensar o problema. A magia está no seu chip construído à medida, a Language Processing Unit, ou LPU.
Ao contrário de uma GPU (Graphics Processing Unit), que é mais uma ferramenta poderosa de uso geral adaptada para IA, a LPU foi conceigida desde o início com um único propósito: executar modelos de linguagem o mais rápido humanamente possível.
O verdadeiro truque está na forma como lidam com a memória. A maioria dos chips com os quais está familiarizado, como as GPUs, usam um tipo de memória chamado DRAM. Pense na DRAM como uma estante de biblioteca enorme. Pode conter imensos livros (dados), mas tem de ir até lá para buscar o que precisa, o que leva algum tempo.
A Groq decidiu seguir um caminho diferente, usando algo chamado SRAM. A SRAM é como ter o livro exato que precisa aberto na sua secretária. O acesso é instantâneo, mas a sua secretária só pode conter alguns livros de cada vez. Esta é a mesma memória super-rápida usada para pequenas caches no processador principal do seu computador. É incrivelmente rápida, o que significa que a LPU quase nunca tem de esperar por dados.
graph TD subgraph GPU Tradicional A[Núcleo da GPU] -->|Solicitar Dados| B(Memória DRAM); B -->|Recuperação de Dados com Latência| A; end subgraph LPU Groq C[Núcleo da LPU] -->|Acesso Instantâneo aos Dados| D(Memória SRAM); D -->|Sem Latência| C; end style B fill:#f9f,stroke:#333,stroke-width:2px style D fill:#ccf,stroke:#333,stroke-width:2px
Mas, como na maioria das coisas na vida, há um senão. E um grande. A SRAM é incrivelmente cara e não armazena muitos dados. Enquanto uma única GPU de topo pode armazenar uma grande parte de um modelo de IA na sua memória, uma LPU só pode conter uma fração minúscula. Para executar um modelo de linguagem moderno, a Groq tem de ligar em cadeia centenas, por vezes milhares, destes chips LPU. Esta configuração é o que dá ao seu hardware as suas capacidades de inferência ultrarrápidas, mas também torna a sua construção extremamente cara.
Casos de uso e benefícios: A quem se destina a Groq?
Ok, então é ridiculamente rápida. Mas quem precisa realmente deste tipo de velocidade? Acontece que muitas pessoas. Em qualquer lugar onde um atraso possa arruinar a experiência, a Groq tem um lugar.
Aqui estão alguns locais onde esta velocidade faz uma enorme diferença:
-
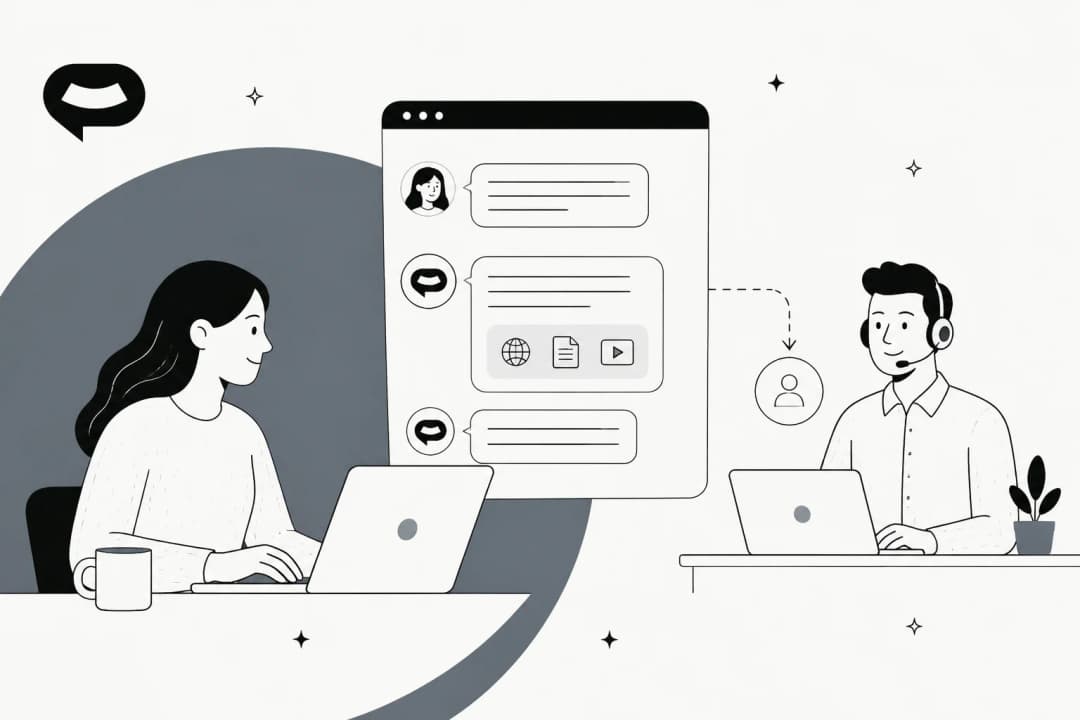
Suporte ao cliente em tempo real: Em vez de um chatbot que parece que está a preencher um formulário web lento, obtém um que consegue acompanhar uma conversa real. Isto elimina as pausas frustrantes que levam os clientes a desistir e a pedir para falar com um agente humano.
-
Análise de dados ao vivo: Pense em áreas de alta pressão como finanças ou até mesmo corridas de Fórmula 1, onde a Groq tem uma parceria com a McLaren. Quando precisa de analisar dados e tomar decisões numa fração de segundo, esse tempo de resposta instantâneo é uma vantagem séria.
-
Aplicações interativas: Para quem usa assistentes de codificação ou ferramentas criativas alimentadas por IA, a velocidade do feedback é tudo. Quando a IA consegue acompanhar a sua linha de pensamento, parece menos uma ferramenta e mais um colaborador.
Para empresas e programadores que usam a sua API, as vantagens são bastante diretas:
-
Velocidade Inacreditável: A Groq pode gerar centenas de tokens por segundo, criando um fluxo de conversação difícil de encontrar em qualquer outro lado.
-
Potencial para Custos Mais Baixos em Escala: Embora a compra do hardware esteja fora do alcance da maioria, se a sua empresa fizer um grande número de pedidos de IA, a eficiência da LPU pode levar a um custo mais baixo por cada um.
-
Fácil de Adotar: Eles tornaram a sua API compatível com os padrões da OpenAI, o que foi uma jogada inteligente. Significa que os programadores podem muitas vezes mudar as suas aplicações para a Groq alterando apenas algumas linhas de código.
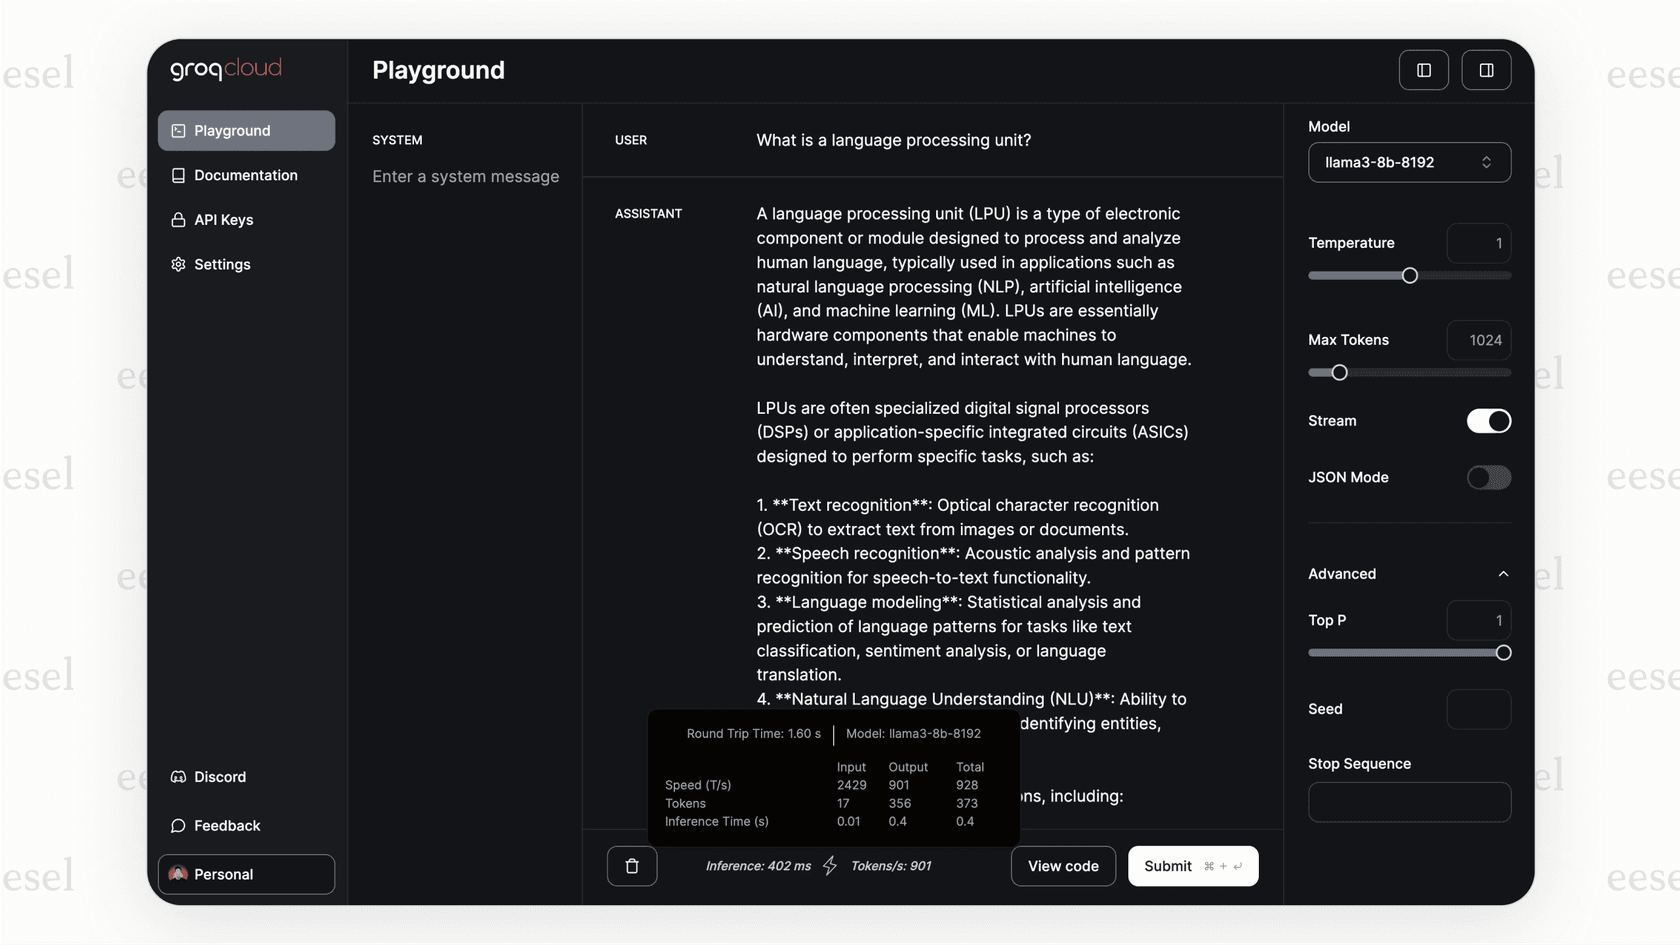
Mas a velocidade bruta é apenas metade da história. Uma IA rápida que dá a resposta errada é apenas uma forma rápida de frustrar os clientes. Para algo como o suporte ao cliente, essa velocidade precisa de inteligência e direção. É aqui que uma plataforma como a eesel AI entra em cena. Ela atua como o cérebro, dizendo ao motor super-rápido o que fazer, ligando-o à informação certa e guiando as suas ações.
Limitações e considerações sobre o uso da Groq
Agora, nem tudo é um mar de rosas. A abordagem da Groq é altamente especializada, e isso traz algumas coisas sérias a ter em conta antes de se aventurar.
O preço elevado do hardware Groq
Este é o maior obstáculo. A menos que esteja a usar a sua API na nuvem, o custo de configurar o seu próprio hardware Groq é astronómico. Não estamos a falar de um pouco caro; estamos a falar de "precisa de um orçamento multimilionário" só para começar. Isto torna o auto-alojamento inacessível para quase todos, exceto as maiores corporações.
Seleção limitada de modelos na GroqCloud
Se estiver a usar a API GroqCloud, tem de escolher entre os modelos que eles decidiram suportar. Não pode simplesmente pegar no seu modelo de código aberto favorito e executá-lo no sistema deles. Esta é uma diferença fundamental em comparação com o uso de GPUs na nuvem de uso geral, que lhe dão muito mais liberdade para experimentar.
A Groq é para inferência, e apenas inferência
Estes chips LPU são construídos para uma tarefa: executar modelos de IA rapidamente. Não são concebidos para treinar um novo modelo do zero ou mesmo para fazer o fine-tuning de um existente. Isto significa que qualquer empresa que use a Groq ainda precisará de acesso a hardware de GPU tradicional para o desenvolvimento dos seus modelos, tornando-a uma ferramenta especializada num conjunto de ferramentas maior, não um substituto completo.
Isto realça por que é inteligente construir as suas ferramentas de IA numa plataforma mais flexível. Não quer ficar preso a um único motor. Pense nisto desta forma: enquanto a Groq pode ser o motor de Fórmula 1 que usa para a velocidade, uma plataforma como a eesel AI é o próprio carro. Permite-lhe ligar-se ao seu helpdesk como o Zendesk, extrair conhecimento de locais como o Confluence e dá-lhe os controlos para orientar a personalidade e o comportamento da IA. Pode até testá-la em tickets de suporte anteriores para ver como se comportaria, tudo antes de falar com um cliente real.
Preços da Groq: API vs. on-premise
Então, quanto custa tudo isto? A Groq tem duas formas principais de pagamento, e estão a anos-luz de distância.
A API GroqCloud
Este é o caminho que a maioria das pessoas seguirá. Paga conforme o uso com base no número de tokens (partes de palavras) que processa. É o modelo padrão para APIs de IA.
| Modelo | Preço de Entrada (por 1M de tokens) | Preço de Saída (por 1M de tokens) |
|---|---|---|
| Llama3-8b-8192 | $0.05 | $0.10 |
| Llama3-70b-8192 | $0.59 | $0.79 |
| Mixtral-8x7b-32768 | $0.24 | $0.24 |
| Gemma-7b-it | $0.10 | $0.10 |
Nota: Os preços podem mudar, por isso é sempre melhor verificar a página oficial de preços da Groq para as taxas mais atuais.
Implementação On-Premise da Groq
Esta é a opção "se tem de perguntar, provavelmente não pode pagar". É para grandes empresas com necessidades de segurança ou desempenho muito específicas que justificam a construção do seu próprio cluster Groq. Embora não haja uma lista de preços pública, os rumores da indústria sugerem que estamos a falar de milhões de dólares para uma configuração básica, com implementações em larga escala a custar muito, muito mais.
Groq: A velocidade é apenas o começo
Então, qual é a conclusão sobre a Groq? Eles encontraram um problema muito específico, a velocidade de inferência de IA, e dedicaram-se de corpo e alma a resolvê-lo. Os seus chips LPU, com o seu design totalmente SRAM, estão numa categoria à parte para respostas em tempo real. Para qualquer aplicação que precise de se sentir verdadeiramente conversacional, Groq é um nome a reter.
Mas não é uma solução mágica para todos os problemas de IA. O alto custo de comprar o hardware e a seleção limitada de modelos na sua API significam que é uma ferramenta especializada para um trabalho especializado. Para a maioria de nós, a Groq será o motor por trás de uma funcionalidade específica que precisa de ser ultrarrápida.
No entanto, a necessidade de IA instantânea só vai aumentar à medida que se integra em mais das nossas ferramentas. A Groq é definitivamente uma empresa a ter debaixo de olho, mas aproveitar essa velocidade de forma eficaz exige mais do que apenas um chip rápido.
Coloque a velocidade da Groq a trabalhar com um agente de IA mais inteligente
Hardware rápido é ótimo, mas para o suporte ao cliente, o verdadeiro objetivo é obter respostas rápidas e precisas que realmente resolvam problemas. Precisa de um sistema que possa pegar nessa velocidade bruta e canalizá-la para algo genuinamente útil.
Foi para isso que construímos a eesel AI. É uma plataforma que lhe permite ligar as suas fontes de conhecimento, afinar o comportamento do seu agente de IA e tê-lo a funcionar em minutos, não em meses. Damos-lhe o controlo e as ferramentas de teste necessárias para transformar a velocidade bruta da IA em resultados que pode medir, como clientes mais felizes e menos tickets de suporte.
Pronto para construir um agente de suporte de IA que é incrivelmente rápido e totalmente sob o seu controlo? Comece o seu teste gratuito com a eesel AI hoje.
Perguntas frequentes
O que é exatamente a Groq e que problema resolve na IA?
A Groq é uma empresa americana de chips de IA especializada na construção de hardware para inferência de IA extremamente rápida. A sua missão é eliminar a latência (pausa) nas interações de IA, tornando-as instantâneas e naturais.
Como é que a tecnologia LPU da Groq atinge velocidades tão recordes para a inferência de IA?
A Groq atinge a sua velocidade através da sua Language Processing Unit (LPU) personalizada, concebida especificamente para modelos de linguagem. Ao contrário das GPUs, as LPUs usam memória SRAM super-rápida para acesso instantâneo aos dados, minimizando os tempos de espera e maximizando a velocidade de processamento.
Para que tipos de aplicações a Groq é mais benéfica e porque é que a sua velocidade é importante nesses casos?
A Groq é mais benéfica para aplicações que requerem respostas de IA em tempo real, como suporte ao cliente interativo, análise de dados ao vivo em áreas críticas como finanças e ferramentas criativas fluidas alimentadas por IA. A sua velocidade elimina atrasos frustrantes, fazendo com que a IA pareça um colaborador perfeito.
A Groq é a mesma empresa por trás do modelo de IA 'Grok' de Elon Musk?
Não, Groq (com 'q') é uma empresa completamente diferente do modelo de IA 'Grok' de Elon Musk. A Groq é uma empresa de chips de IA focada em hardware para inferência rápida, enquanto 'Grok' é um modelo de chatbot de IA.
Quais são as principais limitações que uma empresa deve considerar antes de adotar a tecnologia da Groq?
As principais limitações incluem o custo extremamente elevado do hardware on-premise da Groq, o que limita a sua acessibilidade para a maioria das empresas. Além disso, se usar a API GroqCloud, está limitado aos modelos que eles suportam, e os chips são exclusivamente para inferência, não para treinar modelos de IA.
Qual é o modelo de preços típico para usar a Groq e existem diferentes opções?
A Groq oferece duas opções principais: a API GroqCloud, onde paga conforme o uso com base nos tokens processados, que é geralmente acessível. Para soluções on-premise da Groq, o custo é significativamente mais elevado, muitas vezes na ordem dos milhões de dólares, reservado para grandes corporações com necessidades específicas.
Posso usar os chips LPU da Groq para treinar novos modelos de IA ou fazer o fine-tuning dos existentes?
Não, os chips LPU da Groq são especificamente concebidos e otimizados para a inferência de IA, o processo de usar um modelo treinado para gerar respostas. Não foram construídos para treinar novos modelos do zero ou para fazer o fine-tuning dos existentes; essas tarefas ainda requerem hardware de GPU tradicional.