

2026年9月2日、Googleは汎用のGemini 3.8 Flashと同時にGemini 3.8 Flash Cyberを公開しました。同じモデルを一つの仕事に特化して調整したバージョンで、その仕事とはソフトウェアのセキュリティ脆弱性を発見してパッチを当てることです。従来の3.5 Flash Cyberに代わるもので、Googleによれば、サイバー分野のトレーニングこそが汎用モデルのコーディングと推論の向上も後押ししたといいます。
期待しすぎる前に知っておくべきことが二つあります。第一に、ほぼ確実に、あなたはこれを使えません。GoogleのFairwind Programを通じて信頼できる防御担当者に限定されており、公開APIもセルフサービスのアクセスもありません。第二に、最も強力なサイバーモデルを申請制プログラムの背後に置くのは、これで3つ目の主要ラボです。OpenAIはDaybreak経由でGPT-5.6-Cyberを、Anthropicは4月に先駆けてProject Glasswing経由でClaude Mythos 5を、それぞれ制限しています。
これらのプログラムのどれにも入れない防御担当者にとっての実践的な教訓は、AIエージェントを構築するときに私が何度も立ち返る考え方です。モデルは安価な最下層であり、本当の仕事をするのはその周りのシステムです。これはセキュリティエージェントでもサポートエージェントでも同じです。
Gemini 3.8 Flash Cyberとは実際に何か
GoogleのGeminiファミリーは、最も難しい推論向けのProモデルと、高速で安価な主力であるFlashモデルに分かれます。Flash Cyberはその第三の存在、つまり専門特化モデルです。Googleは汎用のGemini 3.8 Flashを取り上げ、狭く重要度の高い領域、すなわちコードの脆弱性の検出、検証、パッチ適用に集中的に鍛え上げました。しかも大規模な最先端モデルよりトークンあたりの価格は低く抑えられています。
今回興味深いのは、恩恵が流れた方向です。昨年のGemini 3.5 Flash Cyberでは、サイバーモデルは明らかに下流の専門モデルでした。3.8では、Googleは両バリアントが同じ基盤知能を共有しており、サイバー分野のトレーニングが汎用モデルのコーディングと推論の向上の理由の一部だと述べています。セキュリティの仕事は厳しい教師であることがわかります。見慣れないコードを読み、どこで壊れるか仮説を立て、それを証明するのは難しい推論ループであり、それを訓練することが全方位で効果を生むようです。
ここで、ほとんどのリリース記事が省く率直な位置づけを述べます。Flash Cyberは会話するチャットボットではありません。巨大なコードベースに対して何度も実行し、針を探すためのコンポーネントです。まさにFlashラインが担う大量処理の仕事であり、だからこそGoogleはセキュリティ専門モデルを、より重いProモデルではなくFlashの上に構築しました。一度だけ実行できるほど賢いより、百回実行できるほど安いほうが勝ります。
実際に誰が使えるのか:Fairwind Program
ここが、ほとんどの読者が足を止める部分です。Gemini 3.8 Flash Cyberは、Fairwind Programを通じた信頼できる防御担当者のみが利用できます。AI Studioに切り替えスイッチはなく、APIキーもセルフサービスのプランもありません。
理由は懸念そのものにあります。デュアルユースです。悪用可能なバグを見つけるのが得意なモデルは、同じ理由で攻撃者が欲しがる道具でもあります。そこでGoogleは、防御側にも攻撃側にもほぼ同じだけ役立つ能力を制限するときのやり方で制限しています。まず審査済みのユーザーに限った管理された展開です。汎用の3.8 Flashは標準的なCBRNおよびサイバー攻撃対策のセーフガードを備えて出荷されますが、Cyberバリアントは「より許容的な緩和措置のセット」で動作し、プログラムの背後に隔離されています。
名前が挙がっているFairwindのパートナーを見ると、実際に「信頼できる防御担当者」が誰を指すかがわかります。Palo Alto Networks(Charlie Sestito)、Snowflake(Mayank Upadhyay)、Wiz(Gal Nagli)、Armadin(David Slater)のセキュリティおよびインフラチームです。個人開発者が今日の午後に自分のリポジトリへ向けようと期待しているなら、それは選択肢にありません。
どれほど優秀か:防御担当者向けベンチマーク
Googleは、お決まりの合成リーダーボードを前面に出しませんでした。自社のセキュリティチームとパートナーがモデルから得た成果を前面に出しました。これは、飽和した別のベンチマークよりも有用な指標です。
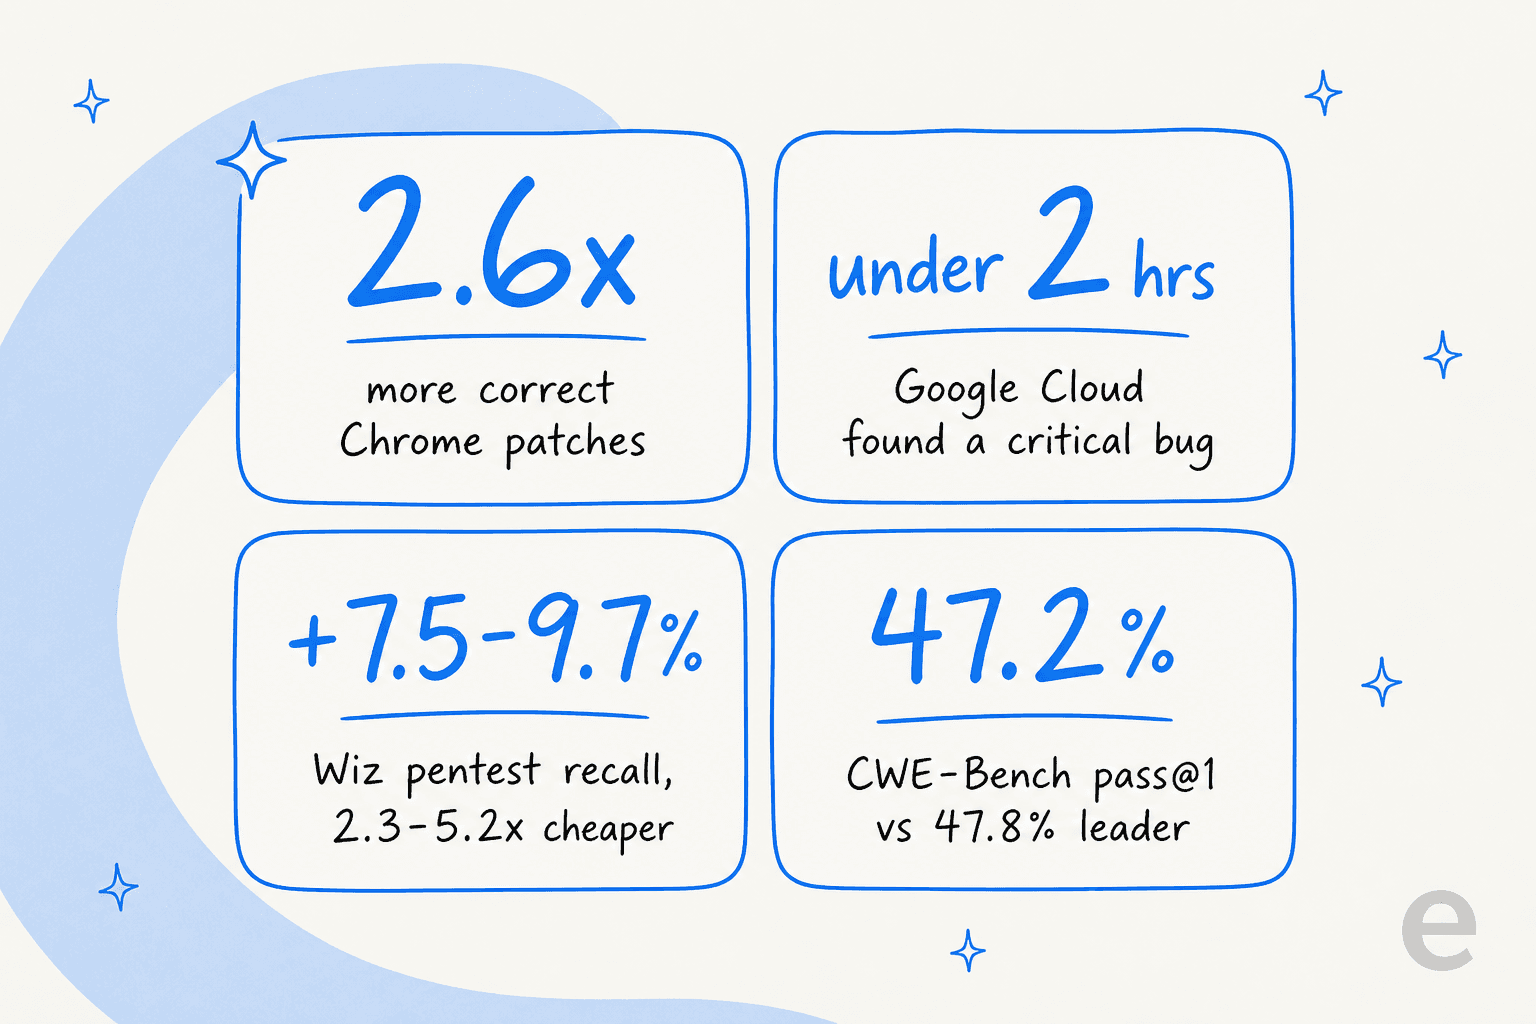
Chrome Securityチームは、このモデルがChromeの脆弱性に対して、はるかに大きい最良の商用モデルより2.6倍多くの正しいパッチを生成したと報告しました。Wizは、社内のペネトレーションテストベンチマークで、コストを2.3〜5.2分の1に抑えながらリコールが7.5〜9.7%高いことを測定しました。Flashラインが勝つべく作られた「ドルあたりの能力」のトレードオフの好例です。さらにGoogle CloudのVulnerability Researchチームは、通常は数か月かかる作業を、重大な基盤的脆弱性の発見まで2時間未満で終えたとGoogleは述べています。
より比較しやすい数値では、内容は意図的に控えめです。Collinearが運営する自動パッチ適用ベンチマークCWE-Benchで、Gemini 3.8 Flash Cyberはpass@1が47.2%、対して有力な最先端モデルは47.8%で、ほぼ同水準ですが、コストは大幅に低く、これがGoogleの主張するパレートフロンティアの要点です。20のプログラミング言語にまたがる社内ベンチマークでは70%超の成功率を記録し、自律的な脆弱性発見ベンチマークであるCyberGymでは、3.5 Flash Cyberとはるかに大きい最先端モデルの両方を上回るとGoogleは述べています。
見方は、Flashラインが一般に勝つ理由と同じです。「リーダーボードの頂点」ではなく、ファインチューニングとハーネスが、本来なら生のパラメータ数が担うはずの重みを担うことで、競争力のある最先端性能をわずかなコストで実現するということです。
より大きな流れ:今や誰もがサイバーモデルを制限している
Googleの投稿だけを読むと、アクセス制限付きのサイバーモデルはGoogle特有のものだと思うかもしれません。そうではありません。今や業界の標準であり、Googleは最後に動いたにすぎません。
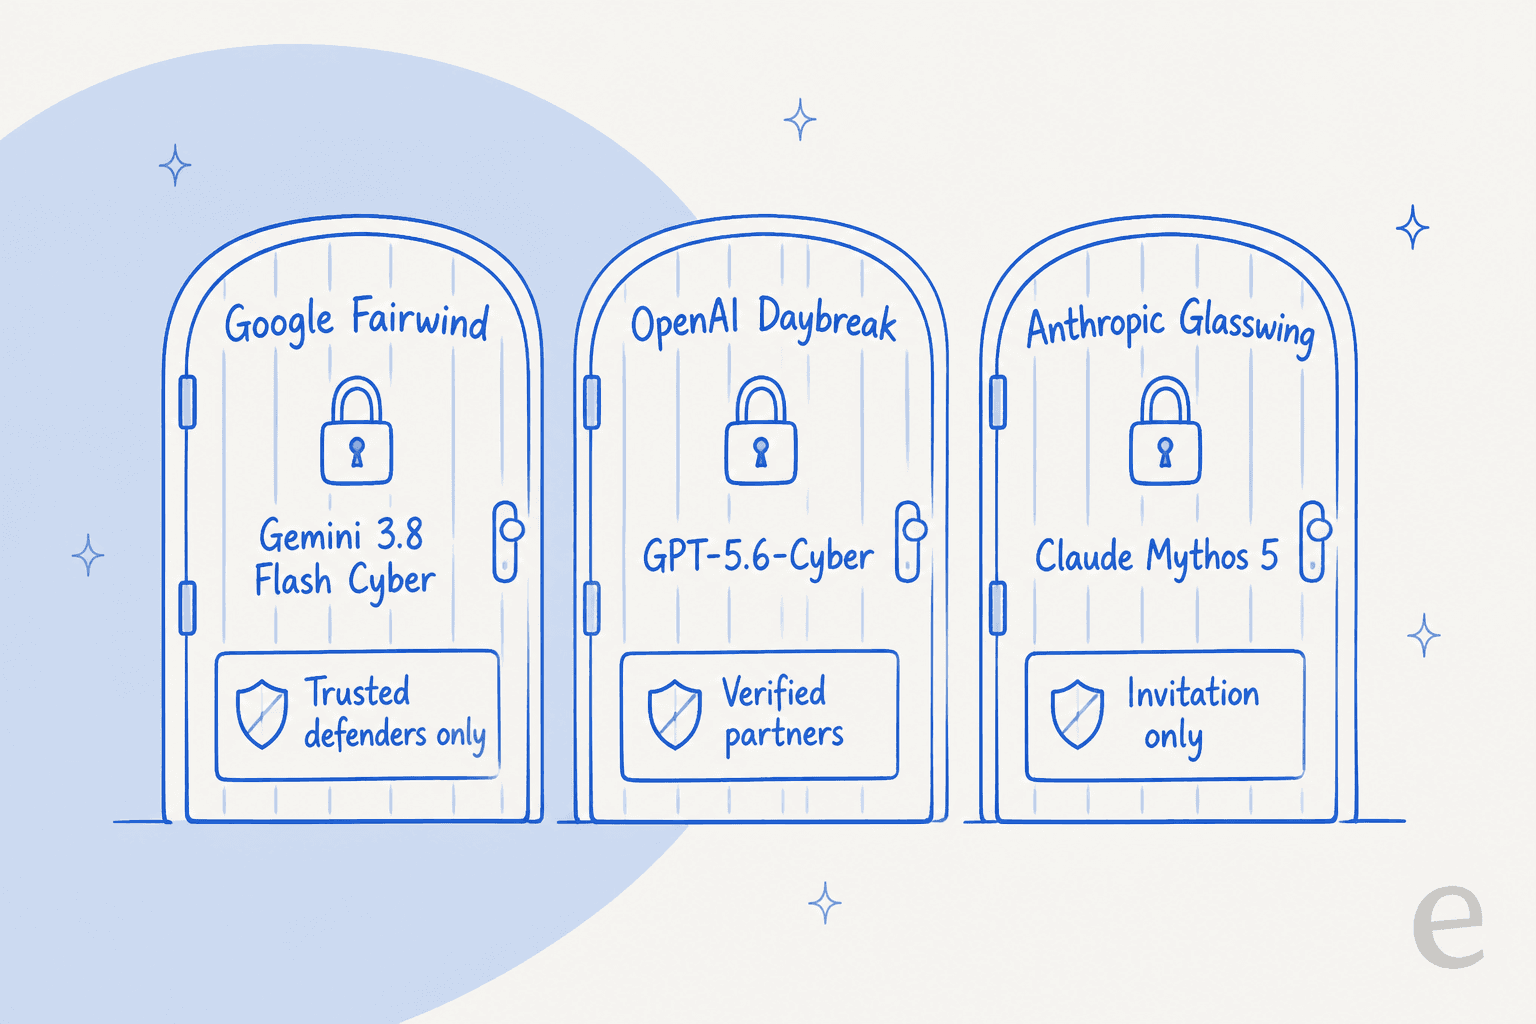
OpenAIは、Daybreakプログラムを通じてGPT-5.6-Cyberを制限しています。これはGPT-5.6 Solをベースに別途トレーニングされたモデルで、検証済みの個人およびパートナー経由で利用でき、OpenAIは価格を一度も公表していません。料金表のCyberの行は文字どおり空欄です。
Anthropicが先でした。Project Glasswingは2026年4月7日に始まり、OpenAIのプログラムより2か月以上早く、1億ドルの利用クレジットの拠出と十数社のローンチパートナーを伴っていました。その制限付きモデルであるClaude Mythos 5は、より明快な設計方針をとっています。一般提供のClaude Fable 5と同じ基盤の重みを使い、ゼロから再学習するのではなくサイバーセキュリティのセーフガードを外したものです。Anthropicは価格(100万トークンあたり10ドル / 50ドル)も公表しており、他の2つのラボはサイバーモデルについてこれをしていません。
3つのプログラムを並べると次のとおりです。
| 項目 | Google Fairwind | OpenAI Daybreak | Anthropic Glasswing |
|---|---|---|---|
| 制限付きモデル | Gemini 3.8 Flash Cyber | GPT-5.6-Cyber | Claude Mythos 5 |
| モデル設計 | 汎用3.8 Flashと同じ基盤 | Solをベースに別途トレーニング | Fable 5と同じ重み、セーフガードを解除 |
| アクセス | 信頼できる防御担当者、申請のみ | 検証済みパートナー+個人向けルート | 招待制のみ、セルフサービスなし |
| 公開価格 | なし | なし | 100万トークンあたり10ドル / 50ドル |
| 公開日 | 2026年9月2日 | 2026年8月10日 | 2026年4月7日 |
じっくり考える価値のある点があります。今年前半、ある政府が脱獄をめぐる争いを理由に、Anthropicのモデルを18日間完全に停止させました。国家の主体が電源を抜くほどデュアルユース性の高い能力となれば、アクセス制限はマーケティング上の選択ではなく、このカテゴリ全体の構造的な特徴に見えてきます。
どれも入手できない場合は?
ほとんどのチームにとって、「どの制限付きサイバーモデルを使うべきか」への答えは「どれも使えない」です。そこで有用な問いは、できることは何かになります。
デュアルユースのセキュリティ能力が本当に必要なら、現時点で最も実用的なのはAnthropicのCyber Verification Programです。既存の組織で無料で申請でき、約2営業日で結果が出て、OpusおよびSonnetクラスのモデル(Mythos自体は対象外)のセーフガードが緩和されます。ソースコードの脆弱性発見はClaude Opus 5ですでに標準で動作し、どのラボが提供するものよりもセルフサービスの信頼ティアに近い存在です。
しかし一歩引いて見てください。モデルに一切触れなくても、このリリースが重要なのはここです。Gemini 3.8 Flash Cyberは、あらゆるAIエージェントプロジェクトで私が出会うパターンの明快な事例です。モデルは最下層であり、全体ではありません。Googleは「セキュリティモデル」を出荷して終わりにしたのではなく、バグを検出し、それが本物であると証明し、修正を書き、その修正がビルドを壊していないか確認するシステムでモデルを包みました。知能は、生の重みと同じくらいその包みの中にも宿っています。
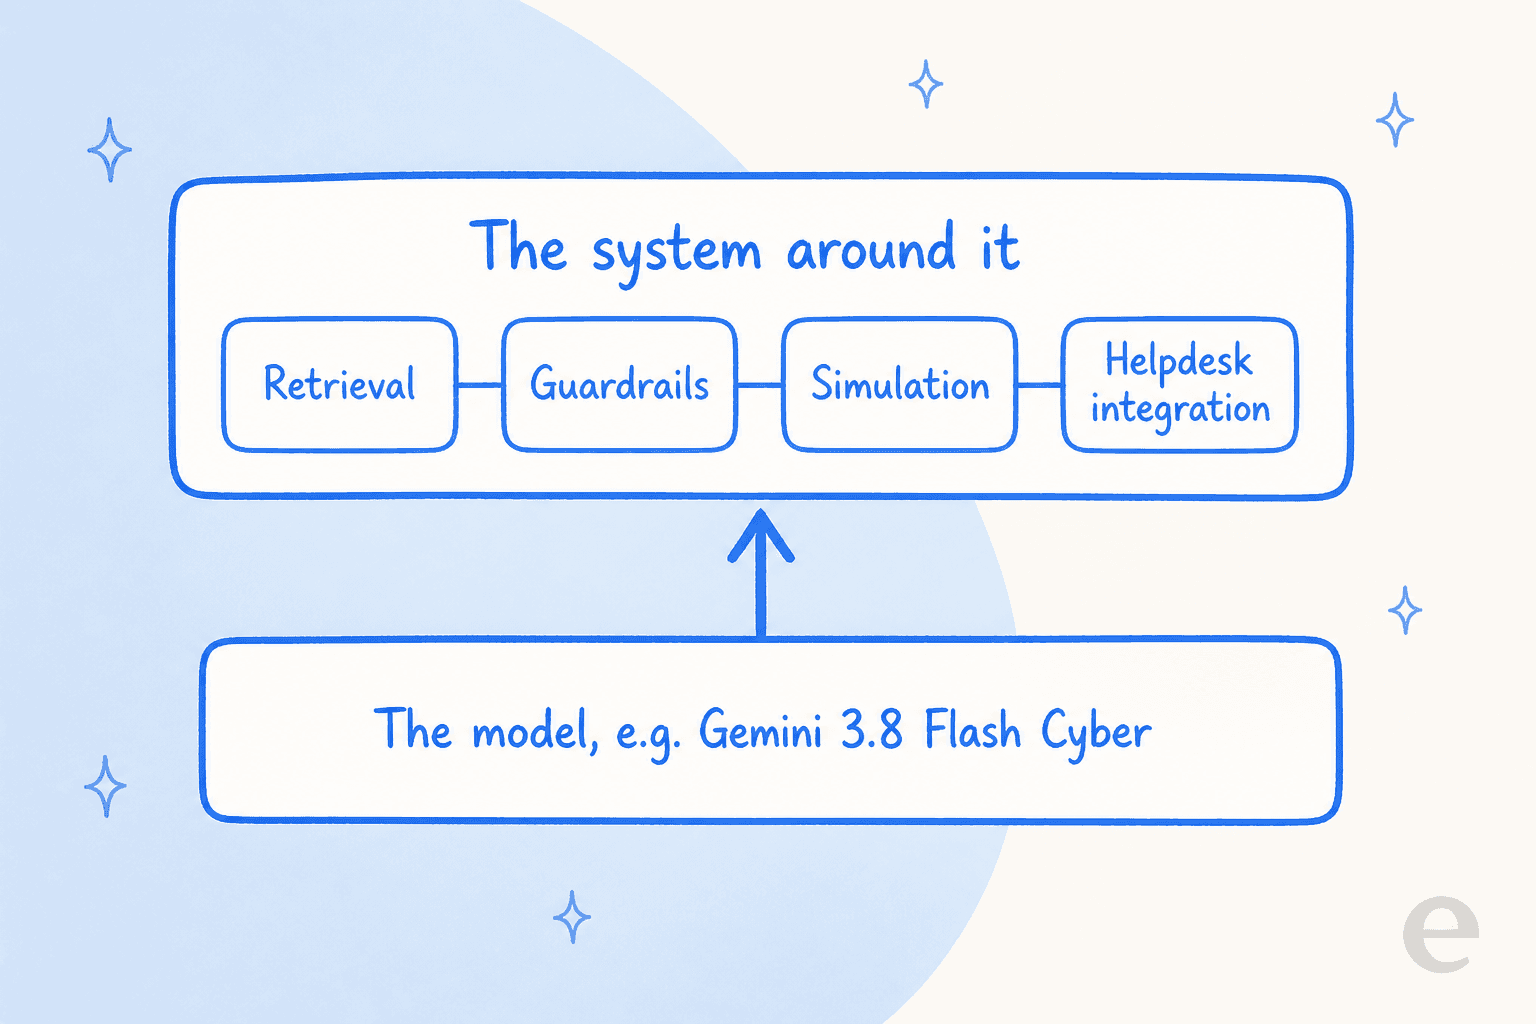
私は長年、実際のサポートキューにAIを載せるチームにいましたが、何度も目にした失敗は、優れたセキュリティハーネスが防ぐように設計されているものと同じです。自信ありげに聞こえるモデルが、周囲の層を誰も作っていないために間違った答えを返すことです。セキュリティでは、検証されていない「修正」がビルドを壊すのが失敗の形です。カスタマーサポートでは、自信満々のボットが返金ポリシーをでっち上げます。同じ病気で、領域が違うだけです。治療法も同じです。モデルが推測ではなく実際の情報源から答えるための検索、きれいに引き継ぐためのガードレール、そして本物に触れる前に挙動を把握するためのテストです。
ですから、新しいモデルが登場したとき、それがCyberでも、汎用の3.8 Flashでも、3週間後の次の新作でも、サポートチームにとって正しい問いは「モデルは十分に優秀か」ではありません。ほとんどの仕事では、すでに十分です。本当の問いは、その周りの検索、ガードレール、シミュレーション、ヘルプデスク連携を誰が構築するのかです。それこそが実際の仕事であり、素のAPIを自分でヘルプデスクにつなぐのが罠である理由です。
eeselを試す
最先端モデルはインフラです。eeselは、その上に迎え入れるチームメイトです。セキュリティハーネスがサイバーモデルにとっての層であるように、サポートにおいてeeselはあなたのヘルプデスクにとっての層です。既存のツールに接続し、過去のチケットとナレッジベースからすぐに学習し、最先端モデルの上で動くAIサポートチームメイトで、APIを自分で配線しなくても性能向上の恩恵を受けられます。

「出荷前に検証する」という考え方にそのまま対応するのがシミュレーションです。eeselは実際の顧客に回答する前に、過去のチケットに対してチームメイトを実行し、解決率と、実際に送っていたはずの返信内容を確認できます。しかもトークン単位ではなく、行った仕事に基づく料金体系なので、チケットごとのトークン計算が不要です。サポート自動化を構築するためにモデルを比較しているなら、望む成果から出発し、配管はプラットフォームに任せてください。無料で試せます。