

Runway Solaris, annoncé le 31 août 2026, est le premier de ce que Runway appelle les Interface World Models. La version en une ligne : au lieu de construire un logiciel sous forme de code puis de l'exécuter, Solaris génère l'interface elle-même, image par image, en direct, pendant que vous interagissez avec elle. Il n'y a ni HTML, ni CSS, ni code en dessous. L'image sur votre écran est l'application.
Il repose sur le modèle vidéo Gen-4.5 de Runway, associe un modèle de langage (qui décide ce qui doit se passer) à un modèle de monde (qui génère l'apparence) et vise l'interaction en temps réel en 720p. Dans l'étude utilisateurs de Runway elle-même, les participants ont préféré Solaris à une interface codée par Claude Opus 5 à 61 % contre 24 % pour le respect des consignes et à 71 % contre 21 % pour le comportement naturel.
Le piège : c'est un aperçu de recherche, pas un produit. Il n'y a ni tarif, ni API publique, et l'accès se fait uniquement sur demande. Toutes les réactions jusqu'ici portent sur une vidéo de démonstration, pas sur une utilisation concrète, et les sceptiques les plus affûtés posent déjà deux questions légitimes : les coûts de génération en continu permettent-ils un modèle économique viable, et peut-on faire confiance au résultat ? Cette question de confiance est la plus importante si vous travaillez dans le support, et c'est exactement le problème qu'un coéquipier IA pour votre helpdesk doit résoudre avant de toucher un vrai client.
Ce qu'est réellement Runway Solaris
Il vaut mieux clarifier ce point d'abord, car la plupart des avis du jour du lancement le brouillent : Solaris n'est pas un énième outil de texte vers vidéo, ni un créateur d'applications à la Lovable où l'IA écrit le code à votre place. C'est plus étrange que les deux.
Runway, l'entreprise surtout connue pour la génération de vidéo par IA, se décrit désormais comme "building foundational Real-World Intelligence that can understand, simulate and act in the world". Solaris est le premier modèle d'une nouvelle famille appelée Interface World Models, et la prémisse de départ est un véritable « et si » : que se passe-t-il quand un système d'exploitation génère des applications et des sites web pendant que vous les utilisez ?
Dans une application normale, l'idée d'un designer est traduite en code, le code est livré, et à partir de là l'application ne peut faire que ce que quelqu'un a anticipé et écrit. L'argument de Runway est que cette étape de traduction fait perdre de l'information, c'est "a lossy compression of the space of possible interactions, frozen before any user arrives." Solaris la saute. Il n'y a pas de représentation intermédiaire. Le modèle génère directement la couche d'interface, et "every frame is synthesized as you interact, allowing the interface to respond continuously to your actions."
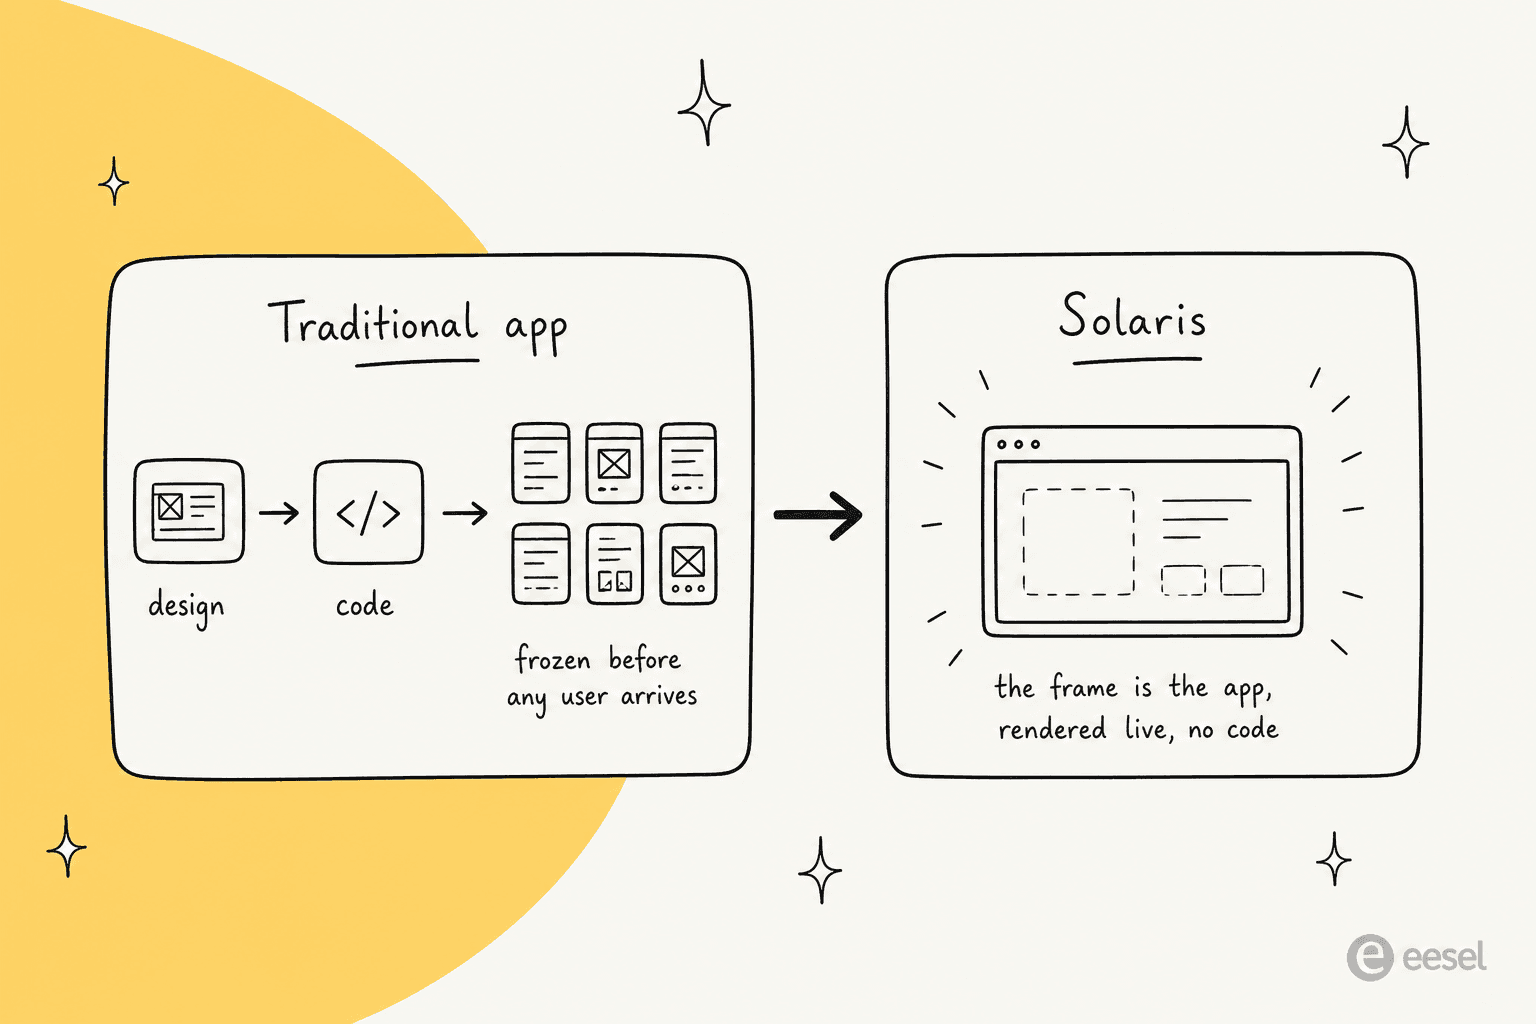
Les exemples de la démo rendent cela concret. Une boutique de vêtements virtuelle où l'on fait glisser un t-shirt sur une photo de soi pour l'essayer. Une salade que l'on compose en faisant glisser des ingrédients dans un bol. Une démonstration de combustion qui réagit avec des résultats physiquement plausibles. Et mon cadrage préféré du billet, "redefining the mouse", où l'on clique sur un chat et son pelage devient notre pinceau, ou l'on clique sur un tableau et l'on dessine dans son style. Aucune de ces interactions n'a été codée. Le modèle les a apprises.
Si vous avez suivi la recherche de Runway, c'est l'échelon logique après GWM-1, son modèle de monde général, et il s'inscrit dans une vraie lignée : Gen-4, puis Gen-4.5, puis GWM-1, maintenant Solaris. Ce n'est pas un simple changement de marque d'un ancien modèle.
Comment fonctionne Solaris : deux modèles, un écran
C'est la partie que je trouve la plus intéressante, car c'est une réutilisation astucieuse de briques existantes plutôt qu'une architecture mystérieuse et nouvelle.
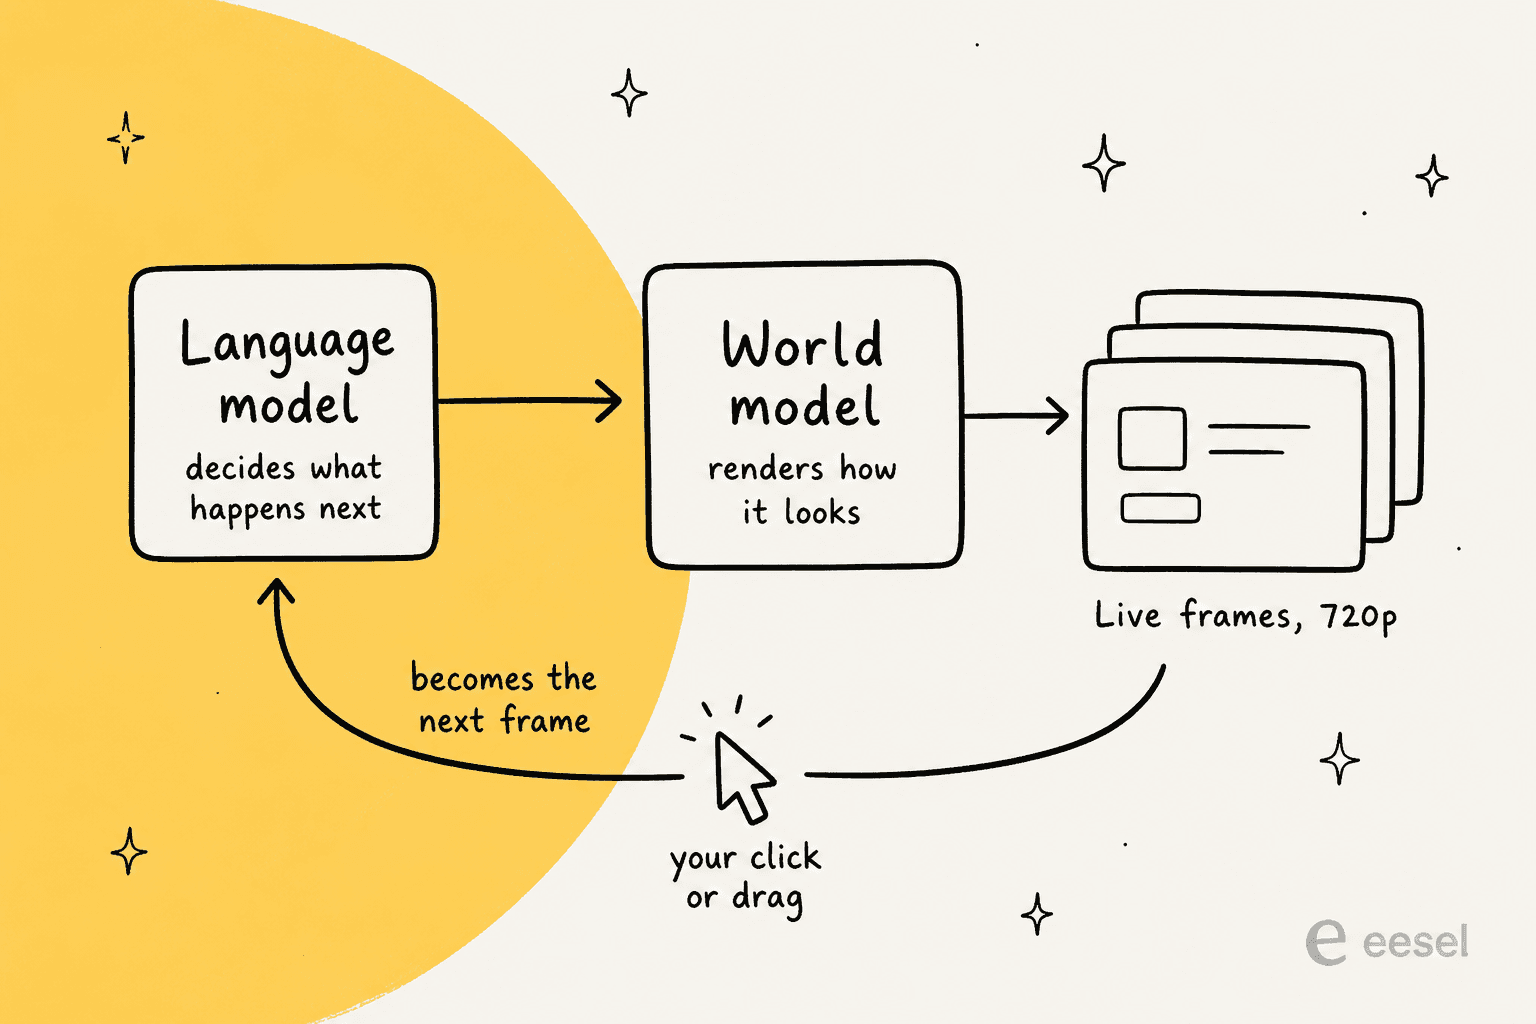
Deux modèles font deux tâches. Un modèle de langage interprète votre demande, décide si une action modifie la scène actuelle ou bascule vers une nouvelle, et produit les prompts qui guident le rendu. Un modèle de monde, construit sur Gen-4.5, génère ensuite l'apparence réelle de ce comportement. Selon les mots de Runway : "one decides what the application should do next, while the other generates how that behaviour appears."
L'astuce qui le rend interactif plutôt qu'un clip préenregistré tient à la façon dont il traite vos actions. Les clics, glissements et modifications sont injectés comme conditionnement pour l'image suivante, de la même manière qu'un texte ou une image. Le modèle ne voit que des interactions déjà survenues, donc il apprend la relation entre une action et son résultat visuel sans que personne ne programme cette relation.
Pour qu'un modèle vidéo tourne assez vite pour paraître en direct, il a fallu trois étapes : lui apprendre à générer les images de façon autorégressive, chaque image ne dépendant que des précédentes ; distiller le lent processus de débruitage en de nombreuses étapes vers quelques étapes seulement ; puis entraîner cette version rapide sur ses propres sorties pour que la qualité tienne sur une longue session. Runway a placé son seuil au point où les interactions "stop feeling interactive somewhere around half a second of delay," et affirme que le travail en temps réel a aussi rendu Solaris de plusieurs ordres de grandeur moins cher à exécuter qu'un modèle de diffusion vidéo standard. Il faut toutefois souligner ce qui n'est pas divulgué : ni fréquence d'images, ni nombre de paramètres, ni longueur de contexte, ni taille de modèle. On connaît les objectifs de conception, pas les preuves.
La démo à laquelle tout le monde réagit
Comme Solaris est sorti sous forme de rapport de recherche avec des tests limités, la réaction est une réaction à la démo, et elle se divise nettement entre émerveillement et sourcil levé.
Côté émerveillement, les créateurs qui passent leurs journées dans les outils génératifs ont tout de suite compris ce que fait Solaris :
"Very cool work by Runway. Feels like the best of both worlds -- fine grain control of a WYSIWYG editor with the creativity & speed of generative models."
Le CTO de Runway, Anastasis Germanidis, a publié le fil de lancement, qui a recueilli environ mille mentions j'aime et est devenu le centre de gravité de la discussion. Sur Hacker News, un commentateur l'a qualifié de "one of the most innovative and coolest AI model demos I've seen this year", ce qui est une barre haute dans une année où les démos ne manquent pas.
Mais les avis les plus utiles sont ceux qui cherchent les coutures. Un designer sur r/UXDesign a souligné que l'interaction « montrer, ne pas expliquer » est une vieille idée, les chercheurs écrivent depuis des décennies sur la programmation par démonstration, donc la nouveauté est le rendu, pas le modèle d'interaction. Et la question analytique la plus pointue est venue de Hacker News, celle à laquelle je reviens sans cesse :
"So, instead of inferring intent from an information-dense input (text), they do it w/ just mouse-based gestures? ... I would love to see how this holds up in practice."

Ce « comment ça tient en pratique » porte beaucoup, et c'est le bon réflexe. Une vidéo de démo est un parcours idéal soigneusement choisi. La question intéressante, c'est la dixième minute d'une vraie session, pas les trente premières secondes.
Solaris contre une interface codée : ce que disent les chiffres
Runway n'a pas seulement livré une vidéo et de bonnes sensations. Elle a mené deux études, et les chiffres sont la partie la plus solide de l'annonce.
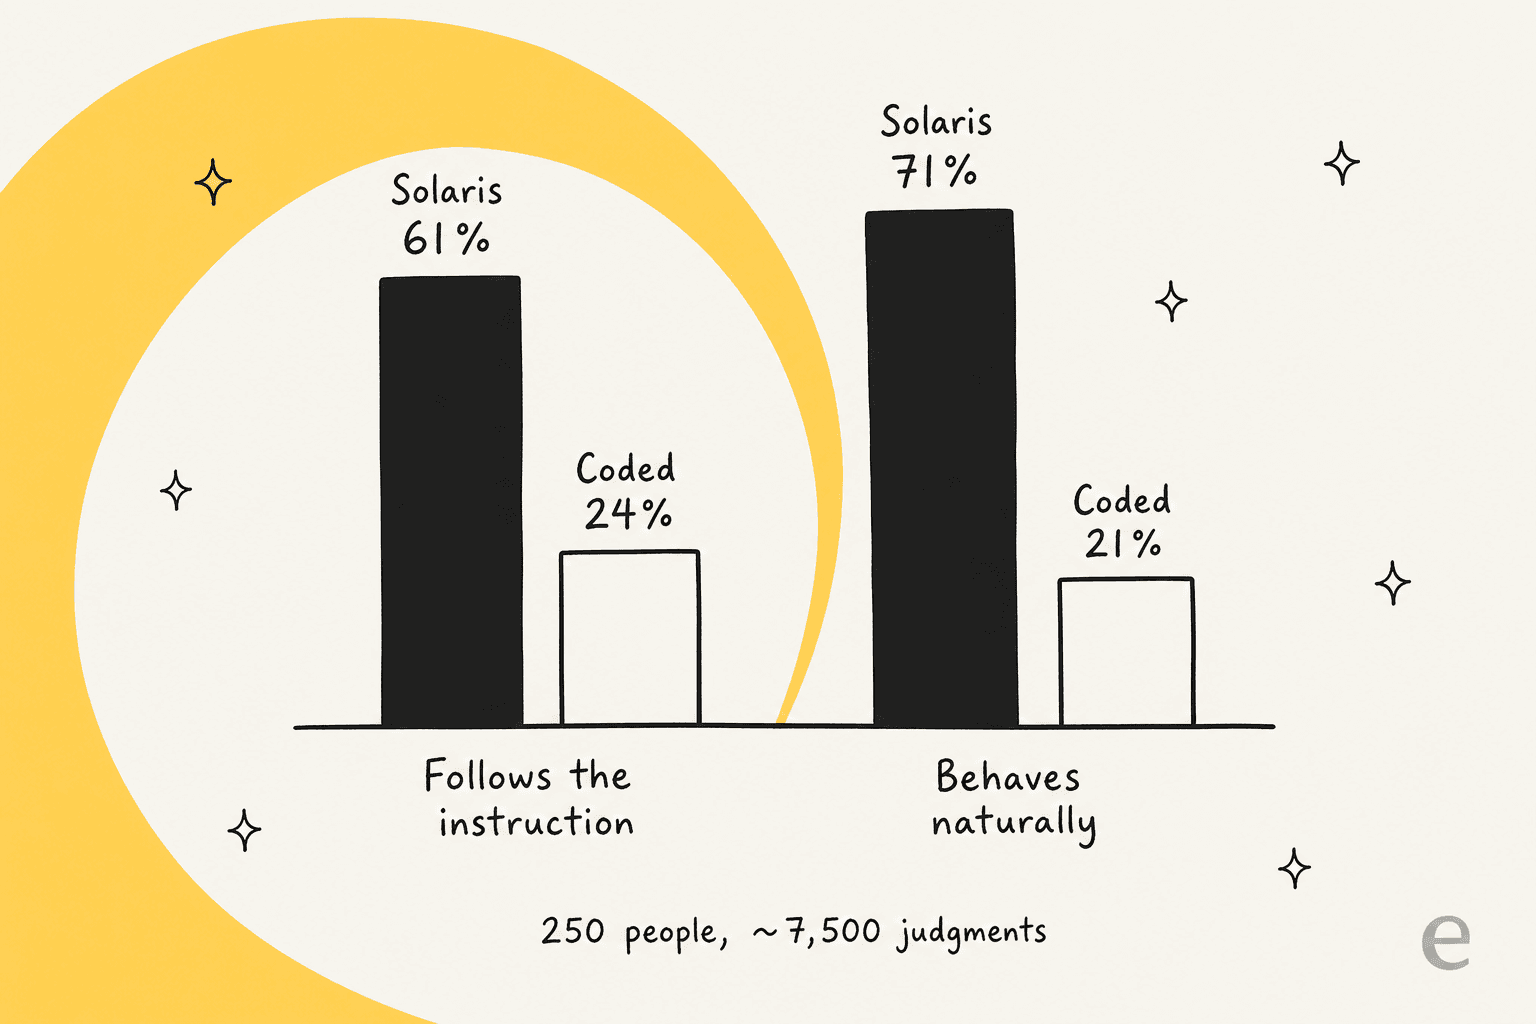
L'étude principale a opposé Solaris à une interface codée construite par Claude Opus 5, un modèle de pointe, avec la même image de départ et les mêmes demandes d'interaction. Avec 250 participants et environ 7 500 jugements par paires, voici le résultat :
| Question | Solaris préféré | Interface codée | Équivalent |
|---|---|---|---|
| Laquelle suit mieux la consigne ? | 61 % | 24 % | 13 % |
| Laquelle se comporte de façon plus naturelle dans la scène ? | 71 % | 21 % | 6 % |
La seconde étude, que Runway appelle "the cost of translation,", est celle qui explique la philosophie. Elle a testé avec quelle fidélité des modèles multimodaux, dont GPT-4o, Gemini 2.5 Pro et Claude Fable 5, pouvaient reconstruire une interface à partir d'une seule capture d'écran, sur 30 interfaces. Le constat : tous les modèles perdent de l'information dans la traduction, et cela empire à mesure que la complexité visuelle augmente. C'est toute la thèse de Runway en une expérience : le code est une étape intermédiaire avec pertes, alors on le supprime.
Deux réserves honnêtes. Ce sont les propres études de Runway, pas des benchmarks indépendants, et il n'y a pas encore de chiffre tiers pour les recouper. Et « préféré dans une comparaison de démo par paires » n'est pas la même chose que « assez fiable pour être livré », ce qui est l'écart que les sceptiques contournent.
Là où les sceptiques ont raison
Je veux être juste envers Solaris, car c'est une vraie recherche et les démos sont impressionnantes. Mais deux critiques sont assez fortes pour être placées juste à côté du battage médiatique.
La première est l'économie. Le meilleur commentaire critique que j'ai trouvé vient de r/accelerate, et il vaut la peine d'être lu en entier :
"I like this a lot but I'm skeptical that people are going to want to pay ongoing generation costs for their app to function versus just having a coded app... if it requires your company stream dolla dolla bills directly to runway at all times to run your app I'm not seeing this as a feasible business model. Your economics would scale up with engagement, not a good situation to be in."

Runway dit bien que le travail en temps réel a rendu Solaris beaucoup moins cher que la diffusion vidéo standard et que "the cost curve continues to improve." Mais « moins cher que générer de la vidéo » est une barre basse quand l'alternative est du code qui tourne pour presque rien. Le coût est l'un des trois défis d'ingénierie que Runway nomme elle-même, avec la vitesse et la cohérence sur une longue session.
La seconde est la confiance, et c'est celle dont Runway parle le plus franchement. Sa propre section sur les limites le dit sans détour : "a convincing wrong answer is worse than no answer." Une interface générée peut afficher quelque chose qui a l'air juste mais ne l'est pas : un prix, un détail produit, un bouton qui ne fait pas ce qu'il semble faire. Runway dit que garder Solaris ancré dans un contexte vérifié au fil d'une session est "an active research focus", ce qui est la façon polie, en recherche, de dire que ce n'est pas encore résolu. Quelqu'un sur Hacker News l'a formulé plus crûment, en le comparant à des démos antérieures de modèles de monde :
"it looks cool at first but really quickly you'll start to see the gaps"
Ce que Solaris signifie si vous gérez le support client
C'est ici que cela cesse d'être une histoire de vidéo IA et devient pertinent pour quiconque déploie de l'IA auprès de vrais utilisateurs.
Runway évoque un cas d'usage qui tombe directement dans l'expérience client : une boutique qui devient un environnement généré, préservant l'identité de la marque tout en adaptant produits, mises en page et recommandations à chaque visiteur en temps réel. C'est une image vraiment enthousiasmante de là où les interfaces pourraient aller. Mais remarquez que le problème non résolu le plus difficile de Solaris, ancrer la sortie dans des données vérifiées pour qu'elle n'affiche pas avec assurance quelque chose de faux, est exactement le problème qui définit l'IA pour le support depuis le premier jour.
Je construis des agents IA pour le helpdesk depuis des années, et la leçon la plus importante est celle que Runway vient d'écrire dans sa propre section sur les limites. Un bot de support qui paraît sûr de lui et se trompe fait plus de dégâts que celui qui dit « je vous passe un humain ». C'est pourquoi les hallucinations de l'IA en support sont ce contre quoi l'on construit d'abord, pas en dernier, et pourquoi nous simulons chaque déploiement sur des milliers de vrais tickets historiques d'une entreprise avant qu'il ne réponde à un client en direct. On ne découvre pas en production si la réponse est fondée ; on le découvre sur des tickets dont on connaît déjà la résolution.
Voici donc comment je lis Solaris, et les modèles comme lui : c'est une infrastructure fascinante, un nouveau substrat pour la façon dont les interfaces pourraient être générées. Mais une infrastructure n'est pas un employé. Un modèle capable de tout générer a toujours besoin de garde-fous, d'ancrage et de contexte métier pour qu'on lui confie une tâche précise, et c'est une discipline différente de celle qui consiste à faire bouger des pixels.
Essayez eesel
C'est cet écart qu'eesel est conçu pour combler. Là où Runway construit la couche de modèle, eesel est le coéquipier IA que vous embauchez pour une tâche, et aujourd'hui cette équipe comprend un coéquipier IA pour le helpdesk et un rédacteur de blog IA. Chacun arrive avec les compétences, les intégrations et le contexte d'entreprise de son rôle, plutôt que d'être un généraliste brut que vous devez câbler vous-même.

Pour le support en particulier, le coéquipier helpdesk se branche sur les outils que vous utilisez déjà, Zendesk, Freshdesk, Gorgias, Slack, apprend de vos anciens tickets et de votre centre d'aide et, surtout, vous permet de le simuler sur de vrais tickets historiques avant qu'il ne réponde à un client. C'est le problème de confiance que Solaris commence tout juste à nommer, résolu pour la seule tâche qui ne peut pas se permettre une mauvaise réponse convaincante. L'essai est gratuit, et vous pouvez le voir rédiger de vraies réponses sur vos propres tickets en quelques minutes.