

FLUX 3 Action est la partie du nouveau modèle de fondation de Black Forest Labs qui prédit des actions physiques plutôt que des pixels. L'astuce, c'est que c'est le même modèle qui génère de la vidéo, décodé autrement. L'argument de BFL : pour générer une vidéo convaincante, un modèle doit déjà apprendre comment le monde se comporte (contact, poids, cause et effet), donc prédire le prochain mouvement d'un robot n'est qu'une vue de plus de cette même compréhension.
Industrialisé sous le nom FLUX-mimic avec mimic robotics, il a été testé et déployé chez Audi sur des tâches que les robots conventionnels ne pourraient jamais aborder, comme la manipulation de câbles et de joints souples. Le chiffre clé : il a atteint un taux de réussite médian de 95 % sur une tâche de kitting d'objets souples, et il a battu les modèles de robots précédents même avec son backbone gelé, une configuration où le meilleur modèle antérieur obtenait 0 %.
Le hic pour la plupart des lecteurs : vous ne pouvez pas encore utiliser FLUX 3 Action. Il est réservé à des partenaires sélectionnés, sans API publique, prix ni poids. Si vous êtes venu chercher un agent IA que vous pouvez mettre au travail aujourd'hui, FLUX 3 est une infrastructure pour robots, pas une embauche. Cette distinction mérite d'être comprise, et c'est là que j'atterrirai à la fin.
Ce qu'est vraiment FLUX 3 Action
Commençons par clarifier les noms, car ils prêtent à confusion. FLUX 3 est un unique modèle de fondation multimodal de Black Forest Labs, le laboratoire derrière les modèles d'image FLUX. Il est entraîné conjointement sur l'image, la vidéo et l'audio, et l'entreprise le décrit comme « one multimodal model for Image, Video, Audio and Action-Prediction ».
Action-Prediction est cette quatrième capacité. Elle prend des observations visuelles plus une instruction textuelle et prédit des résultats physiques sous forme d'actions de commande de robot. « FLUX 3 Action » n'est donc pas un produit séparé à télécharger. C'est une capacité du backbone FLUX 3, et la version conçue pour de vrais robots, en partenariat avec mimic, s'appelle FLUX-mimic.
Le cadrage qu'utilise BFL est la partie intéressante. Selon leurs mots, un modèle capable à la fois de générer de la vidéo et de piloter des robots « was never really only a content creation model. It is a model of how the world behaves, and content creation is one thing one can do with it. » C'est une grande affirmation, alors voyons pourquoi elle pourrait être vraie.
Pourquoi un modèle vidéo peut piloter un robot
Voici le mécanisme, car c'est toute l'idée. Quand vous entraînez un modèle à générer de la vidéo réaliste, il n'a d'autre choix que d'apprendre la physique. Se tromper sur le poids d'un objet, sur la façon dont une main se referme dessus ou sur ce qui se passe quand deux choses se heurtent, et la vidéo paraît manifestement fausse. Apprendre à restituer le monde avec précision, c'est donc, sous le capot, apprendre comment le monde se comporte.
BFL met des chiffres réels là-dessus. La prédiction vidéo représente plus de 95 % du calcul d'entraînement total de FLUX 3. L'audio, en comparaison, représente moins de 0,5 % des tokens d'un clip 720p, car une fois que l'on comprend la vidéo, faire correspondre le son aux mouvements des lèvres et aux impacts est comparativement facile. Les actions suivent la même forme : l'état d'un robot est un signal de faible dimension étroitement couplé à ce que voit la caméra. Les images, l'audio et les actions sont toutes des vues partielles d'une même réalité physique sous-jacente, donc une fois que le modèle a appris cette réalité à partir de la vidéo, la prédiction d'actions n'est pas un nouveau départ.
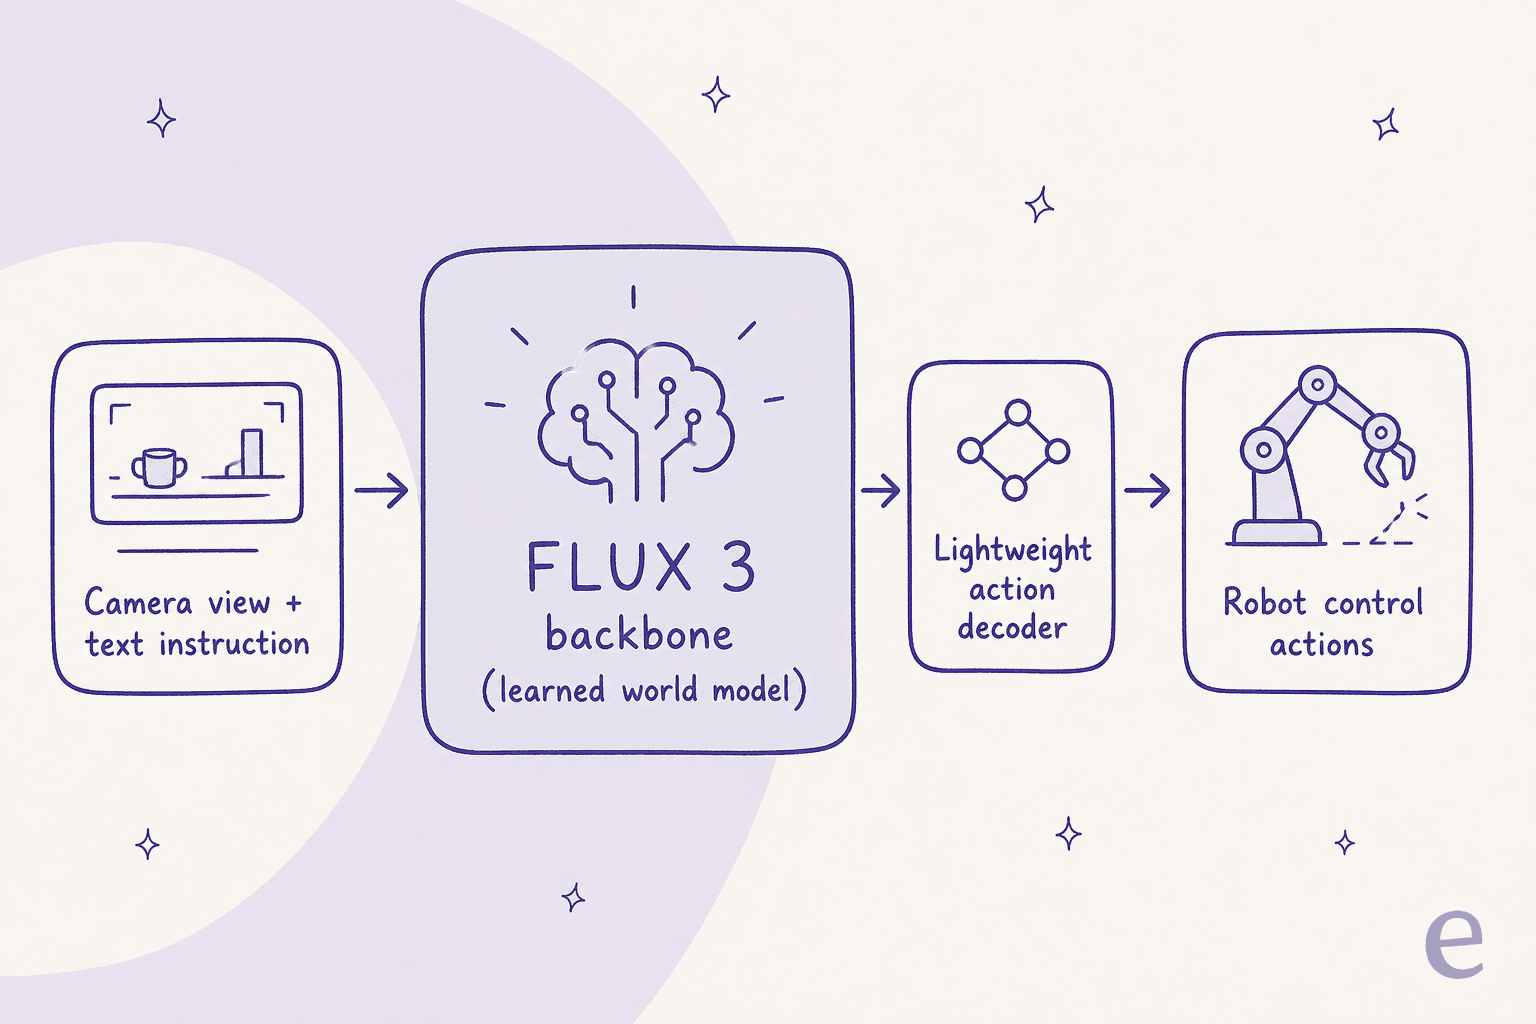
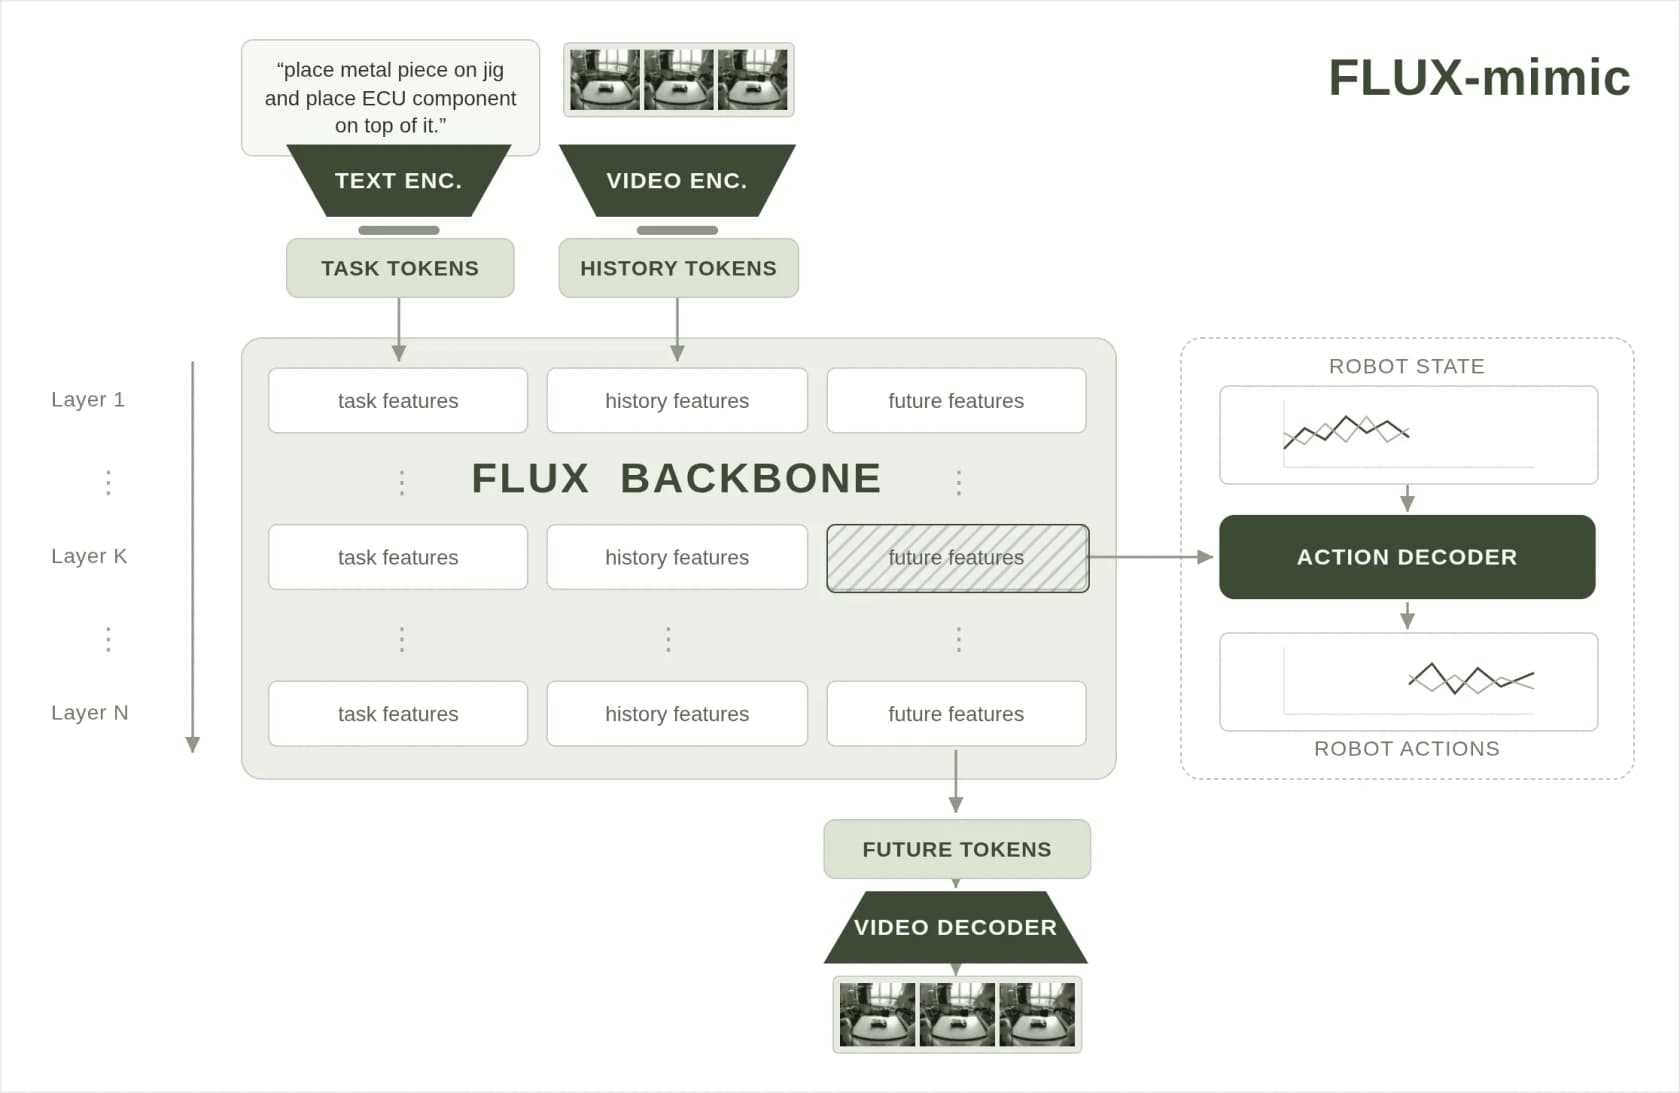
Le pipeline est volontairement épuré. Une vue de caméra et une instruction entrent dans le backbone FLUX 3, qui contient le modèle du monde appris. Un petit décodeur d'actions lit les caractéristiques intermédiaires directement dans le chemin de prédiction vidéo et les transforme en actions de commande. La partie coûteuse, comprendre le monde, est déjà faite avant que le robot ne bouge. C'est une approche distincte de la plupart des modèles vision-langage-action, entraînés de bout en bout pour produire des actions plutôt que de réutiliser un backbone génératif.
Ce qu'a coûté l'ajout des actions
Si les actions ne sont vraiment qu'une autre vue du même monde, apprendre à FLUX 3 à les prédire devrait être peu coûteux et ne pas abîmer ce qu'il sait déjà faire. C'est exactement ce que rapporte BFL. Lorsqu'ils ont ajouté la prédiction d'actions à un grand entraînement, les évaluations humaines du texte-vers-vidéo et de l'image-vers-vidéo ont d'abord chuté jusqu'à 10 % pendant que le modèle absorbait la nouvelle modalité. Après 3 500 étapes, la qualité vidéo était entièrement revenue à son niveau de départ, avec en plus la prédiction d'actions.
Cette récupération est la preuve de la thèse « un backbone, deux métiers ». Le modèle n'a pas sacrifié durablement la qualité vidéo au profit du contrôle de robots. Il a simplement dû comprendre comment la nouvelle modalité s'articulait avec le monde qu'il connaissait déjà, puis la pénalité a disparu. La recherche sur laquelle cela s'appuie s'appelle Self-Flow ; elle unifie génération et apprentissage de représentations, de sorte qu'améliorer l'un améliore l'autre.
On voit la séparation dans le schéma d'architecture de BFL. Les encodeurs de texte et de vidéo alimentent le backbone FLUX partagé, et les mêmes couches produisent des caractéristiques futures de deux manières : via un décodeur vidéo pour générer des images, et via un décodeur d'actions léger pour produire des actions de robot. Un tronc, deux têtes.
Ce que montrent vraiment les benchmarks
C'est là que FLUX 3 Action devient surprenant, alors je veux m'attarder sur les chiffres plutôt que de les survoler. Sur une tâche de kitting d'objets souples (le genre de manipulation de matériaux flexibles avec laquelle l'automatisation conventionnelle a toujours eu du mal), BFL a mesuré le taux de réussite médian sur 20 essais autonomes par modèle.
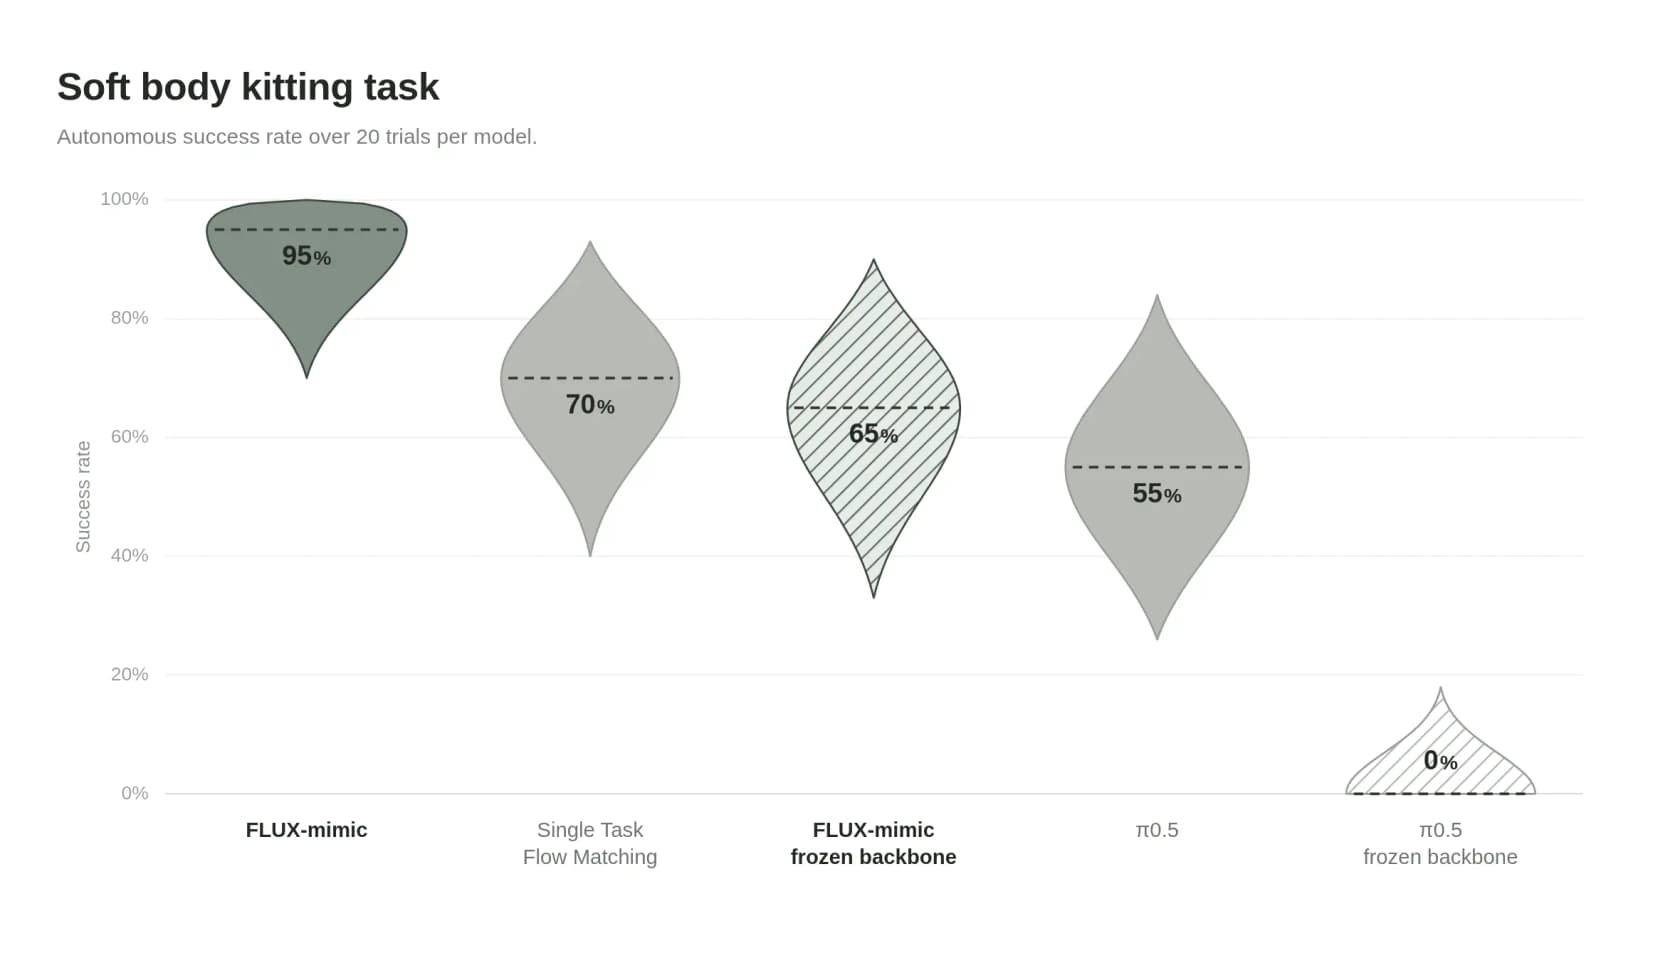
FLUX-mimic a atteint 95 %. Une base de référence de flow matching mono-tâche a atteint 70 %, et π0.5, un solide modèle vision-langage-action antérieur, 55 %. Le chiffre qui compte le plus, cependant, est la colonne du backbone gelé. Quand on gèle le backbone de FLUX-mimic (pas de fine-tuning, juste le modèle du monde pré-entraîné avec un décodeur par-dessus), il obtient quand même 65 %. Faites la même chose avec π0.5 et il obtient 0 %. Autrement dit, la représentation pré-entraînée de FLUX 3 est assez bonne pour piloter un robot avec presque aucun entraînement propre à la tâche, ce que les modèles précédents ne pouvaient pas revendiquer.
Quelques autres constats à retenir, car ils se cumulent :
- Efficacité en échantillons. Les travaux mimic-video rapportent jusqu'à 10 fois moins d'exemples qu'un modèle vision-langage-action pour atteindre la même capacité, parce que la physique est déjà dans la représentation.
- Auto-récupération. Un robot qui rate une saisie se corrige et réessaie, même si aucune démonstration n'a montré cette récupération. Elle vient du modèle du monde, pas du jeu d'entraînement.
- Vitesse. Le backbone va de l'entrée caméra à la représentation du monde en moins de 80 ms sur une seule NVIDIA RTX 5090, et la boucle complète du robot de mimic réagit en 101 ms, à peu près le temps de réaction visuelle humain.
Le point sur la vitesse est subtil mais important. Comme de meilleures représentations signifient plus de capacité par paramètre, BFL peut faire tourner un backbone plus petit (donc plus rapide) tout en atteignant le niveau de précision voulu. En robotique, la latence est la contrainte qui tue les déploiements, donc un backbone plus petit qui suit le monde réel compte plus que le taux de réussite brut.
Du laboratoire à l'atelier
Rien de tout cela ne compterait si cela ne fonctionnait qu'en simulation, donc le déploiement chez Audi est la preuve. Audi exploite l'un des réseaux de production les plus automatisés de l'industrie automobile, ce qui signifie qu'elle sait précisément où les robots conventionnels s'arrêtent encore : pièces souples, manipulation fine et diversité de variantes de la production premium, qui rend les cellules robotisées programmées à la main trop chères à reconcevoir cas par cas.
"In partnership with mimic, Audi has been testing and deploying FLUX-mimic. We have seen these robots solve complex soft-body manipulation work that would have been simply impossible with conventional robotics."
Les tâches citées par BFL sont concrètes : ranger des pièces dans des plateaux structurés, insérer des calculateurs électroniques dans des gabarits serrés, assembler des composants et manipuler des matériaux souples et flexibles comme les joints et les câbles. Cette dernière catégorie est celle qui est restée obstinément manuelle pendant des décennies, ce qui en fait un signal honnête de l'endroit où cette approche fait ses preuves.
Pouvez-vous vraiment utiliser FLUX 3 Action ?
Voici l'état honnête des choses, car l'enthousiasme dépasse la disponibilité. Black Forest Labs déploie FLUX 3 par phases, et la prédiction d'actions n'est pas quelque chose que l'on peut acheter.
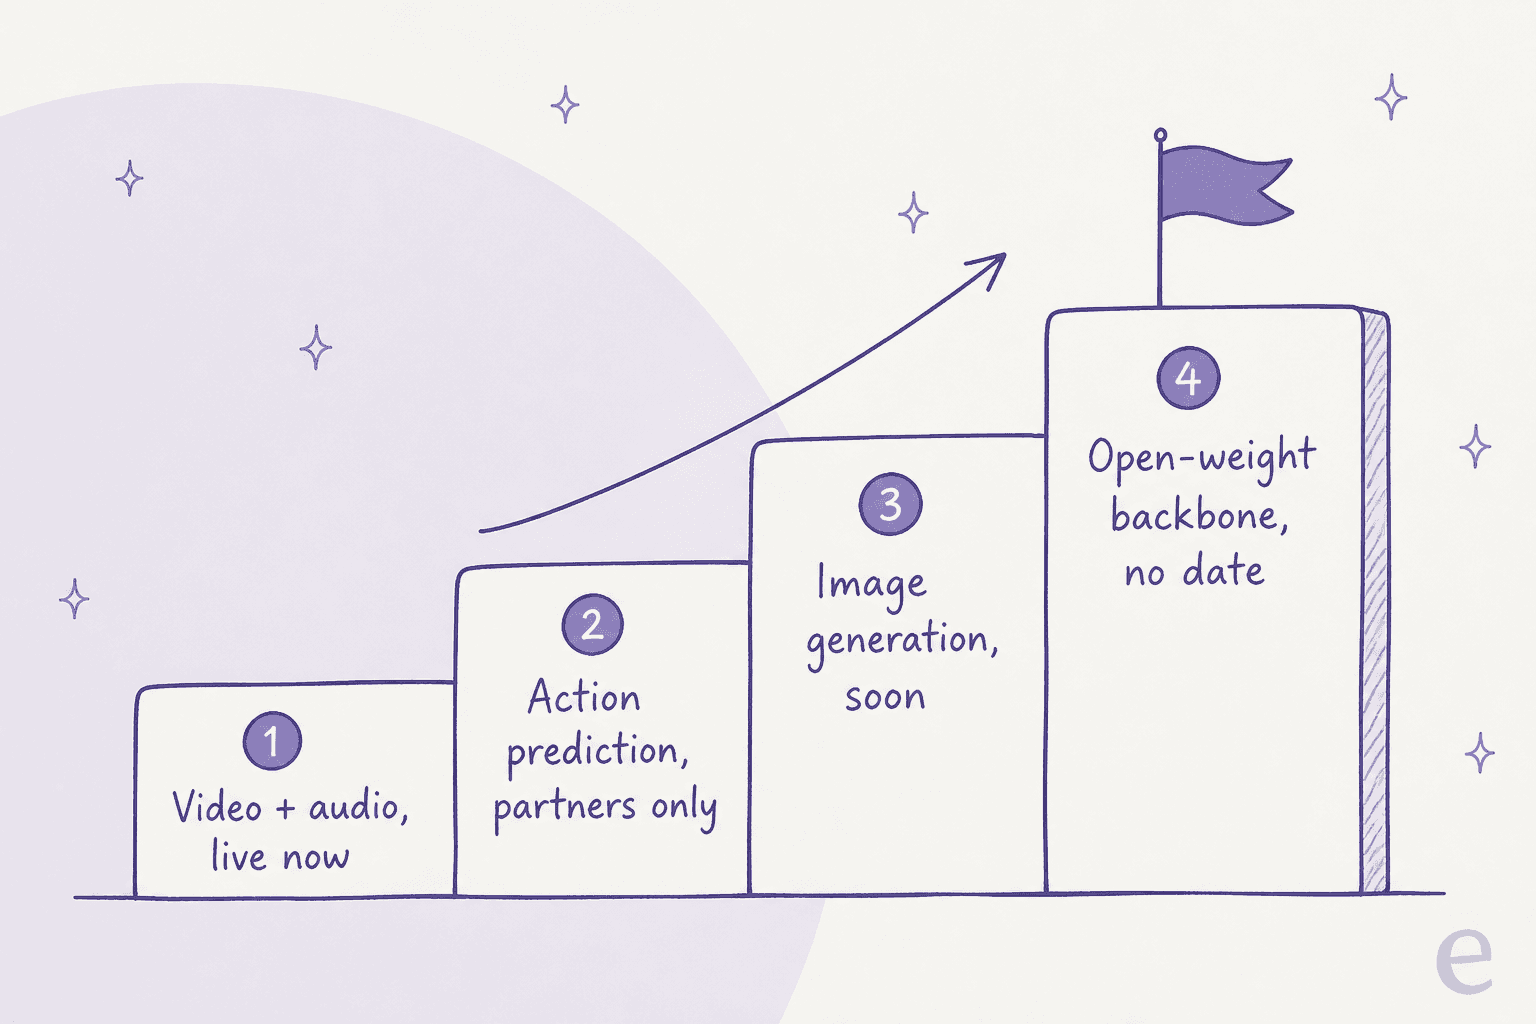
L'ordre de déploiement publié par BFL est : génération et édition vidéo d'abord, prédiction d'actions avec des partenaires sélectionnés, puis synthèse d'images, puis accès à poids ouverts au backbone. Aujourd'hui, seule la vidéo avec audio est généralement disponible. La prédiction d'actions est réservée aux partenaires (mimic a un accès anticipé), avec aucune API publique, aucun prix publié et aucun poids ouvert. La génération d'images de FLUX 3 est toujours marquée « soon », et le backbone à poids ouverts n'a aucune date.
Donc, si vous voulez toucher à FLUX 3 aujourd'hui, ce que vous pouvez réellement payer, c'est la vidéo : texte-vers-vidéo, image-vers-vidéo et vidéo-vers-vidéo jusqu'à 20 secondes, avec audio synchronisé natif, au paiement à l'usage selon les tarifs de l'API BFL, sans abonnement. Pour tout ce qui touche aux robots, vous observez un aperçu de recherche et un programme de partenaires, pas un produit. Ce n'est pas une critique, c'est simplement là où se trouve la frontière. L'IA physique passe lentement de partenaires sélectionnés à la disponibilité générale, pour de bonnes raisons.
Infrastructure contre le coéquipier que vous embauchez vraiment
Je veux prendre du recul, car « FLUX 3 Action » et des expressions comme « agent IA » sont jetés dans le même panier, alors qu'ils appartiennent à des étagères complètement différentes.
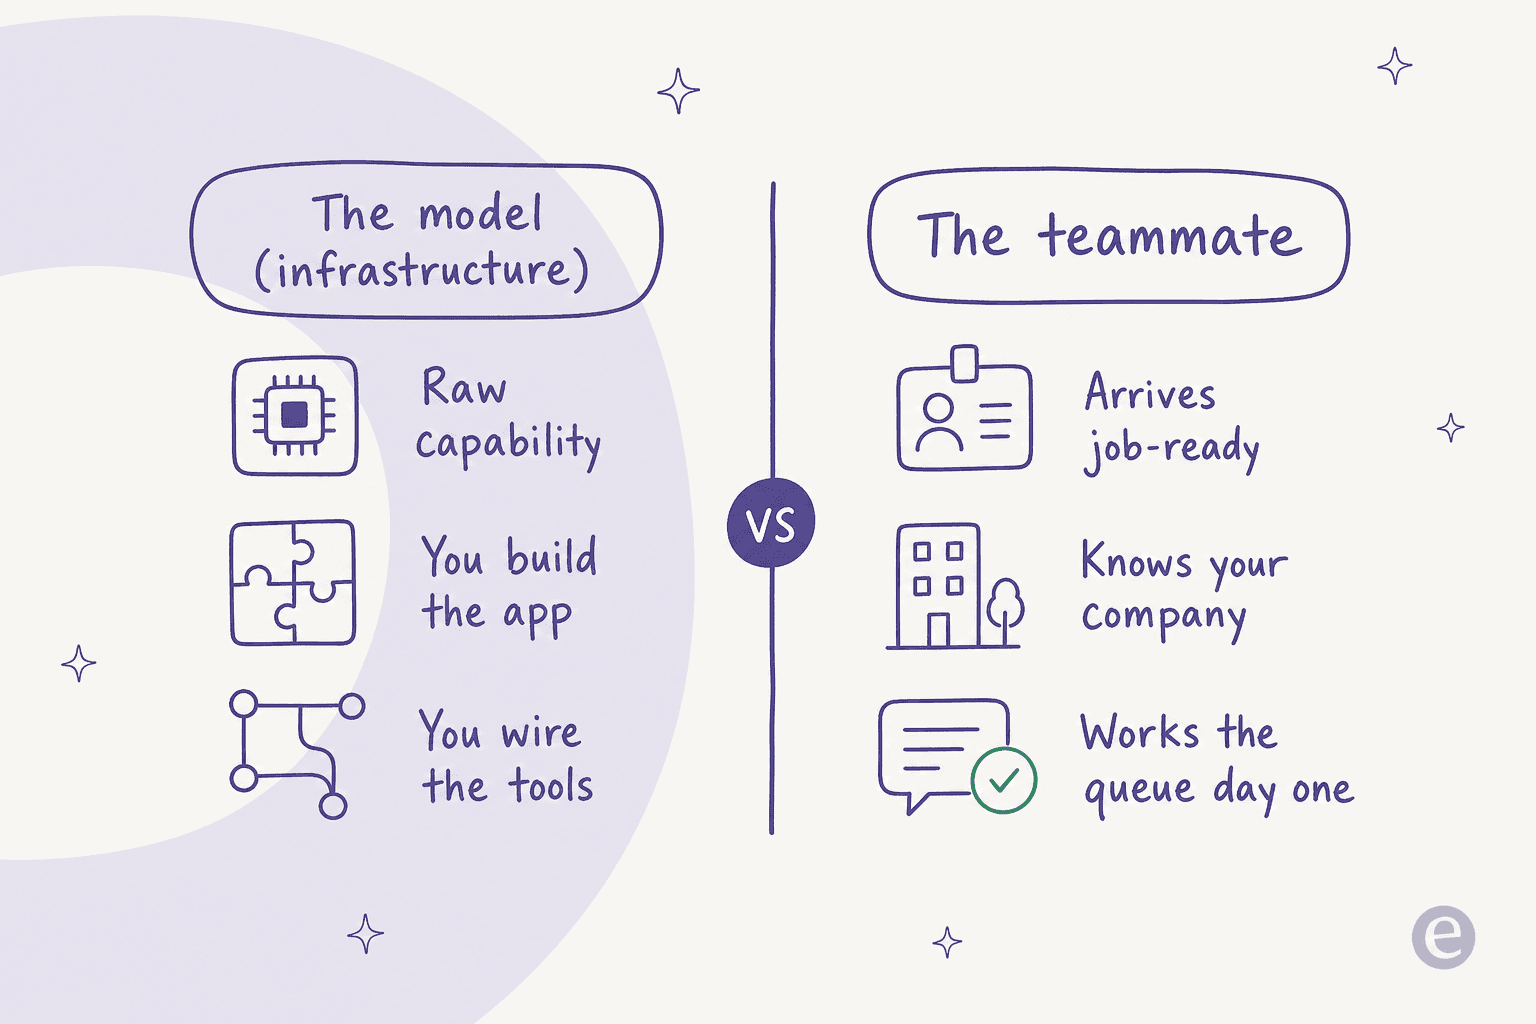
Un modèle de fondation comme FLUX 3 est une infrastructure. C'est de la capacité brute. Pour en tirer de la valeur, vous construisez l'application, branchez les outils, gérez le déploiement et (dans ce cas) le reliez à des robots physiques. C'est exactement la bonne forme pour un laboratoire de robotique ou une équipe de production automobile avec des ingénieurs. C'est la mauvaise forme pour un responsable du support qui a simplement besoin que les tickets reçoivent une réponse.
L'autre étagère, c'est le coéquipier IA : quelque chose qui arrive prêt à travailler, connaît déjà votre entreprise et commence dès le premier jour. Vous ne construisez pas d'application autour, vous le briefez comme une nouvelle recrue. C'est la couche sur laquelle je travaille, et il faut être clair : un modèle n'est pas un coéquipier, pas plus qu'un moteur n'est une voiture. FLUX 3 Action est un moteur remarquable pour l'IA physique. Ce n'est simplement pas ce que vous embauchez.
Comment cela se rattache à eesel
Chez eesel, nous prenons au sérieux le côté « employé, pas infrastructure » de cette ligne. eesel est une plateforme de coéquipiers IA : au lieu de vous remettre un modèle brut pour construire dessus, vous embauchez des coéquipiers prêts à travailler pour des missions précises. L'équipe actuelle comprend un coéquipier IA pour le helpdesk et un rédacteur de blog IA, chacun arrivant avec les compétences, les intégrations et le contexte d'entreprise dont son rôle a besoin.
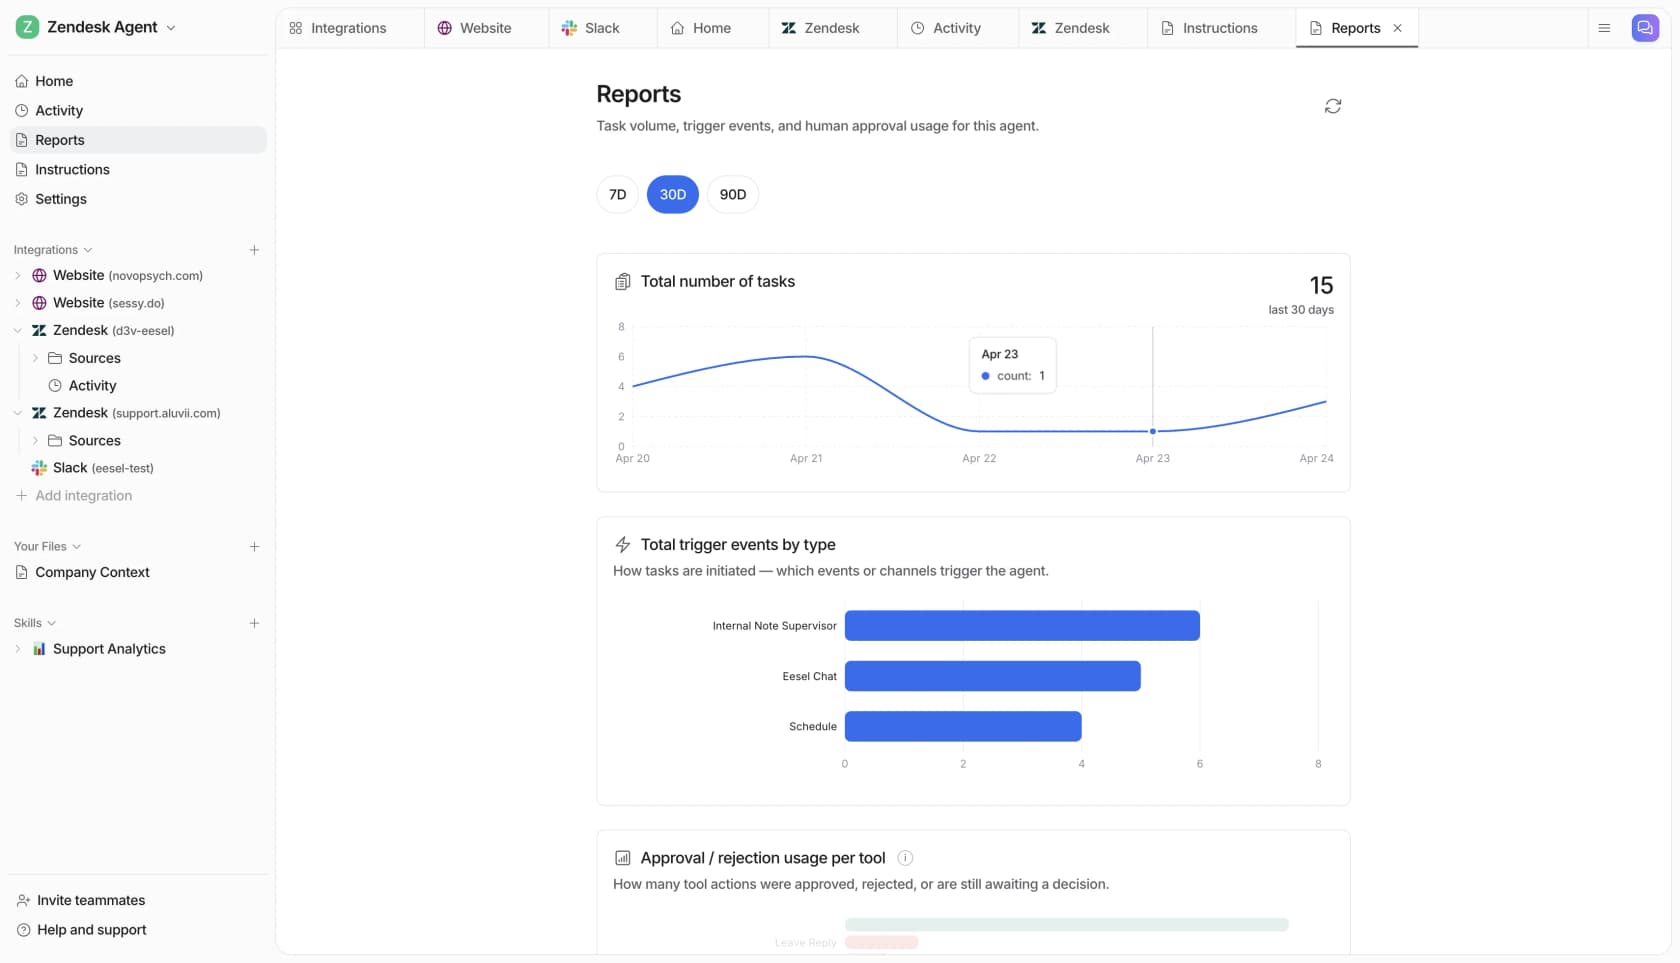
Comme le modèle sous-jacent est une cible mouvante (FLUX aujourd'hui, autre chose le trimestre prochain), l'abstraction utile est le coéquipier, pas la capacité brute. Le coéquipier helpdesk apprend de vos anciens tickets et de votre centre d'aide, rédige des réponses à relire, et vous pouvez le simuler sur vos propres tickets historiques avant sa mise en service, car j'ai vu des bots au ton assuré donner discrètement de mauvaises réponses et je préfère le détecter lors d'une répétition. Si vous aimez piloter depuis un terminal, la CLI d'eesel et son serveur MCP vous permettent (à vous ou à un agent de code comme Claude Code) de configurer des intégrations, de téléverser des connaissances et d'approuver des actions en JSON, de sorte que le même coéquipier est programmable sans le tableau de bord. Il ne pliera pas votre linge et ne tiendra pas une ligne d'usine. Mais pour répondre aux clients et écrire du contenu, c'est l'embauche, pas l'infrastructure. Il est gratuit à essayer.