

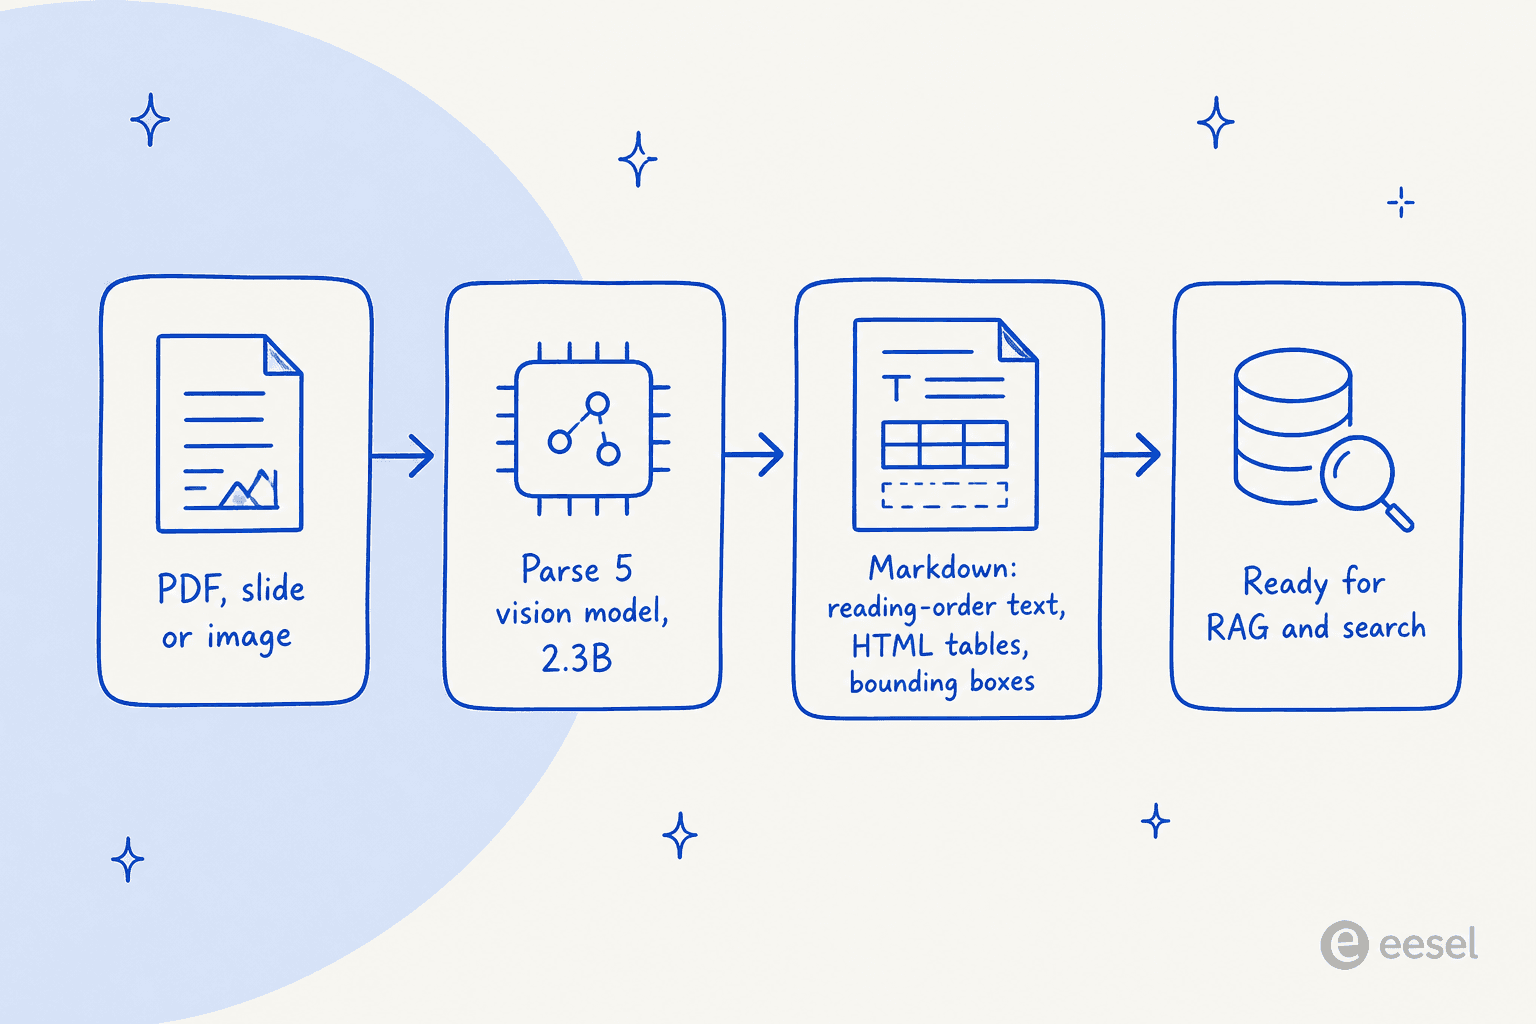
Cohere Parse 5 (identifiant de modèle parse-v5.0) est un petit modèle de vision de 2,3 milliards de paramètres qui lit une page de document et renvoie du Markdown propre : du texte dans l'ordre de lecture, des tableaux en HTML et des zones de délimitation pour les éléments visuels. Il est devenu disponible pour tous le 27 août 2026.
L'essentiel à retenir : il ne cherche pas à être l'analyseur le plus précis. Sur le ParseBench de Cohere lui-même, il obtient 79.2, derrière GPT-5.5 (84.4), Opus 4.8 (84.3) et Gemini 3.5 Flash (81.8). Là où il gagne, c'est sur le prix. À $1.50 per 1,000 pages (encore moins cher si vous l'hébergez vous-même sur Model Vault), il se place dans le coin « haute qualité, faible coût » que les grands modèles de pointe n'atteignent pas. Si vous analysez des centaines de milliers, voire des millions de pages, ce compromis fait tout l'argument.
Parse est une brique d'infrastructure, pas un produit fini. Il vous remet du Markdown ; il vous reste à l'intégrer, l'indexer, y récupérer des informations et construire quelque chose qui réponde aux questions. Si ce que vous voulez vraiment, c'est une IA qui lit votre base de connaissances de support et résout les tickets, vous n'avez pas besoin d'assembler ce pipeline vous-même, et c'est là qu'un outil comme eesel intervient.
Ce qu'est vraiment Cohere Parse 5
Cohere est l'entreprise d'IA pour les entreprises connue pour ses modèles de langage Command, ses modèles de recherche Embed et Rerank, et son fort accent sur le déploiement privé et souverain. Parse est son entrée dans l'analyse de documents, et Parse 5 (parse-v5.0) en est la version actuelle, annoncée le 27 août 2026 sous la formule « enterprise document intelligence at scale ».
Sa tâche est étroite et précise : vous lui donnez une page, il vous rend des données structurées et lisibles par machine. Cohere le décrit comme allant « beyond OCR » parce qu'il ne se contente pas de transcrire des caractères : il comprend les tableaux, les formulaires, les schémas et les images intégrées, puis renvoie le tout sous forme de Markdown propre prêt pour le traitement en aval. Cette sortie est tout l'enjeu. Le Markdown, c'est ce que l'on injecte dans un index de recherche, un pipeline RAG ou un agent IA.
Sous le capot, c'est un modèle compact : 2,3 milliards de paramètres, environ 4,6 Go, avec un contexte de 8 192 tokens, construit sur l'architecture north-micro-vision-instruct de Cohere. Cette petite taille est voulue. Un modèle de 2,3 Md est peu coûteux à exécuter et rapide à servir, et Cohere a misé sur les deux.
Comment fonctionne Parse 5
La mécanique est plus simple que dans la plupart des stacks d'analyse, car le modèle fait le gros du travail en une seule passe. Vous envoyez l'image d'une page, encodée en base64 sous forme de data URI, au point d'accès co.parse de l'API v2 de Cohere. Il renvoie du Markdown par défaut, ou un tableau blocks si vous voulez chaque zone de texte, de tableau et d'image séparée avec ses coordonnées.
Un appel minimal ressemble à ceci :
import base64, cohere

co = cohere.ClientV2("COHERE_API_KEY")

with open("document.png", "rb") as f:
    b64 = base64.b64encode(f.read()).decode("utf-8")

response = co.parse(
    model="parse-v5.0",
    document={"type": "image_url", "image_url": f"data:image/png;base64,{b64}"},
)

for page in response.pages:
    print(page.markdown.content)
Quelques détails à connaître avant de développer dessus. La documentation indique PDF, PowerPoint et JPEG comme formats pris en charge, mais le point d'accès en production n'accepte actuellement que des images, un data URI ou une URL d'image distante, donc les envois de PDF bruts ne sont pas encore câblés. Les images sont limitées à 20 Mo, 50 mégapixels ou 200 Mo décodées. Et les zones de délimitation ne sont renvoyées que pour les tableaux et les images, pas pour chaque ligne de texte, ce qui est un choix délibéré : le modèle préserve l'ordre de lecture dans le Markdown au lieu de déverser un nuage de coordonnées à réassembler.
Il est stable dans neuf langues (arabe, anglais, français, allemand, italien, japonais, coréen, portugais et espagnol), avec une gestion zero-shot d'autres langues à précision moindre. Cohere l'a entraîné sur des documents d'entreprise issus de la finance, de l'assurance et de la science, ce qui en dit long sur son public.
L'histoire du benchmark : il perd en points, il gagne en prix
Voici la partie sur laquelle tout le monde s'est focalisé. Cohere a publié un benchmark, ParseBench, qui note les analyseurs sur trois critères : leur capacité à extraire les tableaux, la fidélité avec laquelle ils reproduisent le texte sans omissions ni hallucinations, et leur capacité à préserver la mise en forme sémantique, comme le texte barré et l'italique. Et le graphique de Cohere lui-même montre Parse 5 derrière trois modèles plus gros.
| Modèle | Moyenne | Tableaux | Fidélité du contenu | Mise en forme sémantique |
|---|---|---|---|---|
| GPT-5.5 | 84.4 | 89.3 | 87.5 | 76.5 |
| Opus 4.8 | 84.3 | 89.7 | 89.0 | 74.1 |
| Gemini 3.5 Flash | 81.8 | 87.6 | 84.7 | 73.2 |
| Cohere Parse 5 | 79.2 | 87.0 | 86.6 | 64.0 |
| LlamaParse (cost-effective) | 78.3 | 81.4 | 90.9 | 62.7 |
| Chandra OCR 2 (open) | 77.7 | 89.2 | 83.7 | 60.3 |
| Mistral OCR 4 | 74.5 | 73.9 | 89.5 | 60.1 |
| Databricks AI Parse | 72.4 | 83.7 | 88.3 | 45.3 |
| Azure Document Intelligence | 69.3 | 86.0 | 84.9 | 37.0 |
| Google Document AI | 57.3 | 55.1 | 83.7 | 33.0 |
| AWS Textract | 53.3 | 82.3 | 74.8 | 2.8 |
Publier un benchmark que l'on ne domine pas est inhabituel, et c'est la démarche honnête. Parse 5 est solide sur les tableaux et la fidélité du contenu (87.0 et 86.6, proches des modèles de pointe) et plus faible sur la mise en forme sémantique (64.0). Il dépasse les analyseurs spécialisés, avec ce que Cohere appelle une « over 20-point improvement » sur AWS Textract et Google Document AI. Ce n'est simplement pas l'outil le plus affûté en précision pure.
L'argument se trouve dans le second graphique. Dès qu'on met le score en regard du prix, Parse 5 se déplace dans le coin que personne d'autre n'occupe.
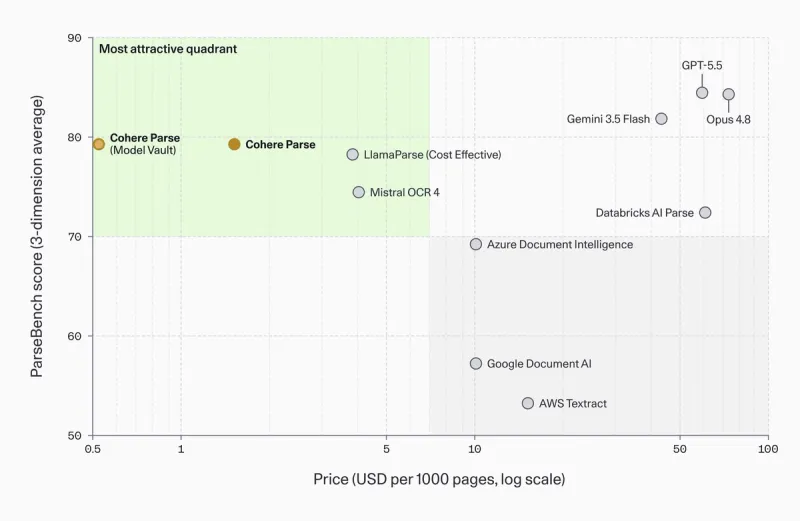
GPT-5.5 et Opus 4.8 obtiennent trois à cinq points de plus, mais se situent très à droite, à environ 40 à 50 fois le coût par page. Pour une revue de contrat ponctuelle, payez pour la précision. Pour un pipeline d'ingestion qui avale un million de factures par mois, cinq points de fidélité de mise en forme ne valent pas une facture 40 fois plus élevée. C'est le pari de Parse 5, et pour le traitement de documents à fort volume, il est raisonnable.
Le journaliste spécialisé dans la tech d'entreprise Sean Kerner a résumé l'ambiance autour du lancement :
"Text, document parsing should be a solved problem at this point right? But it's not.. every few weeks there is another option that claims to make it better. This week it's @cohere Parse 5."
Ce scepticisme est légitime. L'analyse de documents n'est pas « résolue », et Parse 5 ne prétend pas la résoudre. Il prétend réduire fortement le coût de le faire à grande échelle, une promesse plus étroite et plus défendable.
Débit et auto-hébergement
L'autre moitié de l'histoire du prix, c'est la vitesse. Sur un seul GPU H100, Parse 5 traite 4,5 pages par seconde, soit 36 pages par seconde (environ 2 160 par minute) sur un nœud de 8 GPU. Cohere l'a comparé à des analyseurs open source servis de la même façon, sur vLLM, et il arrive en tête.
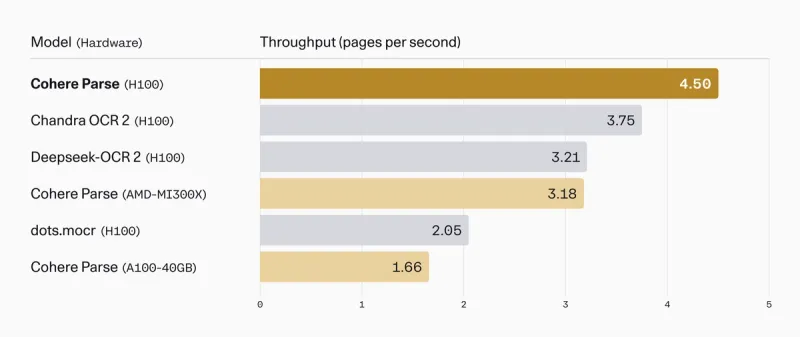
Un débit élevé sur un petit modèle est ce qui rend l'économie viable en auto-hébergement. Et l'auto-hébergement est bien l'angle de Cohere ici. Au-delà de l'API standard, Parse 5 fonctionne comme instance Model Vault dédiée, sur Microsoft Foundry, sur Amazon SageMaker, ou de façon entièrement privée et isolée du réseau, ce qui compte si vous analysez des documents que la loi vous interdit d'envoyer à une API tierce. Il existe aussi un Space de démonstration gratuit sur Hugging Face si vous voulez simplement lui soumettre une page.
Tarifs de Cohere Parse 5
Parse 5 propose deux modèles de tarification, et le bon choix dépend entièrement du volume.
| Option | Prix | Remarques |
|---|---|---|
| API Cohere | $1.50 / 1,000 pages | Paiement à la page. Limite de 500 requêtes/minute. La clé d'essai gratuite autorise 1 000 appels/mois. |
| Model Vault, instance Medium | $4.00 / hour ($2,500 / month) | Instance dédiée mono-locataire. |
| Model Vault, instance XL | $7.00 / hour ($4,300 / month) | Instance dédiée à plus haut débit. |
Le tarif à la page est le titre, et à $1.50 per 1,000 pages, c'est vraiment l'une des options hébergées les moins chères. Les instances dédiées sont celles où les économies s'accumulent. Le calcul de Cohere : à 50 % d'utilisation du GPU, Model Vault revient 23 % moins cher par page que l'API, et à pleine utilisation l'écart atteint 61 %.
Leur exemple chiffré rend cela concret. Un flux de comptes fournisseurs traitant environ 13 millions de pages par mois sur Model Vault plutôt que sur l'API économise environ 12 000 $ par mois, soit 144 000 $ par an. Comparé à un analyseur d'hyperscaler facturé 10 $ pour 1 000 pages, ce seul flux économise environ 1,47 million de dollars par an. Ce sont les chiffres de Cohere sur les hypothèses de Cohere, donc considérez-les comme un meilleur cas, mais la tendance est réelle : à fort volume, les coûts d'analyse par page grimpent vite, et un modèle moins cher est un levier important.
Ce qu'il ne sait pas faire
Être honnête sur les limites rend l'argument du prix crédible, les voici donc. Parse 5 ne produit que du Markdown, pas du JSON structuré, donc si vous avez besoin d'un schéma strict, vous analysez vous-même le Markdown en aval. Il ne renvoie aucun score de confiance, vous ne pouvez donc pas signaler automatiquement les extractions peu fiables pour une relecture humaine. Et il ne classe pas les éléments du document comme les en-têtes, les pieds de page ou la hiérarchie typographique. Rien de tout cela n'est rédhibitoire pour un travail d'ingestion en masse, mais chaque point est une lacune si vous espériez l'intégrer à un flux qui exige des indicateurs de certitude ou un format de sortie rigide.
Où Parse 5 s'intègre (et où il ne s'intègre pas)
C'est la partie qui déroute, alors soyons clairs. Parse 5 est une couche d'analyse. Il transforme des pages en texte. À lui seul, il ne répond à aucune question. Pour passer de « documents » à « une IA qui aide quelqu'un », vous l'enchaînez dans une stack de recherche : analyser les documents, vectoriser les extraits, reclasser les correspondances, puis confier les meilleurs passages à un modèle pour générer une réponse fondée. Cohere vend les trois pièces, regroupées dans sa plateforme Compass.
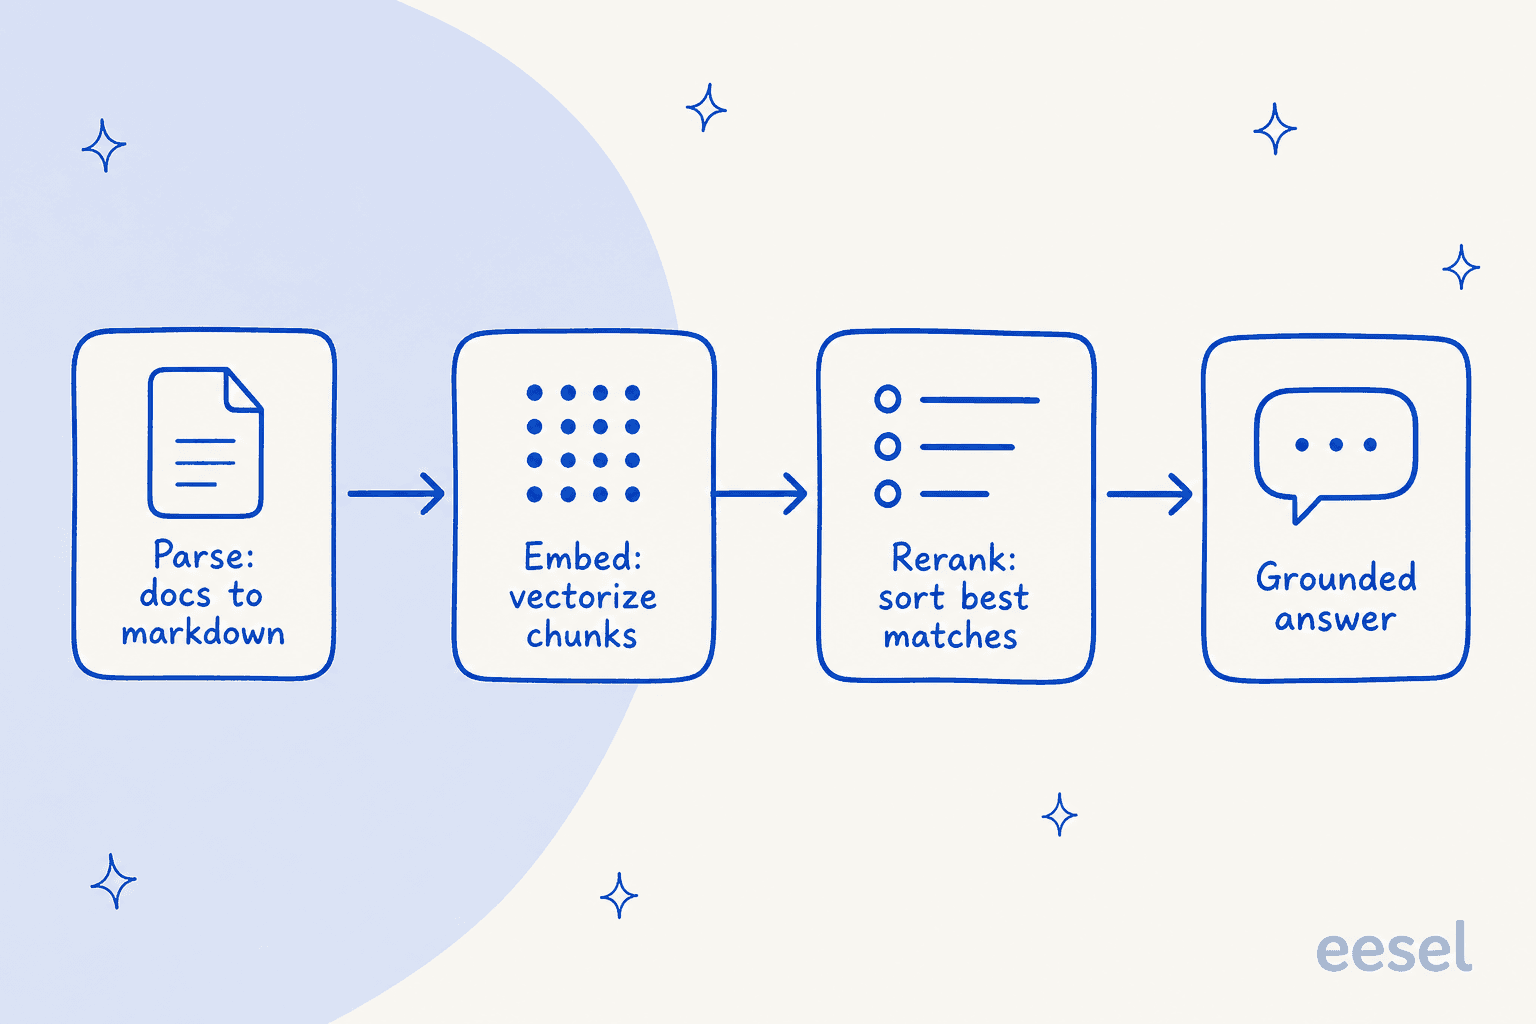
C'est une excellente boîte à outils si vous êtes une équipe plateforme qui construit une intelligence documentaire sur mesure et veut un contrôle maximal à chaque étape. C'est beaucoup d'assemblage si votre but réel est plus courant, comme une IA qui lit votre centre d'aide et vos anciens tickets et résout les questions des clients. Dans ce cas, vous ne cherchez pas un analyseur du tout, vous cherchez le collaborateur prêt à l'emploi, et construire vous-même le pipeline analyse, vectorisation, reclassement et génération est un détour.
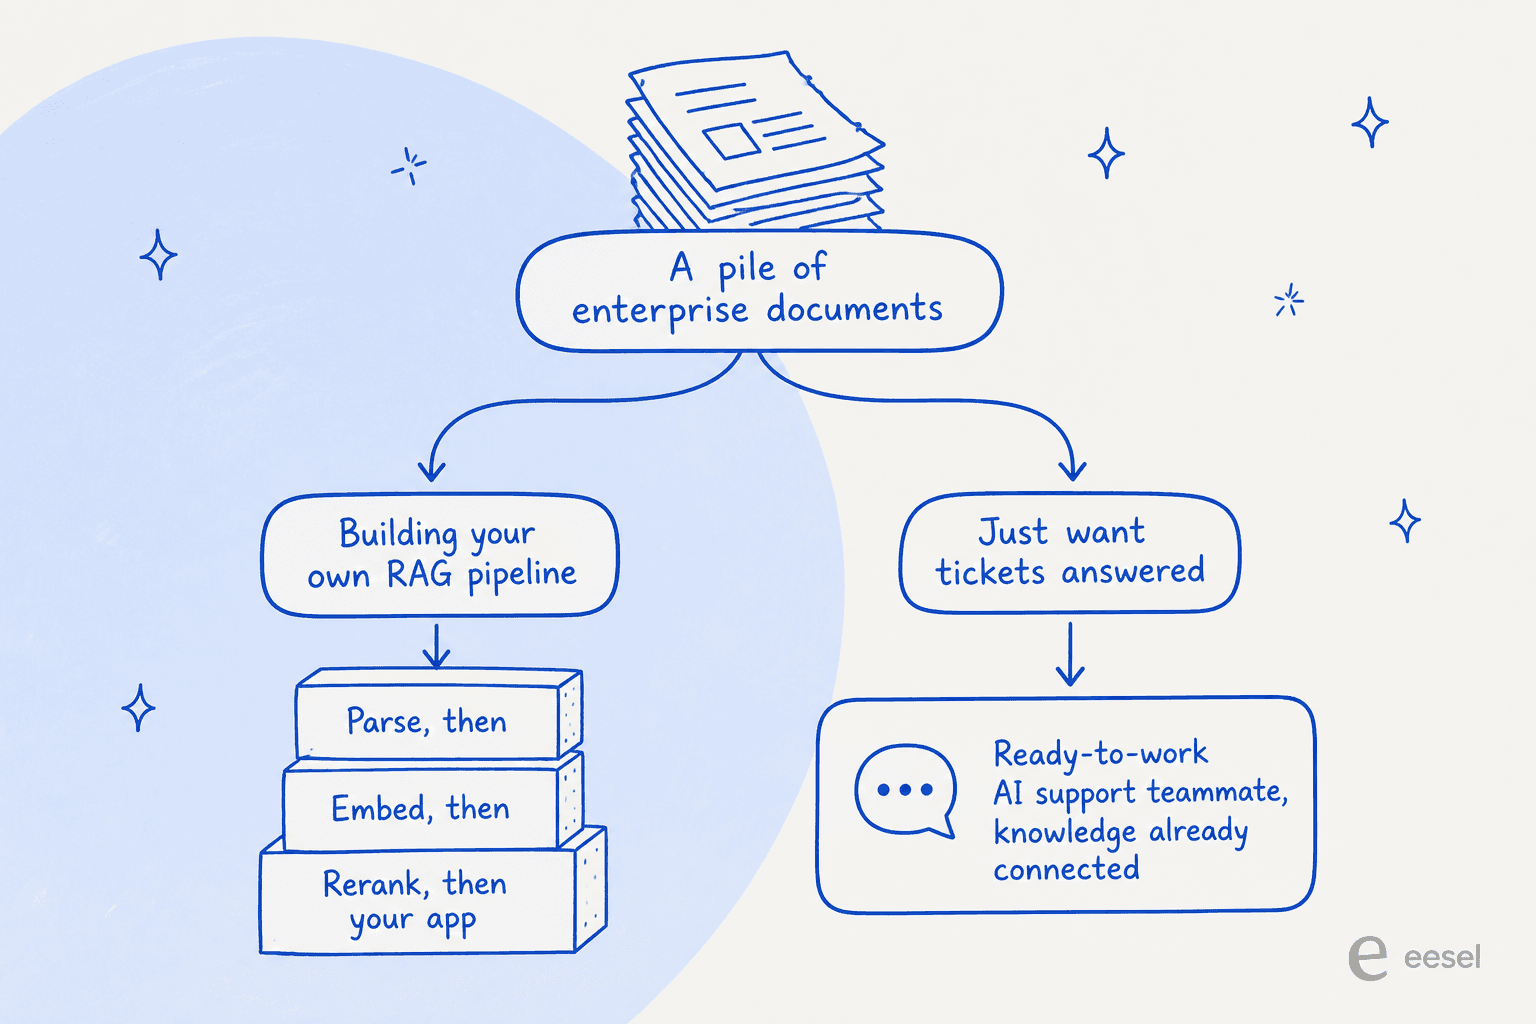
La distinction est la même que celle qui sépare un moteur de voiture d'une voiture. Parse 5 est un très bon moteur, très bon marché. Savoir si vous voulez construire le reste de la voiture autour est la vraie question.
Essayez eesel pour un support qui répond tout simplement
Si votre intérêt pour un modèle d'analyse vient d'un problème de support, cet écart entre moteur et voiture est exactement celui que eesel comble. eesel est une plateforme de coéquipiers IA, et son coéquipier IA pour helpdesk est une version prête à l'emploi de toute la stack : il se connecte directement à votre centre d'aide, Confluence, Google Docs et à vos anciens tickets, apprend d'eux et résout les tickets dans Zendesk, Freshdesk, Gorgias, Slack ou un lien de chat partageable. Pas de pipeline d'analyse à assembler, pas de base de données vectorielle à exploiter.

Le plus difficile à contrefaire, c'est la confiance nécessaire pour l'activer. Nous faisons tourner de l'IA sur de vraies files de support depuis des années, et nous avons vu un bot au ton assuré donner discrètement de mauvaises réponses, c'est pourquoi eesel simule chaque déploiement sur vos tickets historiques avant qu'il ne touche un vrai client, pour que vous voyiez le taux de résolution et les réponses exactes qu'il aurait envoyées. Parse 5 peut faire partie de la façon dont une équipe comme la nôtre déplace des documents. Ce n'est pas le coéquipier. Vous pouvez essayer eesel gratuitement.
Questions fréquentes
Qu'est-ce que Cohere Parse 5 ?
parse-v5.0) est un modèle de vision et de langage de 2,3 milliards de paramètres qui transforme des pages de documents en Markdown propre, avec les tableaux en HTML et des zones de délimitation pour les éléments visuels. Il est conçu pour alimenter à grande échelle des pipelines RAG, des index de recherche et des agents IA.Combien coûte Cohere Parse 5 ?
1,50 $ pour 1 000 pages. Pour les charges lourdes, vous pouvez l'exécuter sous forme d'instance Model Vault dédiée (Medium à 4,00 $/heure, XL à 7,00 $/heure), ce qui, selon Cohere, réduit le coût par page de 23 à 61 % à grande échelle. Comparez avec une analyse de coût agent IA contre agent humain avant de vous engager.