

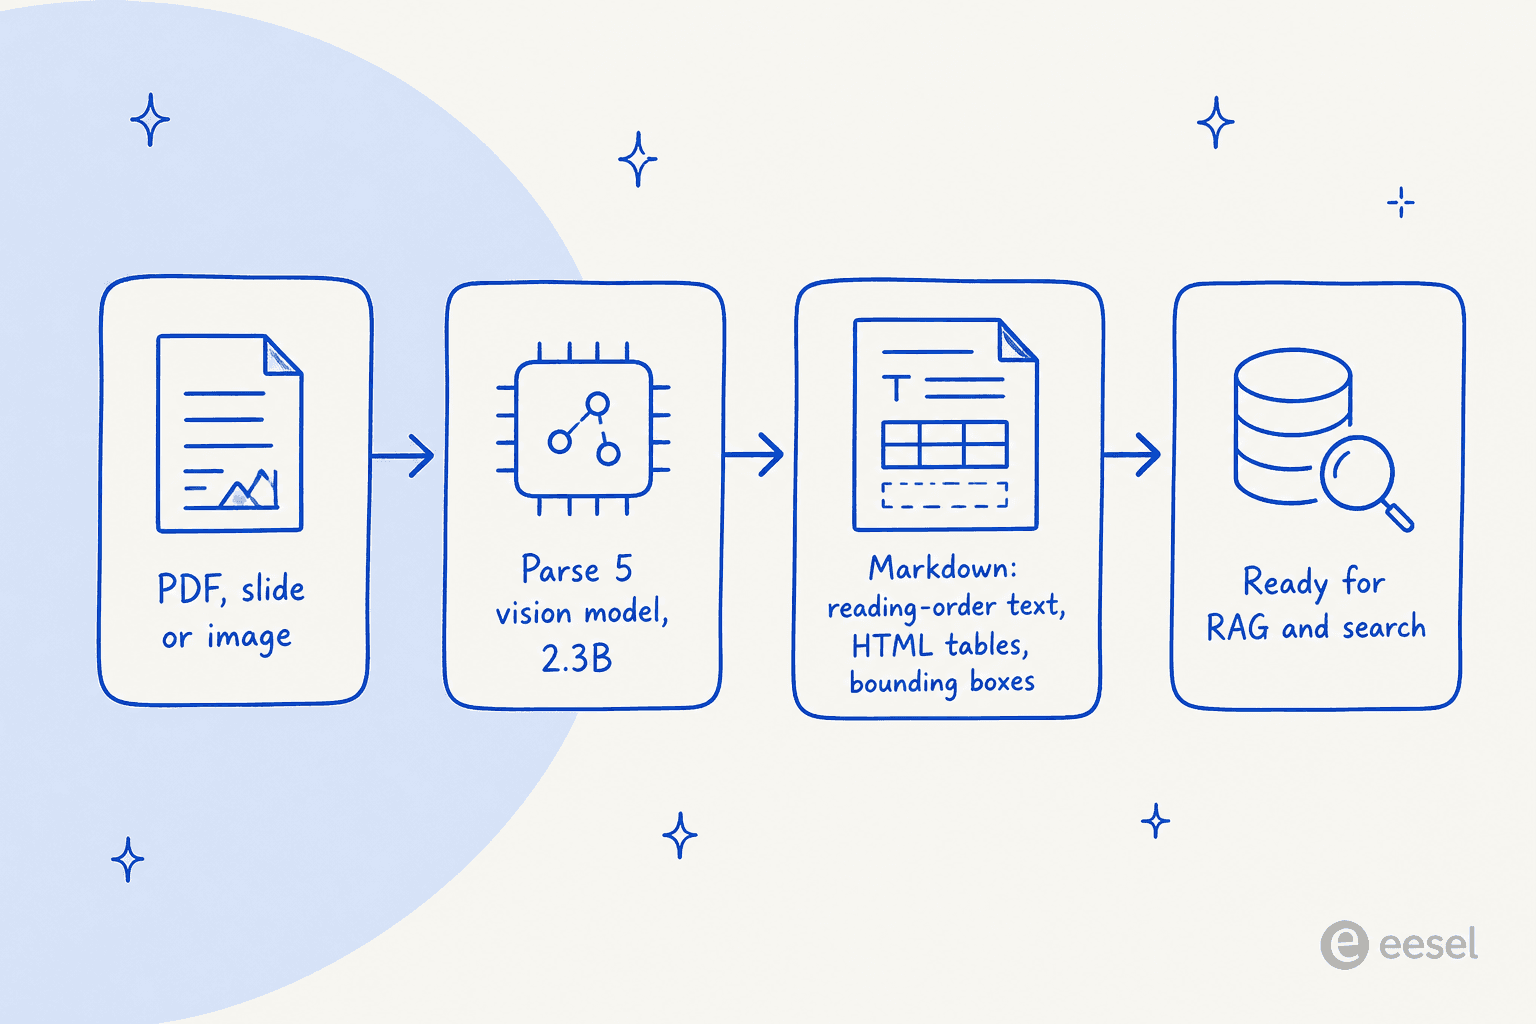
Cohere Parse 5(モデルID parse-v5.0)は、文書のページを読み取り、きれいなMarkdownを返す23億パラメータの小型ビジョンモデルです。テキストは読み順どおりに、表はHTMLで、視覚要素にはバウンディングボックスが付きます。2026年8月27日に一般提供が始まりました。
押さえておきたい点は、最も正確なパーサーを目指していないということです。Cohere自身のParseBenchでのスコアは 79.2 で、GPT-5.5(84.4)、Opus 4.8(84.3)、Gemini 3.5 Flash(81.8)に及びません。勝っているのは価格です。$1.50 per 1,000 pages(Model Vaultで自前ホストすればさらに安く)で、大型の最先端モデルが届かない「高品質・低コスト」の領域に位置しています。数十万〜数百万ページを処理するなら、このトレードオフがそのまま売りになります。
Parseはインフラの部品であり、完成した製品ではありません。渡されるのはMarkdownです。埋め込み、インデックス作成、検索、質問に答える仕組みの構築は自分で行う必要があります。サポートの知識を読み込んでチケットを解決するAIが欲しいだけなら、そのパイプラインを自分で組む必要はありません。そこで登場するのがeeselのようなツールです。
Cohere Parse 5とは何か
Cohereは、Command言語モデル、EmbedとRerankの検索モデル、そしてプライベートでソブリンな展開への注力で知られるエンタープライズAI企業です。Parseは同社の文書パース分野への参入製品で、Parse 5(parse-v5.0)は現行バージョンです。2026年8月27日に「enterprise document intelligence at scale」というキャッチフレーズとともに発表されました。
役割は狭く明確です。ページを渡すと、構造化された機械可読データが返ってきます。Cohereはこれを「beyond OCR」と表現しています。文字を書き起こすだけでなく、表、フォーム、図、埋め込み画像を理解し、すべてを後続処理にそのまま使えるきれいなMarkdownとして返すからです。この出力が肝心です。Markdownは、検索インデックス、RAGパイプライン、AIエージェントに投入するものです。
中身はコンパクトなモデルです。23億パラメータ、約4.6GB、コンテキストは8,192トークンで、Cohereの north-micro-vision-instruct アーキテクチャをベースにしています。この小ささは意図的なものです。2.3Bのモデルは動かすコストが低く、配信も速く、Cohereはその両方を突き詰めました。
Parse 5の仕組み
多くのパースのスタックより仕組みはシンプルです。重い処理をモデルが1回の処理でこなすからです。base64でエンコードしたdata URI形式のページ画像を、Cohereのv2 APIの co.parse エンドポイントに送ります。デフォルトではMarkdownが返り、テキスト・表・画像の各領域を座標つきで個別に取り出したい場合は blocks 配列を指定できます。
最小限の呼び出しは次のようになります。
import base64, cohere

co = cohere.ClientV2("COHERE_API_KEY")

with open("document.png", "rb") as f:
    b64 = base64.b64encode(f.read()).decode("utf-8")

response = co.parse(
    model="parse-v5.0",
    document={"type": "image_url", "image_url": f"data:image/png;base64,{b64}"},
)

for page in response.pages:
    print(page.markdown.content)
実装前に知っておきたい点がいくつかあります。ドキュメントには対応形式としてPDF、PowerPoint、JPEGが挙がっていますが、稼働中のエンドポイントが現在受け付けるのは画像のみ(data URIまたはリモートの画像URL)で、生のPDFアップロードはまだ使えません。画像入力の上限は、20MB、50メガピクセル、またはデコード後200MBです。また、バウンディングボックスが返るのは表と画像のみで、テキストの全行には付きません。これは意図的な設計です。再構成が必要な座標の山を出力する代わりに、Markdown内で読み順を保持します。
9言語で安定して動作します(アラビア語、英語、フランス語、ドイツ語、イタリア語、日本語、韓国語、ポルトガル語、スペイン語)。それ以外の言語もゼロショットで扱えますが、精度は下がります。Cohereは金融、保険、科学分野の業務文書で学習させており、想定している利用者がうかがえます。
ベンチマークの話:点数では負け、価格で勝つ
ここが皆の注目を集めた部分です。CohereはParseBenchというベンチマークを公開しました。パーサーを3つの観点で採点します。表をどれだけうまく抽出できるか、欠落や幻覚なくテキストをどれだけ忠実に再現できるか、取り消し線や斜体といった意味的な書式をどれだけ保持できるかです。そしてCohere自身のグラフでは、Parse 5は3つの大型モデルの後ろに位置しています。
| モデル | 平均 | 表 | 内容の忠実度 | 意味的な書式 |
|---|---|---|---|---|
| GPT-5.5 | 84.4 | 89.3 | 87.5 | 76.5 |
| Opus 4.8 | 84.3 | 89.7 | 89.0 | 74.1 |
| Gemini 3.5 Flash | 81.8 | 87.6 | 84.7 | 73.2 |
| Cohere Parse 5 | 79.2 | 87.0 | 86.6 | 64.0 |
| LlamaParse (cost-effective) | 78.3 | 81.4 | 90.9 | 62.7 |
| Chandra OCR 2 (open) | 77.7 | 89.2 | 83.7 | 60.3 |
| Mistral OCR 4 | 74.5 | 73.9 | 89.5 | 60.1 |
| Databricks AI Parse | 72.4 | 83.7 | 88.3 | 45.3 |
| Azure Document Intelligence | 69.3 | 86.0 | 84.9 | 37.0 |
| Google Document AI | 57.3 | 55.1 | 83.7 | 33.0 |
| AWS Textract | 53.3 | 82.3 | 74.8 | 2.8 |
自社が首位でないベンチマークを公開するのは珍しく、誠実な姿勢です。Parse 5は表と内容の忠実度(87.0 と 86.6、最先端モデルに近い値)に強く、意味的な書式(64.0)は弱めです。専門のパーサーには勝っており、AWS TextractとGoogle Document AIに対してCohereが言う「over 20-point improvement」を達成しています。ただ、純粋な精度では最も鋭い道具ではありません。
主張の核心は2つ目のグラフにあります。スコアを価格に対してプロットすると、Parse 5は他の誰もいない領域に入ります。
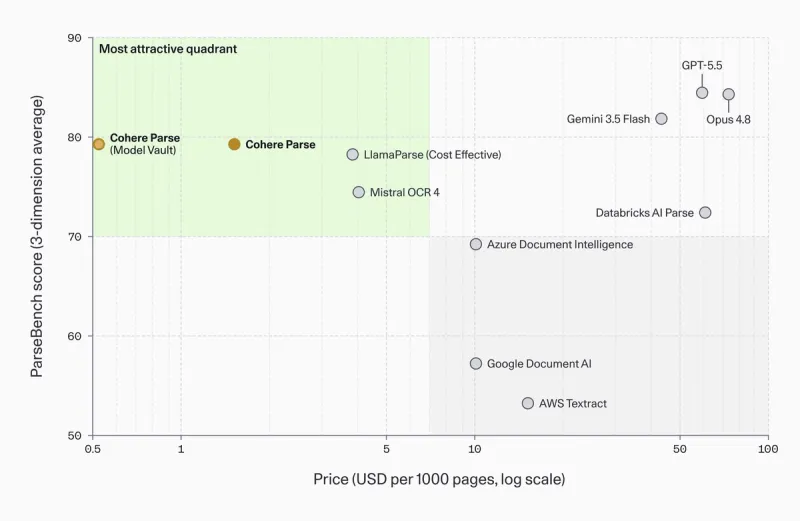
GPT-5.5とOpus 4.8は3〜5ポイント高いスコアですが、グラフでははるか右側にあり、1ページあたりのコストはおよそ40〜50倍です。1回きりの契約書レビューなら、精度にお金を払う価値があります。月に100万枚の請求書を処理する取り込みパイプラインでは、書式の忠実度5ポイントのために40倍の請求を払う価値はありません。これがParse 5の賭けであり、大量の文書処理では妥当な選択です。
エンタープライズ技術ジャーナリストのSean Kernerは、発表時の空気をこうまとめました。
"Text, document parsing should be a solved problem at this point right? But it's not.. every few weeks there is another option that claims to make it better. This week it's @cohere Parse 5."
この懐疑はもっともです。文書パースは「解決済み」ではなく、Parse 5もそうは主張していません。主張しているのは、大規模に行う際のコストを大幅に下げるという、より狭く、より擁護しやすい約束です。
スループットとセルフホスト
価格の話のもう半分は速度です。H100 GPU 1枚で、Parse 5は毎秒4.5ページを処理します。8GPUノードでは毎秒36ページ(1分あたり約2,160ページ)になります。Cohereは、同じ方法でvLLM上に配信したオープンソースのパーサーと比較し、Parse 5が上回りました。
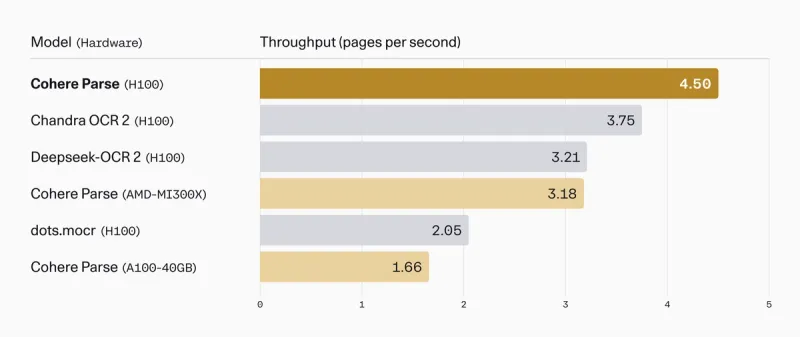
小さなモデルで高いスループットが出ることが、セルフホスト時の採算を成り立たせます。そしてセルフホストはまさにCohereが狙う方向です。標準のAPIに加え、Parse 5は専用のModel Vaultインスタンス、Microsoft Foundry、Amazon SageMaker、あるいは完全に非公開のエアギャップ環境でも動きます。法的に第三者のAPIへ送れない文書を処理する場合に重要です。気軽に1ページ試したいなら、Hugging Faceに無料のデモSpaceもあります。
Cohere Parse 5の料金
Parse 5には2つの料金モデルがあり、どちらが合うかは処理量しだいです。
| オプション | 価格 | 備考 |
|---|---|---|
| Cohere API | $1.50 / 1,000 pages | ページ単位の従量課金。レート制限は毎分500リクエスト。無料トライアルキーは月1,000回の呼び出しまで。 |
| Model Vault、Mediumインスタンス | $4.00 / hour($2,500 / month) | 専用のシングルテナントインスタンス。 |
| Model Vault、XLインスタンス | $7.00 / hour($4,300 / month) | より高スループットの専用インスタンス。 |
ページあたりの料金が目玉で、$1.50 per 1,000 pages はホスト型としては本当に安い部類です。専用インスタンスでは節約がさらに積み上がります。Cohereの試算では、GPU使用率50%でModel VaultはAPIよりページあたり23%安く、使用率が最大になると差は61%に広がります。
同社の具体例がわかりやすいです。月に約1,300万ページを処理する買掛金ワークフローをAPIではなくModel Vaultで動かすと、月およそ1万2,000ドル、年間14万4,000ドルの節約になります。1,000ページあたり10ドルのハイパースケーラー製パーサーと比べると、このワークフローだけで年間約147万ドルを節約できます。これはCohereの前提によるCohereの数字なので最良のケースと考えるべきですが、方向性は確かです。大量処理ではページあたりのパース費用がすぐに膨らむため、より安いモデルは大きな武器になります。
できないこと
限界を正直に示してこそ、価格の主張に信頼性が生まれます。Parse 5はMarkdownのみを出力し、構造化JSONは出せません。厳密なスキーマが必要なら、後段でMarkdownを自分で解析することになります。信頼度スコアも返さないため、確信度の低い抽出を自動的に人間のレビューへ回すことはできません。また、ヘッダー、フッター、フォント階層といった文書要素の分類も行いません。大量の取り込み処理ではどれも致命的ではありませんが、確実性のフラグや厳格な出力形式が必要なワークフローに組み込もうとしていたなら、いずれも不足点になります。
Parse 5が向く場面と向かない場面
ここは混同しやすい点なので、はっきりさせます。Parse 5はパースの層です。ページをテキストに変えます。それだけでは、ひとつの質問にも答えません。「文書」から「誰かを助けるAI」に至るには、検索スタックの中でつなぎます。文書をパースし、チャンクをベクトルへ埋め込み、一致した結果をリランクし、最良の箇所をモデルに渡して根拠のある回答を生成させます。Cohereはこの3つをまとめて、Compassプラットフォームとして販売しています。
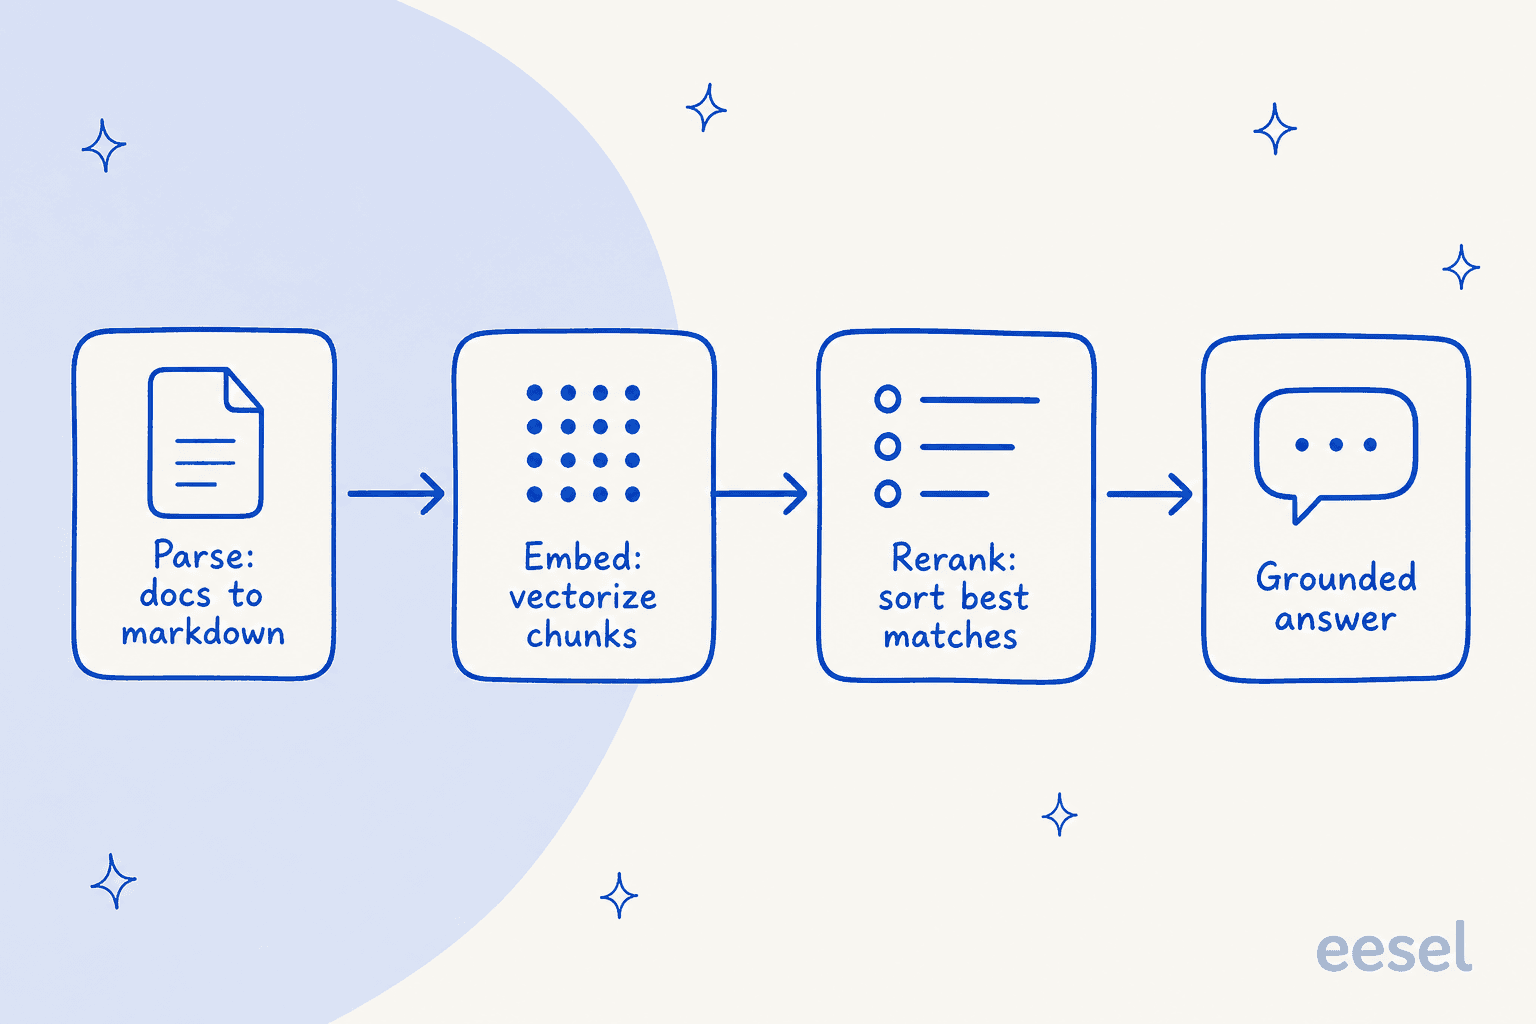
独自の文書インテリジェンスを構築し、各段階を最大限に制御したいプラットフォームチームには優れたツールセットです。一方、本当の目的が、ヘルプセンターと過去のチケットを読み込んで顧客の質問を解決するAIのような、もっと身近なものなら、組み立てが多すぎます。その場合に探しているのはパーサーではなく、完成した働き手であり、パース、埋め込み、リランク、生成のパイプラインを自作するのは遠回りです。
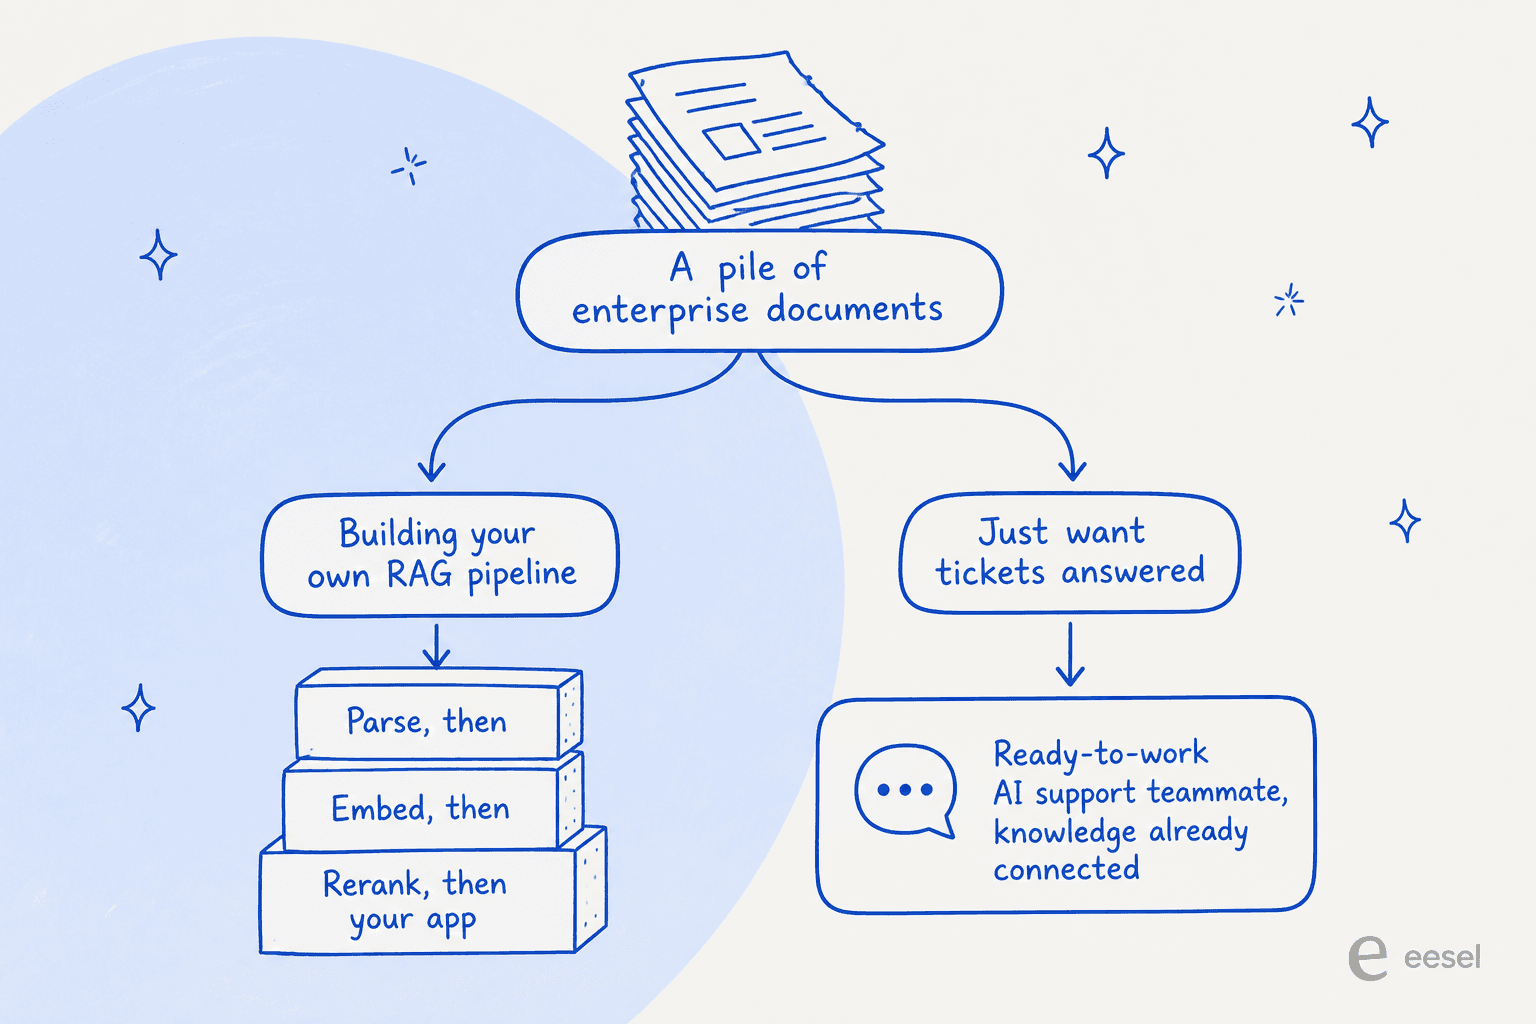
エンジンと車を分けるのと同じ違いです。Parse 5は、非常に優れていて非常に安価なエンジンです。そのまわりに車の残りを自分で組み立てたいかどうかが、本当の問いです。
答えてくれるサポートをeeselで試す
パースモデルへの関心がサポートの課題から来ているなら、エンジンと車の間のその溝を埋めるのがeeselです。eeselはAIチームメイトのプラットフォームで、そのAIヘルプデスクチームメイトは、スタック全体をすぐ使える形にしたものです。ヘルプセンター、Confluence、Google Docsや過去のチケットに直接接続して学習し、Zendesk、Freshdesk、Gorgias、Slack、共有可能なチャットリンク上でチケットを解決します。つなぎ合わせるパースのパイプラインも、運用するベクトルデータベースもありません。

最もごまかせないのは、本番で動かすための確信です。私たちは長年、実際のサポートキューでAIを運用してきて、自信ありげなボットが静かに誤答するのを見てきました。だからeeselは、実際の顧客に触れる前に、過去のチケットですべての展開をシミュレーションします。解決率と、実際に送っていたはずの返信をそのまま確認できます。Parse 5は、私たちのようなチームが文書を扱う方法の一部になり得ます。ただし、チームメイトそのものではありません。eeselは無料で試せます。
よくある質問
Cohere Parse 5とは何ですか?
parse-v5.0)は、文書のページをきれいなMarkdownに変換する23億パラメータのビジョン言語モデルです。表はHTMLで、視覚要素にはバウンディングボックスが付きます。RAGパイプライン、検索インデックス、AIエージェントに大量のデータを供給するために作られています。Cohere Parse 5の料金はいくらですか?
1,000ページあたり$1.50 です。大量処理では、専用のModel Vaultインスタンス(Mediumは1時間$4.00、XLは1時間$7.00)として実行でき、Cohereによると大規模運用でページあたりのコストを23〜61%削減できます。導入を決める前に、AIエージェントと人間のエージェントのコスト比較と照らし合わせてください。