

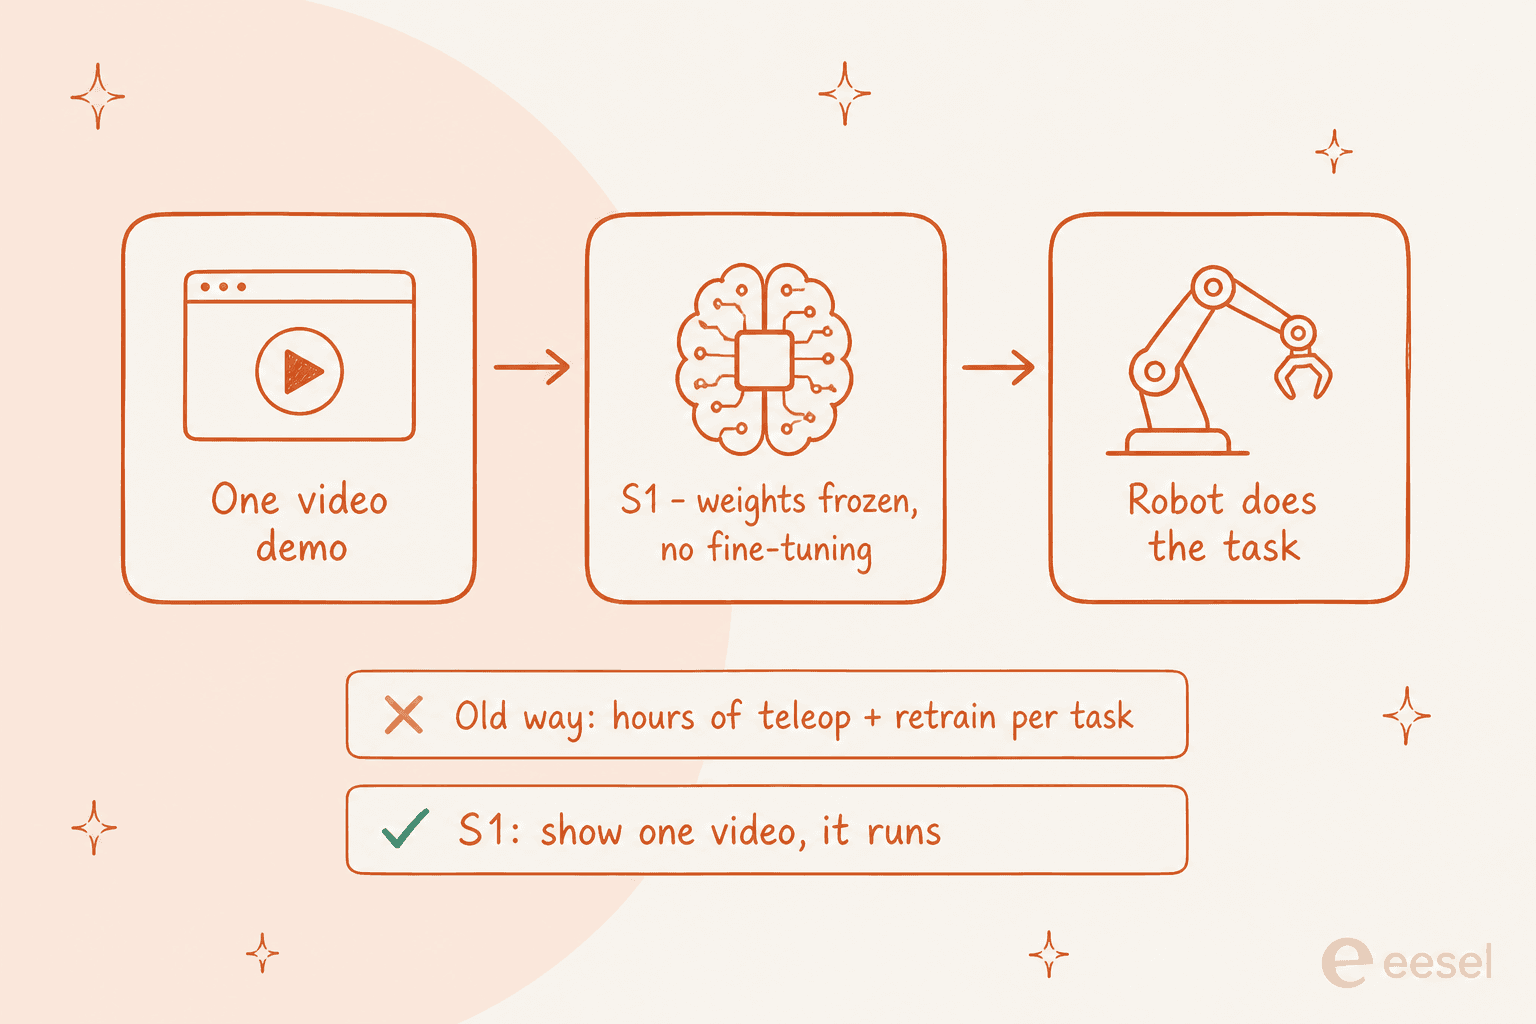
Skild AIのS1は、再学習もファインチューニングもなしで、たった1本のデモ動画から初めての作業を学ぶロボティクス基盤モデルです。見たことのない作業の動画を1本見せるだけで、最長10分の作業を実行します。これが売り込みのすべてであり、ロボットの方策がこれまで作られてきた方法からの本物の転換です。
覚えておくべき数字はこれです。未知の長時間作業で、S1のインコンテキスト学習はステップ成功率66%(対9%)に達し、比較対象は同じデータで学習した言語指示型モデルです。さらに、動画デモ1本は、手作業で集めたテレオペレーションのデモ約380本分に相当します。Skildはこれをロボティクスの「GPT-3の瞬間」と位置づけています。
注意点もあります。これまでの数字はすべてSkild自身の社内ベンチマークによるもので、S1は購入できる製品ではありません。潤沢な資金を持つ研究所の機能デモです(新たに14億ドルを調達し、評価額は約140億ドル)。真剣に受け止める価値があり、統制された研究室の外でも通用するかを見守る価値があります。今日実際の仕事をこなすAIが必要なら、それは今もソフトウェアの世界にあり、そこで活躍するのがeeselのAIチームメイトです。
SkildのS1とは実際に何か
Skild AIはピッツバーグのロボティクス研究所で、「omni-bodied」なロボット頭脳、つまりあらゆるロボットであらゆる作業を動かすための1つのモデルを開発しています。キャッチフレーズはそのまま「Any robot. Any task. One brain.」です。S1はこの旗印のもとでの最初の大型モデルリリースで、2026年8月下旬に発表されました。
重要なのはここです。今日のロボット方策の多くは専門特化型です。ロボットに新しい仕事をさせるには、チームが作業固有のデータを何時間も集め、それでモデルをファインチューニングします。S1はそれを省きます。作業の動画を1本与えると、その動画がモデルのコンテキストに入り、ロボットは出荷時とまったく同じ重みで作業を実行します。Skildの言葉では「no fine-tuning, no post-training. The same model weights produced every example shown in this blog.」です。
聞き覚えがあるなら、それは大規模言語モデルが成し遂げたのと同じ芸当です。最新のチャットボットは、新しいことを聞くたびに再学習されるわけではありません。プロンプトで作業を説明すれば、自分で考えます。Skildは、ロボティクスは「BERT時代」に取り残されており、新しいスキルごとに専用の学習が必要だったと主張し、S1はプロンプティングへの飛躍だとしています。私は仕事でAIエージェントを作っていますが、「作業ごとに再学習」から「1回見せるだけ」への転換は、今回の発表全体で最も重要な考え方なので、仕組みをじっくり見ておく価値があります。
誰もが引用する数字:66%対9%
Skildは自らの主張を裏づけるため、統制された研究を行いました。データ、アーキテクチャ、計算量がまったく同じ2つのモデルを学習させ、違いは作業の指定方法だけでした。1つは動画で指示するインコンテキスト学習モデル、もう1つはテキストで指示する言語条件付きの方策です。そして学習データを1,000時間から100,000時間まで増やし、長時間作業(各4〜8分)での成功率を測りました。
学習中に見たことのある作業では、大規模にすればどちらも好成績でした。S1は96%で、言語指示型は89%でした。劇的な差は未知の作業で現れます。
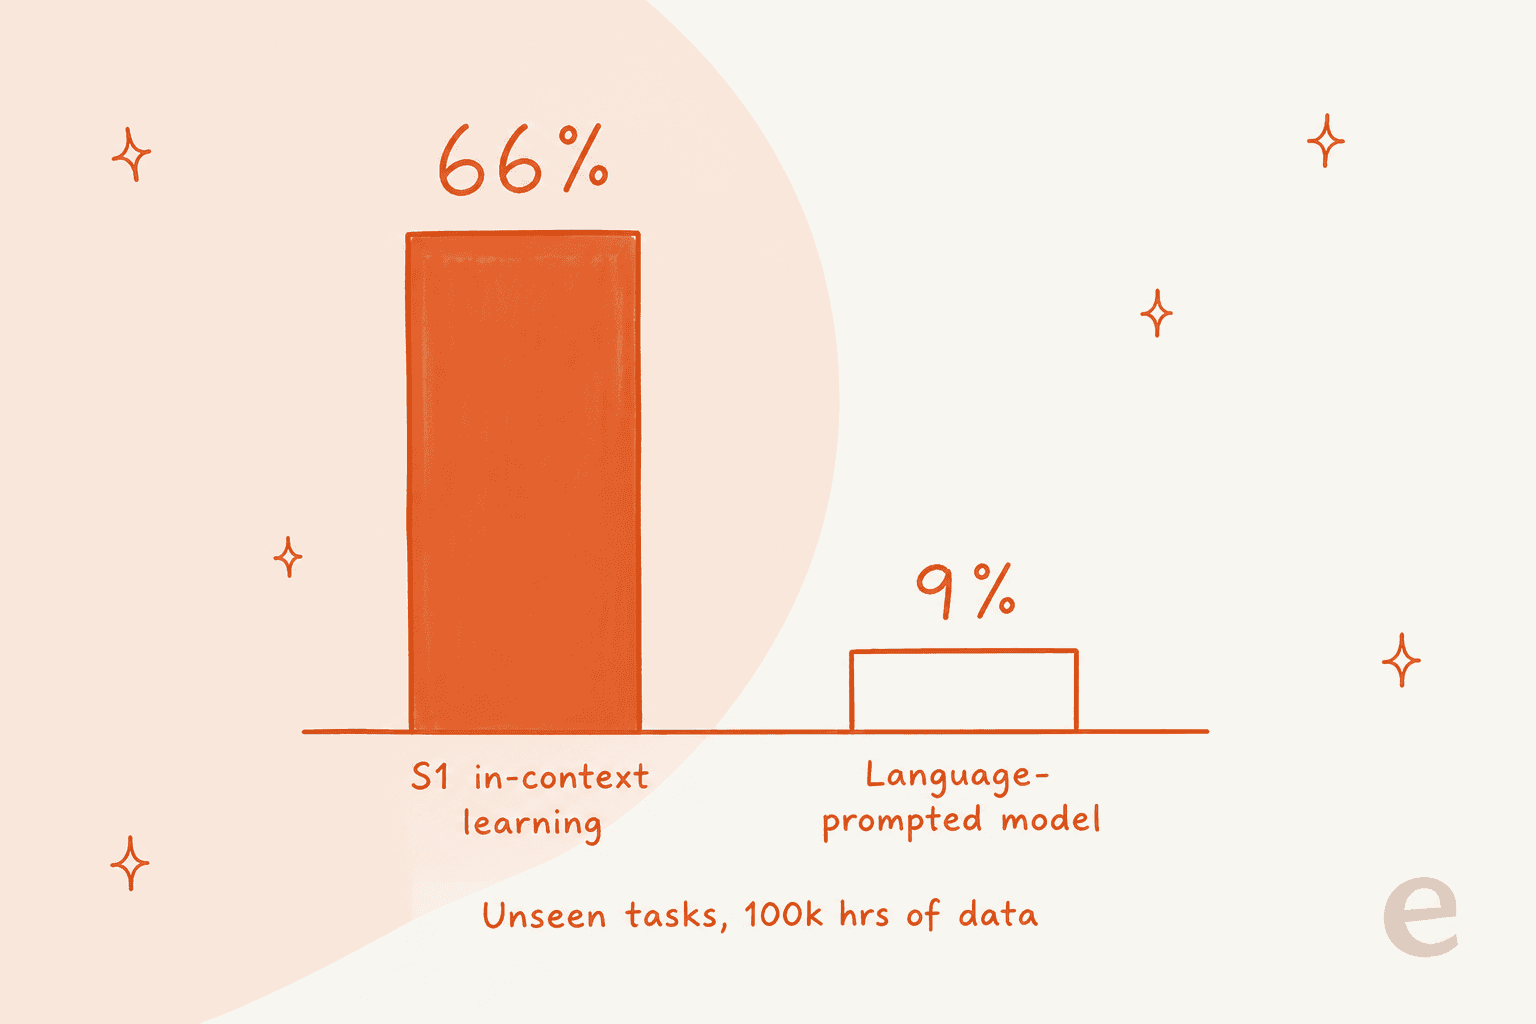
100,000時間のデータで、言語指示型モデルは見たことのない作業でわずか9%にとどまりました。これはSkild自身の研究によるものです。S1のインコンテキスト学習は66%に達し、約7倍の差で、データが増えるほど差は広がりました。Skildの説明は、考えてみれば直感的です。言語は、本当に新しい身体的スキルを説明するには粗い手段です。「パンケーキをひっくり返して」では、ロボットにその動きの感覚は伝わりませんが、動画なら直接見せられます。新しい作業では、デモは一文では伝えられない情報を運びます。
もう1つ、大きな意味を持つ統計があります。Skildは、ファインチューニングしたモデルが、S1が動画1本から得るものに匹敵するには手作業のデモが何本必要かも調べました。答えは、インコンテキストのデモ1本が約380本のテレオペレーションデモに相当し、それを集めるには50〜100時間のテレオペレーションが必要だった、というものです。効率の議論が一行に収まっています。
S1を実際にどう「教える」のか
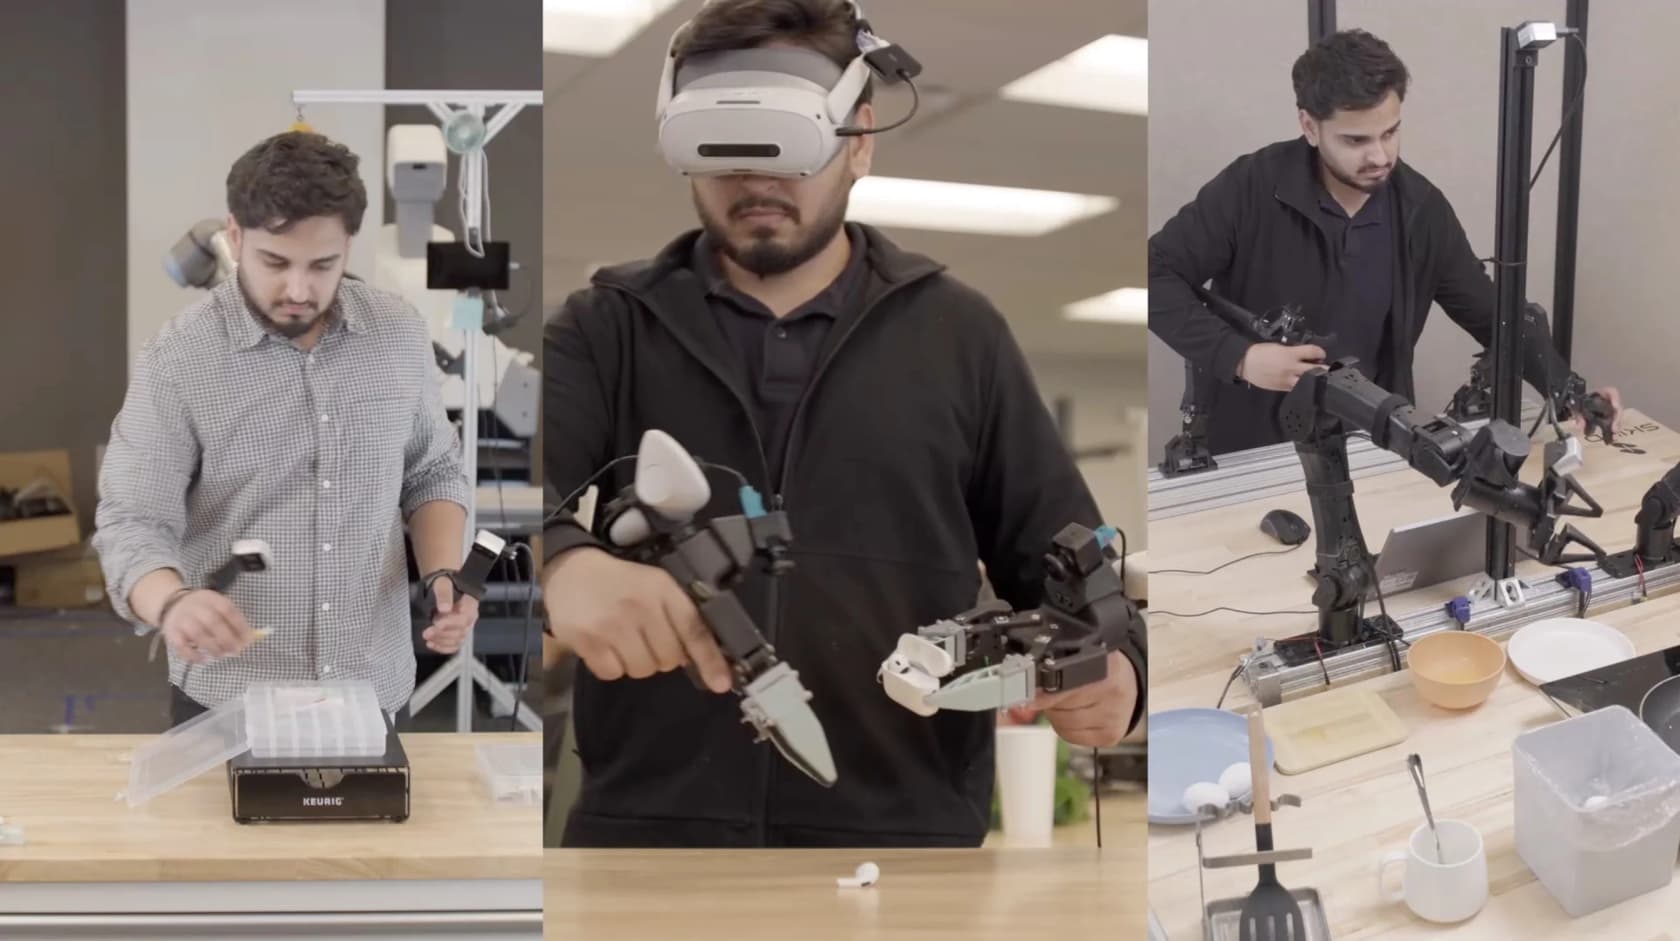
デモはロボット自身からである必要はありません。エゴセントリック(一人称視点)の人間の動画、つまりカメラを身につけた誰かが作業をしているだけの動画でも構いません。S1はその人間のデモを、自分の身体と目の前の場面に置き換える必要があります。つまり、その人の意図、重要な物体、作業の進み具合を暗黙のうちに読み取ることになります。
内部で行われているのはメタ学習です。事前学習は、モデルにデモからの学び方を教える「外側のループ」であり、実行時には動画が「内側のループ」を駆動し、重みを1つも変えずに振る舞いを適応させます。この仕組みが、一度きりのデモを動作する方策に変えます。
この学習から生まれた振る舞いこそ本当に興味深い部分で、Skildはそのために特別にデータを集めたことはないと言います。S1は自分のミスから回復し、そのまま突き進むのではなくやり直します。大まかな常識も示します。デモでじょうろで植物に水をやっていても、机に置かれているのがカップだけなら、S1はカップを使います。さらに欠点のあるデモを修正し、動画を「a specification of the goal, not a trajectory to reproduce」として扱います。雑な人間の例を改善するロボットは、単なる模倣以上のことをしています。
実際の様子
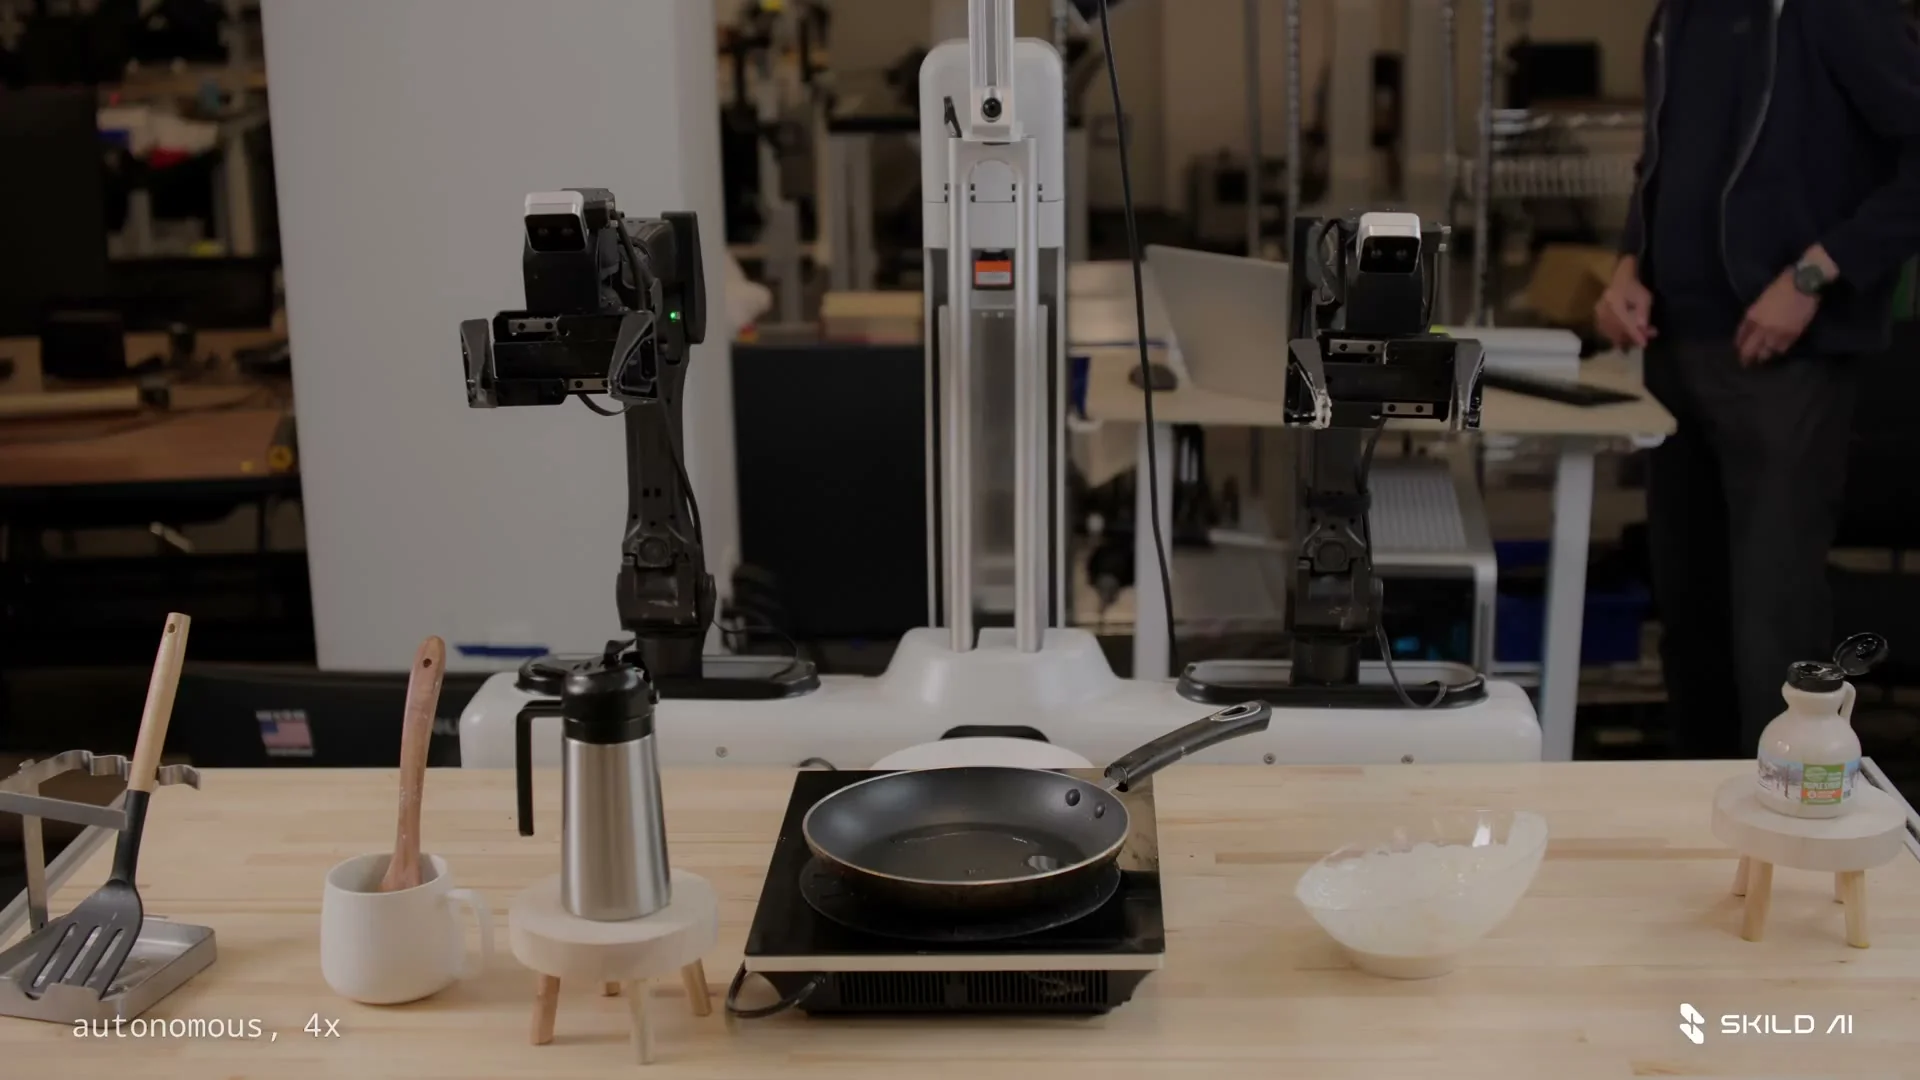
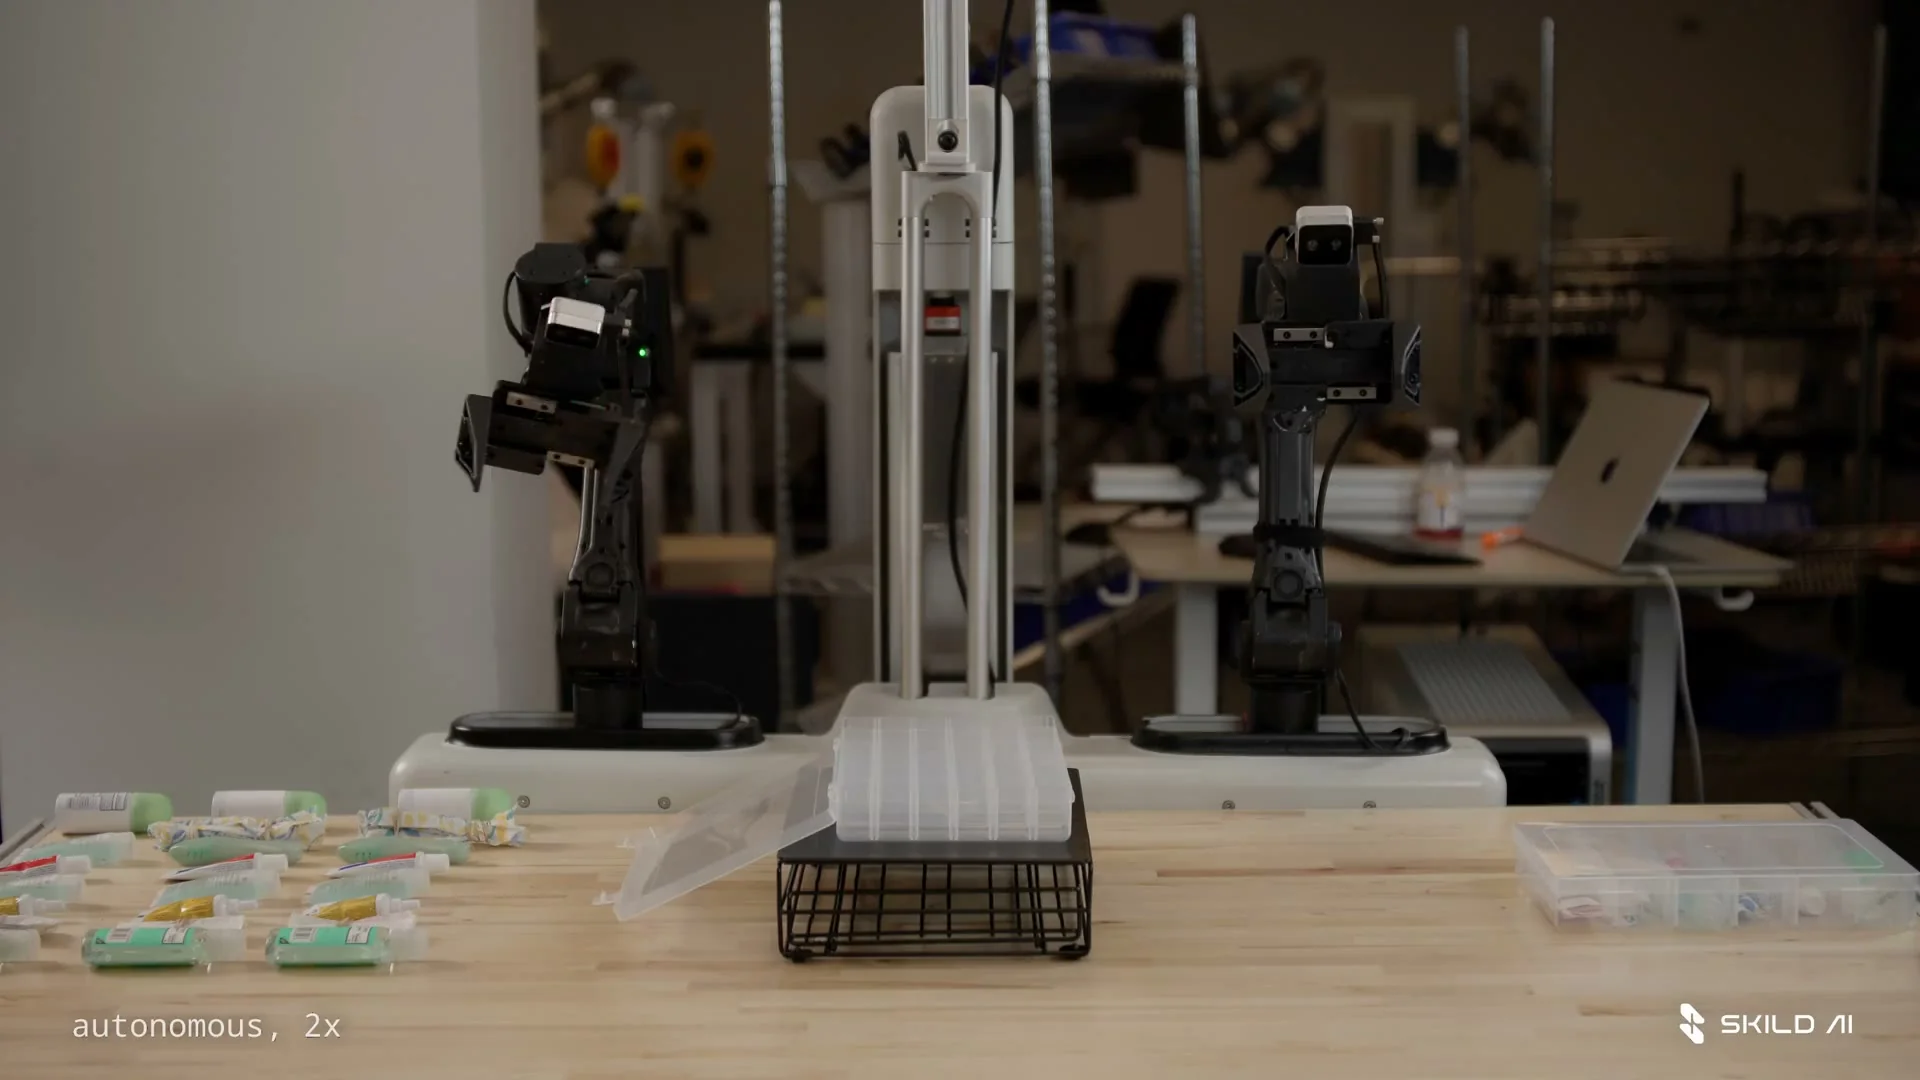
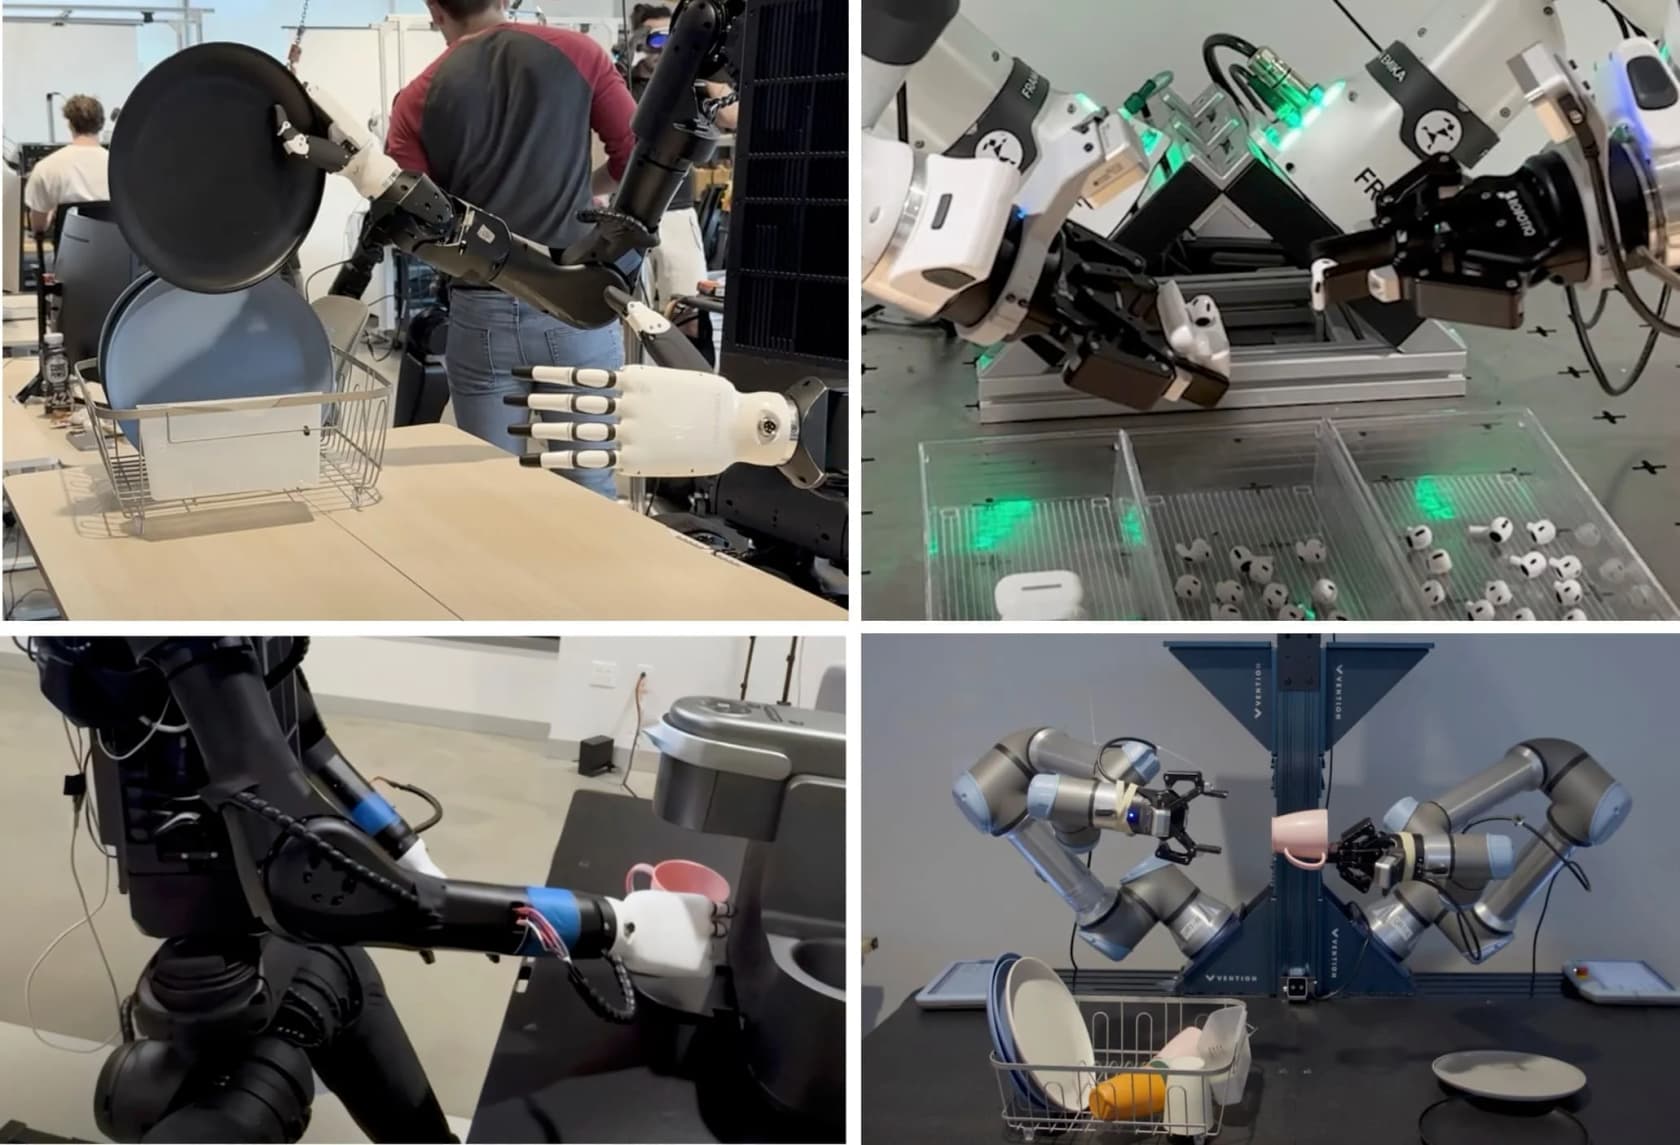
主なデモは、S1が一度も学習したことのない4つの作業です。鉢植え、パンケーキ作り、ハンドドリップコーヒー、キット組み立て。それぞれ最長10分、数十ステップに及び、1本の動画で駆動されます。
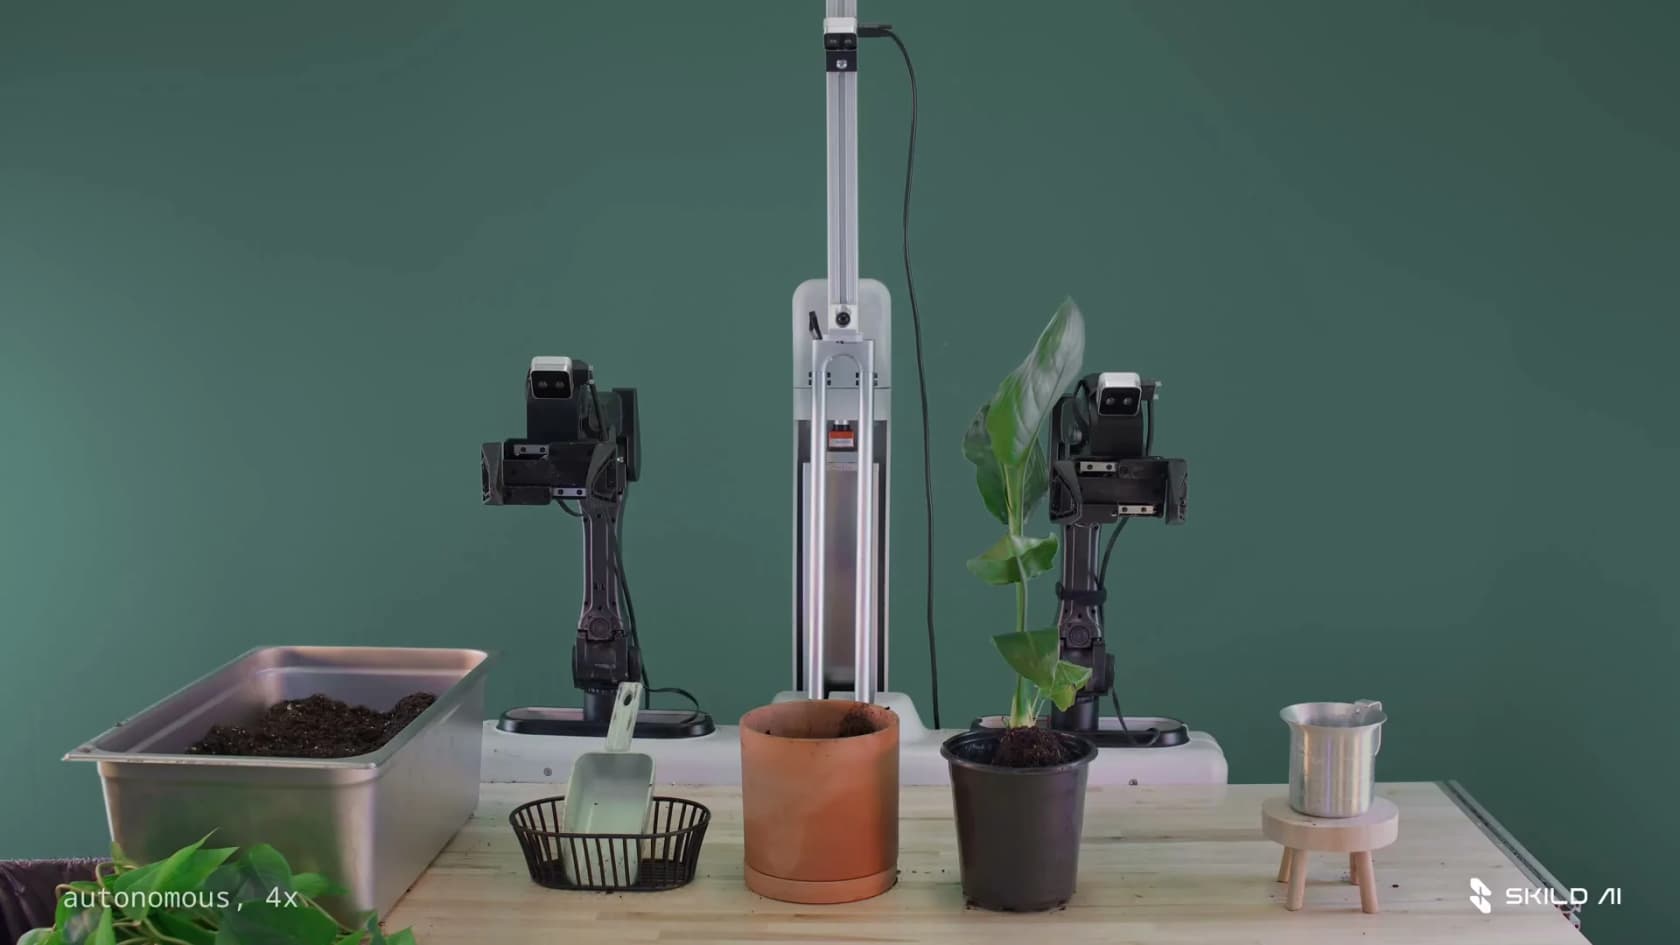
私の印象に残ったのは鉢植えの実行です。Skildがタイムラインを公開しているからです。資材がオフィスに届いたのが午後8:54。午後9:22には、誰かが作業の人間の動画を1本撮影しました。午後9:27には、ロボットが自律的に鉢植えをしていました。つまりデモから動くロボットまで11分で、しかも誰もデータセットを用意していなかった作業です。従来の流れは、ロボットが何かをする前に、何時間ものテレオペレーションとファインチューニングから始まります。
Skildはまた、場面がデモからどれだけずれるとS1が破綻するかも試しました。物体が30cm、45度ずれても、あるいは用途が同じ別の物体に置き換えられても、よく耐えます。大きく性能が落ちるのは、新しい配置が本当に別の計画を要求する場合(反対側の腕で作業するなど)だけです。一方、言語指示型のベースラインは、新しい動きが必要になると最大3倍の速さで崩れました。
1つの頭脳、多くの身体
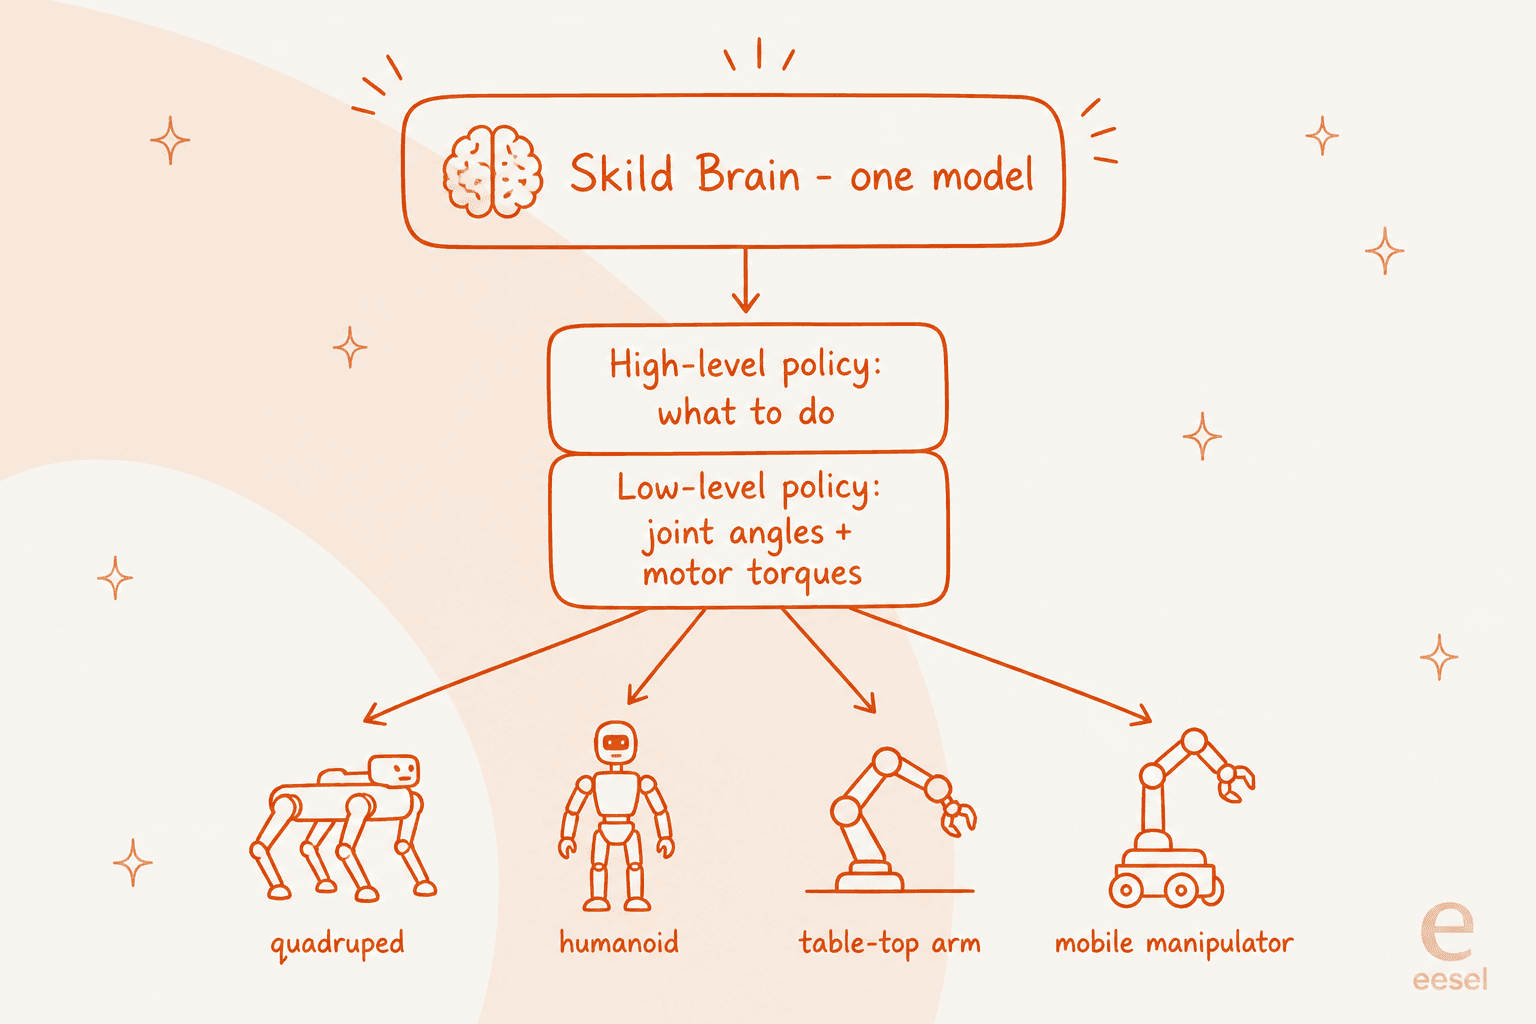
上の作業デモはすべて双腕のマニピュレーション機を使っていますが、Skildのより大きな賭けは、1つのモデルがさまざまな種類のロボットを動かすべきだという点です。Skildはこれを「omni-bodied」と呼び、「humans are also a form of robot」という考えから人間の動画まで取り込んでいます。
アーキテクチャは2つの方策を重ねた構成です。遅めの高レベル方策が何をするか(あのカップを取る、ここへ動く)を決めます。速い低レベル方策が、それらの決定を身体を動かす実際の関節角度とモーターのトルクに変換します。この構成を多くの身体形態にわたって学習させると、Skildによれば2つのものが得られます。学習できるデータが増えることと、ハードウェアが変わったり故障したりしても性能が緩やかに低下することです。
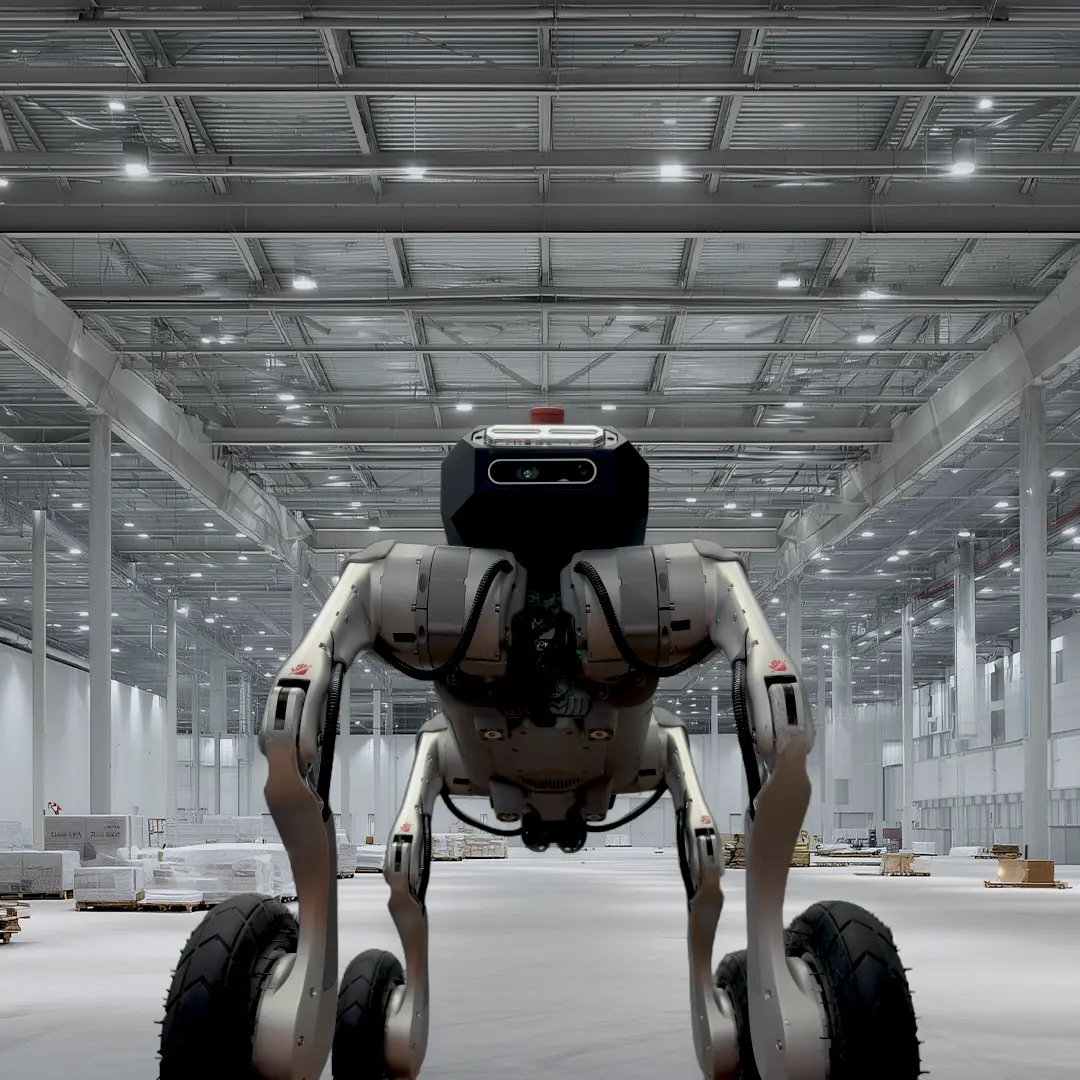
Skildによれば、この頑健性の主張は理論だけではありません。NVIDIAとの事例では、頭脳は車輪が詰まっても2〜3秒で回復し、自重の最大1.5倍のペイロードを扱い、脚を失っても動き続けます。商業的な売りはコストです。Skildは、従来のカスタマイズシステムが25万ドル以上かかるところ、同じモデルが4,000〜15,000ドルのハードウェアで動くと述べ、これを総所有コストの10分の1への削減と位置づけています。
すべての根底にあるデータの問題
どのロボティクス研究所も同じ壁にぶつかります。現実のロボットデータは収集が遅くて高価で、必要量にはまったく足りません。Skildの立場ははっきりしています。必要なのは数百万や数十億の例ではなく数兆であり、「even if the whole population of earth collects data it will take years to reach 100 trillion trajectories」と主張します。現実のテレオペレーションだけでは決してそこに届きません。
そこでSkildは、スケールするデータ源に頼ります。どれも万能ではないので、組み合わせます。
| データ源 | ロボットとの近さ | 作業の多様性 | 低コストで拡大できるか |
|---|---|---|---|
| ロボットのテレオペレーション | 高い | 低い | 低い |
| UMIハンドヘルドグリッパー | 中程度 | 中程度 | 中程度 |
| エゴセントリックな人間の動画 | 低い | 高い | 高い |
| シミュレーション | 中程度 | 低い | 高い |
レシピは次のとおりです。大規模なシミュレーションとインターネット上の人間の動画(どちらも事実上無限)で頭脳を事前学習し、その後、的を絞った現実世界のデータで事後学習します。SkildはこれをNVIDIAのスタックで動かしており、強化学習シナリオにIsaac Lab、物理にOmniverse、合成による多様性の生成にCosmosを使い、これにより「a millennium of experience within days」を圧縮できるとしています。データのクリーニングにも多額を投じており、「for every dollar we spend on collecting data, we spend three on quality control」と述べています。
ここはSkildが最も鋭く批判する部分でもあります。「start with an existing [vision-language model] and sprinkle in less than 1% of real-world robot data」して、その結果をロボティクス基盤モデルと呼ぶ競合を退けます。Skildによれば、それらは「Potemkin village」であり、意味的な知識はあっても「lack the true substance of grounded actionable information」です。この批判が公正かどうかは、これから1年の実際の導入が決めることになります。
開発元と資金
Skildは2023年に、CEOのDeepak PathakとAbhinav Guptaによって創業されました。2人ともカーネギーメロン大学ロボティクス研究所の教授で、Sequoiaによれば、その前に「discussed starting a company for a decade」とのことです。ロボットデータのスケーリング、好奇心駆動の学習、大規模なsim-to-realという彼らの研究の系譜が、製品の実際の土台であり、突然現れた研究所とは違う好ましい点です。
資金調達は、市場がこの賭けをどれほど真剣に見ているかを示しています。直近の資金調達ラウンドで、Skildは14億ドルを調達し、評価額を3倍の140億ドル超にしました。ソフトバンク主導で、NVIDIAのベンチャー部門、Bezos Expeditions、Samsung、LG、Salesforce Venturesなどが参加しています。これにより調達総額は約18.3億ドルになります。Skildはまた、2025年に売上がほぼゼロから「in just a few months」で3,000万ドルになったとCrunchbaseに語りました。同じ分野での比較として、ヒューマノイドメーカーのFigure AIも驚くような額を調達しており、S1は2025年に138億ドルに達したロボティクスの資金環境の中で登場しました。
ロボティクス界の反応
反応はすぐに分かれ、どちらの側にも耳を傾ける価値があります。強気な側では、尊敬を集めるAIの論客がマイルストーンだと評しました。免疫学者で多作なAI論客のDerya Unutmazは率直にこう述べました。
"This is super exciting advance in robotics AI! I believe S1 is the most impressive robot foundation model I had seen! ... In Skild's internal benchmarks, S1 achieved a 66% step-success rate on unseen tasks versus 9% for a language-prompted model, while one video demonstration provided roughly the benefit of 380 post-training examples!"
懐疑派はこの成果を否定しているのではなく、ロボットのデモが歴史的に破綻してきた点を指摘しています。同じスレッドへの返信が、その空気をよく捉えていました。
"'66% on internal benchmarks' is doing a suspicious amount of lifting. robotics demos always look like the future until lighting, grippers, clutter, and failure recovery show up. in-context prompting is cool; the physical world still charges interest."
どちらも同時に正しいのです。インコンテキストでの結果は本物で、手法も健全です。しかし数字はすべてSkild自身のもので、Skild自身のベンチマークによるものであり、統制された研究室は寛容な場所です。Skildの名誉のために言えば、S1は「already at work with our commercial partners」とのことなので、現実世界の証拠が続くはずです。それまでの正直な見方は、有望で、ローンチとしては異例なほどしっかり根拠があり、研究室の外では未証明、というものです。
AIチームメイトの世界でeeselはどこに位置するか
S1が刺激的なのは、ソフトウェアの仕事がすでに自動化されているように、物理的な仕事も自動化される未来を指し示しているからです。ただし時制に注目してください。その未来はまだデモの段階です。課題が鉢植えを待つ植物ではなく、サポートチケットの山やコンテンツの滞留なら、ロボットの頭脳を待つ必要はありません。S1を面白くしている「自分のコンテキストから学び、そして仕事をする」という考え方は、すでにソフトウェアで提供されています。
それがeeselの姿です。特定の仕事のために、すぐに働けるAIチームメイトを採用し、それぞれが最初から御社のことを理解した状態で着任します。AIヘルプデスクのチームメイトは、既存のZendesk、Freshdesk、Gorgiasのキューに参加し、過去のチケットとヘルプセンターから学び、返信を下書きまたは送信します。本番稼働の前に過去のチケットでシミュレーションまで行います。これは私たちなりの「信頼する前にテストする」です。

ラインナップにあるもう1人のチームメイトはAIブログライターで、長文記事を調査して下書きします(実はこのタイプの記事です)。S1にはデモ動画が必要ですが、eeselのチームメイトに必要なのはあなたのナレッジベースです。S1が研究室の成果である一方、こちらは無料トライアルで、営業電話なしで、数分で稼働します。物理ロボットの未来を見たいなら、Skildとその新興ライバルに注目してください。今日の午後にAIにビジネスの実務をしてほしいなら、営業電話なしでeeselを無料で試せます。
よくある質問
Skild AIのS1とは何ですか?
Skild AIのS1は、2026年8月に発表されたロボティクス基盤モデルです。新しい仕事のたびにロボットを再学習させる代わりに、作業の動画を1本見せるだけで、凍結されたままの同じモデルの重みで実行します。Skildの汎用ロボット頭脳の主力リリースです。
Skild S1はどのように新しい作業を学習しますか?
S1はインコンテキスト学習を使います。作業は動画のデモ(日常的な人間の動画でも可)で指定され、ファインチューニングなしでモデルのコンテキストウィンドウに入ります。未知の長時間作業では、言語で指示するベースラインの9%に対し、Skildはステップ成功率66%を報告しています。詳しくはSkild AIレビューをご覧ください。
Skild AI S1は今日購入・利用できますか?
直接はできません。S1は研究と機能の発表であり、公開価格やAPIのある購入可能な製品ではなく、Skildはすでに商用パートナーと稼働中だとしています。今すぐ実務をこなすAIをお探しなら、こちらのAIエージェントの例をご覧ください。
Skild AIはどれくらい資金を調達していますか?
直近のラウンドで、Skild AIは14億ドルを調達し、評価額を約140億ドルへと3倍に引き上げました。ソフトバンク主導の案件で、調達総額は約18.3億ドルになります。2023年にカーネギーメロン大学のロボティクス教授2人が創業しました。
Skild S1はカスタマーサービスのチャットボットと同じ種類のAIですか?
いいえ。S1は身体を持つAIで、物理ロボットのための頭脳です。AIエージェントとチャットボットの違いで扱うようなサポートエージェントはソフトウェア上で動き、チケットやチャットを解決します。どちらも例から学びますが、一方はロボットアームを動かし、もう一方はヘルプデスク内で返信を下書きします。