Ce que « headless » signifie vraiment pour le support client
Le mot « headless » est un emprunt, et cet emprunt mérite d'être compris car il indique exactement ce que promet le modèle.
Dans la gestion de contenu, un CMS headless stocke et sert votre contenu via une API, et vous laisse la présentation. La « tête » est le frontend ; passer en headless signifie la couper pour que le même contenu puisse s'afficher sur un site, une app mobile, une montre connectée, une borne, peu importe. Le commerce headless a fait la même chose pour les paniers et les tunnels d'achat. Le backend est devenu un service que l'on appelle ; la vitrine est devenue la vôtre à concevoir.
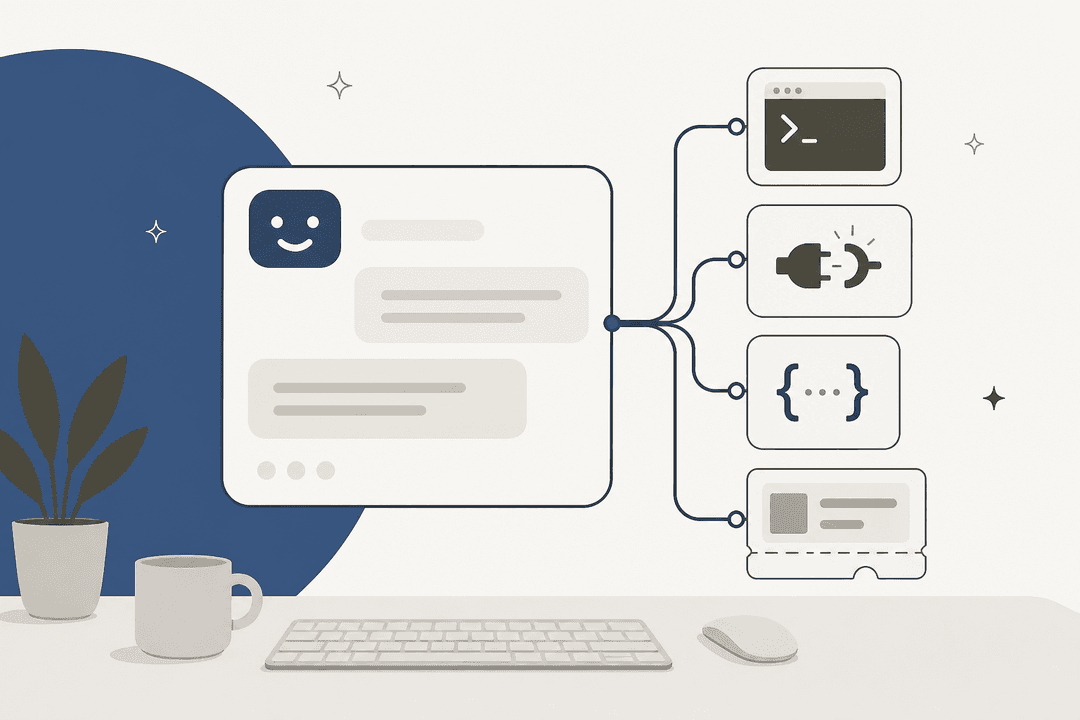
Le support client IA headless applique cette séparation à l'agent de support. Le moteur est le service backend : il ingère votre centre d'aide et vos tickets passés, récupère le contexte pertinent pour une question, en déduit une réponse et (quand il y est autorisé) effectue une action comme étiqueter, escalader ou émettre un remboursement. La tête est n'importe quelle surface à laquelle le client s'adresse. Plutôt que d'être enfermé dans le widget de chat d'un seul fournisseur, vous pointez n'importe quel nombre de frontends vers le même moteur.
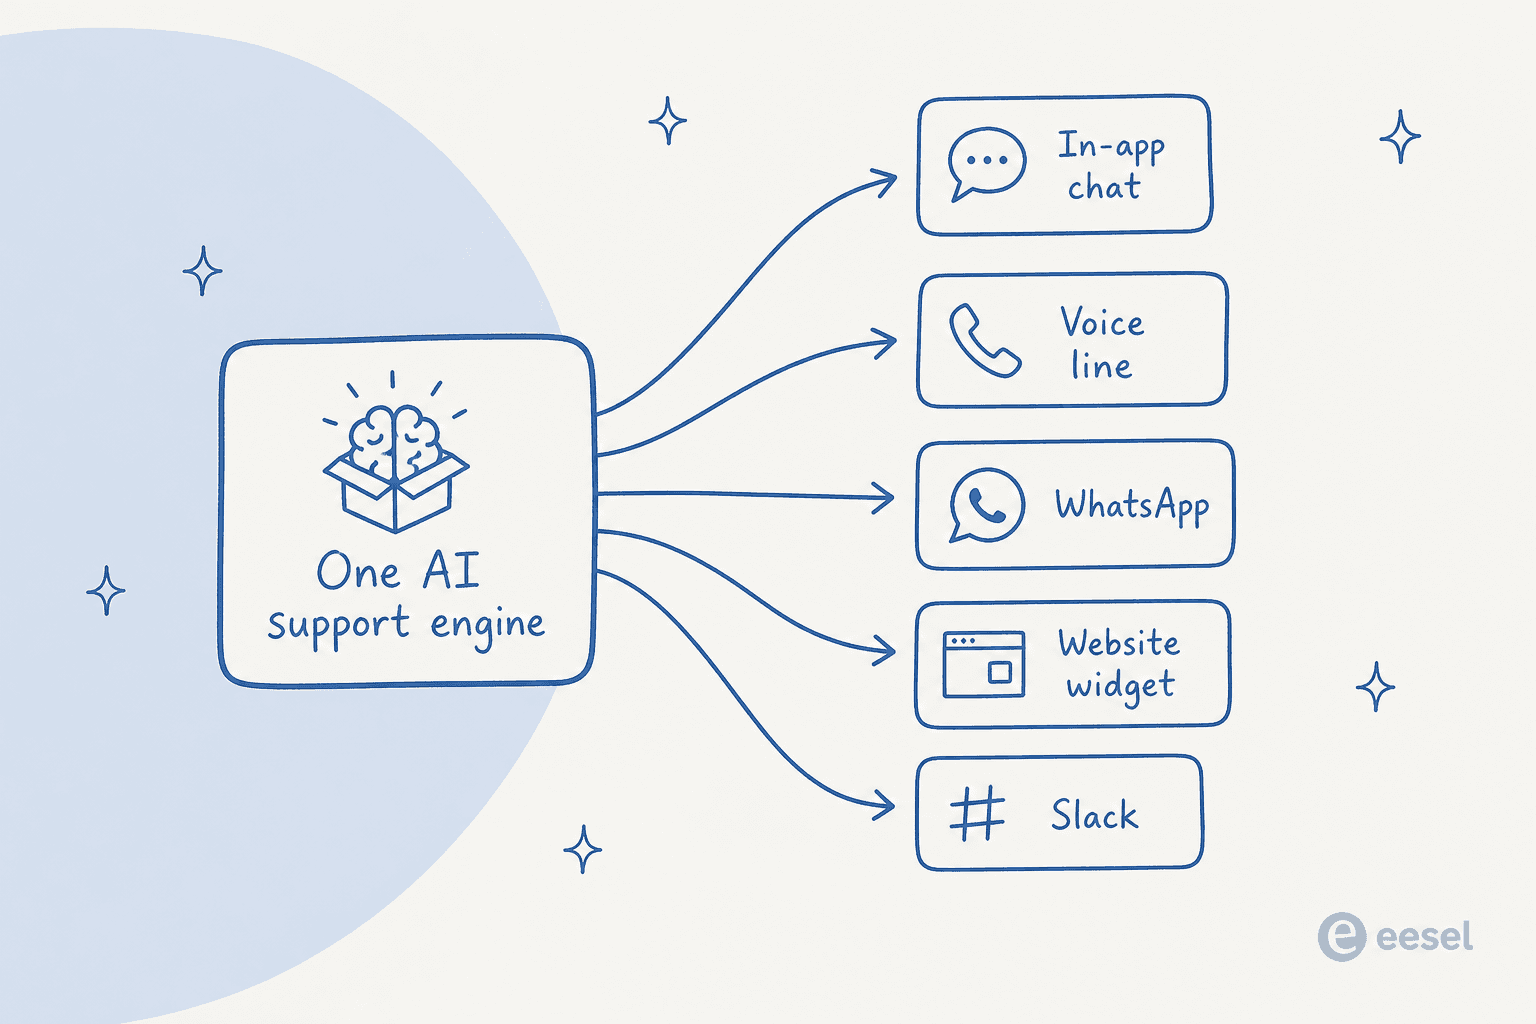
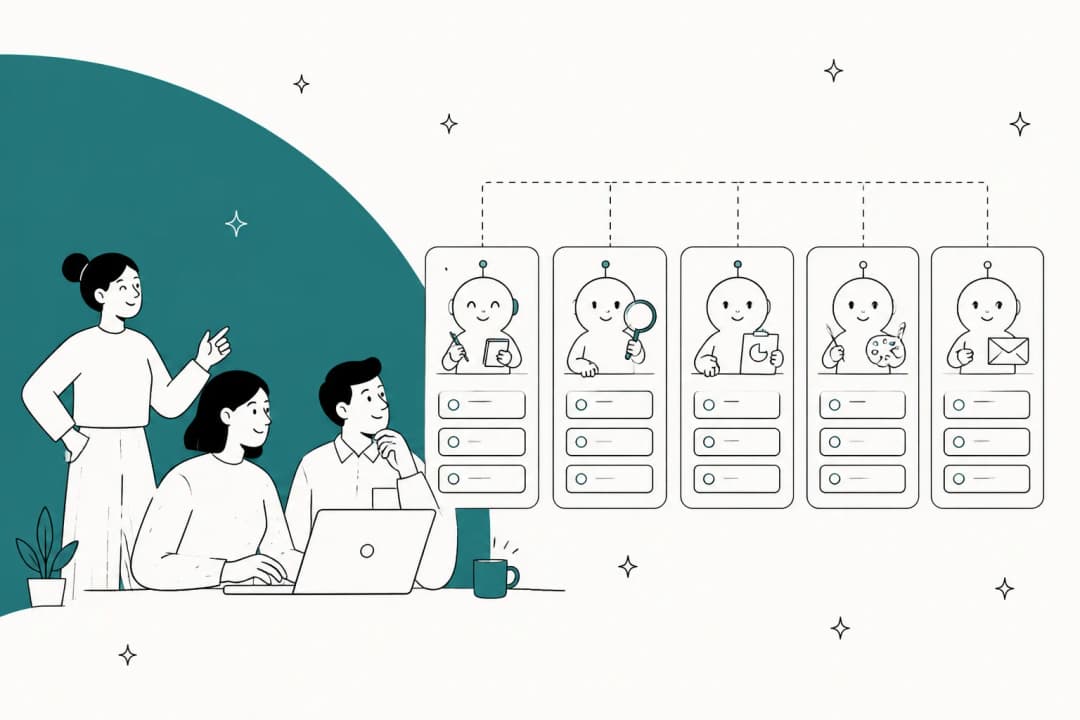
C'est toute l'idée en une image : un moteur, de nombreuses têtes. L'agent de support client cesse d'être un produit auquel on se connecte et devient une capacité que vous appelez depuis votre propre code.
Pourquoi les équipes passent en headless, en premier lieu
Personne n'adopte une architecture pour elle-même. Le support headless apparaît généralement quand une équipe se heurte à l'un de ces murs.
- L'expérience de support doit vivre à l'intérieur du produit. Une application SaaS veut que l'aide apparaisse en contexte (sur l'écran de facturation, en plein onboarding), pas dans une bulle flottante collée dans un coin. Cela signifie que la réponse doit s'afficher dans votre propre UI, ce qui signifie que le moteur doit être appelable, ce qui signifie headless.
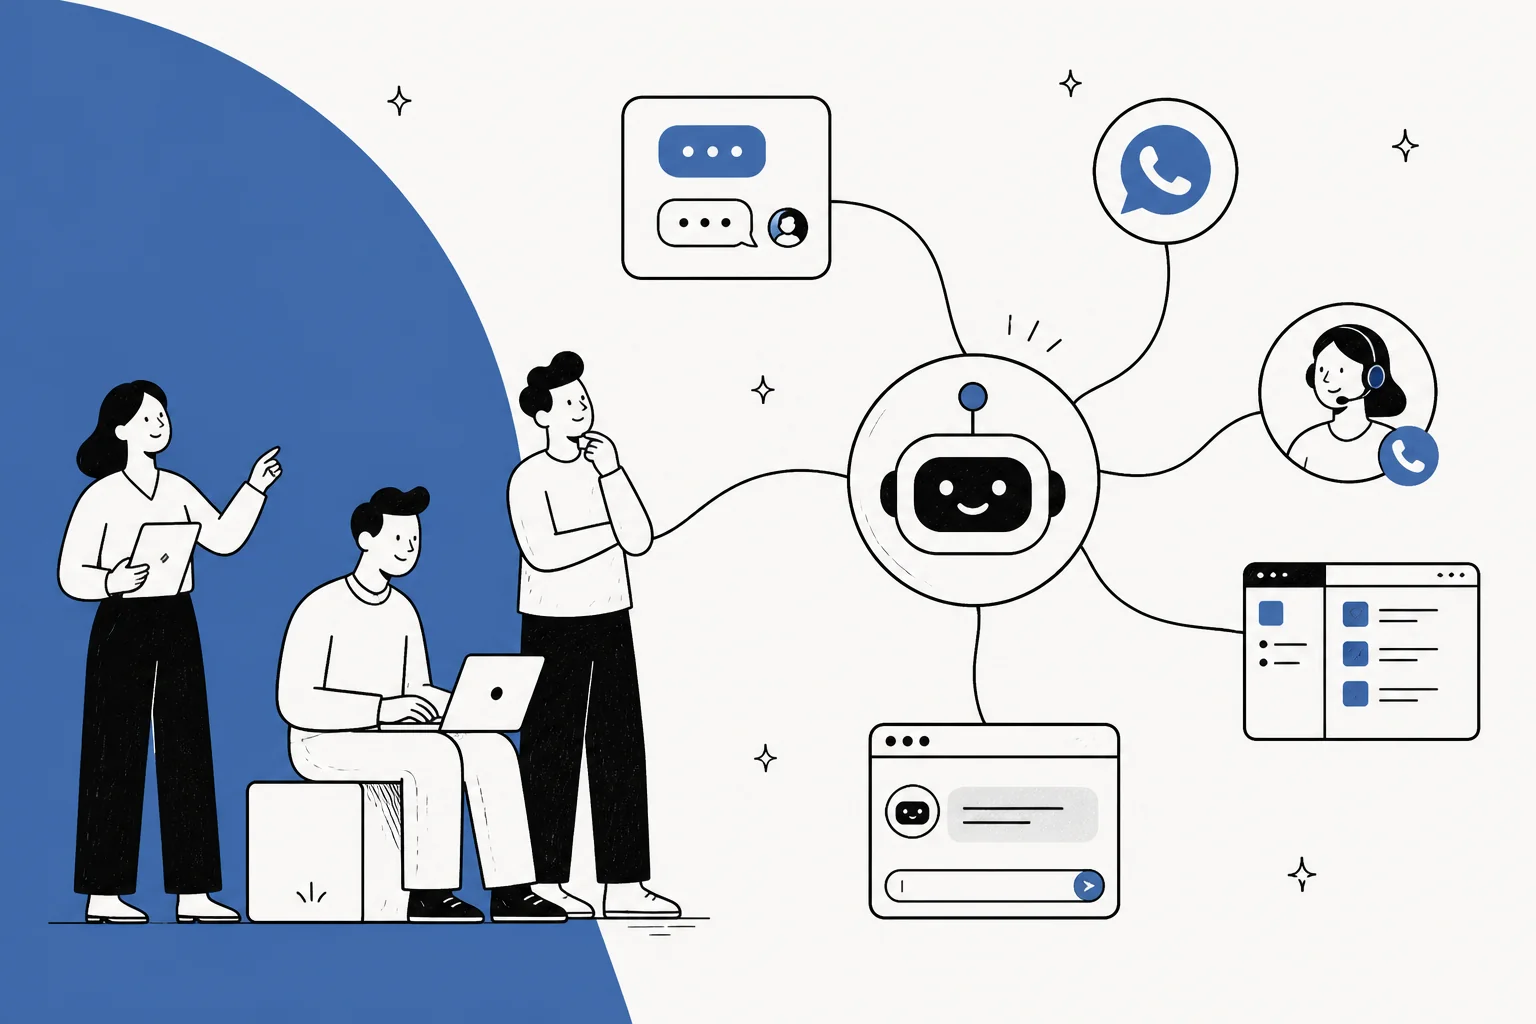
- Le support est réparti sur des canaux qui ne partagent pas de widget. Si vous répondez sur un site, une app mobile, WhatsApp et une ligne vocale, un bot intégré à une UI vous oblige à configurer et à réconcilier quatre agents distincts. Un moteur headless permet à un seul cerveau de servir les quatre, de sorte que la réponse à « où est ma commande ? » soit identique quel que soit l'endroit où on la pose.
- Vous avez déjà un frontend que vous aimez. De nombreuses équipes ont une interface de chat parfaitement correcte, ou un système de design spécifique, ou un canal que le fournisseur ne prend pas en charge. Elles ne veulent pas d'une nouvelle UI ; elles veulent un backend plus intelligent derrière celle qu'elles ont déjà.
- Vous êtes une plateforme, et le support est une fonctionnalité que vous livrez à vos propres clients. Si vous intégrez de l'automatisation de support dans un produit utilisé par d'autres personnes, vous ne pouvez pas leur remettre le widget siglé d'un tiers. Le moteur doit être quelque chose que vous enveloppez vous-même.
Le fil conducteur est le contrôle de l'expérience. Vous vous tournez vers le headless quand le frontend est une décision que vous voulez garder, et que l'intelligence est la partie que vous voulez externaliser ou centraliser. Pour un regard plus approfondi sur la place de l'automatisation à travers ces surfaces, notre guide sur l'IA pour l'automatisation du service client parcourt l'angle des canaux.
Ce dont une stack de support IA headless a vraiment besoin
C'est là que le plan rencontre la réalité. « Headless » donne l'impression que le travail, c'est le frontend, parce que c'est la partie que vous gardez. Mais un agent de support qui se contente d'afficher une boîte de chat et ne peut rien faire est une barre de recherche avec une personnalité. La valeur réside entièrement dans le moteur, et le moteur est un empilement de composants porteurs qu'une API de chat brute ne vous donne pas.
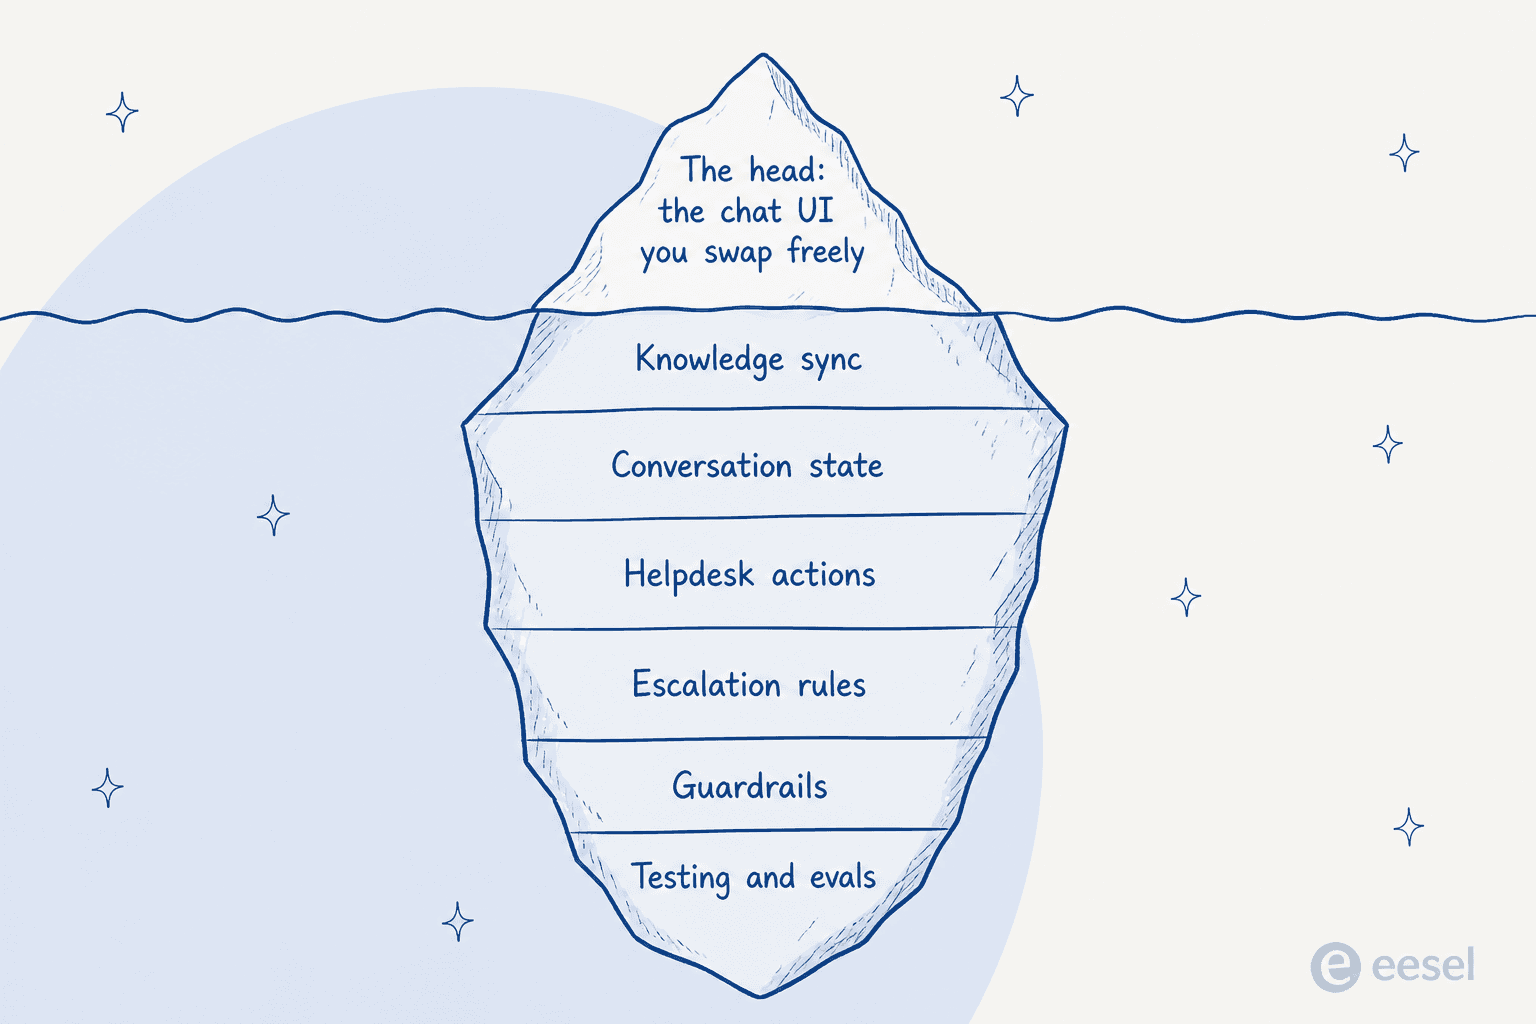
Tout ce qui est sous la ligne de flottaison est la véritable construction :
- Synchronisation des connaissances et récupération. L'agent doit répondre à partir de votre centre d'aide, de votre documentation et souvent de vos tickets passés, et il doit rester à jour à mesure que ceux-ci changent. Cela relève du chunking, de l'embedding, du reranking, de la fraîcheur des données et du contrôle d'accès, pas d'un simple import ponctuel. Nous avons approfondi ces arbitrages dans RAG contre base de données vectorielle contre recherche hybride si vous voulez le détail de la couche de récupération.
- État de la conversation. Un appel à un modèle est sans état. Le support multi-tours (la question de suivi, le « en fait, mon numéro de commande est ») signifie que vous stockez et rejouez l'historique, gérez les fenêtres de contexte et gardez les sessions cohérentes entre les canaux.
- Actions sur le helpdesk. Répondre, c'est la moitié du travail. L'autre moitié, c'est agir : mettre à jour un ticket Zendesk, appliquer une étiquette, escalader vers le niveau 2, consulter une commande. Chacune est une intégration que vous construisez et maintenez, et la couche d'actions est l'endroit où se cache la majeure partie du travail réel.
- Escalade et garde-fous. Quand l'agent doit-il transférer à un humain ? Que ne doit-il jamais dire ou faire ? Comment stoppez-vous une réponse fausse énoncée avec assurance ? Ce sont des politiques que vous codifiez et continuez d'ajuster, pas un réglage que l'on active une fois pour toutes.
- Tests et évaluations. C'est le point que les équipes sautent et regrettent ensuite. Avant qu'un agent ne touche une file d'attente en production, vous voulez savoir comment il va se comporter, idéalement en le simulant sur vos tickets historiques réels. Sans cela, vous déployez en production en espérant que ça se passe bien.
Nous construisons ce moteur depuis des années, et la leçon la moins intuitive concerne l'endroit où la difficulté se concentre. Ce ne sont pas les appels au modèle. D'après notre propre travail d'intégration, les déclencheurs et les actions représentent environ la moitié de l'effort, pas la surface de l'API : chaque plateforme gère les événements différemment, les webhooks par client ne doivent pas devenir orphelins, et les plateformes ont des comportements cachés (Freshdesk, par exemple, ne déclenche jamais silencieusement les règles d'automatisation pour les tickets créés par l'agent, ce qui nous a coûté des heures de diagnostic). Rien de tout cela n'apparaît dans un quickstart. Tout cela apparaît en production.
Les deux façons de construire un support headless
Une fois que vous acceptez que le moteur est le produit, la question construire-ou-acheter devient plus claire. Il y a deux voies honnêtes.
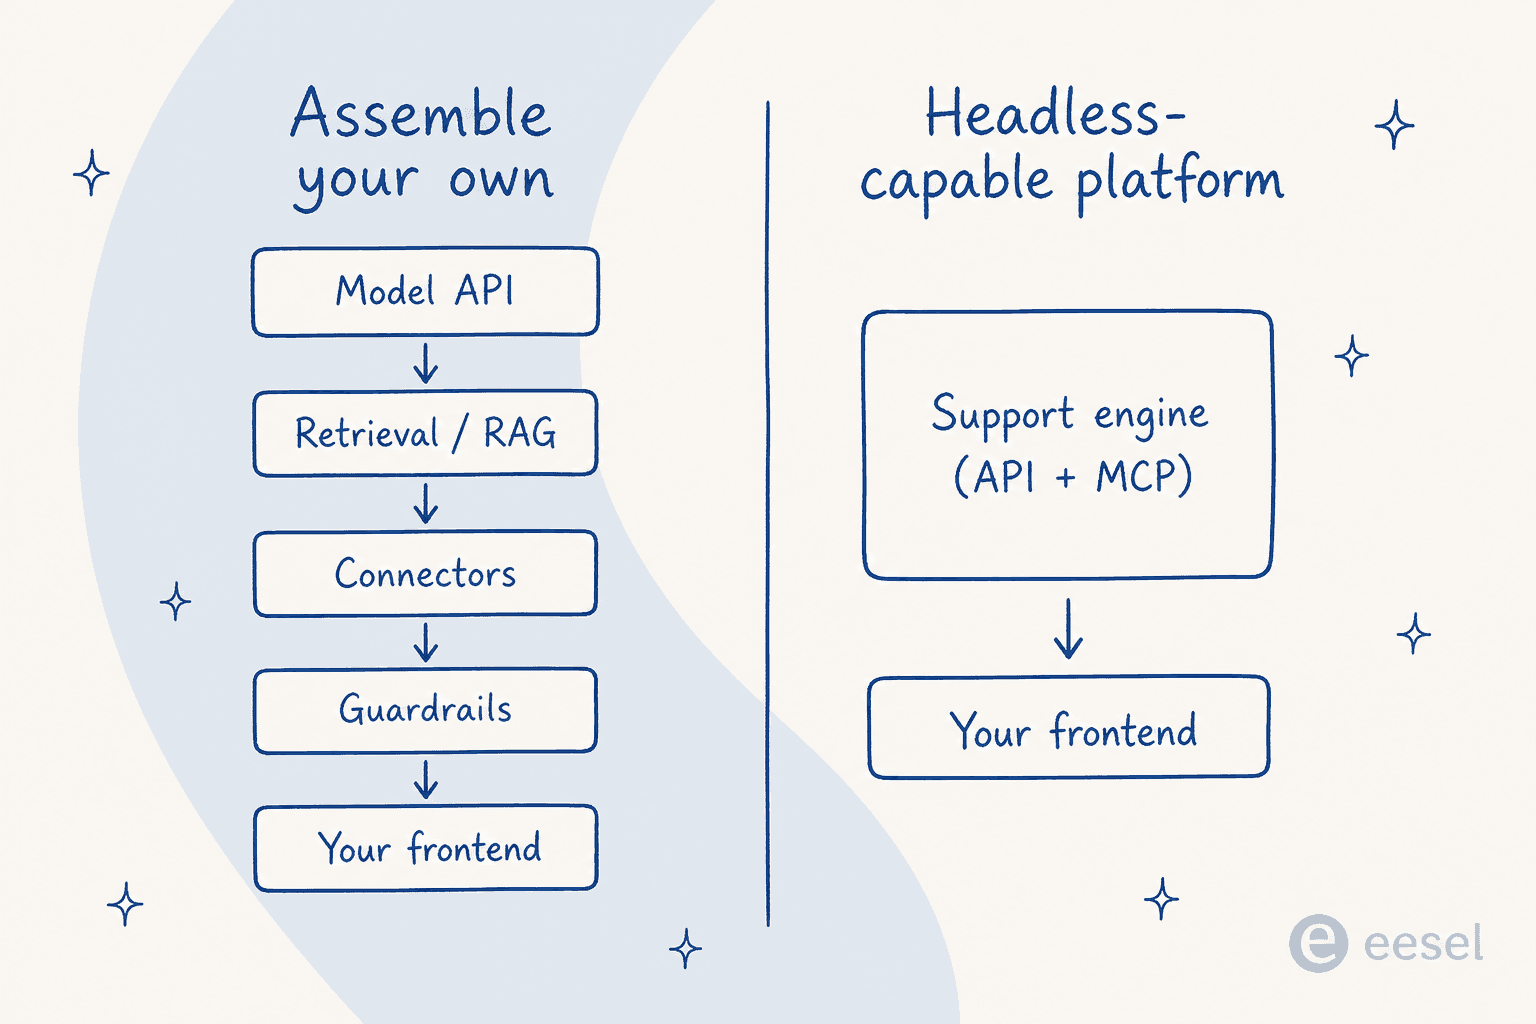
Voie 1 : assemblez la vôtre sur une API de modèle
Vous partez d'une API de modèle de fondation (OpenAI, Anthropic) et vous construisez le moteur autour : une couche de récupération, vos connecteurs vers le helpdesk, des garde-fous, un harnais d'évaluation, puis le frontend. C'est la voie la plus flexible et la seule qui vous donne un contrôle total sur chaque couche. C'est aussi un engagement d'ingénierie réel et continu. L'appel au modèle représente peut-être 10 % du travail ; les 90 % restants correspondent à la pile ci-dessus, qui ne cesse jamais d'avoir besoin de maintenance une fois en production. Nous avons détaillé cette répartition dans l'article sur l'API d'agent de support client. Choisissez cette voie quand la logique personnalisée est votre avantage concurrentiel et que vous avez l'équipe pour en être propriétaire pour toujours.
Voie 2 : utilisez une plateforme compatible headless
Ici, le moteur existe déjà. Une plateforme a construit la récupération, les connecteurs, les garde-fous et les tests, et expose le tout via une API et, de plus en plus, un serveur MCP. Vous apportez la tête. Point crucial : une bonne plateforme propose aussi un widget prêt à l'emploi pour les canaux que vous préférez ne pas construire, de sorte que « headless » ne vous oblige pas à écrire une UI de chat depuis zéro juste pour démarrer.
C'est la voie que la plupart des équipes veulent réellement, car les parties qu'elles allaient construire sont celles qui sont les plus difficiles à bien faire et les moins différenciantes. Vous obtenez la flexibilité d'appeler un moteur depuis votre propre frontend, sans vous engager à maintenir une infrastructure de récupération et d'évaluation pendant toute la durée de vie du produit. eesel est construit ainsi : il se branche sur le helpdesk que vous utilisez déjà, s'intègre en widget là où vous en voulez un, et peut être piloté de manière programmatique là où vous en avez besoin.
Une nuance qui mérite d'être signalée : même au sein de la Voie 2, il existe un levier de contrôle. D'après nos propres tests, pour les intégrations de longue traîne ou ponctuelles, donner à l'agent une clé API ainsi que la documentation et un script de référence a fait mieux qu'un outil préconstruit du fournisseur. Les connecteurs gérés se justifient sur les chemins les plus fréquentés (Zendesk, Freshdesk, Shopify) ; l'approche API brute l'emporte sur les cas rares. Une plateforme qui prend en charge les deux fait bien le headless.
La tête n'a jamais été la partie difficile (et la facture le prouve)
La raison pour laquelle le calcul construire-contre-acheter penche comme il penche, c'est le coût, et le headless change le coût que vous regardez.
Construire le vôtre signifie un compteur au jeton. Chaque API de modèle facture au jeton : environ quelques dollars par million de jetons en entrée et davantage en sortie, facturés à chaque message, chaque nouvelle tentative et chaque fragment récupéré, que le ticket soit réellement résolu ou non. C'est un coût variable qui évolue avec l'usage et qui augmente discrètement à mesure que votre récupération devient plus approfondie. Par-dessus s'ajoute le coût fixe qui n'apparaît jamais dans un calculateur de prix : les ingénieurs qui maintiennent le moteur.
Les plateformes à tarification au résultat inversent le compteur. Plutôt que de payer pour des jetons, vous payez par unité de travail résolue. eesel, par exemple, a un tarif à l'usage d'environ 40 centimes par ticket traité, sans frais par poste et sans frais de plateforme. Le chiffre qui vous intéresse (le coût par ticket résolu) est le chiffre sur lequel vous êtes facturé, et l'ingénierie nécessaire pour maintenir le moteur à jour est le problème du fournisseur, pas une ligne de votre feuille de route.
Nous entendons constamment le réflexe « on n'a qu'à le construire nous-mêmes », et il est plus tentant que jamais. Une équipe du marché intermédiaire l'a formulé sans détour en partant pour un outil moins cher :
"We switched to a system that is working well at half the cost. But long term we will just build our own, which is so possible now with AI. That being said, we probably would have stayed if support was faster and better."
a churned mid-market customer, in a note back to our founder
Cela vaut la peine de s'y attarder, car cela joue dans les deux sens. L'IA a réellement rendu la construction en interne plus accessible qu'il y a deux ans. Et pourtant, la raison pour laquelle cette même équipe cherchait ailleurs était une synchronisation de données défaillante qu'elle ne voulait pas avoir à surveiller, ce qui est exactement le travail de maintenance du moteur auquel « on va le construire nous-mêmes » vous engage de façon permanente. Le headless ne fait pas disparaître les 90 %. Il décide simplement qui en est responsable.
Quand le headless en vaut la peine, et quand ce n'est pas le cas
Pour être honnête sur le compromis : le headless n'est pas automatiquement le bon choix.
Passez en headless quand l'expérience de support fait partie de la surface de votre produit, que vous servez des canaux qui ne partagent pas d'UI, ou que vous êtes une plateforme intégrant du support pour vos propres utilisateurs. Dans ces cas, le frontend est véritablement une décision que vous devez conserver, et un widget intégré vous gêne activement.
Faites l'impasse quand vous gérez le support depuis un seul helpdesk et un widget de site, et que l'UI propre du fournisseur convient. Passer en headless dans ce cas revient à ajouter un projet d'intégration pour vous épargner un frontend que vous n'aviez pas besoin de construire au départ. Un agent de helpdesk IA standard fonctionnant dans votre outil existant vous apportera des tickets résolus plus rapidement, avec moins à maintenir.
La bonne nouvelle, c'est que ce choix n'est pas permanent si vous choisissez le bon moteur. Une plateforme qui propose à la fois un widget prêt à l'emploi et une API vous permet de démarrer avec le widget puis de passer en headless plus tard, sur les canaux où cela se justifie, sans changer de fournisseur. Cette optionnalité (acheter le moteur, garder la décision du frontend ouverte) est la version pragmatique du headless que la plupart des équipes devraient réellement vouloir.
Essayez eesel pour un support headless sans l'assemblage
Si le modèle headless vous séduit mais que construire le moteur ne vous tente pas, c'est exactement ce manque que eesel comble. Il vous donne un moteur de support qui livre déjà les éléments sous la ligne de flottaison : il synchronise vos connaissances et vos tickets passés, se connecte au helpdesk que vous utilisez déjà, et peut effectuer de véritables actions sur les tickets plutôt que de simplement répondre. Vous pouvez l'exécuter dans votre helpdesk, l'intégrer en widget, ou le piloter de manière programmatique, de sorte que « headless » n'a pas à signifier « repartir de zéro ».
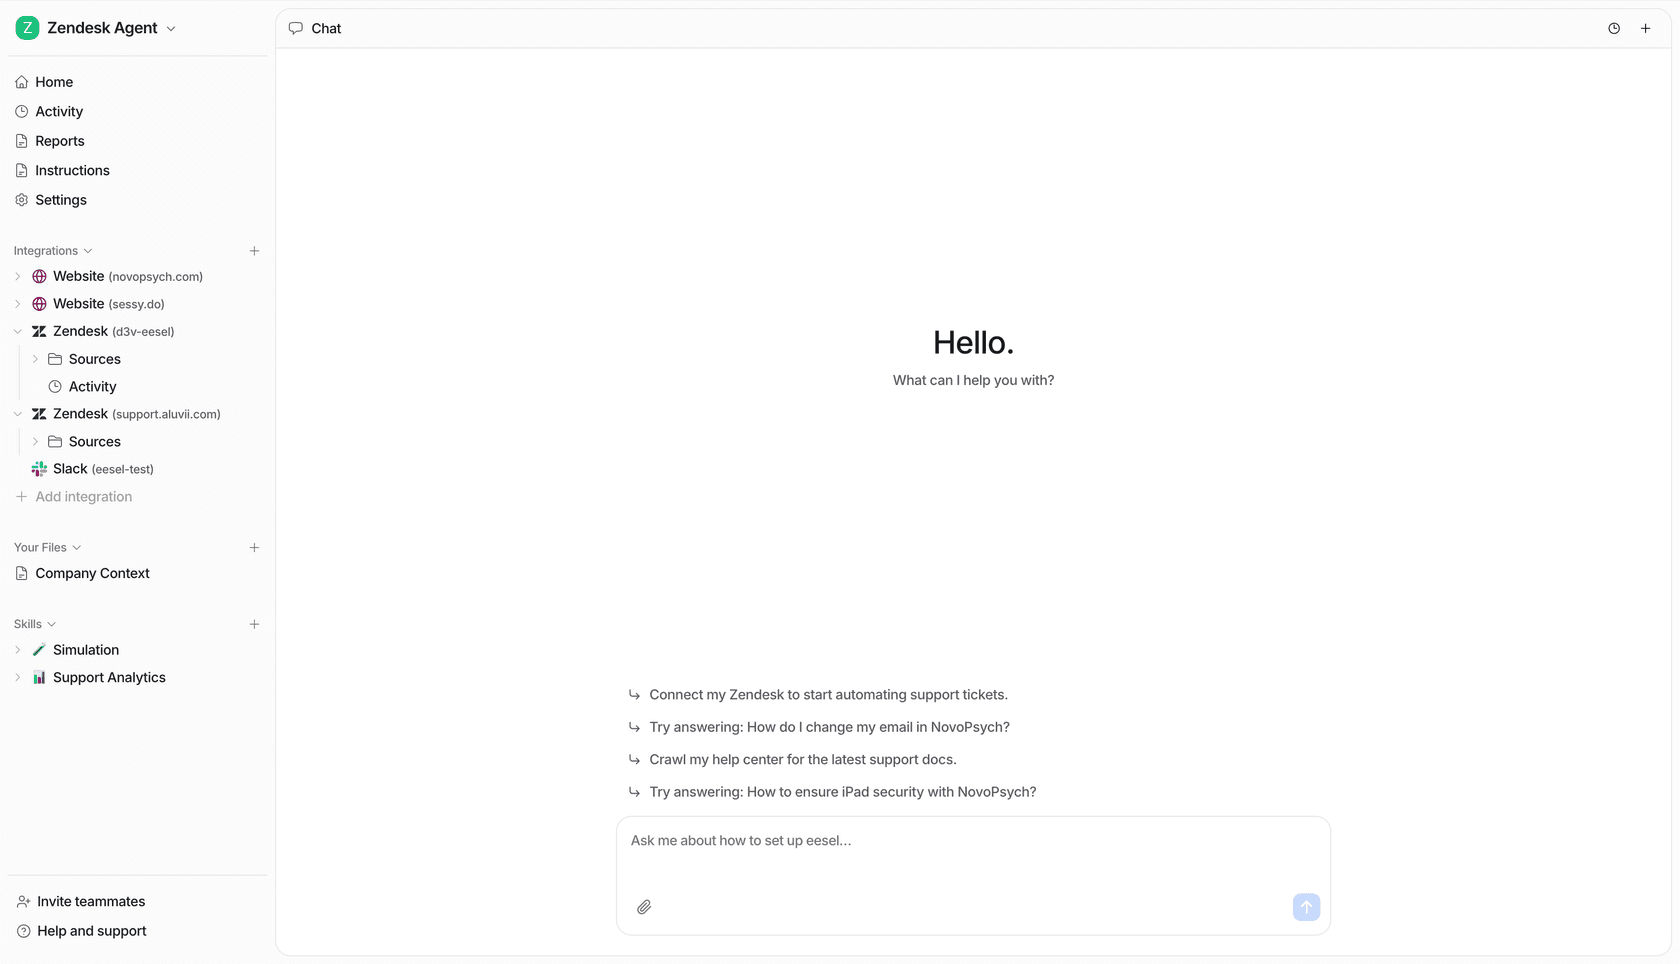
L'élément différenciant à connaître est la couche de tests que nous avons signalée plus tôt comme la partie que les équipes sautent. Avant qu'eesel ne réponde à un seul client en direct, vous pouvez le simuler sur vos propres tickets historiques pour voir comment il aurait répondu et où il aurait escaladé. C'est le filet de sécurité qu'un moteur construit à la main n'a presque jamais dès le premier jour, et il est tarifé à l'usage, à environ 40 centimes par ticket, sans frais par poste ni frais de plateforme. Vous pouvez l'essayer gratuitement et le pointer vers de vrais tickets avant de vous engager.
Questions fréquentes
Qu'est-ce que le support client IA headless ?
Le support client IA headless est-il la même chose qu'une API de chatbot de support ?
Dois-je construire mon propre frontend pour passer en headless ?
Combien coûte le support client IA headless ?
Quel est le rapport entre MCP et le support headless ?


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.