Les 8 meilleures alternatives à Laya AI en 2026

Rama Adi

Katelin Teen
Dernière modification September 21, 2026
Pourquoi chercher des alternatives à Laya AI
Je construis des intégrations et des API pour vivre, donc j'ai un faible pour Laya. La conception est honnête : au lieu de demander à un énorme modèle autorégressif de « répondre uniquement en JSON » en croisant les doigts, Laya fait passer votre état dans un encodeur bidirectionnel, évalue des questions typées en une seule passe et renvoie des probabilités calibrées. Pas de génération de tokens, donc pas de champs inventés ni de JSON malformé, par construction. C'est de l'Apache 2.0, ça tourne à 0,00 $ par million de tokens en auto-hébergement, et c'est présenté comme la réponse ouverte au Jev fermé de TypeSafe.
Les ennuis commencent dans la section limitations de Laya elle-même, sur laquelle le fil Hacker News s'est immédiatement jeté. Telle quelle, la version de base obtient environ 0,35 sur le benchmark de décisions typées, à peine au-dessus de la référence aléatoire de 0,318. Le très beau 0,766 n'apparaît qu'après un fine-tuning sur la partie entraînement du benchmark. C'est un gros astérisque, et les praticiens du fil l'ont dit sans détour :
"Idk, your limitations section sure makes it seem less drop in and less general than Jev. Like the point here isn't your ML aptitude it's how easy is it for developers to drop this into a product and use it. I'm more than capable of training a bert classifier... I don't want to manage GPUs / CPUs now. I don't want to maintain my corpus and retrain as my product's data distribution shifts... I do just want a reasonably good general classifier served to me with a great devex and calibrated confidence scores."

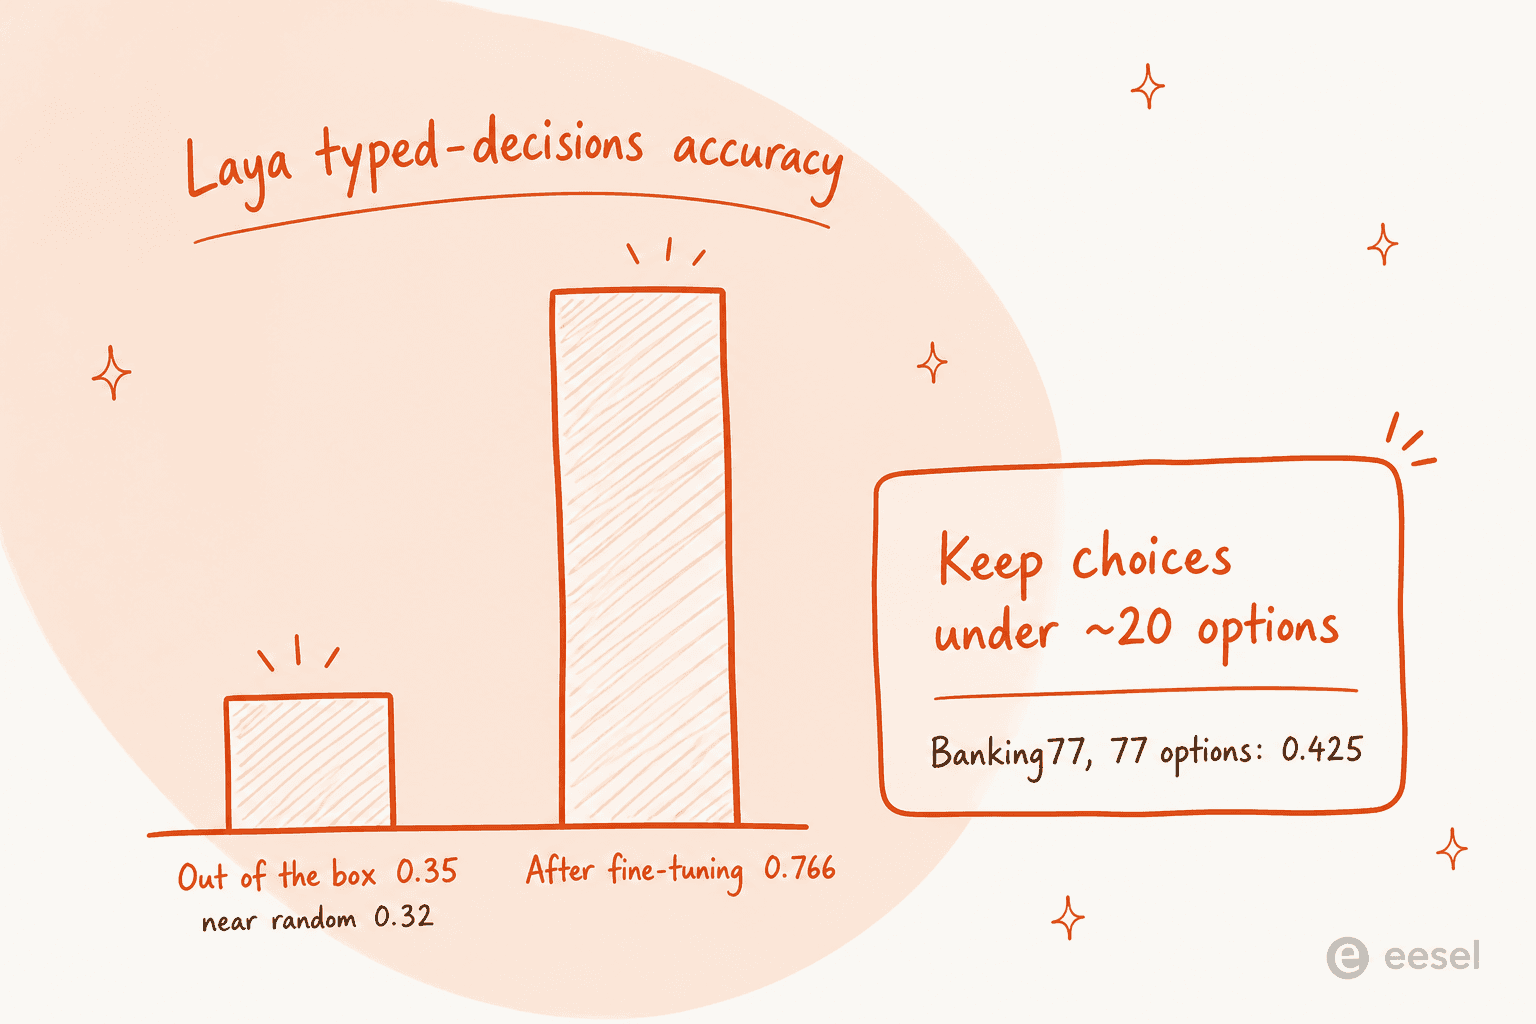
Il y a un second plafond à connaître avant de vous engager. Les questions à choix de Laya se dégradent au-delà d'environ 20 options, car les libellés candidats se partagent un budget de tokens fixe. Sur Banking77, un jeu d'intentions de 77 libellés, Laya a obtenu 0,425 contre 0,870 pour Jev. Beaucoup de problèmes de routage réels ont plus de 20 catégories, ce n'est donc pas un cas marginal pour tout le monde.
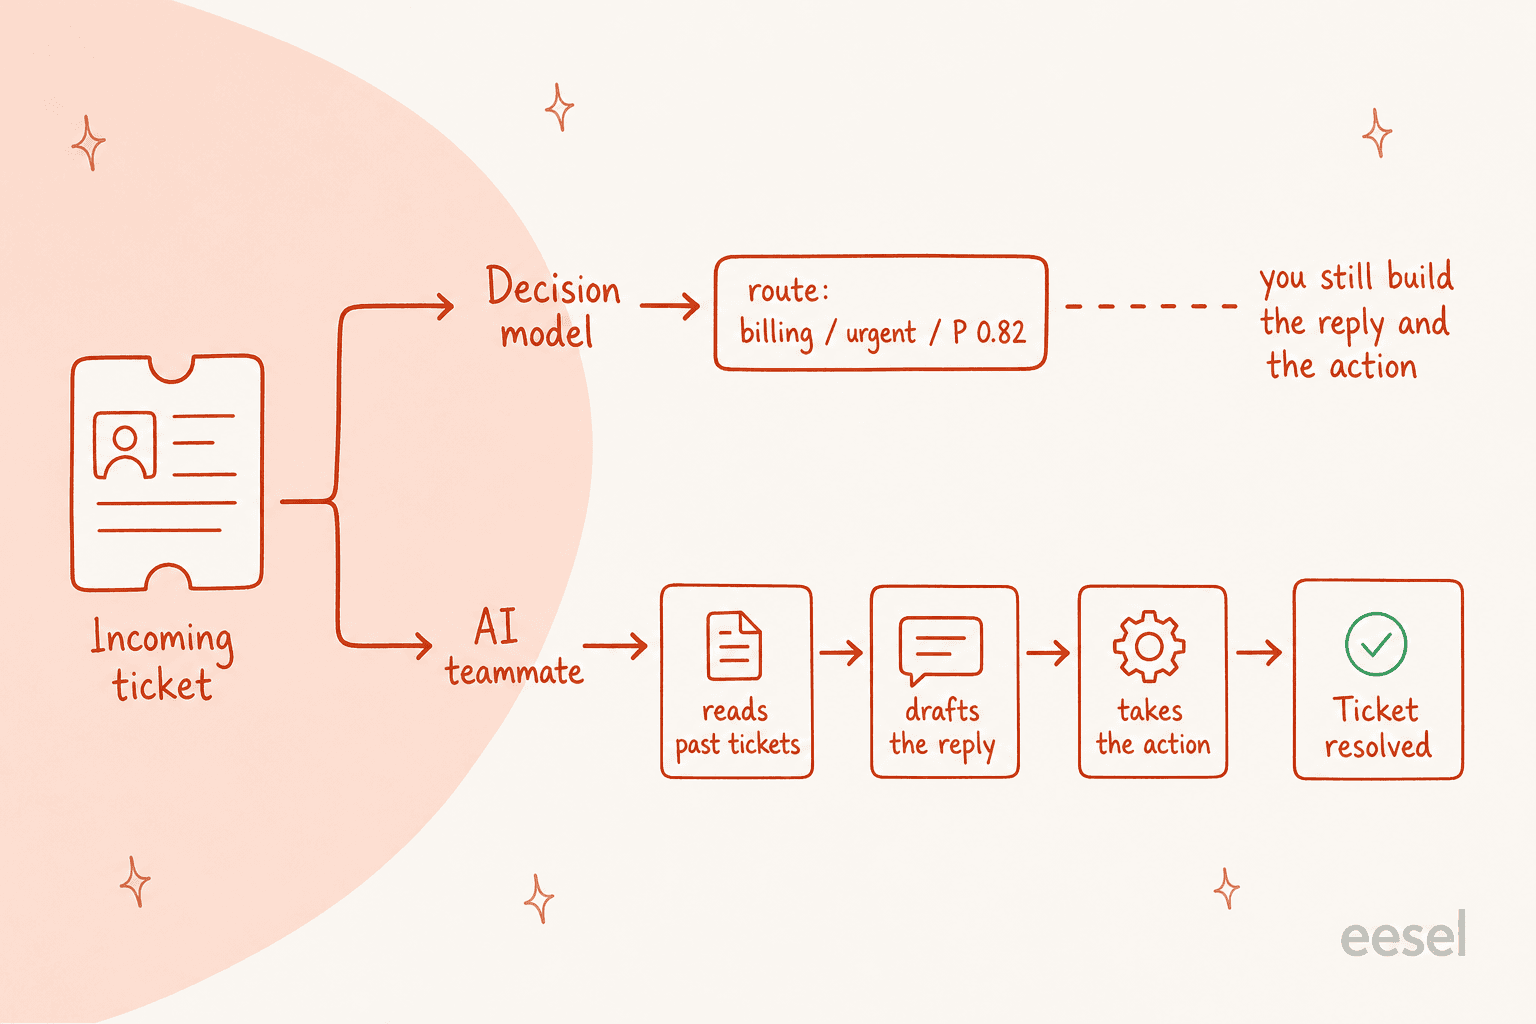
Et puis le point de cadrage, celui qui me tient le plus à cœur. Même au mieux de sa forme, Laya répond à une question. Il vous dit ce ticket concerne la facturation, urgent, P(0,82). Il n'écrit pas la réponse, ne rembourse pas la commande et ne passe pas la main à un humain. C'est très bien si vous construisez vous-même le produit autour, et rédhibitoire si vous pensiez acheter un résultat. Un commentateur a bien résumé l'attrait de toute la catégorie :
"The ability to knock out any arbitrary classification problem in minutes instead of in a week is a big deal... I don't want to spend a week to create a dataset, finetune a model, and set up infrastructure to run the model, every time I have a small routing or classification problem."
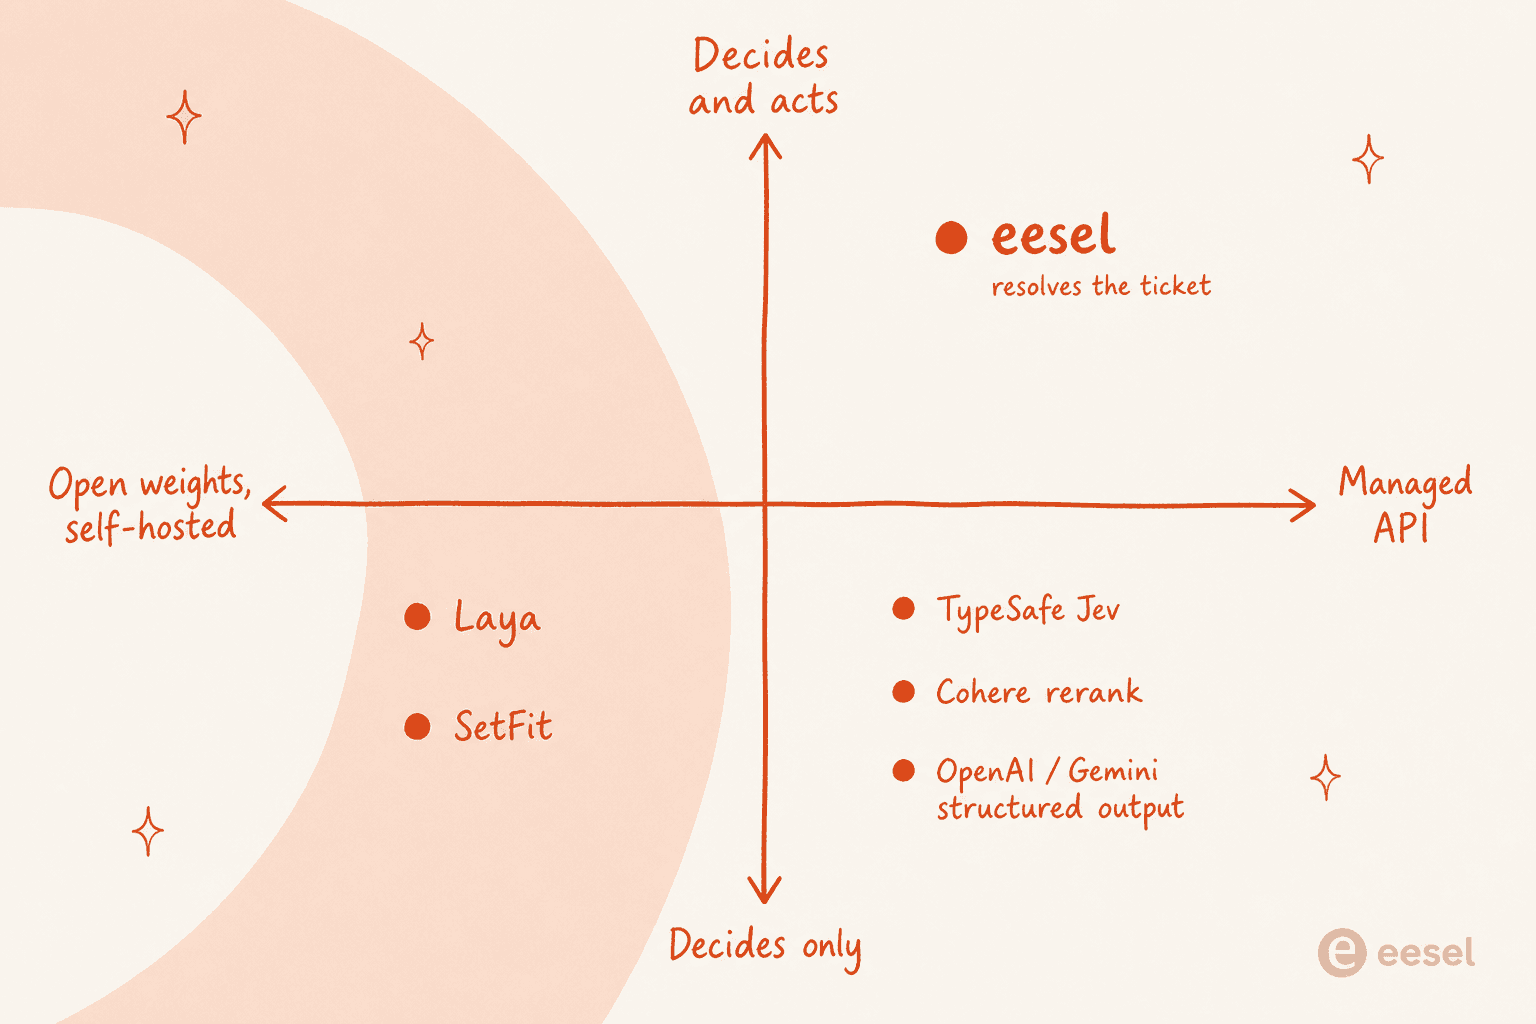
C'est la tension que chaque alternative ci-dessous résout à sa façon : combien voulez-vous faire tourner vous-même, et voulez-vous une décision ou une résolution ?
Comment j'ai choisi ces alternatives
J'ai évalué chaque option selon cinq critères :
- Ce qu'elle fait vraiment - classifieur pur, API de décision typée, bibliothèque de sortie contrainte ou coéquipier complet qui agit.
- Auto-hébergé ou managé - faites-vous tourner les poids ou appelez-vous un endpoint ?
- La confiance - peut-on se fier au score assez pour agir automatiquement, ou est-ce une boîte noire ? Tout l'argument de Laya est la calibration, les alternatives sont donc jugées à cette aune.
- Coût réel - licence, prix par appel et temps d'ingénierie que personne ne met dans le devis.
- Couverture multilingue - Laya couvre plus de 100 langues, les équipes de support internationales doivent donc savoir ce à quoi elles renonceraient.
Voici le paysage en une image avant d'entrer dans chaque outil.
Les alternatives à Laya AI en un coup d'œil
| Outil | Idéal pour | Type | Auto-hébergeable ? | Décide ou agit | Unité de facturation | Prix de départ |
|---|---|---|---|---|---|---|
| eesel | Résoudre vraiment les tickets de support | Coéquipier IA | Managé | Décide et agit | Forfaits de crédits dès 299 $/mois | Offre gratuite (100 crédits) |
| TypeSafe Jev | Un jumeau managé de Laya | API de décision | Managé | Décide | Par million de tokens | 0,042 $ / M en entrée, sortie gratuite |
| SetFit | Classification few-shot maîtrisée | Classifieur OSS | Oui | Décide | Aucune (calcul) | 0 $ (Apache 2.0) |
| Cohere | Pertinence RAG + classification | API managée | Option VPC / on-prem | Décide | Par recherche / par M | ~2,00 $ / 1K recherches |
| OpenAI Structured Outputs | Équipes déjà sur GPT | Fonction de LLM | Managé | Décide | Par million de tokens | Pas de supplément sur le modèle |
| Google Gemini | Classification structurée managée la moins chère | Fonction de LLM | Managé | Décide | Par million de tokens | Flash-Lite est le moins cher |
| Outlines / Instructor | Sûreté de schéma sur votre propre LLM | Bibliothèques OSS | Oui | Décide | Aucune (calcul) | 0 $ (Apache-2 / MIT) |
| Cloudflare Workers AI | Inférence en périphérie, Jev inclus | Catalogue managé | Managé | Décide | Neurons | Offre gratuite, puis à l'usage |
1. eesel
Idéal pour : les équipes qui réalisent que la décision n'était que la première étape, et que ce qu'elles veulent vraiment, c'est le ticket de support résolu.
Soyons honnêtes d'emblée, car le skill de blog avec lequel j'écris y tient : eesel n'est pas un modèle de décision, et si vous avez précisément besoin d'une brique de classification typée en 33 ms à brancher dans votre propre pipeline, l'un des outils ci-dessous est un meilleur remplacement littéral. Mais la plupart de ceux qui évaluent Laya pour du support ne veulent pas une étiquette, ils veulent le résultat auquel l'étiquette devait mener. C'est le vide qu'eesel comble.

eesel est une plateforme de coéquipiers IA : vous recrutez des coéquipiers prêts à travailler sur des missions précises, et l'équipe actuelle compte un coéquipier helpdesk IA et un rédacteur de blog IA. Le coéquipier helpdesk réalise toute la boucle qu'un modèle de décision ne peut pas faire : il lit des années de tickets passés et votre centre d'aide, rédige la réponse, exécute l'action, et route ou escalade quand il n'est pas sûr. Le routage en est une fonction, pas le produit entier.
C'est ici que nos années à faire tourner de l'IA sur de vraies files de support comptent dans cette comparaison. Les propres données de Laya montrent quelque chose qui mérite qu'on s'y arrête : sur le balayage multilingue, son modèle anglais a obtenu 0,000 de précision en khmer tout en affichant 0,952 de confiance moyenne. Un modèle peut être faux avec assurance et en toute calibration. Nous l'avons appris à la dure en voyant des bots donner des réponses assurées et complètement fausses, et c'est exactement pourquoi chaque déploiement d'eesel est simulé sur vos tickets historiques avant de toucher une conversation réelle. Vous voyez d'abord le vrai taux de résolution automatique sur vos propres données, pas un chiffre de benchmark.
Pour les développeurs qui aimaient la programmabilité de Laya, eesel expose le même coéquipier via la CLI eesel et MCP : vous pouvez l'installer, brancher des sources de connaissances, définir des instructions, lancer une simulation et vérifier l'activité depuis un terminal ou un script. Des agents de code comme Claude Code, Codex et Cursor peuvent le piloter de la même façon. C'est le même coéquipier qu'un responsable support non technique configure dans le tableau de bord, simplement utilisé comme du code.
Points forts :
- Décide et résout, sur Zendesk, Freshdesk, Slack, e-mail et plus de 100 autres outils.
- Simule sur votre historique réel de tickets avant la mise en production, la confiance repose donc sur vos données.
- S'entraîne en langage courant, avec en plus une interface complète CLI et MCP pour le public qui code.
Points faibles :
- Ce n'est pas une brique de classification brute ; si vous avez vraiment besoin d'un simple appel de modèle dans votre propre stack, ce n'est pas la bonne forme.
- C'est un coéquipier managé, pas des poids à faire tourner hors réseau.
Tarifs : gratuit pour commencer, puis un prix mensuel fixe à partir de 299 $/mois pour 500 crédits (1 crédit par ticket ou chat), vous payez donc les tickets traités plutôt que chaque token deviné.
Verdict : si la décision de routage a toujours servi à venir à bout d'une file de support, sautez la brique et recrutez le coéquipier. Si vous avez vraiment besoin d'un classifieur autonome, lisez la suite.
2. TypeSafe Jev
Idéal pour : exactement le cas d'usage de Laya, mais managé, sans rien à ajuster ni à héberger vous-même.
Jev est le modèle auquel Laya a voulu répondre, c'est donc l'alternative la plus naturelle de la liste. TypeSafe, fondée par Diogo Almeida (co-inventeur du RLHF chez OpenAI), l'appelle le premier « modèle System 1 » public : vous envoyez un état non structuré et des questions typées, et il renvoie des décisions probabilistes typées en une passe parallèle, avec les trois mêmes primitives que Laya a empruntées : noul, choice et score.
L'arbitrage face à Laya est net. Jev est fermé et facturé à l'usage, mais il est vraiment prêt à l'emploi, sans étape d'entraînement, ce que la foule de Hacker News répétait qu'il manquait à Laya. Les benchmarks de Laya affirment qu'il est 7,8 fois plus rapide et mieux calibré que Jev, mais ce sont les chiffres de Laya sur la configuration de Laya, et ils ne valent qu'après le fine-tuning que Jev ne vous demande pas. Sur une tâche à 77 classes, rappelez-vous, Jev a bel et bien battu Laya 0,870 à 0,425.
Points forts :
- Pas de poids, pas de GPU, pas de fine-tuning, l'expérience prête à l'emploi que Laya n'offre pas.
- Solide sur les tâches à choix de forte cardinalité où Laya décroche.
- Les tokens de sortie sont gratuits, les décisions lourdes en lecture coûtent donc peu.
Points faibles :
- Fermé et propriétaire, sans option isolée ni on-prem.
- Encore en accès anticipé, pas de page de tarifs publique au-delà du tarif ci-dessous, et une liste d'attente.
Tarifs : 0,042 $ par million de tokens en entrée, sortie gratuite, facturé via l'API.
Verdict : si vous aimiez le concept de Laya mais pas ses devoirs de fine-tuning ni son GPU, Jev en est la version managée. Sachez simplement que vous échangez l'ouverture contre la commodité. Pour un face-à-face complet côté managé, mon panorama des alternatives à Jev va plus loin.
3. SetFit
Idéal pour : les équipes prêtes à étiqueter quelques exemples et à entraîner, qui veulent un classifieur entièrement à elles.
Si l'exigence de fine-tuning de Laya est le point bloquant, SetFit en fait la fonctionnalité. C'est un framework Hugging Face (avec Intel Labs et l'UKP Lab) pour la classification de texte few-shot : il affine par apprentissage contrastif le corps d'un sentence-transformer, puis entraîne une petite tête de classification sur les embeddings. Pas de prompts, pas de verbalizers.
Le résultat phare est la bonne partie : avec seulement 8 exemples étiquetés par classe, SetFit rivalise avec le fine-tuning de RoBERTa Large sur un jeu complet de 3 000 exemples, avec un ordre de grandeur de paramètres en moins et un entraînement bien plus rapide. Il tourne sur CPU ou sur un GPU modeste, il est Apache-2.0, et le multilingue vient gratuitement en choisissant un corps de sentence-transformer multilingue. Puisque vous alliez de toute façon affiner Laya, SetFit est sans doute le chemin le plus mûr et le mieux documenté vers la même destination de « petit classifieur rapide ».
Points forts :
- Vraiment few-shot, ~8 exemples par classe suffisent pour démarrer.
- Entièrement ouvert (Apache-2.0), auto-hébergé, inférence à 0 $, comme Laya.
- Assez petit pour être entraîné et servi sur du matériel courant.
Points faibles :
- Classifieur seulement, pas d'API de « décisions » calibrée, pas de primitives noul/choice/score.
- Pas de routeur de langues intégré, vous choisissez vous-même le corps multilingue.
- Vous apportez toujours les données étiquetées et lancez l'ajustement en deux étapes.
Tarifs : gratuit, Apache-2.0. pip install setfit et c'est parti.
Verdict : le plus proche esprit frère open source de Laya pour la classification. Si la couche de confiance calibrée et le routeur multilingue ne sont pas rédhibitoires, SetFit est une façon plus sereine de posséder un classifieur.
4. Cohere
Idéal pour : les tâches de pertinence RAG et de classification pour lesquelles on se tourne vers Laya, livrées comme une API managée adaptée aux entreprises.
Plusieurs des cas d'usage vitrine de Laya, notamment le filtrage par pertinence de passages RAG, sont exactement ce que Cohere maîtrise discrètement depuis des années. Ses modèles Rerank évaluent la pertinence de chaque passage par rapport à une requête, et ses endpoints Embed et Classify s'occupent du travail du type « dans quelle catégorie va ce texte », le tout sans rien entraîner ni héberger.
La pile de récupération de Cohere est la partie que les praticiens adorent vraiment. Les équipes décrivent régulièrement Rerank comme la raison pour laquelle elles restent, même quand elles génèrent avec le modèle d'un autre fournisseur, car le classement par pertinence est le travail pour lequel il a été conçu.
Là où il diffère de Laya : c'est une API managée, pas des poids, même si Cohere est étonnamment accommodant sur ce point, avec des déploiements « Model Vault » en VPC et on-prem pour les équipes qui doivent garder leurs données chez elles. C'est une voie médiane que Laya (entièrement auto-hébergé) et Jev (entièrement fermé) ne proposent pas.
Points forts :
- Rerank est le meilleur de sa catégorie pour la pertinence RAG, un cas d'usage phare de Laya.
- Prise en charge de plus de 100 langues sur Embed 4 et Rerank 4.
- Option VPC / on-prem pour les équipes réglementées, plus une offre gratuite pour développeurs.
Points faibles :
- Managé et facturé à l'usage par défaut, pas l'auto-hébergement à 0 $ de Laya.
- Orienté entreprises, mettre la pile de récupération en production demande donc un vrai travail d'ingénierie, pas une installation en une ligne.
Tarifs : Rerank 4 Fast coûte 2,00 $ / 1K recherches, Rerank 4 Pro 2,50 $ / 1K, Embed 4 0,12 $ / M de tokens (texte). Essai gratuit pour développeurs.
Verdict : si ce que vous vouliez de Laya était du classement par pertinence ou de la classification et que vous préférez ne pas faire tourner de GPU, Cohere est la réponse managée adulte, surtout si vous avez besoin d'une option on-prem.
5. OpenAI Structured Outputs
Idéal pour : les équipes déjà sur GPT qui veulent des décisions typées, au schéma garanti, sans ajouter de modèle.
Vous n'avez pas strictement besoin d'un modèle de décision dédié pour obtenir une sortie typée. La fonction Structured Outputs d'OpenAI fait respecter à un modèle GPT-5.6 un JSON Schema que vous fournissez, de sorte que la réponse correspond garantiment à vos types (ou renvoie un refus explicite), et elle se branche directement sur Pydantic ou Zod.
La réserve honnête est celle autour de laquelle tout le débat « ne peut pas halluciner » a tourné : valide selon le schéma ne veut pas dire correct. Un modèle peut vous remettre une réponse parfaitement typée qui est simplement fausse, et contrairement à Laya, un LLM généraliste donne un signal de confiance plus flou (vous pouvez lire les logprobs, mais ce n'est pas la distribution calibrée que Laya est conçu pour produire). Vous payez aussi la latence et le coût complets d'un LLM à chaque appel, soit l'excès de plus de 500 ms que Laya voulait justement remplacer pour de simples décisions réflexes.
Points forts :
- Aucun nouveau modèle à adopter si vous êtes déjà chez OpenAI.
- Respect du schéma garanti, avec des refus explicites pour la sécurité.
- Structured Outputs lui-même n'ajoute aucun supplément au tarif de base des tokens.
Points faibles :
- Coût et latence complets d'un LLM pour ce que Laya fait en 33 ms.
- La confiance via
logprobsest un indicateur approximatif, pas des probabilités de décision calibrées.
Tarifs : pas de supplément pour la fonction, vous payez les tarifs de tokens du modèle sous-jacent (les modèles phares GPT-5.6 vont de 0,20 $ à 5,00 $ par million en entrée).
Verdict : la voie de moindre résistance si GPT est déjà dans votre stack et que votre volume de décisions est modeste. À fort volume, le coût par appel est exactement ce qui pousse vers un modèle de décision dédié.
6. Google Gemini
Idéal pour : la voie managée la moins chère vers la classification structurée, avec un modèle qui en fait un cas d'usage de premier plan.
La sortie structurée de Gemini fonctionne sur le même principe que celle d'OpenAI : vous passez un schéma de réponse et Gemini le respecte, et la documentation de Google cite explicitement la « classification structurée » comme cas d'usage pris en charge plutôt que comme un bricolage.
Gemini mérite sa propre place face à OpenAI grâce au prix en bas de gamme : le palier Flash-Lite vise la classification à fort volume et à bas coût, la pression économique qui envoie justement les gens vers Laya. Si vous voulez des décisions structurées managées mais que le calcul de tokens d'un modèle phare vous effraie, les petits modèles de Gemini sont le levier managé le moins cher ici. La même réserve « typé mais pas forcément correct » de la section OpenAI s'applique : c'est un LLM généraliste, pas un modèle de décision calibré.
Points forts :
- La classification structurée est un cas d'usage documenté et de premier plan.
- Le prix de Flash-Lite est conçu pour des décisions peu coûteuses à fort volume.
- Large couverture multilingue sans configuration supplémentaire.
Points faibles :
- Toujours la latence d'un LLM et un signal de confiance approximatif, pas la calibration de Laya.
- Vous enferme dans la surface d'API de Google.
Tarifs : pas de supplément pour la fonction par rapport aux tarifs de tokens des modèles Gemini, Flash-Lite étant le palier le moins cher.
Verdict : le meilleur choix managé quand le coût par décision est tout l'enjeu et que vous n'avez pas besoin de confiance calibrée. En pratique, la sortie structurée d'OpenAI avec un plancher plus bas.
7. Outlines et Instructor
Idéal pour : les équipes qui veulent garder leur propre LLM (ouvert ou hébergé) mais imposer un schéma au décodage.
Si votre objection à Laya est « je ne veux pas d'un modèle à part, je veux juste que mon modèle actuel arrête de renvoyer n'importe quoi », deux bibliothèques open source règlent cela directement. Outlines (par dottxt) impose la structure au décodage, de sorte que le modèle ne peut émettre que des tokens conformes à votre schéma, et fonctionne avec OpenAI, Ollama et vLLM. Instructor enveloppe les appels de modèle avec Pydantic et de la validation, et il est devenu la façon par défaut d'obtenir une sortie typée sur plus de 15 fournisseurs.
Ce ne sont pas des modèles de décision, ce sont des garde-fous autour du modèle que vous faites déjà tourner. C'est leur force (apportez vos propres poids, aucune nouvelle dépendance à servir) et leur limite (vous héritez de la latence, du coût et de l'absence de confiance calibrée de votre modèle de base). Outlines est en Apache-2, Instructor en MIT, tous deux gratuits. Notez que dottxt vend aussi une API hébergée payante au-dessus de la bibliothèque ouverte, si vous préférez ne pas la faire tourner.
Points forts :
- Gardez votre modèle actuel, rendez simplement sa sortie sûre en types.
- Entièrement ouverts (Apache-2 / MIT), auto-hébergés, projets actifs.
- L'application au décodage d'Outlines est vraiment difficile à contourner.
Points faibles :
- Pas un modèle, aucun gain de vitesse ni de coût par rapport au LLM en dessous.
- Pas de probabilités de décision calibrées, pas de routeur multilingue.
Tarifs : gratuit et open source. Outlines propose une API hébergée dottxt payante si vous la voulez managée.
Verdict : le bon outil si le vrai problème était la sûreté du schéma, pas la vitesse de décision. Associé à un petit modèle local, vous obtenez l'essentiel de la garantie « jamais malformé » de Laya sans adopter un nouveau modèle.
8. Cloudflare Workers AI
Idéal pour : les équipes qui veulent faire tourner de petits modèles (Jev lui-même inclus) en périphérie, facturés à l'usage.
Cloudflare Workers AI est un animal un peu différent : un catalogue de plus de 65 modèles hébergés que vous exécutez en périphérie, près de vos utilisateurs, sans infrastructure à vous. Il est pertinent ici pour une raison précise : il héberge typesafe/jev, donc si c'est le concept de modèle de décision qui vous intéresse, Cloudflare est l'un des moyens de l'appeler réellement.
L'argument face à l'auto-hébergement de Laya, c'est la latence et l'exploitation : votre décision s'exécute sur un site en périphérie proche de la requête, et vous ne touchez jamais un GPU. L'argument face au coût de 0 $ de Laya, c'est l'honnêteté : vous payez à l'usage (dans l'unité « Neurons » de Cloudflare), même s'il y a une offre gratuite pour démarrer. C'est moins un remplacement équivalent de Laya qu'une surface de déploiement pour toute la catégorie.
Points forts :
- Inférence en périphérie, faible latence réseau, aucune infrastructure à gérer.
- Héberge Jev et des dizaines d'autres petits modèles sur une même surface de facturation.
- Offre gratuite, puis mesure transparente en Neurons.
Points faibles :
- Facturé à l'usage, pas l'auto-hébergement gratuit que donne Laya.
- Vous choisissez dans le catalogue de Cloudflare, sans exécuter de poids personnalisés arbitraires.
Tarifs : quota gratuit, puis facturation en Neurons.
Verdict : plus une réponse à « où l'exécuter » qu'à « quoi exécuter ». Si la latence en périphérie et l'absence d'exploitation comptent plus que le dernier centime, c'est une façon propre de déployer un modèle de décision sans GPU.
Laquelle choisir vraiment ?
La carte du début le dit le mieux : vos deux vraies questions sont combien voulez-vous faire tourner vous-même et voulez-vous une décision ou une résolution. Ce petit sélecteur vous mène à la présélection.
Essayer eesel
Si vous avez découvert Laya en cherchant à rendre une file de support plus intelligente, voici le raccourci : la décision de routage n'a jamais été le but, c'était de fermer le ticket. eesel est le coéquipier helpdesk IA qui prend la décision de tri et agit en conséquence, en rédigeant la réponse, en exécutant l'action et en escaladant quand il hésite, en direct dans Zendesk, Freshdesk, Slack et plus de 100 autres outils.
La partie qui répond à la plus grosse réserve de Laya : comme un modèle sûr de lui peut quand même se tromper, eesel simule chaque déploiement sur vos tickets historiques avant de toucher un vrai client, vous voyez donc le vrai taux de résolution sur vos données, pas un benchmark. Et pour les développeurs qui aimaient la programmabilité de Laya, la CLI et MCP d'eesel vous permettent de piloter le même coéquipier depuis un terminal, un script ou un agent de code. Commencez gratuitement.