

Was Laya AI eigentlich ist
Der Slogan auf der Laya-Startseite lautet „decisions, not text“ (Entscheidungen, nicht Text), und das ist das ganze Produkt in drei Worten. Die meiste KI, die Sie bisher genutzt haben, ist autoregressiv: Sie sagt das nächste Token voraus, dann das nächste und baut so einen Satz auf. Das ist großartig, um eine Antwort zu schreiben, und schlecht für eine Ja-oder-Nein-Entscheidung, denn Sie lassen ein Sprachmodell laufen, um ein einziges Bit an Information zu erhalten, und parsen dann Freitext, um es wiederzugewinnen.
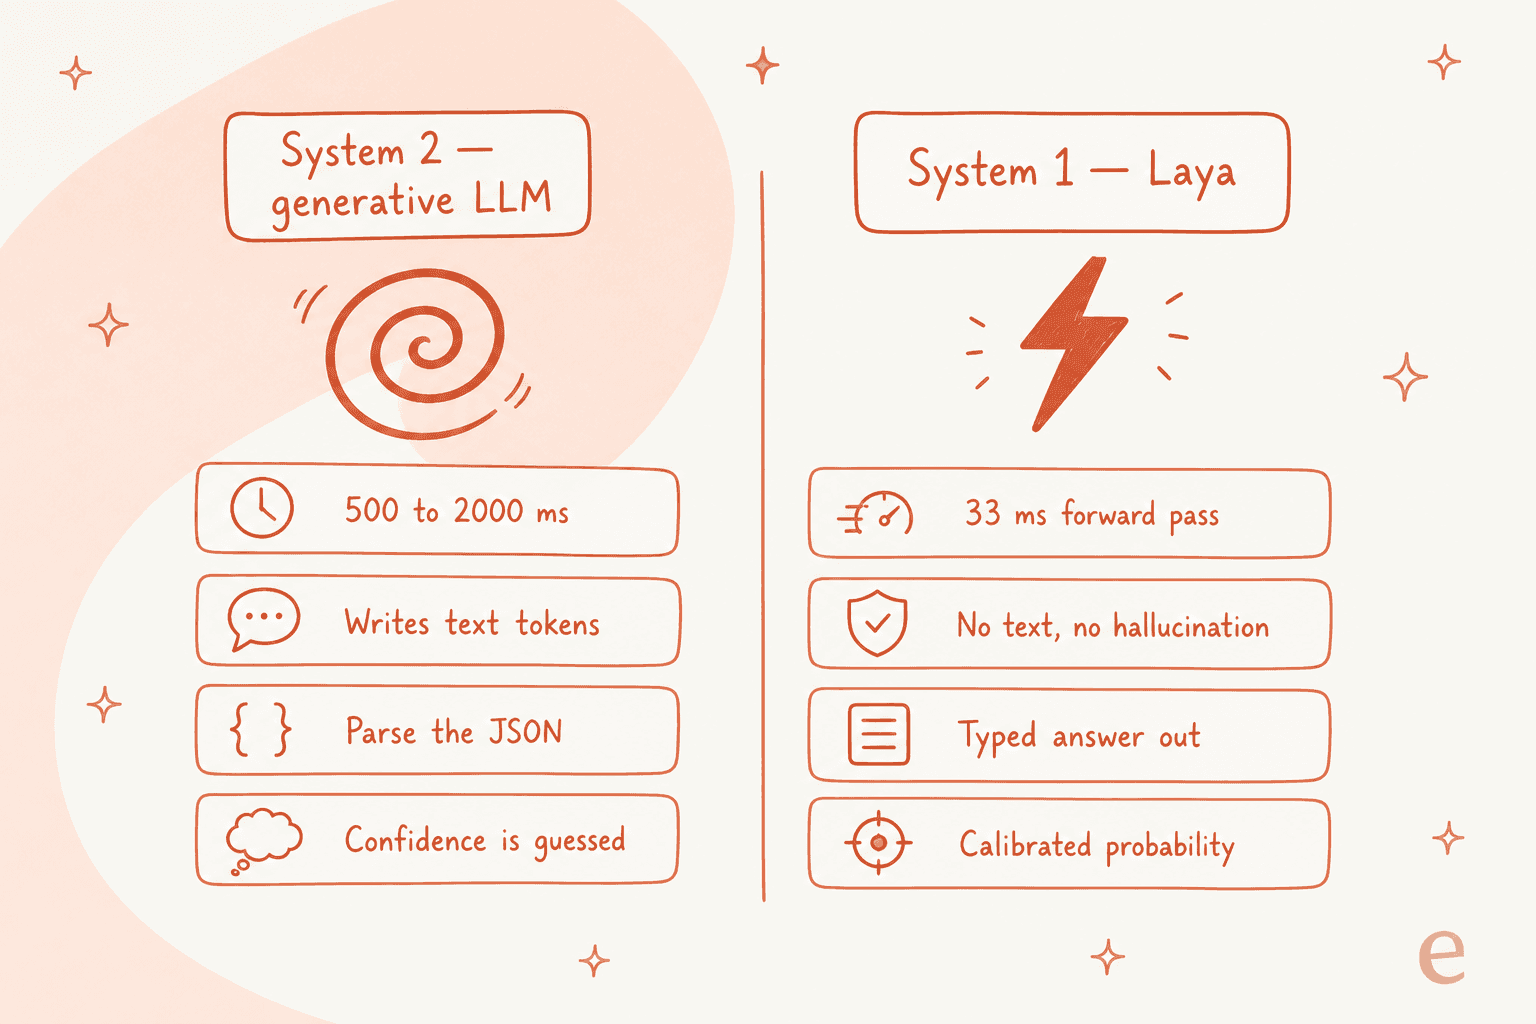
Laya ist die andere Art von Modell. Es ist ein bidirektionaler Encoder, der die gesamte Eingabe auf einmal liest und eine feste Frage beantwortet, indem er Ihre Optionen bewertet, statt sie auszuschreiben. Convai nennt es ein System-1-Modell: das sofortige, reflexhafte Urteil, im Gegensatz zum langsamen, abwägenden System-2-Denken eines generativen LLM. Der Entwickler, Nandakishor Mukkunnoth von Convai Innovations, bringt die Motivation unverblümt auf den Punkt:
"Not every AI problem requires an autoregressive chatbot."
Er hat recht, und wenn Sie jemals ein 8B-Modell mit einem Prompt verdrahtet haben, der auf „respond only with JSON“ endet, kennen Sie den Schmerz, den er beschreibt.
Die Idee: System 1, nicht System 2
Der Ansatz beruht auf einer echten Ineffizienz. Wenn Sie ein generatives Modell aufrufen, um ein Ticket zu routen oder eine Phishing-Mail zu markieren, zahlen Sie dreifach: 500 bis 2.000 ms Latenz, echte Inferenzkosten und fragiles String-Parsing am Ende. Schlimmer noch: Die Konfidenzzahl, die ein LLM Ihnen gibt, ist Theater. Nandakishor formuliert es so:
"When an LLM outputs 'confidence: 0.95', it is just predicting tokens that sound confident. There is zero mathematical calibration behind it."
Layas Antwort ist, die Reflex-Entscheidung zu einem eigenen Modell zu machen, das eine echte Wahrscheinlichkeitsverteilung liefert statt eines selbstsicher klingenden Satzes. Dieser Kontrast ist der gesamte Grund, warum das Modell existiert.
Diesen Teil finde ich am interessantesten, weil er zu etwas passt, das ich auf die harte Tour gelernt habe. Der gefährliche Fehler in der Support-Automatisierung ist nicht ein Bot, der „Ich weiß es nicht“ sagt. Es ist ein Bot, der selbstsicher falsch liegt. Ein Modell, das ehrliche Wahrscheinlichkeiten meldet, ist mehr wert als eines, das bei der reinen Genauigkeit einen Punkt höher liegt, weil Sie die Konfidenz tatsächlich als Schwelle nutzen und die wackligen Fälle eskalieren können. Laya ist von Grund auf um diese Idee herum gebaut.
Wie Laya unter der Haube funktioniert
Mechanisch nimmt Laya einen Zustand plus eine oder mehrere getippte Fragen und beantwortet sie alle in einem parallelen Durchlauf. Es gibt drei Frageprimitive, und sobald Sie sie kennen, merken Sie, dass sie die meisten „Entscheidungen“ einer Support-Pipeline abdecken:
- choice wählt eine Option aus einer von Ihnen definierten Menge (Routing, Intent, Thema).
- score ordnet den Zustand auf einer ordinalen Skala wie 0 bis 3 ein (Dringlichkeit, Frustration, Schweregrad).
- noul ist ein Boolean, der ein kalibriertes P(true) von 0.0 bis 1.0 liefert (Phishing, Spam, Jailbreak, Abwanderungsrisiko).
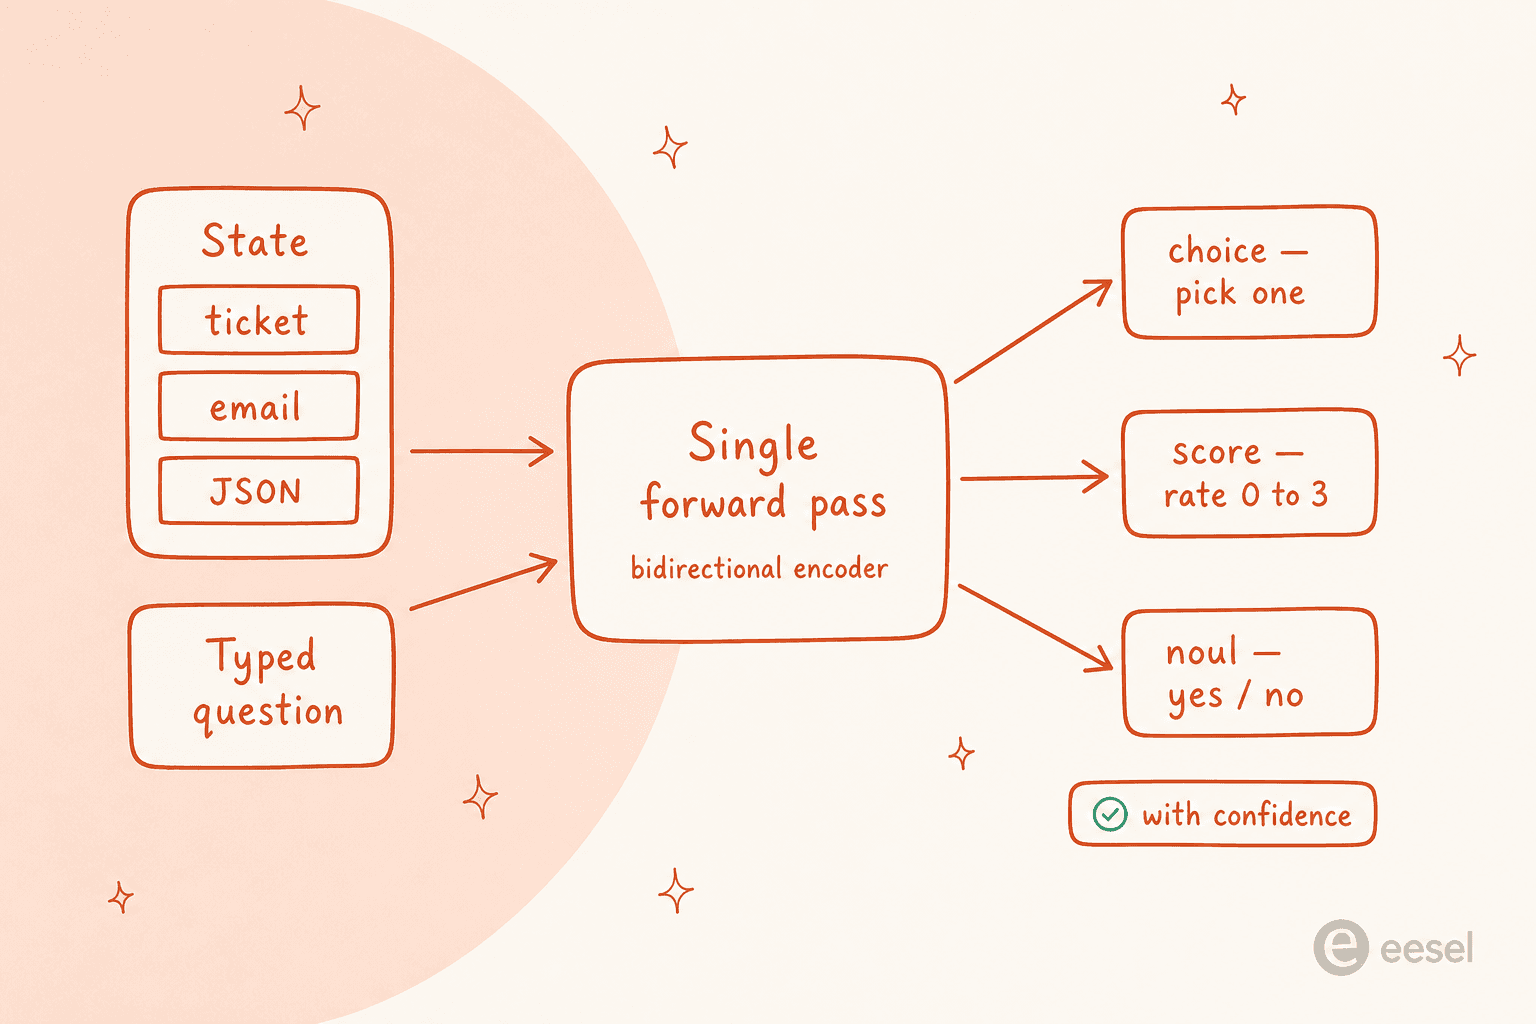
Das Clevere ist, wie es Optionen bewertet. Jede Option wird mit ihrem eigenen [MASK]-Token verpackt, das Modell liest den verborgenen Zustand an dieser Markierung, um einen Logit zu erzeugen, und wendet dann Softmax über die Optionen der Frage an. Weil der Antwortraum erst zur Anfragezeit definiert wird, brauchen neue Schemata kein Neutraining, Sie übergeben einfach andere Optionen. Der englische Checkpoint ist ModernBERT-large mit 421 Mio. Parametern, mit einem kleinen Entscheidungskopf obendrauf.
Dann ist da das Training, aus dem die Kalibrierung stammt. Laya wird mit dem trainiert, was Convai RLCD nennt: Reinforcement Learning gegen streng eigentliche Scoring-Regeln. Die Kurzfassung: Naives Training bringt einem Modell Übermut bei, weil das Hochdrücken der Gewinnwahrscheinlichkeit Richtung 1.0 eine einfache Genauigkeitsbelohnung maximiert. Nandakishors Satz dazu ist der schärfste der ganzen Veröffentlichung:
"Naive RL maximizes accuracy by destroying calibration. It turns your model into a confidently wrong machine."
RLCD belohnt das Modell dagegen nur, wenn seine gemeldete Wahrscheinlichkeit der Realität entspricht, sodass ehrliche Konfidenz der Weg zum Sieg ist. Das ist eine echte, überprüfbare Designentscheidung, kein Slogan, und genau das würde ich mir von Laya holen.
Die drei Checkpoints
„Laya“ ist in Wahrheit eine Familie aus drei Checkpoints in einem Hugging-Face-Repo, und die Wahl des richtigen ist wichtiger, als das Marketing vermuten lässt.
| Checkpoint | Backbone | Parameter | Am besten für |
|---|---|---|---|
convaiinnovations/laya | ModernBERT-large | 421M | Englische Guardrails, E-Mail-Triage |
laya-multilingual | mmBERT-base | 322M | 100+ Sprachen, ca. 2,2-mal schneller |
laya-typed-decisions | ModernBERT-large | 421M | Die vier Typed-Decisions-Workflows (0.766 Genauigkeit) |
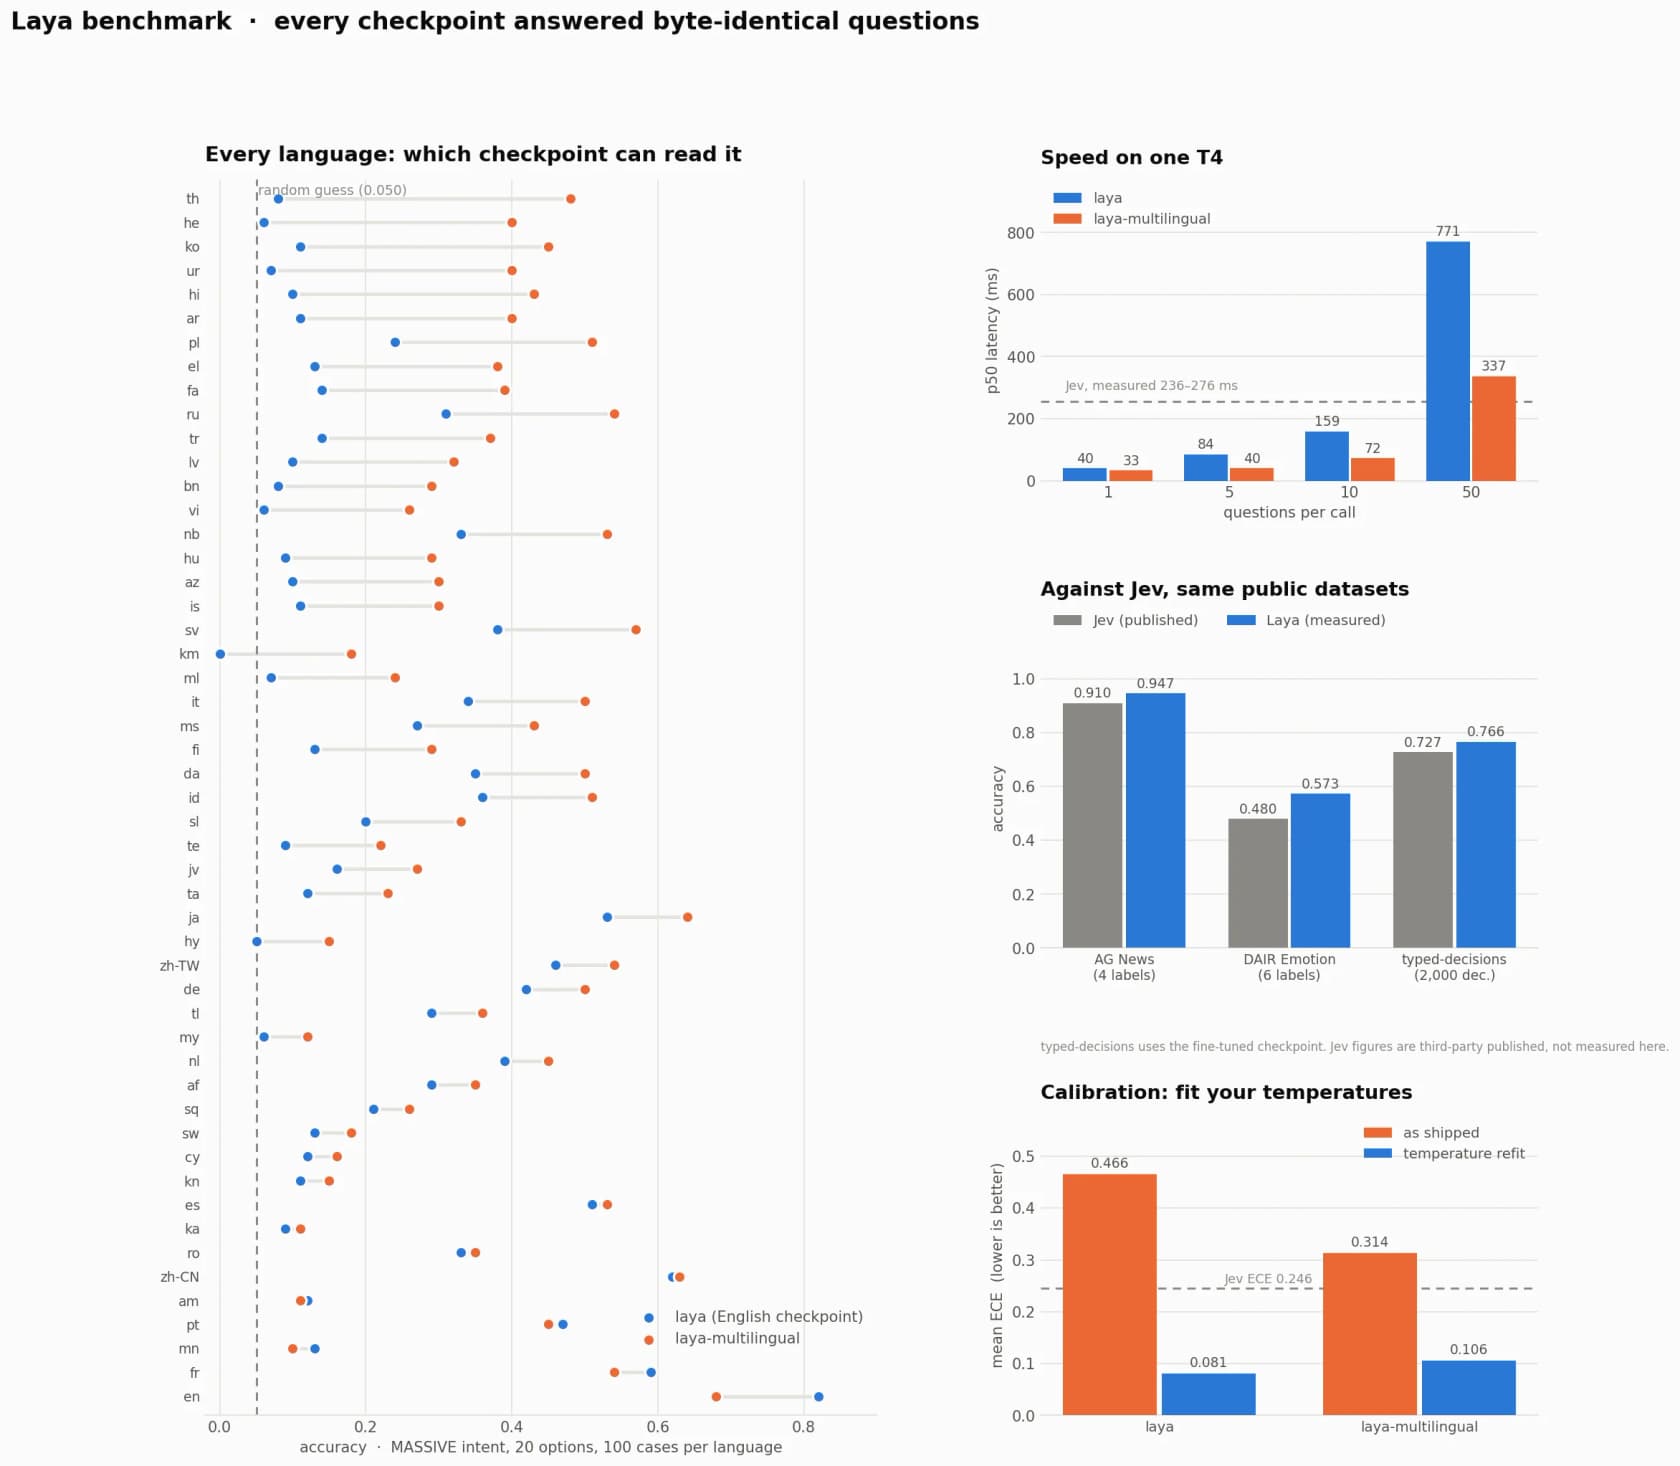
Das englische Basismodell bricht außerhalb lateinischer Schriften zusammen, und zwar nicht elegant. Im Test über 51 Sprachen erreichte es bei Khmer 0.000 Genauigkeit bei gemeldeter Konfidenz von 0.952, genau die „selbstsicher falsch“-Falle, die das Modell eigentlich vermeiden soll. Konfidenz-Gating kann Sie hier nicht retten, deshalb liefert Laya einen eingebauten Router mit, der die Schrift in unter einer halben Millisekunde erkennt und den mehrsprachigen Checkpoint wählt, bevor der Vorwärtsdurchlauf überhaupt läuft.
Die Benchmarks und der Vorbehalt, den alle übersehen haben
Hier ist der vollständige Vergleich, den das Projekt gegen Jev veröffentlicht hat. Es ist viel, aber die Kernaussage ist, dass Laya (mit Routing) Jev bei den gemeinsamen öffentlichen Datensätzen leicht übertrifft und dabei deutlich schneller und besser kalibriert ist.
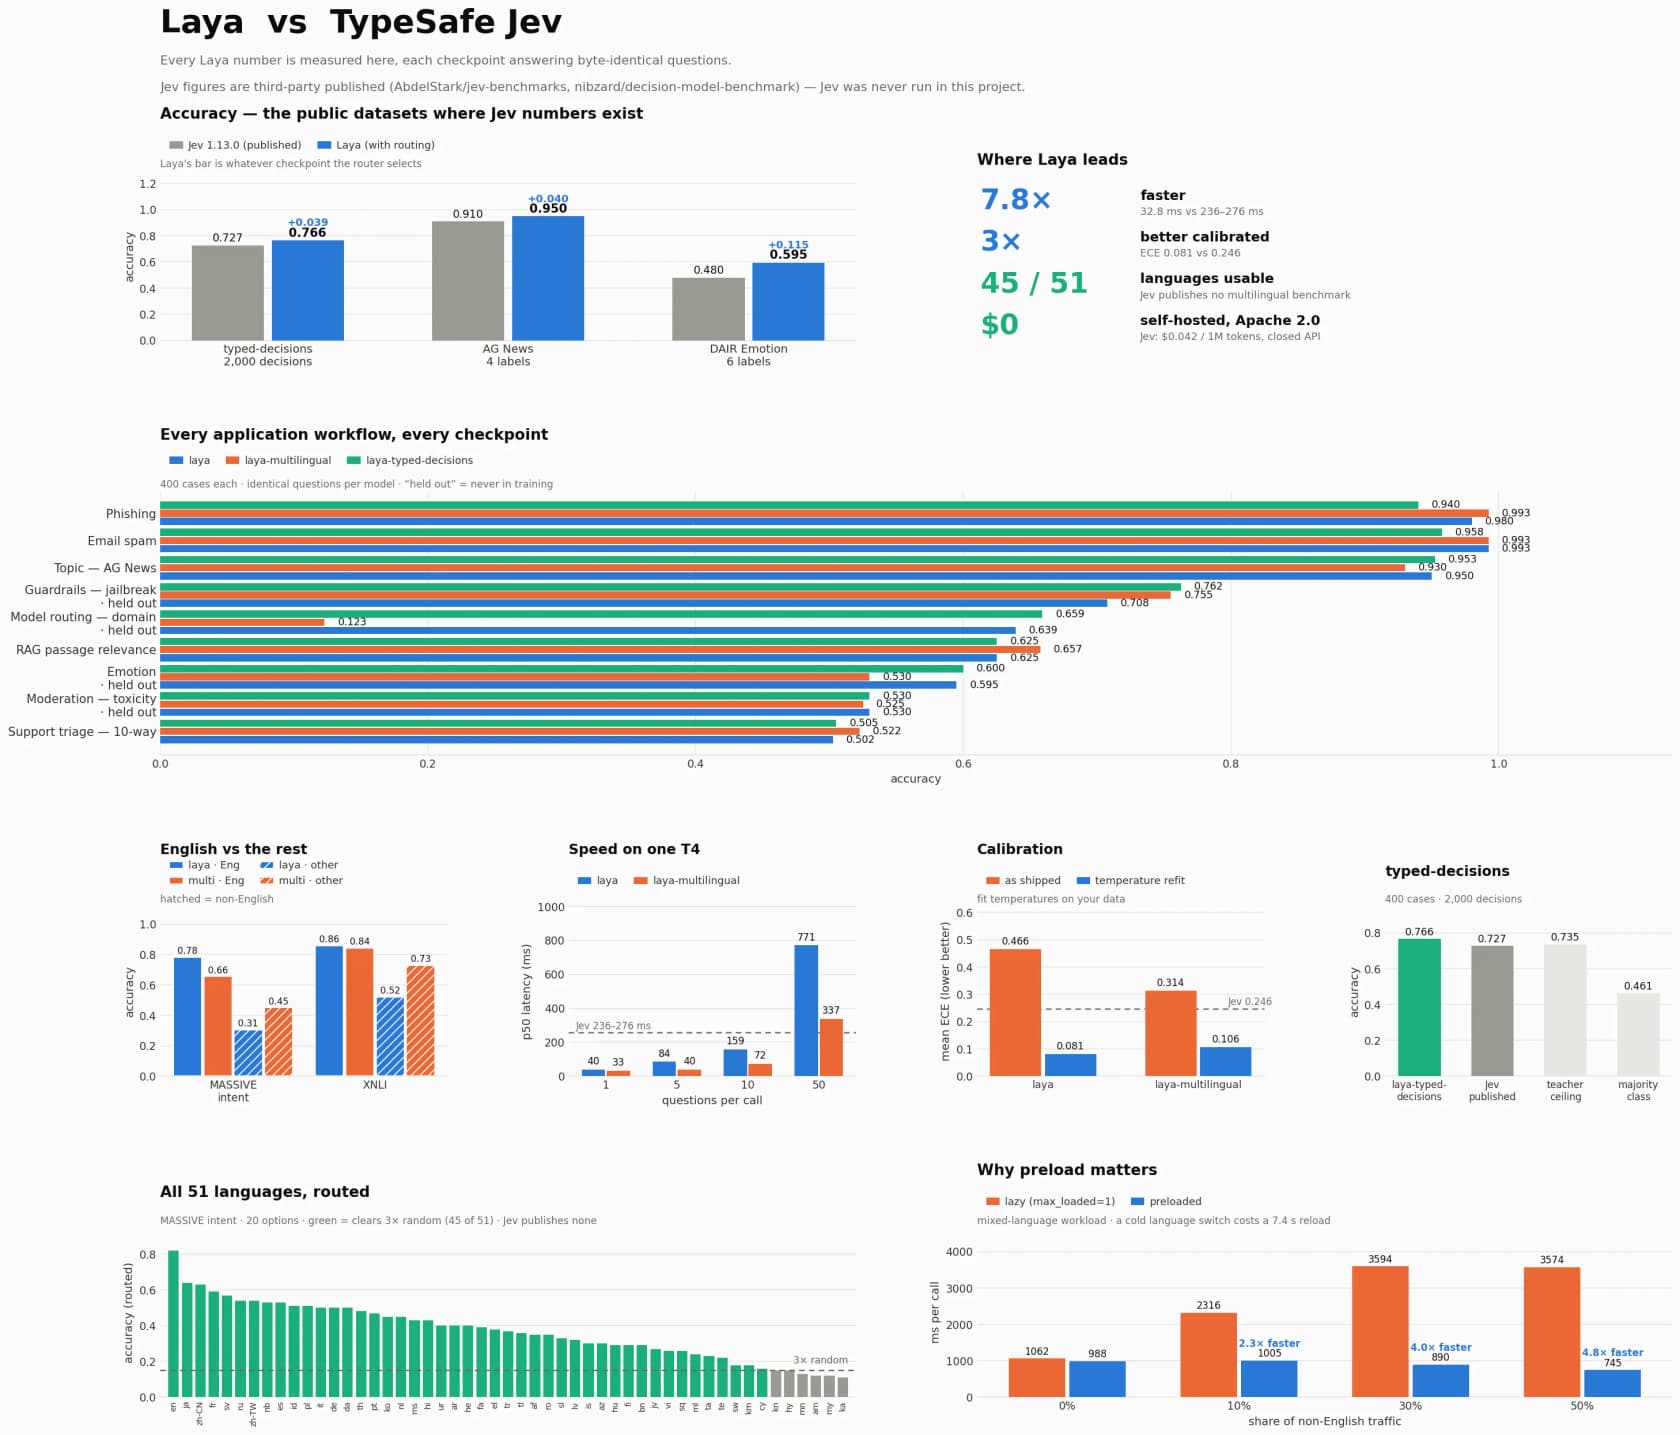
Die Zahlen, die man sich merken sollte, alle auf einer einzelnen Tesla T4 gemessen (die Jev-Werte stammen aus Drittquellen, da Convai keinen API-Zugang hatte):
- Latenz: 32,8 ms p50 für eine gerouteten Frage, gegenüber 236 bis 276 ms bei Jev. Das sind die 7,8-fache Geschwindigkeit.
- Kalibrierung: ECE von 0.081 nach Temperatur-Refit, gegenüber 0.246 bei Jev, ein 3-fach besserer Kalibrierungswert.
- Genauigkeit: 0.766 auf dem Typed-Set mit 2.000 Entscheidungen, gegenüber 0.727 bei Jev, und es übertrifft die Teacher-Obergrenze von 0.735.
Und dann das Sternchen, das die Diskussion dominierte. Diese 0.766 stammen vom feinabgestimmten Checkpoint. Die Basismodelle erreichen von Haus aus etwa 0.362 beim selben Benchmark, kaum über der Zufallsbasis von 0.318. Der Limitations-Abschnitt des Projekts sagt das selbst klar: Behandeln Sie Laya als schnelle Grundlage zum Spezialisieren, nicht als Zero-Shot-Orakel. Auf Hacker News, wo der Launch über 1.300 Punkte erreichte, war der meistbeachtete kritische Kommentar genau dieser:
"This should be way up in the article. Fine tuning is a pain, requiring it for good results put Laya in a whole different category vs Jev"

Das ist ein berechtigter Treffer. Jev wird als zero-shot nutzbar verkauft; Laya ist, ehrlich gelesen, eine Basis, die man spezialisiert. Die Verteidiger hatten ebenfalls eine faire Entgegnung: Ein schnelles, per Prompt steuerbares, kalibriertes Modell, das man an einem Nachmittag feinabstimmen kann, ist immer noch ein großer Schritt gegenüber der Verwaltung einer Flotte maßgeschneiderter Klassifikatoren.
Wofür Sie es tatsächlich einsetzen würden
Ohne das Jev-Drama ist Laya ein schneller Klassifikator mit ehrlicher Konfidenz und passt überall dort, wo Sie derzeit ein generatives Modell überbezahlen, um eine kleine strukturierte Entscheidung zu treffen. Das Projekt meldet echte Genauigkeiten pro Workflow, und die Streuung zeigt, wo es stark ist:
- E-Mail-Spamfilterung: 0.993
- Phishing-Erkennung: 0.980
- LLM-Guardrails und Jailbreak-Erkennung: 0.755 bis 0.762 (0.931 bei 50 % selektiver Abdeckung)
- Relevanz von RAG-Passagen: 0.657
- Support-Ticket-Routing, 10 Klassen: 0.522
Die binären Sicherheitsentscheidungen sind exzellent; bei der breiten, unscharfen Klassifikation braucht es das Fine-Tuning. Das Argument aus der Praxis für ein solches Modell wurde auf HN gut formuliert und deckt sich mit dem, was ich von Teams höre, die in einzelnen Routing-Regeln ertrinken:
"The ability to knock out any arbitrary classification problem in minutes instead of in a week is a big deal... I don't want to spend a week to create a dataset, finetune a model, and set up infrastructure to run the model, every time I have a small routing or classification problem."
In diesem Thread gibt es eine echte Spannung, die man benennen sollte, denn sie ist die eigentliche Kaufentscheidung. Manche Entwickler wollen ein Drop-in, das sie nie trainieren müssen:
"I don't want to manage GPUs / CPUs now. I don't want to maintain my corpus and retrain as my product's data distribution shifts... I just want a reasonably good general classifier served to me with a great devex and calibrated confidence scores to help me figure out when to fallback."
Das ist für viele Teams die ehrliche Grenze von Laya: Es ist ein hervorragender Baustein, wenn Sie bereit sind, es zu betreiben und zu spezialisieren, und weniger passend, wenn Sie etwas wollten, das sofort einfach funktioniert.
Geschwindigkeit, Sprachen und Kosten
Eindeutig stark ist Laya bei den banalen operativen Dingen. Es läuft bei 45 von 51 Sprachen mit Routing über dem Dreifachen des Zufallsniveaus, während es von Jev keine veröffentlichten mehrsprachigen Zahlen gibt.
Bei den Kosten: Es steht unter Apache 2.0 und wird selbst gehostet, also $0.00 pro Million Tokens gegenüber Jevs $0.042, und es läuft luftdicht abgeschottet auf Ihrer eigenen Hardware, was für alle mit HIPAA- oder DSGVO-Auflagen wichtig ist. Die Installation ist ein Einzeiler, pip install laya, und Router(preload=True) hält alle Checkpoints im Speicher, sodass Sie bei Sprachwechseln ein Neuladen von 7 bis 10 Sekunden vermeiden. Das GitHub-Repo hat über 9.000 Sterne, und es gibt einen Live-Demo-Space, falls Sie vor dem ersten Code herumprobieren wollen.
Der eine Vorbehalt bei Problemen mit vielen Klassen: choice-Fragen verschlechtern sich bei mehr als etwa 20 Optionen mit dem Standard-Token-Budget. Auf Banking77 (77 Labels) erreichte Laya 0.425 gegenüber 0.870 bei Jev, weil jede Option nur 3 bis 4 Tokens zur Unterscheidung erhält. Die Lösung ist, das Budget zu erhöhen oder eine Hierarchie von grob nach fein aufzuteilen, aber von Haus aus ist ein Router mit 10 Klassen komfortabel und einer mit 77 nicht.
Die Kontroverse: Wer hat es zuerst gebaut
Über Laya kann man nicht schreiben, ohne die Entstehungsgeschichte zu erwähnen, denn sie ist der halbe Grund, warum der Beitrag viral ging. Nandakishors Darstellung ist ein Prioritätsanspruch: Er sagt, er habe diesen nicht-autoregressiven, mit RL trainierten Entscheidungsansatz in einem arXiv-Paper vom März 2025 und einer Folgearbeit vom September 2025 veröffentlicht, ein volles Jahr bevor TypeSafe Jev mit großem Tamtam startete.
"It is incredibly frustrating when something you poured your heart into for months as an open-source researcher gets overlooked because it was built for a vertical use case, while a funded lab packages the same core idea horizontally and gets all the glory."
Die Community war gespalten, und zwar fair. Manche wiesen darauf hin, dass sauberes Branding und eine nutzbare API selbst das Produkt sind und dass seine frühere Arbeit als Nischen-Tool für „Sales-Conversion“ vermarktet wurde, das niemand las. Andere zeigten Sympathie, und mehrere waren froh, dass es die offene Version überhaupt gibt, auch wenn sie über den Launch-Hype um beide Modelle die Augen verdrehten:
"I had used versions of bert to achieve the same functionality years ago. But to me it seems like they were able to trick the VCs with 'can't hallucinate' etc. To the above author, kudos for sharing your work and making it open."
Meine Einschätzung: Das Prioritätsargument lenkt von einem starken Release ab. Ob Laya zuerst da war oder nicht, es ist offen, schnell, ehrlich dokumentiert und funktioniert gut für die Aufgaben, bei denen es ehrlich ist. Das ist mehr wert als der Streit um die Urheberschaft.
Wo ein Entscheidungsmodell hinpasst und wo ein KI-Teamkollege
Hier kommt der Teil, der mir am wichtigsten ist, denn ich baue so etwas beruflich. Ein Entscheidungsmodell und ein KI-Teamkollege sind keine Konkurrenten. Sie leben auf unterschiedlichen Ebenen.
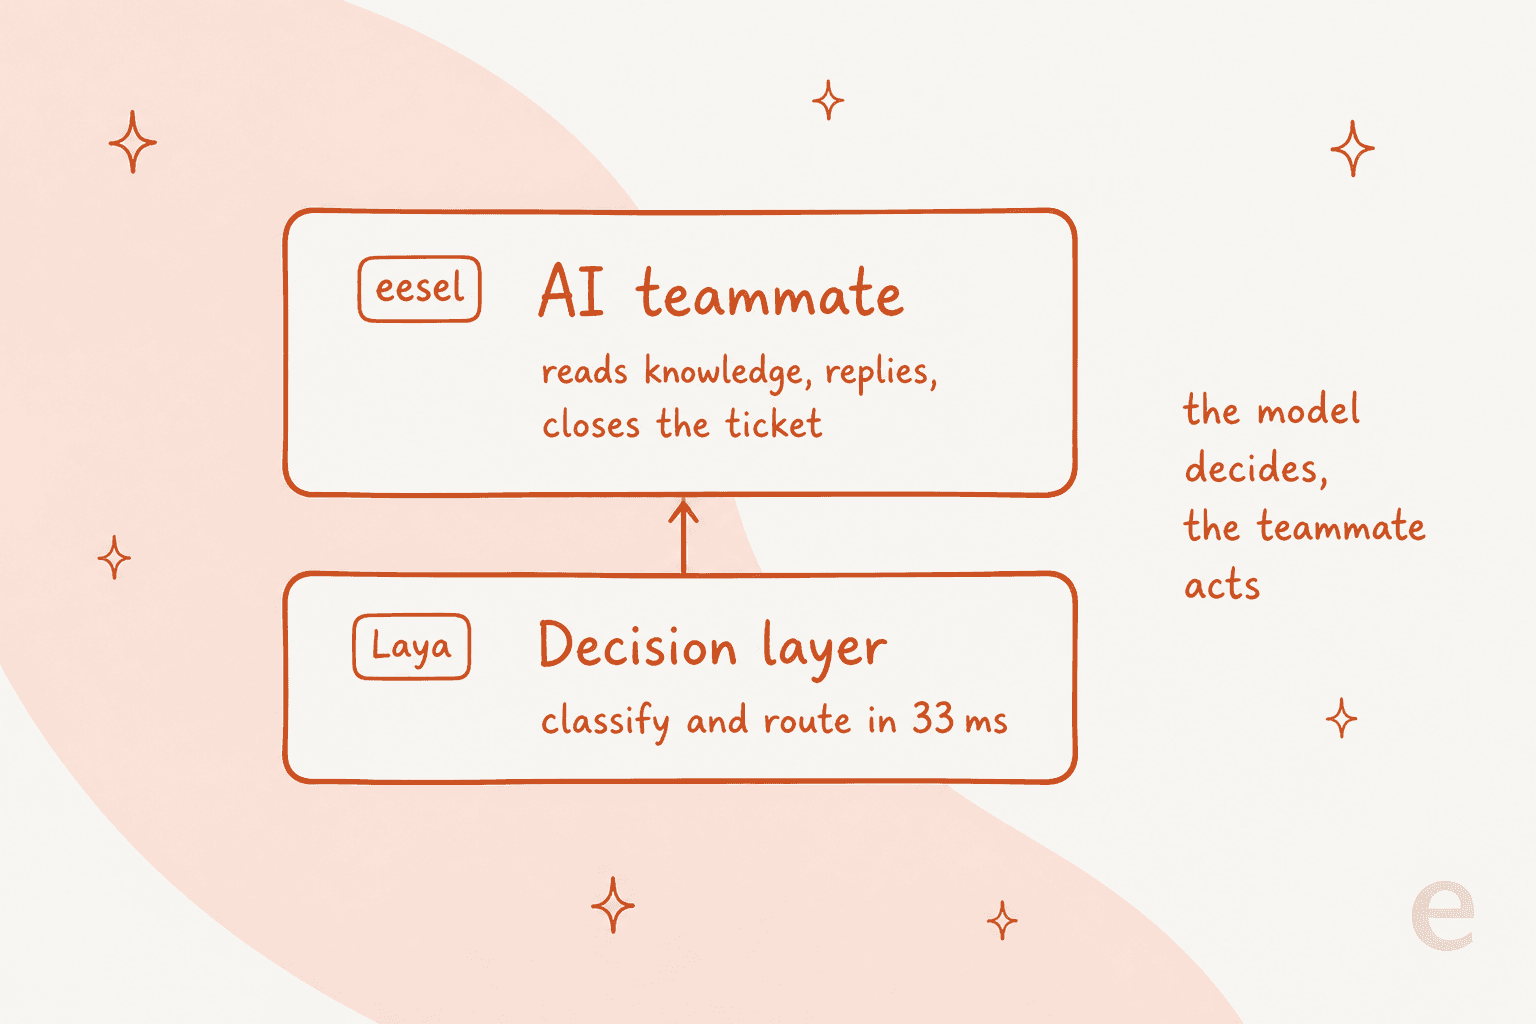
Laya ist Infrastruktur. Es beantwortet „In welche Queue gehört dieses Ticket?“ oder „Ist das dringend?“ in 33 ms und macht diese eine Sache wunderbar. Aber es liest Ihr Help Center nicht, entwirft keine Antwort, prüft keinen Bestellstatus und schließt die Unterhaltung nicht ab. Das sind die eigentlichen Aufgaben, die ein Support-Team erledigt haben muss, und dafür braucht es ein Modell, das handelt, nicht nur klassifiziert.
Das ist der Unterschied zwischen einer Komponente und einem Mitarbeiter. eesel ist eine Plattform für KI-Teamkollegen, und der KI-Helpdesk-Teamkollege ist der, der für den Support eingestellt wird: Er tritt Ihrer bestehenden Queue bei, in Zendesk, Freshdesk oder wo auch immer Sie bereits arbeiten, liest Ihre bisherigen Tickets und Dokumente und löst das ganze Ticket von Anfang bis Ende. Unter der Haube trifft er dieselbe Art schneller, kalibrierter Routing- und Konfidenzentscheidungen, in denen Laya gut ist, verpackt sie aber in das Lesen, das Entwerfen und das Handeln, die aus einer Klassifizierung eine gelöste Unterhaltung machen. Wenn Sie Entwickler sind und diesen Teamkollegen direkt skripten oder automatisieren möchten, lassen die eesel CLI und der MCP-Server eine Person, ein Skript oder einen Coding-Agenten wie Claude Code denselben Workspace steuern, den auch das Dashboard nutzt.
eesel ausprobieren
Wenn Sie sich Laya ansehen, weil Sie klügere, schnellere Support-Entscheidungen wollen, lohnt es sich, klar zu benennen, was Sie kaufen. Ein Entscheidungsmodell gibt Ihnen eine Komponente zum Bauen. Ein KI-Support-Teamkollege gibt Ihnen den fertigen Mitarbeiter.

Ich vertraue dem Kalibrierungsargument von Laya, weil ich die Alternative erlebt habe. Wir haben gesehen, wie selbstsicher klingende Bots in Live-Queues stillschweigend falsche Antworten gaben, weshalb jeder eesel-Rollout zuerst eine Simulation über Ihre eigenen historischen Tickets durchläuft, damit Sie die genaue Lösungsrate und die genauen Antworten sehen, bevor ein einziger Kunde berührt wird. Die Preise sind ein fester Monatspreis, ab $299/Monat für 500 Credits (1 Credit pro Ticket oder Chat), ohne Gebühren pro Nutzer, und es gibt einen kostenlosen Plan mit 100 Credits. Wenn die Entscheidung umgesetzt und nicht nur etikettiert werden soll, ist das die Ebene, die Sie sich ansehen sollten.
Was ich einem Freund sagen würde
Laya ist ein echter Beitrag, und ich bin froh, dass es offen ist. Wenn Sie Entwickler mit Klassifikations- oder Routing-Problemen sind und Lust aufs Fine-Tuning haben, ist es eines der interessantesten neuen Werkzeuge des Jahres: schnell, kalibriert, mehrsprachig und kostenlos. Lesen Sie die Model Card, sie ist erfrischend ehrlich über die eigenen Grenzen.
Aber lesen Sie den Abschnitt zu den Grenzen, bevor Sie darauf aufbauen. Die Zero-Shot-Werte liegen nahe am Zufall, die Konfidenz muss auf Ihren Daten neu angepasst werden, und breite Klassifikation braucht Fine-Tuning. Behandeln Sie es als die ausgezeichnete Grundlage, die es zu sein vorgibt, und wenn Sie eigentlich die ganze Support-Arbeit erledigt haben wollen statt einer einzelnen zurückgegebenen Entscheidung, greifen Sie zu einem Teamkollegen, nicht zu einer Komponente.
Häufig gestellte Fragen
Was ist Laya AI?
Laya AI ist ein quelloffenes Entscheidungsmodell mit 421 Mio. Parametern von Convai Innovations. Statt wie ein Chatbot Text zu generieren, nimmt es einen Zustand (ein Ticket, eine E-Mail oder JSON) plus getippte Fragen entgegen und liefert in einem einzigen Vorwärtsdurchlauf von ca. 33 ms getippte Antworten mit kalibrierten Wahrscheinlichkeiten. Es steht unter Apache 2.0 und ist als offene Antwort auf das geschlossene Jev von TypeSafe AI positioniert.
Was kostet Laya AI?
Laya ist kostenlos. Die Gewichte liegen unter Apache 2.0 auf Hugging Face, Self-Hosting kostet also $0.00 pro Million Tokens, gegenüber $0.042 pro Million Tokens bei der geschlossenen Jev-API. Ihre einzigen Kosten sind die GPU oder CPU, auf der Sie es betreiben. Wenn Sie lieber gar kein Modell betreiben möchten, übernimmt ein KI-Helpdesk-Teamkollege sowohl die Klassifizierung als auch die Antwort für Sie.
Eignet sich Laya AI für das Ticket-Routing?
Es ist eine starke Basis dafür. Bei einem Support-Triage-Benchmark mit 10 Klassen erreicht das Basismodell 0.522, und der feinabgestimmte Checkpoint übertrifft beim Typed-Decisions-Set die Obergrenze des Teacher-Modells. Außerdem liefert jede Antwort einen kalibrierten Konfidenzwert für das Fallback-Gating. In unserer Übersicht zu KI-Tools für die Ticket-Triage sehen Sie, wie das in einen echten Support-Stack passt.
Kann Laya AI wirklich nicht halluzinieren?
Innerhalb seines Ausgaberaums ja. Laya gibt nie Text-Tokens aus, sondern liefert nur Wahrscheinlichkeiten über eine feste, von Ihnen definierte Optionsmenge. Eine fehlerhafte Antwort oder eine erfundene Kategorie ist daher konstruktionsbedingt unmöglich. Es kann trotzdem falsch liegen, weshalb der kalibrierte Konfidenzwert wichtiger ist als der Marketingspruch.
Muss ich Laya AI feinabstimmen?
Für ernsthafte Genauigkeit meist ja. Von Haus aus erreichen die Basis-Checkpoints beim Typed-Decisions-Benchmark nur etwa zufällige Werte (~0.362); die Schlagzeilenzahl 0.766 stammt vom Fine-Tuning auf genau diese Aufgabe. Betrachten Sie Laya als schnelle Grundlage zum Spezialisieren, nicht als Zero-Shot-Orakel, und passen Sie die Temperatur auf Ihren eigenen Daten neu an, bevor Sie den Konfidenzwerten vertrauen.