人々が「ターミナルからAIエージェントを管理する」と言うとき本当に求めていること
私はeeselでインテグレーションとAPIを開発しているので、この検索フレーズは自分の仕事にとても近いものです。誰かがこれを入力するとき、シェルでのチャットプロンプトを求めていることはほとんどありません。それはプラットフォームエンジニア、オペレーションリード、あるいはファウンディングエンジニアであり、すでに他のすべてをコマンドラインから運用していて、完全にWebダッシュボードの裏に存在するAIサポートエージェントを渡されたばかりの人です。それは、クリックでしか設定できないサーバーが間違って感じられるのと同じように、間違って感じられます。
その直感は正しく、多くのエンジニアが私より鋭くそれを表現してきました。
"Devs spent decades building CI/CD, monitoring, rollbacks, and circuit breakers because deploying software and hoping it works was never acceptable. Then they built AI agents and somehow went back to hoping."

これが、この検索の裏にあるむずがゆさです。最新のスタックの他のすべては、バージョン管理し、レビューし、デプロイし、ロールバックできるコードです。それなのにAIエージェントは、誰かがブラウザで動作を切り替える設定画面として現れ、監査証跡もなく、実際の顧客が触れる前に変更をテストする方法もありません。ここでのターミナルは、ある規律全体の略記です。それが本番システムであるなら、本番システムとして操作できるべきです。
つまり本当の問いは「CLIはあるか」ではありません。「このエージェントを、インフラの他の部分と同じように扱えるか」なのです。これがすべてを再構成し、この記事の残りで持ち続ける価値のある枠組みです。
発想の転換: エージェントはセットアップするボットではなく、運用するサービスである
AIサポートエージェントに関するコンテンツのほとんどは、セットアップで止まっています。ヘルプセンターを接続し、トーンを選び、オンにする。しかしセットアップは1日目にすぎません。本当に重要な仕事は2日目とそれ以降の毎日です。設定がドリフトし、ナレッジ記事が古くなり、新製品がローンチされ、エージェントがそれについて自信満々に間違った回答をし始めます。エージェントを管理することはループであり、ローンチではありません。
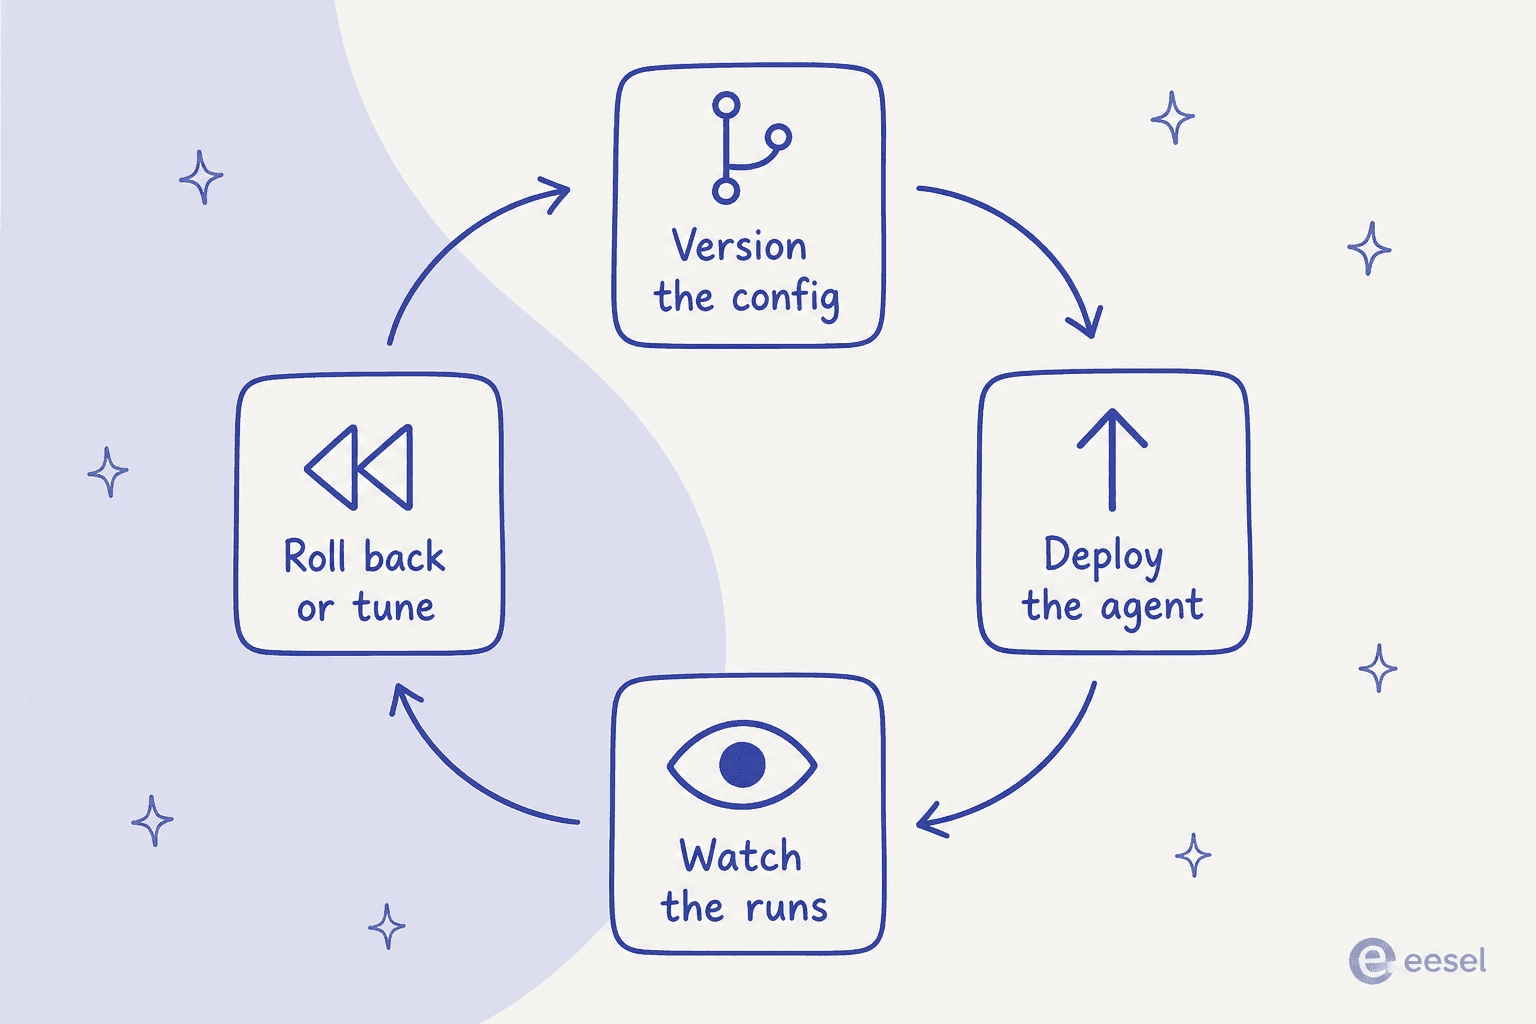
そのループこそ、「ops-as-code」が居場所を与えてくれるものです。設定をバージョン管理して、変更を誰かがレビューできるdiffにする。パイプラインを通してデプロイして、ロールアウトを再現可能にする。実行を監視して、エージェントが実際に何をしたかを把握する。何かがおかしいときはロールバックまたは調整する。どれもエキゾチックなものではありません。どのサービスを運用するときもそうするはずです。AIエージェントについてそれが新しく感じられる唯一の理由は、あまりに多くのツールがまずダッシュボードとして作られ、プログラム可能なインターフェースを一度も育てなかったからです。agents-as-codeフレームワークを構築しているあるチームは、その目標を率直に述べています。
"Orloj treats agents the way infrastructure-as-code treats cloud resources. You write a manifest that declares an agent's model, tools, permissions, and execution limits."

この枠組みを持てば、ターミナルはゴールであることをやめ、ゴールへのインターフェースになります。エージェントの振る舞いを、先週の火曜日に変更したことを覚えておかなければならないものではなく、diffできるものにしたいはずです。
今日実際にスクリプト化できること
ここからが実践的な部分です。あなたのツールがAPIまたはCLIを提供していれば、驚くほど多くのエージェント管理がすでにシェルから機能します。ベンダーが誰であっても普遍的なパターンは、どのサービスにも使うのと同じものです。設定ファイルが真実の源であり、APIがデプロイ先であり、バージョン管理が監査ログです。生の形では、それはただのcurlとjqです。例えば直近1日分の実行を取得してエスカレーション数を数える場合。
curl -s https://api.yourtool.com/v1/agent/runs \
  -H "Authorization: Bearer $AGENT_TOKEN" \
  --data-urlencode "since=$(date -u -v-1d +%FT%TZ)" \
| jq '[.runs[] | select(.outcome == "escalated")] | length'
一部のツールは生のRESTのステップを飛ばして、一級のCLIを提供します。eeselもその一つです。そのコマンドラインツールは本物のnpmバイナリ(@eesel/cli)であり、ドキュメントはターミナルが裏口ではなく想定されたインターフェースであると率直に述べています。サイト上のすべてが「ターミナルから実行できる」のです。典型的なセッションは次のようになります。
eesel login                 # browser once, or set EESEL_API_TOKEN for CI
eesel status                # what's connected, is knowledge current, plan
eesel activity              # every run, newest first (JSON by default)
eesel instructions          # read or edit the agent's standing rules
eesel approvals list        # actions held, waiting on a human
すべてのコマンドはJSONを出力し、エラーはstderrに構造化された1行として返り、EESEL_API_TOKEN(とEESEL_AGENT_ID)を設定すれば、ブラウザログインなしでCI上でヘッドレスに全体を動かせます。これをcronジョブやGitHub Actionにぶら下げれば、ダッシュボード不要の、スケジュール可能でレビュー可能、バージョン管理されたエージェント管理が手に入ります。
落とし穴は、その「もし」の大きさです。多くのサポートAIには、その名に値するAPIがまったくなく、スクリプト化できることの上限は完全にベンダーが決めます。これは購入前に確認すべき最も重要なことです。プログラム可能なインターフェースを持たないツールは、どれだけ望んでもターミナルから管理することは決してできません。コミットする前に、管理可能性のスペクトルをたどっておく価値があります。
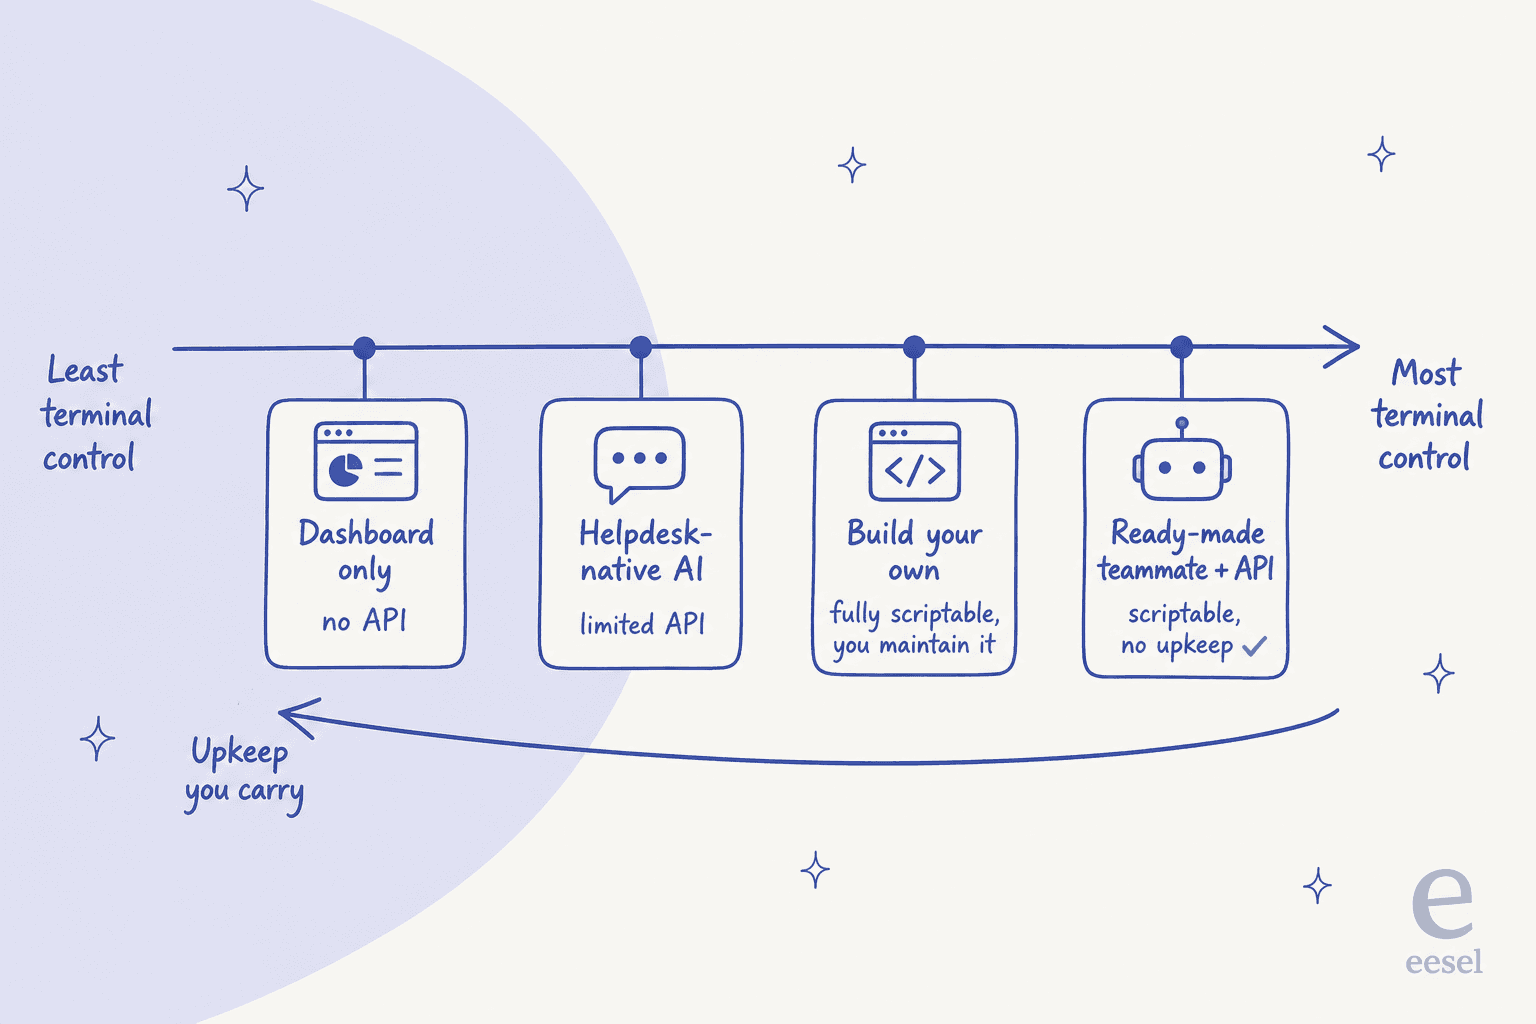
その線上には本当のトレードオフがあります。モデルAPIの上に自前のエージェントを構築すると、完全なコントロールと完全なメンテナンス負担を得られます。検索、ガードレール、評価ハーネス、そしてプロンプトのリグレッションが出荷されたときの深夜2時のポケベルすべてをあなたが所有することになります。適切なAPIを備えた既製のエージェントは、メンテナンスの尾を引かずにプログラム可能性の大部分を与えてくれます。どちらの端を選ぶかは、エージェントの管理があなたの仕事なのか、それとも本来の仕事にかかる税金なのかによります。(自作側を検討しているなら、カスタマーサポートエージェントAPIとAIヘルプデスクAPIの解説で詳しく掘り下げています。)
ターミナルが渡してくれない半分: エージェントが何をしたかを見ること
ここに落とし穴があります。コマンドラインからのデプロイは簡単な半分であり、それがあなたに、自分がコントロールしていると思い込ませます。スクリプトが実行され、APIが200を返し、ターミナルがexit 0を出力し、あなたは次に進みます。しかしクリーンな終了コードは、変更が送信されたことを教えてくれるだけです。エージェントが正しいことをしているかどうかについては何も教えてくれません。
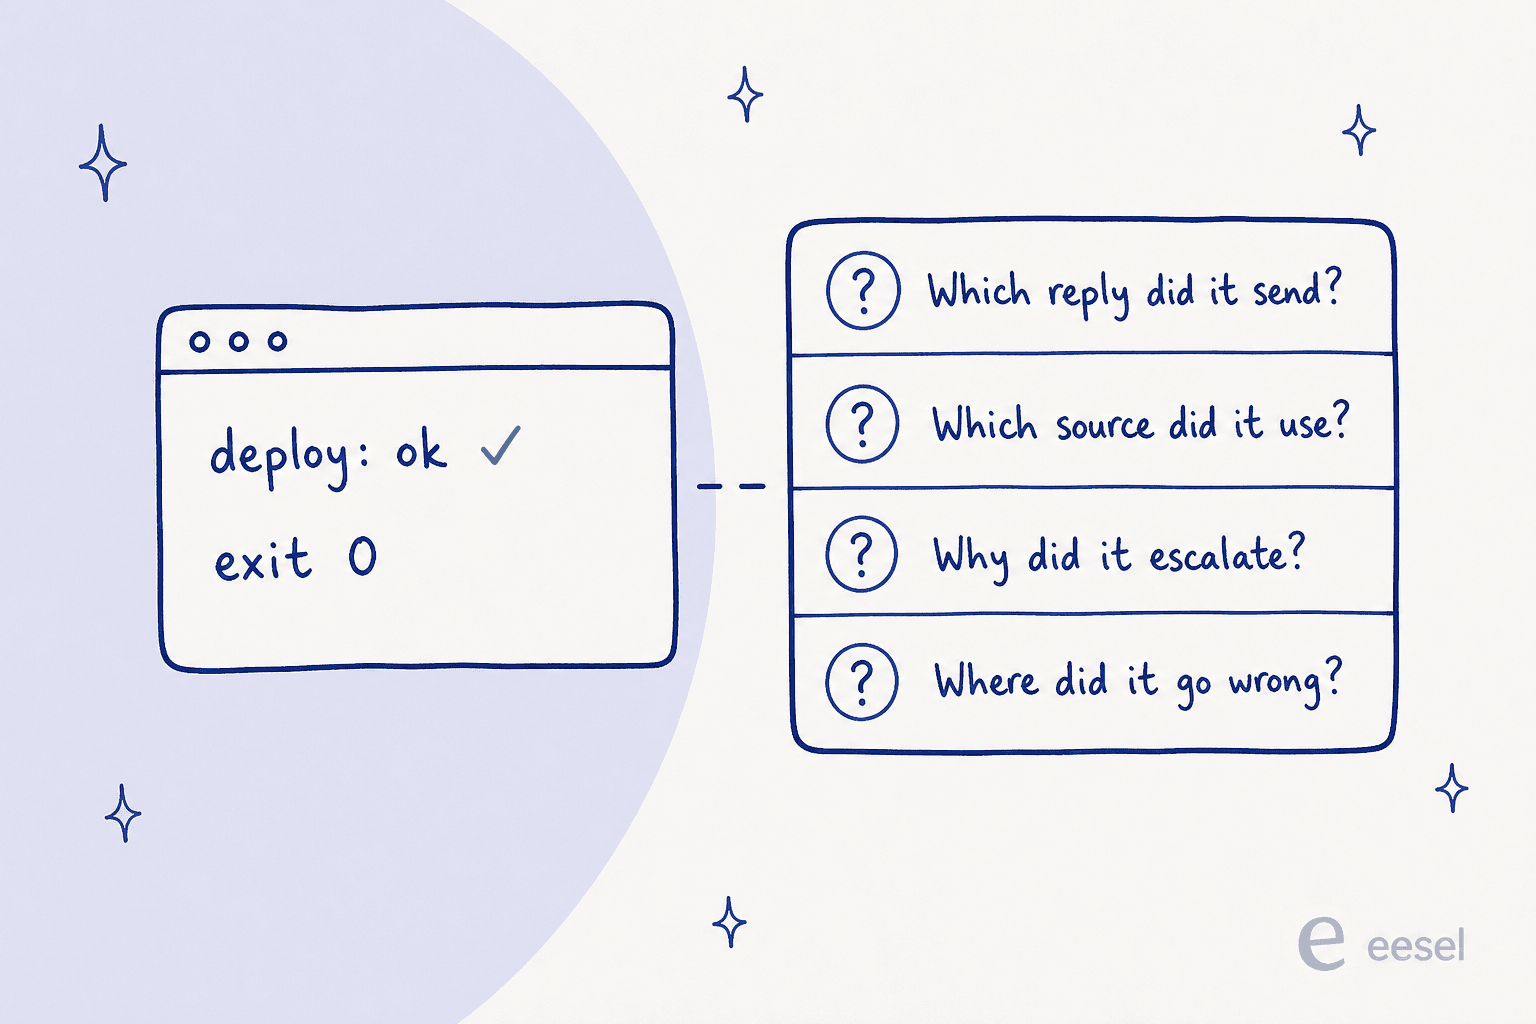
これは、多くのDIYエージェントプロジェクトが静かに崩壊するところです。デプロイは一晩で自動化できますが、どの回答がどの顧客に届いたか、エージェントがどのナレッジソースに依拠したか、なぜあるチケットをエスカレーションし別のチケットには回答したのかを知る必要性は自動化で消し去ることはできません。ある技術者による本番障害6か月間の記録は、失敗パターンを的確に言い当てています。
"Agent works in testing. Works in the demo. Ships to production. Two weeks later - same input, different output. No error. No log that helps. Just a wrong answer delivered confidently."
それが観測可能性であり、構築するのは高くつく部分で、省略するのは簡単な部分です。だからこそ開発者フォーラムの空気は、「どのモデルか」から「何をしたか見えるか」へと静かに移ってきたのです。
"honestly I'm starting to think observability is becoming more important than the model itself"
私たちが何度も学び直している教訓は、ターミナルはそれが操縦しているツールの背後にある実行履歴と同じくらいしか役に立たないということです。エージェントがデプロイはできても仕事ぶりを見せられないなら、あなたは決して問題ではなかった部分を自動化したことになります。ツールを評価するときは、書き込み側と同じくらい強く読み取り側を突いてください。実行の完全なトランスクリプトを取得できますか。回答の背後にある確信度とソースを見られますか。何かがドリフトしたときにアラートを受け取れますか。これを美しく表示しながらもそれをスクリプトに一切公開しないダッシュボードは、あなたの自動化にとって依然としてブラックボックスです。
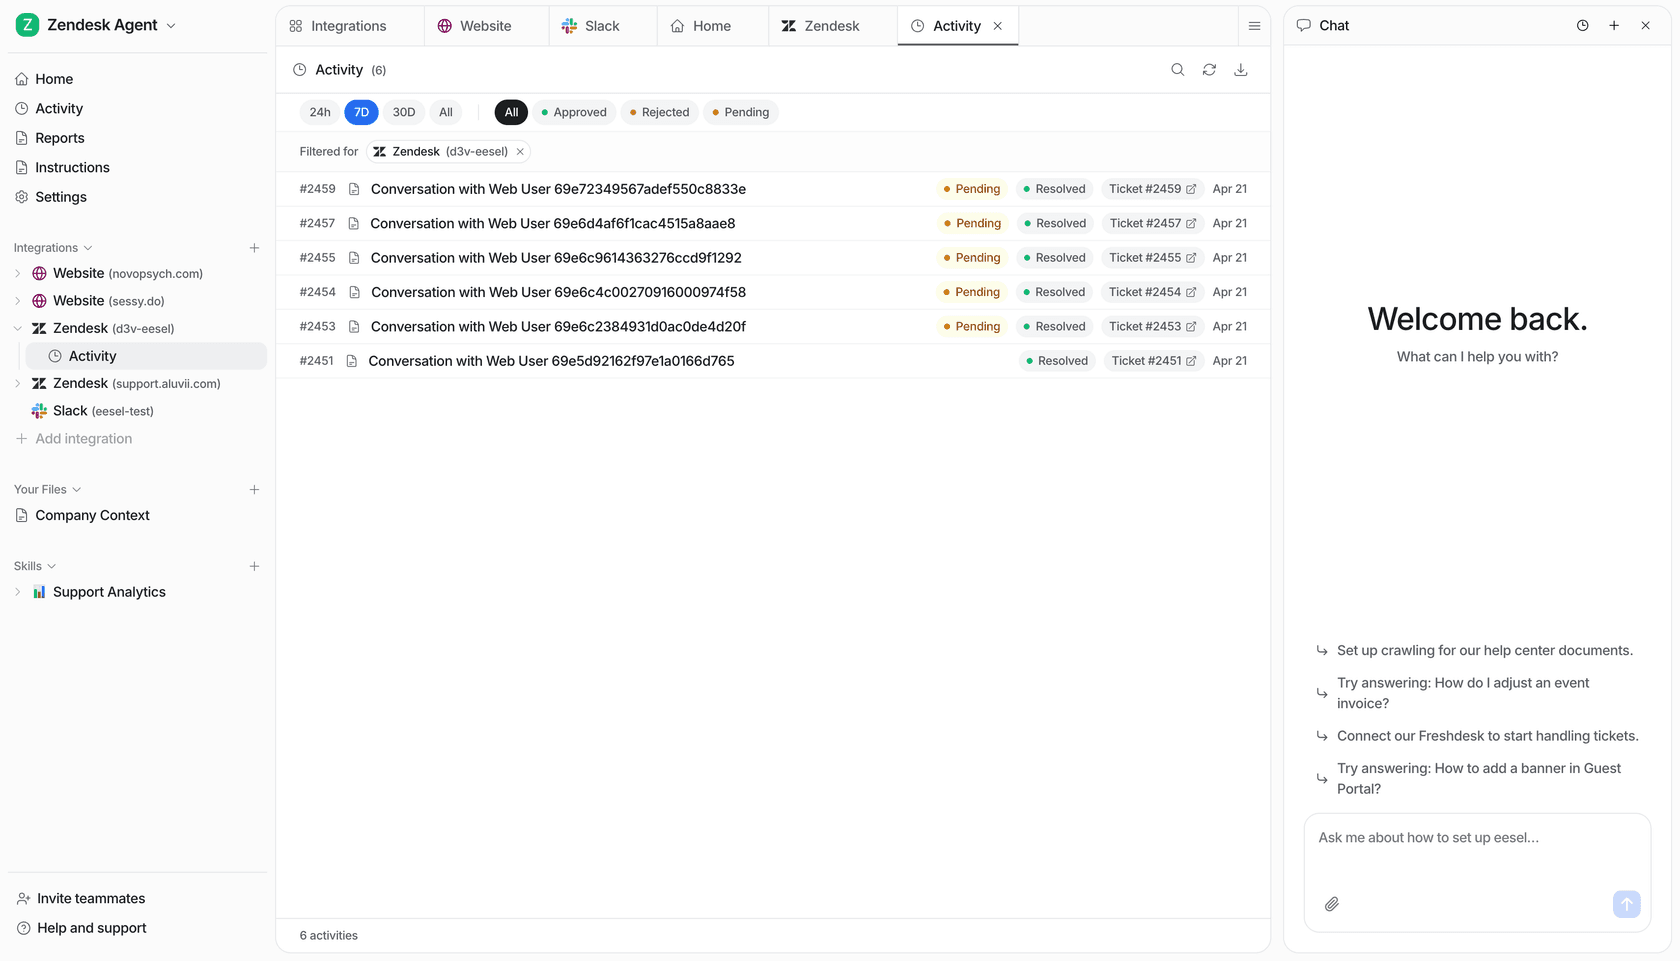
これが自分たちの側で最も誇りに思っている部分です。eesel activityはすべての実行を新しい順に一覧表示し、1件を完全な詳細で読むことができ、それはダッシュボードが表示するのと同じJSONなので、回答が見えないどこかで単に起きたことになることは決してありません。eesel approvalsと組み合わせれば、人間はシェルを一度も離れることなく、キューに入ったアクションを保留、承認、または拒否できます。
デプロイ前にテストする: エージェントのためのステージング環境
サービス運用の習慣を一つだけエージェントに適用するなら、これにしてください。設定変更を絶対に顧客に直接出荷しないこと。通常のソフトウェアにはステージング環境があります。AIエージェントの場合、それに相当するのは、実際の顧客が1人でも見る前に、自分たちの過去のチケットを新しい設定に対して再生し、何が起きたかを確認することです。このサイクルを経験したある開発者は、その解決策をスナップショットテストと表現しました。
"What finally fixed the cycle for me was treating agent behavior like snapshot tests. Record the trajectory when it's working, save it as baseline, diff after every change. If the tool path shifted or output drifted - block the deploy before it hits prod."
これが重要な理由は理論的なものではありません。Sierraのリサーチチームによるツールエージェントのベンチマークであるτ-benchでは、最良のエージェントでも現実的なサポートタスクで50%未満のスコアしか出せず、pass^1スコアを達成したGPT-4oエージェントが、同じタスクを8回繰り返し実行しただけでpass^8では約25%まで落ち込み、約60%の信頼性崩壊が起きました。見出しの精度は怖い数字ではありません。実行ごとの一貫性のなさこそが怖い数字であり、それを顧客より先に捉える唯一の方法は、まず新しい設定を現実に対して実行してみることです。
私たちは、実際のライブサポートキューにAIを3年以上導入してきた中で、同じことを苦労して学びました。自信ありげに聞こえるボットが静かに間違った回答を配り続けるのを目にしてきました。だからこそ、あらゆるロールアウトはまず過去のチケットに対してシミュレーションされます。そのシミュレーションはあなたのリグレッションスイートです。コマンドレベルでは、--dry-runフラグが同じ発想の小さなバージョンを実現します。それは書き込みが行う正確な呼び出しを、送信せずに出力し、変更が何をするかを、実際に行う前に確認できるようにします。
これはまた、スクリプト化の正直な限界でもあります。再生を自動化できます。結果に応じてデプロイをゲートできます。しかしスクリプト化できないのは、あるチケットカテゴリでの4ポイントの低下が、別の場所での10ポイントの向上に対して許容できるかどうかという判断です。ターミナルはテストを安価で反復可能にしますが、結果を読むのは依然として人間です。社内でよく言われる言い方を借りれば、チケットはスクリプト化できても、回答はスクリプト化できません。
運用にかかる費用と、請求書が隠れている場所
エージェントの運用にはメーターがあり、そのメーターこそ「ターミナルから管理する」が静かに予算の問題に変わる場所です。単位が数字より重要なのは、単位が同じではないからです。あるツールは解決件数ごとに課金し、あるツールは会話ごと、あるツールはAPIトークンごとに課金します。実行を問い合わせるために1日に何千ものAPI呼び出しを発火するスクリプトは、呼び出しごとに課金されている場合、驚くべき請求額を生み出しかねません。
サポートエージェントのコスト表の正直なバージョンは次のようになります。
| アプローチ | 何をスクリプト化するか | 誰がメンテナンスするか | おおよそのコストモデル |
|---|---|---|---|
| ダッシュボードのみのツール | 何もない、APIなし | ベンダー | 解決件数ごと、またはシートごと |
| ヘルプデスクネイティブAI | ヘルプデスクAPI経由の限定的な設定 | ベンダー | 解決件数ごと(多くの場合1.50〜2.00ドル) |
| モデルAPIの上に自前構築 | すべて | あなた | すべてのメッセージと再試行ごとのトークン単位 |
| CLIを備えた既製エージェント(eesel) | 設定、実行、アクション | ベンダー | 1チケットあたり0.40ドル |
興味深いのは両端です。自前構築は、チケットが解決してもしなくても課金されるトークン単位の請求に加え、検索とガードレールを維持する人の給与コストがかかります。eeselのようなチケット単位のモデルは、何メッセージかかろうと処理した会話ごとに定額で、シート課金やプラットフォーム料金もなく、実際にスクリプトや予算に組み込めるほど支出を予測可能にします。月間1,000チケットならおよそ400ドルであり、支払うのはエージェントにルーティングしたチケットの分だけで、人間がまだ対応しているチケットの分は払いません。
実際に運用できるサポートエージェントとしてeeselを試す
これを検索した理由のすべてが、ダッシュボードの子守をする代わりにサポートエージェントをサービスとして運用したいということなら、それこそeeselが埋めるために作られたギャップです。eeselは既存のヘルプデスク(Zendesk、Freshdesk、Front、Gorgias、Help Scout、そしてその他)に参加するAIチームメイトで、過去のチケットとドキュメントで学習し、本物のプログラム可能なインターフェースを提供します。CLI、ワークスペースごとのMCPサーバー、Webhook、そしてエージェントが自分のシステムを呼び出せるアウトバウンドのネットワークアクセスです。
これをインストールして、完全にシェルから操作できます。
npx @eesel/cli init chat-bubble --site https://your-site.com
eesel chat "what's our refund policy?"   # test an answer before go-live
eesel activity                            # watch what it actually did
この記事で紹介した2つの最も重要な習慣は組み込み済みです。公開前に過去のチケットに対してシミュレーションし、すべての回答が単独で送信する権利を得るまでドラフトのままにしながら段階的にロールアウトします。そして1チケットあたり0.40ドルでシート料金がないため、いくつかのチケット種別から始めて、営業電話ではなくスクリプトから拡大できます。
クレジットカードなしで無料で始め、数分でヘルプデスクに組み込み、何かにコミットする前に実際のチケットをどう扱うか確認できます。それがポイントです。盲目的に信頼しなければならないエージェントではなく、テストし、観察し、運用できるエージェントです。
よくある質問
AIエージェントを本当にターミナルから管理できますか?
AIサポートエージェントにとって「ops-as-code」とは何を意味しますか?
コマンドラインからAIエージェントへの変更をどうデプロイしますか?
AIサポートエージェントを運用するにはどれくらいの費用がかかりますか?
本番環境でAIエージェントが誤った回答をした場合はどうなりますか?


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.