

L'AI co-scientist de Google est un système d'IA multi-agents basé sur Gemini qui joue le rôle de collaborateur de recherche virtuel. Vous lui donnez un objectif de recherche en langage naturel, et une équipe d'agents spécialisés génère, critique et classe des hypothèses inédites, puis vous renvoie une courte liste avec des citations. Passé d'une démo en 2025 à un article de Nature évalué par les pairs en mai 2026, il est désormais l'outil « Hypothesis Generation » de Gemini for Science.
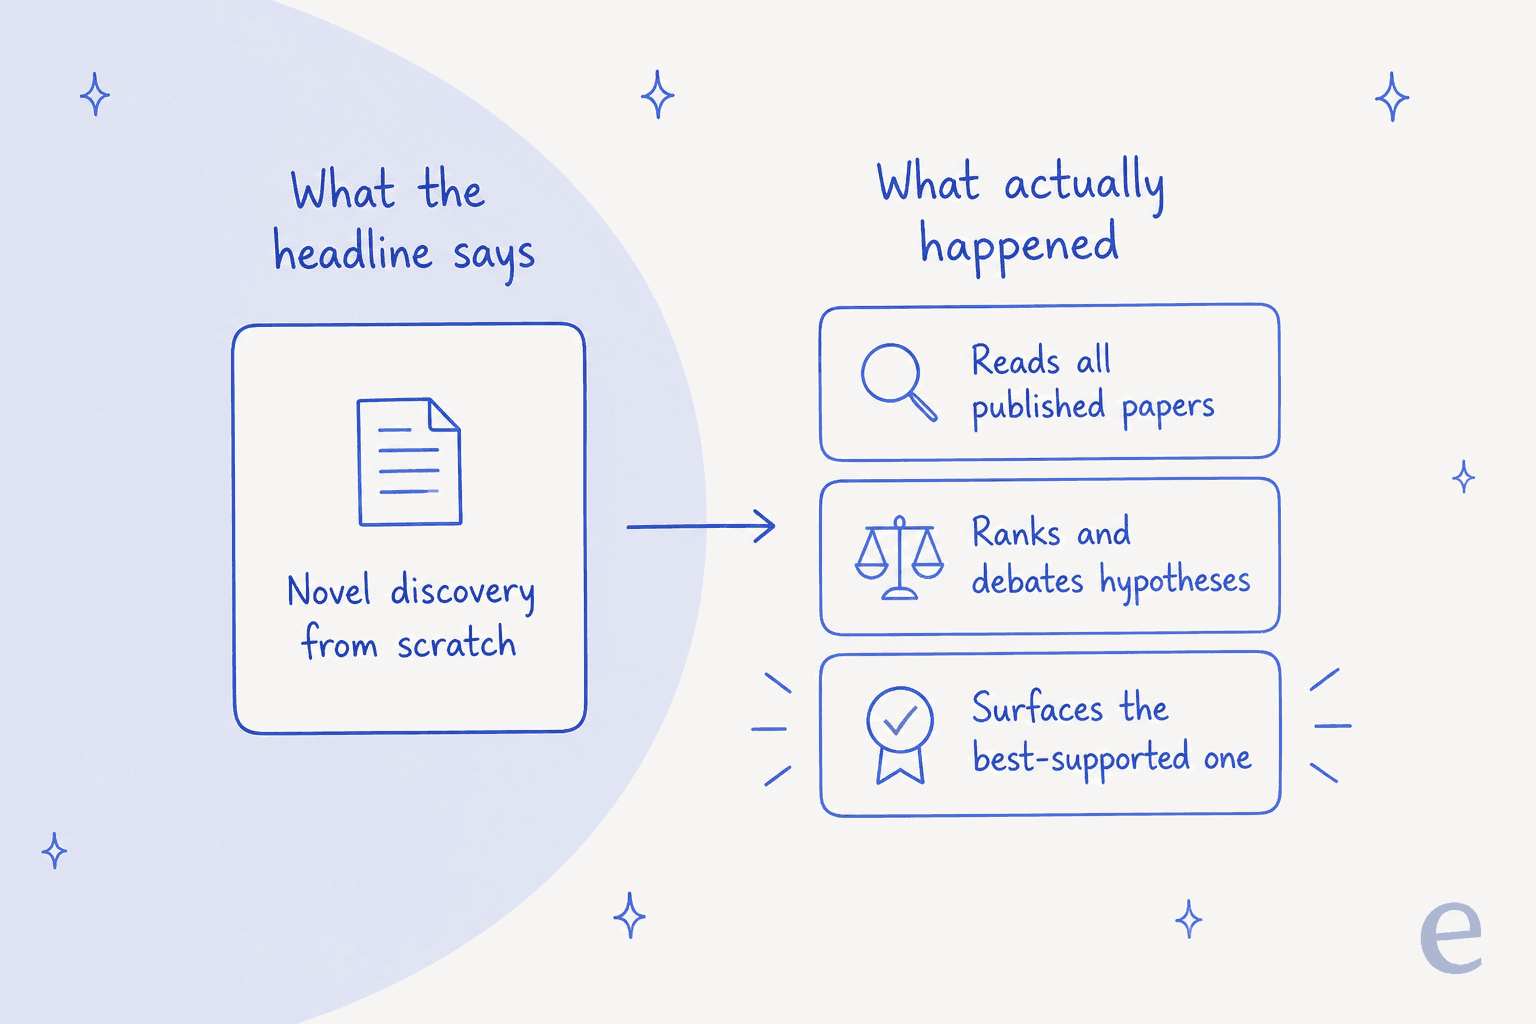
Le moment phare a été l'histoire de la « superbactérie » : il a reproduit en environ deux jours une hypothèse qu'une équipe de l'Imperial College avait mis une décennie à atteindre. La lecture honnête, à laquelle même les sceptiques aboutissent, est qu'il a lu tous les articles pertinents et synthétisé la réponse plus vite que n'importe quel humain, et non qu'il a inventé l'idée à partir de rien. C'est tout de même très utile, mais c'est une autre affirmation.
L'accès est restreint : les chercheurs individuels s'inscrivent sur labs.google/science, et la R&D en entreprise bénéficie d'une préversion privée via Google Cloud. Il n'y a pas encore de tarif public. Si vous ne dirigez pas un laboratoire de paillasse, ce qui compte, c'est la forme du dispositif : un coéquipier IA spécialisé embauché pour une tâche bien définie. C'est exactement le modèle qu'eesel applique au support et au contenu, des tâches que vous pouvez activer dès aujourd'hui.
Ce qu'est réellement l'AI co-scientist de Google
Commençons par ce qu'il n'est pas. Ce n'est pas un chatbot, ni un outil de recherche bibliographique qui vous remet un résumé bien rangé. Google est précis sur ce point : le co-scientist est conçu pour découvrir de nouvelles connaissances et formuler des « hypothèses et propositions de recherche manifestement inédites », pas pour reformuler ce que l'on sait déjà.
Sous le capot, c'est une coalition d'agents qui tournent sur Gemini. Vous lui donnez un objectif en langage naturel, par exemple « propose des candidats de repositionnement de médicaments pour la leucémie myéloïde aiguë », et le système lance des agents spécialisés qui jouent chacun un rôle de la méthode scientifique : l'un propose des idées, l'un les critique comme un relecteur, l'un les classe, l'un affine les survivantes. Le résultat est un ensemble classé d'hypothèses et une synthèse de recherche que vous pourriez réellement emporter au laboratoire.
Le projet a un vrai pedigree. Il a été présenté pour la première fois par Google Research en février 2025, sous la direction de Juraj Gottweis et Vivek Natarajan, puis publié dans Nature en mai 2026 après avoir été testé avec plus de 100 institutions. C'est ce parcours qu'il faut retenir : démo, puis un an de validation en laboratoire, puis un article évalué par les pairs, un niveau d'exigence bien supérieur au billet de blog habituel « nous avons construit un agent sympa ».
Comment fonctionne le système multi-agents
Le plus simple est de l'imaginer comme un rythme en trois temps : générer des idées, les débattre, les faire évoluer, en boucle.
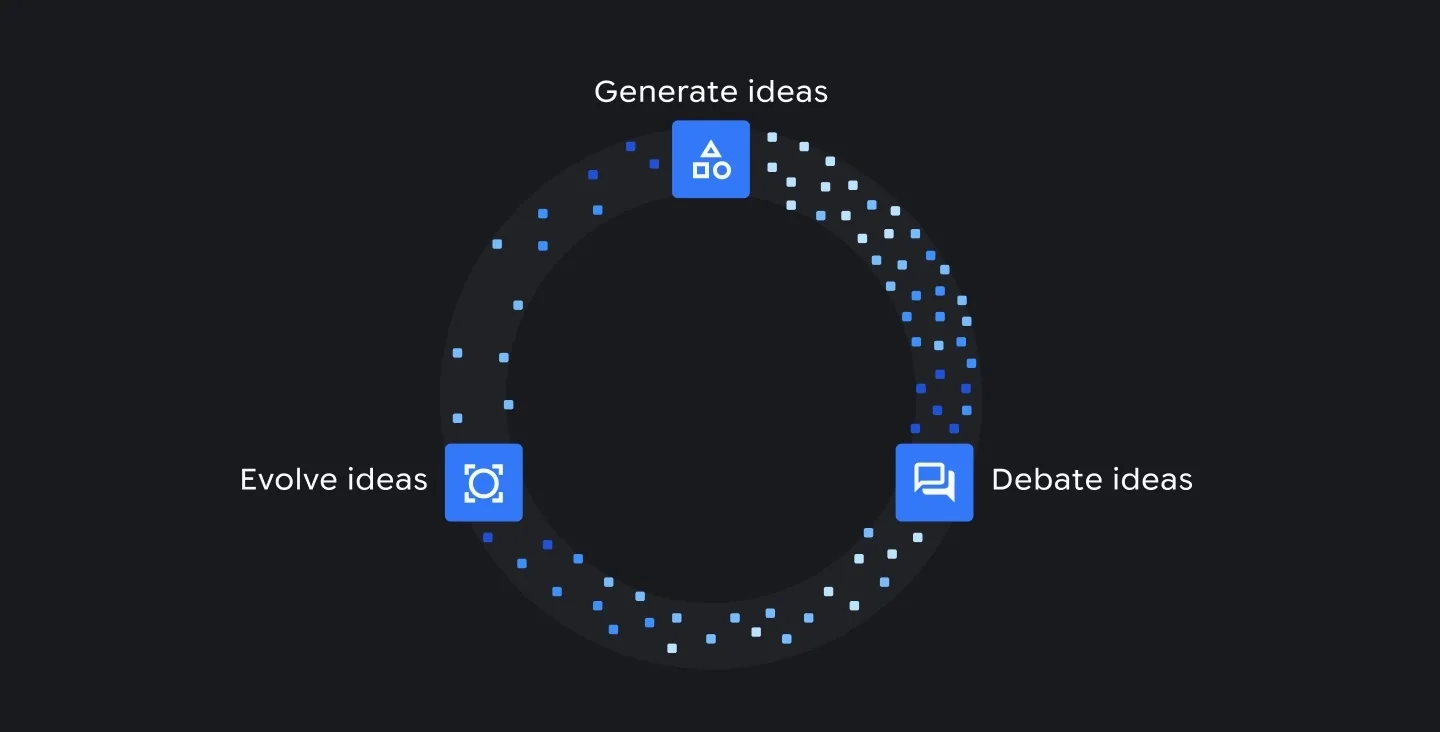
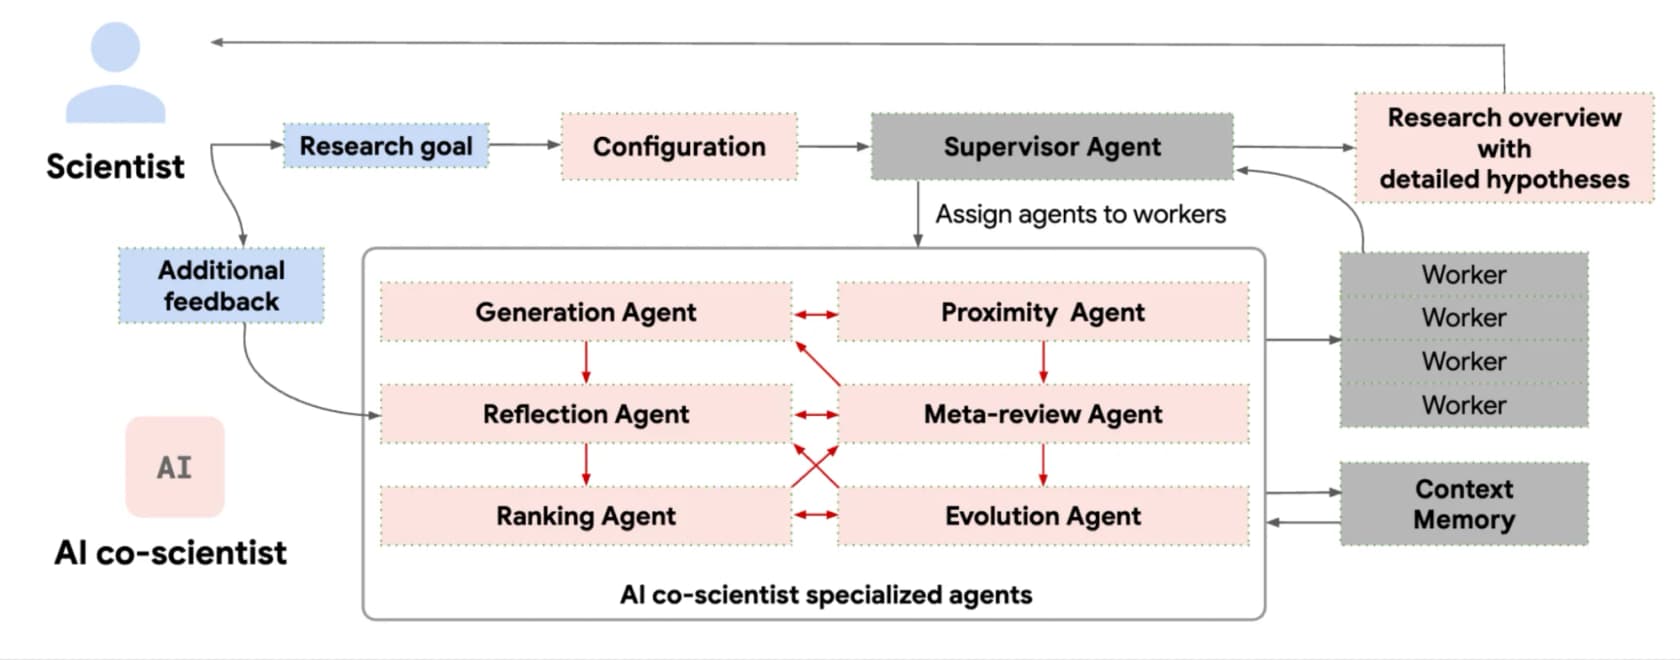
Six agents spécialisés se partagent ce travail, et un septième les chapeaute. L'article de DeepMind sur Nature les nomme clairement :
- Generation propose des axes de travail et des hypothèses initiales, ancrées dans la littérature.
- Proximity regroupe et déduplique les idées pour que le système explore largement au lieu de tourner autour d'une seule réponse.
- Reflection joue le rôle de relecteur virtuel, en vérifiant l'exactitude et la nouveauté de chaque hypothèse.
- Ranking organise un « tournoi d'idées », en comparant les hypothèses deux à deux.
- Evolution affine et recombine les idées les mieux classées.
- Meta-review synthétise le tout dans la feuille de route de recherche finale.
Au-dessus de tous, un agent Superviseur transforme votre objectif en plan et affecte les agents spécialisés à une file de workers, ce qui permet au système d'augmenter ou de réduire la puissance de calcul. C'est la pièce qui en fait un véritable système multi-agents plutôt qu'un seul modèle déguisé : les agents tournent en parallèle et s'alimentent mutuellement, explorant plusieurs pistes à la fois.
Si vous avez lu des articles sur l'architecture d'Agentforce deep research, sur des plateformes d'agents d'entreprise comme OpenAI Frontier ou sur des outils de recherche comme Hebbia, ce schéma vous sera familier : découper une grande tâche floue en rôles, confier chacun à un spécialiste et les orchestrer. Le co-scientist pousse cette idée vers la tâche la plus difficile possible, les questions scientifiques ouvertes.
Le tournoi d'idées, et pourquoi l'essentiel du calcul sert à vérifier
La partie compétitive est le trait d'ingéniosité. L'agent Ranking organise un tournoi basé sur le classement Elo où les hypothèses s'affrontent dans des débats scientifiques simulés, en empruntant l'idée d'auto-apprentissage d'AlphaGo et d'AlphaStar. Les hypothèses les mieux notées montent, les plus faibles sont éliminées, et les survivantes évoluent encore.
Voici le détail que la plupart des articles passent sous silence : Google affirme que la majorité du calcul du système sert à vérifier les hypothèses, pas à les générer. Les affirmations sont recoupées avec la littérature et avec des bases de données comme ChEMBL et UniProt pour s'assurer qu'elles sont fondées et exactes. Cette priorité donnée à la vérification plutôt qu'au brainstorming est le choix de conception le plus important, et c'est la même leçon que dans l'IA en entreprise, où le plus difficile n'est jamais de produire une réponse mais de s'assurer qu'elle est juste avant de l'envoyer. Quiconque s'est débattu avec les AI hallucinations reconnaîtra ce réflexe.
Le tournoi reflète-t-il vraiment la qualité ? Google a testé si son score Elo interne correspondait à la précision réelle sur le jeu GPQA « diamond », un ensemble de questions scientifiques de niveau doctorat.
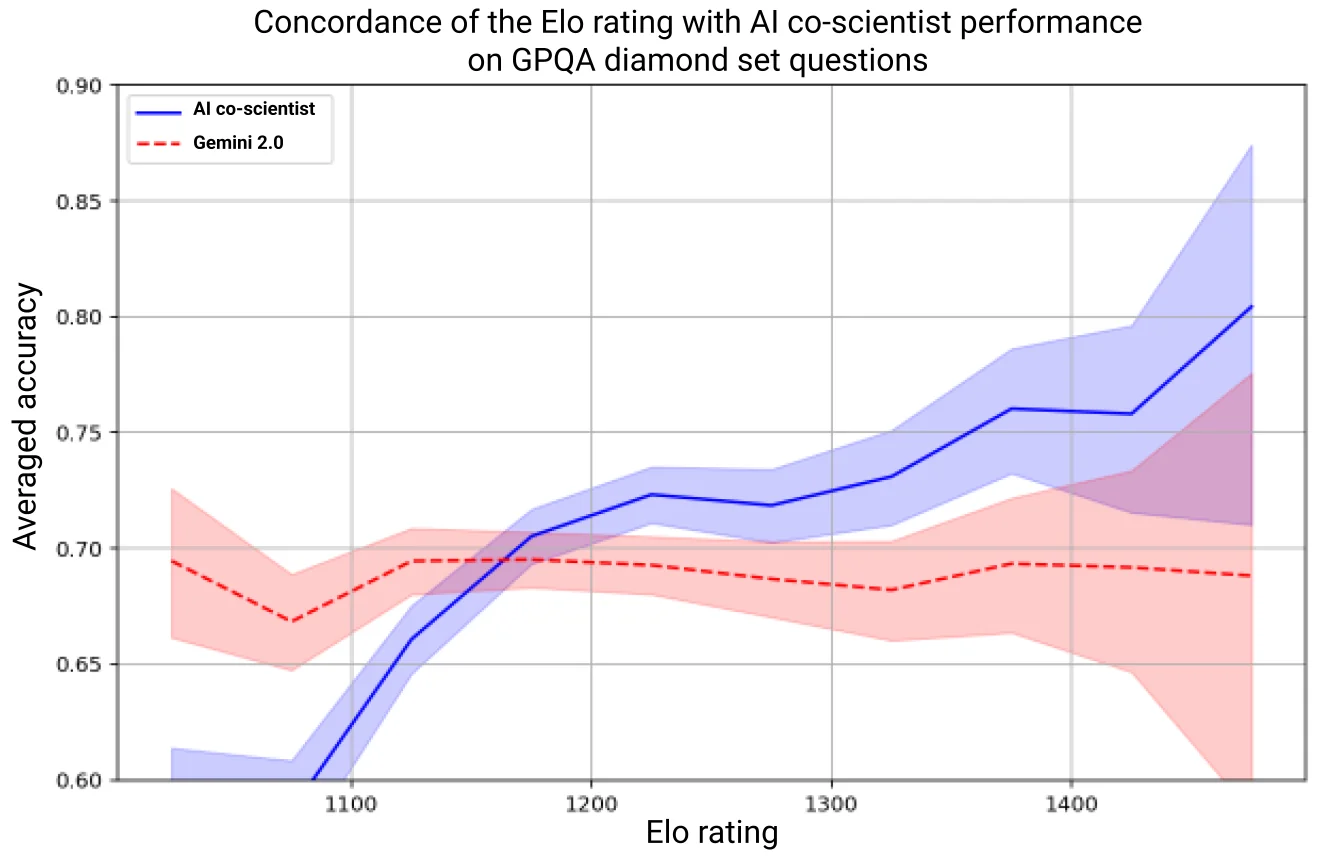
La ligne bleue monte : un Elo auto-évalué plus élevé était réellement corrélé à une plus grande probabilité d'avoir raison, et le co-scientist s'est nettement détaché de la base de référence Gemini 2.0 brute à mesure qu'il passait plus de temps à raisonner. Ce n'est pas une vérité de terrain indépendante, et Google le reconnaît, mais c'est un vrai signe que l'approche « réfléchir plus longtemps, débattre davantage » apporte quelque chose.
L'histoire de la superbactérie que tout le monde cite
Voici le moment qui l'a rendu célèbre. Google a confronté le co-scientist à une question de résistance aux antimicrobiens : comment les îlots chromosomiques inductibles par les phages formant des capsides (cf-PICIs) se propagent-ils à travers autant d'espèces bactériennes ? L'équipe du professeur José Penadés, à l'Imperial College London, avait passé environ dix ans à le comprendre et n'avait pas encore publié la réponse.
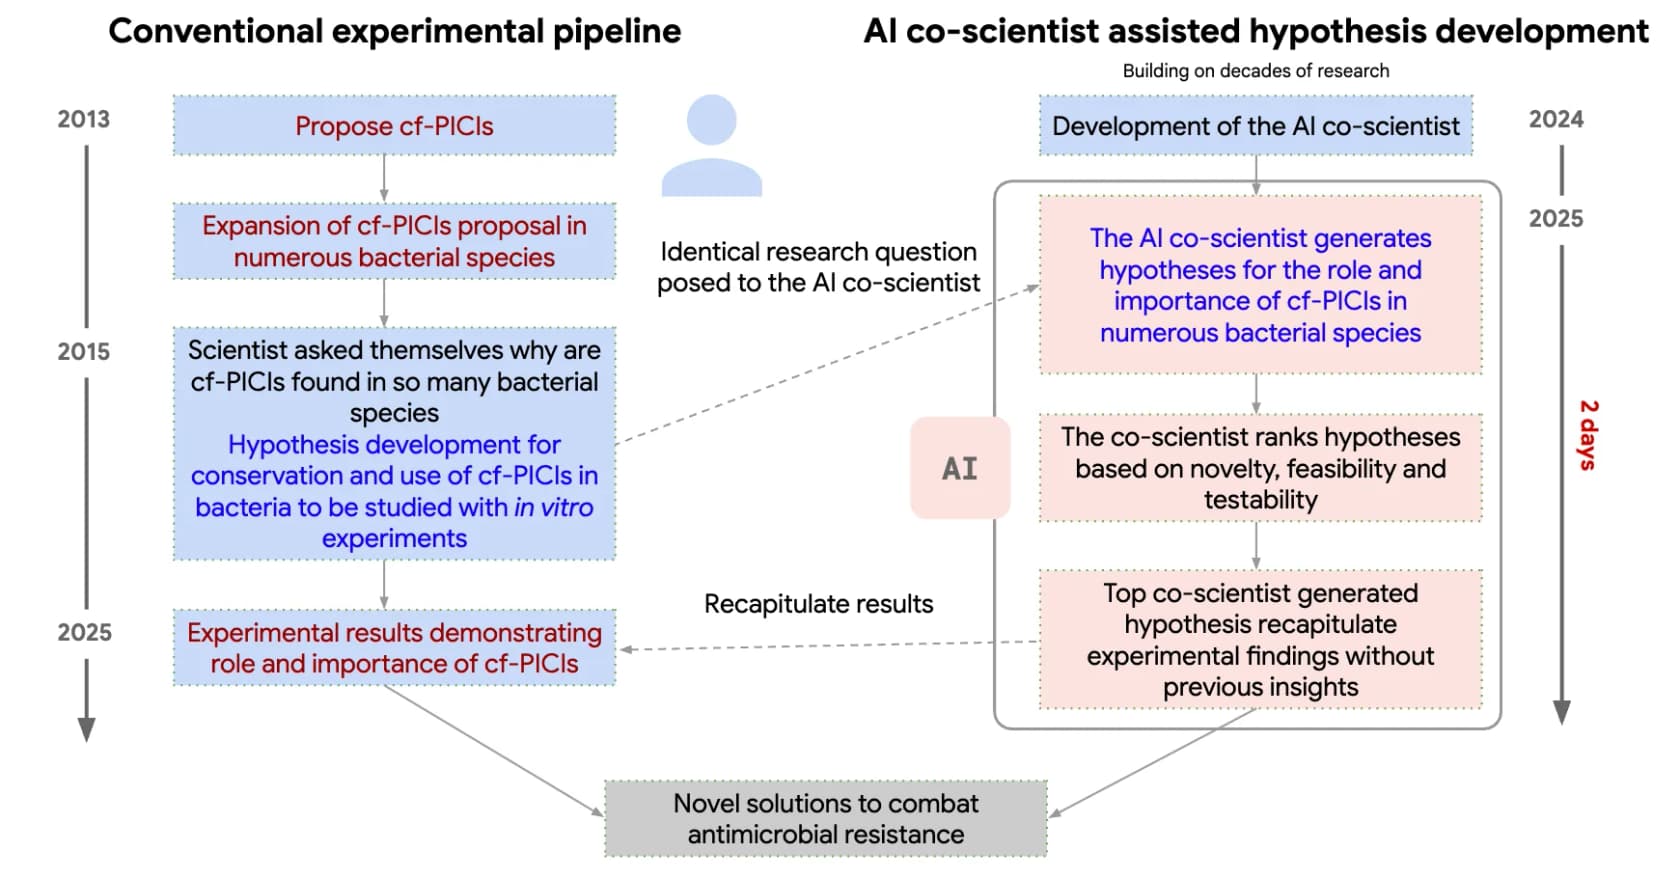
Face à la même question, le système est arrivé à l'hypothèse centrale de l'équipe en environ deux jours. Penadés a été, on le comprend, stupéfait, et ce n'était pas un simple coup de chance :
"It's not just that the top hypothesis they provide was the right one. It's that they provide another four, and all of them made sense. And for one of them, we never thought about it, and we're now working on that."

Ce passage sur « quatre hypothèses de plus, dont une à laquelle nous n'avions jamais pensé » est la partie enthousiasmante, et la découverte a ensuite été publiée dans Cell.
Mais l'histoire a été condensée en « l'IA résout un problème de superbactérie en deux jours », et ce cadrage a déclenché un vif débat. Le fil Hacker News le plus voté sur le sujet a défendu le point de vue inverse sans détour :
"The point isn't that it's bad, the point is that the AI did not discover the solution to the problem independently, as news headlines had implied."
L'objection technique est juste. Le co-scientist lit la littérature publiée, et des travaux voisins du même groupe étaient déjà parus, si bien qu'un scientifique ayant écrit les articles précédents pourrait, sans s'en rendre compte, formuler le prompt avec le même cadrage que celui qui a mené à la réponse. Comme l'a dit un commentateur, c'était plus proche de « a search engine for information from its training data » que d'une découverte partie de zéro.
Alors, percée ou battage ? L'avis le plus utile de ce même fil refusait les deux extrêmes :
"'Knowing all of the relevant literature' is a great first step for solving a problem! ... 'This paper from a lower-tier journal two years ago suggests you should look at X' is a very valuable thing to have!"
C'est le verdict honnête. Le co-scientist n'est pas un Einstein synthétique qui a des idées originales sous la douche. C'est le synthétiseur de littérature le plus rapide et le plus exhaustif jamais conçu, capable d'avoir tous les articles pertinents sous les yeux à la fois et de relier un résultat enfoui dans une revue obscure à votre question exacte. Vue ainsi, l'histoire des deux jours reste remarquable, mais ce n'est pas l'histoire que racontait le gros titre.
Ce pour quoi il est vraiment bon : trois résultats de laboratoire
Au-delà du cas de la superbactérie, Google a soumis le système à des expériences de laboratoire de bout en bout sur trois problèmes biomédicaux de difficulté croissante.
| Application | Repositionnement de médicaments | Découverte de nouvelles cibles | Expliquer un mécanisme |
|---|---|---|---|
| Exemple | Leucémie myéloïde aiguë | Fibrose hépatique | Résistance aux antimicrobiens |
| Défi | Recherche combinatoire | Identifier des cibles inédites | Comprendre des systèmes complexes |
| Difficulté | Moyenne | Élevée | Très élevée |
| Résultat | Les médicaments ont inhibé des cellules tumorales à des doses cliniques | Des candidats ont bloqué une réponse cicatricielle, p<0.01 | A retrouvé le mécanisme des cf-PICI |
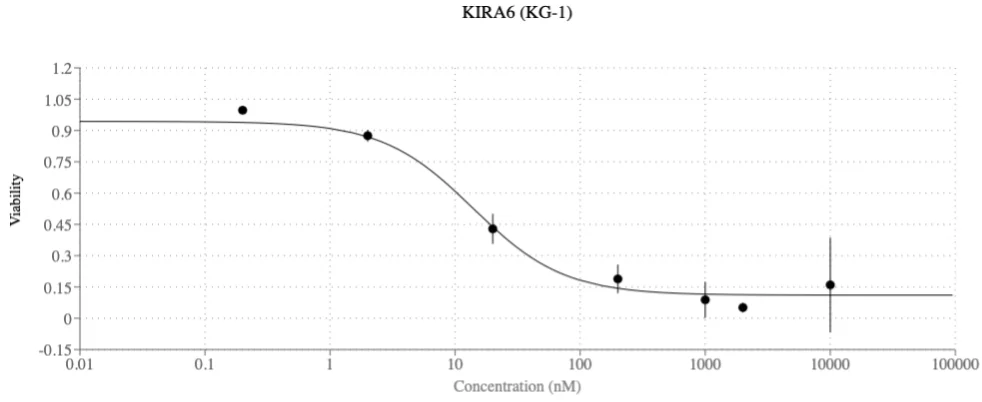
Le cas du repositionnement de médicaments est le plus concret. Le co-scientist a proposé des médicaments existants susceptibles d'agir contre la leucémie myéloïde aiguë, et des tests de suivi en laboratoire ont confirmé que les composés suggérés inhibent la viabilité tumorale à des concentrations cliniquement pertinentes sur plusieurs lignées cellulaires.
Le travail sur la fibrose hépatique, mené avec une équipe de Stanford et publié dans Advanced Science, est allé plus loin en territoire inédit, en faisant ressortir un candidat de repositionnement qui a bloqué 91 % d'une réponse liée à la cicatrisation en laboratoire. Les scientifiques qui l'ont utilisé décrivent sa valeur de manière constante, moins « il a fait mon travail » que « il a repéré ce que j'aurais manqué » :
"Co-Scientist feels like a collaborator that's read everything available about biomedical science, with the reasoning capabilities to find the connections that we're currently missing."
Remarquez la prudence du cadrage de la part de ceux qui en sont les plus proches. Il structure la réflexion, repère les lacunes et fixe des priorités, mais c'est toujours l'humain qui pose les questions et mène les expériences. C'est le même schéma avec un humain dans la boucle qui sépare un AI agent utile d'un agent trop sûr de lui.
Où l'utiliser dès aujourd'hui
Voici le test de réalité pratique : pour la plupart des gens, on ne peut pas simplement se connecter et l'utiliser.
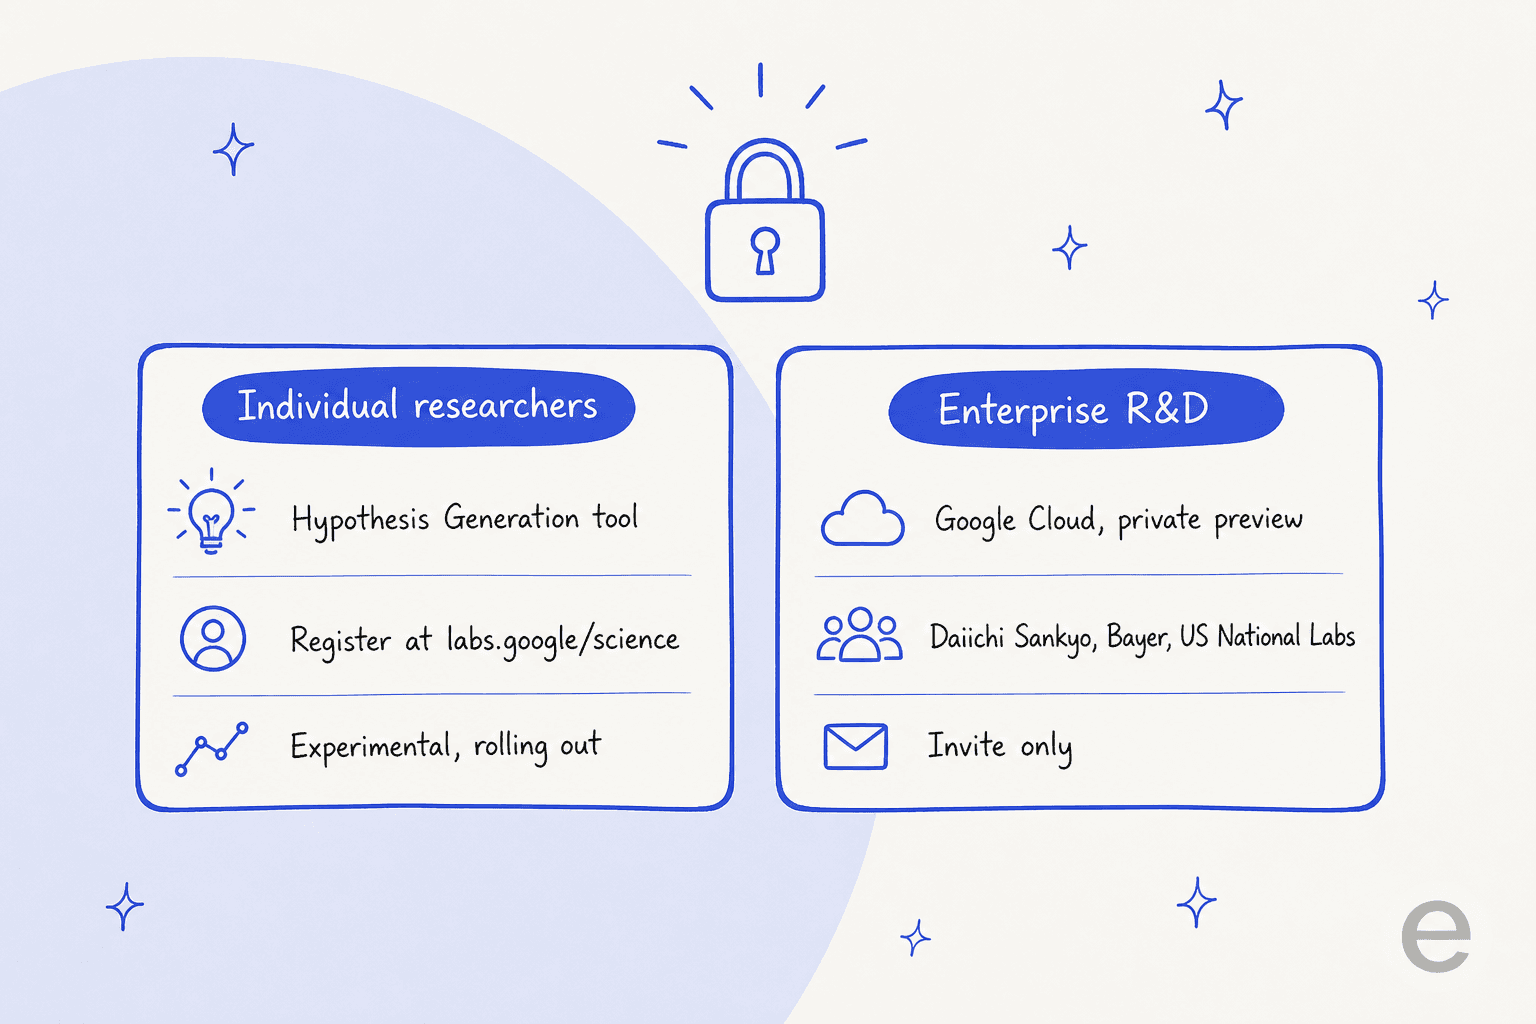
Il y a deux voies, et les deux sont restreintes. Les chercheurs individuels peuvent manifester leur intérêt sur labs.google/science pour l'outil expérimental Hypothesis Generation, que Google ouvre progressivement. Les équipes de R&D en entreprise obtiennent une version de niveau entreprise via Google Cloud, actuellement en préversion privée avec des partenaires dont Daiichi Sankyo, Bayer Crop Science et les laboratoires nationaux américains.
Deux réserves honnêtes. Google n'a publié aucun tarif à l'usage, aucun quota ni aucune limite d'utilisation pour le co-scientist, le coût reste donc une inconnue. Et l'outil est fortement biomédical : les résultats phares concernent tous le repositionnement de médicaments, la découverte de cibles et les mécanismes de maladies, donc si vous travaillez en science des matériaux ou en économie, l'adéquation est beaucoup moins démontrée. C'est tôt, c'est sur invitation, et cela vise pour l'instant clairement les sciences de la vie.
Ce que cela signifie si vous ne dirigez pas un laboratoire de recherche
La plupart des lecteurs ne pointeront jamais un agent vers une lignée de cellules cancéreuses. Pourquoi le co-scientist compte-t-il alors pour un responsable support ou un marketeur ? Parce qu'il est la preuve la plus claire, et aux enjeux les plus élevés, d'un schéma qui remodèle discrètement le travail ordinaire : un coéquipier IA spécialisé embauché pour une tâche clairement définie, qui arrive avec les compétences et le contexte pour l'accomplir.
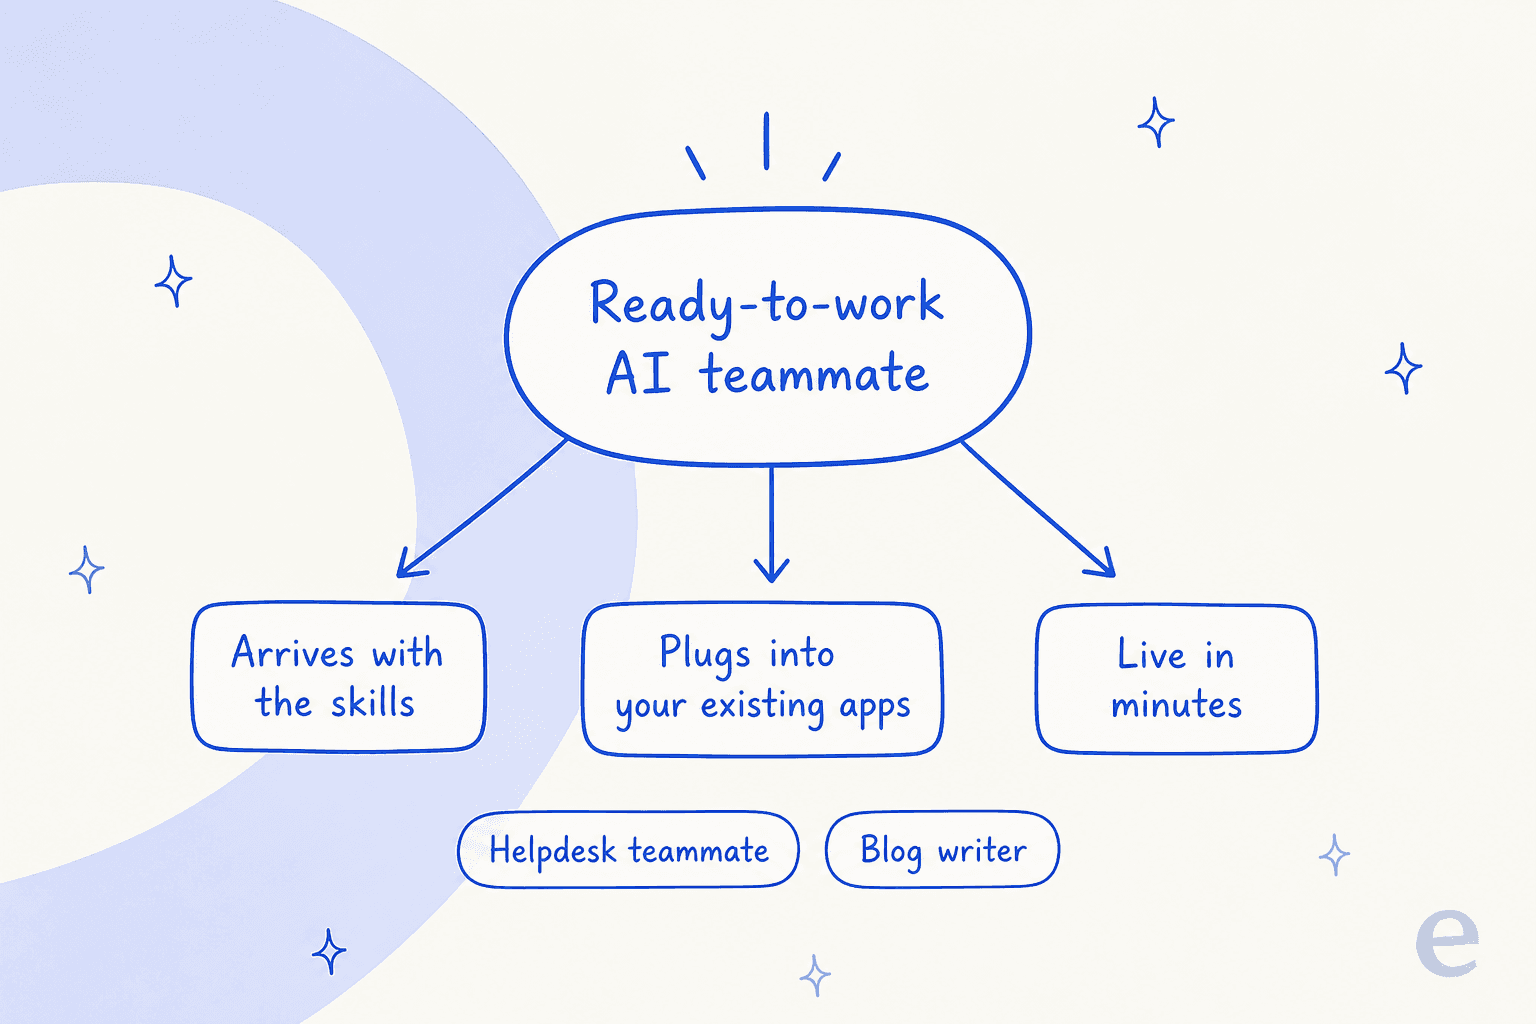
Sans la biologie, le co-scientist est un modèle : lui donner un objectif, laisser une coalition d'agents raisonner, consacrer l'essentiel de l'effort à vérifier avant de faire confiance au résultat, et laisser un humain maître de la décision finale. C'est exactement la recette d'un bon agent métier, qu'il réponde à un ticket ou rédige un article. La différence, c'est que la version de Google est une préversion de recherche, alors que la version métier peut être activée cet après-midi, souvent pour une fraction du coût d'un agent humain.
Essayer eesel
Google a conçu un co-scientist pour le laboratoire. eesel conçoit des coéquipiers IA prêts à travailler pour les tâches que votre équipe fait réellement, et vous pouvez en embaucher un en quelques minutes au lieu de vous inscrire sur une liste d'attente.
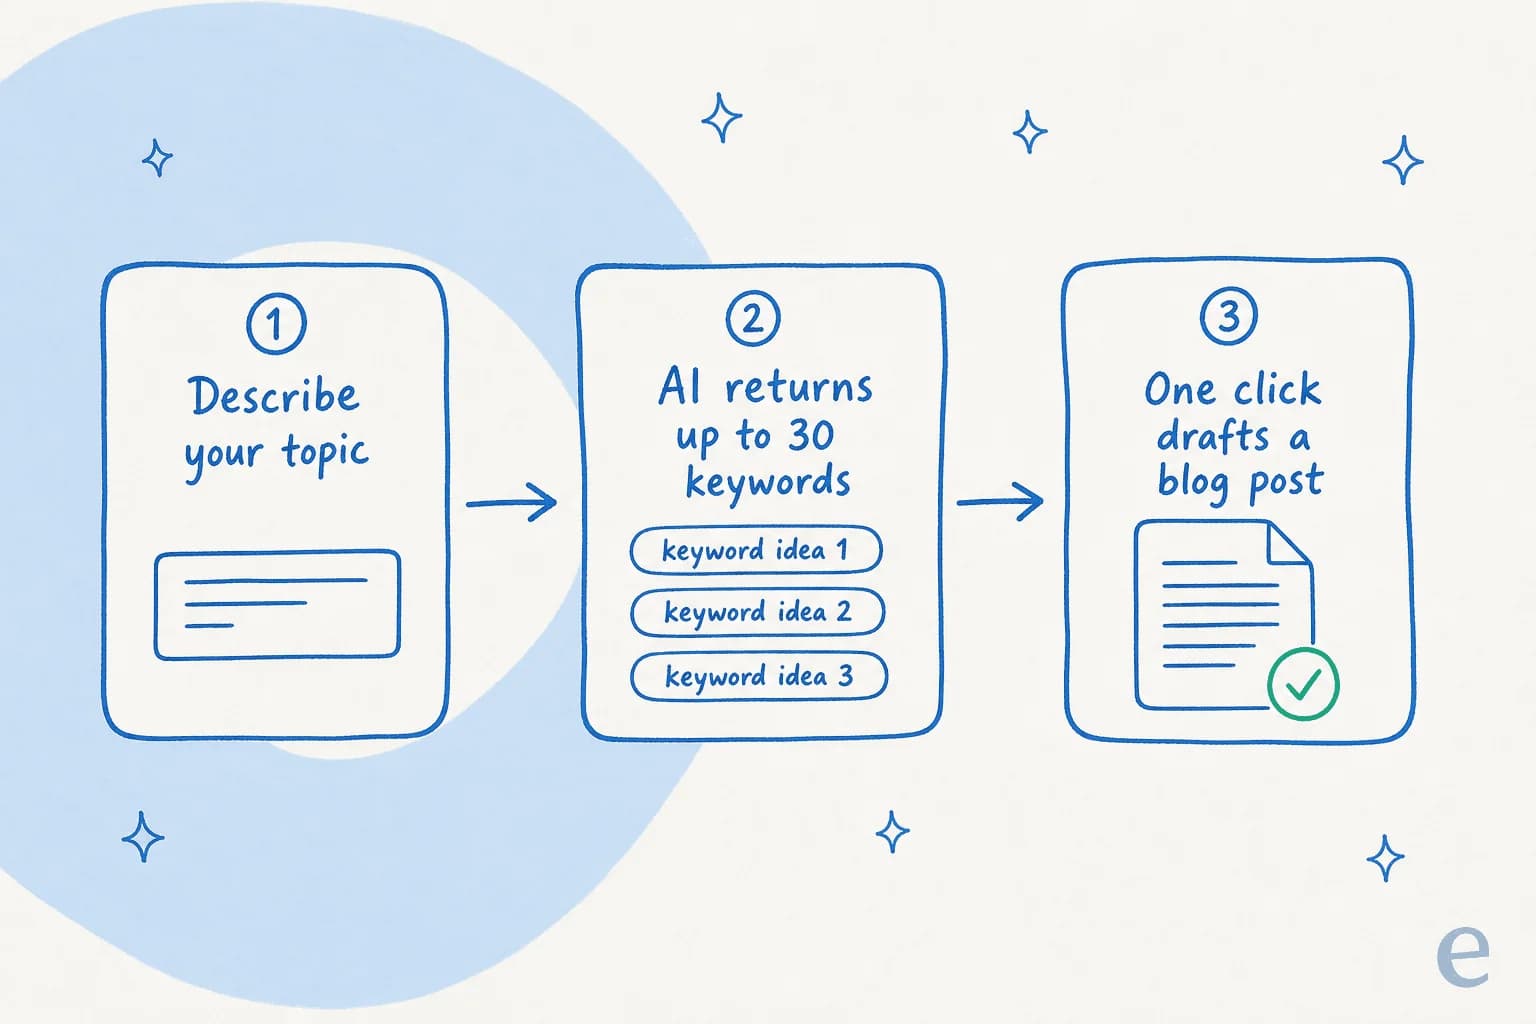
C'est la même idée qui fait fonctionner le co-scientist, appliquée au support et au contenu. Le coéquipier IA pour le helpdesk rejoint votre file existante, apprend de vos anciens tickets et de votre centre d'aide, et rédige ou envoie des réponses, et vous pouvez le simuler sur de vrais tickets historiques avant qu'il ne touche un client en direct. Le rédacteur de blog IA gère la boucle recherche et rédaction de bout en bout. Les deux fonctionnent sous un seul compte, se branchent aux outils que vous utilisez déjà et sont en ligne en quelques minutes. Le démarrage est gratuit, sans appel commercial. Découvrez comment les coéquipiers fonctionnent.
Comment fonctionne l'AI co-scientist de Google ?