

Resumo rápido
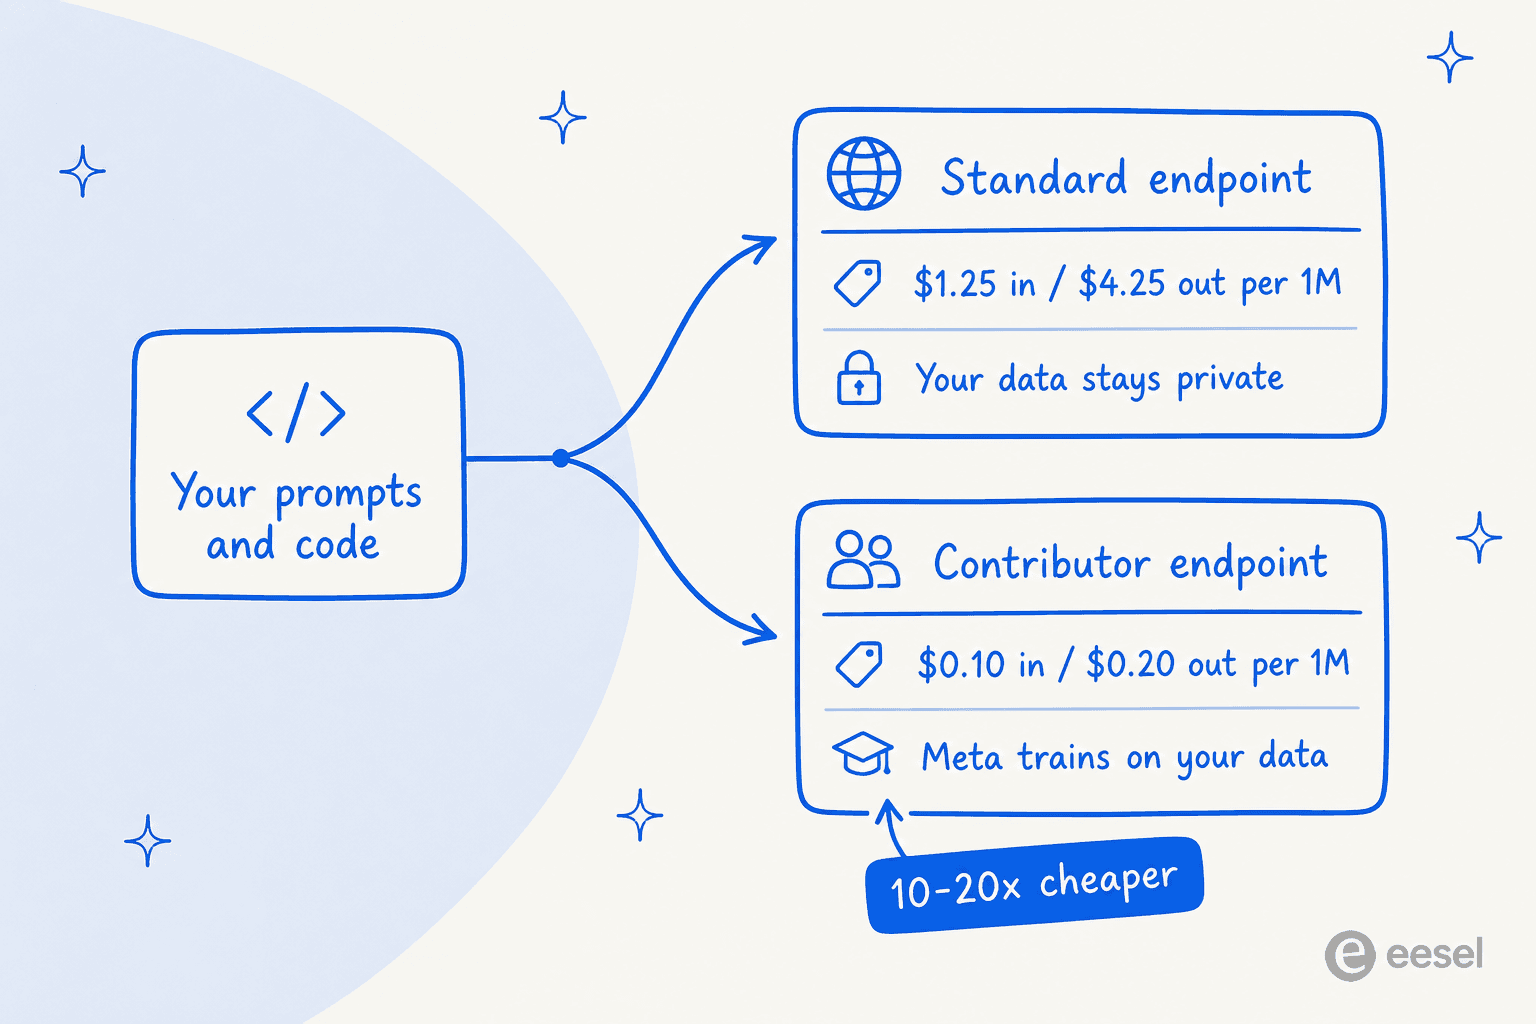
O Muse Spark 1.3 da Meta tem dois preços para o mesmo modelo, e a diferença entre eles se resume inteiramente aos seus dados. O endpoint padrão custa $1,25 por 1 milhão de tokens de entrada e $4,25 por 1 milhão de saída no nível xhigh, mantendo seu tráfego privado. O endpoint de contribuidor custa cerca de $0,10 / $0,20 por milhão, sendo aproximadamente 10 a 20 vezes mais barato, em troca de permitir que a Meta treine com o conteúdo que você envia.
O preço de tabela é apenas metade da história. O Muse Spark 1.3 é extraordinariamente verboso, então uma taxa baixa por token ainda pode resultar em uma fatura alta por tarefa. A Artificial Analysis estima que o custo misto do endpoint padrão seja de cerca de $0,78 por 1 milhão de tokens e aproximadamente $1,37 para concluir uma única tarefa do Intelligence Index, além de existir um desconto de cache de 88% que vale a pena conhecer.
Passei dois anos observando equipes escolherem um modelo com base no preço de entrada e depois serem surpreendidas pela linha de saída na fatura. Por isso, aqui está a opinião sincera de quem constrói soluções: uma API de modelo bruto é um centro de custo que você precisa gerenciar token por token. Se o que você realmente deseja é um agente de suporte ou um redator de blog que execute um trabalho por um preço previsível, é nessa camada que um colega de equipe de IA como o eesel atua, cobrando por resolução em vez de por token.
O que você realmente paga
A primeira coisa a entender é que o "preço do Muse Spark 1.3" não é um número único. A Meta disponibiliza o mesmo modelo através de dois endpoints na API de Modelos da Meta, e eles têm preços muito diferentes.
| Endpoint | Entrada / 1M | Saída / 1M | Seus dados | Ideal para |
|---|---|---|---|---|
| Padrão (xhigh) | $1,25 | $4,25 | Mantidos privados, não usados para treino | Produção, dados de clientes, código proprietário |
| Contribuidor | ~$0,10 | ~$0,20 | Usados para melhorar os produtos da Meta | Projetos pessoais, scripts descartáveis, tarefas em lote não sensíveis |
As taxas padrão do xhigh foram confirmadas pela Artificial Analysis e permaneceram estáveis em relação ao Muse Spark 1.2, em vez de subirem com a nova versão, o que é uma boa notícia. Os números do contribuidor vêm de usuários citando a própria página de preços da Meta no tópico de lançamento: portanto, trate os valores exatos como de alta confiança, mas não como definitivos até que a página seja mais fácil de ler. De qualquer forma, a diferença é de cerca de 10 a 20 vezes, e essa é a decisão de preço mais importante que você tomará com este modelo.
A interpretação da comunidade sobre por que essa divisão existe foi mais perspicaz do que qualquer artigo de imprensa:
"Não é que a Meta queira tanto os seus dados a ponto de pagar caro por eles. É que as empresas realmente não querem que a Meta tenha seus dados e estão dispostas a pagar caro por isso."
Essa é a troca em uma frase. O valor extra do endpoint padrão não é uma taxa, é o produto. Escolha o endpoint que combine com a sensibilidade da entrada, não aquele com o menor número.
Estime sua fatura mensal
Preços de tabela são abstratos até que você insira seu próprio volume, então aqui está uma calculadora. Insira aproximadamente quantos milhões de tokens você utiliza por mês, escolha um endpoint e ela fará a aritmética tanto para a entrada quanto para o lado da saída, que é notoriamente pesado.
Observe o campo de saída especificamente. Como o Muse Spark 1.3 depende muito de tokens de saída, e a saída custa 3,4 vezes o preço da entrada, esse campo altera sua fatura muito mais do que o campo de entrada. Isso nos leva à parte que o preço de tabela esconde.
A taxa de verbosidade
Aqui está a pegadinha que não aparece em nenhuma página de preços: o Muse Spark 1.3 "pensa alto" com frequência. A Artificial Analysis mediu o modelo emitindo 140 milhões de tokens de saída para completar o Intelligence Index completo, contra uma mediana do setor de cerca de 90 milhões, e os testes da própria comunidade no lançamento o colocaram em aproximadamente 3 vezes o uso de tokens da versão 1.2.
Você paga por token de saída. Portanto, um modelo com uma taxa de saída baixa que gera uma montanha de tokens não é automaticamente a opção barata. Execute o mesmo trabalho em um modelo mais conciso com uma taxa mais alta e o modelo conciso pode ser mais vantajoso na fatura. Esse é exatamente o perigo que mencionei no início, e é por isso que o custo por tarefa importa mais do que a taxa por token. A Artificial Analysis coloca o endpoint padrão em cerca de $1,37 para concluir uma tarefa do Intelligence Index quando se leva em conta a verbosidade, junto com uma velocidade de saída próxima a 198 tokens/segundo e um tempo para o primeiro token de cerca de 29 segundos.
Dois fatores ajudam a reduzir o custo real:
- O desconto de cache de 88%. Tokens de entrada repetidos (um prompt de sistema longo, uma base de conhecimento que você envia a cada chamada) são cobrados a uma fração da taxa de entrada. Para cargas de trabalho baseadas em agentes ou com muita recuperação de dados que reenviam o mesmo contexto, essa é uma economia real e significativa.
- O suporte da própria Meta. A Meta co-treinou o modelo com o Muse Code: portanto, executá-lo dentro do Muse Code tende a usar menos tokens e turnos do que um agente de terceiros. Se você fizer o benchmark em outro lugar e ele parecer caro, parte da razão é a plataforma utilizada.
A lição para o orçamento: não calcule o custo deste modelo com base apenas na taxa de entrada. Estime seu volume de saída honestamente, aplique o desconto de cache onde seu fluxo de trabalho repetir contextos e simule com uma fatia real do seu próprio tráfego antes de se comprometer.
O nível máximo que você ainda não pode comprar
Há um asterisco nos preços que é fácil de ignorar. A Meta divulgou suas pontuações de benchmark principais no nível de raciocínio max, mas o nível max está restrito a testes de segurança adicionais no lançamento, então o nível que você pode realmente chamar e pagar hoje é o xhigh. Ainda não há um preço padrão público para o nível max.
Isso importa por dois motivos. Primeiro, se você planeja seu orçamento com base nas pontuações de lançamento, está se baseando em um nível que não pode comprar. Segundo, quando o max for liberado, espere que ele custe mais e seja ainda mais verboso do que o xhigh, já que mais raciocínio significa mais tokens de saída a $4,25 por milhão. O detalhamento completo do benchmark analisa o quanto do salto da versão 1.2 para a 1.3 é, na verdade, uma diferença entre max e xhigh em vez de um salto geracional limpo: vale a pena ler antes de assumir que os números de alto nível se aplicam ao que você está pagando.
Como o preço se compara ao mercado
Considerando apenas o preço de tabela, o endpoint padrão do Muse Spark 1.3 situa-se na faixa econômica dos modelos de ponta. Veja onde ele se posiciona em relação aos modelos que a maioria das equipes considera. Estas são as taxas de entrada/saída de tabela para um nível comparável: o custo real ainda oscila conforme a verbosidade e sua própria mistura de uso.
| Modelo | Entrada / 1M | Saída / 1M | Notas |
|---|---|---|---|
| eesel AI | $0,40 | - | Preço por ticket/sessão; $4,00 por post de blog; teste gratuito de $50; sem taxas mensais. |
| Muse Spark 1.3 (padrão xhigh) | $1,25 | $4,25 | Muito verboso; 88% de desconto em cache; endpoint de contribuidor ~10-20x mais barato |
| Muse Spark 1.3 (contribuidor) | ~$0,10 | ~$0,20 | Meta treina com seus dados |
| Claude Opus 5 | mais alto | mais alto | Supera o 1.3 na maioria das avaliações de agentes; nível premium |
| GPT-6 Astra | médio | médio | Estrutura de preços diferente; veja seu próprio detalhamento |
| Gemini 3.8 Flash | baixo | baixo | Liderou brevemente o mesmo índice no dia em que o 1.3 foi lançado |
| DeepSeek V4 Flash | muito baixo | muito baixo | Aberto, licença MIT; o verdadeiro piso de orçamento |
| Kimi K3 | médio | médio | Outro concorrente de pesos abertos |
A leitura honesta: no endpoint de contribuidor, o 1.3 é mais barato por milhão do que a maioria das opções de ponta hospedadas, e até supera alguns modelos econômicos legados, como um comentarista observou. No endpoint padrão, ele tem um preço competitivo, mas não é o mais barato, e a verbosidade significa que o custo efetivo sobe mais rápido do que o preço de tabela sugere. Se o seu único critério é o preço por token em trabalhos não sensíveis, o endpoint de contribuidor ou um modelo aberto como o DeepSeek V4 Flash é difícil de bater. Se o seu critério é o preço por trabalho concluído em dados reais, a matemática fica mais interessante, e é nessa parte que vale a pena prestar atenção.
Do preço por token para um preço por resultado
Aqui está a visão de quem constrói, e é o que a maioria dos posts sobre preços ignora. Cada número acima é um custo de matéria-prima, não um custo para realizar o trabalho. O preço do token diz quanto custa o motor. Ele não diz nada sobre conectar o modelo à sua central de atendimento, carregá-lo com o contexto da sua empresa, testá-lo contra casos atípicos ou fazê-lo confirmar informações antes de enviar um e-mail a um cliente. Você constrói e paga por tudo isso além do token.
Essa lacuna é onde o eesel atua. A forma como eu definiria é a seguinte: modelos como o Muse Spark 1.3 são a infraestrutura, e o eesel é o colega de equipe que você contrata para trabalhar nela. Você não precisa escolher um nível, configurar integrações e arcar com a verbosidade na sua própria fatura. Você contrata um colega de equipe pronto para o trabalho para uma função definida, e ele já chega com as habilidades, integrações e o contexto da empresa para essa função.
O modelo de precificação é a diferença concreta. O eesel cobra por resolução, não por token, então um modelo que pensa alto 3 vezes mais não é um item de linha que você precisa prever. O colega de equipe de IA para helpdesk entra na sua fila de suporte, consulta pedidos e redige ou envia respostas dentro da sua central de atendimento atual, e o redator de blog com IA pesquisa e redige posts longos como este. Em ambos os casos, o preço que você vê está atrelado ao trabalho realizado, não aos tokens consumidos.
Experimente o eesel
Se você está lendo um post sobre os preços do Muse Spark 1.3 porque está decidindo com o que construir, esse é o momento exato para o qual o eesel foi criado. Você obtém um colega de equipe de IA pronto para o trabalho em vez de uma API de modelo bruto, de modo que a matemática por token acima deixa de ser um problema seu.
O diferencial concreto é a parte que um modelo bruto não pode oferecer: o colega de equipe do helpdesk é simulado contra tickets anteriores antes de entrar em operação, para que você veja como ele teria lidado com conversas reais em vez de apenas esperar que um benchmark funcione na prática. Ele se conecta às suas ferramentas em minutos, é grátis para testar e, como cobra por resolução em vez de por token, um modelo verboso pensando alto não afeta seu orçamento.