

Resumo rápido
A Meta lançou o Muse Spark 1.3 em 2 de setembro de 2026, cerca de quatro semanas após a versão 1.2, integrado ao seu agente de codificação Muse Code e à API Meta Model. É um salto real: ele ocupa a 6ª posição entre 636 modelos no Índice de Inteligência da Artificial Analysis, com uma janela de contexto de 1 milhão de tokens e entrada de texto, imagem e vídeo.
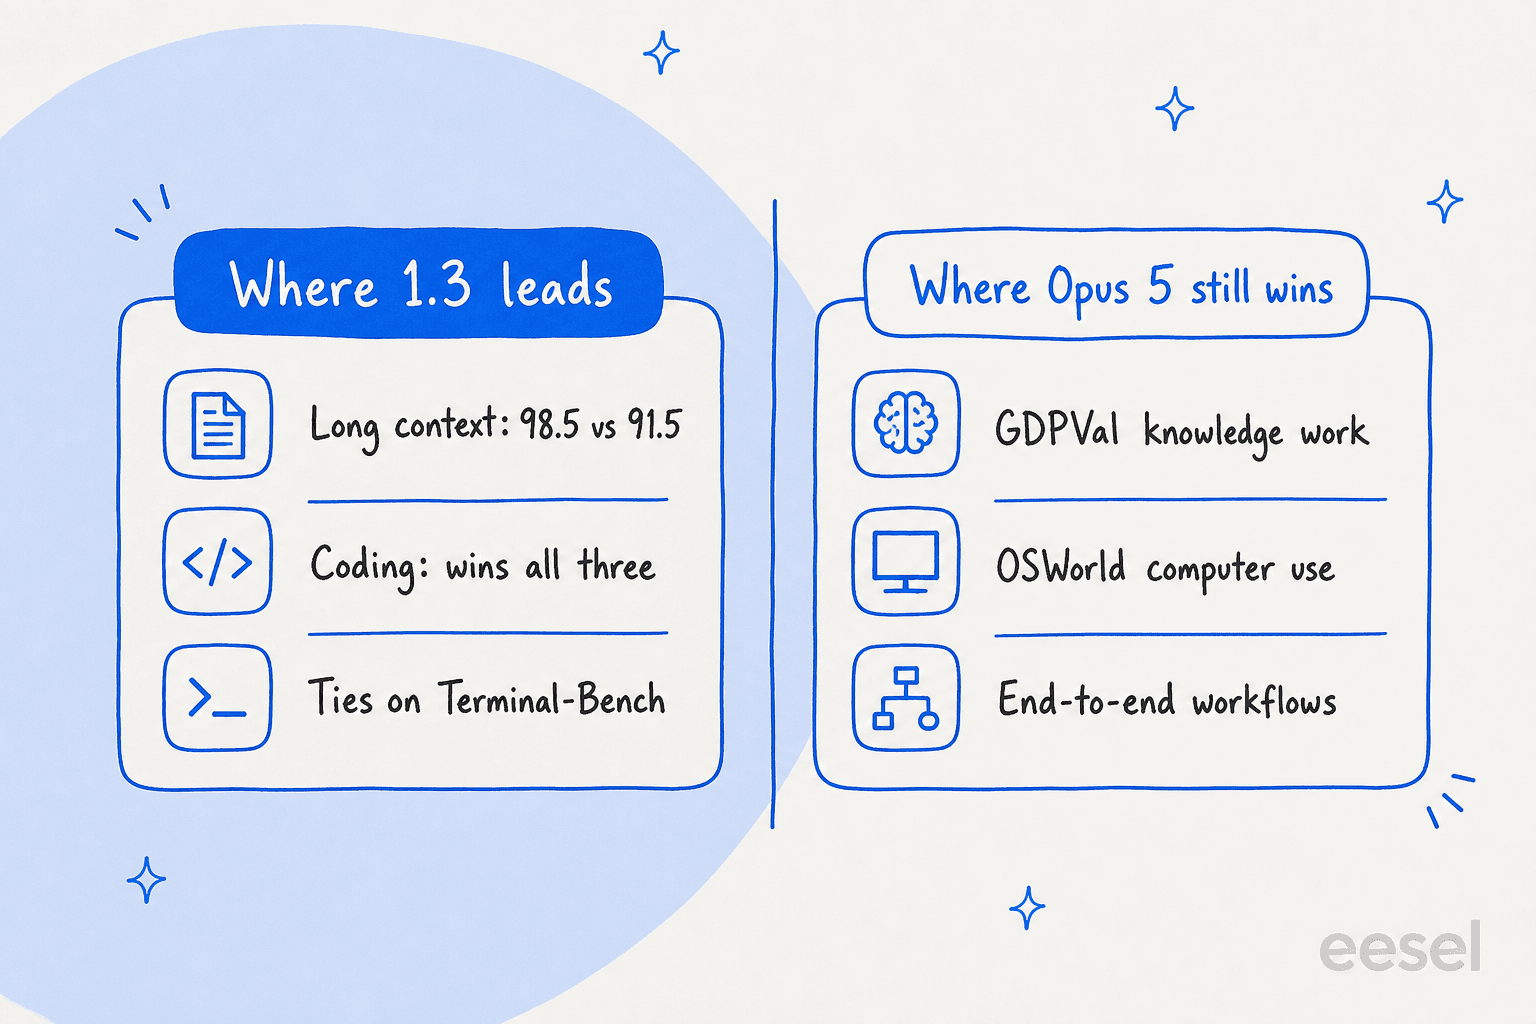
A leitura honesta de onde ele vence: contexto longo e codificação são os ganhos reais. Ele apresenta uma recuperação de contexto longo quase perfeita (98,5 e 98,1) e vence todas as linhas de codificação no placar da própria Meta. No entanto, em benchmarks puramente de agentes, o Opus 5 (max) ainda lidera em quatro de seis. Além disso, os números principais vêm com uma pegadinha: o placar da Meta compara o modo max do 1.3 (ainda restrito por testes de segurança no lançamento) com o modo xhigh do 1.2, então parte do salto é uma mudança de nível de raciocínio, não um salto geracional limpo. Ele também é cerca de 3 vezes mais prolixo que o 1.2.
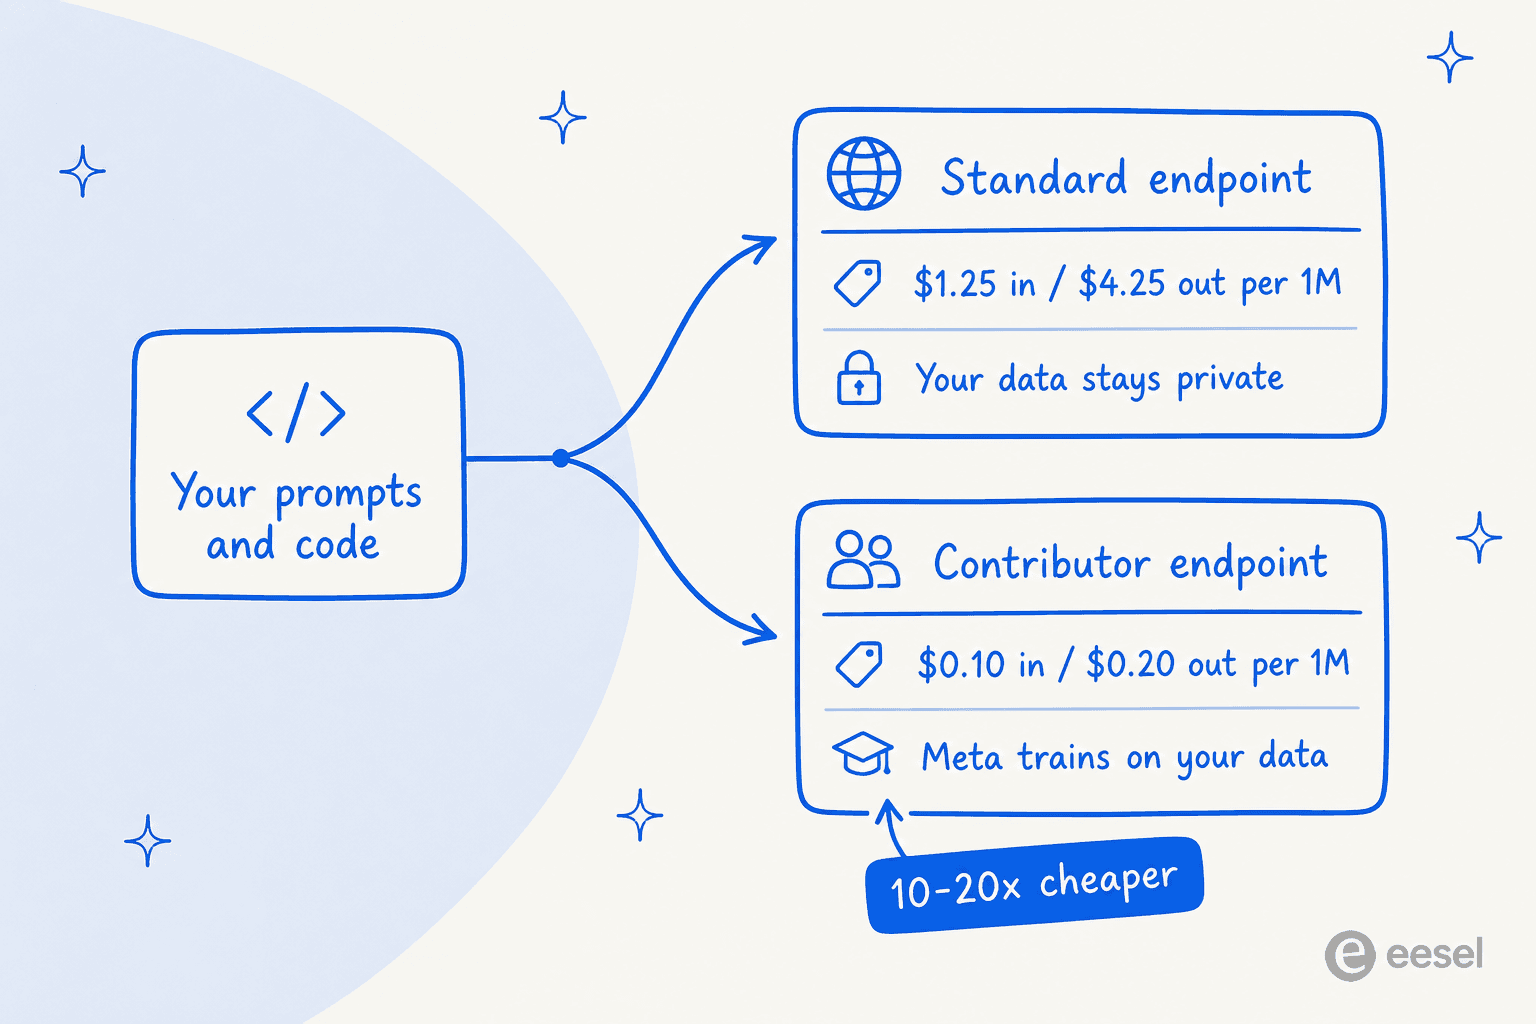
O preço é a parte mais discutida. O endpoint padrão custa US$ 1,25 / US$ 4,25 por 1 milhão de tokens; um endpoint de "colaborador" é cerca de 10 a 20 vezes mais barato se você permitir que a Meta treine com seus dados. Qualquer que seja sua escolha, um modelo bruto é infraestrutura, não um trabalhador pronto. Se o que você realmente quer é um agente de suporte ou um redator de blog que já conheça o seu negócio, esse é o trabalho que um colega de equipe de IA como o eesel AI faz sobre modelos como este.
O que o Muse Spark 1.3 realmente é
Eu trabalho construindo sobre essas APIs de modelos, então a primeira coisa que faço em qualquer lançamento é separar o modelo do marketing. O Muse Spark 1.3 é o modelo de raciocínio de fronteira da Meta, de pesos fechados, e a Meta o posiciona como mais um passo "em direção à superinteligência pessoal" em seu anúncio no blog de pesquisa. Você pode acessá-lo de duas maneiras: pelo Muse Code, a estrutura de agente de codificação da própria Meta, ou diretamente pela API Meta Model.
Alguns fatos que valem a pena destacar antes que o barulho dos benchmarks comece:
- Ele é lançado em duas variantes publicadas:
max(o modo de raciocínio superior) exhigh(mais rápido). O blog da Meta observa que o raciocínio max estará disponível "em breve, após concluirmos testes de segurança adicionais", portanto, o modo totalmente disponível no lançamento é o xhigh, não o max. - A janela de contexto é de 1 milhão de tokens, e ele aceita texto, imagem e vídeo como entrada.
- É um modelo proprietário. A Artificial Analysis o lista como fechado, e nenhum lançamento de pesos abertos foi anunciado, o que o coloca em uma categoria diferente da linha Llama aberta da Meta.
Essa divisão de variantes importa mais do que parece, e voltarei a esse ponto, porque ela está silenciosamente fazendo muito trabalho nos números de lançamento.
Os benchmarks: onde o 1.3 vence e onde não vence
A Meta liderou o lançamento com um placar de quatro modelos: Muse Spark 1.3, Muse Spark 1.2, GPT-5.6 Sol e Claude Opus 5, abrangendo tarefas de agente, codificação, acompanhamento de instruções e contexto longo. Aqui está ele, direto da fonte.
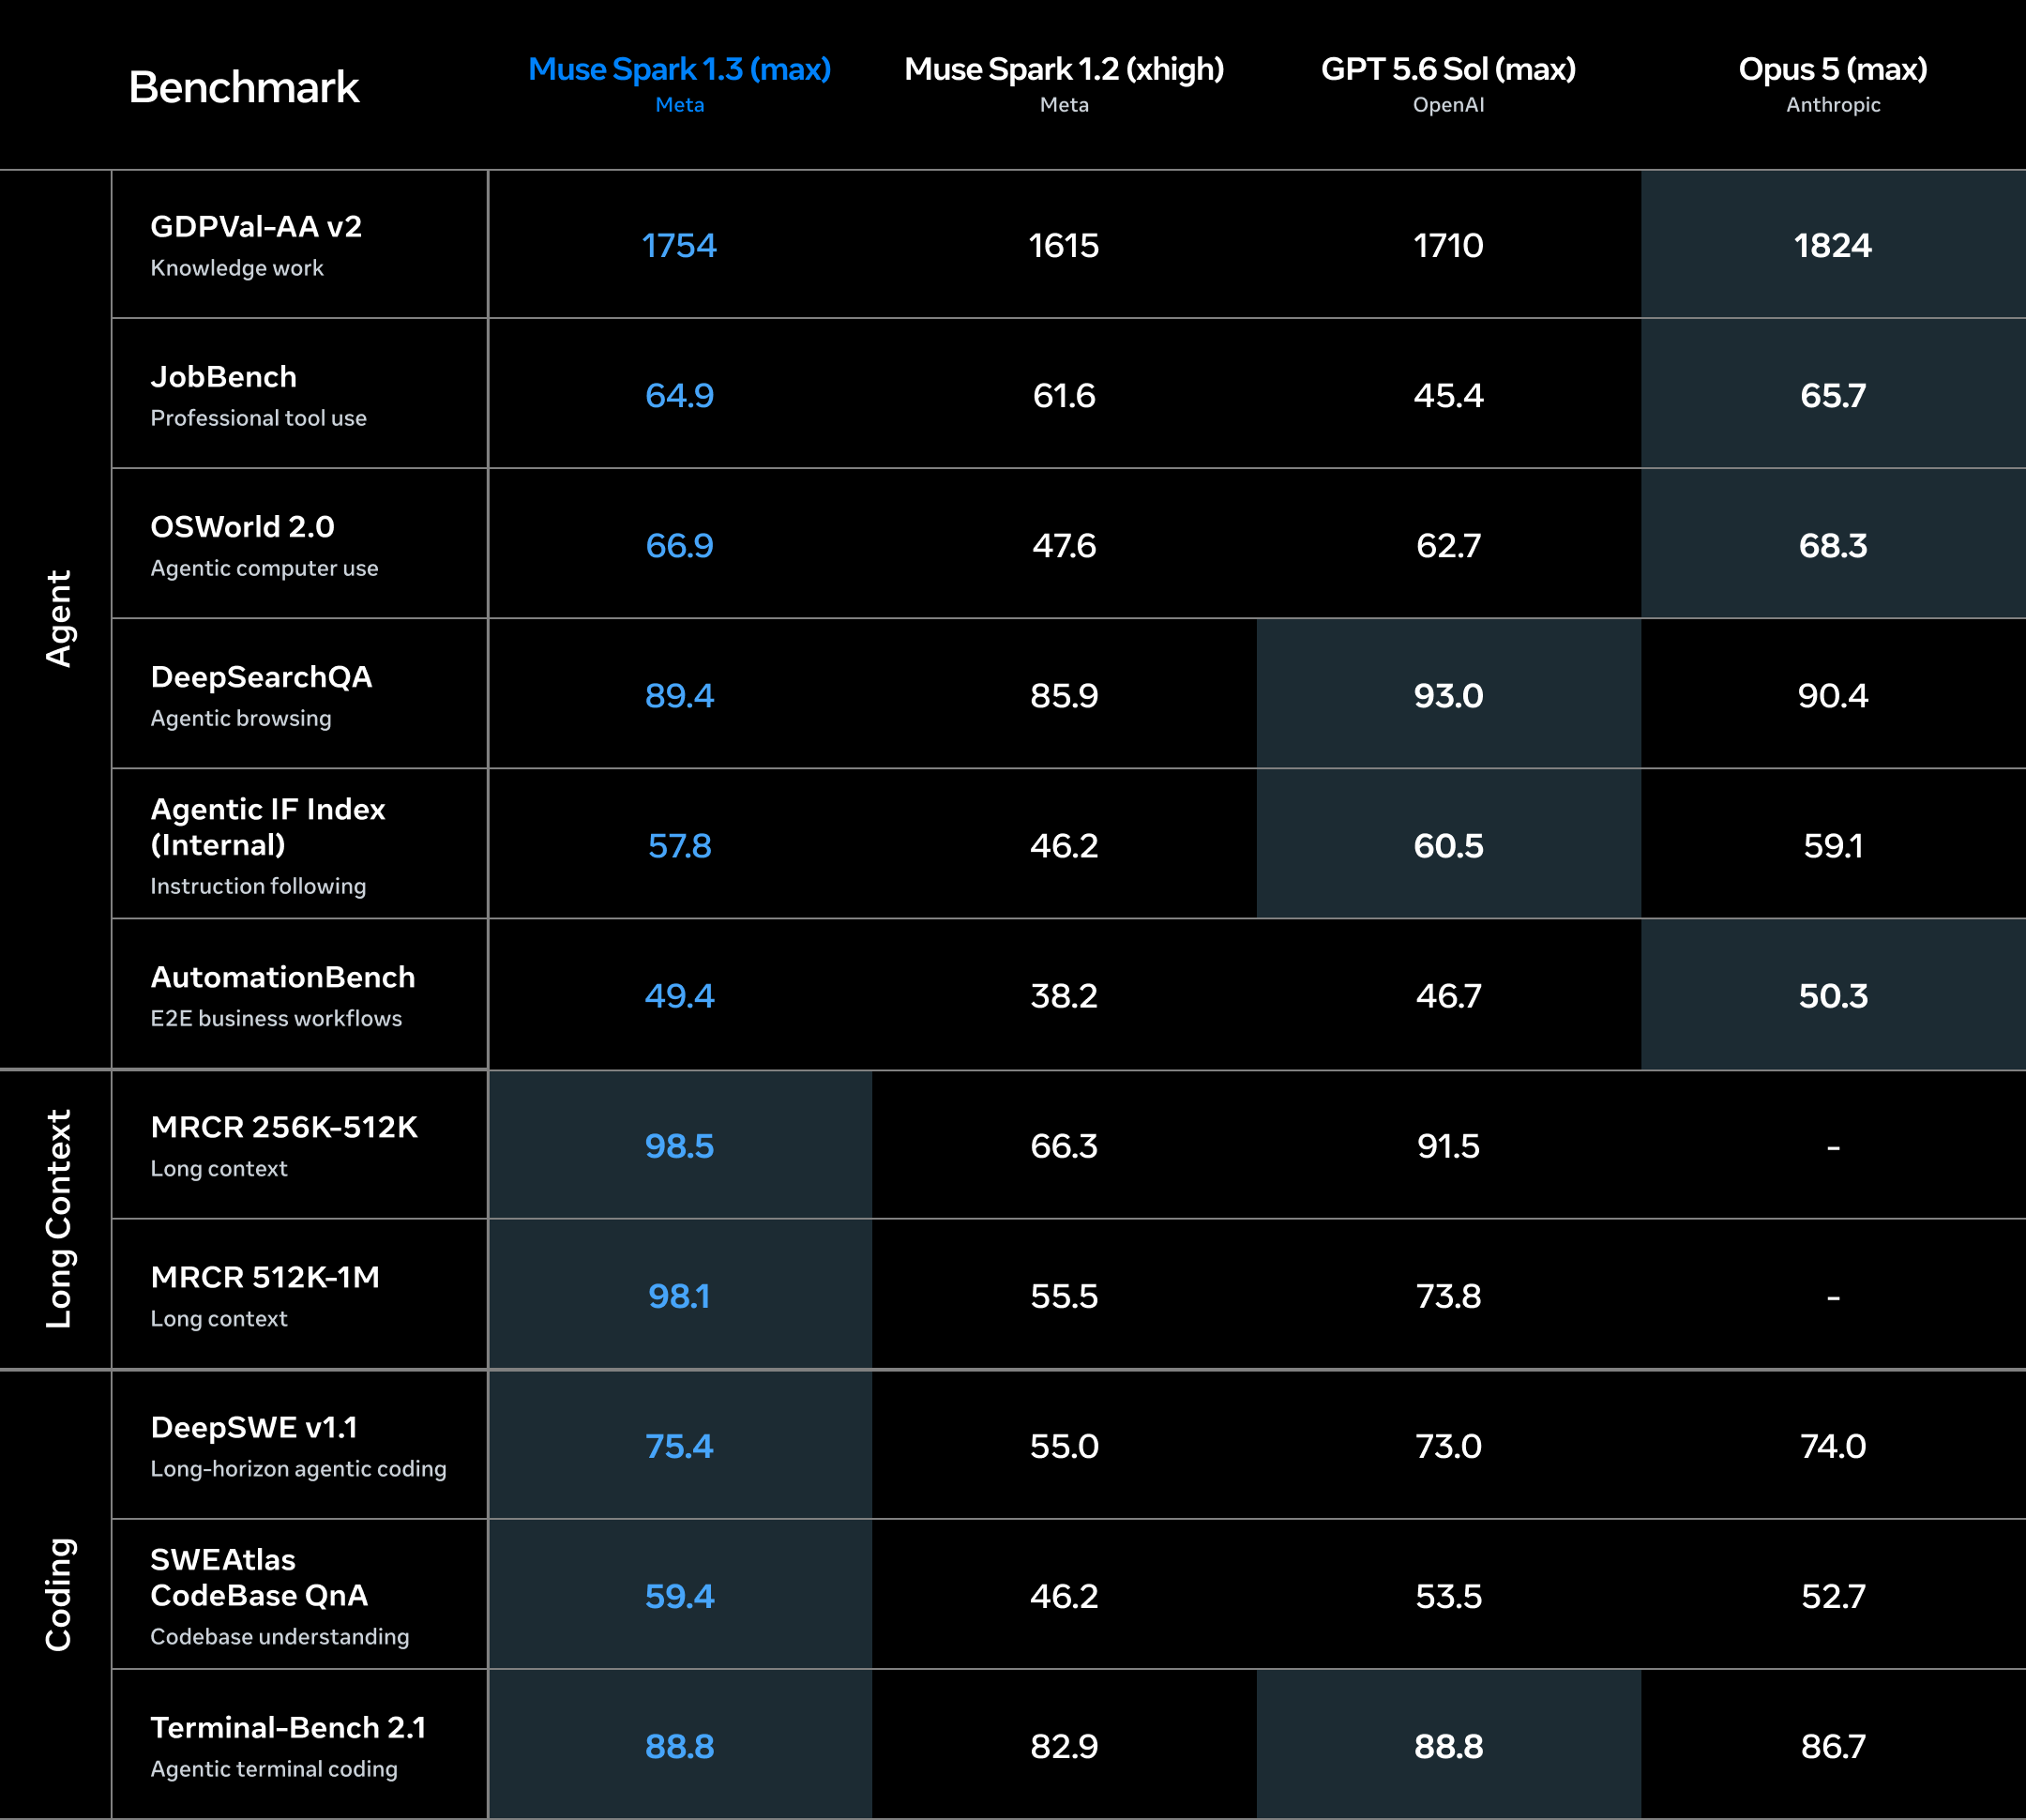
Ao ler as linhas, um padrão claro aparece, o que é mais útil do que um único número de manchete:
| Benchmark | eesel AI (Agente) | Muse Spark 1.3 (max) | Muse Spark 1.2 (xhigh) | GPT-5.6 Sol (max) | Opus 5 (max) |
|---|---|---|---|---|---|
| GDPVal-AA v2 (trabalho intelectual) | Integrado | 1754 | 1615 | 1710 | 1824 |
| JobBench (uso de ferramentas prof.) | Integrado | 64.9 | 61.6 | 45.4 | 65.7 |
| OSWorld 2.0 (uso de computador) | Integrado | 66.9 | 47.6 | 62.7 | 68.3 |
| DeepSearchQA (navegação agentística) | Integrado | 89.4 | 85.9 | 93.0 | 90.4 |
| Agentic IF Index (seguir instruções) | Integrado | 57.8 | 46.2 | 60.5 | 59.1 |
| AutomationBench (fluxos E2E) | Integrado | 49.4 | 38.2 | 46.7 | 50.3 |
| MRCR 256K-512K (contexto longo) | Integrado | 98.5 | 66.3 | 91.5 | – |
| MRCR 512K-1M (contexto longo) | Integrado | 98.1 | 55.5 | 73.8 | – |
| DeepSWE v1.1 (codificação agentística) | Integrado | 75.4 | 55.0 | 73.0 | 74.0 |
| SWEAtlas CodeBase QnA | Integrado | 59.4 | 46.2 | 53.5 | 52.7 |
| Terminal-Bench 2.1 (codificação terminal) | Integrado | 88.8 | 82.9 | 88.8 | 86.7 |
A história que a tabela conta: o Muse Spark 1.3 domina o contexto longo e a codificação. Seus 98,5 e 98,1 nos testes de contexto longo MRCR não são apenas vitórias, eles deixam o GPT-5.6 Sol (91,5 e 73,8) e seu próprio antecessor (66,3 e 55,5) bem para trás, sendo que o Opus 5 nem sequer registrou um número. Na codificação, ele leva o DeepSWE v1.1 (75,4), a compreensão de base de código (59,4) e empata com o GPT-5.6 Sol no topo do Terminal-Bench (88,8). Esse é um resultado real e verificável, e está de acordo com a própria afirmação da Meta de que o 1.3 usa cerca de 20% menos chamadas de ferramentas e cerca de 25% menos tokens do que o 1.2 para terminar um trabalho de codificação.
Mas olhe honestamente para a coluna de agentes. Nos seis benchmarks de agentes, o Opus 5 (max) vence o 1.3 em quatro (GDPVal, JobBench, OSWorld, AutomationBench), e o GPT-5.6 Sol leva os outros dois (DeepSearchQA, Agentic IF). Portanto, "agente e codificação aprimorados" é justo para codificação, mas nas avaliações de agentes, o 1.3 é um segundo lugar forte, não o líder. No conjunto, a Artificial Analysis coloca sua variante max em um Índice de Inteligência de 62, classificado em 6º lugar entre 636 modelos, contra uma mediana de 17 para modelos comparáveis. É bom, mas a classificação é próxima o suficiente para que um rival possa retomá-la em uma semana, e um comentarista do Hacker News notou que o Gemini 3.8 Flash ocupou brevemente o primeiro lugar no mesmo dia.
A pegadinha nos números principais
Aqui está o que eu gostaria que um colega me apontasse. Olhe novamente para os cabeçalhos das colunas do placar: a coluna 1.3 é max, e a coluna 1.2 é xhigh. Esses são níveis de raciocínio diferentes. Portanto, alguns dos saltos chamativos de 1.2 para 1.3, como o OSWorld indo de 47,6 para 66,9 ou o MRCR indo de 66,3 para 98,5, são em parte uma lacuna entre max e xhigh, e não um ganho puro de versão sobre versão. Uma comparação direta entre xhigh certamente estreitaria esses resultados.
Essa abordagem incomodou algumas pessoas. Como disse um comentarista no tópico de lançamento:
"É um pouco desonesto que o benchmark mostre apenas o raciocínio max." – sunaookami, Hacker News
A pegadinha tem peso real porque o modo max que carrega esses resultados principais é o que ainda está bloqueado por testes de segurança no lançamento. O que você pode realmente chamar hoje é o xhigh, que marcou 61 no Índice de Inteligência. Não é uma diferença enorme em relação a 62, mas é o número honesto para o que está sendo entregue agora.
O segundo asterisco é a prolixidade. A Artificial Analysis mediu o 1.3 emitindo 120 milhões de tokens de saída para completar o Índice de Inteligência completo (a mediana para o setor é de 72 milhões), e os testes da própria comunidade indicaram que ele utiliza cerca de 3 vezes os tokens do 1.2. Como você paga por token de saída, um modelo que pensa em voz alta 3 vezes mais não é automaticamente mais barato apenas porque o preço por token é baixo. Vale a pena simular em sua própria carga de trabalho antes de assumir que o preço de tabela é vantajoso.
Preços: a divisão de dados por desconto
É aqui que o lançamento ficou interessante, e é uma jogada bem ao estilo da Meta. Existem dois endpoints para o mesmo modelo, e a diferença de preço é inteiramente sobre os seus dados.
| Endpoint | Entrada / 1M | Saída / 1M | Seus dados |
|---|---|---|---|
| eesel AI | US$ 0,40 / ticket | US$ 4,00 / blog | Privados e seguros |
| Padrão (xhigh) | US$ 1,25 | US$ 4,25 | Mantidos privados, sem treino |
| Colaborador | ~US$ 0,10 | ~US$ 0,20 | Usados para melhorar produtos Meta |
Os números padrão do xhigh são confirmados pela Artificial Analysis, que também registrou um custo de US$ 0,55 por tarefa do Índice de Inteligência, 182 tokens/segundo de saída e um tempo de 38,51 segundos para o primeiro token de resposta. Os dados do colaborador vêm de usuários citando a página de preços da Meta no tópico de lançamento, então trate os centavos exatos como alta confiança, mas não como verdade absoluta até que a página da Meta seja mais fácil de ler. De qualquer forma, a diferença é de aproximadamente 10 a 20 vezes.
A leitura da comunidade sobre o porquê dessa divisão existir foi mais afiada do que qualquer artigo de imprensa:
"Não é que a Meta queira muito seus dados e esteja disposta a pagar caro por eles. É que as empresas realmente não querem que a Meta tenha seus dados e estão dispostas a pagar caro por isso." – IshKebab, Hacker News
Essa é a troca em uma frase. O endpoint colaborador é mais barato por milhão do que o ChatGPT Luna e até o antigo DeepSeek V4 Flash, notou um comentarista, o que é um ótimo negócio para um projeto de hobby ou um script descartável. Para qualquer coisa que envolva dados de clientes ou código proprietário, o prêmio do endpoint padrão é o objetivo, não um erro. Escolha o endpoint que corresponda à sensibilidade da entrada, não apenas o que tem o menor número.
O que a comunidade realmente pensa
O sentimento no dia do lançamento viveu no Hacker News (391 pontos, 261 comentários), e foi refrescantemente misto, em vez de apenas empolgação. As pessoas que usaram o 1.2 em uma estrutura real de codificação gostaram da velocidade e do preço, e estavam curiosas para saber se o 1.3 corrige seus hábitos:
"Estou usando em parte o 1.2 para fazer engenharia reversa e reimplementar um binário de jogo antigo e tem sido muito bom e rápido... o 1.2 pode ficar preso gerando resumos de pensamento com sons semelhantes sem progresso aparente quando solicitado a resolver bugs." – WASDx, Hacker News
Outros não ficaram convencidos pela geração anterior, o que é um alerta justo contra ler benchmarks como experiência real:
"Usei o Muse Spark 1.2 e não fiquei nem um pouco impressionado. Rápido e barato, mas até o GPT 5.6 Terra parecia muito mais capaz." – Gecko4072, Hacker News
Uma dica prática surgiu repetidamente e vale a pena anotar: a Meta treinou o modelo junto com sua própria estrutura, então executá-lo dentro do Muse Code em vez de um agente de terceiros tende a usar menos tokens e turnos. Se você o testar na estrutura de outra pessoa e ele parecer caro, esse é um dos motivos.
Como a Meta projetou o comportamento do agente
Benchmarks à parte, a afirmação de engenharia mais interessante é sobre o comportamento. A Meta diz que o 1.3 foi treinado para se comportar menos como um estagiário ansioso e mais como um cuidadoso: fazer perguntas de esclarecimento, pedir ajuda quando estiver travado, confirmar antes de ações consequentes ou irreversíveis e manter um único tópico longo e bagunçado sem perder os requisitos iniciais.
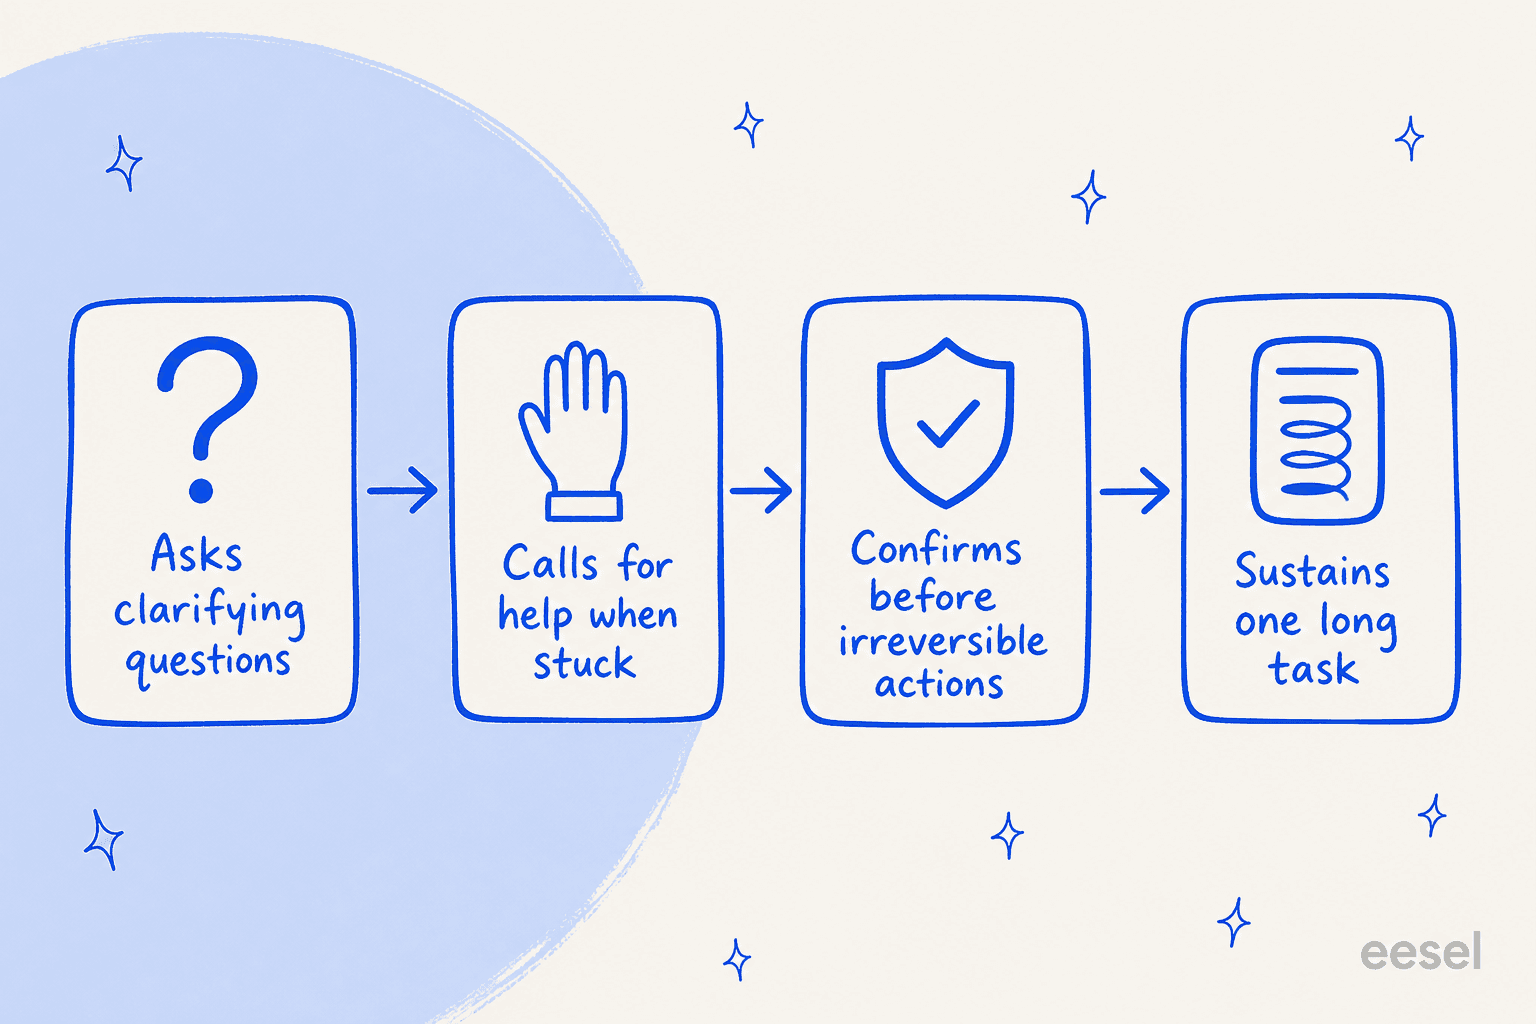
A Meta combina isso com alegações de segurança: maior resiliência a adversários, melhor resistência a prompt injection e melhor calibração em torno de ações irreversíveis. Tendo passado mais de três anos observando agentes de IA operarem em filas reais, leio "confirma antes de ações irreversíveis" como a linha mais importante em todo o anúncio. Um modelo confiante que faz silenciosamente a coisa errada é pior do que um hesitante que verifica. É exatamente por isso que, nos produtos em que trabalho, simulamos cada agente contra dados históricos reais antes de ele tocar em um cliente ao vivo, em vez de confiar em uma pontuação de benchmark para prever o comportamento em produção.
Esse instinto também é a ponte para a parte que a maioria desses posts de lançamento ignora: um modelo forte é matéria-prima, não um trabalhador finalizado.
De um modelo de fronteira a um colega de equipe contratado
Aqui está a visão honesta de quem constrói. O Muse Spark 1.3 é um ótimo motor. Ele não é, por si só, um funcionário. O modelo não conhece o seu produto, não está conectado à sua central de ajuda ou ao seu CMS, não foi testado contra seus casos extremos e não confirmará antes de enviar um e-mail a um cliente, a menos que você construa tudo isso ao redor dele. Essa lacuna entre "modelo de fronteira" e "algo que faz um trabalho" é toda a camada que o eesel AI existe para preencher.
A forma como eu enquadraria isso: modelos como este são a infraestrutura; o eesel AI é o colega de equipe que você contrata sobre ela. Você não escolhe o modelo, configura as integrações e escreve a estrutura de segurança. Você contrata um colega de equipe pronto para trabalhar para uma função específica, e ele chega já trazendo as habilidades, integrações e o contexto da empresa para esse trabalho.
Experimente o eesel AI
Se você leu este post porque está decidindo o que construir com o Muse Spark 1.3, este é o momento para o qual o eesel AI foi criado. O eesel AI é uma plataforma de colegas de equipe de IA: em vez de uma API de modelo bruto, você contrata um colega de equipe pronto para o trabalho em uma função definida. Hoje, esse catálogo inclui um colega de equipe de central de ajuda de IA que se junta à sua fila de suporte, pesquisa pedidos e redige ou envia respostas dentro da sua central de ajuda existente, e um redator de blog de IA que pesquisa e redige posts longos como este.
O diferencial concreto é a parte que um modelo bruto não pode oferecer: o colega de equipe da central de ajuda é simulado contra seus próprios tickets antigos antes de entrar no ar, para que você veja como ele teria lidado com conversas reais, em vez de apenas torcer para que um benchmark se aplique. Ele se conecta às suas ferramentas em minutos, tem um plano gratuito com 100 créditos e utiliza um preço mensal fixo (US$ 0,40 por ticket ou chat e US$ 4,00 por post de blog, com US$ 50 de teste gratuito) em vez de faturamento por token, de modo que um modelo prolixo pensando em voz alta não seja um problema de custo para você.