

Um agente de voz com IA para atendimento ao cliente atende ligações sozinho: ele transcreve o que a pessoa diz (reconhecimento de fala), raciocina sobre seu conhecimento e seus sistemas com um LLM e depois responde falando (síntese de voz), tudo em cerca de um segundo. O difícil não é a IA, é a infraestrutura em tempo real. Quem liga percebe atraso acima de 800 ms, então todo o percurso é cronometrado.
Quanto ao custo, a voz é cobrada por minuto. As plataformas prontas colocam a maioria das chamadas de suporte na faixa de US$ 0,07 a US$ 0,16 por minuto antes da linha telefônica, então uma chamada de 5 minutos custa cerca de US$ 0,35 a US$ 0,80 mais a telefonia.
O que eu tatuaria em todo lançamento: a IA de voz funciona quando encaminha para uma pessoa e falha quando tenta substituí-la. Passei anos colocando IA em filas de suporte ao vivo, e a maior lição é confiança acima de cobertura. Deixe o agente cuidar do que tem certeza e passe o resto adiante. Essa lição vale para qualquer canal, e é por isso que vale acertar a abordagem do agente de IA para helpdesk que resolve seus chats e tickets antes de acrescentar uma linha telefônica.
O que um agente de voz com IA realmente é
Sem o marketing, um agente de voz com IA é um sistema que atende o telefone, entende quem liga em linguagem natural, faz o trabalho e responde falando, sem uma pessoa na linha durante a maior parte da chamada. O desenho dominante encadeia três modelos especializados: reconhecimento de fala (STT), um modelo de linguagem grande (LLM) para pensar e síntese de voz (TTS), tudo sobre uma camada de telefonia que conecta a chamada real. A Twilio chama isso de arquitetura de agente de voz em cascata, em que "the user's speech is transcribed, the transcript is processed by an LLM, then the resulting tokens are synthesized into audio."
Uma variante mais nova reúne essa cadeia em um único modelo. A Realtime API da OpenAI funciona diretamente de voz para voz, o que "reduces latency, preserves nuance in speech, and produces more natural, expressive responses."
Duas comparações ajudam a entender:
- Não é a velha URA. "Digite 1 para cobrança" (IVR) só entende tons do teclado ou algumas palavras roteirizadas e força todo mundo pelo mesmo menu rígido. Um agente de voz deixa a pessoa descrever o problema com as próprias palavras e, a partir daí, encaminha ou resolve.
- É o primo de voz de um chatbot de texto, num meio muito mais difícil. O chat é por turnos e perdoa um ou dois segundos de atraso. A voz é síncrona e em tempo real, e essa diferença é todo o desafio de engenharia. Se você já leu sobre a diferença entre um agente de IA e um chatbot baseado em regras, este é o mesmo salto, com um problema de áudio em tempo real por cima.
Como um agente de voz com IA funciona, passo a passo
Este é o caminho completo de uma chamada de suporte, do toque à resposta.
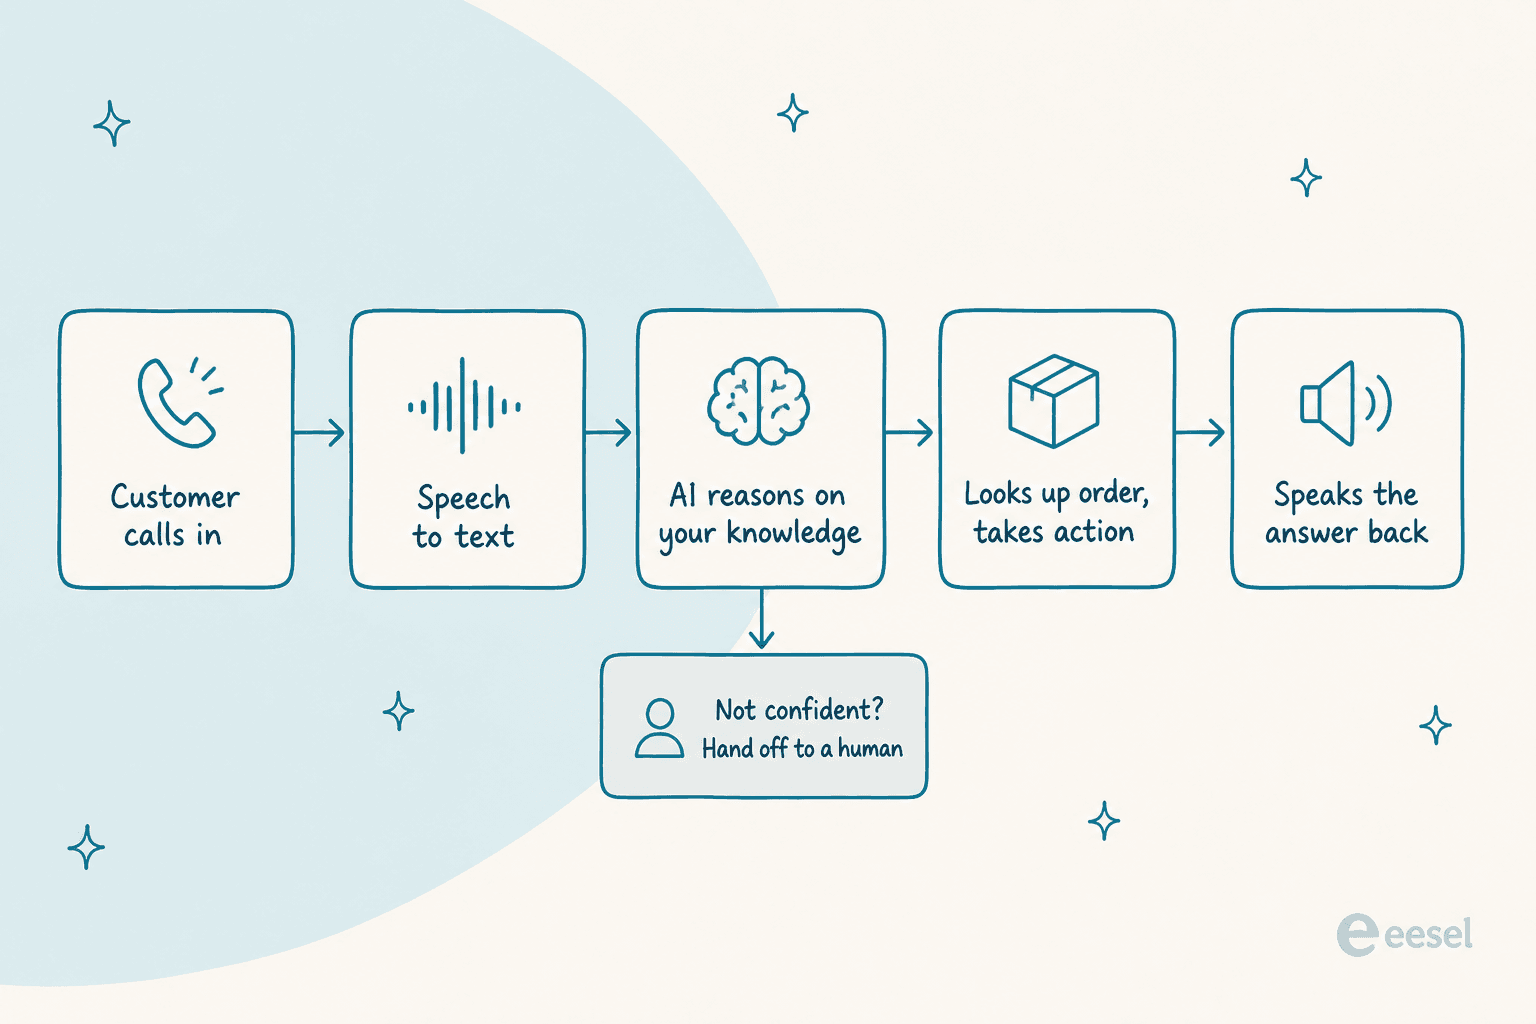
Telefonia (a linha telefônica). A chamada chega pela rede telefônica (PSTN) ou por uma conexão SIP. A Twilio expõe isso como um elemento <ConversationRelay> que "handles the complexities of live, synchronous voice calls," e a OpenAI adicionou recentemente chamadas telefônicas via SIP à sua Realtime API.
Reconhecimento de fala. O áudio de quem liga é transcrito ao vivo. O que realmente é difícil aqui não é o reconhecimento, e sim o endpointing: saber quando a pessoa realmente terminou de falar, já que uma pausa curta no meio da frase "can sound identical to an end-of-turn pause." Bons sistemas mantêm dois buffers de transcrição, um palpite provisório e um registro confirmado, para começar a pensar cedo e corrigir depois.
LLM mais recuperação de conhecimento. A transcrição vai para um LLM que descobre o que a pessoa precisa e busca respostas fundamentadas numa base de conhecimento em vez de adivinhar. A construção de referência da AWS conecta Amazon Connect, Lex e Bedrock Knowledge Bases para que o agente responda com conteúdo recuperado da empresa. Essa etapa de recuperação é o mesmo motivo pelo qual um bom agente de texto precisa ser treinado na sua base de conhecimento antes de dizer uma palavra.
Ações em sistemas de negócio. Um agente em produção não só fala, ele chama ferramentas: consultar um pedido, verificar um registro do CRM, abrir um ticket. O gpt-realtime da OpenAI ganhou suporte a servidores MCP remotos para você apontar uma sessão para um conjunto de ferramentas e tornou assíncronas as chamadas longas para que "the model can continue a fluid conversation while waiting on results."
Síntese de voz. As palavras do modelo são enviadas de volta como fala sintetizada. O Flux TTS da Deepgram intercala a geração de texto e áudio para que o tamanho da resposta não aumente a latência do primeiro áudio, com o primeiro áudio "as low as 80ms."
Esse último número indica a história real. Cada uma dessas etapas corre contra o relógio, tema da próxima seção.
Por que a voz é muito mais difícil do que um chatbot
Se você já construiu um agente de texto, seu instinto é que a voz é "a mesma coisa, só que falada." Não é. A voz traz um conjunto de restrições em tempo real que o chat simplesmente não tem.
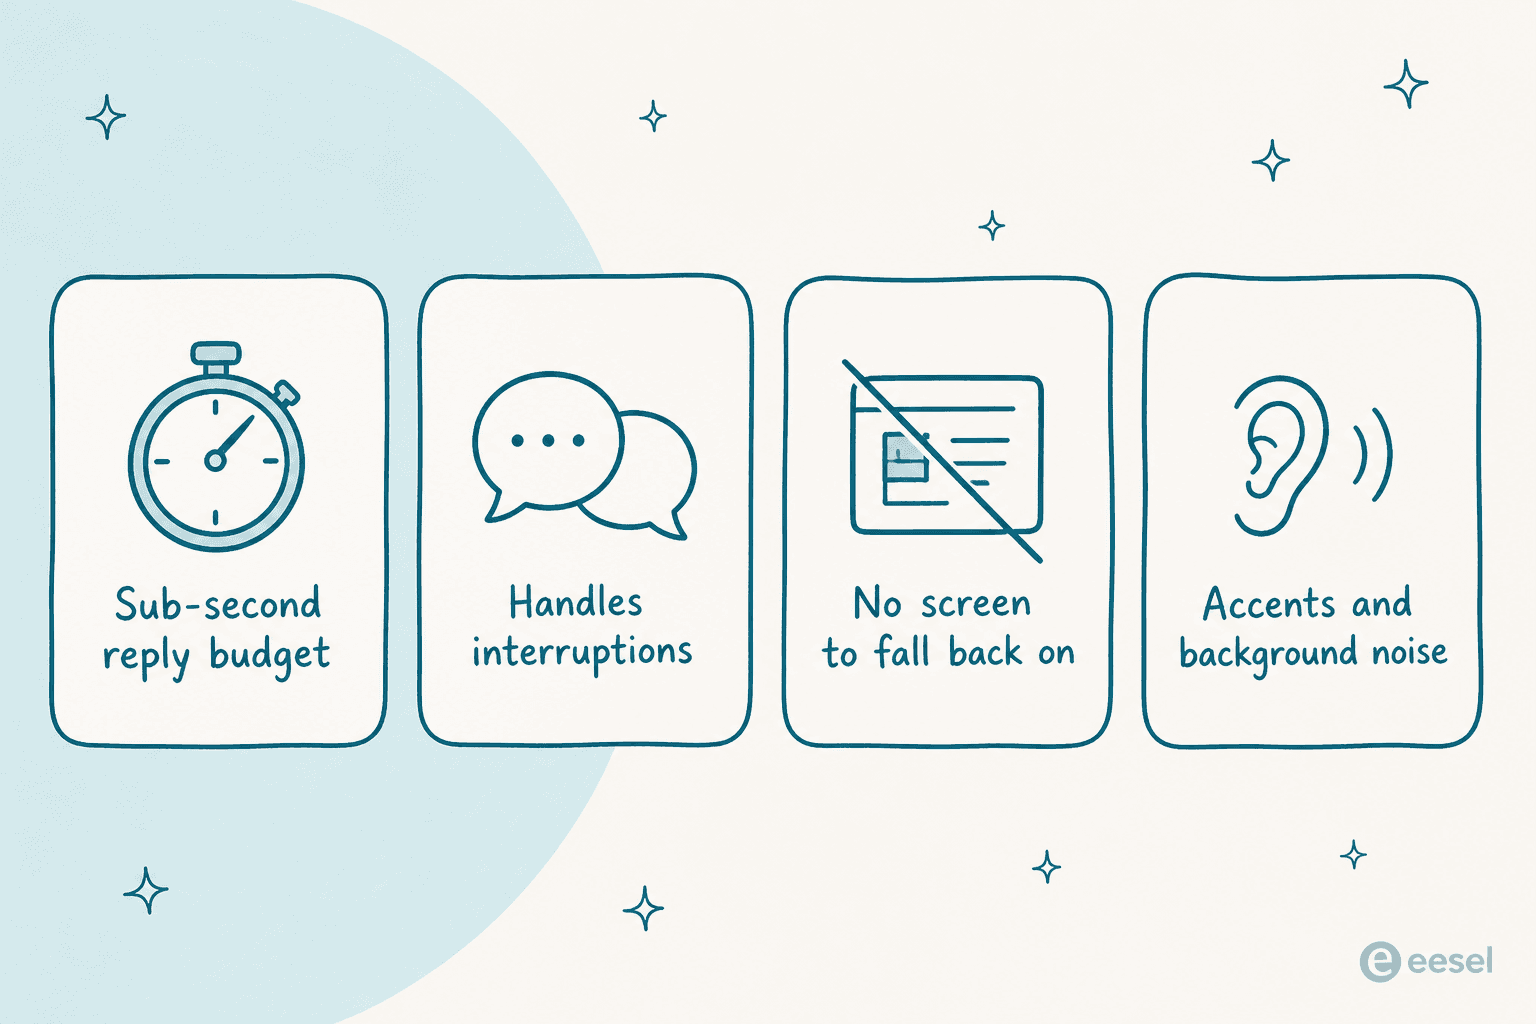
O relógio é o maior problema. A Twilio, ao publicar suas próprias metas de lançamento no fim de 2025, define a latência como o "mouth-to-ear turn gap" e fixa uma meta de ponta a ponta de 1.115 ms, com um limite superior de 1.400 ms. Esse orçamento não é gasto em um só lugar. Ele se acumula em aproximadamente STT 350 ms, LLM 375 ms, TTS 100 ms, mais rede e buffer, e como esses números se somam, "acceptable numbers at each stage can still sum to a broken conversation." A Deepgram coloca o limiar de percepção ainda mais baixo: quem liga "start noticing lag near 800ms of total round-trip time."
Depois há tudo o que quem liga faz e o usuário de chat nunca faz. Interrompe. Tratar esse "barge-in" significa cancelar a resposta em andamento no instante em que a pessoa entra, e é por isso que a API de agentes da Deepgram traz detecção de barge-in integrada e previsão de troca de turnos. Também ligam de lugares barulhentos, com sotaques e sem tela como alternativa, então não existe a saída "clique no botão abaixo" quando o áudio não está claro.
Um desenvolvedor que reconstruiu um ciclo de voz do zero apontou a dificuldade exatamente onde ela está:
"The hard part isn't STT, LLMs, or TTS in isolation, but turn-taking: detecting when the user starts and stops speaking, cancelling in-flight generation instantly, and pipelining everything to minimize time-to-first-audio... By colocating Twilio, Deepgram, ElevenLabs, and the orchestration layer, I reached ~790ms end-to-end latency."

Os modelos, para ser justo, ficaram realmente bons. O gpt-realtime marca 82,8% na avaliação de raciocínio Big Bench Audio, contra 65,6% do modelo da OpenAI do fim de 2024, e consegue captar sinais não verbais como risadas e trocar de idioma no meio da frase. A inteligência geralmente não é o que quebra uma demo de voz. É a infraestrutura em volta.
Quanto um agente de voz com IA realmente custa
Esta é a parte que a maioria das páginas de fornecedores esconde: a IA de voz é cobrada por minuto de conversa, e o valor por minuto do título quase nunca é a conta inteira. Dependendo do fornecedor, somam-se também telefonia (a linha telefônica), STT, o LLM e o TTS, às vezes agrupados, às vezes repassados "a preço de custo", às vezes cobrados como itens separados que você mesmo monta.
Três formatos de preço dominam:
- Tudo incluído por minuto (Bland, Retell, ElevenLabs Agents): uma tarifa única que já inclui STT, LLM e TTS. Mais simples, geralmente com um valor de vitrine um pouco maior.
- Taxa de plataforma mais repasse (Vapi): uma taxa fina de orquestração por minuto e depois você paga STT, LLM e TTS a preço de custo. O piso mais barato, com mais peças móveis.
- Componente ou infraestrutura (Twilio, Deepgram, OpenAI, Amazon Connect): você compra uma camada e conecta o resto por conta própria.
| Fornecedor | Plano / nível | Tarifa publicada | O que está incluído | Repassado ou extra |
|---|---|---|---|---|
| Bland AI | Start (dev) | $0.14 / min | LLM, STT, TTS tudo incluído, "no model pass-throughs" | Número de entrada ~US$ 15/mês; US$ 0,05/min de transferência |
| Retell AI | Pay-as-you-go | $0.07-$0.31 / min (~$0.115 ponto médio) | Infraestrutura de voz + LLM + TTS combinados | US$ 10 em créditos grátis; telefonia ~US$ 0 se for a sua |
| Ringly | Pagamento por conversa | US$ 99/mês inclui 50 conversas; depois US$ 1,99/conversa | Suporte telefônico com IA conectado ao Shopify | Chamadas em que o Seth ajuda antes da transferência são cobráveis; tarifas personalizadas a partir de 1.000+ chamadas/mês |
| Vapi | Build (uso) | $0.05 / min taxa de plataforma | Apenas a orquestração da Vapi | STT/LLM/TTS a preço de custo; US$ 10/linha/mês acima de 10 |
| Deepgram | Voice Agent API (Standard) | $0.075 / min | Pacote da Deepgram STT + LLM + TTS | LLM próprio US$ 0,065/min; Advanced US$ 0,163/min |
| ElevenLabs Agents | Tarifa excedente | $0.08 / min (burst $0.16) | TTS + orquestração + minutos do plano | LLM cobrado separado; telefonia separada |
| Twilio | ConversationRelay | $0.07 / min | Apenas orquestração de voz com IA | + PSTN $0.0085-$0.014/min + seu próprio STT/LLM/TTS |
| Amazon Connect | Voz (uso) | $0.038 / min de voz | Telefonia de contact center + plataforma | Telefonia + complementos Amazon Q / Contact Lens |
| OpenAI Realtime | gpt-realtime-2.1 | $32 / 1M tokens de áudio de entrada, $64 / 1M de áudio de saída | Apenas o modelo | ~US$ 0,06-0,24/min na prática; sem telefonia |
A Ringly é outro tipo de compra: um serviço voltado ao Shopify cobrado por conversa, e não infraestrutura de voz cobrada por minuto. O exemplo a seguir vale para as plataformas por minuto.
Um exemplo prático mostra como isso se acumula. Digamos que você tenha 2.000 chamadas de suporte por mês, com média de 4 minutos. Numa plataforma tudo incluído a cerca de US$ 0,12/min, são 8.000 minutos, ou cerca de US$ 960 de plataforma. Some uma linha estilo Twilio a ~US$ 0,01/min e você chega perto de US$ 1.040, mais o aluguel do número e os minutos de transferência para uma pessoa. Barato por chamada, mas sobe com o volume, e as chamadas mais longas e confusas (as que um caso fora do padrão cria) são as caras.
Algumas armadilhas para considerar antes de assinar qualquer coisa:
- A telefonia quase sempre é cobrada à parte, mesmo por fornecedores "tudo incluído". É uma linha real por minuto mais US$ 1 a US$ 2 por número, e as tarifas internacionais são bem mais altas.
- "A preço de custo" não é de graça. O piso de US$ 0,05/min da Vapi é real, mas STT mais LLM mais TTS a preço de custo facilmente somam US$ 0,05 a US$ 0,10, e você acaba na mesma faixa dos fornecedores tudo incluído.
- Conformidade é um adicional. HIPAA e Zero Data Retention são níveis pagos em algumas plataformas; um BAA costuma ficar restrito ao Enterprise.
Se, depois dessa tabela, sua impressão é de que o preço por minuto é imprevisível, essa é a leitura honesta. É um dos motivos pelos quais os canais de texto, em que a eesel usa planos mensais de créditos com um crédito por ticket ou chat de cliente, e não por minuto de conversa, costumam ser mais fáceis de prever. Nosso detalhamento completo do custo de agente de IA versus agente humano faz as contas.
Três plataformas de voz com IA para comparar no atendimento ao cliente
As opções abaixo cobrem diferentes necessidades de implantação. Teste cada uma com suas próprias chamadas, sistemas conectados e requisitos de transferência antes de escolher.
1. Bland AI: uma pilha de voz agrupada
A Bland AI combina o modelo de linguagem, o reconhecimento de fala e a geração de fala em sua plataforma de voz. É uma opção para equipes que querem esses componentes com um único fornecedor. Confirme as cobranças de número de telefone e transferência além da tarifa da plataforma.
2. Retell AI: infraestrutura de voz baseada em uso
A Retell AI oferece infraestrutura de voz com preço baseado em uso. Compare a configuração completa de que você precisa, incluindo modelo, voz e telefonia, em vez de tratar a menor tarifa anunciada como o custo de cada chamada.
3. Ringly: suporte telefônico com IA para lojas Shopify
O Seth, da Ringly, é um sistema de atendimento telefônico com IA criado para lojas Shopify. Ele atende chamadas recebidas, consulta pedidos e produtos, resolve dúvidas rotineiras sobre devoluções e transfere quem liga para sua equipe quando necessário. Serve a equipes de e-commerce que querem um agente de voz conectado aos dados da loja sem montar a própria pilha de voz e telefonia.
Diferente das opções de infraestrutura por minuto acima, a Ringly cobra por conversa. Seu preço publicado é de US$ 99/mês pelas primeiras 50 conversas e depois US$ 1,99 por cada conversa cobrável adicional. Chamadas em que o Seth ajuda antes de transferir contam do mesmo jeito; spam, desligamentos, números errados e pedidos imediatos por uma pessoa não contam. Confirme como essas regras se aplicam ao seu perfil de chamadas antes de estimar a conta. O foco no Shopify o torna menos adequado a outros setores ou a chamadas ativas.
O que as pessoas realmente dizem sobre ligar para uma IA
As demos sempre mostram a mesma coisa: alguém pergunta "qual é o horário de funcionamento" e uma IA responde com fluidez. A realidade é mais mista, e a distância entre as duas é o mais útil de entender antes de implantar.
Quando funciona, funciona de verdade. Aqui, uma pessoa real descreve uma ligação de suporte fora do expediente, não um fornecedor:
"It was after hours, and a dreaded robot voice answered my call. I was fully prepared to spend the next 10 minutes rewording my issue... Surprisingly, this robot understood every single sentence I said... That's the most pleasant customer service call I have ever experienced. I don't mind talking to AI. In fact, instead of a live agent, I actually prefer to talk to your LLM, so my issue can be quickly triaged to the right human who actually understand my situation."
Repare no que tornou aquela chamada boa: ela foi encaminhada à pessoa certa. Esse é o padrão. Agora o modo de falha, de alguém que caiu num beco sem saída de desvio:
"One (recently) even told me, after wandering through the menu options, that they were going to text me a link to their app - and then hung up on me. I already tried the app, their system was broken - that's why I was trying to call and talk to a human!"
E o enquadramento mais afiado da tensão central, que vale ler duas vezes:
"The problem with the call center A.I. is that almost every time I need to call somewhere that uses them, I have some kind of edge case. They always give examples of how the automated agent can handle simple queries like 'what's my balance'... but I never need to call with something straightforward like that."
Esse é o jogo todo em um comentário. As pessoas não ligam por causa do simples, ligam por causa do caso fora do padrão, e um agente que não consegue admitir com clareza "este é para uma pessoa" transforma um canal de suporte numa parede.
O que todo mundo erra: confiança acima de cobertura
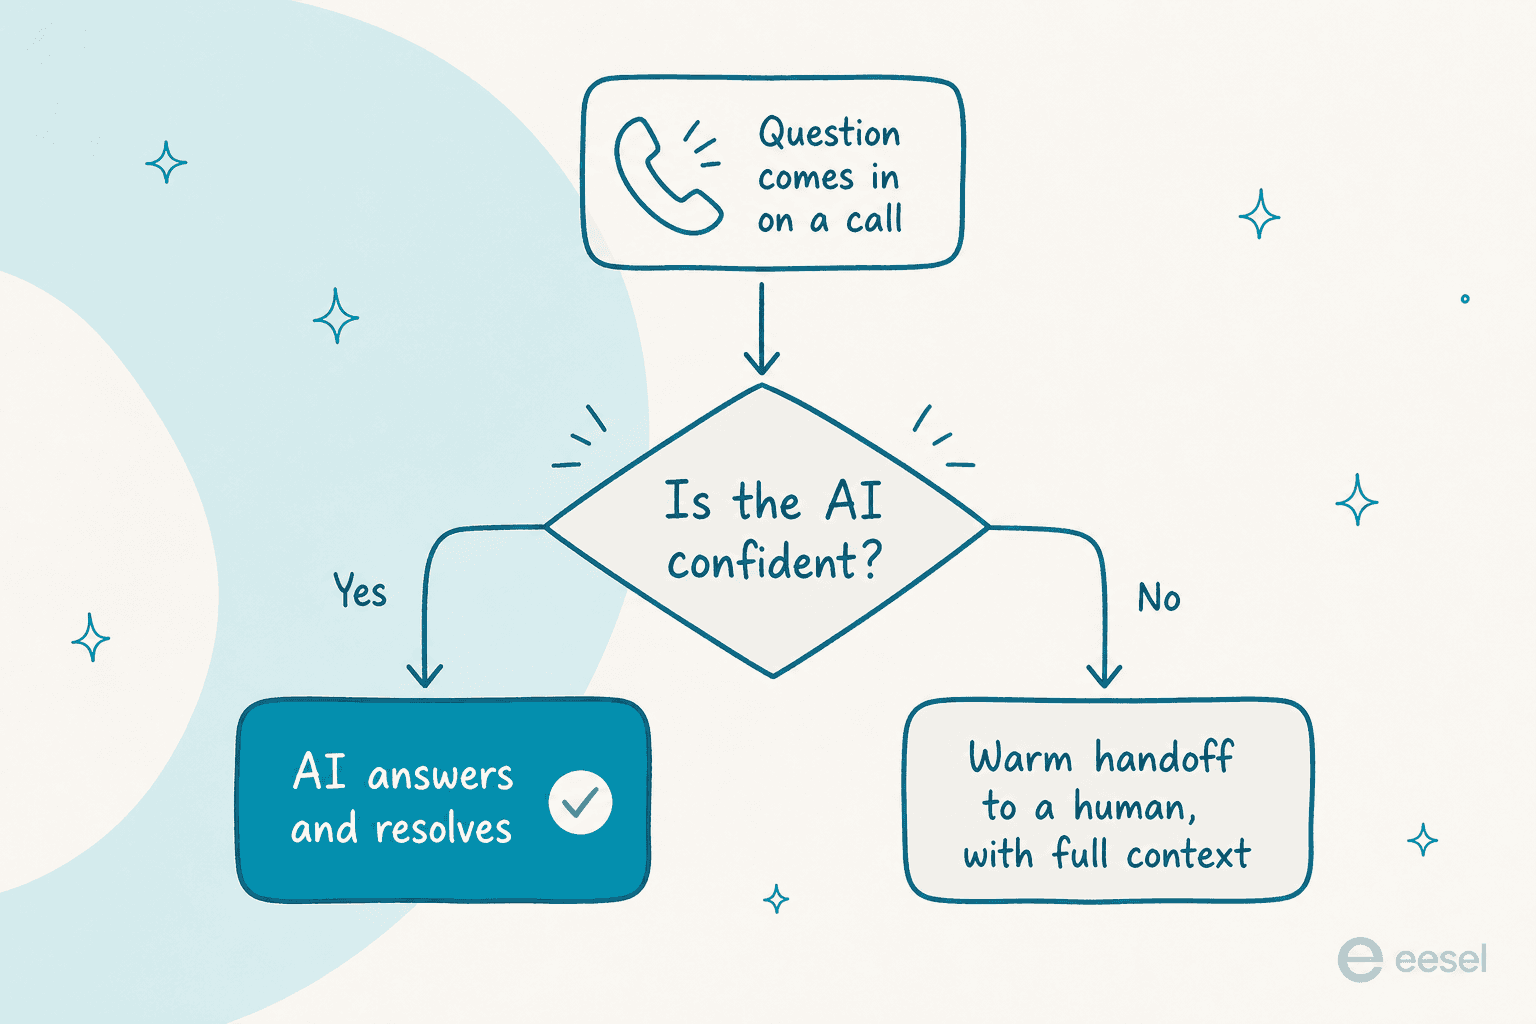
O erro que vejo as equipes cometerem repetidamente é otimizar quanto o agente de voz consegue responder em vez de quão bem ele sabe quando não responder. Numa chamada ao vivo, uma resposta errada dita com confiança é pior do que uma transferência rápida, porque quem liga age com base nela e você só descobre depois.
Essa não é uma ideia exclusiva da voz, é a lição de anos operando IA em filas de suporte ao vivo, em todos os canais. Um dos nossos clientes, líder de CX numa marca DTC de suplementos, disse melhor do que qualquer apresentação comercial:
"The AI will never be able to answer 100% of the questions. I need an AI who is only handling the tickets that it's confident to handle, and all the other ones, leave them alone."
Esse é o princípio de projeto. Na prática, significa três coisas, seja o canal voz ou texto:
- Baseie cada resposta no seu conhecimento real, para que o agente busque na sua central de ajuda e em resoluções passadas em vez de improvisar. Isso evita que ele alucine em perguntas de suporte.
- Condicione à confiança, para que só resolva o que tem certeza e passe o resto a uma pessoa com todo o contexto, exatamente o padrão da boa chamada acima.
- Teste com seu próprio histórico antes de entrar no ar, não com os cenários de demo de um fornecedor. Você quer saber como ele teria tratado suas últimas mil chamadas ou tickets reais, não um "qual é o horário de funcionamento" roteirizado.
Esse último ponto é o que as equipes pulam e lamentam. É a diferença entre esperar e saber, e é por isso que simular com tickets passados antes de tocar em um único cliente virou requisito básico no lado de texto do suporte.
Onde a voz com IA se encaixa na sua pilha de suporte
Então, você deve colocar um agente de IA na sua linha telefônica? Minha opinião honesta: a voz é um canal e, para a maioria das equipes de suporte, não é o maior. Chat, e-mail e tickets costumam concentrar muito mais volume e é menos arriscado automatizá-los primeiro, porque um agente de texto pode redigir, esperar revisão e transferir sem ninguém esperando ao telefone em tempo real.
Uma sequência sensata para a maioria das equipes:
- Automatize os canais de texto primeiro, onde valem o mesmo conhecimento e o mesmo filtro de confiança, com um modo de falha muito mais suave. É aqui que uma ferramenta de atendimento ao cliente com IA se paga mais rápido.
- Descubra do que seu agente realmente tem certeza com dados reais, usando a taxa de resolução e outras métricas como guia.
- Estenda para a voz quando confiar no roteamento, reaproveitando a mesma base de conhecimento e a mesma lógica de transferência que você já validou no texto.
O conhecimento e a lógica de confiança são as partes reutilizáveis. A infraestrutura específica de voz (telefonia, latência, barge-in) é a camada extra que você acrescenta por cima, e é um projeto de verdade, não uma caixinha para marcar. Acertar primeiro a base de texto é o que faz valer a pena adicionar a camada de voz depois.
Experimente a eesel no lado de texto do suporte
A eesel é uma colega de IA para helpdesk que cuida dos canais onde está a maior parte do seu volume: tickets, chat ao vivo e e-mail dentro do helpdesk que você já usa. Não é um agente de telefone ou de voz, e prefiro dizer isso claramente a exagerar. O que ela faz bem é a base que este texto inteiro defende que você construa primeiro: ela treina nos seus tickets passados e na sua central de ajuda, condiciona as respostas à confiança para só responder o que tem certeza e permite simular com seu histórico real de tickets antes de tocar numa conversa ao vivo, para você ver a taxa de resolução antes de se comprometer.

Ela se integra ao Zendesk, Freshdesk, Gorgias, Front, Help Scout e Slack, e usa planos mensais de créditos em vez de cobrança por minuto, que você pode conferir na página de preços. Faça os canais de texto resolverem bem primeiro, e a camada de voz vira uma extensão de algo em que você já confia, não um salto no escuro. Você pode experimentar a eesel de graça, sem cartão de crédito e sem conversa com vendas.