

Gemini 3.5 Transcribeは、GoogleがGeminiの名を冠して初めて出した音声認識モデルです。ドキュメント、ベンチマーク、本番で使っている人たちの声を徹底的に調べたうえでの私の結論は、強力で価格も妥当なマネージドモデルだが、1つだけ本物の落とし穴がある、というものです。
良い点:ファイル用モデルで1分あたり約0.005ドル(Google自身のCloud Speech-to-Textスタンダード層の約3分の1)、クリーンな英語音声で単語誤り率2.6%、組み込みの話者分離、単語タイムスタンプ、85以上の言語に対する言語自動検出。
落とし穴:Googleが最も推しているSmart transcriptionは、話し言葉を整えるために書き換えを行いますが、何がノイズかという判断が常にあなたと一致するわけではありません。テスターは、正確な言い回しが削られる例を確認しています。また、話者分離は3人を超えると不安定になり、議事録では問題になります。
向いている人:ディクテーション、話者が1人の録音、大量でコストを重視する文字起こし。ほかを探すべき人:逐語的な出力が必要な場合(法務、研究)や、複数話者の会議。後者ではDeepgramやElevenLabs Scribeのような専門サービスが今も先行しています。そしてサポートチームの場合、文字起こしは入力レイヤーにすぎず、チケットを実際に解決する何かが別に必要です。そこで登場するのがAIヘルプデスクのチームメイトです。
Gemini 3.5 Transcribeとは(ざっくり)
これまで、Googleで音声を文字起こしするには2つの方法しかありませんでした。Google CloudのSpeech-to-Text API(Chirpシリーズ)か、汎用のGeminiチャットモデルに音声ファイルを渡して丁寧にお願いするかです。2026年8月26日ごろに発表されたGemini 3.5 Transcribeは、この用途のためにGoogleが初めて専用に作ったモデルで、Chirp 3の後継と位置づけられています。
Googleのモデルページは、これを「a speech-to-text model based on Gemini's audio understanding capabilities」と説明しており、言語検出、話者分離、単語単位のタイムスタンプ、Smart transcription、カスタム語彙のバイアス指定を備えています。実際には2つのエンドポイントで、録音済みファイル用のgemini-3.5-transcribeと、リアルタイムストリーミング用のgemini-3.5-transcribe-liveです。料金と仕様の詳細は別記事で掘り下げています。このレビューでは、本当に良いのかどうかを扱います。
多くの開発者が最初に見ることになる、モデルページ自体がこちらです。
これを基盤にする前に1点注意があります。Google自身のドキュメントでも、ステータスについて意見が一致していません。モデル概要ページでは「New Stable」とされている一方、ローンチブログでは「in public preview」とされています。すでにコンシューマー向け製品(GboardのRambler、macOS版Geminiアプリ)で稼働しているため、本番に近いが完全には固まっていない、と捉えるのがよいでしょう。
どう評価したか
数か月分の本番ログがあったわけではないので、このレビューの根拠は正直にお伝えします。モデルカードと料金ドキュメントを全文読み、Googleのベンチマーク主張がどう示されているかを確認し、ローンチ後の数日間にWhisper、Deepgram、ElevenLabs Scribeと比較テストをしていた開発者たちの声に大きく頼りました。文字起こしは、ベンダーのきれいなベンチマーク値と実際の結果が大きく乖離しがちな分野なので、コミュニティの声は仕様書と同じくらい重要です。
分かったことを手短に言うと、数値は本物で良好、価格は非常に競争力があり、目立つ不満は2つの点に集中しています。順に見ていきましょう。
精度:ラボの数値は優秀、試金石は実際の音声
紙の上では、このモデルは非常に優秀です。Googleは以下の単語誤り率を報告しており、いずれもArtificial Analysisによるものとされています。
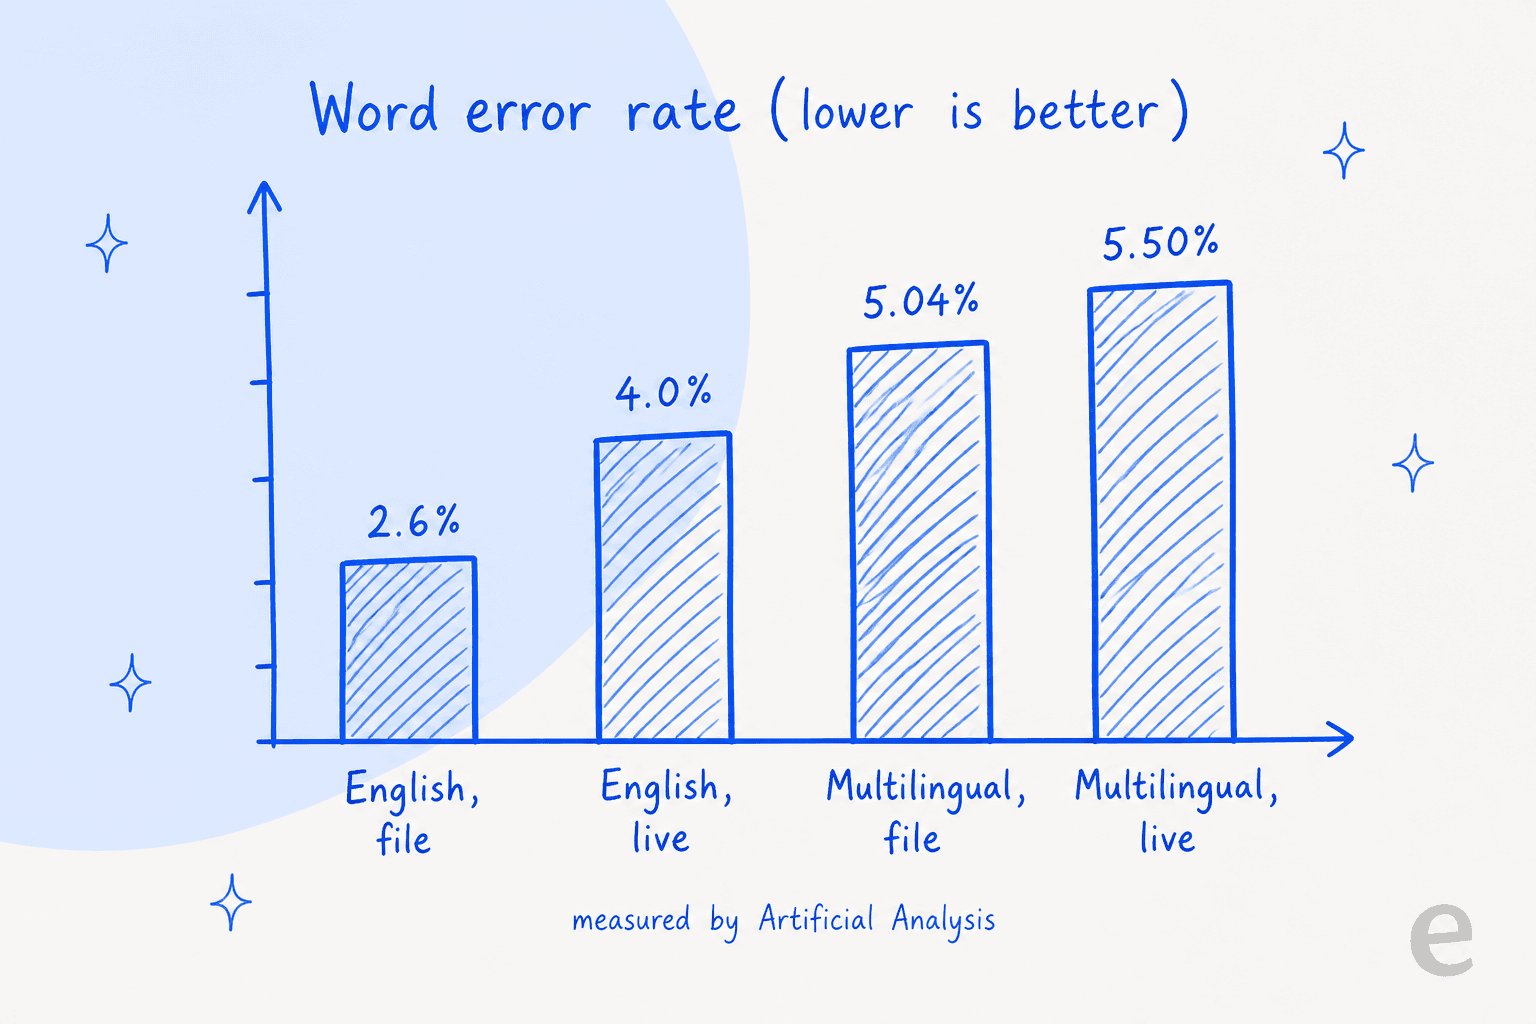
非ストリーミング英語での単語誤り率2.6%は、おおよそ40語に1語の誤りという水準で、非常に優秀です。Googleは最終文字起こしまでの時間がChirp 3比で70%改善したとも主張していますが、この見せ方はGoogle自身のものなので、独立したベンチマークではなくベンダー提示の数値として扱います。
より有用なのは、人々が自分の音声で動かして分かったことです。ここでは評価が割れます。強い肯定側では、レビューとしてはほぼ最大級の称賛でした。
"I am using it all day as a main dictation model, and I can say it's the best model in terms of accuracy, latency, and formatting I have ever used."

しかしローンチスレッドには、比較を行ってもう少し冷めた結論に至った人が大勢います。まさにこれを仕事にしている1人は、ハイブリッド構成に戻りました。
"Curious if this suffers from the same hallucination problems as Chirp or not... we've moved back to Whisper for timestamp accuracy and then Gemini Flash for transcription correction."
私の見方:きれいなベンチマーク上の単語誤り率と、あなたの実際の音声(ノイズの多い通話、複数の訛り、混線)での単語誤り率は別物です。ラボの数値は有力な出発点であって、保証ではありません。実務で評価するなら、パイプラインを組む前に自分の録音で試してください。
Smart transcriptionの落とし穴
このレビューで最も強調したいのがここです。Smart transcriptionはGoogleが最も力を入れている機能であり、同時に最も多い不満でもあります。人の話し言葉をそのまま書き起こしたものは雑然としています。「えーと」と言い、言い直し、数字をもごもご言います。Smart transcriptionはそれらを自動で整えます。
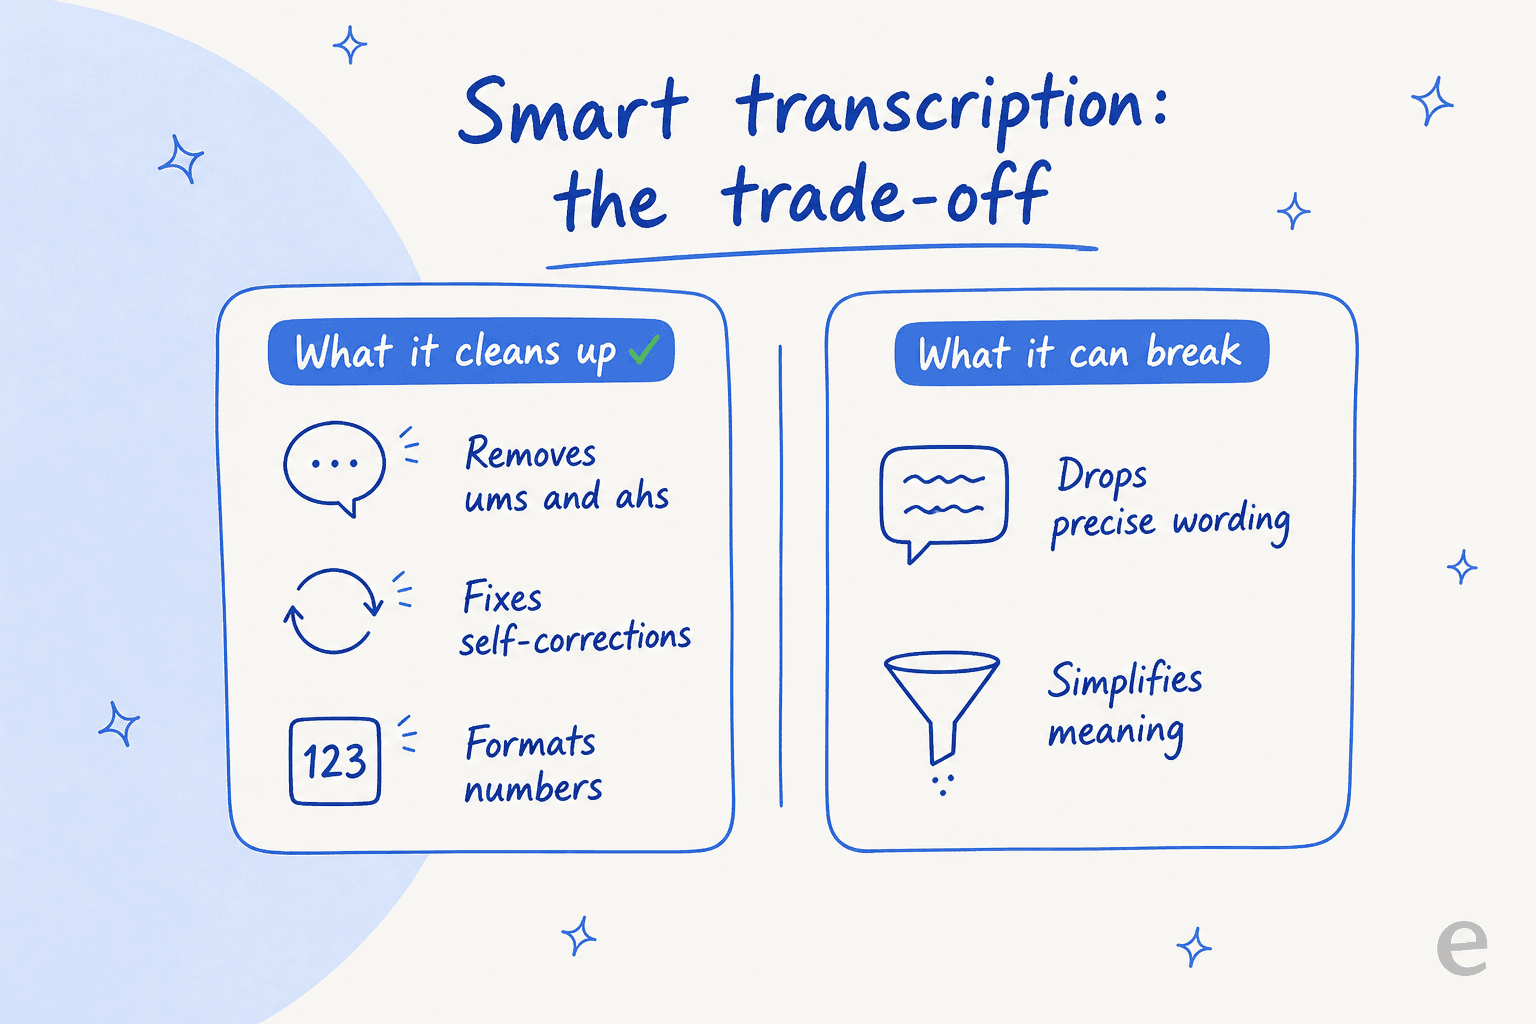
ローンチ記事によると、言い直し(「let's meet Tuesday, no, Wednesday」が「Wednesday」になる)を処理し、フィラーを除去し、英数字の並びを賢く整形します。メールのディクテーションや議事メモの整理には、単体のディクテーションツールが別料金を取るような機能であり、基本モデルに含まれているのは確かな利点です。
問題は、「整える」ことが判断を要する行為であり、モデルがあなたの判断を常に共有するわけではない点です。Pixel 11 Proで試したある開発者は、率直にこう述べました。
"The main issue is when you want to say something precise with specific wording it might 'simplify' it and break the meaning. Something like 'I hesitated to check it, I should have verified' => 'I should have verified'... I tried the sentence few times and it always removed the first part."
購入判断で持っておくべき考え方は、Smart transcriptionは中立的な文字起こしではなく機能だ、ということです。正確な言葉が重要な用途(法務、研究、コンプライアンス、医療)では、脚注ではなく真剣に比較検討すべきトレードオフです。このモデルを信頼する前に、自分の音声で最も念入りに試したいのがこの点です。
話者分離は3人を超えると止まる
2つ目の繰り返し出る不満は複数話者の扱いで、会議の文字起こしをするなら注意すべき点です。Googleのドキュメントには2つの異なる上限が書かれています。モデルページではファイル用モデルが「up to 8 speakers (Attribution for 3+ speakers is experimental)」に対応するとされ、ローンチブログでは「up to three」とされています。現時点で信頼できる上限は3人なので、この数字で計画するのがよいでしょう。ライブストリーミング用モデルは低遅延を優先するため、話者分離がまったくありません。
この差はテストで大きく表れました。
"Still no real time diarization beyond 3 people (and even then experimental) when others do it very well, like Soniox and Deepgram. For something like meeting notes this is critical."
ユースケースが2人のサポート通話や、話者1人のボイスメモなら、影響はありません。6人のスタンドアップなら実際の制約であり、開発に入って3週間たつまで仕様書では見過ごしてしまうタイプの問題です。
料金:ここが強み
Googleはモデル発表に料金を載せず、それに苛立った開発者の1人が自らHacker Newsに投稿したほどでした。料金ページから分かる実際の姿は次のとおりです。
| モデル | 音声入力 | テキスト出力 | 混合レート |
|---|---|---|---|
gemini-3.5-transcribe(ファイル) | 100万トークンあたり$2.00(約$0.003/分) | 100万トークンあたり$12.00(約$0.002/分) | 約$0.005 / 分 |
gemini-3.5-transcribe-live(ストリーミング) | 100万トークンあたり$3.50(約$0.005/分) | 100万トークンあたり$21.00(約$0.004/分) | 約$0.009 / 分 |
比較として、Google自身のCloud Speech-to-Text v2のスタンダード認識は$0.016/分から、ダイナミックバッチ層は$0.003/分です。つまり新しいファイル用モデルは、スタンダードのリアルタイム認識をきれいに下回り、最安のバッチオプションをわずかに上回る位置にあります。計算するときは同じ条件同士で比べてください。リアルタイム同士、バッチ同士です。
具体的に確認するため、自分の利用量を入力してみてください。
計算例:月に200時間のサポート通話を文字起こしする小規模チームは、ファイル用モデルで約60ドル、Cloud Speech-to-Textスタンダードでは約192ドルになります。確かな節約ですが、この規模では人生が変わるほどではありません。正直なところ、より大きなコストの問題は、文字起こしそのものではなく、その後トランスクリプトをどう扱うかであることが多いです。これについては後述します。
Whisper、Deepgram、Scribeとの比較
ここは慎重にいきたいところです。公平な一騎打ちの比較には各ベンダー自身の数値が必要で、正直なところ、実際のA/Bテストは私ではなくユーザーが行っています。そこで、十分に裏付けできない仕様表の代わりに、これらのモデルを実際に比較している人たちが何を見つけたかを紹介します。
コストについては、反応がほぼ真っ二つに割れました。whispermemos.comを運営する開発者は計算して、感心した様子でした。
"I did the math based on our data from customers... and it seems to be $0.12 per hour of input audio... Scribe is $0.22. If the accuracy is close to Scribe, I think it's a good deal."
精度が十分近づくか確信が持てない人もいました。
"Still more expensive and worse performing than ElevenLabs Scribe, unfortunately. Not sure who's the target audience for this."
そしてWhisperには今も熱心な支持者がいます。セルフホストなら無料であることと、すでにチームがその周りにパイプラインを構築していることが理由です。私が最も多く見たパターンはハイブリッドで、正確な単語タイムスタンプにWhisper、実際のテキストにGeminiモデルを使うものでした。要するに、Gemini 3.5 Transcribeは強力で価格も妥当なマネージドの選択肢であり、専門のASRツールに対して自動的に勝つわけではありません。どちらが勝つかは、あなたの音声と、信頼できる話者分離が必要かどうかで決まります。
結論:誰に向いているか
リサーチを踏まえた私の結論は次のとおりです。
| Gemini 3.5 Transcribe | |
|---|---|
| 強み | 低価格(ファイルで約$0.005/分)、英語の単語誤り率2.6%、組み込みの話者分離とタイムスタンプ、85以上の言語、マネージドAPI |
| 弱み | Smart transcriptionが正確な言い回しを書き換えることがある、3人を超える話者分離は信頼できない、バッチ/Flex層がない、ステータスと話者数上限についてドキュメントが矛盾 |
| 最適な用途 | ディクテーション、話者1人のボイスメモ、大量でコストを重視する文字起こし |
| ほかを探すべき場合 | 逐語出力、4人以上の会議、またはバッチで最低コストが必要な場合 |
結局は、あなたの音声次第です。
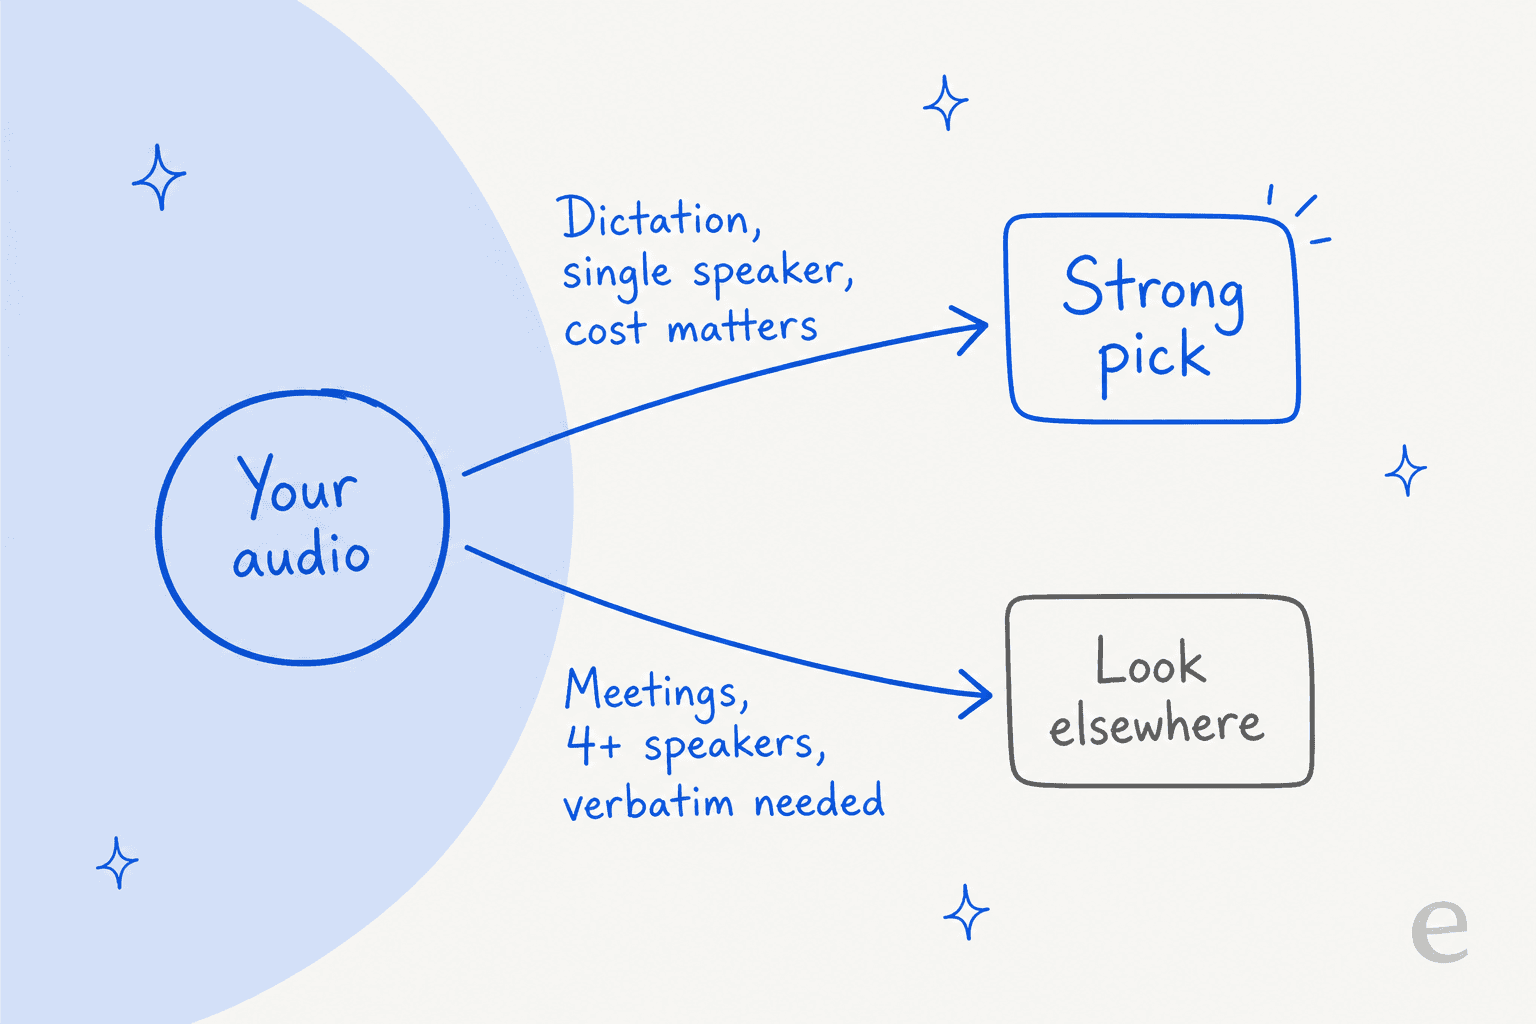
ディクテーション機能を出荷する、あるいは話者1人のボイスメモの山を文字起こしするなら、私は喜んでこれを選びます。マネージドモデルとして、価格と英語の精度は他に勝ちにくいからです。6人の会議の議事録を作る場合や、正確な言葉が法的な重みを持つ用途では、決める前にDeepgramやElevenLabs Scribeも並べて試し、ベンチマークの数値が自分の音声に当てはまるとは考えません。
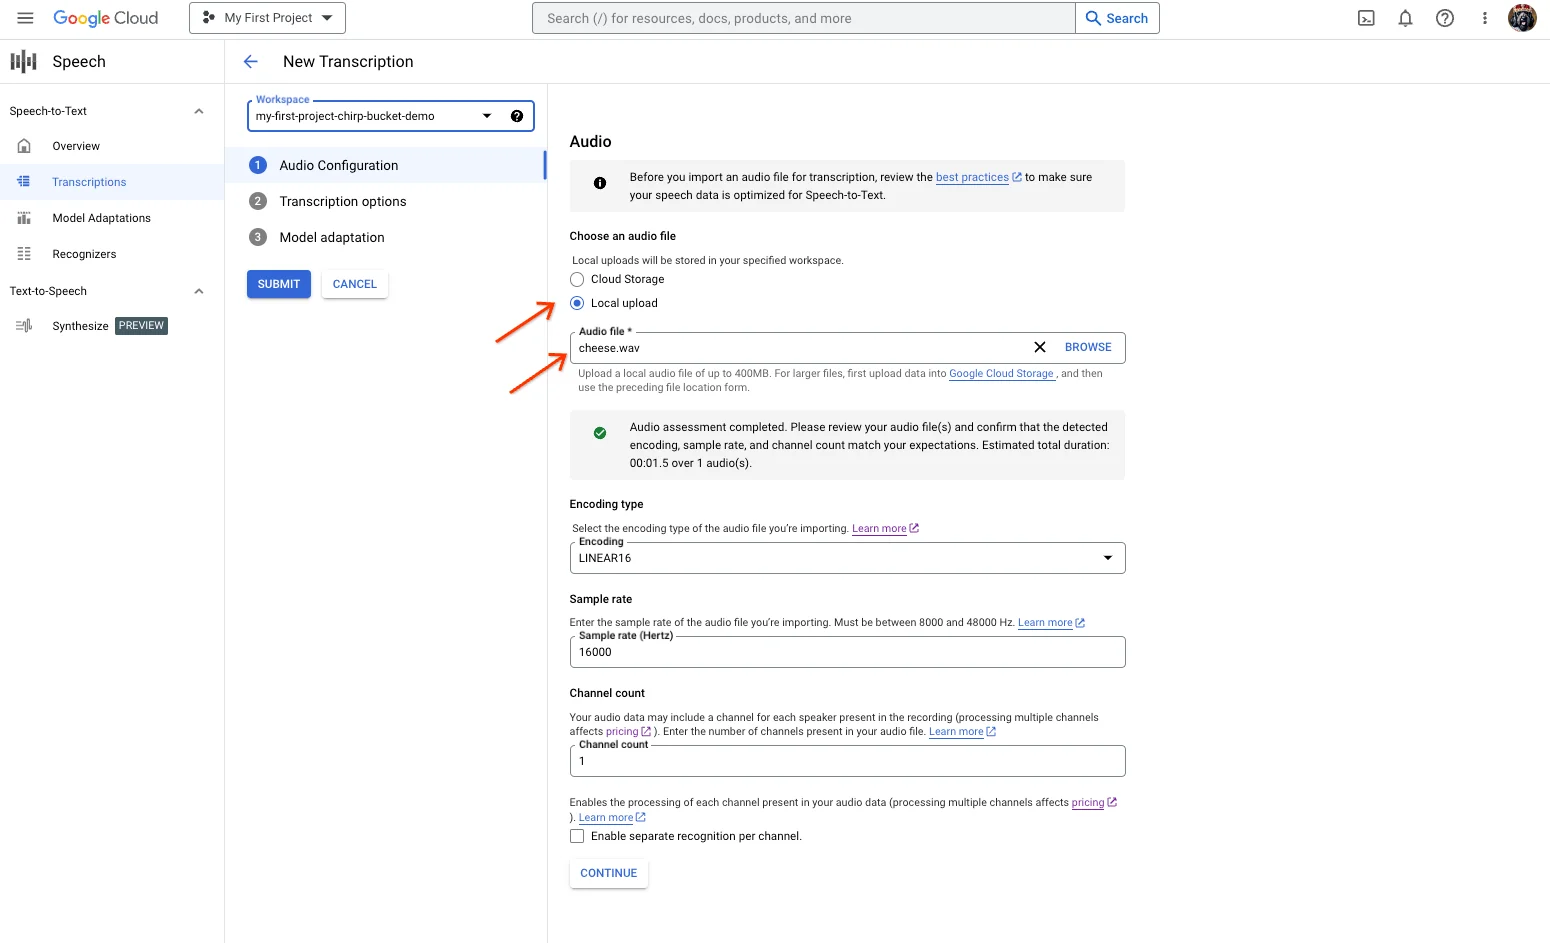
参考までに、Google Cloudの文字起こしコンソールを使ったことがあれば、ファイルアップロードの流れは馴染みがあるはずです。音声を指定し、オプションを選びます。
サポートチームにとっての文字起こしの位置づけ
レビューでは見落とされがちなので、はっきり言っておきます。Gemini 3.5 Transcribeはインフラです。音声をテキストに変え、その難しい仕事をうまくこなします。しかし、顧客の電話やボイスメモの文字起こしは答えではなく、ただの始まりです。そのテキストを読み、顧客が何を必要としているかを理解し、適切な情報を引き出し、実際にチケットを解決する何かが、まだ必要です。
その解決レイヤーこそ、私が取り組んでいる領域です。ここ数年、実際のサポートキューで動くAIに関わってきましたが、パターンは変わりません。言葉を正確に拾うのは最低条件で、それに正しく対応するのが難しい部分です。文字起こしモデルは言葉を与えてくれますが、あなたの返金ポリシーも、注文システムも、その顧客が直近に開いた3件のチケットも知りません。
これがモデルとチームメイトの違いです。Gemini 3.5 Transcribeは、1つの狭い仕事に優れたモデルです。eeselはチームメイトのプラットフォームで、特定の仕事にすぐ働けるAIチームメイトを採用でき、現在の顔ぶれにはAIヘルプデスクのチームメイトとAIブログライターがいます。ヘルプデスクのチームメイトは、すでにお使いのヘルプデスク、Zendesk、Freshdesk、Gorgiasにつながり、既存のキューに加わって、ヘルプセンターや過去のチケットで学習します。
音声・チャットのチケットにeeselを試す
音声やチャットのチケットに追われていて、文字起こしのレビューにたどり着いたのなら、文字起こしは仕事の半分にすぎないことを思い出してください。eeselのAIヘルプデスクチームメイトは、Gemini 3.5 Transcribeのようなモデルが終わるところから引き継ぎます。顧客のメッセージを読み、返信を作成または送信し、1,000以上の連携にわたってループを閉じます。
最初に挙げたいのはシミュレーションモードです。AIが実際の顧客に触れる前に、過去の自社チケット数千件で実行し、どのように応答していたかを正確に確認できるので、スイッチを入れて祈る必要がありません。どんな文字起こしモデルにも私が勧める「まず自分のデータで試す」という助言が、製品に組み込まれています。料金は月額固定で、500クレジットで月299ドルから(チケットまたはチャット1件につき1クレジット)、席ごとの料金はなく、カード不要で100クレジットの無料プランもあります。問題の賢い文字起こしと、その実際の解決との違いです。